Sunucu kayıtlarınızda CCBot/2.0 (https://commoncrawl.org/faq/) diye kendini tanıtan bir ziyaretçi görüyorsunuz. Ya da bir yapay zekâ modelinin makalesinde, eğitim metninin büyük kısmının "filtrelenmiş Common Crawl" verisinden geldiğini okuyorsunuz. İkisi de aynı yere çıkar: 2008'den beri herkese açık web'in kopyasını çıkaran ve bu kopyaları isteyen herkese veren kâr amacı gütmeyen bir kuruluş.
Bu yazıda bir taramanın içinde neler olduğunu, tarayıcının (crawler) nasıl davrandığını, verinin ne kadar büyük ve ne kadar güncel olduğunu (17 Kasım 2026'da okuduğumuz resmî tarama listesiyle), kimlerin kullandığını, nerede yetersiz kaldığını, site sahiplerinin taramanın dışında nasıl kalabileceğini ve Wayback Machine ile farkını anlatıyoruz.
Common Crawl nedir?
Common Crawl, web'i tarayan ve topladığı sayfaları açık bir veri seti olarak yayımlayan, ABD vergi mevzuatına göre 501(c)(3) statüsünde kâr amacı gütmeyen bir kuruluştur. Kendi sitesine göre 300 milyardan fazla sayfadan oluşan bu veri seti 2007'den beri ücretsiz ve açıktır; 10.000'den fazla araştırma makalesinde de kaynak olarak gösterilmiştir (17 Kasım 2026'da okundu).
Mantığı pratiktir: milyarlarca sayfayı taramak, yalnız büyük şirketlerin karşılayabileceği sunucu ve mühendislik gücü ister; bu yüzden işi tek bir kuruluş yapar ve sonucu herkesle paylaşır. Veri, Amazon S3'te ABD Doğu (Kuzey Virginia) bölgesinde durur ve data.commoncrawl.org adresinden HTTPS ile de indirilebilir. Common Crawl bir arama motoru değildir: sıralanmış sonuç yoktur, yalnızca adres arayan bir dizin vardır.
Bir Common Crawl taramasında neler var?
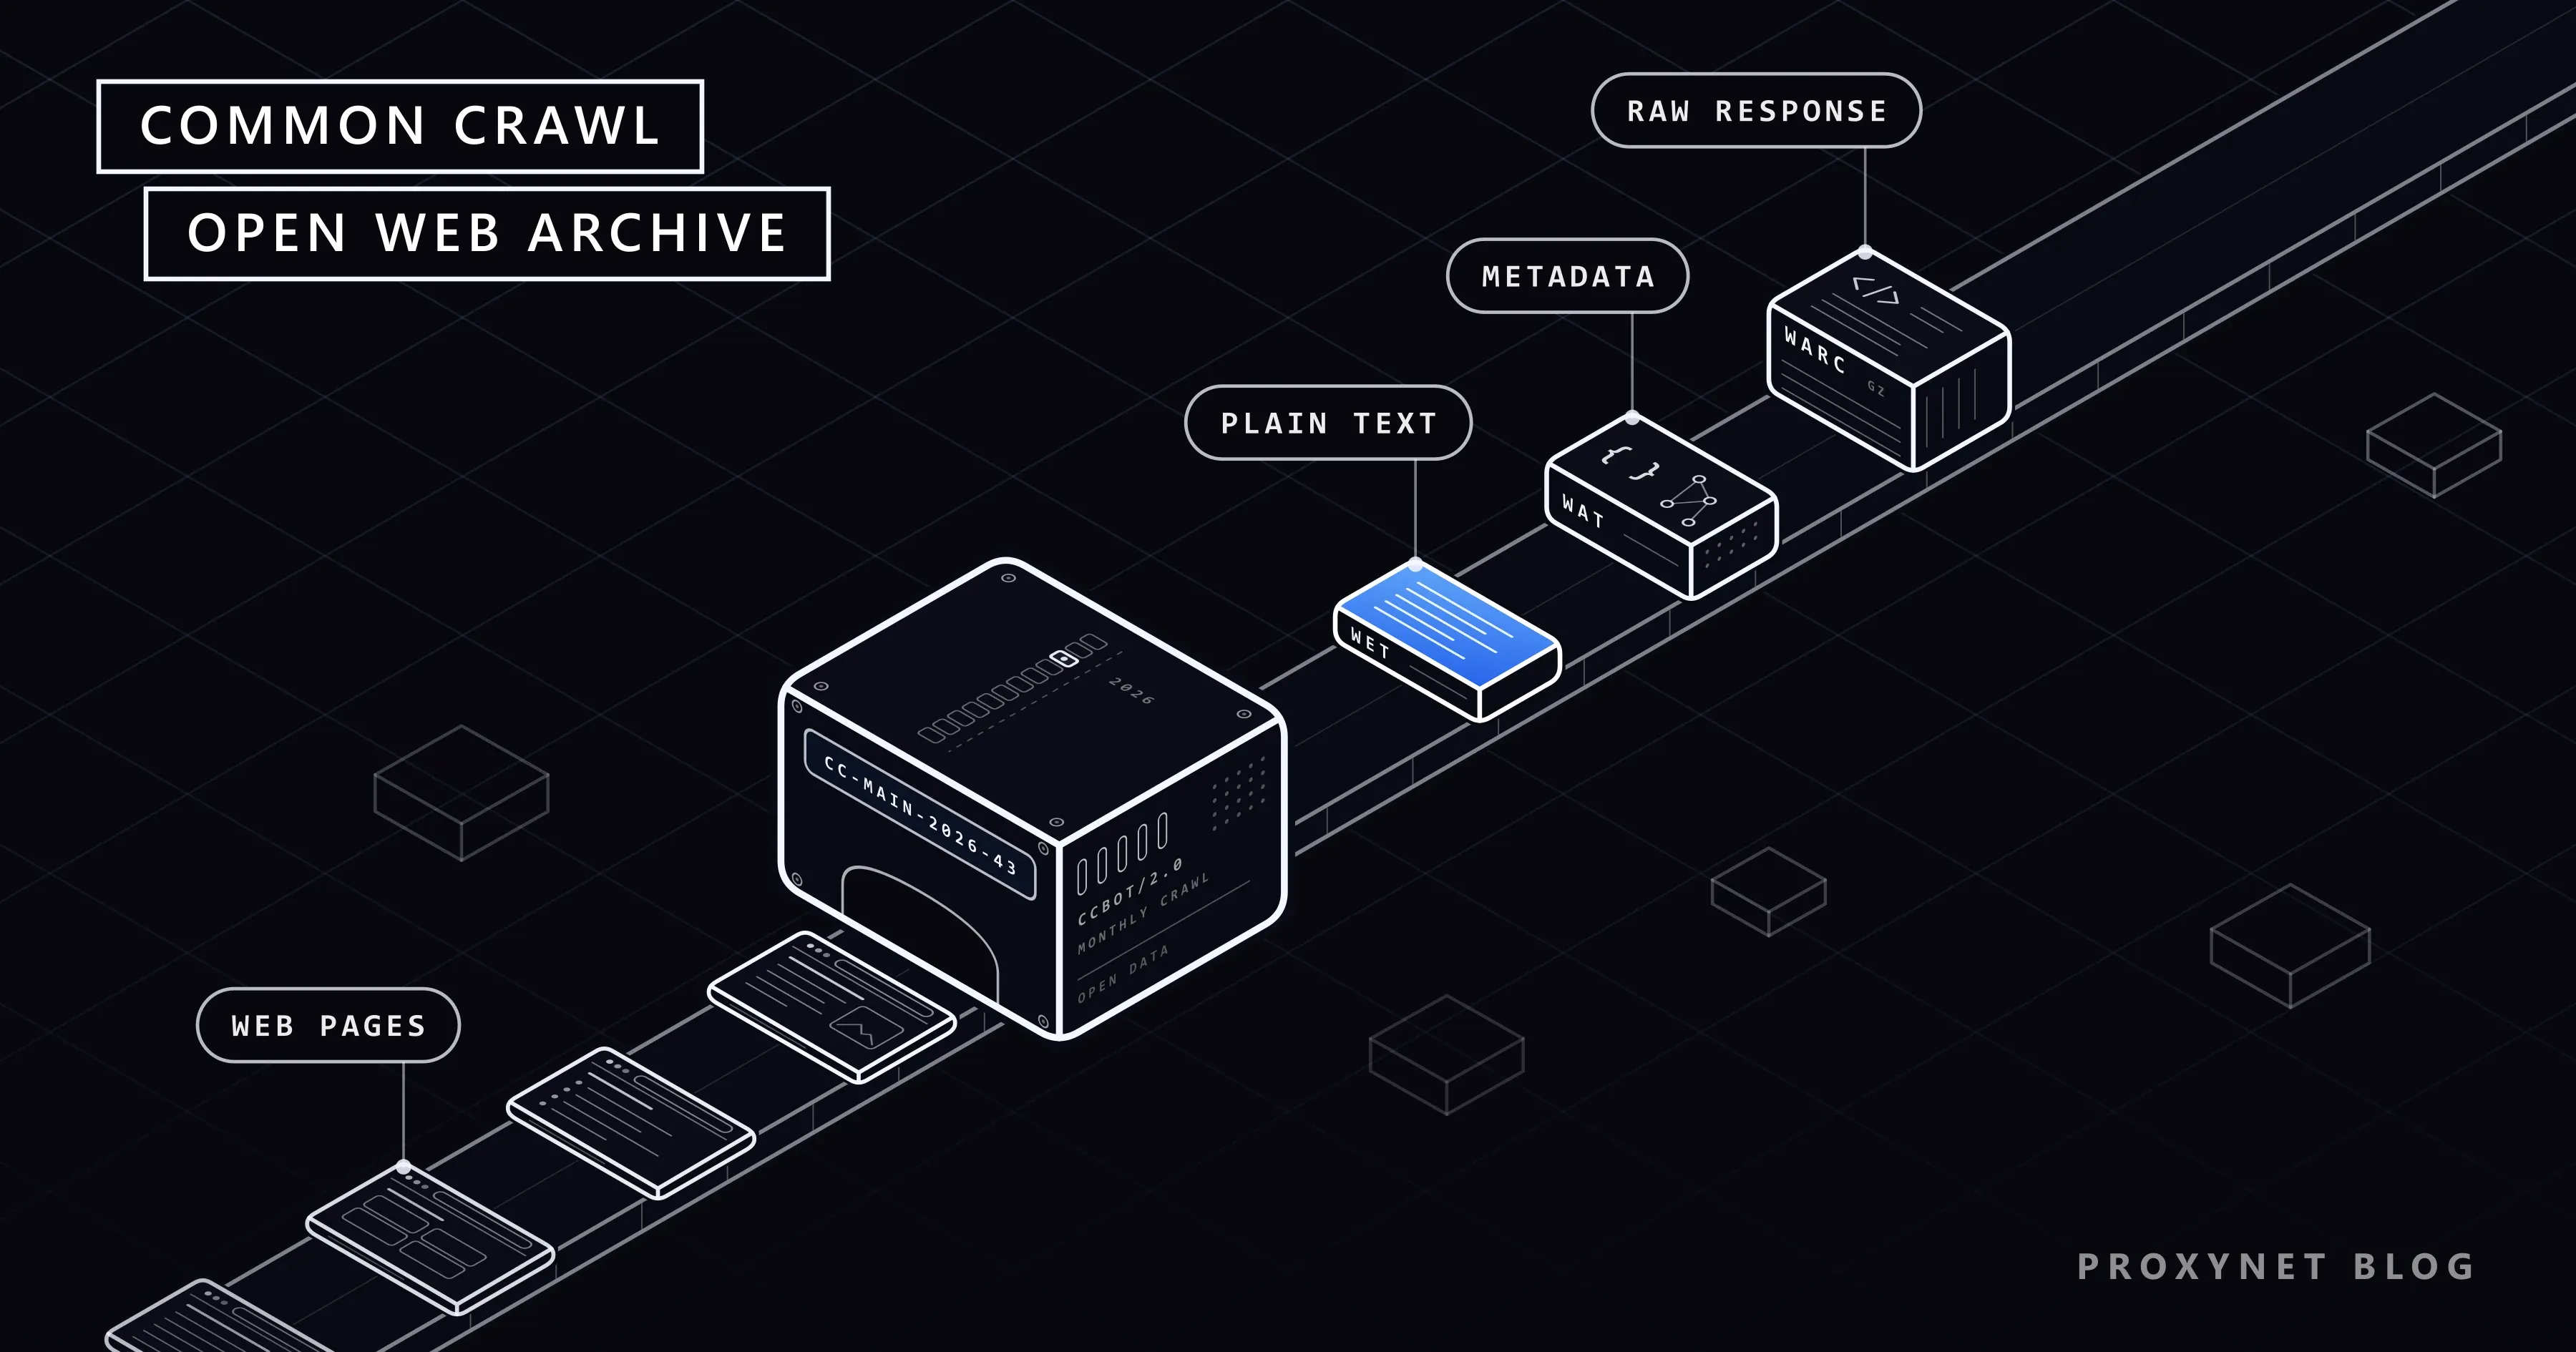
Her tarama, üç ayrı biçimdeki dosyalarla ve belirli bir sayfanın nerede saklandığını gösteren dizinlerle birlikte yayımlanır.
- WARC (Web ARChive) ham kayıttır: her sayfa için CCBot'un gönderdiği HTTP isteği ve sunucunun başlıklar ve HTML dahil eksiksiz yanıtı.
- WAT dosyaları her WARC kaydından hesaplanan meta veriyi JSON olarak tutar: yanıt başlıkları, sayfada bulunan linkler ve diğer ayrıntılar.
- WET (WARC Encapsulated Text) dosyaları yalnızca her sayfadan çıkarılmış düz metni içerir.
- URL dizini "bu adres yakalandı mı, nerede duruyor?" sorusunu cevaplar. Sorgu sonucunda yakalama zamanı, HTTP durum kodu ve kaydın hangi dosyada, hangi konumda (offset) ve ne uzunlukta durduğu döner. Dizinin ikinci biçimi olan Parquet formatındaki URL Index, milyonlarca satırı veritabanı araçlarıyla süzmeye uygundur.
robots.txt dosyaları ve 200 dışındaki yanıtlar, yani yönlendirmeler ve hatalar, ayrı setler olarak yayımlanır. Ekim 2026 taramasının ana parçaları, Common Crawl'un duyurusundaki sıkıştırılmış boyutlarla şöyle:
| Dosya | Ne tutar? | Boyut (sıkıştırılmış) | Tipik kullanım |
|---|---|---|---|
| WARC | İstekler, yanıtlar, ham HTML | 86,19 TiB | Sayfaları kendi yönteminizle yeniden okumak |
| WAT | JSON olarak başlıklar ve linkler | 14,06 TiB | Link grafları, site araştırması |
| WET | Çıkarılmış düz metin | 5,85 TiB | Dil verisi, metin analizi |
| URL dizini | Yakalanan adresler ve konumları | 0,43 TiB | İndirmeden önce sayfa bulmak |
Bir tebibayt (TiB) yaklaşık 1,1 terabayttır. Metin, ham arşivin yaklaşık on beşte biri kadardır. Bu yüzden yalnız metne ihtiyaç duyan bir ekip WET dosyalarından, sayfa yapısına ya da daha iyi bir metin çıkarıcıya ihtiyaç duyan bir ekip WARC dosyalarından başlar.
CCBot sayfaları nasıl toplar?
Common Crawl'un tarayıcısı CCBot önce robots.txt dosyasını okur, düz HTML getirir ve sunucu zorlandığında yavaşlar. Aşağıdaki ayrıntılar Common Crawl'un 17 Kasım 2026'da okuduğumuz SSS sayfasından geliyor.
- robots.txt dosyasını kontrol eder. Dosya CCBot'a izin vermiyorsa sayfa getirilmez; Common Crawl dosyayı zaman zaman yeniden kontrol eder.
- Kendini tanıtır. İstekler
CCBot/2.0 (https://commoncrawl.org/faq/)user agent bilgisini taşır ve SSS'de listelenen birkaç özel IP aralığından gelir. Gerçek bir CCBot IPv4 adresinde ters DNS (reverse DNS) sorgusucrawl.commoncrawl.orgile biten bir ad döndürür; bu da onu yalnızca adını ödünç alan botlardan ayırır. - Sayfaları linkler ve site haritaları üzerinden bulur. CCBot başka sitelerdeki linkleri izler; bu yüzden sizin hiç link vermediğiniz sayfalara da ulaşabilir. robots.txt içinde belirtilen site haritalarını da okur.
nofollowlinklere uyar. - HTML'i betik çalıştırmadan getirir. JavaScript çalıştırılmaz, çerez kullanılmaz: içeriği ziyaretçinin web tarayıcısında oluşturulan bir sayfa arşivde neredeyse boş görünebilir.
- Hızını ayarlar. Aynı siteye gönderdiği istekler arasında birkaç saniye bekler, 429 (çok fazla istek) ve 5xx hatalarında yavaşlar ve
Crawl-delaysatırına uyar. - Örneklem alır. Common Crawl siteleri bütünüyle arşivlemez; her sitenin sayfalarından rastgele seçilmiş bir alt küme saklar.
- Yayımlar. Yakalanan sayfalar WARC dosyalarına yazılır; WAT, WET ve dizinler bunlardan türetilir, tarama da
CC-MAIN-2026-43gibi bir kimlikle yayımlanır.
Common Crawl ne kadar büyük, ne sıklıkla güncellenir?
Common Crawl her ay yeni bir tarama yayımlar; 2025'te ve 2026'da her ay için bir tarama çıktı. Resmî tarama listesi https://index.commoncrawl.org/collinfo.json adresindeki bir JSON dosyasıdır. Bu dosyayı 17 Kasım 2026'da saat 02.02'de (UTC) bir kez okuduk; ilk iki kaydı, hiç değiştirmeden:
[
  {
    "id": "CC-MAIN-2026-43",
    "name": "October 2026 Index",
    "timegate": "https://index.commoncrawl.org/CC-MAIN-2026-43/",
    "cdx-api": "https://index.commoncrawl.org/CC-MAIN-2026-43-index",
    "from": "2026-10-05T10:56:23",
    "to": "2026-10-18T05:34:47"
  },
  {
    "id": "CC-MAIN-2026-39",
    "name": "September 2026 Index",
    "timegate": "https://index.commoncrawl.org/CC-MAIN-2026-39/",
    "cdx-api": "https://index.commoncrawl.org/CC-MAIN-2026-39-index",
    "from": "2026-09-04T13:16:03",
    "to": "2026-09-17T05:59:21"
  },
Listede 129 kayıt vardı. En yenisi olan CC-MAIN-2026-43, 5-18 Ekim 2026 arasında taranmış; en eskisi 2008-2009 dönemini kapsıyor ve WARC'tan önce kullanılan ARC biçiminde. Her kayıtta o taramanın dizinine giden bir cdx-api adresi var. Tarihler de ritmi gösteriyor: yaklaşık iki haftalık tarama, ardından bir sonraki aya kadar ara.
Common Crawl'un 21 Ekim'de yayımlanan Ekim 2026 tarama duyurusu taramanın boyutunu veriyor: 41,4 milyon host ve 34,3 milyon kayıtlı alan adından 2,16 milyar sayfa, sıkıştırılmamış hâliyle 371,19 TiB. Bu sayfaların 830,1 milyonu daha önceki hiçbir taramanın ziyaret etmediği adreslerdeydi; geri kalanı ise araştırmacılara aynı URL'yi aydan aya karşılaştırma imkânı veriyor.
Ayrı bir haber veri seti olan CC-NEWS ise haber sitelerindeki yazıları aylık yayını beklemeden, yakalandıktan kısa süre sonra yayımlamak için 2016'da başlatıldı.
Common Crawl'u kimler kullanır?
Common Crawl'u daha çok, web sayfalarına toplu hâlde ihtiyaç duyan ama milyarlarca sayfayı kendi başına tarayamayanlar kullanır:
- Dil modeli eğitimi. Büyük dil modeli (LLM), metni tahmin ederek öğrenir ve yüz milyarlarca sözcüğe ihtiyaç duyar; Common Crawl bunun en büyük ücretsiz kaynağıdır.
- Akademik araştırma. Dilbilimciler ve web araştırmacıları web'in yapısını, hangi dilleri kullandığını ve sayfaların nasıl değiştiğini inceler.
- SEO ve link analizi. WAT dosyaları her sayfadaki linkleri listeler. Common Crawl bunlardan host ve alan adı düzeyinde, harmonic centrality ve PageRank gibi sıralama puanları içeren web grafları (sitelerin birbirine verdiği linklerin haritası) üretir; Mayıs-Temmuz 2026 host grafında 240,4 milyon düğüm ve 3,7 milyar kenar vardı.
En iyi belgelenmiş kullanım model makalelerindedir. OpenAI'ın GPT-3 makalesi, 2016-2019 arasını kapsayan, her biri bir aya ait 41 Common Crawl parçasını anlatıyor: filtrelemeden önce 45 TB sıkıştırılmış düz metin, filtrelemeden sonra 570 GB; bu veri eğitim karışımının %60'ını oluşturuyor. Yazarlar daha kaliteli metne benzeyen sayfaları tutmuş ve birbirine çok benzeyen belgeleri ayıklamış.
Google'ın T5 makalesi ise Colossal Clean Crawled Corpus'u, kısaca C4'ü, Common Crawl'un tek bir ayından, Nisan 2019 taramasından üretmiş; temizlikten sonra yaklaşık 750 GB İngilizce metin kalmış. C4 gibi temizlenmiş setler, ekiplerin ham bir taramayı kendileri işlemeden Common Crawl metnini kullanmasını sağlar.
Eğitim ile bugüne dair soruları cevaplamak ayrı işlerdir. 2019 anlık görüntüsüyle eğitilmiş bir model daha yenisini bilmez; bu yüzden birçok yapay zekâ aracı, soru sorulduğu anda güncel sayfaları getirir. Bu yönteme RAG (retrieval-augmented generation, getirmeyle zenginleştirilmiş üretim) denir; o sayfaların nasıl temiz metne dönüştürüldüğünü RAG rehberimizde anlattık.
Common Crawl'un sınırları nelerdir?
Common Crawl, herkese açık web'den ayda bir kez ve tek bir yerden alınan büyük bir örneklemdir; bu tanımın her parçası bir sınır getirir.
- Web'in kendisi değil, örneklem. Her site, sayfalarının rastgele bir alt kümesiyle temsil edilir. CCBot'u engelleyen siteler taramada yer almaz, giriş gerektiren sayfalar hiç getirilmez, JavaScript ile oluşturulan içerik ise cılız kalır.
- Canlı veri değil, anlık görüntü. Dün değişen bir sayfa bir sonraki taramaya kadar eski hâliyle görünür ya da hiç görünmez. İki tarama arasında olanlar ana veri setinde yer almaz.
- Dengesiz dil dağılımı. Common Crawl her sayfanın dilini açık kaynaklı bir dil tanıma aracı olan CLD2 ile belirler. Ekim 2026 taramasının dil istatistiklerine göre sayfaların %42,56'sı İngilizce, ardından Rusça (%6,30) ve Almanca (%5,77) geliyor; Türkçenin payı %1,14.
- Gürültü ve yinelenen içerik. T5 yazarları, Common Crawl'dan çıkarılan metnin çoğunun doğal dil olmadığını yazıyor: menüler, hata mesajları ve tekrar eden metinler. Ciddi her kullanım önce filtreleme ve tekilleştirme yapar.
- Tek bir bakış açısı. CCBot birkaç IP aralığından çalışır. Fiyatı, dili ya da içeriği ziyaretçinin konumuna göre değiştiren bir site, CCBot'a o adreslere yönelik sürümü gösterir.
Common Crawl verisini kullanmak serbest mi?
Common Crawl verisini indirmek ücretsizdir ama içindeki sayfalar hâlâ onları yayımlayanlara aittir. Kullanım şartları (son güncelleme 7 Mart 2024), taranan içeriğin sahibinin Common Crawl olmadığını, kullanıcıların üçüncü kişilerin telif haklarına saygı göstermesi gerektiğini ve kullanımlarının riskini kendilerinin taşıdığını söylüyor. Şartlar yapay zekâ eğitimini yasaklamıyor; ancak bundan doğacak taleplere karşı Common Crawl'u tazmin etmeyi kullanıcıya yüklüyor.
Taranmış sayfalarla yapay zekâ eğitmek tartışmalı bir konu. Nisan 2026'da ABD'li yayıncıların birliği News/Media Alliance, Common Crawl'a bir mektup göndererek yayıncıların içeriğini talep üzerine kaldırmasını ve şartlarına yapay zekâ kullanımını yasaklayan bir madde eklemesini istedi. Kopyalanmış sayfalarla eğitimin hukuka uygun olup olmadığı mahkemelerde ve yasama süreçlerinde hâlâ tartışılıyor ve cevap ülkeden ülkeye değişiyor; ticari bir proje için kendi pazarınızdaki bir hukukçuya danışın.
Sayfalarda ad ve e-posta adresi gibi kişisel veriler de bulunabilir. Bu verilerin işlenmesi, sayfayı ilk kim toplamış olursa olsun, Türkiye'de KVKK ve AB'de GDPR gibi kişisel verilerin korunması yasalarına tabidir.
Site sahipleri Common Crawl taramasının dışında nasıl kalır?
CCBot'u sitenizden uzak tutmak için robots.txt dosyanıza ona özel bir grup ekleyin. Common Crawl'un SSS sayfası şu iki satırı veriyor:
User-agent: CCBot
Disallow: /
Engellemek yerine yavaşlatmak istiyorsanız istekler arasına saniye cinsinden bir bekleme süresi koyun:
User-agent: CCBot
Crawl-delay: 2
Grupların ve kuralların nasıl okunduğunu robots.txt rehberimizde anlattık. CCBot'u engellemek GPTBot'u, ClaudeBot'u ya da başka bir botu durdurmaz; her biri için ayrı bir grup gerekir.
robots.txt kuralı sonraki ziyaretler için geçerlidir; kuralı eklemeden önce yakalanan sayfalar zaten yayımlanmış taramaların içindedir. Hukuki kaldırma talepleri için Common Crawl, Opt-Out Ledger adlı herkese açık bir liste tutuyor.
Common Crawl, Wayback Machine ve kendi taramanız
Common Crawl, Wayback Machine ve sizin kendi taramanız web sayfalarının kopyalarını saklar ama farklı sorulara cevap verir.
| Common Crawl | Wayback Machine | Kendi taramanız | |
|---|---|---|---|
| Ne için? | Programlarla toplu analiz | Eski sayfaları görüntülemek | Size özgü soru |
| Nasıl kullanılır? | Dosya indirme, dizin sorgusu | Adres girip tarih seçme | Seçtiğiniz sayfaları toplama |
| Güncellik | Aylık anlık görüntüler | Sayfanın kaydedildiği an | Planladığınız sıklıkta |
| Kapsam | Birçok siteden örneklem | Kaydedilmiş sayfalar | Yalnız hedef siteleriniz |
| Maliyet | Veri ücretsiz, işlem sizden | Göz atmak ücretsiz | Kurulum ve bakım sizden |
Internet Archive'ın işlettiği Wayback Machine insanlar için yapılmıştır: bir adres yazarsınız, takvimden bir kayıt seçersiniz ve sayfanın o günkü hâlini görürsünüz. Herkes Save Page Now ile tek bir sayfanın kaydedilmesini de isteyebilir. Bu tarafı Wayback Machine rehberimizde ele aldık. Common Crawl'un böyle bir görüntüleyicisi yoktur; dosyaları milyonlarca sayfayı aynı anda okuyan kodlar için hazırlanır.
Common Crawl neden güncel ve yerel veri veremez?
Common Crawl size bir ürünün bugün Madrid'deki fiyatını ya da bir sayfanın Seul'deki ziyaretçilere nasıl göründüğünü gösteremez, çünkü ayda bir kez ve birkaç IP aralığından taranır. Bu tür veri, sizin sorunuz için, doğru zamanda ve doğru yerden toplanmalıdır.
Fiyat takip eden ya da yerelleştirilmiş sayfaları kontrol eden ekipler bu herkese açık sayfaları kendileri toplar: belirli aralıklarla, makul bir hızla, robots.txt ve sitenin şartları içinde kalarak. Bir sayfayı belirli bir ülke ya da şehirdeki ziyaretçinin gördüğü gibi görmek için isteğin oradan gelmesi gerekir; ülke ve şehir hedeflemeli bir Residential Proxy isteği o konumdaki bir ev bağlantısı üzerinden gönderir.
Proxy'lerin böyle bir tarayıcıda nerede durduğunu web crawler çözüm sayfamızda anlattık. Common Crawl'un kendisi ise proxy kullanılacak bir yer değildir: SSS sayfası, dizinin proxy ağları üzerinden sorgulanmamasını, isteklerin tek tek ve açık bir user agent ile gönderilmesini ve 503 hatası alındığında yavaşlanmasını istiyor.
Sık yapılan hatalar
- Common Crawl'u web'in tamamı sanmak. Common Crawl bir örneklemdir; bir sayfanın taramada olmaması o sayfa hakkında hiçbir şey kanıtlamaz.
- Ham WET metniyle eğitim yapmak. Bu metnin çoğu menü, bildirim ve tekrardır; önce filtreleyin ve tekilleştirin.
- Dizin sunucusuna art arda istek göndermek. Sunucuda sıkı bir hız sınırı vardır ve kısa sürede çok fazla istek gönderen bir IP 24 saat engellenebilir. Geniş çaplı süzme için Parquet formatındaki URL Index'i Amazon Athena ya da Apache Spark gibi bir araçla kullanın.
- robots.txt'nin eski taramaları temizlemesini beklemek. Yeni kural yalnızca sonraki ziyaretleri etkiler.
Karar rehberi
| İhtiyacınız | En uygun seçenek |
|---|---|
| Araştırma ya da model eğitimi için geniş web metni | WET dosyaları ya da C4 gibi filtrelenmiş bir set |
| Bir sayfanın geçmişteki bir tarihte nasıl göründüğü | Wayback Machine |
| Hangi sitenin hangisine link verdiği | WAT dosyaları ya da Common Crawl'un web grafları |
| Sitenizin Common Crawl'da olup olmadığı | URL dizininde yavaş bir sorgu |
| Sitenizi sonraki taramaların dışında tutmak | robots.txt'de bir CCBot grubu |
| Bugünkü fiyatlar ya da bir ülkeden görünen sayfalar | Makul hızda kendi taramanız ya da yönetilen bir hizmet |
Sıkça sorulan sorular
Common Crawl ücretsiz mi?
Evet. Veriyi herkes HTTPS üzerinden ya da Amazon S3'ten Common Crawl'a ücret ödemeden indirebilir; yalnızca kendi depolama ve işlem maliyetinizi ödersiniz. Common Crawl verinin saklandığı AWS bölgesi olan us-east-1'de işlenmesini öneriyor. Sayfaların telif hakkı ise sahiplerinde kalır.
Common Crawl robots.txt kurallarına uyar mı?
Evet. CCBot bir sayfayı getirmeden önce robots.txt dosyasını okur, CCBot için yasaklanan yolları atlar, Crawl-delay satırına ve nofollow linklere uyar. SSS sayfası IP aralıklarını listelediği için kendini CCBot diye tanıtan bir ziyaretçinin gerçek olup olmadığını kontrol edebilirsiniz.
Common Crawl görselleri de içerir mi?
Pratikte hayır. Ekim 2026 taramasında yakalanan kayıtların %98,31'i HTML sayfası, %1,00'ı PDF dosyasıydı; görsellerin payı ise yalnızca %0,001 civarındaydı. HTML içinde görsellerin adresleri durur ama görsel dosyalarının kendisi taramada yer almaz.
Common Crawl ile C4 arasındaki fark nedir?
Common Crawl ham aylık taramadır. C4 ise Google araştırmacılarının bu taramanın tek bir ayından, Nisan 2019'dan ürettiği temizlenmiş bir İngilizce veri setidir; kalıp metin satırları, çok kısa sayfalar, kod, saldırgan sözcükler ve tekrar eden metinler çıkarıldıktan sonra geriye yaklaşık 750 GB kalmıştır.
Common Crawl'da arama motoru gibi arama yapılabilir mi?
Hayır. Tam metin arama ve sıralama yoktur; dizin yalnızca adrese ya da adres kalıbına göre kayıt bulur. Metin içinde arama yapmak için WET dosyalarını kendi araçlarınızla işlemeniz gerekir.
Sitemin Common Crawl'da olup olmadığını nasıl anlarım?
index.commoncrawl.org adresini açın, bir tarama seçin ve alan adınızı example.com/* gibi bir joker karakterle arayın. Sonuçlar yakalanan her URL'yi yakalama zamanı ve HTTP durum koduyla listeler. Sunucuda hız sınırı olduğu için sorguları tek tek gönderin.
Özet
Common Crawl, herkese açık web'den alınmış büyük bir örneklemin ücretsiz ve açık kopyasıdır: CCBot tarafından yaklaşık ayda bir yakalanır ve ham sayfalar (WARC), meta veri (WAT), düz metin (WET) ve URL dizinleri olarak yayımlanır. Yapay zekâ eğitiminin ve web araştırmalarının önemli bir kısmının arkasında durur; ama tek bir bakış açısından alınmış dönemsel bir örneklemdir, ciddi filtreleme ister ve içindeki sayfalar telif haklarını korur. Site sahipleri CCBot'u robots.txt ile yönetir. Veriniz güncel ya da yerel olmak zorundaysa onu makul bir hızla kendiniz toplayın ya da yönetilen sayfa çıkarma hizmetimiz için satış ekibimizle görüşün.