Ihr Skript zur Preisprüfung läuft auf Ihrem Laptop. Sie verschieben es auf einen Server, schicken es über einen Proxy, und nach einer halben Minute steht im Log TimeoutError: page.goto: Timeout 30000ms exceeded. Beim nächsten Lauf öffnet sich die Seite, und das Skript bricht eine Zeile später mit locator.click: Timeout 30000ms exceeded. ab. Sie ändern die Zahl auf 60000, und jetzt scheitert das Skript nach einer vollen Minute, denn die Zahl war nie das Problem.
Dieser Leitfaden behandelt die vier Arten von Timeouts, das Call Log, waitUntil, die Stellen, an denen Sie Limits setzen, langsame Proxys und Sperrseiten, die als „Element nicht gefunden“ enden, danach ein getestetes Skript mit Wiederholungen in Python und Node.js und das Gegenstück in Puppeteer. Jede Meldung unten stammt aus unseren Läufen mit Playwright 1.63 und Puppeteer 25.12 gegen eine lokale Testseite und einen Test-Proxy.
Was bedeutet „Timeout 30000ms exceeded“ in Playwright?
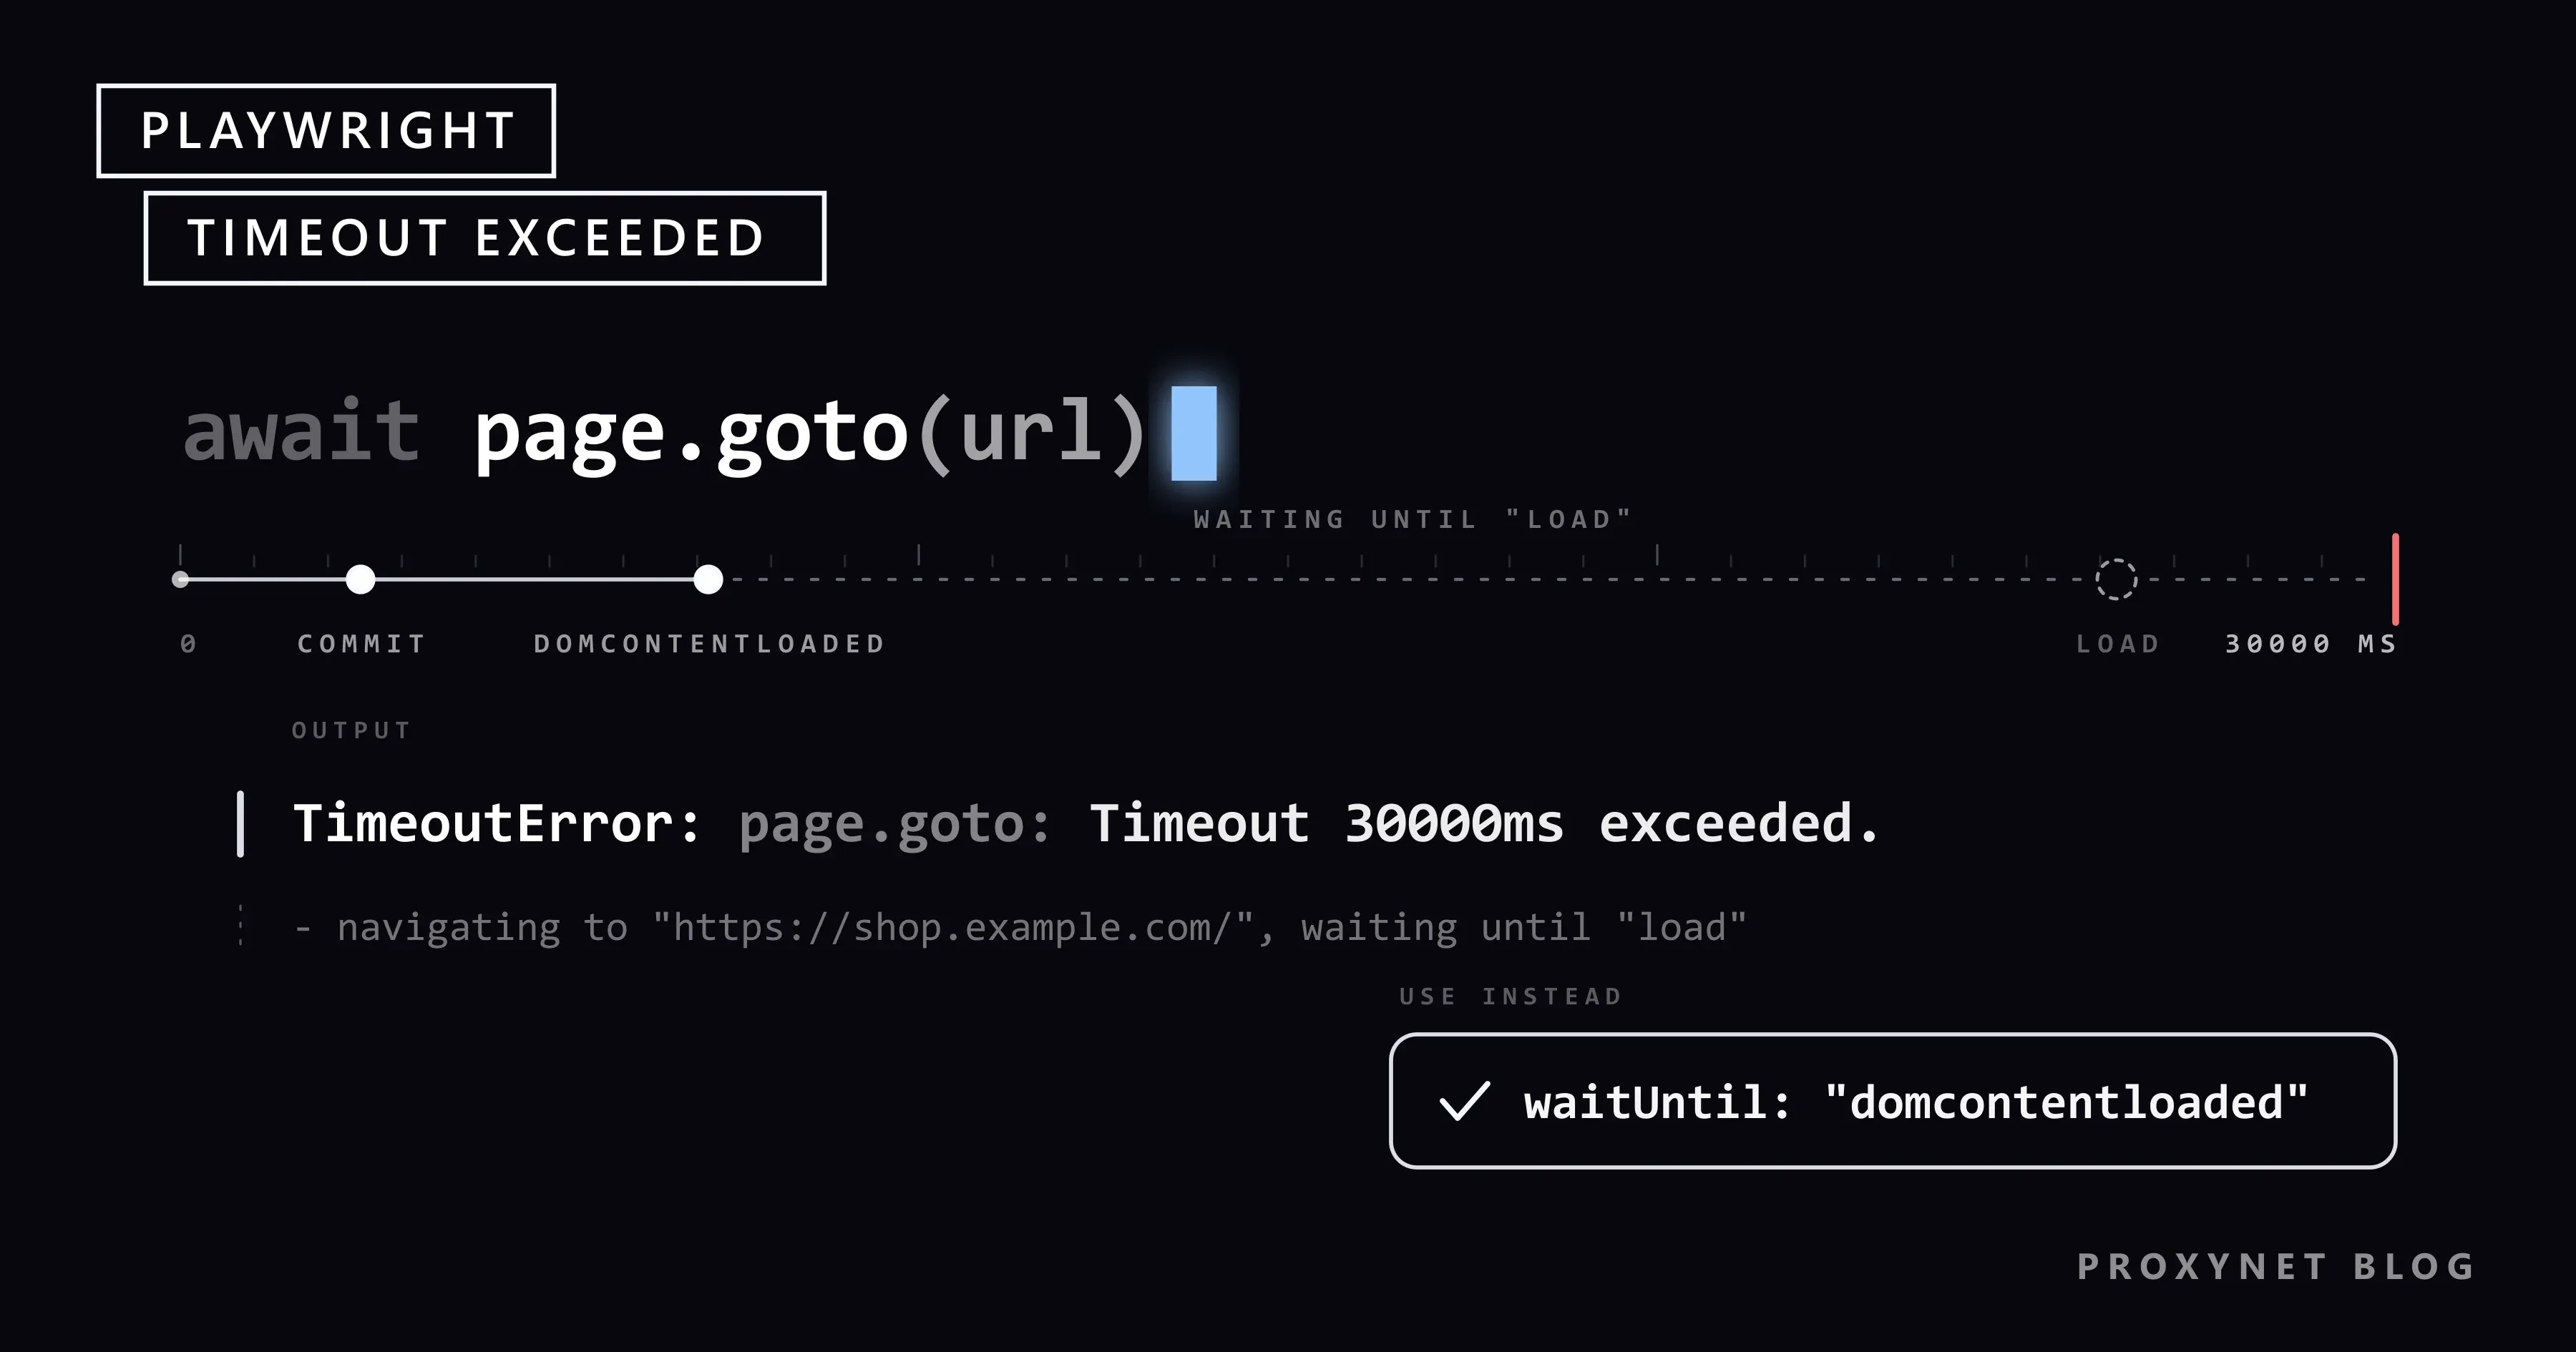
Playwright wartet von selbst: page.goto(), bis die Seite einen Ladezustand erreicht, jede Locator-Aktion, bis das Element existiert und die Aktion annehmen kann. Erreicht eine Wartezeit ihr Limit, löst Playwright einen TimeoutError aus. In der Bibliothek liegt dieses Limit bei 30.000 ms, also 30 Sekunden; unsere Läufe in Python und Node.js stoppten beide bei genau 30,0 Sekunden.
Die Meldung nennt die Methode, die gewartet hat, das Limit und in einem Call Log, was Playwright gerade tat. Diese hier kam von einer Testseite, deren Server nie antwortete:
TimeoutError: page.goto: Timeout 30000ms exceeded.
Call log:
  - navigating to "http://127.0.0.1:8090/slow", waiting until "load"
Python schreibt Page.goto und Locator.click mit großem Anfangsbuchstaben, Node.js page.goto und locator.click. Importieren Sie die Klasse in Python unter einem anderen Namen, denn TimeoutError aus playwright.sync_api würde den eingebauten TimeoutError von Python verdecken. In Node.js ist es errors.TimeoutError aus dem Paket playwright.
Welches Timeout ist abgelaufen? Die vier Arten
Die Bibliothek, mit der Scraper arbeiten, gibt Navigationen und Aktionen jeweils 30 Sekunden. Der Test-Runner Playwright Test gibt ihnen kein eigenes Limit, dafür dem ganzen Test 30 Sekunden, wie die Playwright-Dokumentation zu Timeouts aufführt; deshalb nennt die JavaScript-API-Referenz für goto den Standardwert 0.
| Meldung beginnt mit | Art | Standardwert | Ändern mit |
|---|---|---|---|
page.goto: Timeout … | Navigation | 30 s (Bibliothek), keiner (Test) | timeout im Aufruf, set_default_navigation_timeout(), navigationTimeout |
locator.click: Timeout … | Aktion oder Locator | 30 s (Bibliothek), keiner (Test) | timeout im Aufruf, set_default_timeout(), actionTimeout |
expect(locator)… failed mit Timeout: 5000ms | Assertion | 5 s | expect: { timeout }, in Python expect.set_options(timeout=…) |
Test timeout of 30000ms exceeded. | Ganzer Test (Playwright Test) | 30 s | timeout in der Konfiguration, test.setTimeout(), test.slow() |
Zwei Details aus unseren Läufen. In Python löst ein fehlgeschlagenes expect() einen gewöhnlichen AssertionError aus, den except PlaywrightTimeoutError nicht abfängt. Und wenn das Test-Timeout während page.goto zuschlägt, setzt Playwright Test page.goto: net::ERR_ABORTED; maybe frame was detached? unter die Timeout-Zeile. Das ist kein Netzwerkfehler: Der Runner hat die Seite unter dem noch wartenden Aufruf geschlossen.
Wie lesen Sie das Call Log?
Das Call Log, das Aufrufprotokoll unter der Fehlerzeile, ist der nützlichste Teil der Meldung. Hier ein Klick auf einen Button, den ein Cookie-Banner verdeckt, gekürzt aus unserem Lauf:
Locator.click: Timeout 5000ms exceeded.
Call log:
  - waiting for locator("#buy")
    - locator resolved to <button id="buy">Add to cart</button>
  - attempting click action
    2 × waiting for element to be visible, enabled and stable
      - element is visible, enabled and stable
      - scrolling into view if needed
      - done scrolling
      - <div id="cookie-banner">We use cookies</div> intercepts pointer events
    - retrying click action
Lesen Sie es in vier Schritten:
- Die Methode in der ersten Zeile benennt das Warten:
goto,click,fill,textContent. - Der letzte Schritt im Log zeigt, wo es stehen blieb.
waiting for locator("#price")ohne etwas darunter bedeutet, dass nichts gepasst hat;locator resolved to …bedeutet, dass das Element gefunden wurde, die Aktion aber nicht ausgeführt werden konnte. - Die Zeile mit dem Grund, falls vorhanden:
intercepts pointer events(etwas liegt darüber),element is not visible,element is not enabled. - Die vergangene Zeit. Ein Fehler genau bei Ihrem Limit ist ein echtes Warten. Ein früherer Fehler wie
net::ERR_PROXY_CONNECTION_FAILEDist ein anderes Problem; das behandelt Was ist Playwright und wie nutzt man es mit Proxy?.
Navigations-Timeouts: page.goto und waitUntil
page.goto() wartet auf ein Lifecycle-Ereignis, das Sie mit waitUntil (in Python wait_until) wählen:
commit: Die Antwort ist angekommen, und das Dokument hat zu laden begonnen.domcontentloaded: Das HTML ist geparst; Bilder, Fonts und iframes laden womöglich noch.load(Standard): Die Seite und die Ressourcen, die sie nachzieht, Bilder und Stylesheets eingeschlossen, sind fertig geladen.networkidle: mindestens 500 ms lang keine Netzwerkverbindungen. Die Referenz zu page.goto kennzeichnet es als „discouraged“ (nicht empfohlen) und rät, sich stattdessen auf Assertions zu verlassen.
Der Standardwert load verursacht viele Navigations-Timeouts: Ein langsames Bild, ein Tracking-Pixel oder ein Widget verhindert, dass das Ereignis eintritt, während der gesuchte Text längst auf der Seite steht. Auf unserer Testseite stand der Preis im HTML, und ein Bild wurde nie fertig. Mit load lief goto nach 10 Sekunden in ein Timeout; mit domcontentloaded kehrte es nach 0,1 Sekunden zurück, und der Preis war lesbar. networkidle scheiterte an einer Seite, die alle 300 ms einen Endpunkt aufruft, wie es Chat-Widgets und Live-Preise tun.
Das Muster, das trägt: mit domcontentloaded navigieren und dann auf das eine Element warten, das Sie brauchen.
response = page.goto(url, wait_until="domcontentloaded")
price = page.locator("#price").inner_text() # wartet auf das Element, höchstens bis zum Aktions-Timeoutconst response = await page.goto(url, { waitUntil: "domcontentloaded" });
const price = await page.locator("#price").innerText();Läuft goto auch mit domcontentloaded in ein Timeout, kam schon das HTML zu spät an, und das ist eine Frage des Netzes (siehe den Abschnitt über Proxys). Stehen die Daten im HTML oder hinter einem JSON-Endpunkt, brauchen Sie womöglich gar keinen Browser; Statische und dynamische Seiten beim Web Scraping zeigt, wie Sie das prüfen.
Locator- und Aktions-Timeouts: automatisches Warten und was es blockiert
Vor einem Klick prüft Playwright, ob das Element sichtbar, stabil (nicht in Bewegung) und aktiviert ist und an dieser Stelle wirklich den Klick empfängt, und wiederholt die Prüfungen, bis das Limit abgelaufen ist. Ein Locator-Timeout geht auf eine kurze Liste von Ursachen zurück:
- Der Selektor passt auf nichts. Ein Tippfehler, ein Klassenname, der sich mit jedem Build ändert, oder ein Text, der je nach Sprache abweicht. Stabile Attribute (
id,data-*) oderget_by_role()halten länger. - Das Element erscheint zu spät. Ein Preis, der 12 Sekunden nach dem Laden gerendert wird, scheitert jedes Mal an einem Limit von 10 Sekunden.
- Etwas verdeckt es. Cookie-Banner und Modals zeigen sich als
intercepts pointer events. Schließen Sie das Overlay so, wie es ein Besucher täte;force=Trueüberspringt die Prüfung, und der Klick landet dort, wo kein Nutzer klicken könnte. - Es liegt in einem iframe.
page.locator("#price")schaut nicht in Frames; in unserem Test lief es in ein Timeout, währendpage.frame_locator("iframe").locator("#price")den Preis sofort lieferte. - Sie sind auf einer anderen Seite, als Sie denken. Eine Sperrseite oder eine Login-Schranke hat kein
#price(siehe unten).
page.wait_for_selector() funktioniert weiterhin, aber die API-Referenz von Playwright kennzeichnet es als „discouraged“ und empfiehlt Locators, die das Element bei jedem Versuch neu suchen und deshalb ein erneutes Rendern überstehen. Wie sich das von den expliziten Wartezeiten in Selenium unterscheidet, steht in Playwright oder Selenium: Welches Werkzeug passt?.
Timeouts bewusst setzen: pro Aufruf, pro Context, in der Konfiguration
Ein timeout, das einem einzelnen Aufruf übergeben wird, hat Vorrang vor allem anderen. Darunter haben Standardwerte der Seite Vorrang vor denen des Contexts, und ein Navigations-Standardwert hat Vorrang vor dem allgemeinen. Setzen Sie die Standardwerte in Python auf den Context, damit jede Seite darin sie erbt:
context = browser.new_context()
context.set_default_navigation_timeout(15_000)  # goto, reload, wait_for_url
context.set_default_timeout(10_000)             # Locators, Klicks, Wartevorgänge
page = context.new_page()
page.goto(slow_report_url, timeout=45_000)      # eine bekannt langsame Seite bekommt mehr
In Playwright Test stehen die Limits in der Konfiguration. Mit dieser Konfiguration scheiterte in unserem Lauf ein fehlendes Element mit locator.click: Timeout 10000ms exceeded. und eine Seite, die nie antwortete, mit page.goto: Timeout 15000ms exceeded.:
import { defineConfig } from "@playwright/test";

export default defineConfig({
  timeout: 60_000,              // ganzer Test, einschließlich Hooks und Fixtures
  expect: { timeout: 10_000 },  // jede expect(...)-Assertion
  use: {
    actionTimeout: 10_000,      // click, fill, textContent ...
    navigationTimeout: 15_000,  // goto, reload, waitForURL ...
  },
});
test.slow() verdreifacht das Limit für einen langsamen Test. Vermeiden Sie timeout=0 im Produktivbetrieb: Eine Seite, die nie antwortet, hält dann einen Context für immer fest. Zwei-Minuten-Limits überall sind kaum besser; eine Warteschlange mit hundert toten URLs braucht dann mehr als drei Stunden.
Langsame Proxys: erst messen, dann das Timeout setzen
Ein Proxy fügt jeder Anfrage eine Station hinzu, und ein Browser stellt pro Seite viele Anfragen. Residential-IPs laufen über Heimanschlüsse und bringen meist mehr Latenz mit als Datacenter-IPs; ein Limit, das an Ihrer Büroleitung nie greift, kann deshalb über eine weit entfernte Ausgangs-IP greifen. Messen Sie, bevor Sie eine Zahl wählen. Dieses Skript öffnet dieselbe Seite fünfmal in frischen Contexts, das Limit ist nur für die Messung abgeschaltet:
import statistics
import time

from playwright.sync_api import sync_playwright

PROXY = {"server": "http://pr.proxynet.io:8000", "username": "user", "password": "pass"}
URL = "https://shop.example.com/product/42"

with sync_playwright() as p:
    browser = p.chromium.launch(proxy=PROXY)
    times = []
    for _ in range(5):
        context = browser.new_context()  # frische Sitzung, kein Cache zwischen den Läufen
        page = context.new_page()
        start = time.monotonic()
        page.goto(URL, wait_until="domcontentloaded", timeout=0)  # kein Limit während der Messung
        page.locator("#price").wait_for(timeout=0)
        times.append(time.monotonic() - start)
        context.close()
    browser.close()

print("runs:", " ".join(f"{t:.2f}s" for t in times))
print(f"median {statistics.median(times):.2f}s, slowest {max(times):.2f}s")
Über unseren lokalen Test-Proxy, der jeder Anfrage 2 Sekunden hinzufügt, gab es aus:
runs: 3.42s 3.38s 3.37s 3.38s 3.38s
median 3.38s, slowest 3.42s
Legen Sie das Limit nach dem langsamsten Lauf fest, mit Luft nach oben; wir haben 15 Sekunden gewählt. Nehmen Sie bei einem echten Ziel mehr Stichproben und messen Sie erneut, wenn sich Land, Proxy-Typ oder Website ändern. Drei weitere Punkte:
- Weniger laden. Das Blockieren von Bildern, Medien und Fonts mit
page.route()senkt die Zahl der Anfragen pro Seite; den Code finden Sie in unserem Leitfaden zu Playwright mit Proxy. - Die Ausgangs-IP passend zur Aufgabe wählen. Mit einem Datacenter-Proxy sind die Ausgangs-IPs schneller, sofern das Ziel Datacenter-IPs akzeptiert. Wo eine Website Heim-IPs oder eine bestimmte Stadt braucht, nehmen Sie einen Residential-Proxy mit eigenem, gemessenem Limit.
- Die Zugangsdaten prüfen. Mit einem falschen Proxy-Passwort auf einer HTTPS-Seite meldete unser
requestfailed-Listener sofortnet::ERR_TUNNEL_CONNECTION_FAILED, aberpage.gotoscheiterte erst, als sein Limit von 10 Sekunden abgelaufen war. Ein Problem mit den Zugangsdaten kann wie ein langsamer Proxy aussehen; fügen Sie diesen Listener deshalb beim Debuggen hinzu:
page.on("requestfailed", lambda r: print("FAILED:", r.url, r.failure))Außerhalb des Browsers meldet Requests in Python Proxy-Fehler als „Max retries exceeded“; Max Retries Exceeded With URL: Bedeutung und Lösung erklärt, wie Sie diese Meldung lesen.
Wenn eine Sperrseite zu „Element nicht gefunden“ wird
Dieser Fall kostet die meiste Zeit. Die Website lehnt die Anfrage ab und liefert eine Sperrseite mit dem Status 403 oder 429. page.goto() löst bei HTTP-Fehlerstatus keine Ausnahme aus; unser goto kehrte mit einem 403 ganz normal zurück. Das Skript wartet dann das volle Limit auf ein Element ab, das die Sperrseite nie enthalten wird. Im Log steht ein Timeout; die eigentliche Antwort war eine Ablehnung.
Unsere Test-Sperrseite trug den Titel „Access denied“, und der Python-Fehler von expect() gab sogar ihren Accessibility-Snapshot mit heading "Access denied" darin aus. Schauen Sie hin, bevor Sie warten:
- Behalten Sie die Antwort, die
gotozurückgibt, und lesen Sie ihren Status. - Lesen Sie
page.title(); Sperr- und Challenge-Seiten haben eigene Titel. - Deutet eines von beiden auf eine Sperre hin, hören Sie auf: keine Wiederholung, kein Warten auf das Element.
- Finden Sie den Grund heraus: Ihre Anfragerate, die
robots.txtund die Nutzungsbedingungen der Website oder die Frage, ob sie eine API anbietet.
Eine Sperrseite zu wiederholen macht es schlimmer, und IPs zu wechseln, um an einer Ablehnung vorbeizukommen, ist keine Lösung: Die Website hat Nein gesagt. Ein 429 bedeutet zu viele Anfragen; drosseln Sie das Tempo und beachten Sie Retry-After (429 Too Many Requests: Was ist ein Rate-Limit-Fehler?). Warum Websites automatisierte Besucher markieren, steht in Bot-Erkennung: So funktionieren Anti-Bot-Systeme. Wege um diese Seiten herum behandeln wir nicht; was trägt, sind ein langsamerer Crawl, eine Erlaubnis oder die offizielle API (Web Scraping vs. API: Welche Methode sollten Sie nutzen?).
Vollständiges Beispiel: gemessene Timeouts, Sperrprüfung und Wiederholungen
Das Skript öffnet Produktseiten über einen Proxy. Jeder Versuch bekommt einen frischen Context mit bewusst gesetzten Limits. Es prüft Status und Titel, bevor es auf Inhalt wartet, stoppt bei einer Sperrseite und wiederholt nur Timeouts, mit exponentiell wachsender Wartezeit (Exponential Backoff) plus Zufallsanteil (Jitter), damit parallele Worker nicht im Gleichschritt wiederholen.
"""Produktseiten über einen Proxy öffnen, mit gemessenen Timeouts, Sperrprüfung und Wiederholungen."""
import random
import time

from playwright.sync_api import TimeoutError as PlaywrightTimeoutError
from playwright.sync_api import sync_playwright

PROXY = {"server": "http://pr.proxynet.io:8000", "username": "user", "password": "pass"}
URLS = [f"https://shop.example.com/product/{n}" for n in (42, 43, 44)]

NAV_TIMEOUT = 15_000     # ms: etwa das 4-Fache der langsamsten Seite, die wir über den Proxy gemessen haben
ACTION_TIMEOUT = 10_000  # ms: Locators, Klicks und Wartevorgänge
ATTEMPTS = 3
STOP_STATUS = {403, 429}  # Ablehnung oder Rate-Limit: eine Wiederholung macht es schlimmer
STOP_WORDS = ("access denied", "blocked", "captcha", "verify you are human")  # pro Website anpassen


class Blocked(Exception):
    """Die Website antwortete mit einer Sperr- oder Rate-Limit-Seite: stoppen und den Grund herausfinden."""


def fetch_price(browser, url):
    for attempt in range(1, ATTEMPTS + 1):
        context = browser.new_context()  # saubere Cookies und leerer Cache bei jedem Versuch
        context.set_default_navigation_timeout(NAV_TIMEOUT)
        context.set_default_timeout(ACTION_TIMEOUT)
        page = context.new_page()
        start = time.monotonic()
        try:
            response = page.goto(url, wait_until="domcontentloaded")
            status = response.status if response else None
            title = page.title()
            if status in STOP_STATUS or any(word in title.lower() for word in STOP_WORDS):
                raise Blocked(f"HTTP {status}, title {title!r}")
            return page.locator("#price").inner_text()  # wartet automatisch bis zu ACTION_TIMEOUT
        except PlaywrightTimeoutError as exc:
            print(f"  attempt {attempt}: {str(exc).splitlines()[0]} ({time.monotonic() - start:.1f}s)")
            if attempt == ATTEMPTS:
                raise
            time.sleep(2**attempt + random.random())  # 2-3 s, dann 4-5 s
        finally:
            context.close()


with sync_playwright() as p:
    browser = p.chromium.launch(proxy=PROXY)
    for url in URLS:
        print(url)
        try:
            print("  price:", fetch_price(browser, url))
        except Blocked as exc:
            print("  stopped, not retrying:", exc)
        except PlaywrightTimeoutError:
            print(f"  gave up after {ATTEMPTS} attempts")
    browser.close()
Wir haben es mit unserer lokalen Testseite (shop.test) als Host ausgeführt, über den Proxy, der jeder Anfrage 2 Sekunden hinzufügt; die dritte Seite war so eingestellt, dass sie bei ihren ersten beiden Anfragen hängen blieb:
http://shop.test/product/42
  price: $19.90
http://shop.test/product/43
  stopped, not retrying: HTTP 403, title 'Access denied'
http://shop.test/product/44
  attempt 1: Page.goto: Timeout 15000ms exceeded. (15.0s)
  attempt 2: Page.goto: Timeout 15000ms exceeded. (15.0s)
  price: $19.90
Die Sperrseite kostete eine Anfrage und keine Wartezeit; die hängende Seite kostete zwei Timeouts und klappte dann. Wiederholungen, die von Statuscodes gesteuert werden, etwa bei 503 mit Retry-After, gehören in eine eigene Schicht; HTTP-Statuscodes beim Web Scraping: 403, 407, 429, 503 enthält diesen Code. Derselbe Kern in Node.js:
import { chromium, errors } from "playwright";

const PROXY = { server: "http://pr.proxynet.io:8000", username: "user", password: "pass" };
const URLS = ["https://shop.example.com/product/42", "https://shop.example.com/product/45"];

const browser = await chromium.launch({ proxy: PROXY });
for (const url of URLS) {
  const context = await browser.newContext();
  context.setDefaultNavigationTimeout(15_000); // goto, reload, waitForURL
  context.setDefaultTimeout(10_000);           // Locators, Klicks, Wartevorgänge
  const page = await context.newPage();
  try {
    const response = await page.goto(url, { waitUntil: "domcontentloaded" });
    console.log(url, "status", response?.status(), "title", await page.title());
    console.log("  price:", await page.locator("#price").innerText());
  } catch (err) {
    if (!(err instanceof errors.TimeoutError)) throw err;
    console.log("  timeout:", err.message.split("\n")[0]);
  } finally {
    await context.close();
  }
}
await browser.close();
Auf unserer Testseite rendert die zweite Seite ihren Preis erst nach 12 Sekunden:
http://shop.test/product/42 status 200 title Product
  price: $19.90
http://shop.test/product/45 status 200 title Product
  timeout: locator.innerText: Timeout 10000ms exceeded.
Puppeteer: „Navigation timeout of 30000 ms exceeded“
Puppeteer nutzt dasselbe Modell unter anderen Namen. Auch sein Standardwert liegt bei 30 Sekunden, page.setDefaultNavigationTimeout() und page.setDefaultTimeout() ändern ihn, und waitUntil akzeptiert load, domcontentloaded, networkidle0 und networkidle2. Die Referenz zu den Lifecycle-Ereignissen von Puppeteer definiert die letzten beiden als höchstens 0 bzw. 2 offene Verbindungen für 500 ms; auf lebhaften Seiten scheitern sie deshalb genauso wie networkidle.
import puppeteer, { TimeoutError } from "puppeteer";

const browser = await puppeteer.launch({ args: ["--proxy-server=http://pr.proxynet.io:8000"] });
const page = await browser.newPage();
await page.authenticate({ username: "user", password: "pass" });
page.setDefaultNavigationTimeout(15_000); // goto, reload, waitForNavigation
page.setDefaultTimeout(10_000);           // waitForSelector und andere Wartevorgänge

try {
  const response = await page.goto("https://shop.example.com/product/45", { waitUntil: "domcontentloaded" });
  console.log("status", response?.status(), "title", await page.title());
  await page.waitForSelector("#price");
} catch (err) {
  if (!(err instanceof TimeoutError)) throw err;
  console.log(`${err.name}: ${err.message} (${err.cause?.message})`);
} finally {
  await browser.close();
}
Unsere Läufe mit Puppeteer 25.12 gaben diese Meldungen aus; die erste stammt von einer Seite, die nie antwortete, mit dem Standardlimit:
TimeoutError: Navigation timeout of 30000 ms exceeded
TimeoutError: Waiting for selector `#price` failed (Waiting failed: 10000ms exceeded)
Die Selektor-Meldung lässt das Limit weg; es steht in err.cause. Der Proxy wird als Chromium-Flag übergeben, die Zugangsdaten über page.authenticate(), das im Hintergrund die Request Interception einschaltet. Die Ursachen und Lösungen oben gelten unverändert.
Wo Ihnen dieser Fehler begegnet
- Scraping von Shops, die per JavaScript rendern: Preise laden nach dem HTML, warten Sie also auf das Element (Data Scraping).
- Crawlen einer langen Warteschlange: Eine hängende Seite sollte ein Timeout kosten, nicht den ganzen Lauf (Web Crawler).
- Die eigene App aus anderen Ländern testen: Jede Ausgangs-IP hat ihre eigene Latenz, setzen Sie Limits also pro Land (App-Tests).
- KI-Agenten, die einen Browser steuern: Ein Agent, der
gotoaufruft, stößt an dieselben Limits (Playwright MCP). - Geplante Crawls: Lesen Sie die Crawl-Regeln der Website, bevor Sie an der Geschwindigkeit drehen (Was ist robots.txt und wie liest man die Datei?).
Häufige Fehler
- Den Standardwert auf 60 oder 120 Sekunden erhöhen. Ein Warten, das nicht gelingen kann, scheitert nur später.
networkidleals „bereit“ behandeln. Lebhafte Seiten werden nie still.- Feste Pausen vor jedem Schritt.
time.sleep()undwaitForTimeout()sind auf schnellen Seiten zu lang und auf langsamen zu kurz. - In Python um
expect()nurTimeoutErrorabfangen. Es löstAssertionErroraus. - Status und Titel überspringen. Eine Sperrseite wird dann zu einem 30-sekündigen „Element nicht gefunden“.
- Gesperrte Anfragen wiederholen. Wiederholungen sind für Timeouts und Netzabbrüche da, nicht für
403und429. - Overlays mit
force=Trueübergehen. Der Klick landet dort, wo ein Nutzer nicht klicken könnte.
Entscheidungshilfe
| Was Sie sehen | Was zu tun ist |
|---|---|
page.goto: Timeout mit waiting until "load" | domcontentloaded, dann auf das Element warten |
page.goto: Timeout mit waiting until "networkidle" | networkidle streichen; auf ein Element warten |
page.goto: Timeout mit domcontentloaded | Ladezeit über den Proxy messen; das Limit daraus ableiten |
waiting for locator(...) und nichts darunter | Selektor, Frames und die aktuelle Seite prüfen |
intercepts pointer events | Das Overlay so schließen, wie es ein Nutzer täte |
Status 403 oder 429 oder ein Sperrtitel | Stoppen; langsamer werden, robots.txt prüfen, um Erlaubnis bitten oder eine API nutzen |
Test timeout of 30000ms exceeded. | Den hängenden Schritt finden; das Limit nur für langsame Tests erhöhen |
requestfailed zeigt ERR_TUNNEL_CONNECTION_FAILED | Die Proxy-Zugangsdaten korrigieren, bevor Sie Timeouts anfassen |
Häufige Fragen
Was ist das Standard-Timeout in Playwright?
In der Bibliothek 30 Sekunden für Navigationen und Aktionen. In Playwright Test bekommt ein ganzer Test 30 Sekunden und jedes expect() 5 Sekunden; Aktionen und Navigationen haben kein eigenes Limit.
Wie erhöhe ich das Timeout für page.goto?
Übergeben Sie es dem Aufruf (page.goto(url, timeout=60_000) in Python, { timeout: 60_000 } in Node.js), setzen Sie set_default_navigation_timeout() auf den Context oder navigationTimeout in der Konfiguration von Playwright Test. Erhöhen Sie es erst, nachdem Sie gemessen haben.
Warum läuft page.goto in ein Timeout, obwohl die Seite schon zu sehen ist?
goto wartet standardmäßig auf das Ereignis load, und ein einziges Bild oder Widget, das nie fertig wird, hält es auf. Nutzen Sie domcontentloaded und warten Sie auf das Element, das Sie brauchen.
Sollte ich networkidle verwenden?
Nein. Die Referenz von Playwright kennzeichnet es als „discouraged“, und Seiten mit Polling oder Live-Chat erreichen diesen Zustand womöglich nie. Warten Sie stattdessen auf ein bestimmtes Element.
Wie fange ich einen Playwright-TimeoutError in Python ab?
Importieren Sie ihn mit from playwright.sync_api import TimeoutError as PlaywrightTimeoutError und fangen Sie diesen Namen ab. Ein fehlgeschlagenes expect() löst AssertionError aus.
Kann ein Proxy Timeouts in Playwright verursachen?
Ja. Eine langsame Ausgangs-IP kann Seiten über das Limit schieben, und falsche Zugangsdaten auf einer HTTPS-Seite können als Timeout erscheinen. Messen Sie über den Proxy, setzen Sie Limits nach den Ergebnissen und hören Sie auf requestfailed. Eine Sperrseite lässt sich mit einem anderen Proxy nicht beheben.
Fazit
„Timeout 30000ms exceeded“ benennt das Warten, das abgelaufen ist, nicht die Ursache. Lesen Sie die Methode und das Ende des Call Logs und beheben Sie dann, worauf beides zeigt: ein Warten auf load oder networkidle, einen Selektor, ein Overlay, einen Frame, eine Sperrseite oder eine langsame Ausgangs-IP. Setzen Sie Limits auf dem Context nach gemessenen Ladezeiten, geben Sie der seltenen langsamen Seite ein eigenes Limit, wiederholen Sie nur Timeouts mit Backoff und stoppen Sie bei Sperren. Um Proxys zu wählen, die zu Ihren Zielen passen, vergleichen Sie unsere Proxy-Dienste.