Un chatbot de atención al cliente le dice a un cliente que puede pedir un descuento después del viaje, mientras que la página de políticas de la propia empresa dice que no. Un asistente de programación sugiere instalar una biblioteca que nunca se publicó. Un abogado presenta un escrito que cita sentencias que ningún tribunal dictó jamás. Cada respuesta era fluida y concreta, sin rastro de duda, y cada una era falsa. En el mundo de la IA, este fallo tiene nombre: alucinación.
Este artículo explica qué es una alucinación de IA, por qué la producen los modelos de lenguaje, sus tipos principales, casos documentados, cómo detectarla, cómo reducirla con grounding (anclaje en fuentes) y verificación, y por qué no se puede eliminar del todo.
¿Qué es una alucinación de IA?
Una alucinación de IA es un contenido generado por un modelo de IA que se presenta como un hecho, pero es erróneo, inventado o no está respaldado por su entrada. La palabra se toma de la psicología como metáfora: el modelo no ve ni oye nada. Produce texto, y parte de ese texto no coincide con la realidad o con el documento sobre el que se le preguntó.
El NIST, el instituto de normas de Estados Unidos, prefiere otra palabra. Su perfil de IA generativa, el Generative AI Profile (NIST AI 600-1), llama a este riesgo confabulación (confabulation) y lo define como la producción de contenido erróneo o falso expresado con seguridad, que coloquialmente se conoce como alucinación o invención (fabrication). La definición también abarca las salidas que se apartan del prompt o contradicen lo que el modelo dijo antes en la misma conversación.
En sentido estricto, dos cosas no son alucinaciones: repetir un error que ya estaba en el documento que tú aportaste, que es un problema de la fuente, e inventar en un relato o una imagen, donde inventar es justamente la tarea. La alucinación es un problema cuando el lector espera hechos.
¿Por qué alucinan los modelos de IA?
Los modelos de IA alucinan porque un modelo de lenguaje se entrena para predecir texto plausible, no para comprobarlo: elige el siguiente fragmento de palabra (token) que mejor encaja con los patrones aprendidos, y luego el siguiente. Nuestra guía sobre cómo funcionan los modelos de lenguaje grandes recorre ese ciclo paso a paso. En ningún punto se consulta un dato, así que una frase plausible y falsa y una frase plausible y verdadera salen del mismo proceso.
Investigadores y organismos de normalización señalan las mismas causas:
- La predicción premia lo plausible. El NIST considera la confabulación un resultado natural del diseño de los modelos generativos: se aproximan a los patrones estadísticos de sus datos de entrenamiento, y un texto que suena bien puntúa alto, sea cierto o no.
- Datos raros o erróneos en el entrenamiento. Un dato que aparece muchas veces en los datos de entrenamiento suele reproducirse bien; uno que aparece una o dos veces, no, y los errores de los datos se repiten con fluidez. En Why Language Models Hallucinate («Por qué alucinan los modelos de lenguaje»), investigadores de OpenAI y Georgia Tech sostienen que, con datos arbitrarios sin ningún patrón detrás, como el cumpleaños de una persona, algunos errores son estadísticamente inevitables para un modelo base.
- El entrenamiento y las pruebas premian adivinar. El mismo artículo señala que la mayoría de las pruebas de referencia (benchmarks) califican las respuestas solo como correctas o incorrectas, así que «no lo sé» no suma nada y una respuesta al azar a veces suma un punto. Un modelo ajustado para esas pruebas aprende a adivinar.
- Los datos de entrenamiento tienen fecha de fin. Un modelo no sabe nada de lo ocurrido después de su fecha de corte del conocimiento y puede responder sobre un hecho, un precio o una norma posteriores a partir de patrones antiguos.
- Prompts vagos y premisas falsas. Preguntar por qué un producto ganó un premio que nunca ganó invita a una respuesta construida sobre esa premisa. El ajuste por preferencias (preference tuning) también puede volver a un modelo demasiado dispuesto a darle la razón al usuario, algo que los investigadores llaman complacencia (sycophancy).
- Contexto largo o con ruido. En el estudio «Lost in the Middle» (Liu y colaboradores, 2023), los modelos respondían mejor cuando el pasaje relevante estaba al principio o al final de una entrada larga, y peor cuando estaba en el medio.
- Ajustes de decodificación. La mayoría de las herramientas toman una muestra de las probabilidades predichas en lugar de elegir siempre la palabra más probable; un ajuste de aleatoriedad más alto, normalmente llamado temperatura, hace más frecuentes las palabras y afirmaciones improbables.
¿Qué tipos de alucinación de IA hay?
Las alucinaciones de IA se dividen en dos grandes grupos: respuestas que chocan con hechos del mundo real y respuestas que no siguen las instrucciones o el texto que recibió el modelo. Una revisión sobre la alucinación en los modelos de lenguaje grandes publicada en 2023 por Huang y colaboradores las llama alucinaciones de factualidad (factuality) y de fidelidad (faithfulness). Investigaciones anteriores sobre generación de texto usaban los términos intrínseca (la salida contradice la fuente) y extrínseca (la salida añade algo que la fuente no puede confirmar).
En la práctica, los tipos se ven así (los ejemplos son inventados):
| Tipo | Cómo se ve | Ejemplo |
|---|---|---|
| Error factual | Una fecha, cifra o nombre equivocados | «La marca A se fundó en 2009»; su web dice 2012 |
| Fuente inventada | Una cita, referencia, enlace o caso que no existe | Un estudio con autores verosímiles y un enlace roto |
| Paquete inventado | Código que importa una biblioteca que nadie publicó | Un comando de instalación para un nombre desconocido |
| Contradice la fuente | Un resumen que invierte el documento | «Devoluciones en 30 días»; la política dice 14 |
| Añade a la fuente | Detalles que el documento nunca menciona | Una cita del CEO que no está en el artículo |
| Autocontradicción | Choca con una respuesta anterior | Dos totales distintos en un mismo chat |
Las fuentes inventadas convencen porque una referencia es un patrón (autores, título, revista, año, DOI) que un modelo puede reproducir sin ningún artículo detrás. Con el código pasa lo mismo: un estudio de 2024 sobre modelos que generan código en Python y JavaScript, aceptado en el USENIX Security Symposium de 2025, encontró modelos que recomendaban paquetes inexistentes y repetían muchos de los mismos nombres inventados. Así, un atacante puede publicar un paquete malicioso con uno de esos nombres y esperar.
¿Qué ejemplos reales de alucinación de IA hay?
Los casos mejor documentados vienen de tribunales y órganos de resolución de disputas, cuyas decisiones dejan constancia de lo que se dijo y de lo que costó.
Jurisprudencia inventada en un tribunal de EE. UU. En Mata v. Avianca, un tribunal federal de Nueva York sancionó el 22 de junio de 2023 a dos abogados y a su bufete por presentar resoluciones judiciales inexistentes, con citas y referencias falsas creadas por ChatGPT. Cuando uno de los abogados le preguntó al chatbot si un caso era real, este respondió que sí y que podía encontrarse en bases de datos jurídicas. El tribunal escribió que usar una herramienta de IA fiable como ayuda no es impropio en sí mismo, pero que los abogados deben comprobar lo que presentan. Impuso una multa de 5.000 dólares estadounidenses y ordenó enviar cartas al cliente y a cada juez señalado falsamente como autor de una resolución falsa.
La respuesta equivocada de un chatbot sobre una política. En Moffatt v. Air Canada (2024 BCCRT 149), el chatbot del sitio web de una aerolínea le dijo a un pasajero que podía solicitar una tarifa reducida por duelo (bereavement fare) en los 90 días siguientes a la emisión del boleto, mientras que la página de políticas de la propia aerolínea decía que no se aplicaba después del viaje. El 14 de febrero de 2024, el Civil Resolution Tribunal, el tribunal de resolución de disputas de la provincia canadiense de Columbia Británica, rechazó el argumento de que la aerolínea no era responsable de su chatbot, la declaró responsable de toda la información de su sitio web y le ordenó pagar 812,02 dólares canadienses. La decisión no dice qué tecnología usaba el chatbot; su lección es que una respuesta automática sigue siendo la respuesta de la empresa.
Seguros de sí mismos y distintos cada vez. En el artículo de OpenAI y Georgia Tech, los autores preguntaron a tres modelos de chat populares por el título de la tesis doctoral de uno de los autores. Cada uno dio un título y un año distintos, y ninguno acertó.
¿Cómo detectar una alucinación de IA?
Detectas una alucinación contrastando las afirmaciones concretas con una fuente que puedas abrir, porque el tono de la respuesta no te dice nada. Estas señales merecen una segunda mirada:
- Detalles precisos sin fuente. Cifras exactas, fechas, citas o números de caso sin enlace ni referencia.
- Fuentes que no se abren. Un enlace que da error, un DOI que no lleva a ninguna parte, una cita que no encuentras en el texto citado.
- Mucho detalle sobre un tema poco conocido. Cuanto más raro es el tema, menos aprendió el modelo sobre él y más rellena por su cuenta.
- Respuestas que cambian. Vuelve a preguntar en un chat nuevo o reformula la pregunta. Si los datos cambian, al menos una versión es falsa.
- Autoconfirmación. Preguntar al mismo modelo «¿Esto es real?» no demuestra nada, como mostró el caso Mata.
- Un resumen que sabe demasiado. Cualquier detalle que no encuentres en el documento resumido.
¿Cómo se reducen las alucinaciones de IA?
Las alucinaciones se reducen dándole al modelo los datos que necesita, dejándole negarse cuando no sabe y comprobando sus afirmaciones antes de usarlas. Los equipos combinan varios pasos:
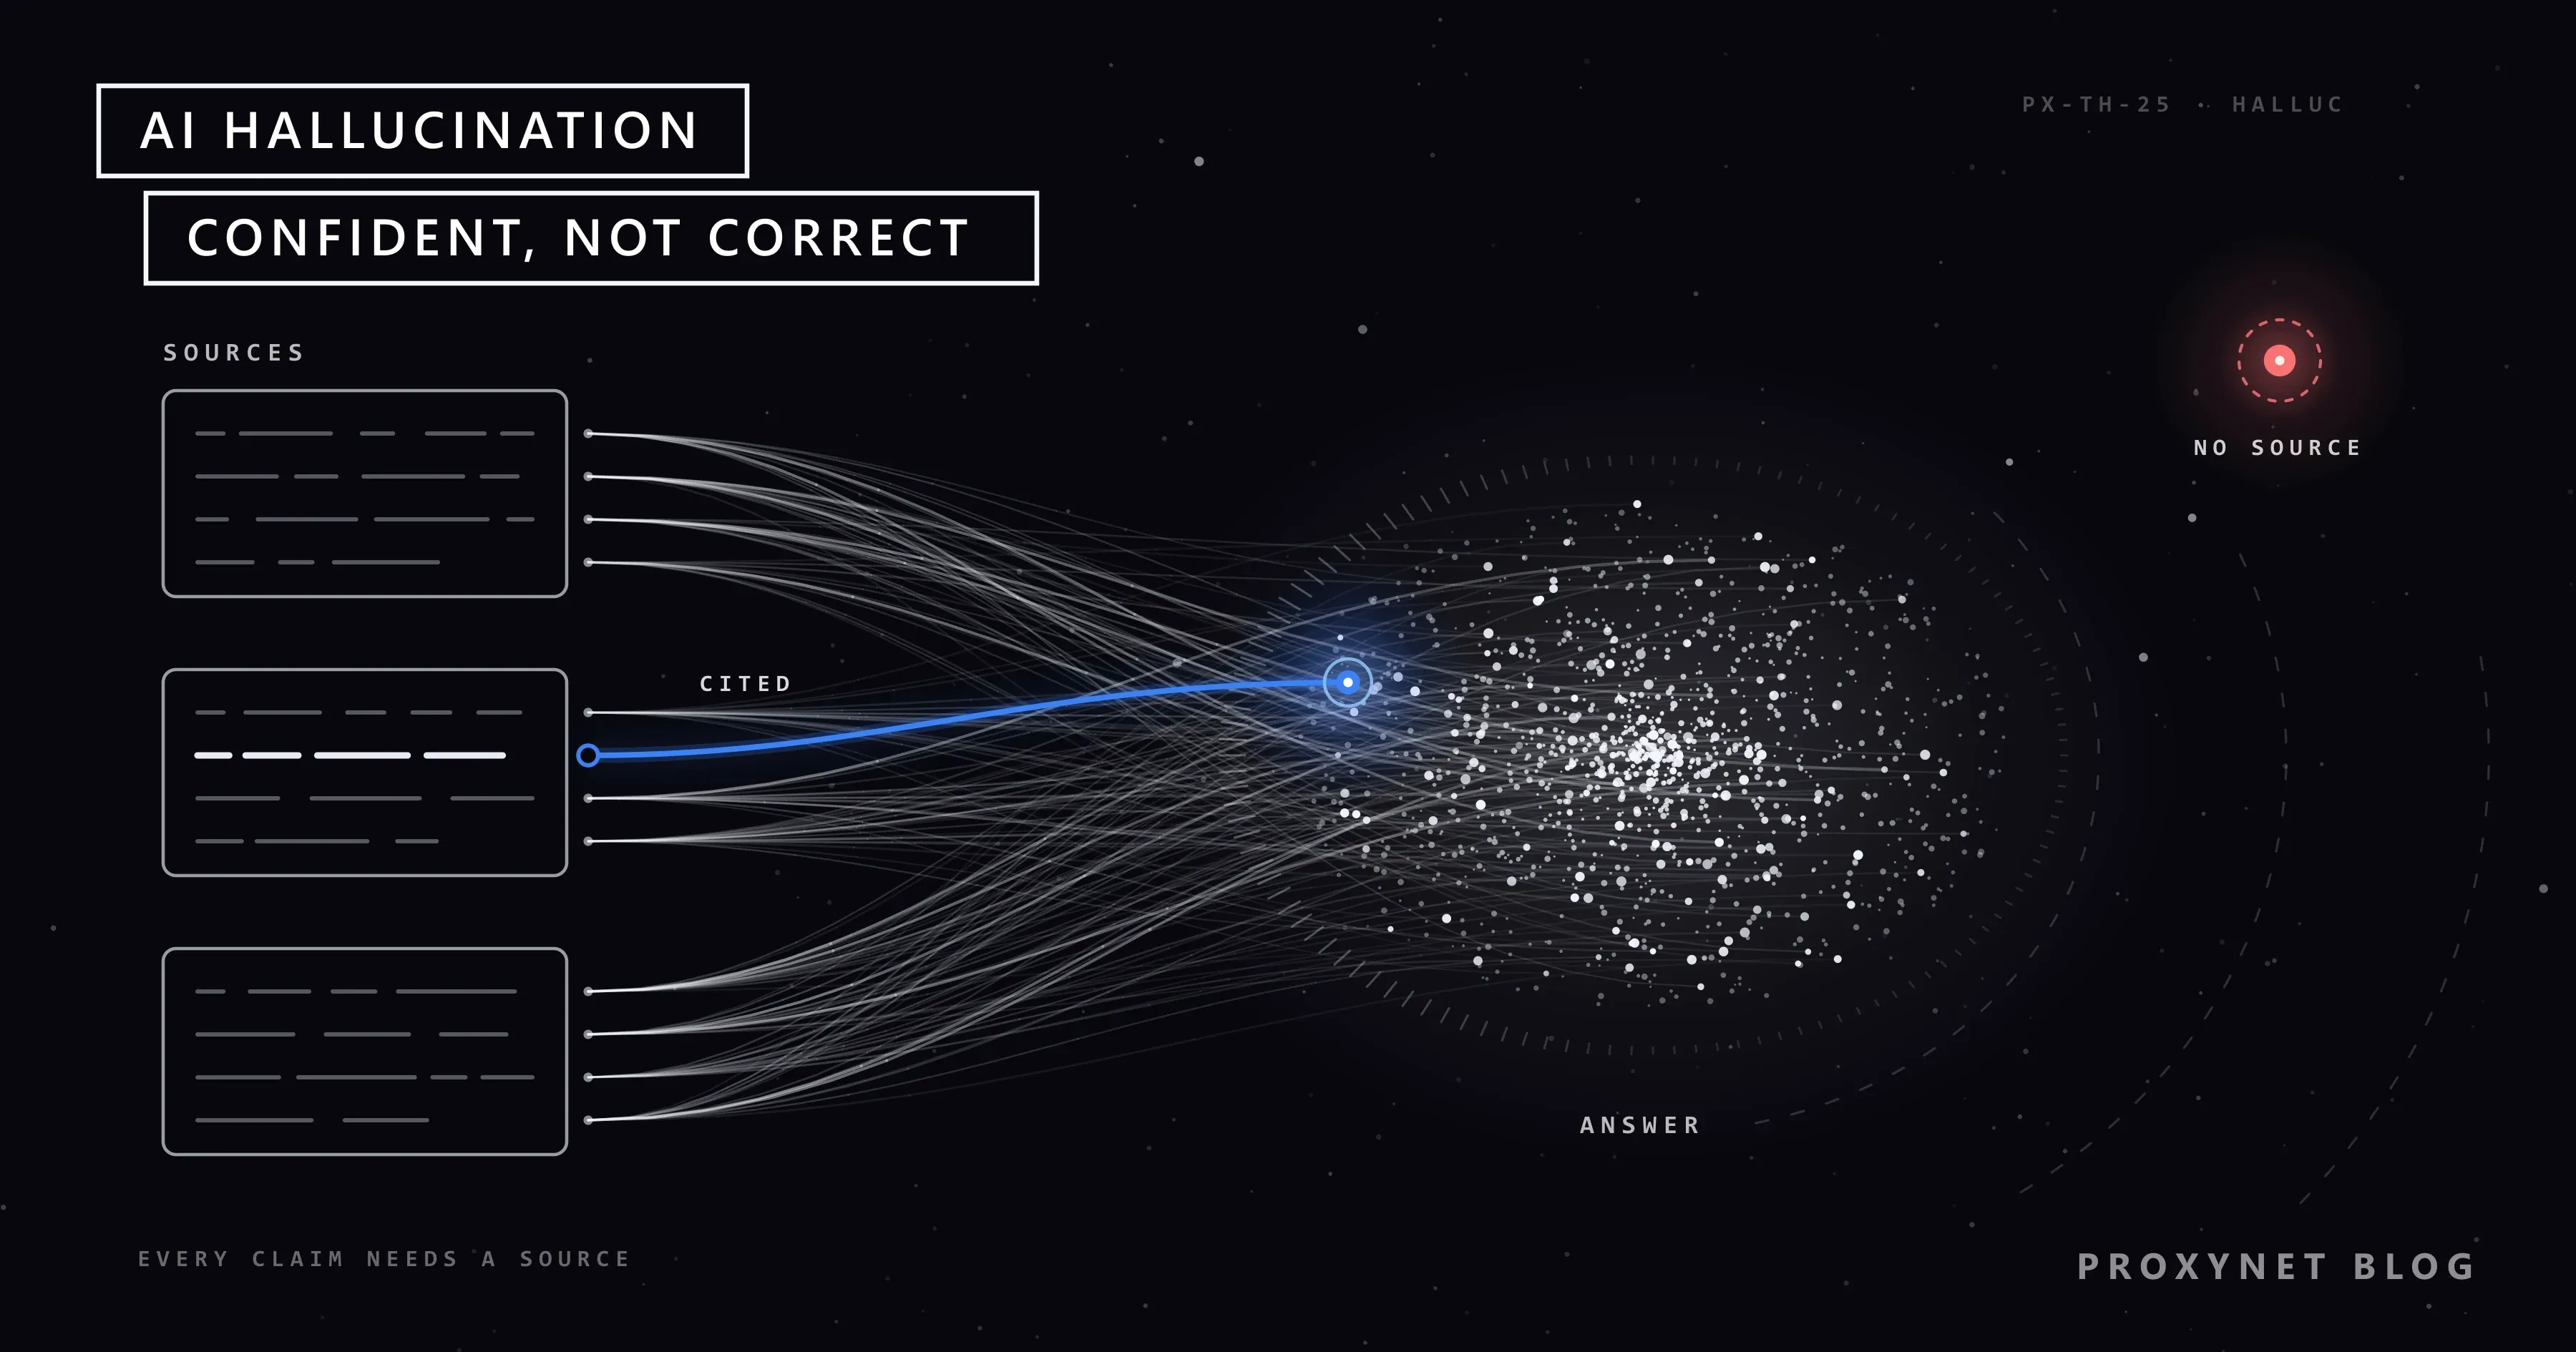
- Basa la respuesta en fuentes. Con RAG (generación aumentada por recuperación), el sistema busca pasajes relevantes en un índice de documentos cuando llega una pregunta y el modelo responde a partir de ellos, citando cada uno. Cómo preparar páginas web para ese índice se explica en Web scraping para RAG: de HTML a fragmentos Markdown limpios.
- Limita el modelo al texto aportado. Pídele que responda solo con los documentos proporcionados, que diga cuándo la respuesta no está en ellos y que cite la frase en la que se apoya cada afirmación.
- Haz aceptable el «no lo sé». Indica que negarse es mejor que adivinar. Los autores de OpenAI y Georgia Tech proponen lo mismo para las pruebas de referencia: una respuesta incorrecta debería costar más que ninguna respuesta.
- Pide fuentes y luego ábrelas. Las referencias solicitadas también pueden ser inventadas.
- Baja la aleatoriedad en tareas factuales. Una temperatura baja hace las respuestas más coherentes, pero no añade conocimiento; en el estudio de los paquetes, cambiar los ajustes de decodificación no redujo los nombres inventados.
- Usa herramientas para datos y cifras. Los cálculos, las fechas y la información actual deben venir de una calculadora, de código, de una base de datos o de una búsqueda, no de la memoria del modelo.
- Mantén el contexto enfocado. Envía los pasajes relevantes, no un archivo entero, y coloca el material clave cerca del principio o del final del prompt.
- Revisa los resultados de alto riesgo. El contenido legal, médico y financiero, y todo lo que se envía a clientes, necesita una persona que compruebe cada afirmación; el NIST aconseja una supervisión más estrecha allí donde los resultados de la IA alimentan decisiones con consecuencias.
- Mídelo. Reúne entre 30 y 50 preguntas con respuestas conocidas de tus propios documentos y cuenta las respuestas incorrectas tras cada cambio.
¿Qué significa grounding y por qué importan las fuentes?
Una respuesta con grounding es aquella cuyas afirmaciones pueden rastrearse hasta pasajes concretos de las fuentes aportadas en el momento de responder, de modo que cada afirmación se puede comprobar con el texto del que salió. El grounding no hace veraz a un modelo por sí solo; traslada el riesgo a la recuperación (retrieval). Si la recuperación devuelve el pasaje equivocado, una página desactualizada o una página escrita para otro mercado, el modelo responde con seguridad a partir de ella.
La calidad de la recuperación es la mitad del trabajo. La mayoría de los recuperadores encuentran pasajes por su significado y no por palabras exactas, como se explica en ¿Qué es la búsqueda semántica?, y cada pasaje debería llevar su URL y la hora en que se obtuvo para que las respuestas puedan citarlo.
La ubicación es la parte que los equipos suelen pasar por alto. Los precios, el stock, las condiciones de entrega y las normas locales cambian según el país y la ciudad, y muchos sitios eligen la versión que muestran según la dirección IP del visitante. Un pipeline que obtiene todas las páginas desde un único centro de datos ve una sola versión y responde a usuarios de otros lugares sobre un mercado en el que no están. Recopilar las páginas públicas tal como las ve un visitante local, por ejemplo con Proxies residenciales y segmentación por país y ciudad, mantiene alineados la fuente y el mercado del usuario. Recopila solo páginas públicas, respeta robots.txt y los términos del sitio, mantén un ritmo de solicitudes bajo y usa una API oficial cuando exista.
Si prefieres no encargarte tú de la recopilación, puedes hablar con nuestro equipo de ventas sobre la extracción gestionada de páginas de nuestra Web Scraping API.
¿Se pueden eliminar las alucinaciones de IA?
No. Las alucinaciones pueden volverse menos frecuentes y más fáciles de detectar, pero un modelo de lenguaje de uso general que responde preguntas abiertas seguirá produciéndolas. El NIST trata la confabulación como una consecuencia de cómo funcionan los modelos generativos, y el artículo de OpenAI y Georgia Tech sostiene que incluso los modelos base bien entrenados seguirán cometiendo ciertos errores; un sistema solo los evita si se niega a responder lo que no sabe.
RAG tampoco elimina el problema. La revisión citada más arriba dedica una sección a sus límites: el recuperador puede no encontrar el pasaje correcto y el modelo puede seguir interpretando mal el contexto. El objetivo realista es cometer menos errores, que sean fáciles de detectar y que se detecten antes de causar daño.
¿Dónde aparecen las alucinaciones de IA?
Aparecen allí donde un modelo escribe texto que alguien toma como un hecho: asistentes de chat, resúmenes generados por IA encima de los resultados de búsqueda, asistentes de programación, bots de atención al cliente y herramientas que resumen contratos, artículos o transcripciones de reuniones.
El riesgo crece cuando un modelo, además de escribir, actúa. Un agente de IA que reserva, compra, edita archivos o envía mensajes puede convertir un dato inventado en una acción.
Errores frecuentes
- Dar por correcto un texto fluido. La seguridad y la gramática no son pruebas.
- Pedir al modelo que se verifique a sí mismo. Usa una fuente independiente.
- Fiarte de una referencia sin abrirla. Las referencias falsas se ven exactamente igual que las reales.
- Suponer que con RAG no hay alucinaciones. La recuperación las reduce y añade sus propios puntos de fallo.
- Esperar que una temperatura baja corrija los datos. Reduce la variación, no la ignorancia.
- Lanzar un bot de cara al cliente sin salvaguardas. Necesita una vía para decir «no lo sé», registros y un traspaso a una persona.
- Instalar un paquete porque un asistente lo nombró. Comprueba primero el registro oficial.
Guía de decisión
| Necesidad | Qué hacer |
|---|---|
| Una pregunta general rápida | Verifica en una fuente fiable cualquier dato que vayas a reutilizar |
| Respuestas sobre tus propios documentos | RAG con referencias, respuestas solo a partir del texto |
| Un chatbot de cara al cliente | Políticas actuales, vía para negarse, registros, traspaso a una persona |
| Contenido legal, médico o financiero | Revisión experta de cada afirmación y referencia |
| Código de un asistente | Comprueba cada paquete en su registro y ejecuta las pruebas |
| Precios, stock o normas locales | Páginas actuales del mercado en cuestión |
| Seguir el progreso | Un conjunto de pruebas fijo con respuestas conocidas |
Preguntas frecuentes
¿Por qué la IA se inventa cosas?
La IA se inventa cosas porque un modelo de lenguaje genera la continuación más plausible de un prompt, y plausible no es lo mismo que verdadero. Cuando sus datos de entrenamiento tenían poco sobre un tema, igualmente produce una respuesta con la forma de la correcta. Las pruebas de referencia que no puntúan el «no lo sé» también enseñan a los modelos que adivinar compensa.
¿Se pueden corregir del todo las alucinaciones de IA?
No. El grounding, el permiso para negarse, las herramientas y la revisión humana hacen que las alucinaciones sean menos frecuentes y más fáciles de detectar, pero ningún método actual las elimina de un modelo de uso general. Cuenta con que habrá errores y decide dónde debe revisar el resultado una persona.
¿Una alucinación de IA es lo mismo que mentir?
No. Mentir requiere intención de engañar, y un modelo no la tiene; produce texto probable sin saber si es cierto. El efecto sobre el lector puede ser el mismo, y por eso quien publica una respuesta de IA sigue siendo responsable de ella, como mostró la decisión sobre el chatbot de la aerolínea.
¿Cómo compruebo una respuesta de IA?
Contrasta las afirmaciones importantes con una fuente que puedas abrir tú mismo: la página oficial, el documento original, el registro de paquetes o el expediente judicial. Abre cada enlace, busca las citas palabra por palabra y vuelve a preguntar en un chat nuevo para ver si los datos se mantienen. Nunca dejes que el mismo modelo sea el único juez de su propia respuesta.
¿RAG evita las alucinaciones?
RAG reduce las alucinaciones, pero no las evita. Da al modelo texto actual y relevante y permite a los lectores comprobar los pasajes citados, pero el recuperador puede devolver una página equivocada o desactualizada y el modelo puede seguir interpretando mal lo que recibió. Las referencias y las comprobaciones por muestreo siguen siendo necesarias.
¿Por qué las herramientas de IA inventan fuentes?
Las herramientas de IA inventan fuentes porque una referencia es un patrón que el modelo ha visto innumerables veces: autores, un título, una revista, un año y un enlace. Puede producir ese patrón sin ningún documento real detrás y no puede buscar la referencia por sí solo. Las herramientas que recuperan y citan documentos reales reducen el problema; aun así, vale la pena abrir cada referencia.
En resumen
Una alucinación de IA es una salida segura y fluida que es falsa, inventada o no está respaldada por la entrada. Se deriva de cómo funcionan los modelos de lenguaje: predicen texto plausible, aprenden mal los datos poco frecuentes, dejan de aprender en una fecha de corte y a menudo se entrenan de formas que premian adivinar. Los casos documentados muestran que quien usa la respuesta paga el error. Basar las respuestas en fuentes actuales, permitir el «no lo sé», usar herramientas para los datos y contar con revisión humana hacen que los errores sean menos frecuentes y más fáciles de detectar. Cuando las respuestas dependen de precios, stock o normas que cambian según el lugar, las fuentes tienen que venir del mercado del usuario.