

































Blog de Proxynet – Página 10

Publicado
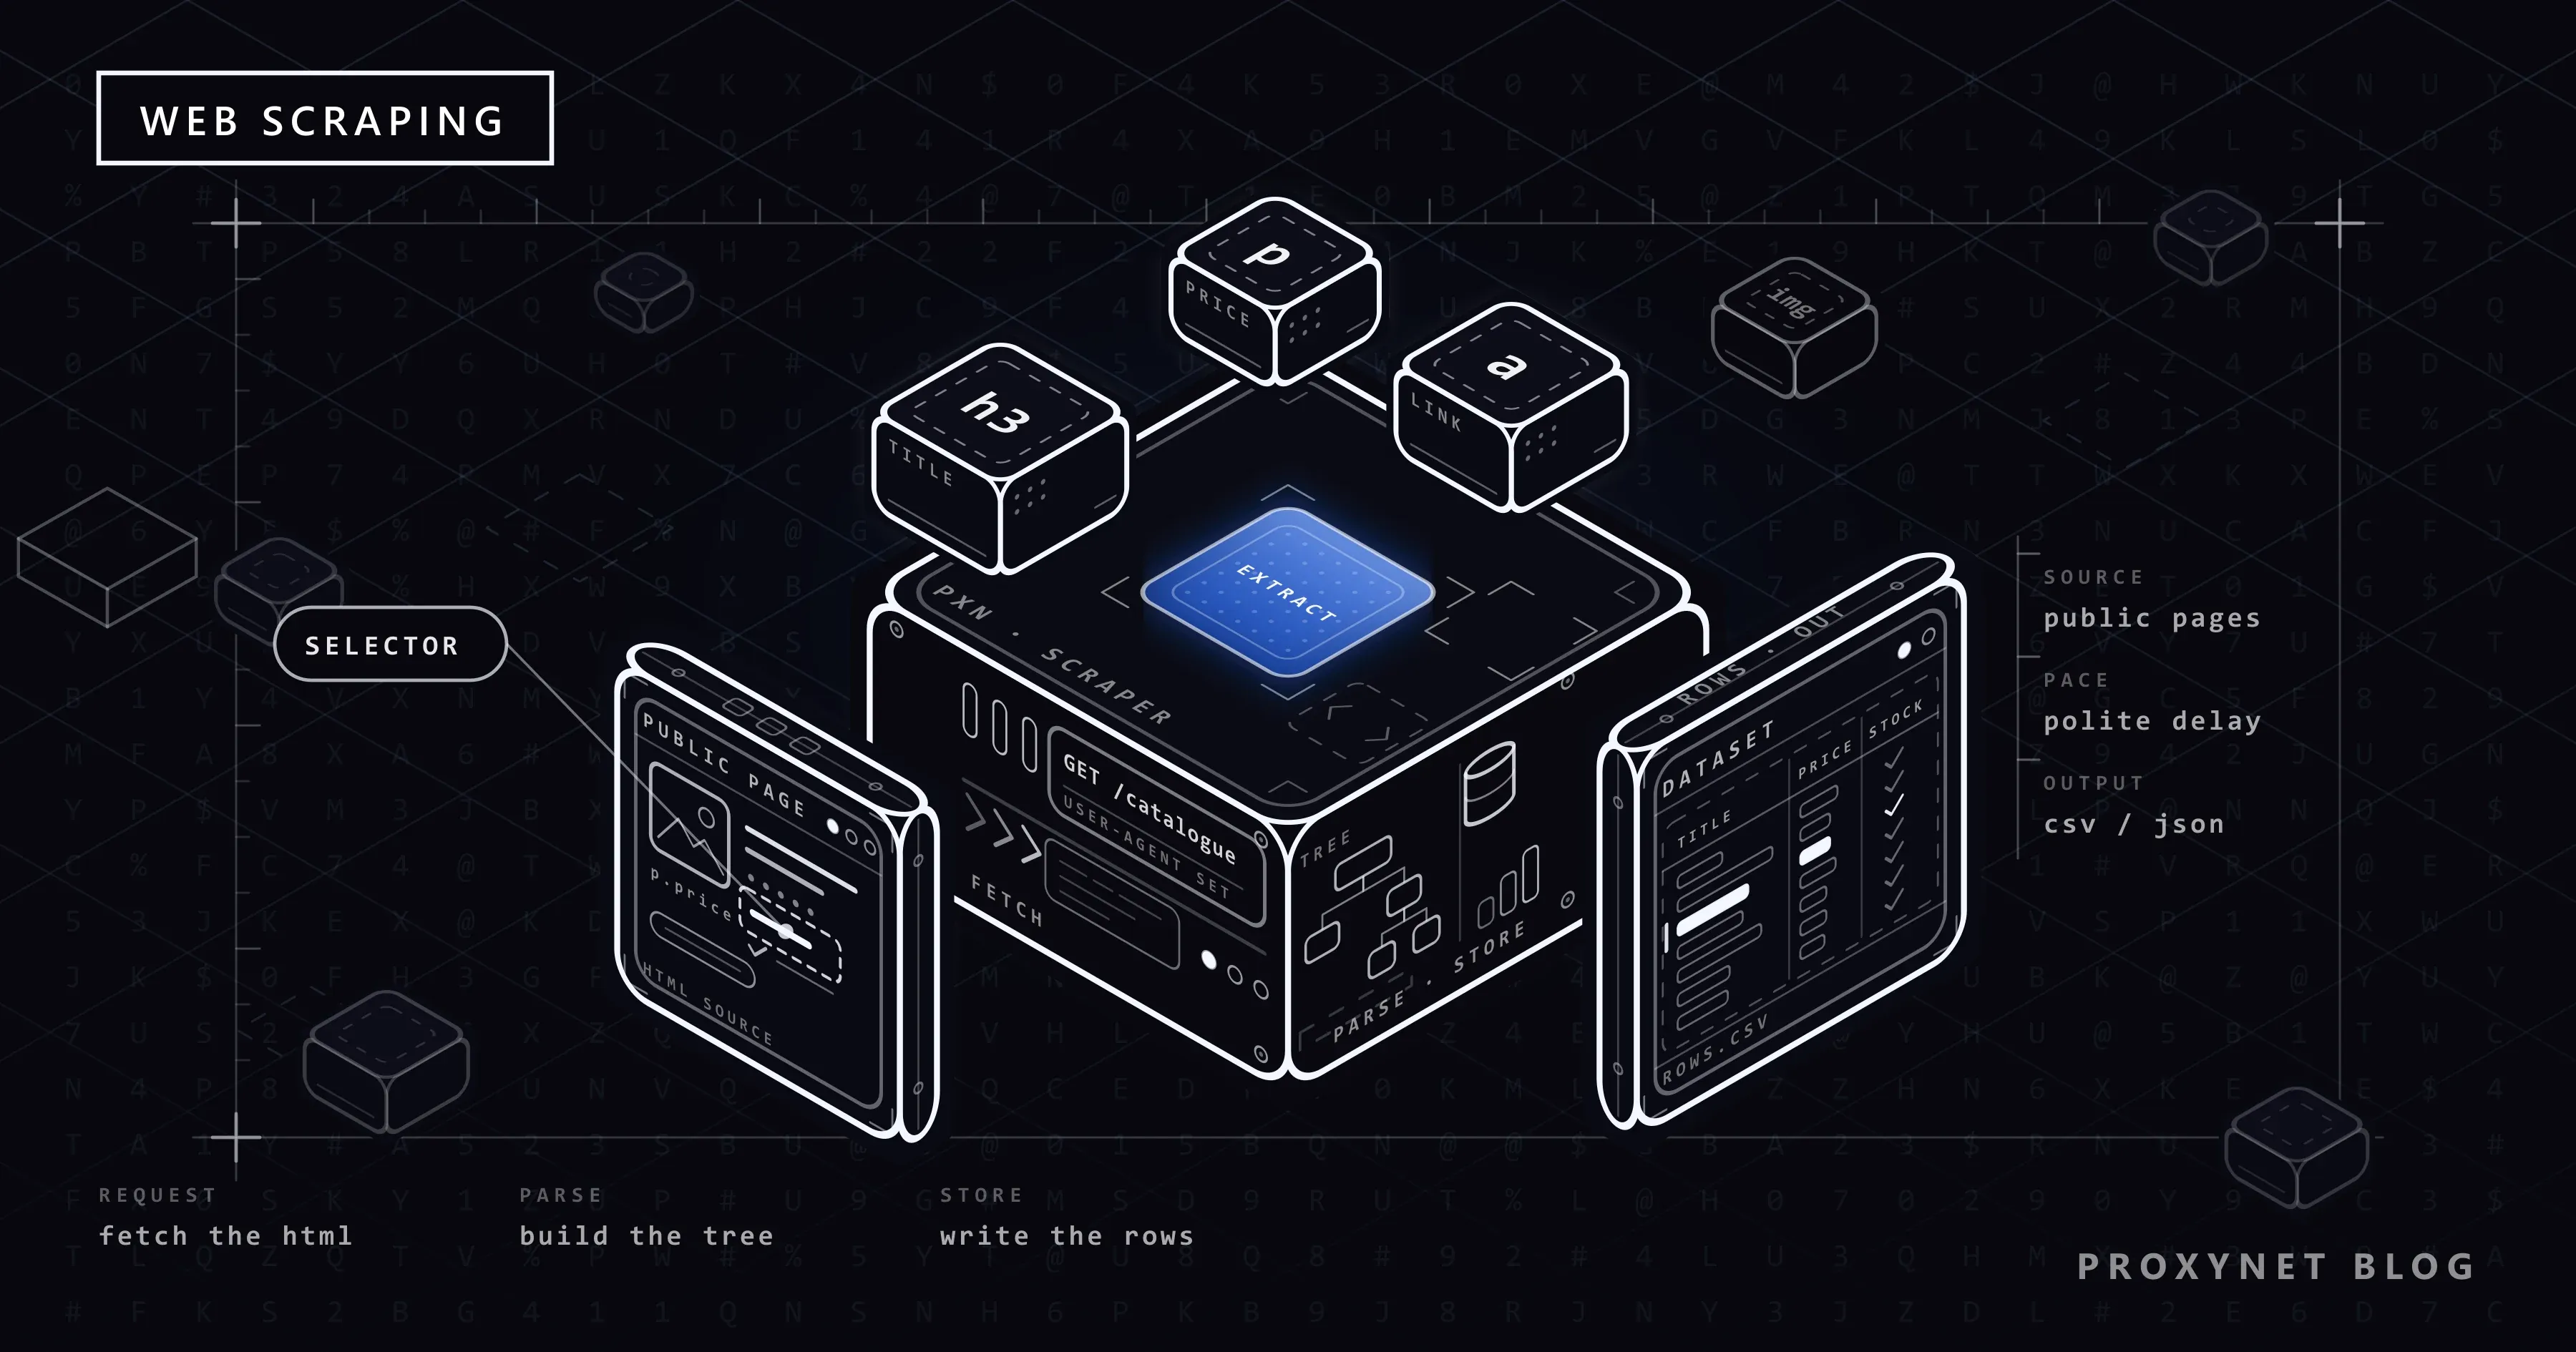
¿Qué es el web scraping y cómo funciona?
El web scraping es la recogida automática de datos de páginas web: un programa descarga el HTML, extrae campos y los guarda. Cómo funciona y para qué sirve.
Autor: Acar Diveroli
Publicado
Proxy de WhatsApp: cómo activarlo y desactivarlo
El proxy de WhatsApp está en Ajustes > Almacenamiento y datos > Proxy. Cómo activarlo y desactivarlo, y por qué un proxy HTTP o SOCKS5 no funciona ahí.
Autor:Acar Diveroli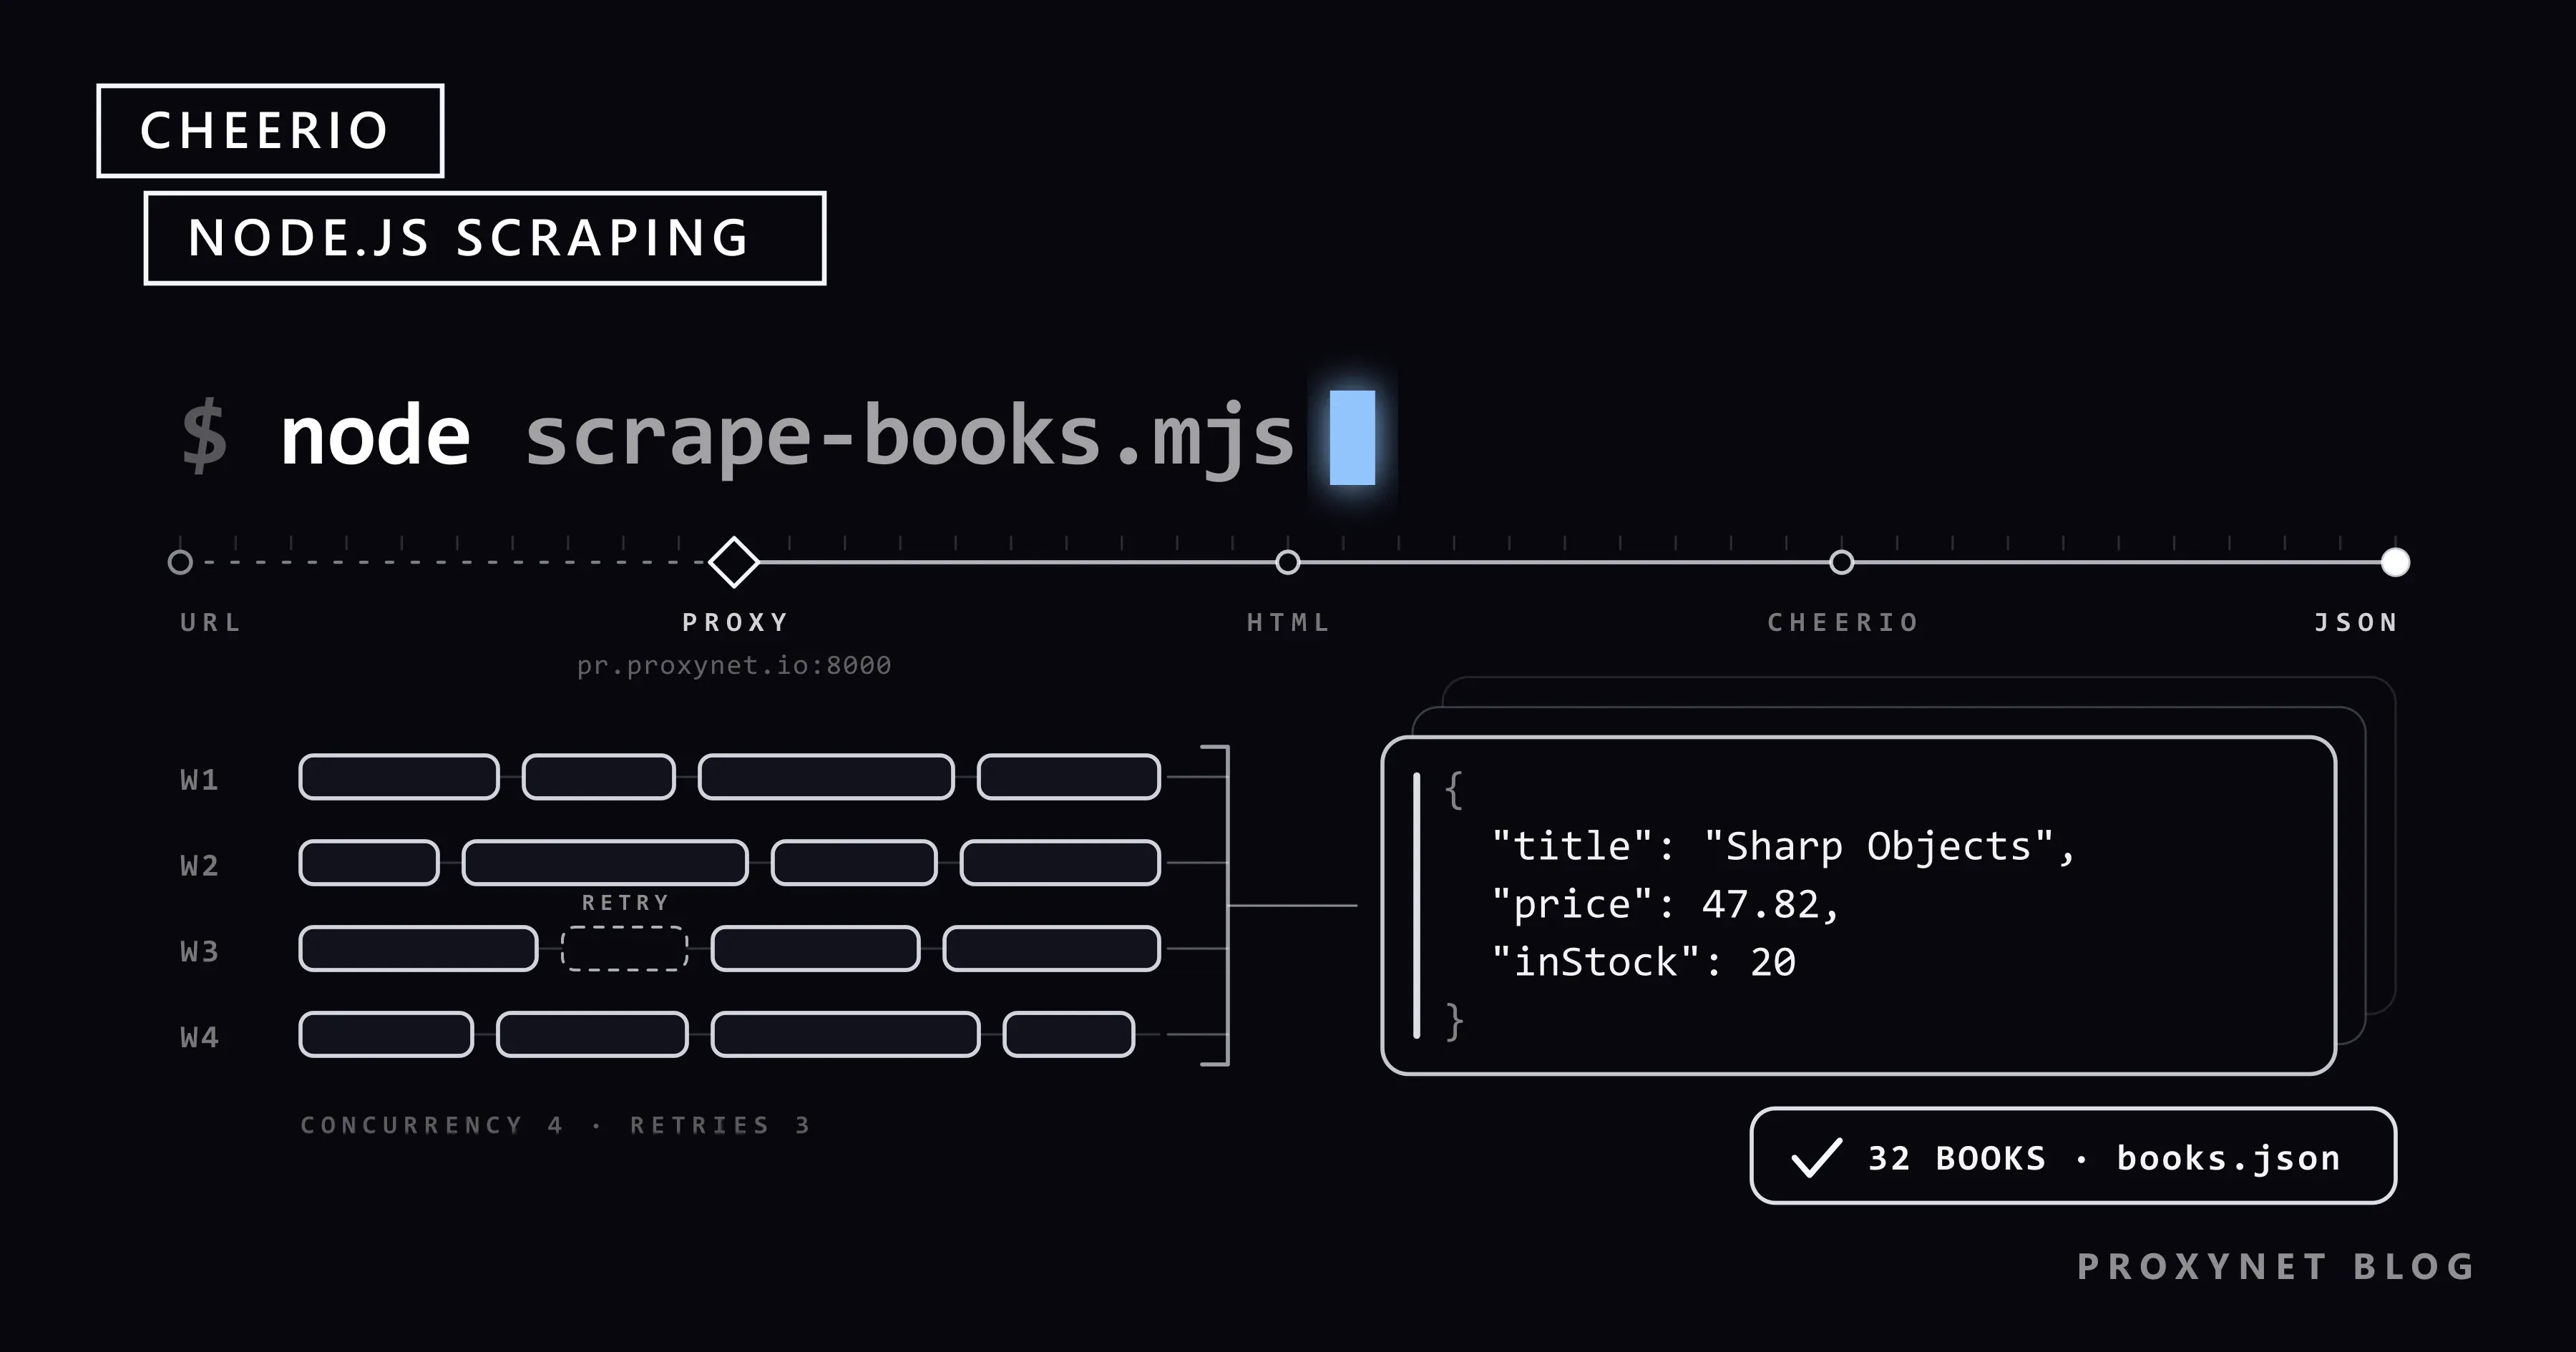
Publicado
Web scraping con Cheerio en Node.js: tutorial paso a paso
Cheerio analiza HTML en Node.js con selectores al estilo jQuery. Crea un scraper probado con fetch, paginación, límite de concurrencia, reintentos y proxy.
Autor:Acar Diveroli
Publicado
Cómo limpiar datos de scraping con pandas en Python
Limpia datos de scraping con pandas: primero el texto, luego tipos, duplicados, valores faltantes y atípicos, y valida antes de guardar. Con script probado.
Autor:Acar Diveroli
Publicado
Cómo extraer datos de un PDF: tablas, texto y OCR
Comprueba primero si el PDF tiene capa de texto. Si la tiene, Excel o pdfplumber leen las tablas; las páginas escaneadas necesitan OCR. Con código probado.
Autor:Acar Diveroli
Publicado
Cómo tratar datos personales (PII) en datos de scraping
Los datos de scraping suelen traer datos personales: nombres, perfiles, emails y teléfonos. Cómo detectarlos, reducirlos, enmascararlos y protegerlos.
Autor:Acar Diveroli
Publicado
Cómo guardar datos de scraping en CSV, JSON y SQLite
Guarda los datos extraídos en CSV para hojas de cálculo, JSON Lines para registros que crecen y SQLite para ejecuciones sin duplicados. Código Python probado.
Autor:Acar Diveroli
Publicado
Análisis de sentimiento en Python: VADER vs Hugging Face
El análisis de sentimiento en Python etiqueta texto como positivo, neutral o negativo. Puntuamos reseñas con VADER de NLTK y un modelo de Hugging Face.
Autor:Acar Diveroli
Publicado
¿Qué son los datos alternativos? Fuentes, usos y riesgos
Los datos alternativos vienen de fuera de los informes de empresa: precios web, ofertas de empleo, paneles de tarjetas e imágenes de satélite. Usos y riesgos.
Autor:Acar Diveroli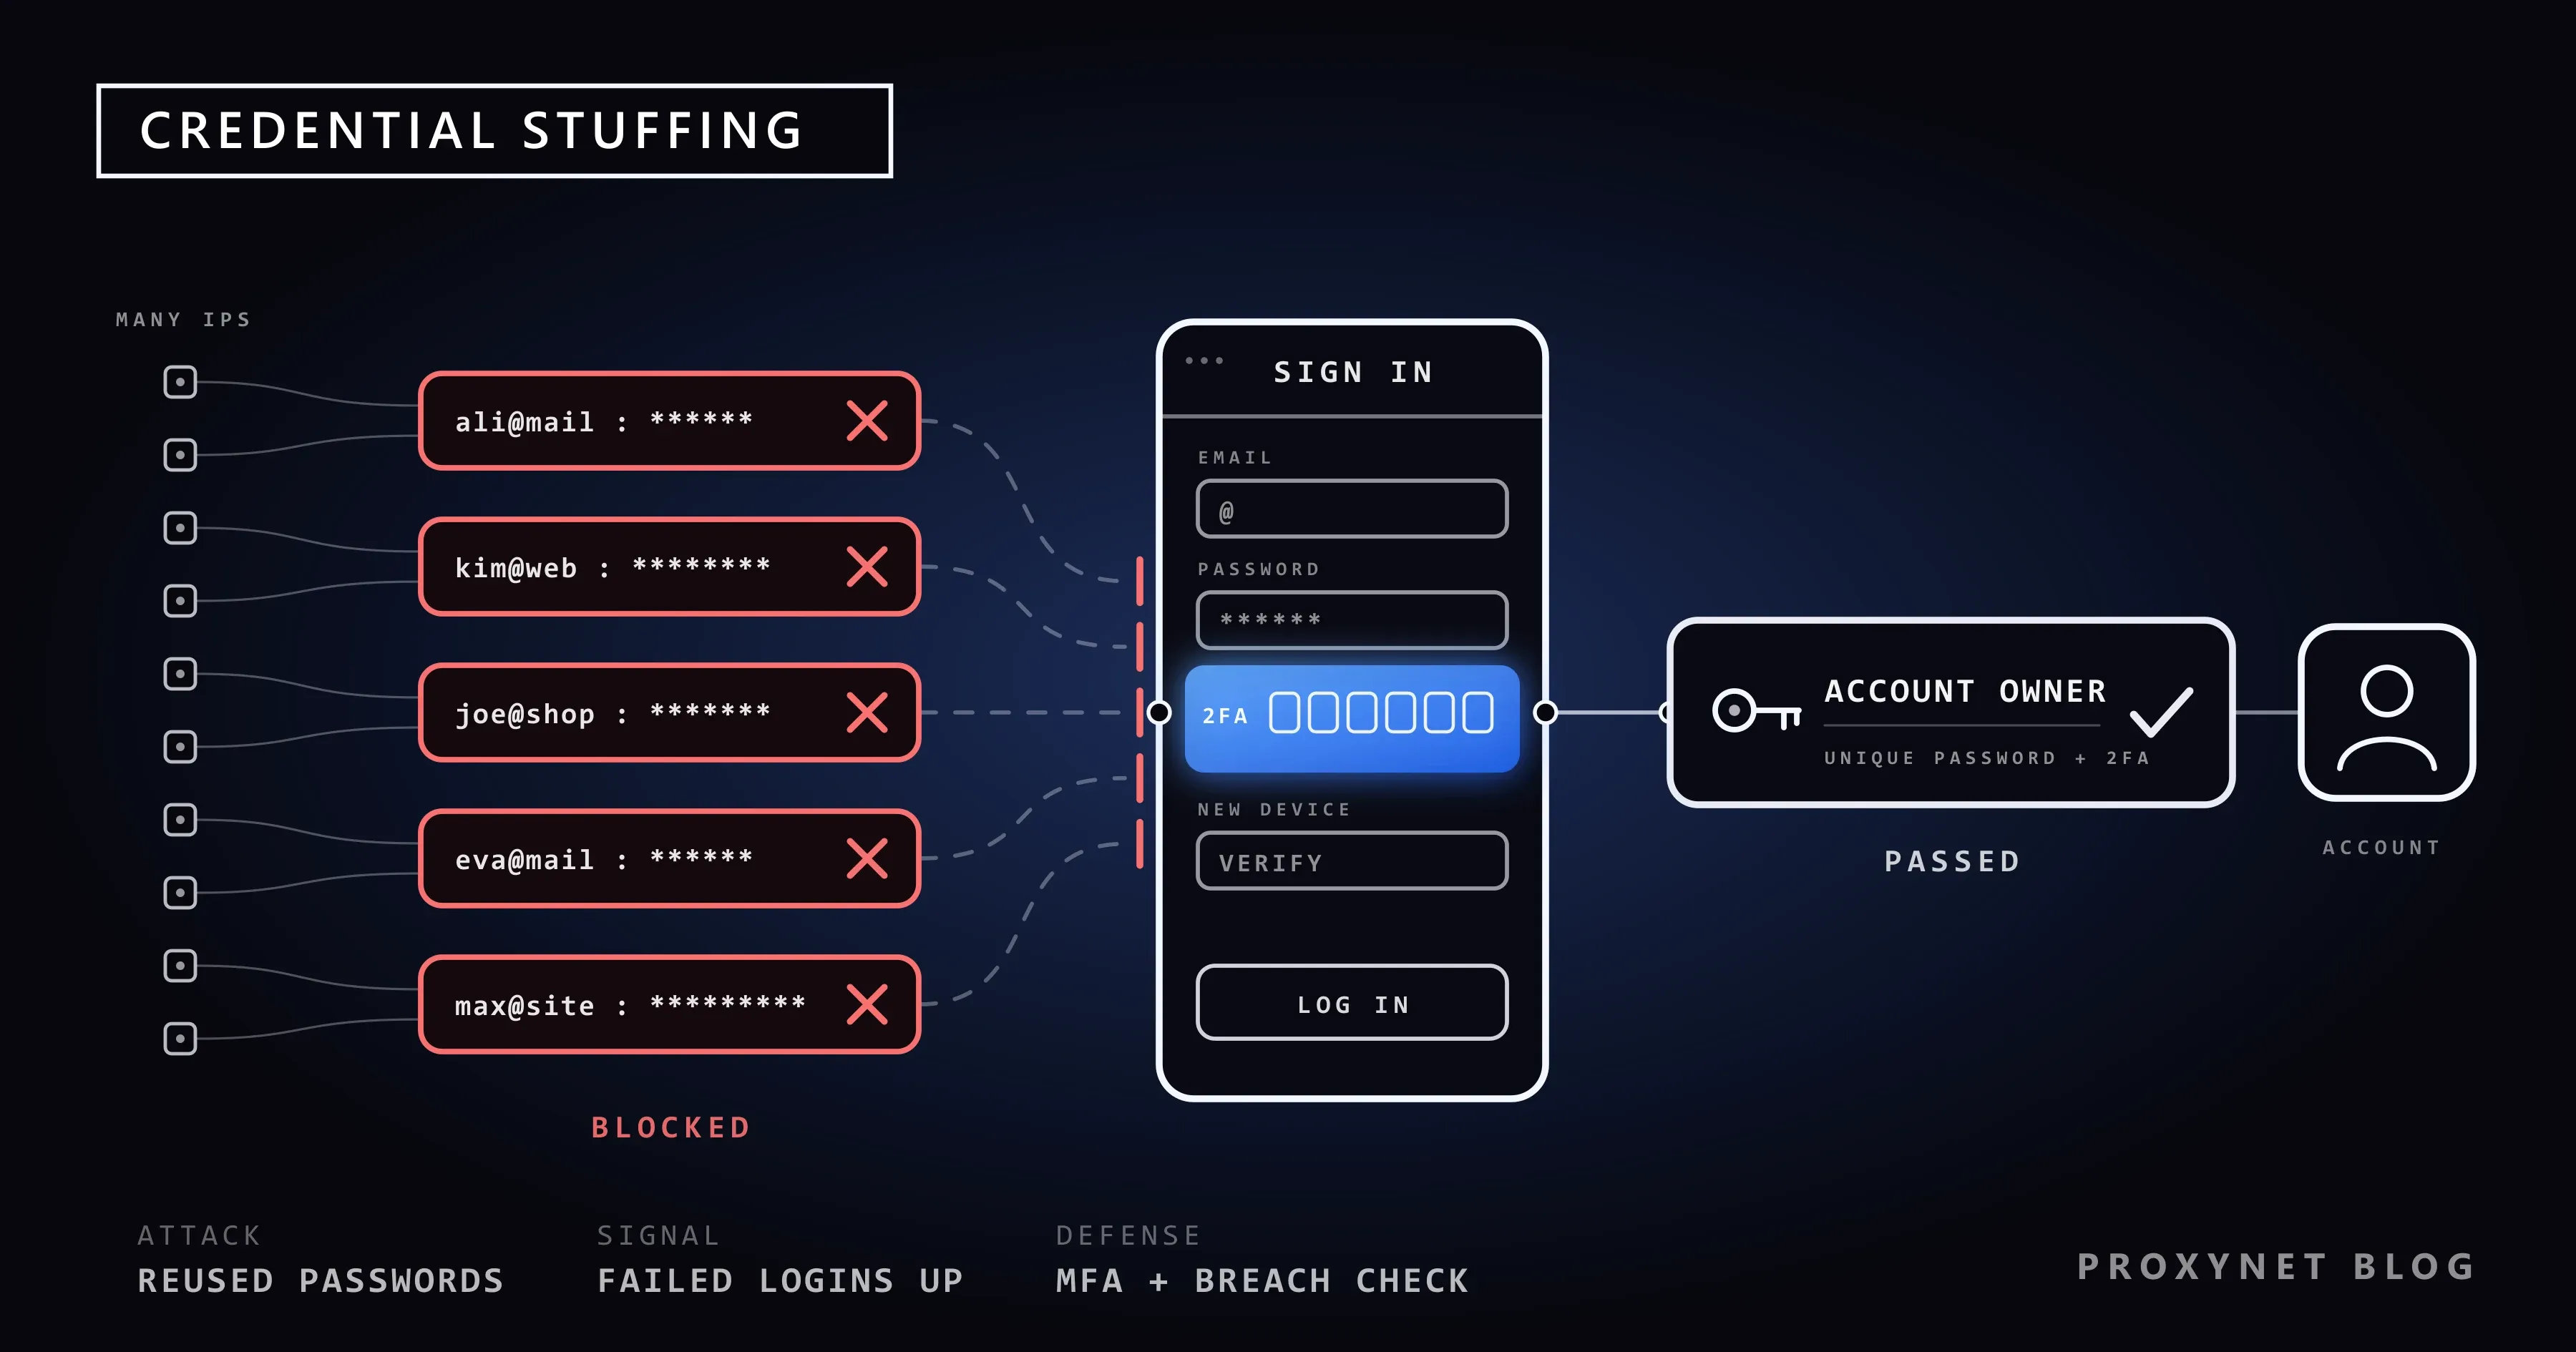
Publicado
¿Qué es el credential stuffing? Cómo detectarlo y frenarlo
El credential stuffing es la reutilización automatizada de usuarios y contraseñas filtrados en otros sitios. Cómo funciona, sus señales y cómo frenarlo.
Autor:Acar Diveroli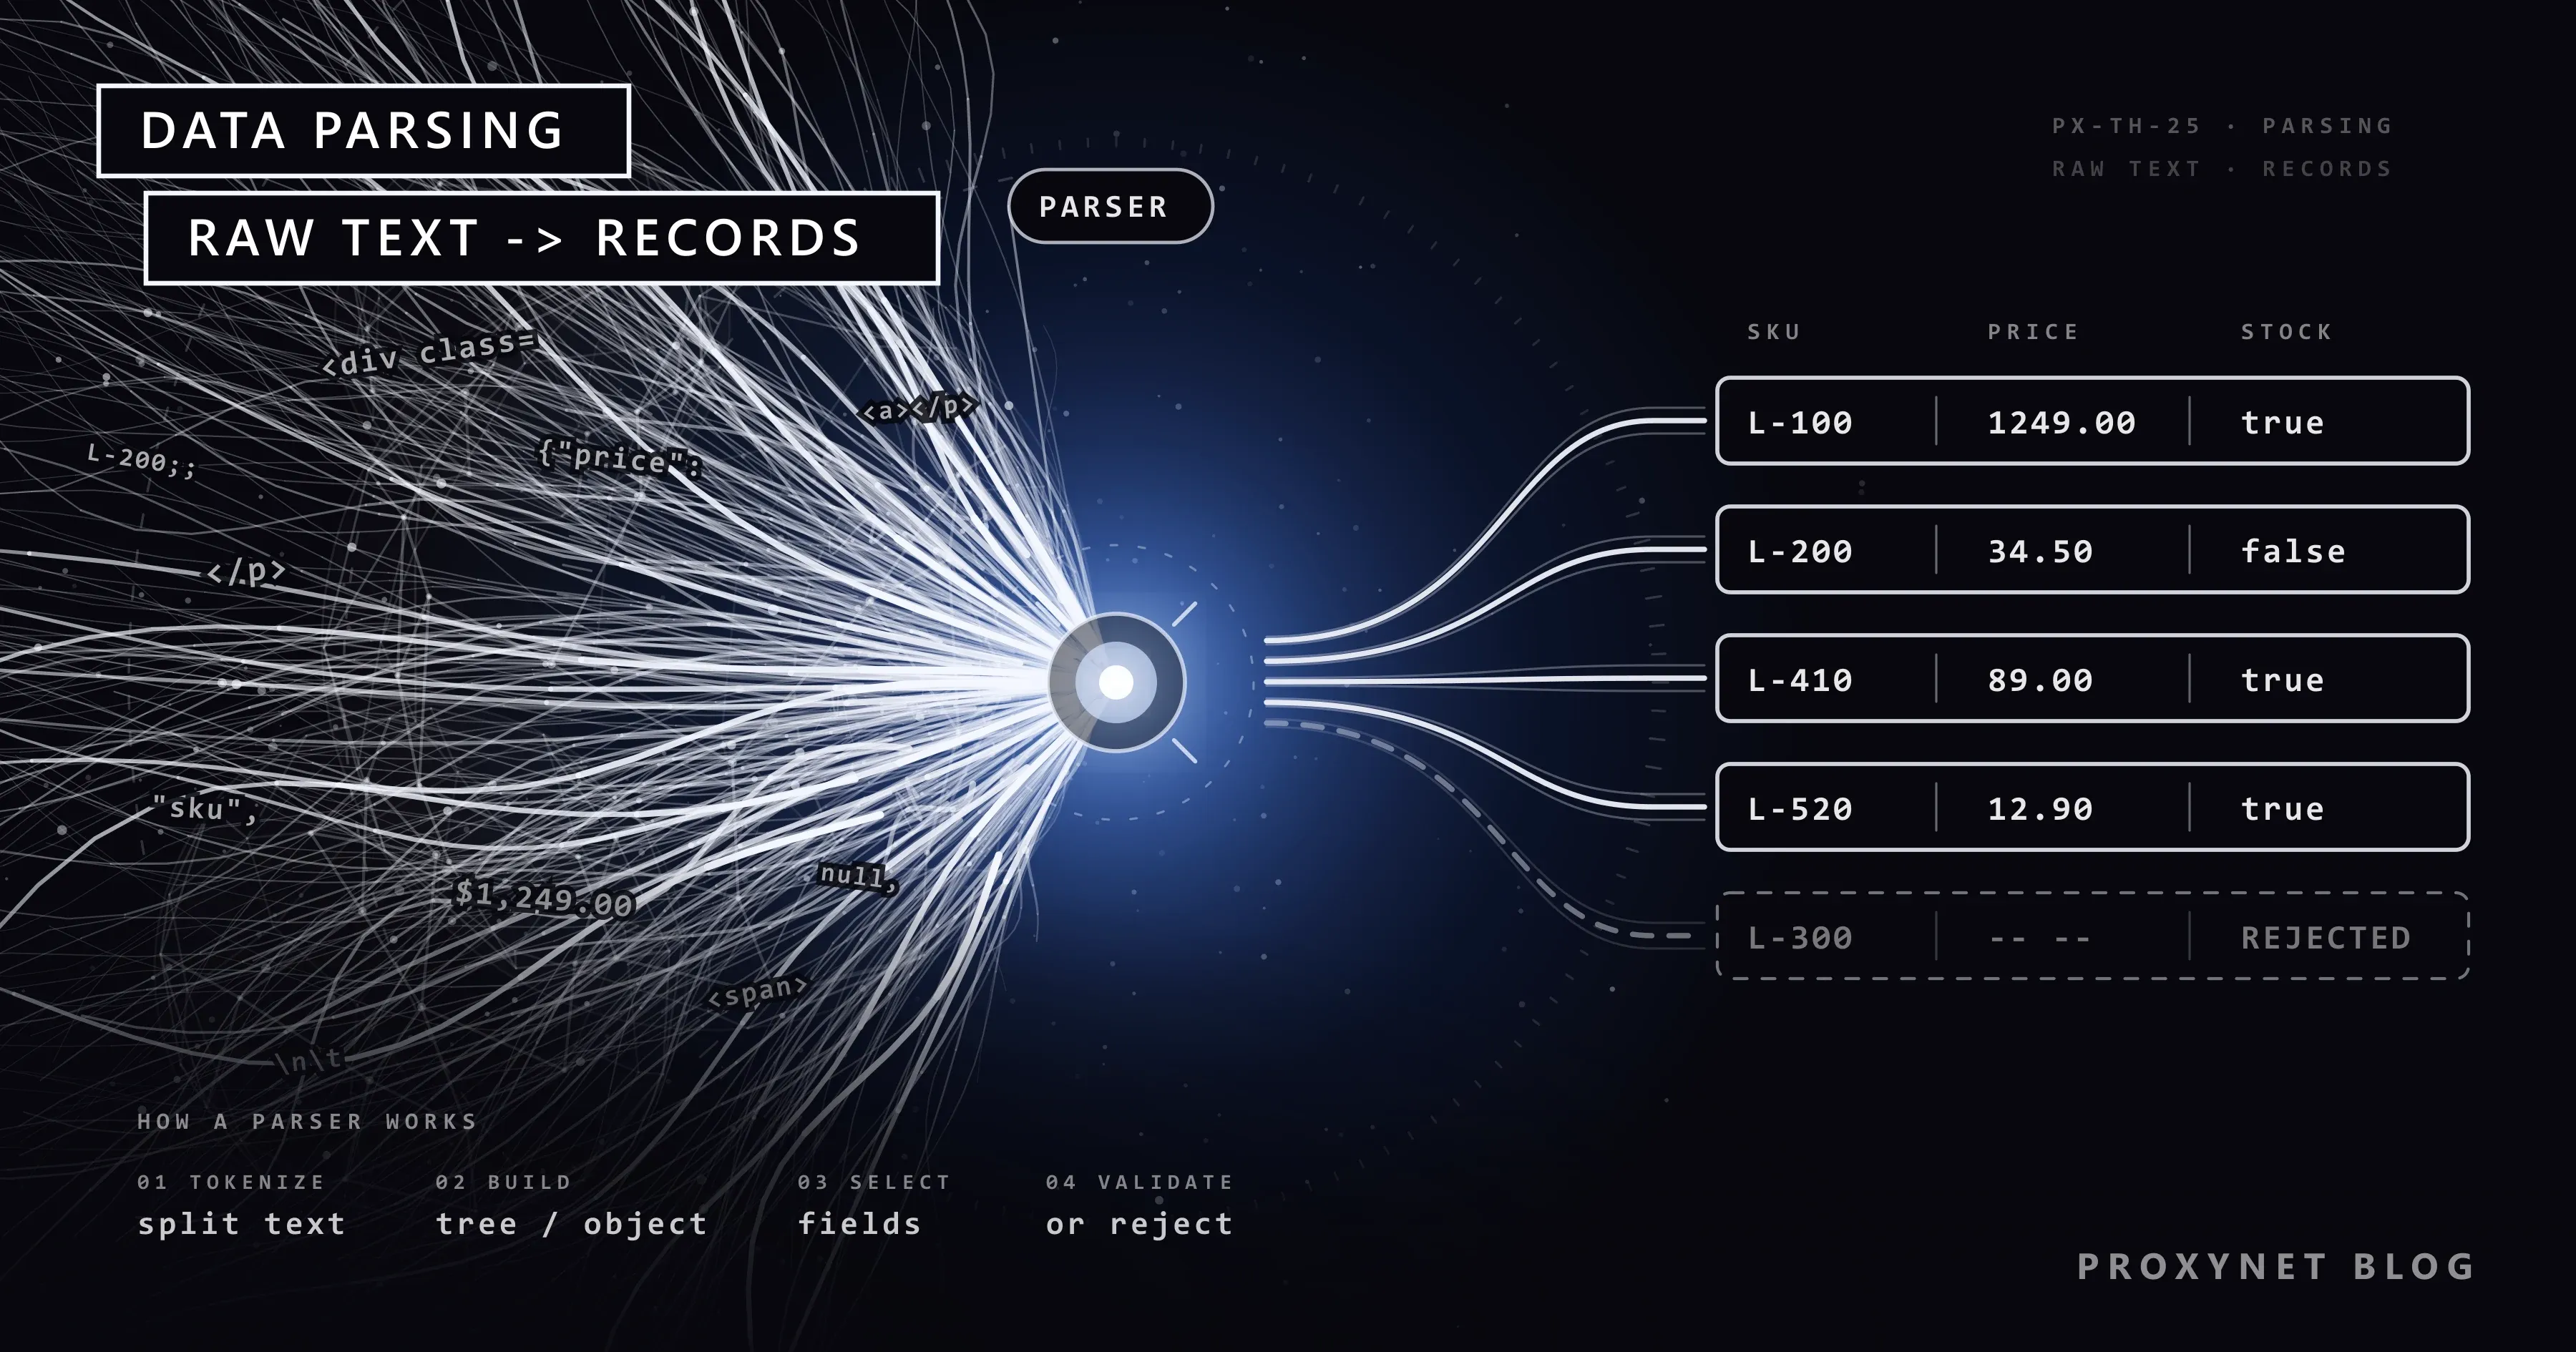
Publicado
¿Qué es el parsing de datos? Tipos, errores y ejemplos
El parsing de datos convierte HTML, JSON, CSV o logs en registros estructurados que tu código puede usar. Cómo funciona un parser, sus tipos y errores comunes.
Autor:Acar Diveroli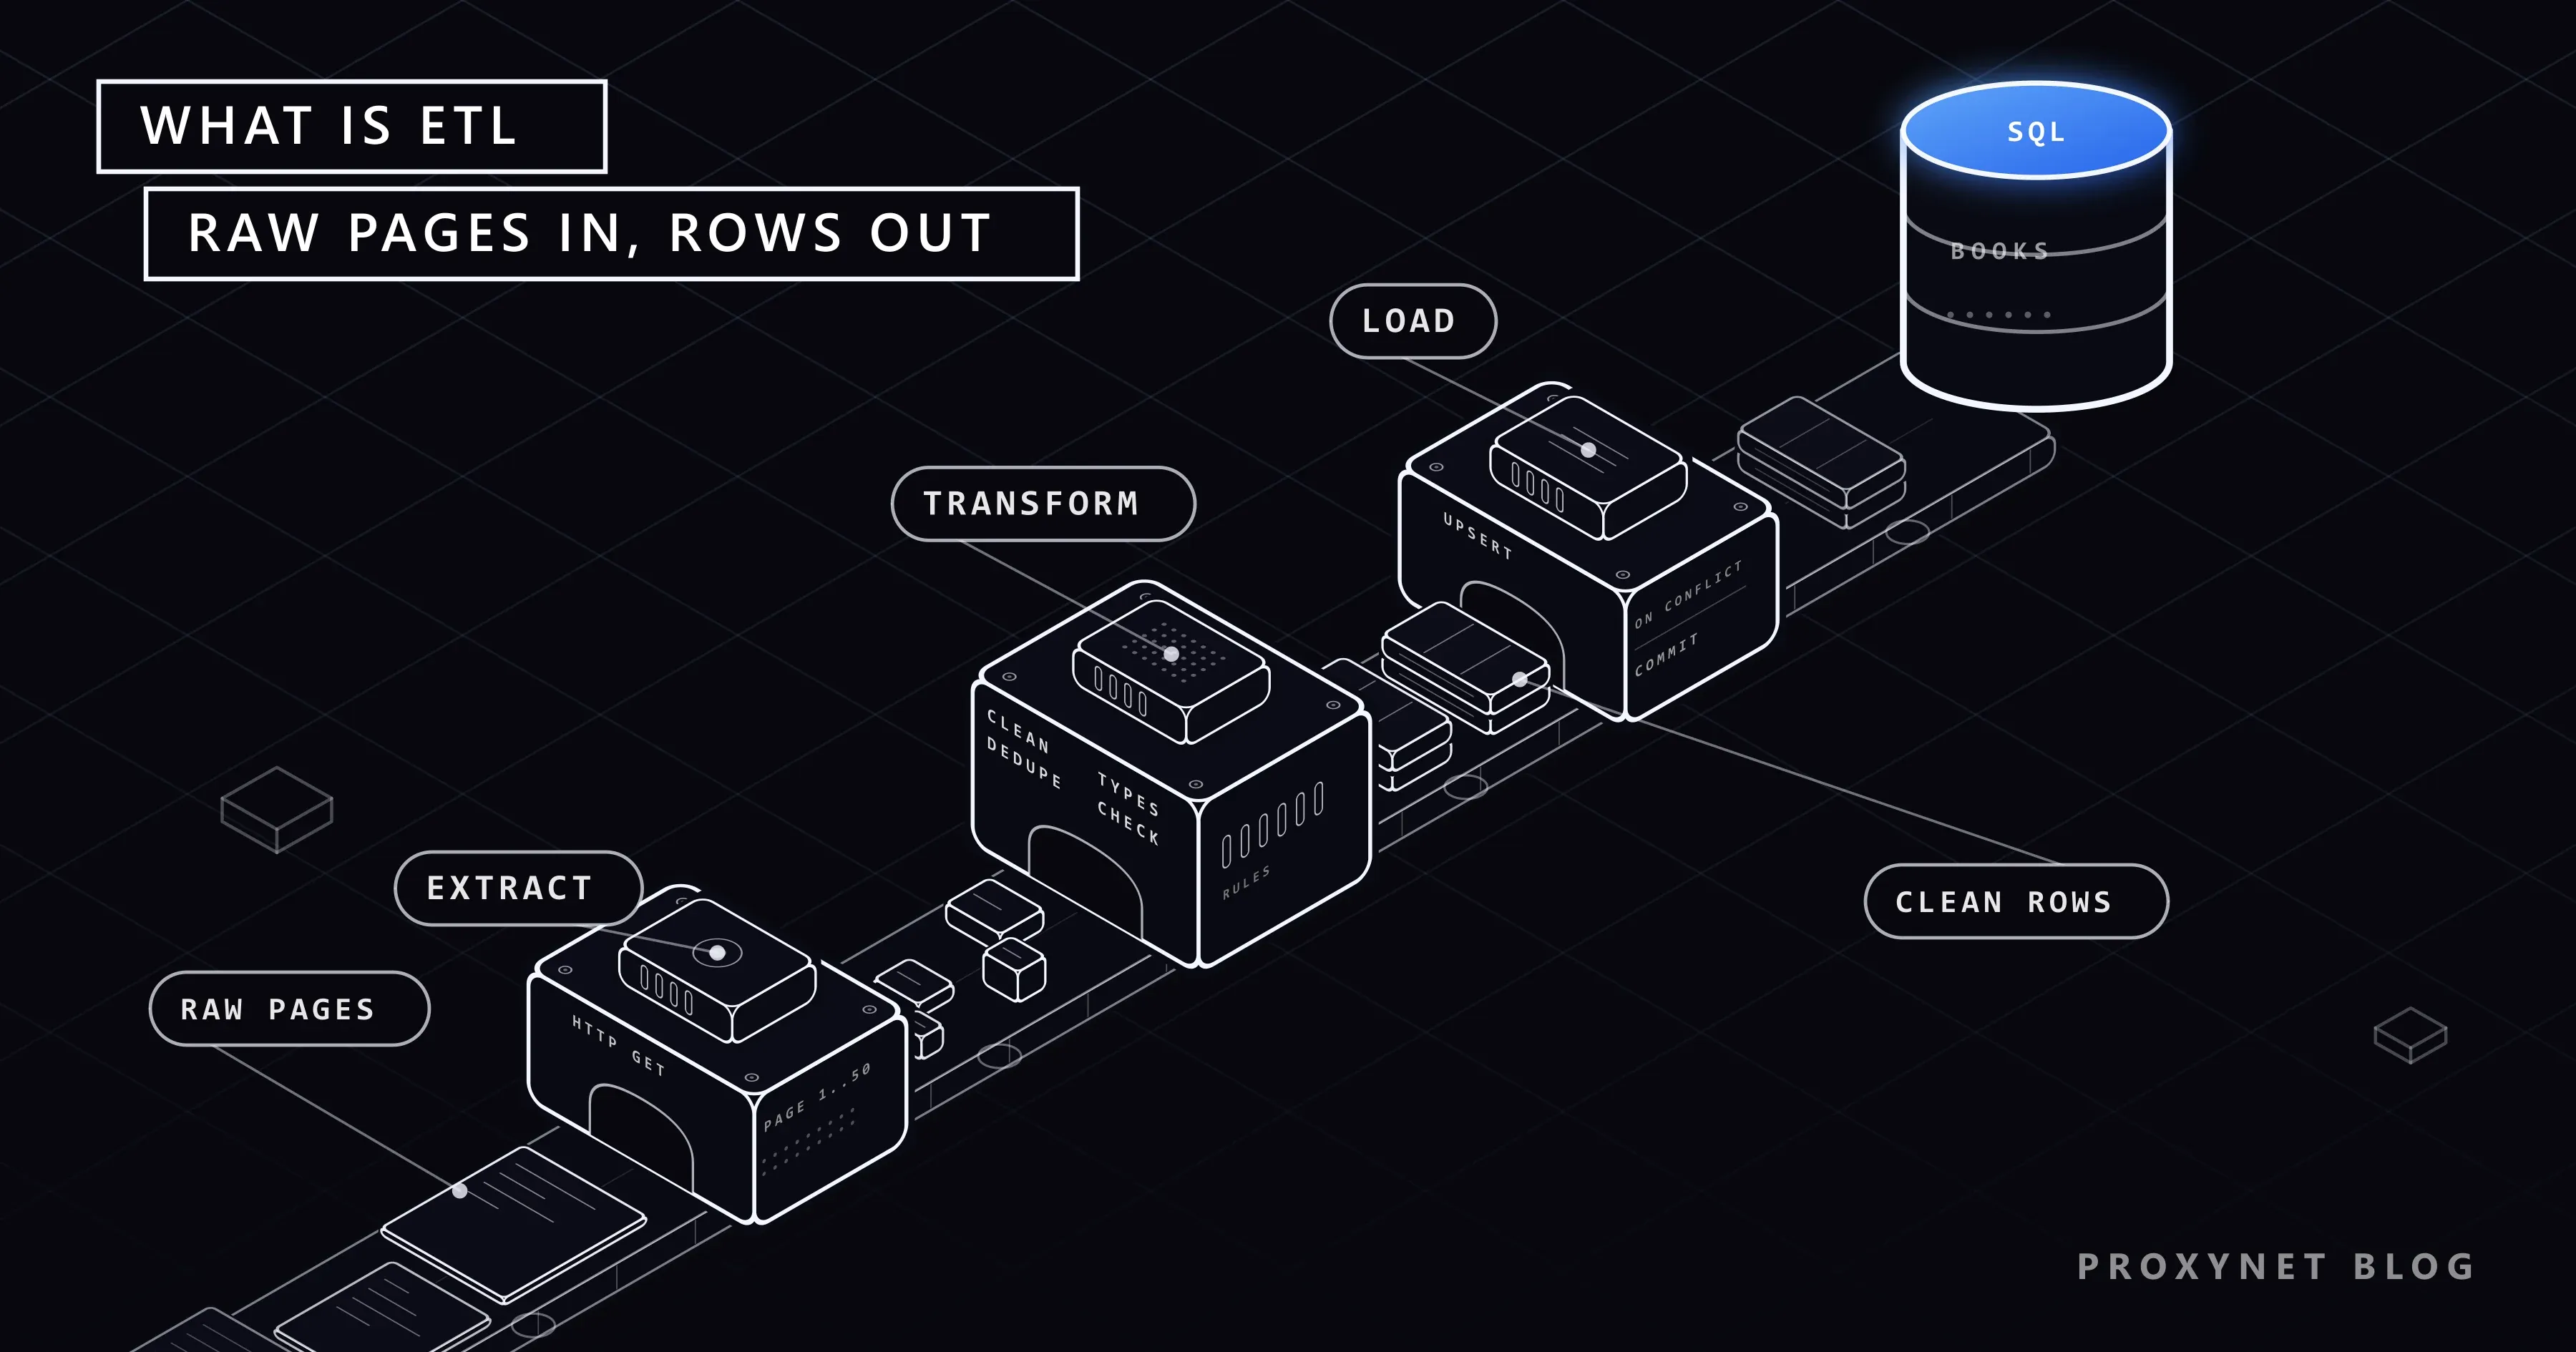
Publicado
¿Qué es ETL? Extracción, transformación y carga con Python
ETL es extraer datos de una fuente, limpiarlos en una forma fija y cargarlos en una base de datos. Cómo funciona, ETL vs. ELT y un job de Python probado.
Autor:Acar Diveroli
¿Qué es el web scraping y cómo funciona?
Autor: Acar DiveroliWeb scrapingPublicado
Proxy de WhatsApp: cómo activarlo y desactivarlo
Autor: Acar DiveroliTutorialesPublicado
Web scraping con Cheerio en Node.js: tutorial paso a paso
Autor: Acar DiveroliTutorialesPublicado
Cómo limpiar datos de scraping con pandas en Python
Autor: Acar DiveroliTutorialesPublicado
Cómo extraer datos de un PDF: tablas, texto y OCR
Autor: Acar DiveroliTutorialesPublicado
Cómo tratar datos personales (PII) en datos de scraping
Autor: Acar DiveroliWeb scrapingPublicado
Cómo guardar datos de scraping en CSV, JSON y SQLite
Autor: Acar DiveroliTutorialesPublicado
Análisis de sentimiento en Python: VADER vs Hugging Face
Autor: Acar DiveroliTutorialesPublicado
¿Qué son los datos alternativos? Fuentes, usos y riesgos
Autor: Acar DiveroliCasos de usoPublicado
¿Qué es el credential stuffing? Cómo detectarlo y frenarlo
Autor: Acar DiveroliProxy 101Publicado
¿Qué es el parsing de datos? Tipos, errores y ejemplos
Autor: Acar DiveroliWeb scrapingPublicado
¿Qué es ETL? Extracción, transformación y carga con Python
Autor: Acar DiveroliWeb scrapingPublicado
Ningún artículo coincide
Publicado
Publicado