

































Blog da Proxynet – Página 10

Publicado
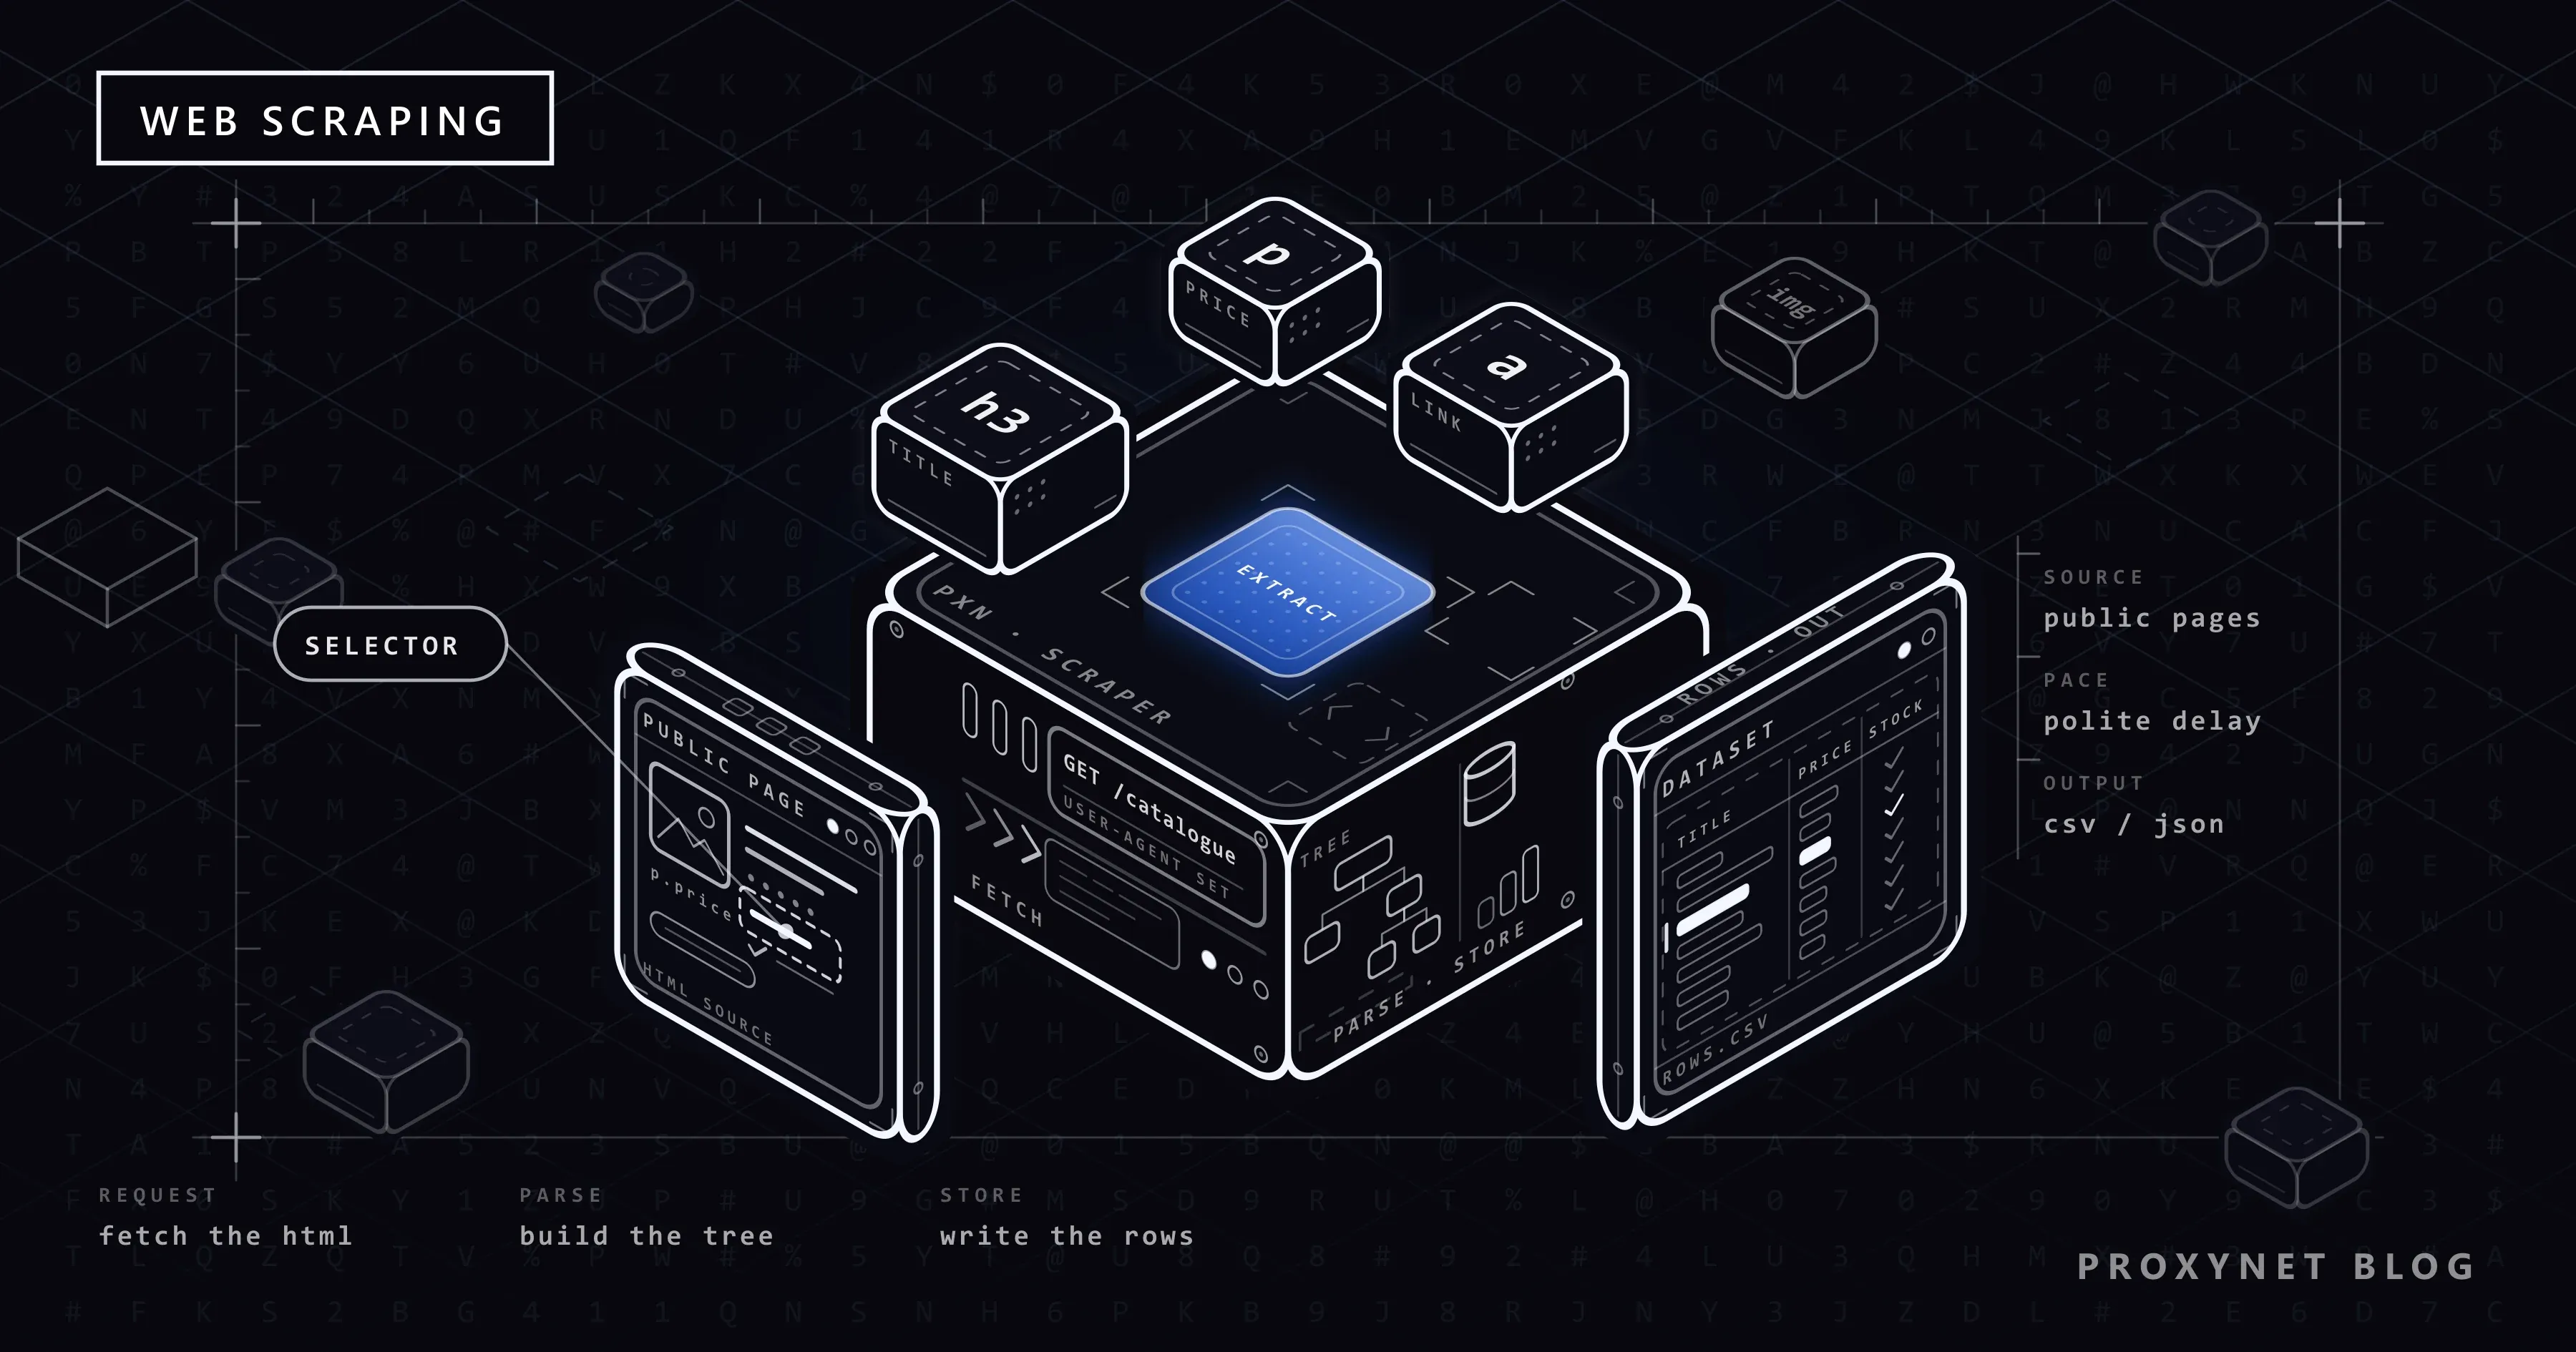
O que é web scraping e como funciona?
Web scraping é a coleta automática de dados de páginas web: um programa baixa o HTML, extrai campos e os salva. Veja como funciona e para que serve.
Autor: Acar Diveroli
Publicado
Proxy do WhatsApp: como ativar e desativar
O proxy do WhatsApp fica em Configurações > Armazenamento e dados. Veja como ativar e desativar e por que um proxy HTTP ou SOCKS5 não funciona ali.
Autor:Acar Diveroli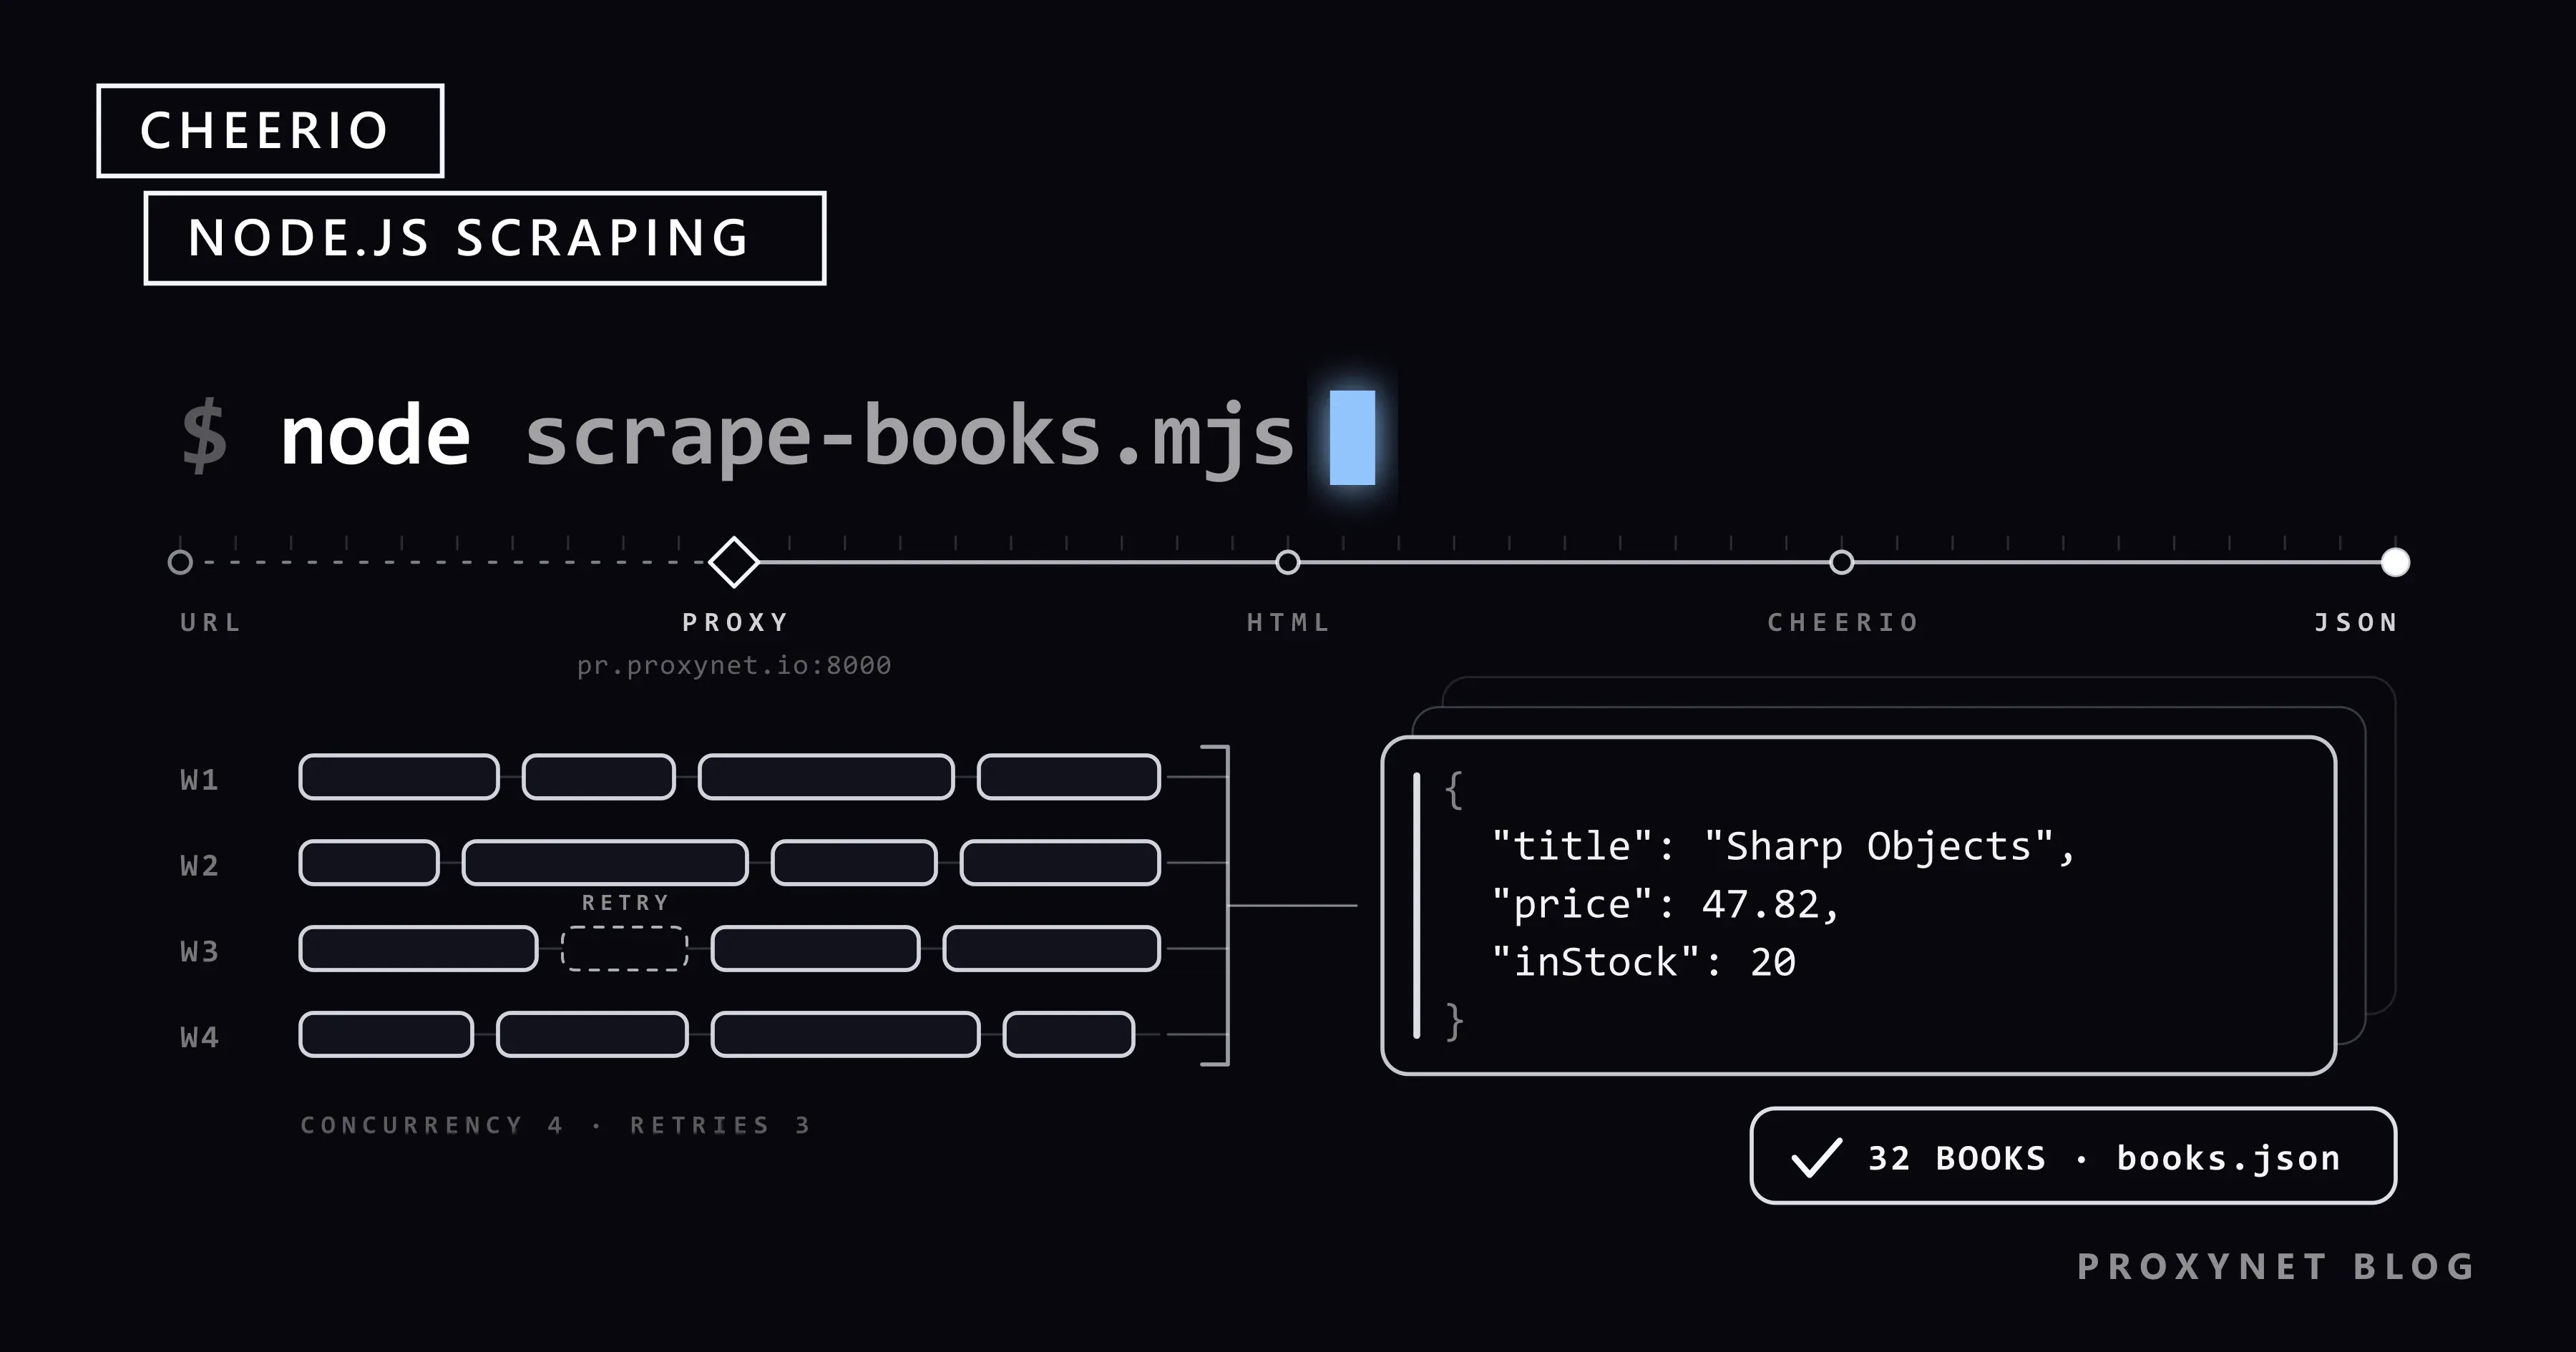
Publicado
Web scraping com Cheerio no Node.js: tutorial passo a passo
O Cheerio analisa HTML no Node.js com seletores no estilo jQuery. Crie um scraper testado com fetch, paginação, limite de concorrência, retentativas e proxy.
Autor:Acar Diveroli
Publicado
Como limpar dados de scraping com pandas em Python
Limpe dados de scraping com pandas: primeiro o texto, depois tipos, duplicatas, valores ausentes e outliers, e valide antes de salvar. Com script testado.
Autor:Acar Diveroli
Publicado
Como extrair dados de PDF: tabelas, texto e OCR
Verifique primeiro se o PDF tem camada de texto. Se tiver, o Excel ou o pdfplumber leem as tabelas; páginas digitalizadas precisam de OCR. Com código testado.
Autor:Acar Diveroli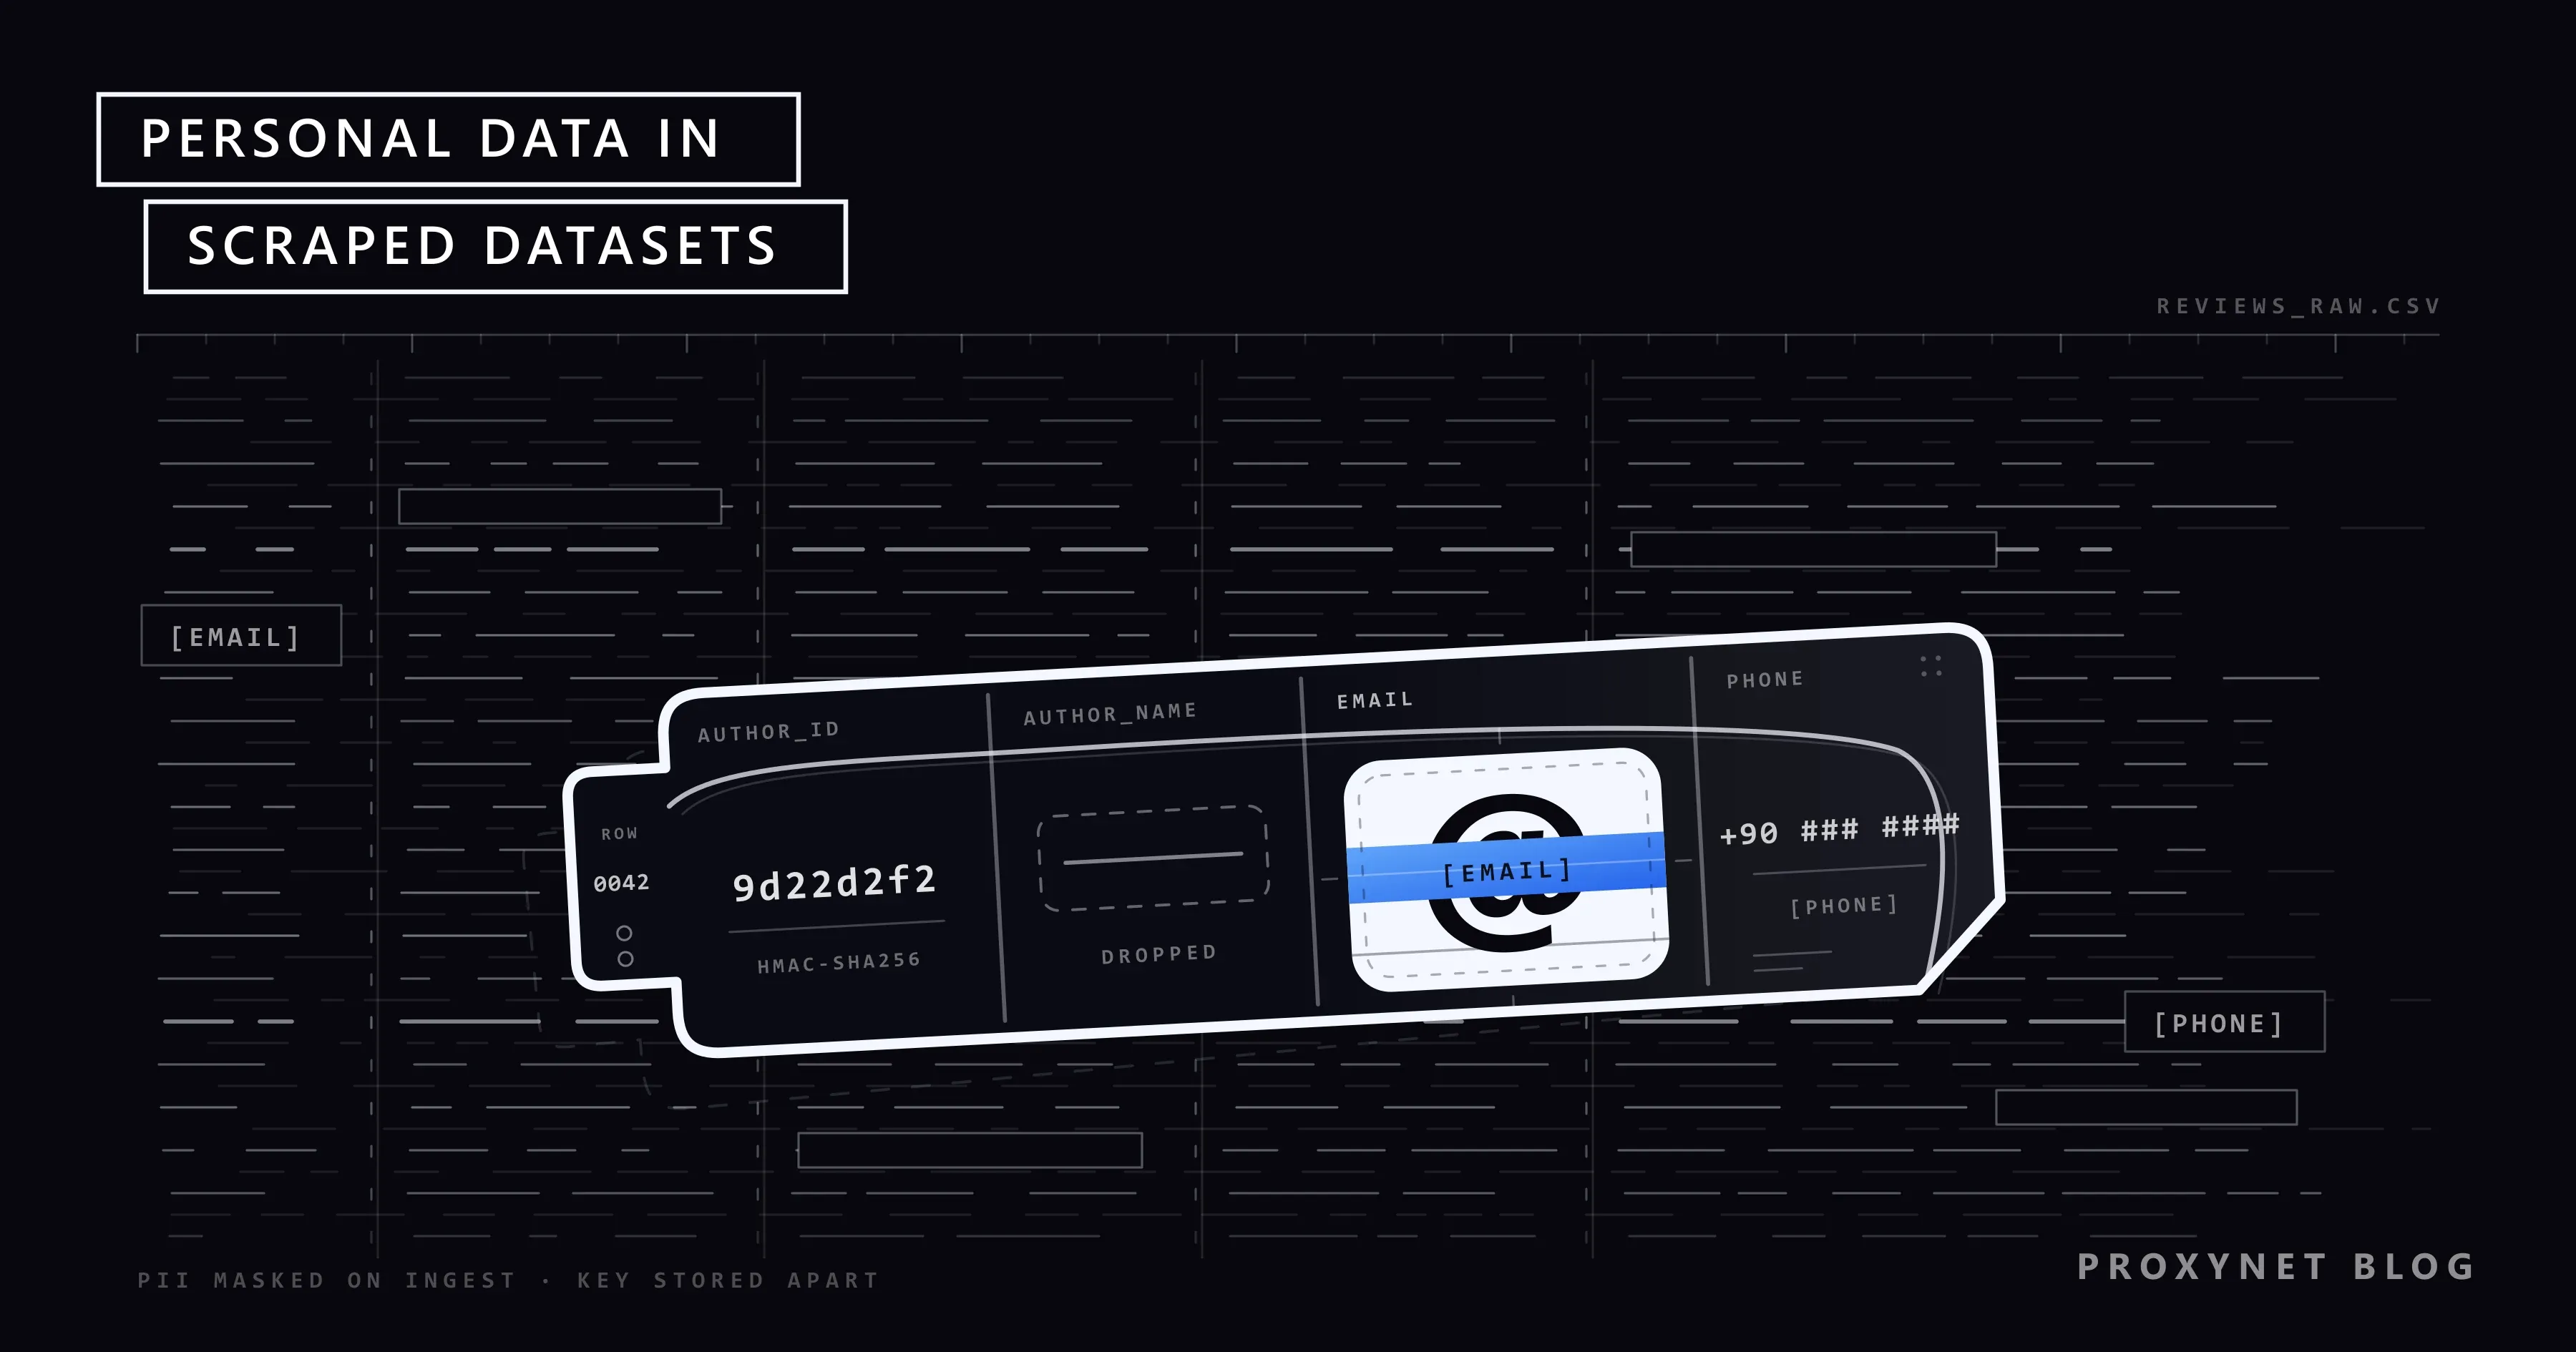
Publicado
Como tratar dados pessoais (PII) em dados de scraping
Dados de scraping costumam trazer dados pessoais: nomes, perfis, e-mails e telefones. Como encontrá-los, reduzi-los, mascará-los e armazená-los com segurança.
Autor:Acar Diveroli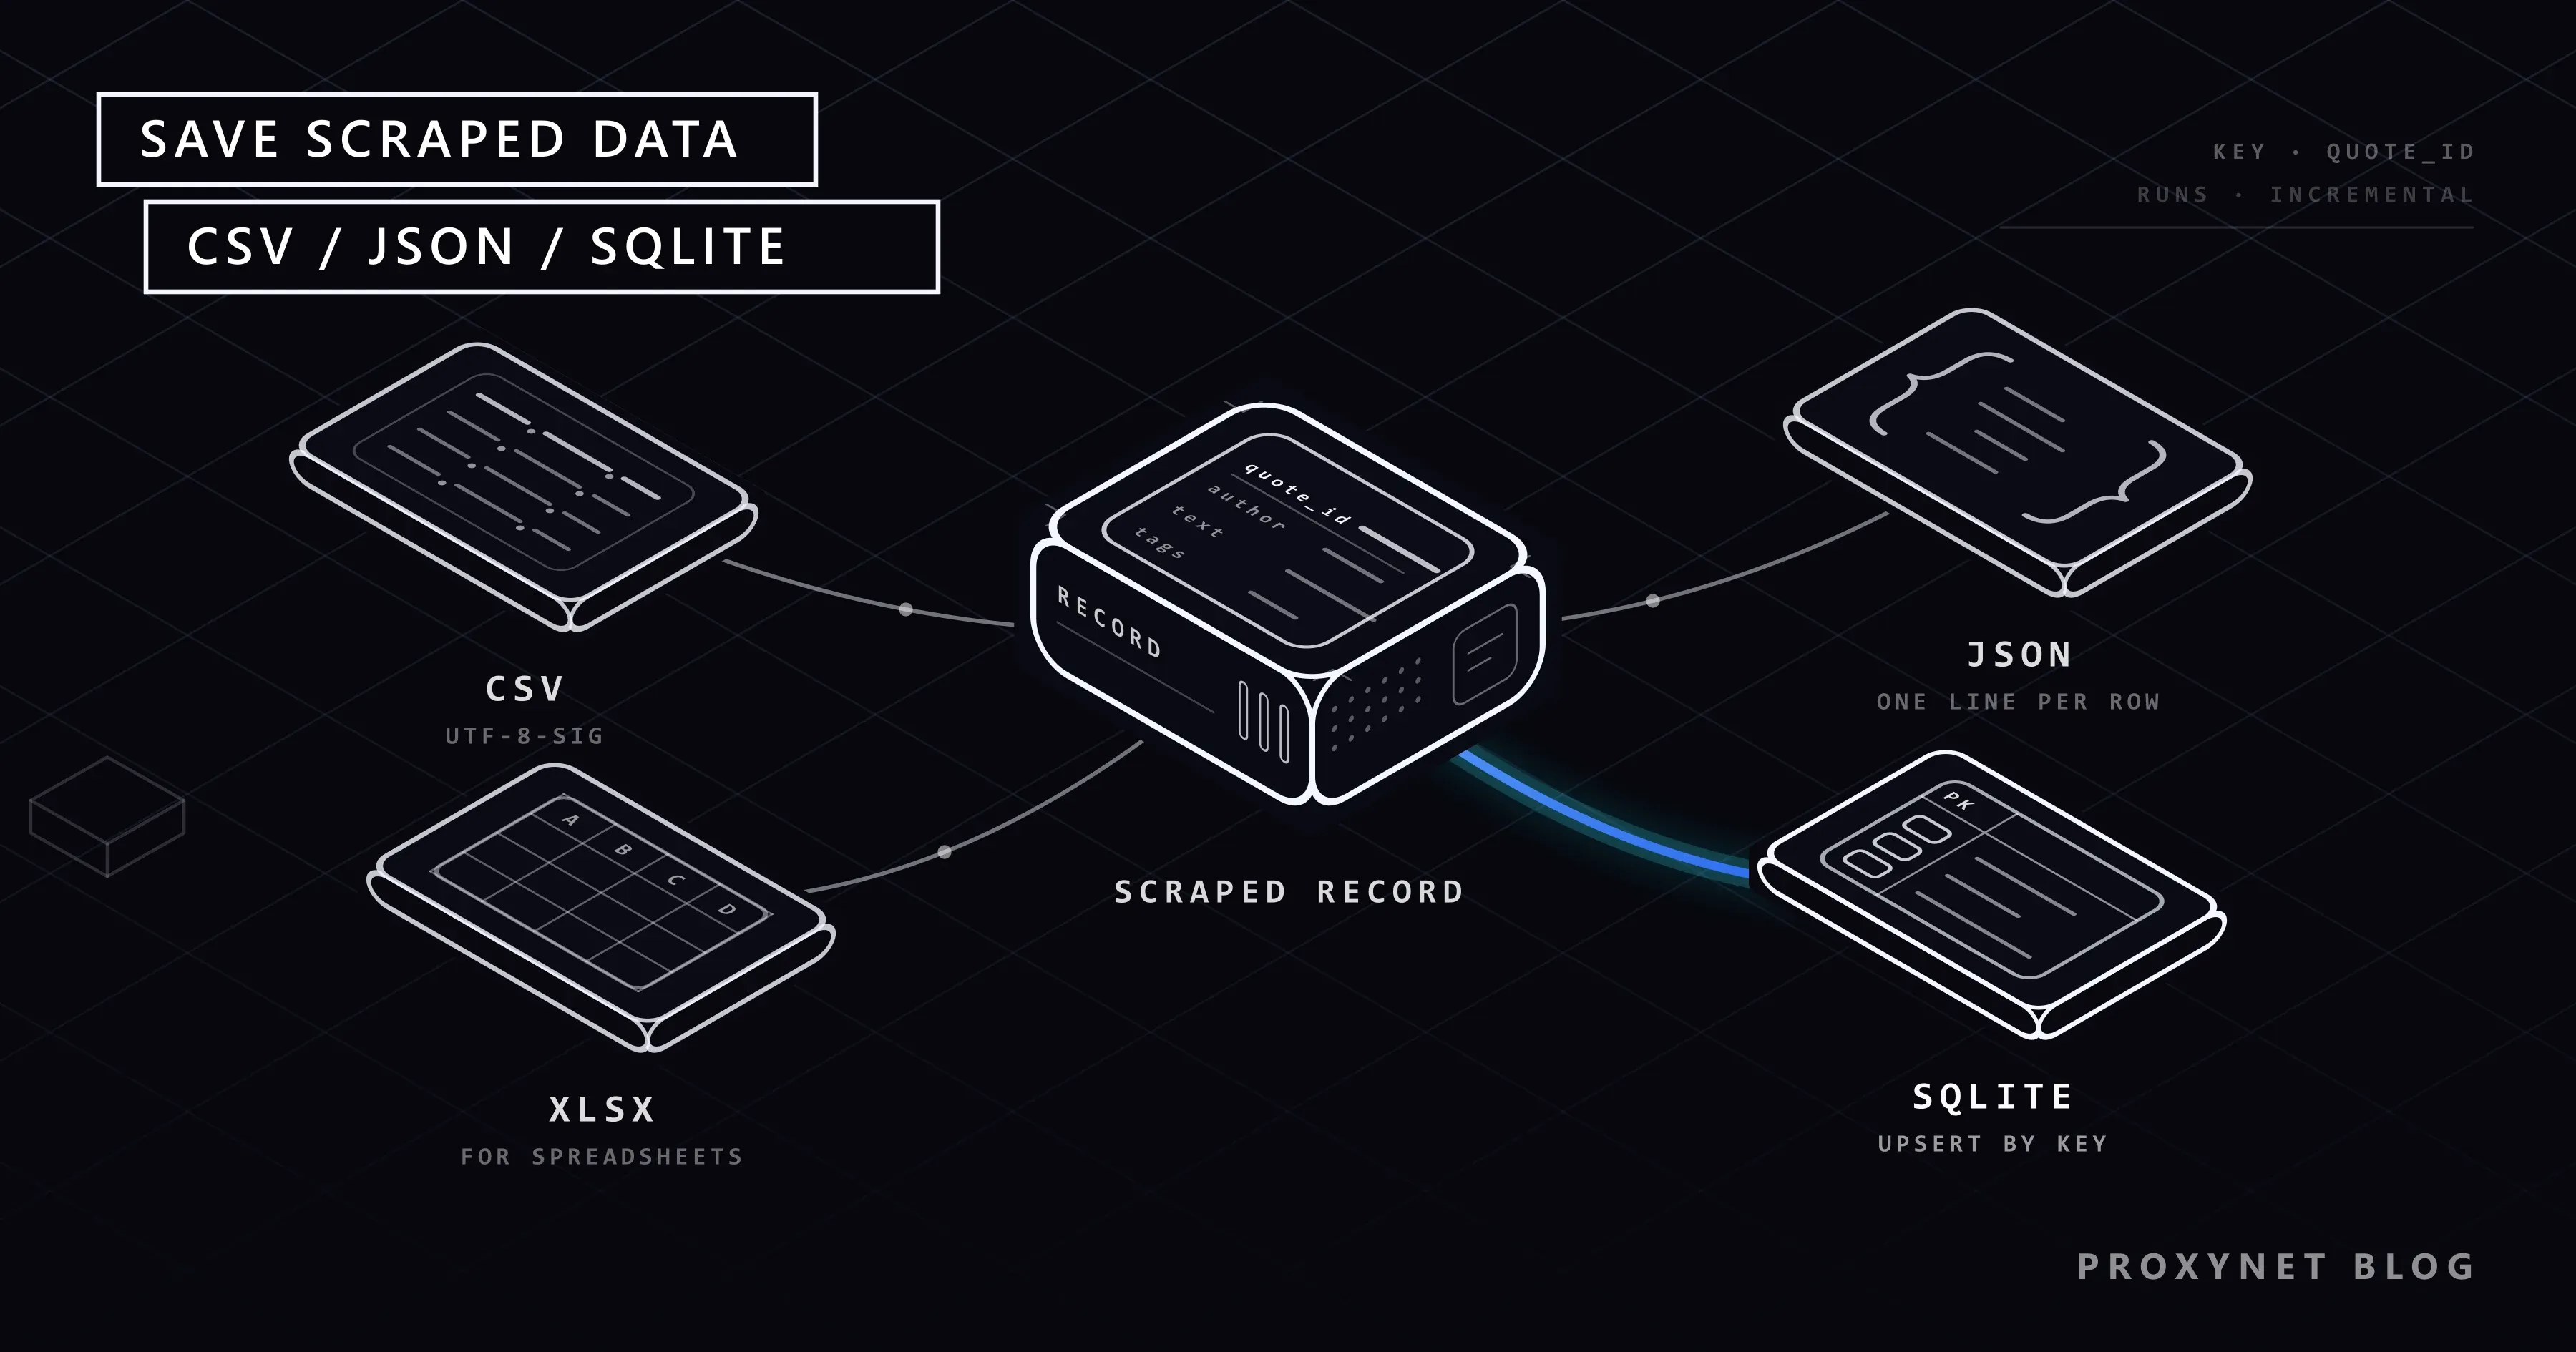
Publicado
Como salvar dados de scraping em CSV, JSON e SQLite
Salve os dados coletados em CSV para planilhas, JSON Lines para logs que só crescem e SQLite para execuções sem duplicatas. Com código Python testado.
Autor:Acar Diveroli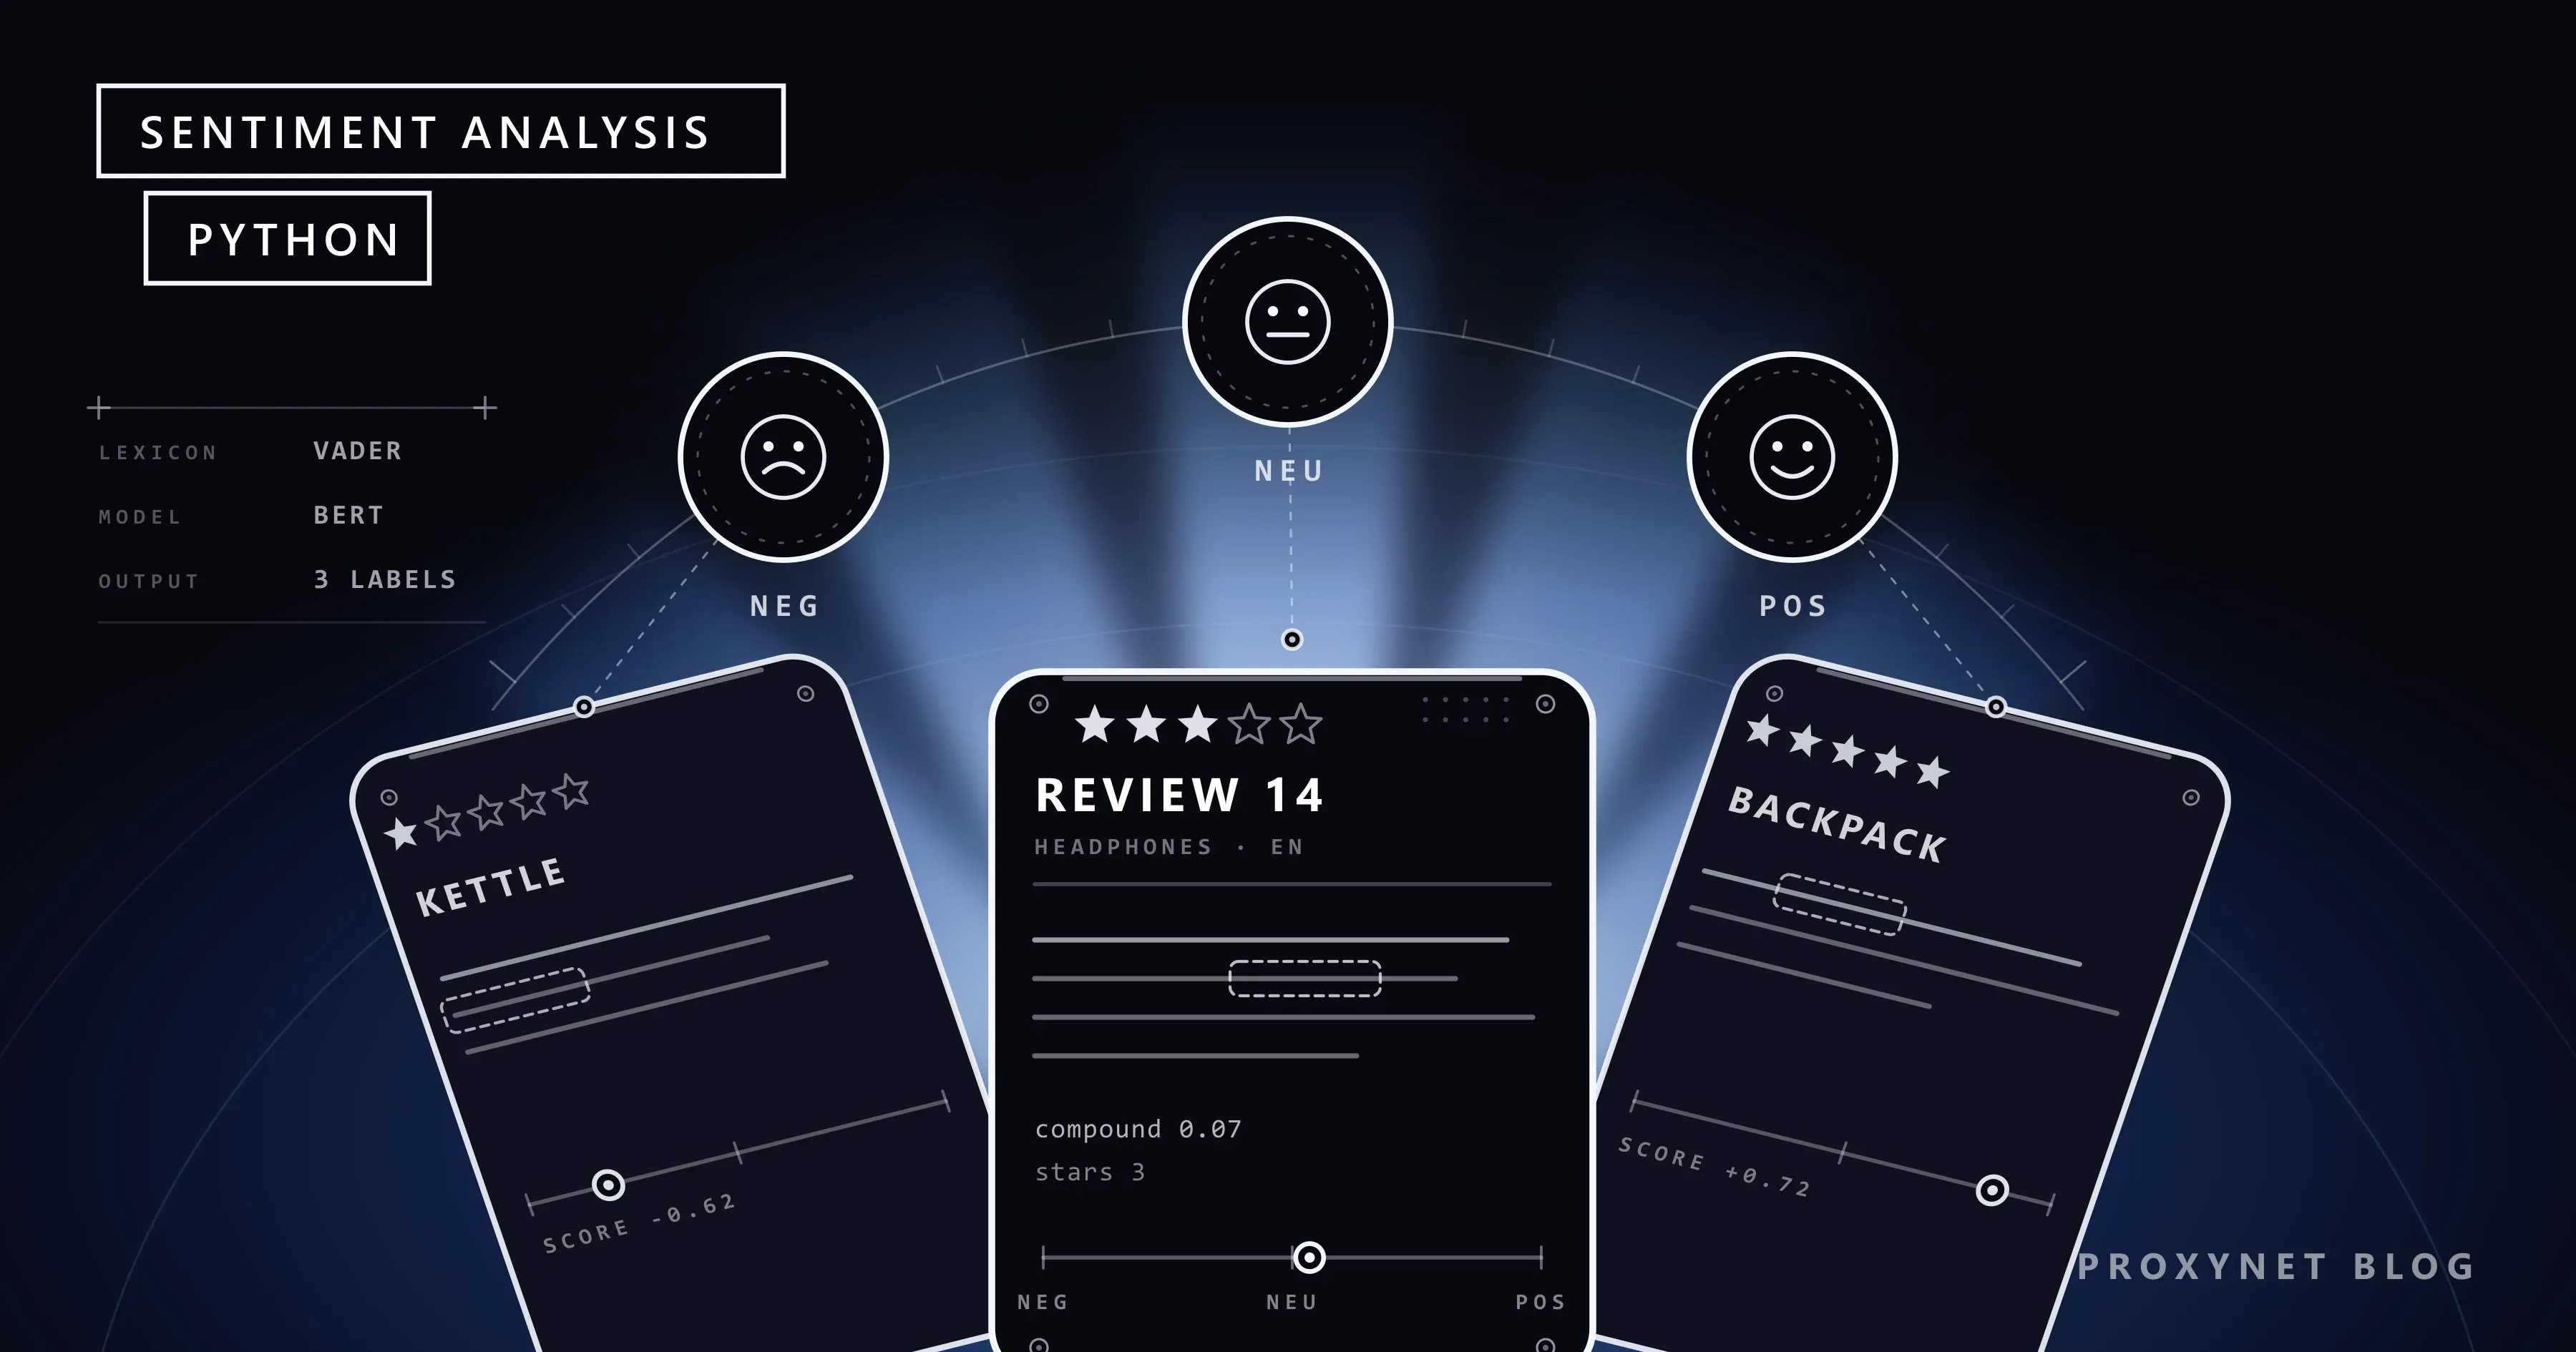
Publicado
Análise de sentimento em Python: VADER vs Hugging Face
A análise de sentimento em Python classifica texto como positivo, neutro ou negativo. Pontuamos avaliações com o VADER do NLTK e um modelo do Hugging Face.
Autor:Acar Diveroli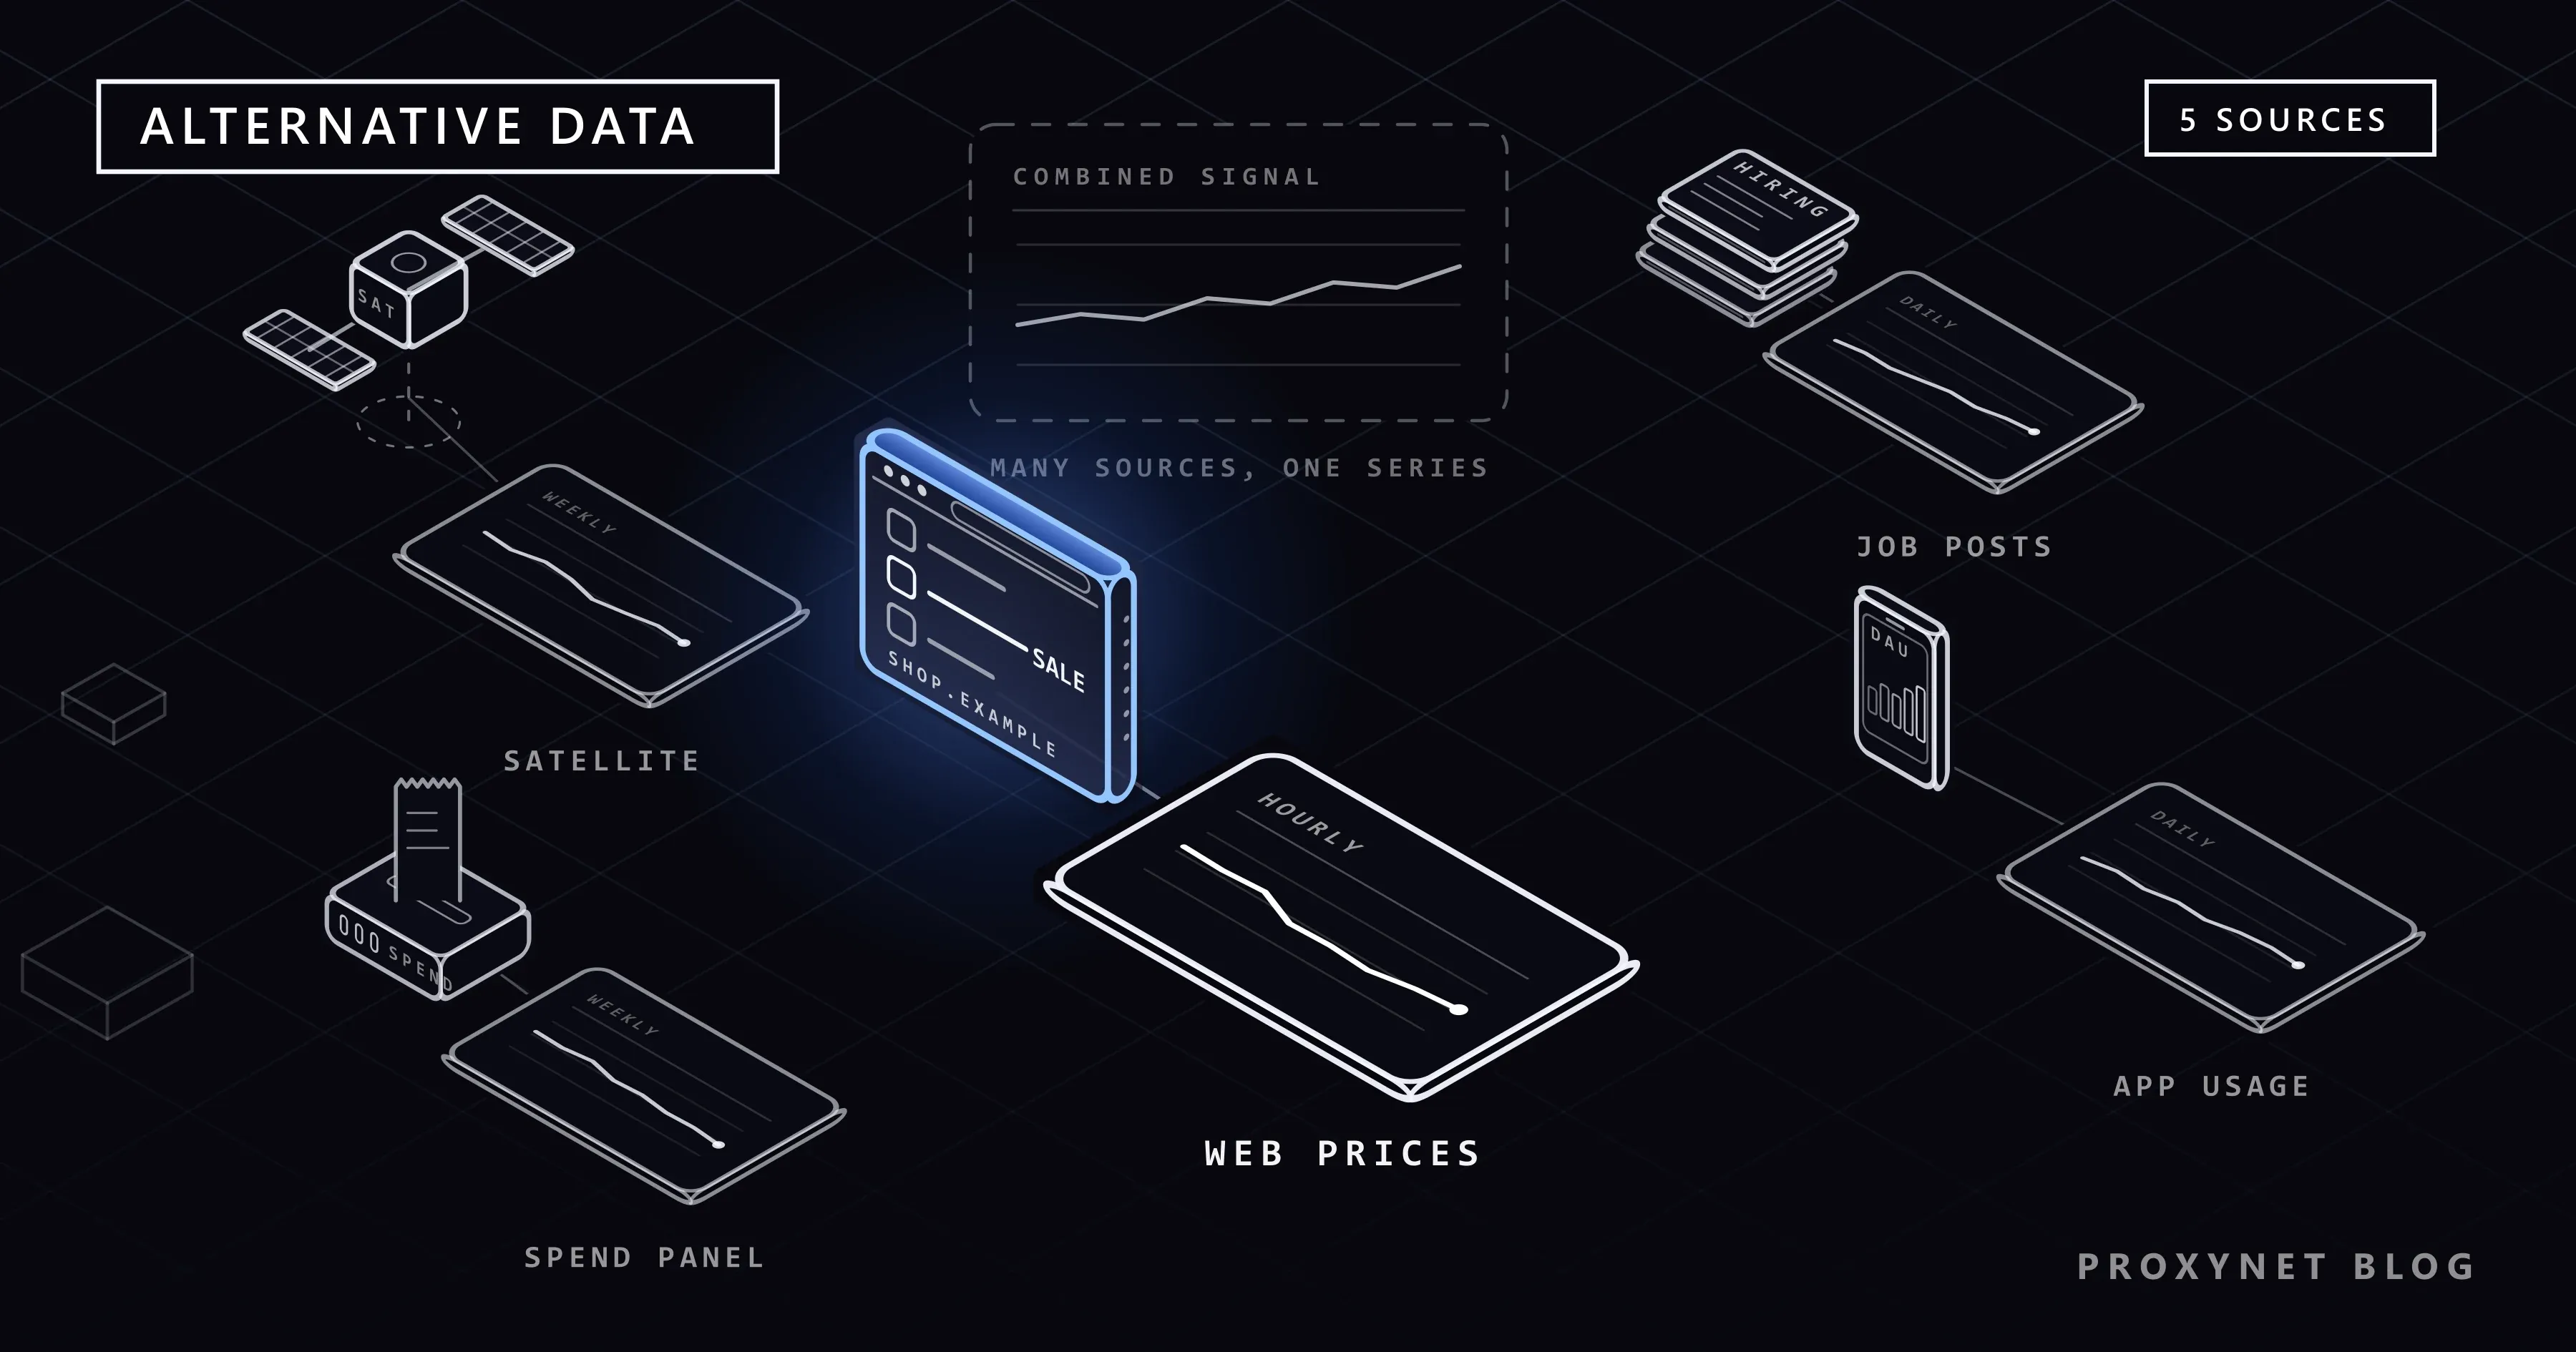
Publicado
O que são dados alternativos? Fontes, usos e riscos
Dados alternativos vêm de fora dos relatórios da empresa: preços na web, vagas de emprego, painéis de cartão e imagens de satélite. Fontes, usos e compliance.
Autor:Acar Diveroli
Publicado
O que é credential stuffing? Como detectar e impedir
Credential stuffing é a reutilização automatizada de logins e senhas vazados em outros sites. Como funciona, os sinais nos seus logs e como impedir.
Autor:Acar Diveroli
Publicado
O que é parsing de dados? Tipos, erros e exemplos
O parsing de dados transforma HTML, JSON, CSV ou logs em registros estruturados para o seu código. Como um parser funciona, os tipos e os erros mais comuns.
Autor:Acar Diveroli
Publicado
O que é ETL? Extração, transformação e carga com Python
ETL é extrair dados de uma fonte, limpá-los em um formato fixo e carregá-los em um banco de dados. Como funciona, ETL vs. ELT e um job em Python testado.
Autor:Acar Diveroli
O que é web scraping e como funciona?
Autor: Acar DiveroliWeb scrapingPublicado
Proxy do WhatsApp: como ativar e desativar
Autor: Acar DiveroliTutoriaisPublicado
Web scraping com Cheerio no Node.js: tutorial passo a passo
Autor: Acar DiveroliTutoriaisPublicado
Como limpar dados de scraping com pandas em Python
Autor: Acar DiveroliTutoriaisPublicado
Como extrair dados de PDF: tabelas, texto e OCR
Autor: Acar DiveroliTutoriaisPublicado
Como tratar dados pessoais (PII) em dados de scraping
Autor: Acar DiveroliWeb scrapingPublicado
Como salvar dados de scraping em CSV, JSON e SQLite
Autor: Acar DiveroliTutoriaisPublicado
Análise de sentimento em Python: VADER vs Hugging Face
Autor: Acar DiveroliTutoriaisPublicado
O que são dados alternativos? Fontes, usos e riscos
Autor: Acar DiveroliCasos de usoPublicado
O que é credential stuffing? Como detectar e impedir
Autor: Acar DiveroliProxy 101Publicado
O que é parsing de dados? Tipos, erros e exemplos
Autor: Acar DiveroliWeb scrapingPublicado
O que é ETL? Extração, transformação e carga com Python
Autor: Acar DiveroliWeb scrapingPublicado
Nenhum artigo encontrado
Publicado
Publicado