
Proxynet Blog – Seite 10
Veröffentlicht
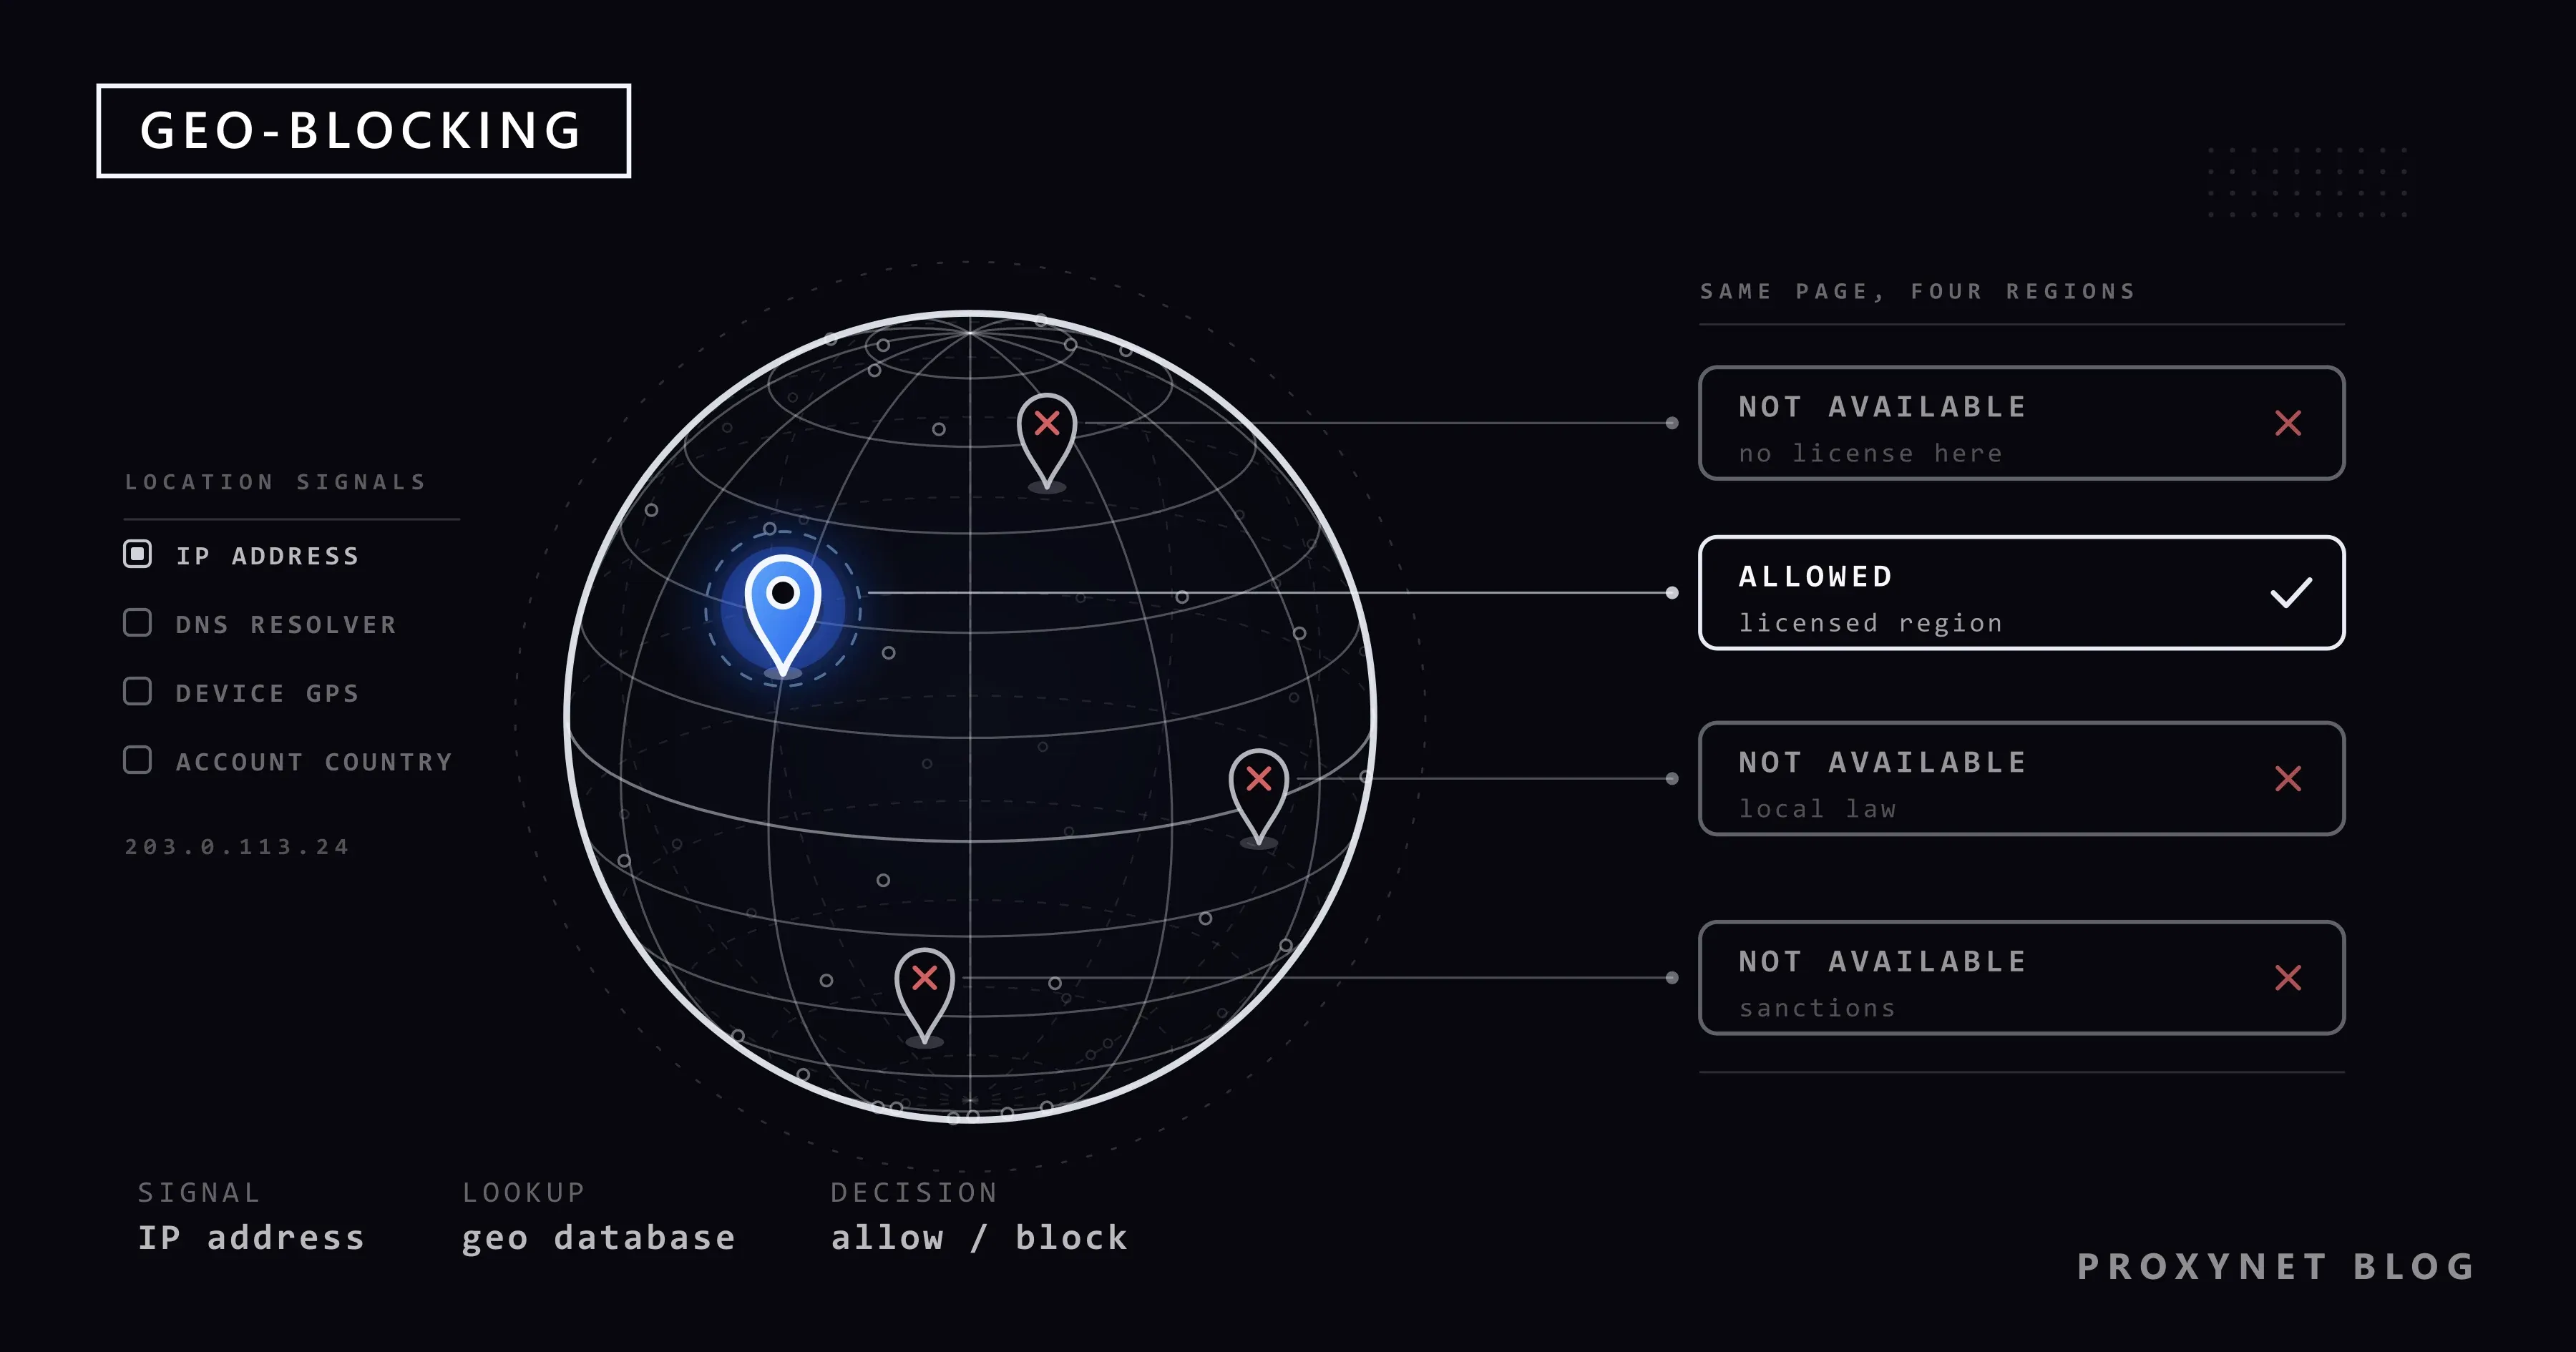
Was ist Geoblocking? So erkennen Websites Ihren Standort
Geoblocking heißt: Eine Website beschränkt Inhalte nach dem Land, das sie an Ihrer Verbindung abliest. Gründe, Standorterkennung und was das EU-Recht sagt.
Autor: Acar Diveroli
Veröffentlicht
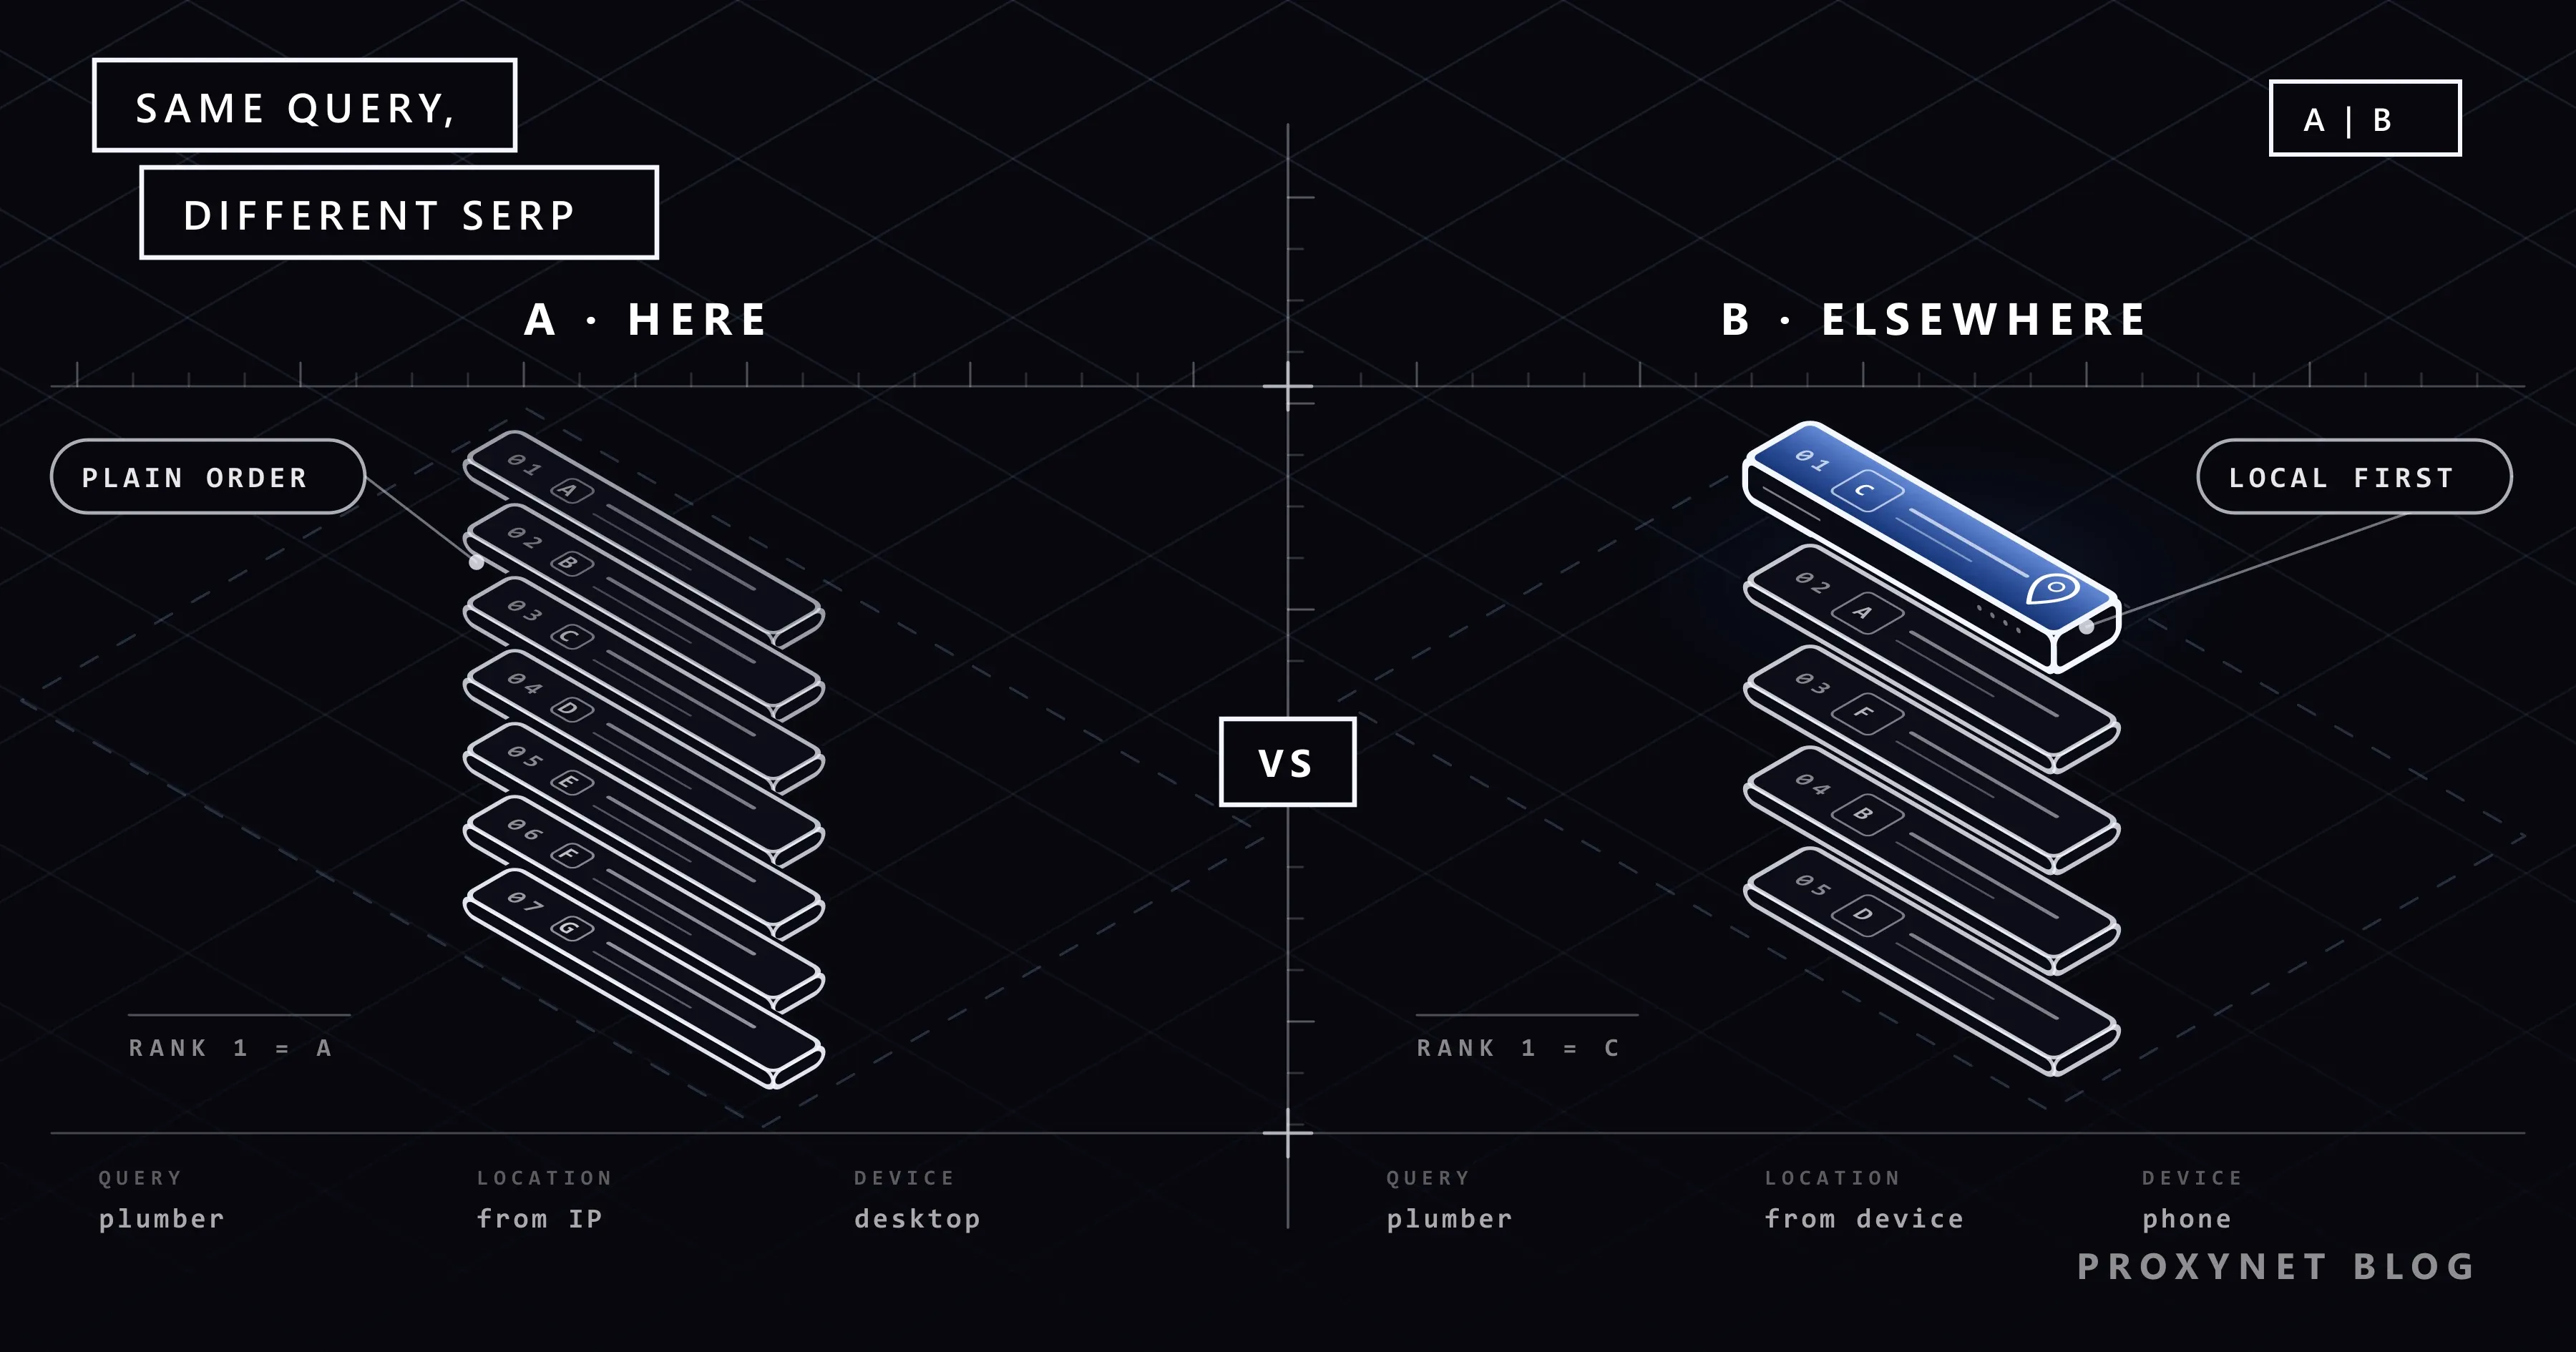
Warum sieht jeder andere Google-Suchergebnisse?
Standort, Sprache, Kontoverlauf, Gerät und Google-Tests ändern die Ergebnisse derselben Suche. Wir erklären die Faktoren und wie Sie sehen, was andere sehen.
Autor:Acar Diveroli
Veröffentlicht
X-Post in Ihrem Land zurückgehalten: Was bedeutet das?
Ein zurückgehaltener X-Post ist wegen einer rechtlichen Forderung oder lokalen Rechts nur in Ihrem Land gesperrt. So bestimmt X Ihr Land und das können Sie tun.
Autor:Acar Diveroli
Veröffentlicht
Access Denied auf Websites: Was bedeutet Reference #18?
Die Seite „Access Denied“ kommt von der Sicherheitsschicht vor einer Website; Reference #18 weist auf Akamai. Wir erklären „You Don't Have Permission“.
Autor: Enver Kaya
Veröffentlicht
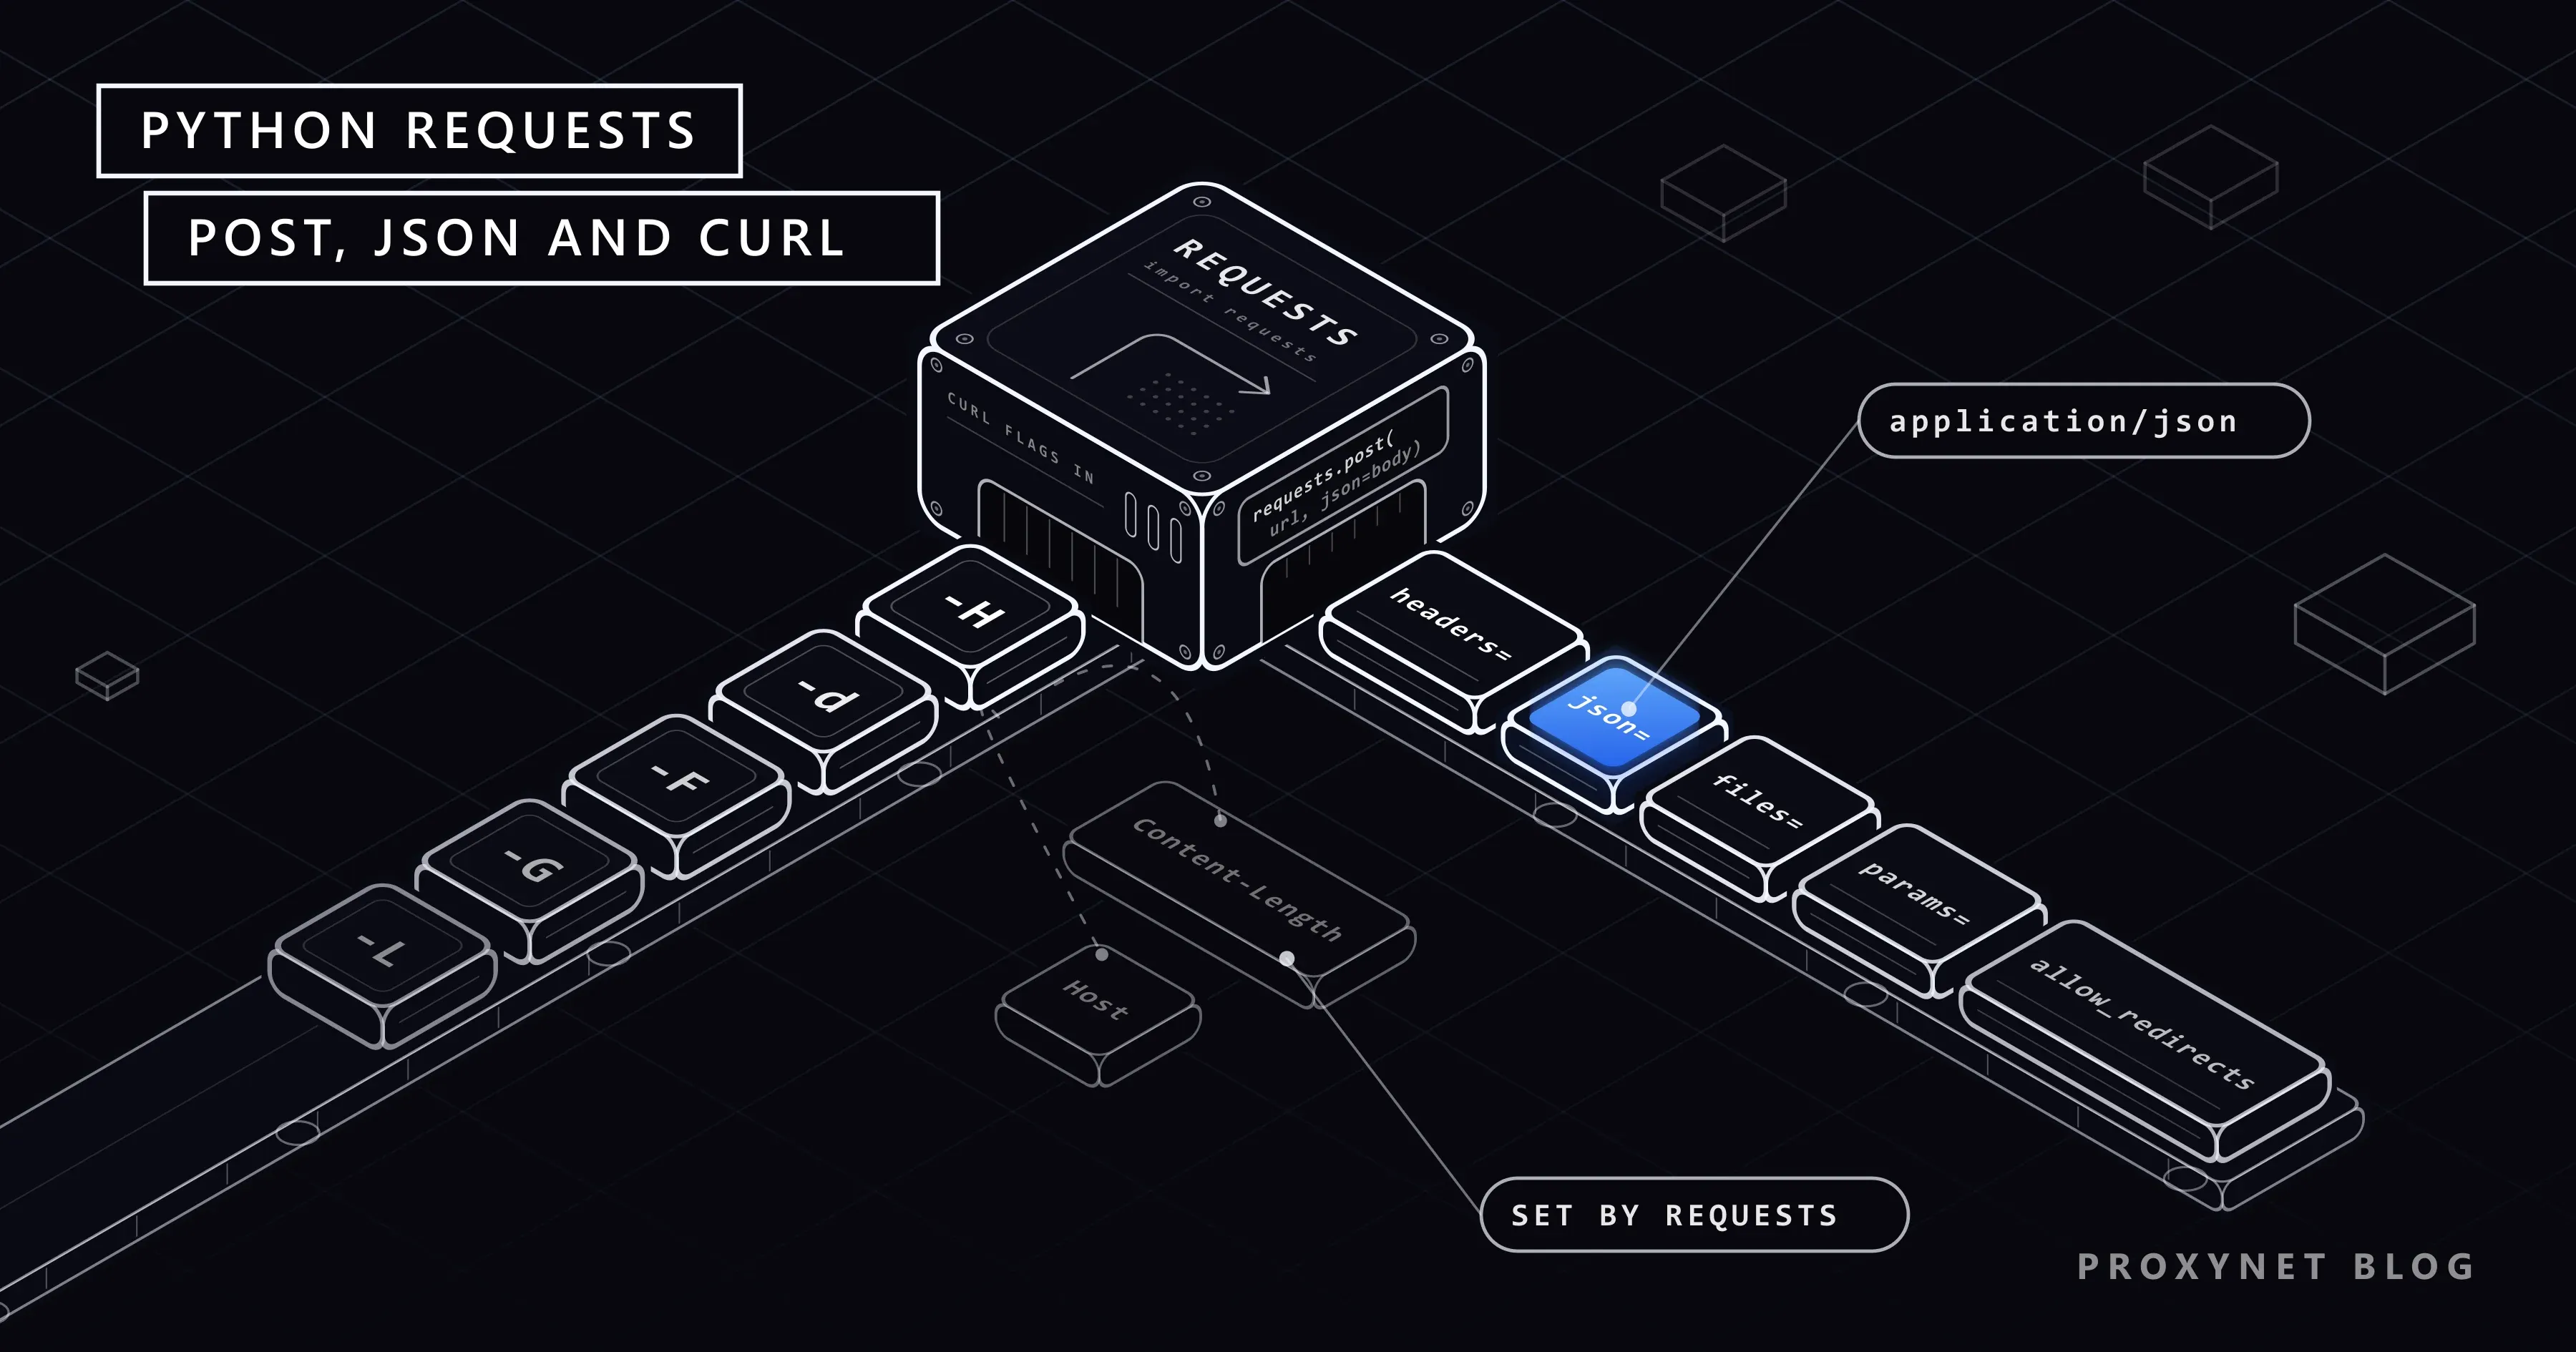
JSON mit Python Requests per POST senden: cURL-Äquivalente
Für JSON per POST genügt requests.post(url, json=data); den Content-Type setzt Requests selbst. So passen data=, params=, Header und cURL-Optionen zusammen.
Autor:Acar Diveroli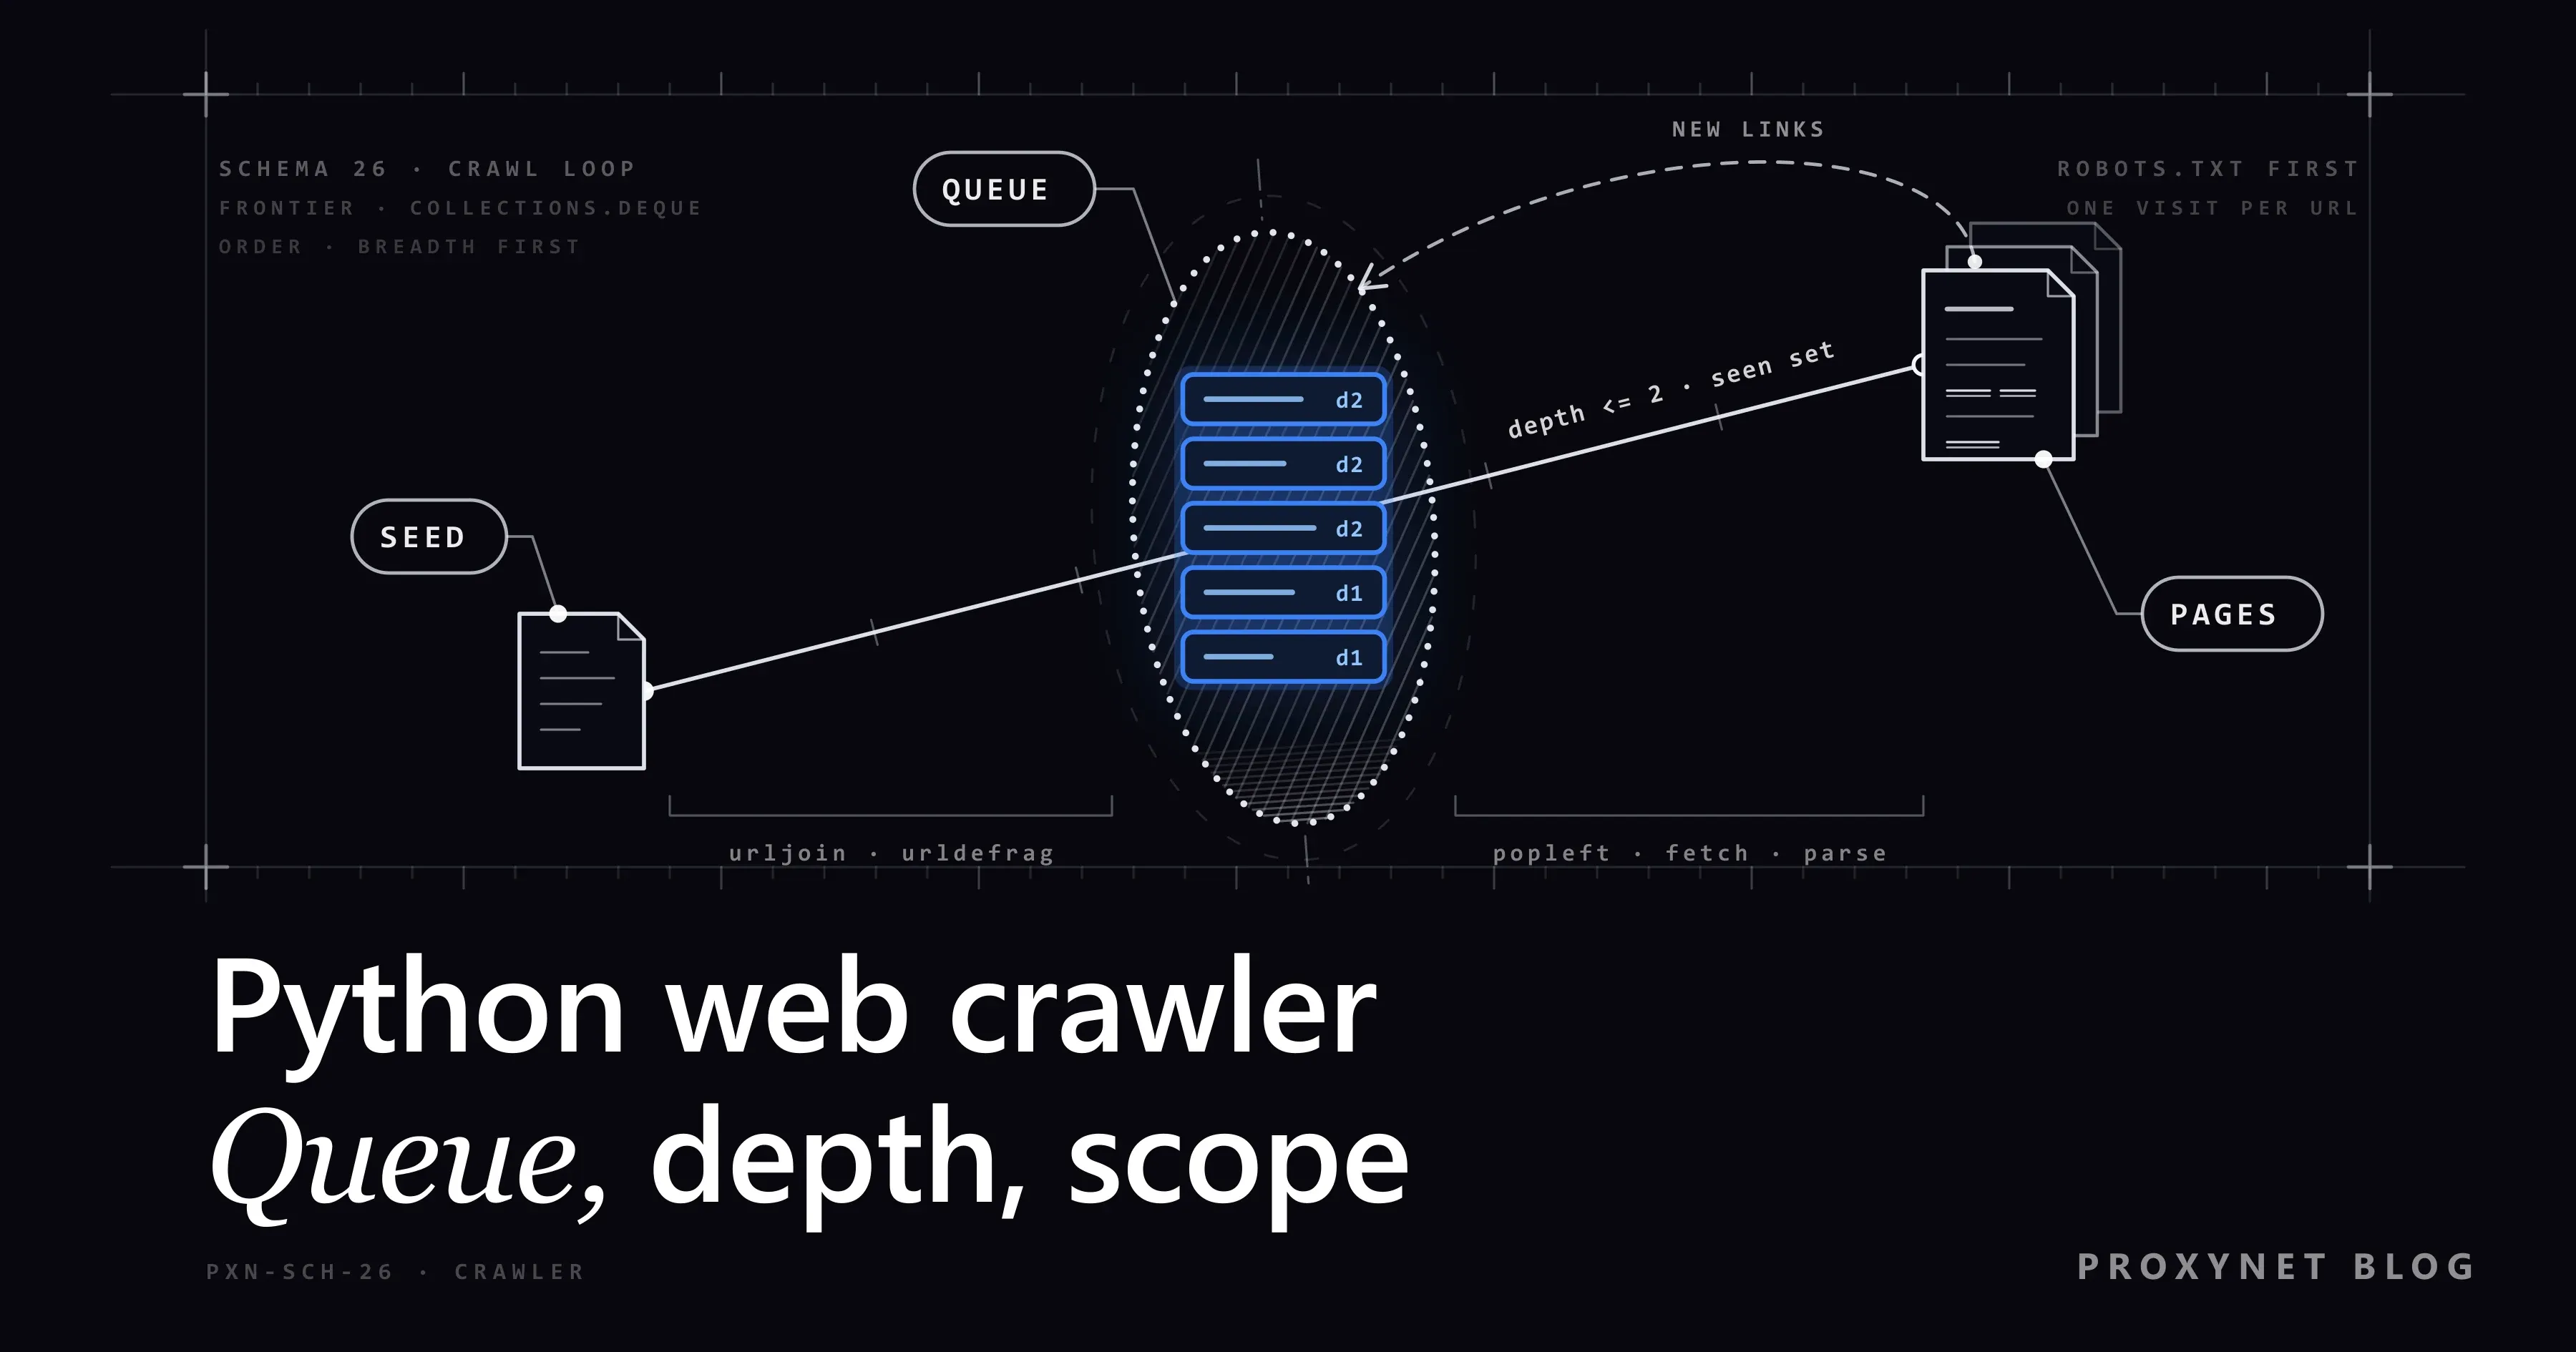
Veröffentlicht
Einen Web-Crawler in Python bauen: Schritt für Schritt
Ein Web-Crawler in Python legt Links ab der Start-URL in eine Warteschlange und besucht jede Seite einmal. Im Code: URL-Normalisierung, Tiefenlimit und Scope.
Autor:Acar Diveroli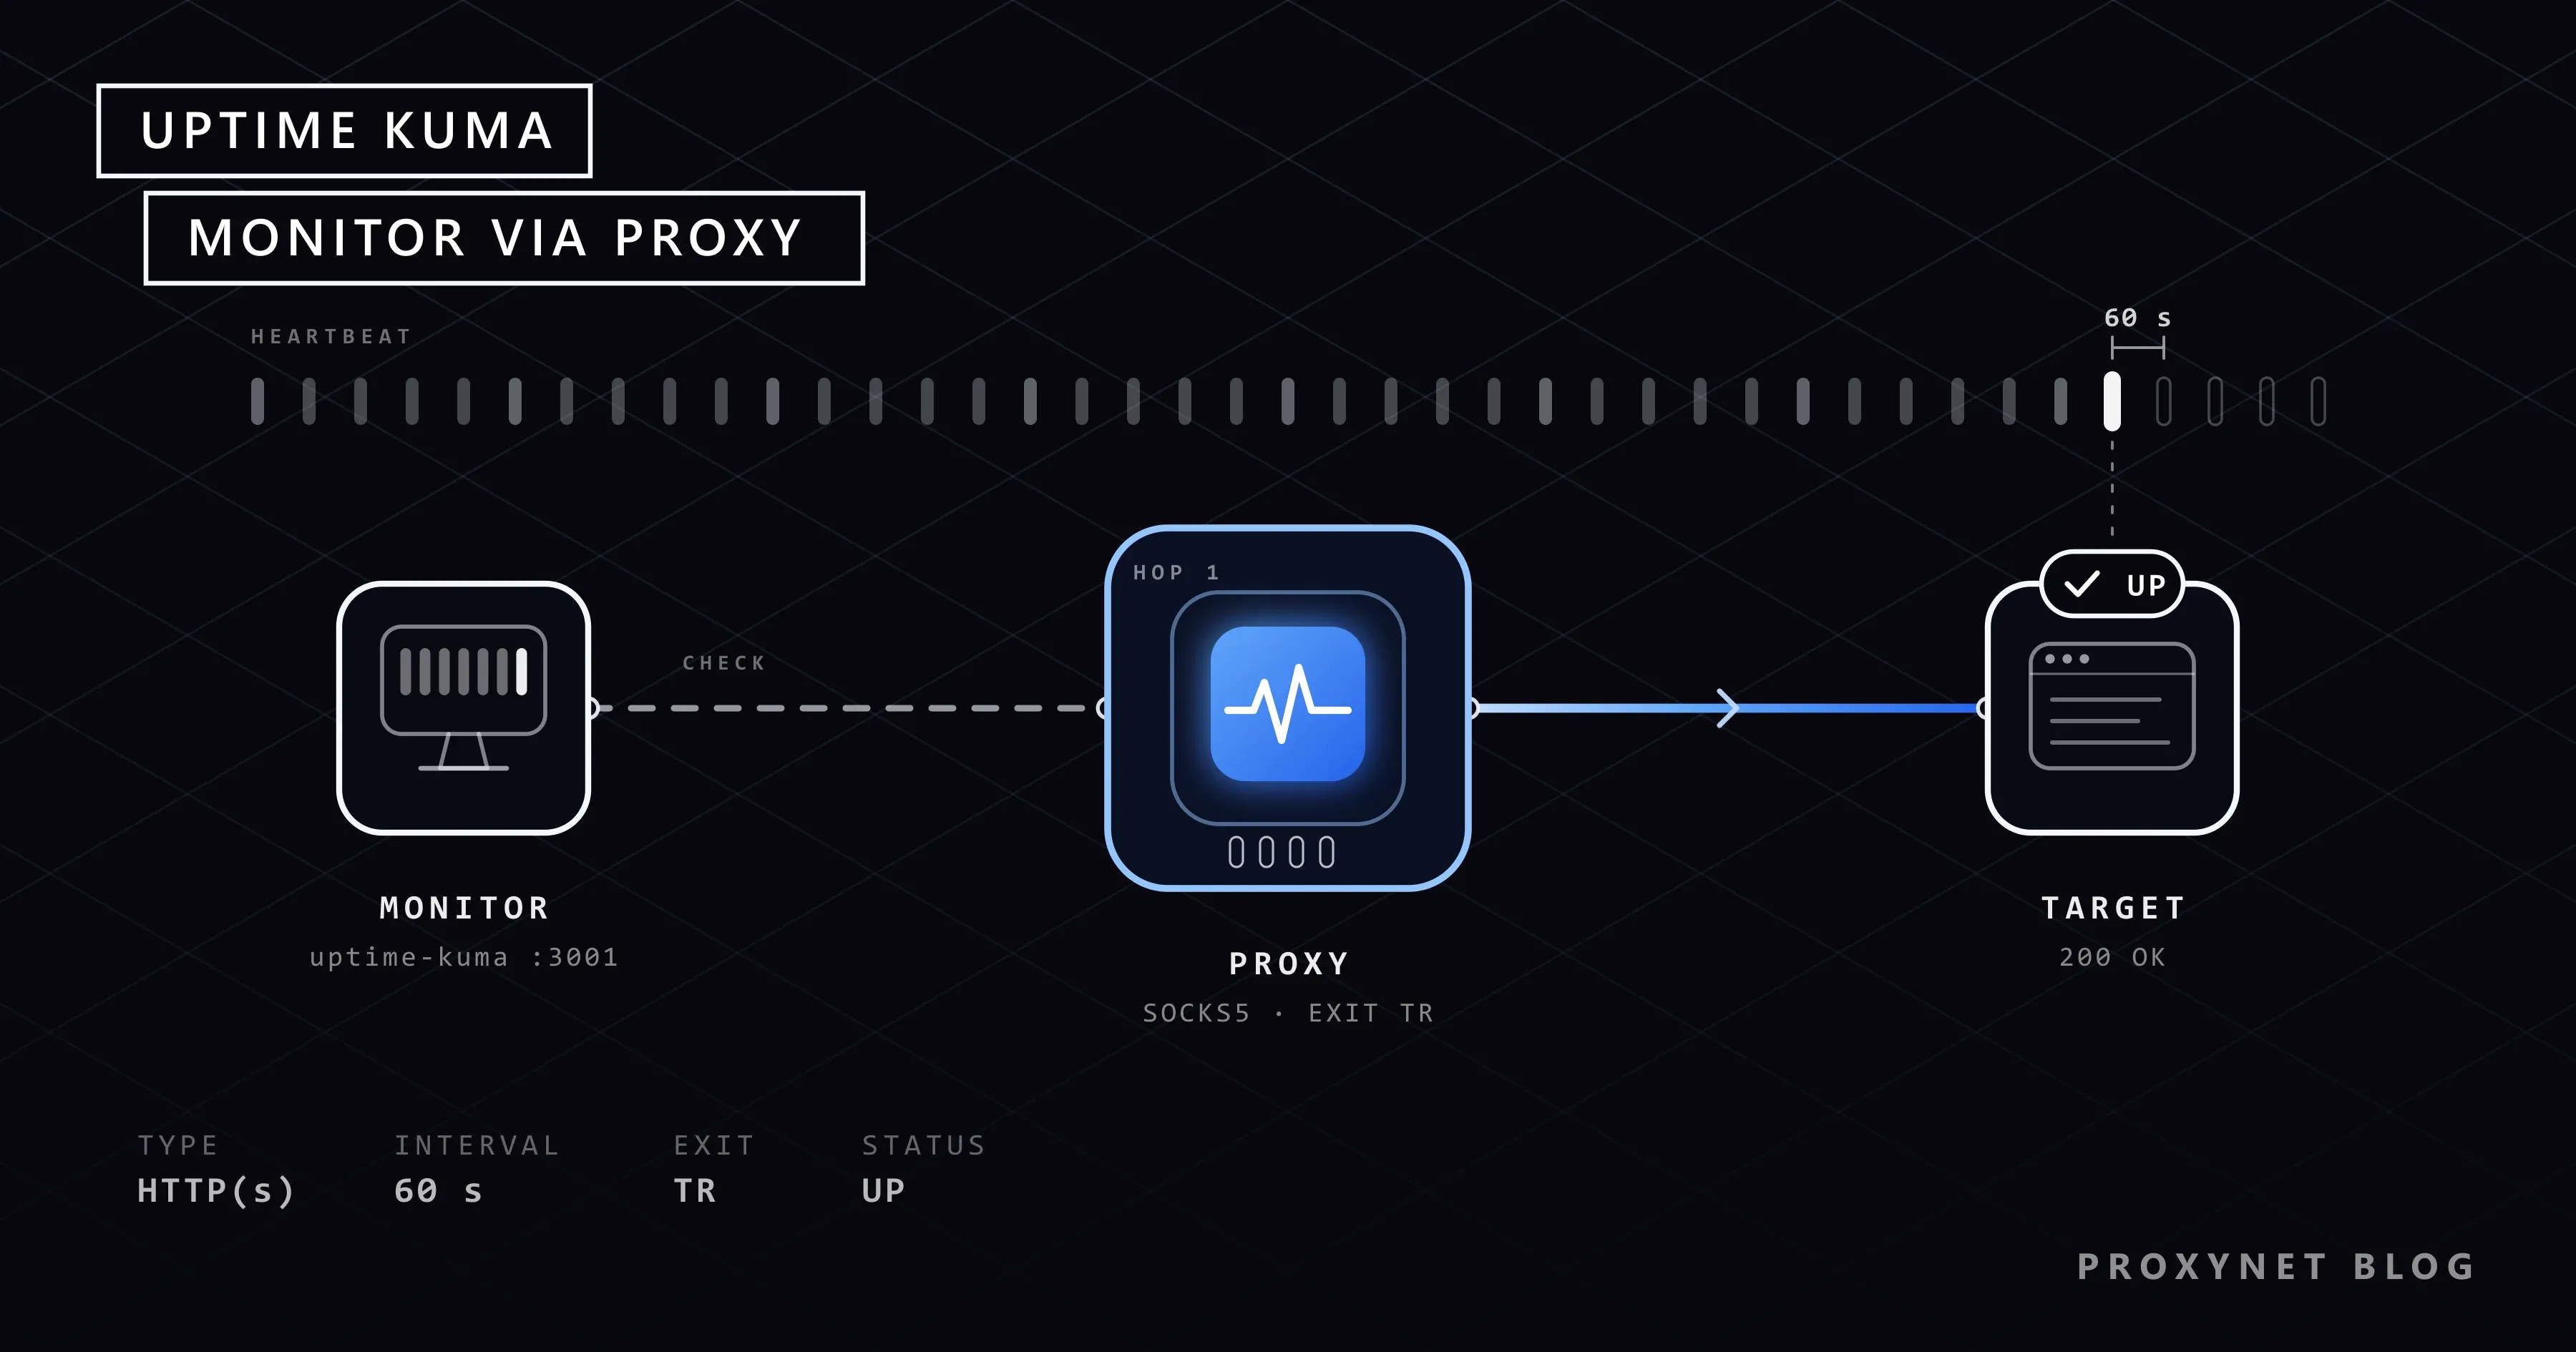
Veröffentlicht
Was ist Uptime Kuma? Einrichtung und Überwachung per Proxy
Uptime Kuma ist ein kostenloses Open-Source-Tool, das Ihre Website im festen Intervall prüft und bei Ausfällen warnt. Mit Docker-Setup und Proxy-Einstellung.
Autor:Enver Kaya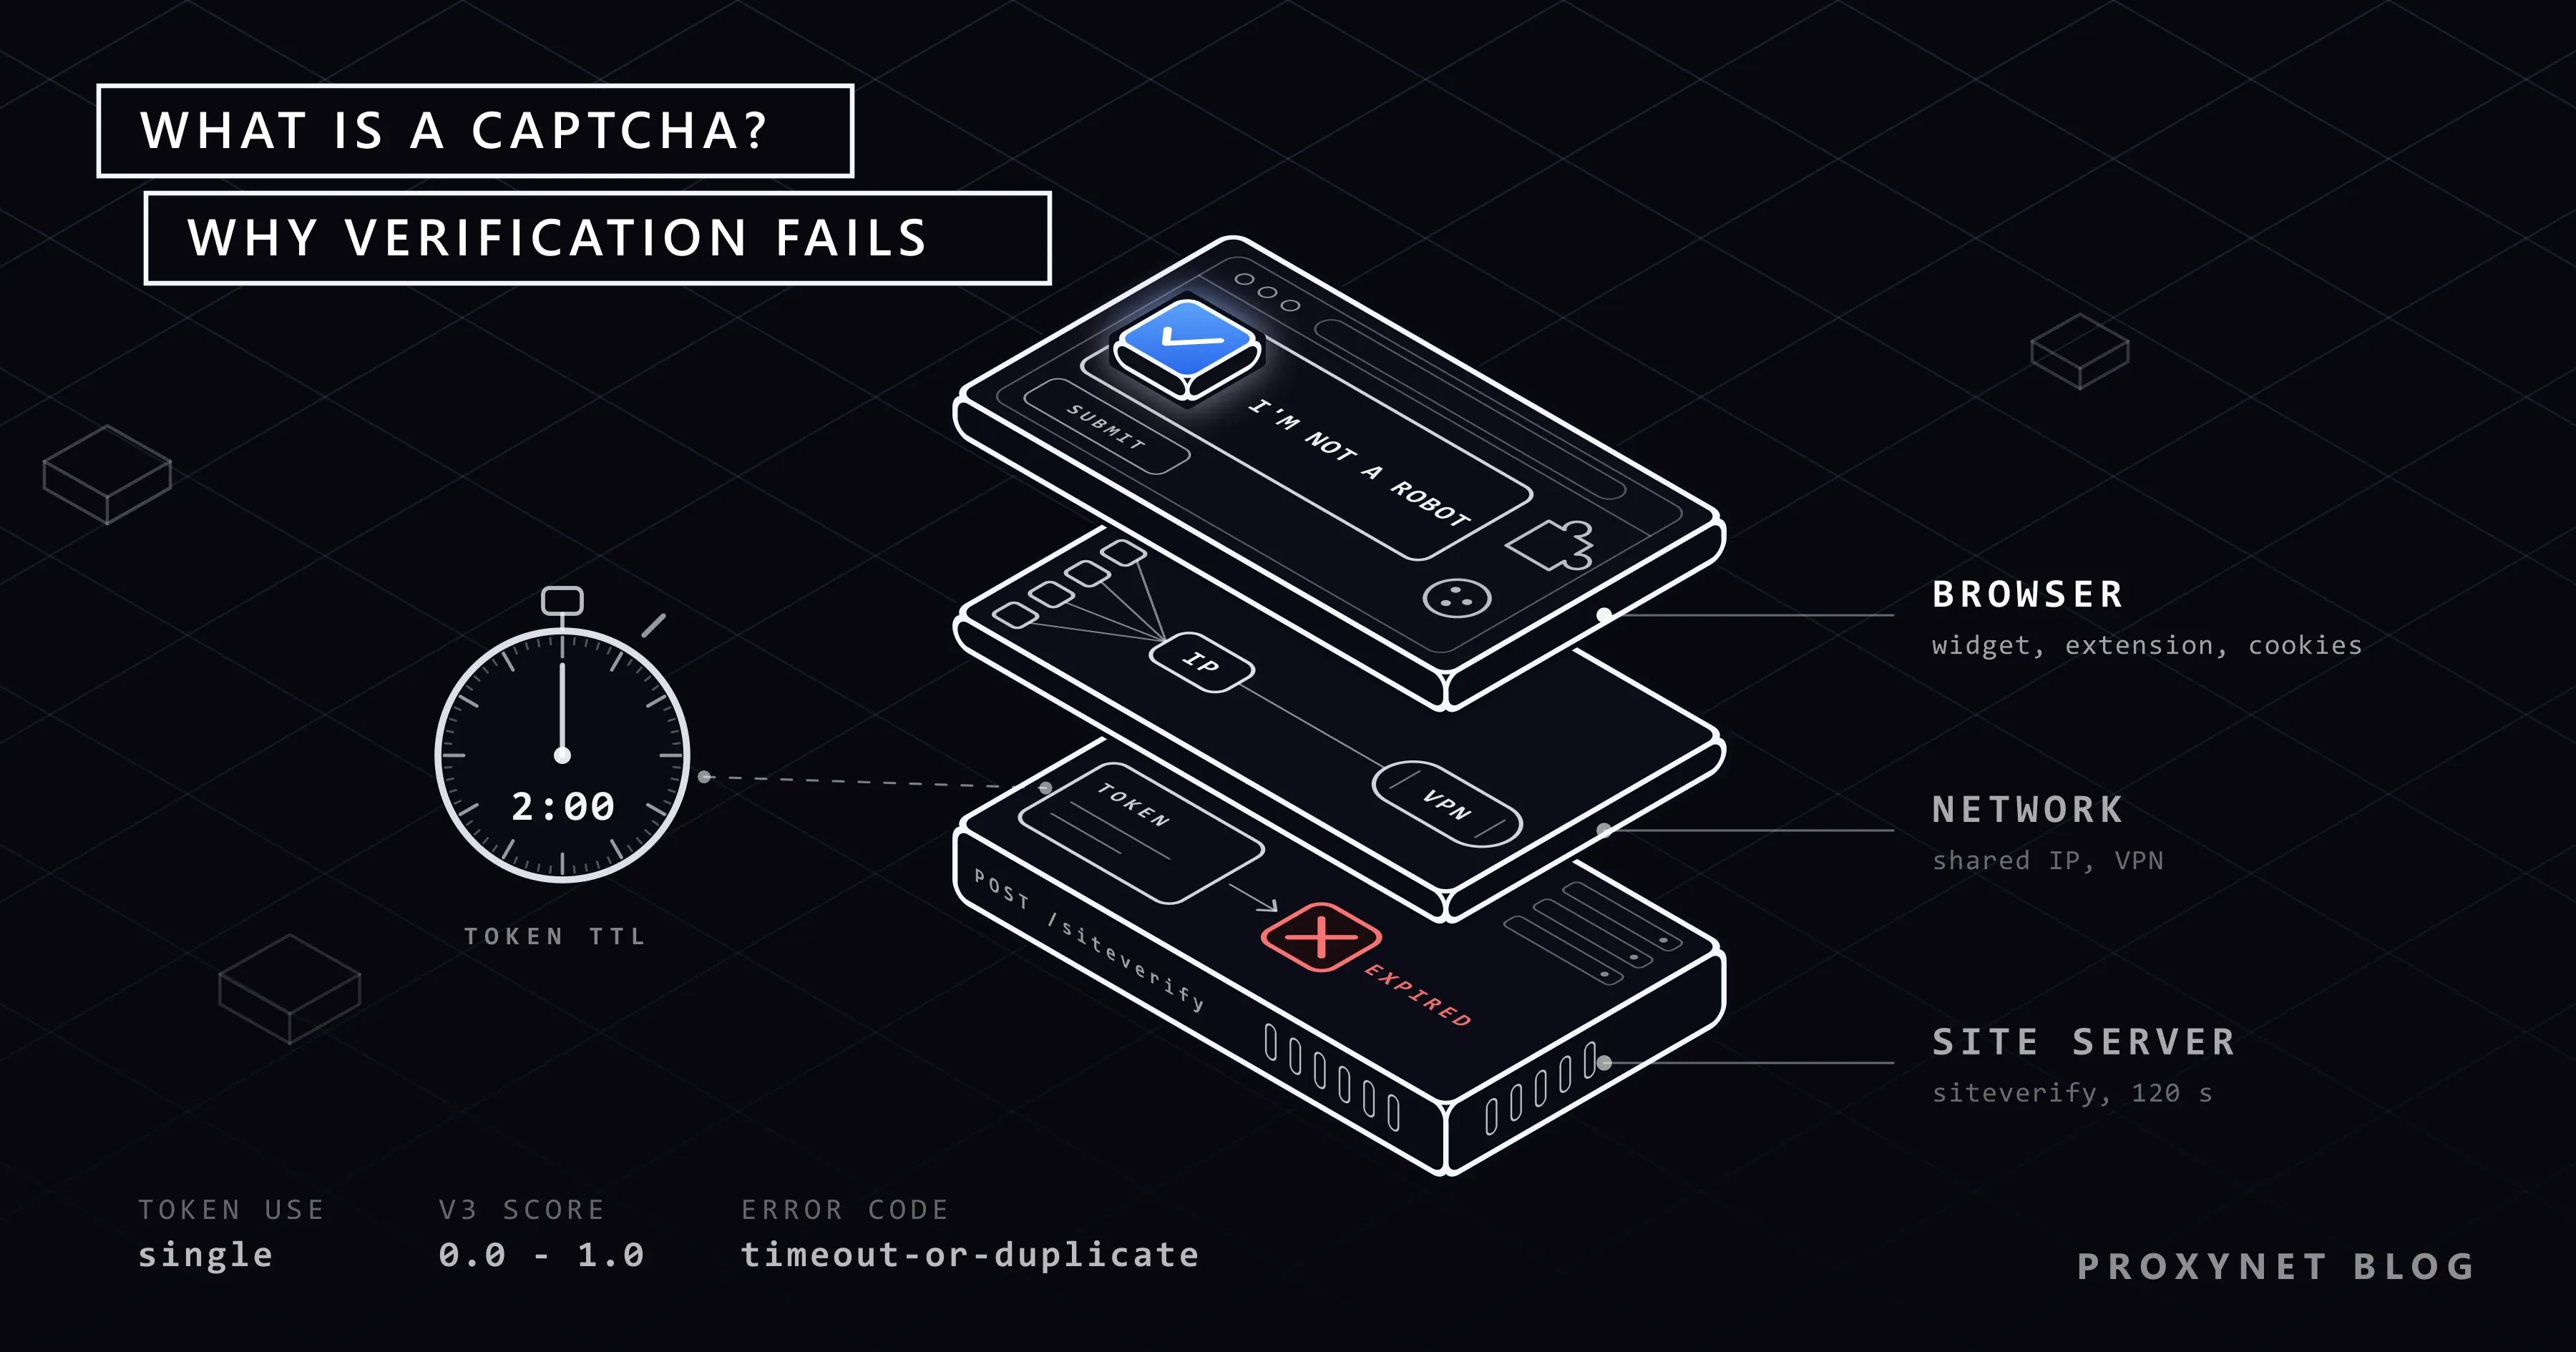
Veröffentlicht
Was ist ein CAPTCHA? Warum schlägt die Prüfung fehl?
Ein CAPTCHA ist ein kurzer Test gegen Bots. Wir erklären reCAPTCHA, die Meldungen Verification Failed, Invalid und Expired und was Sie zuerst tun sollten.
Autor:Enver Kaya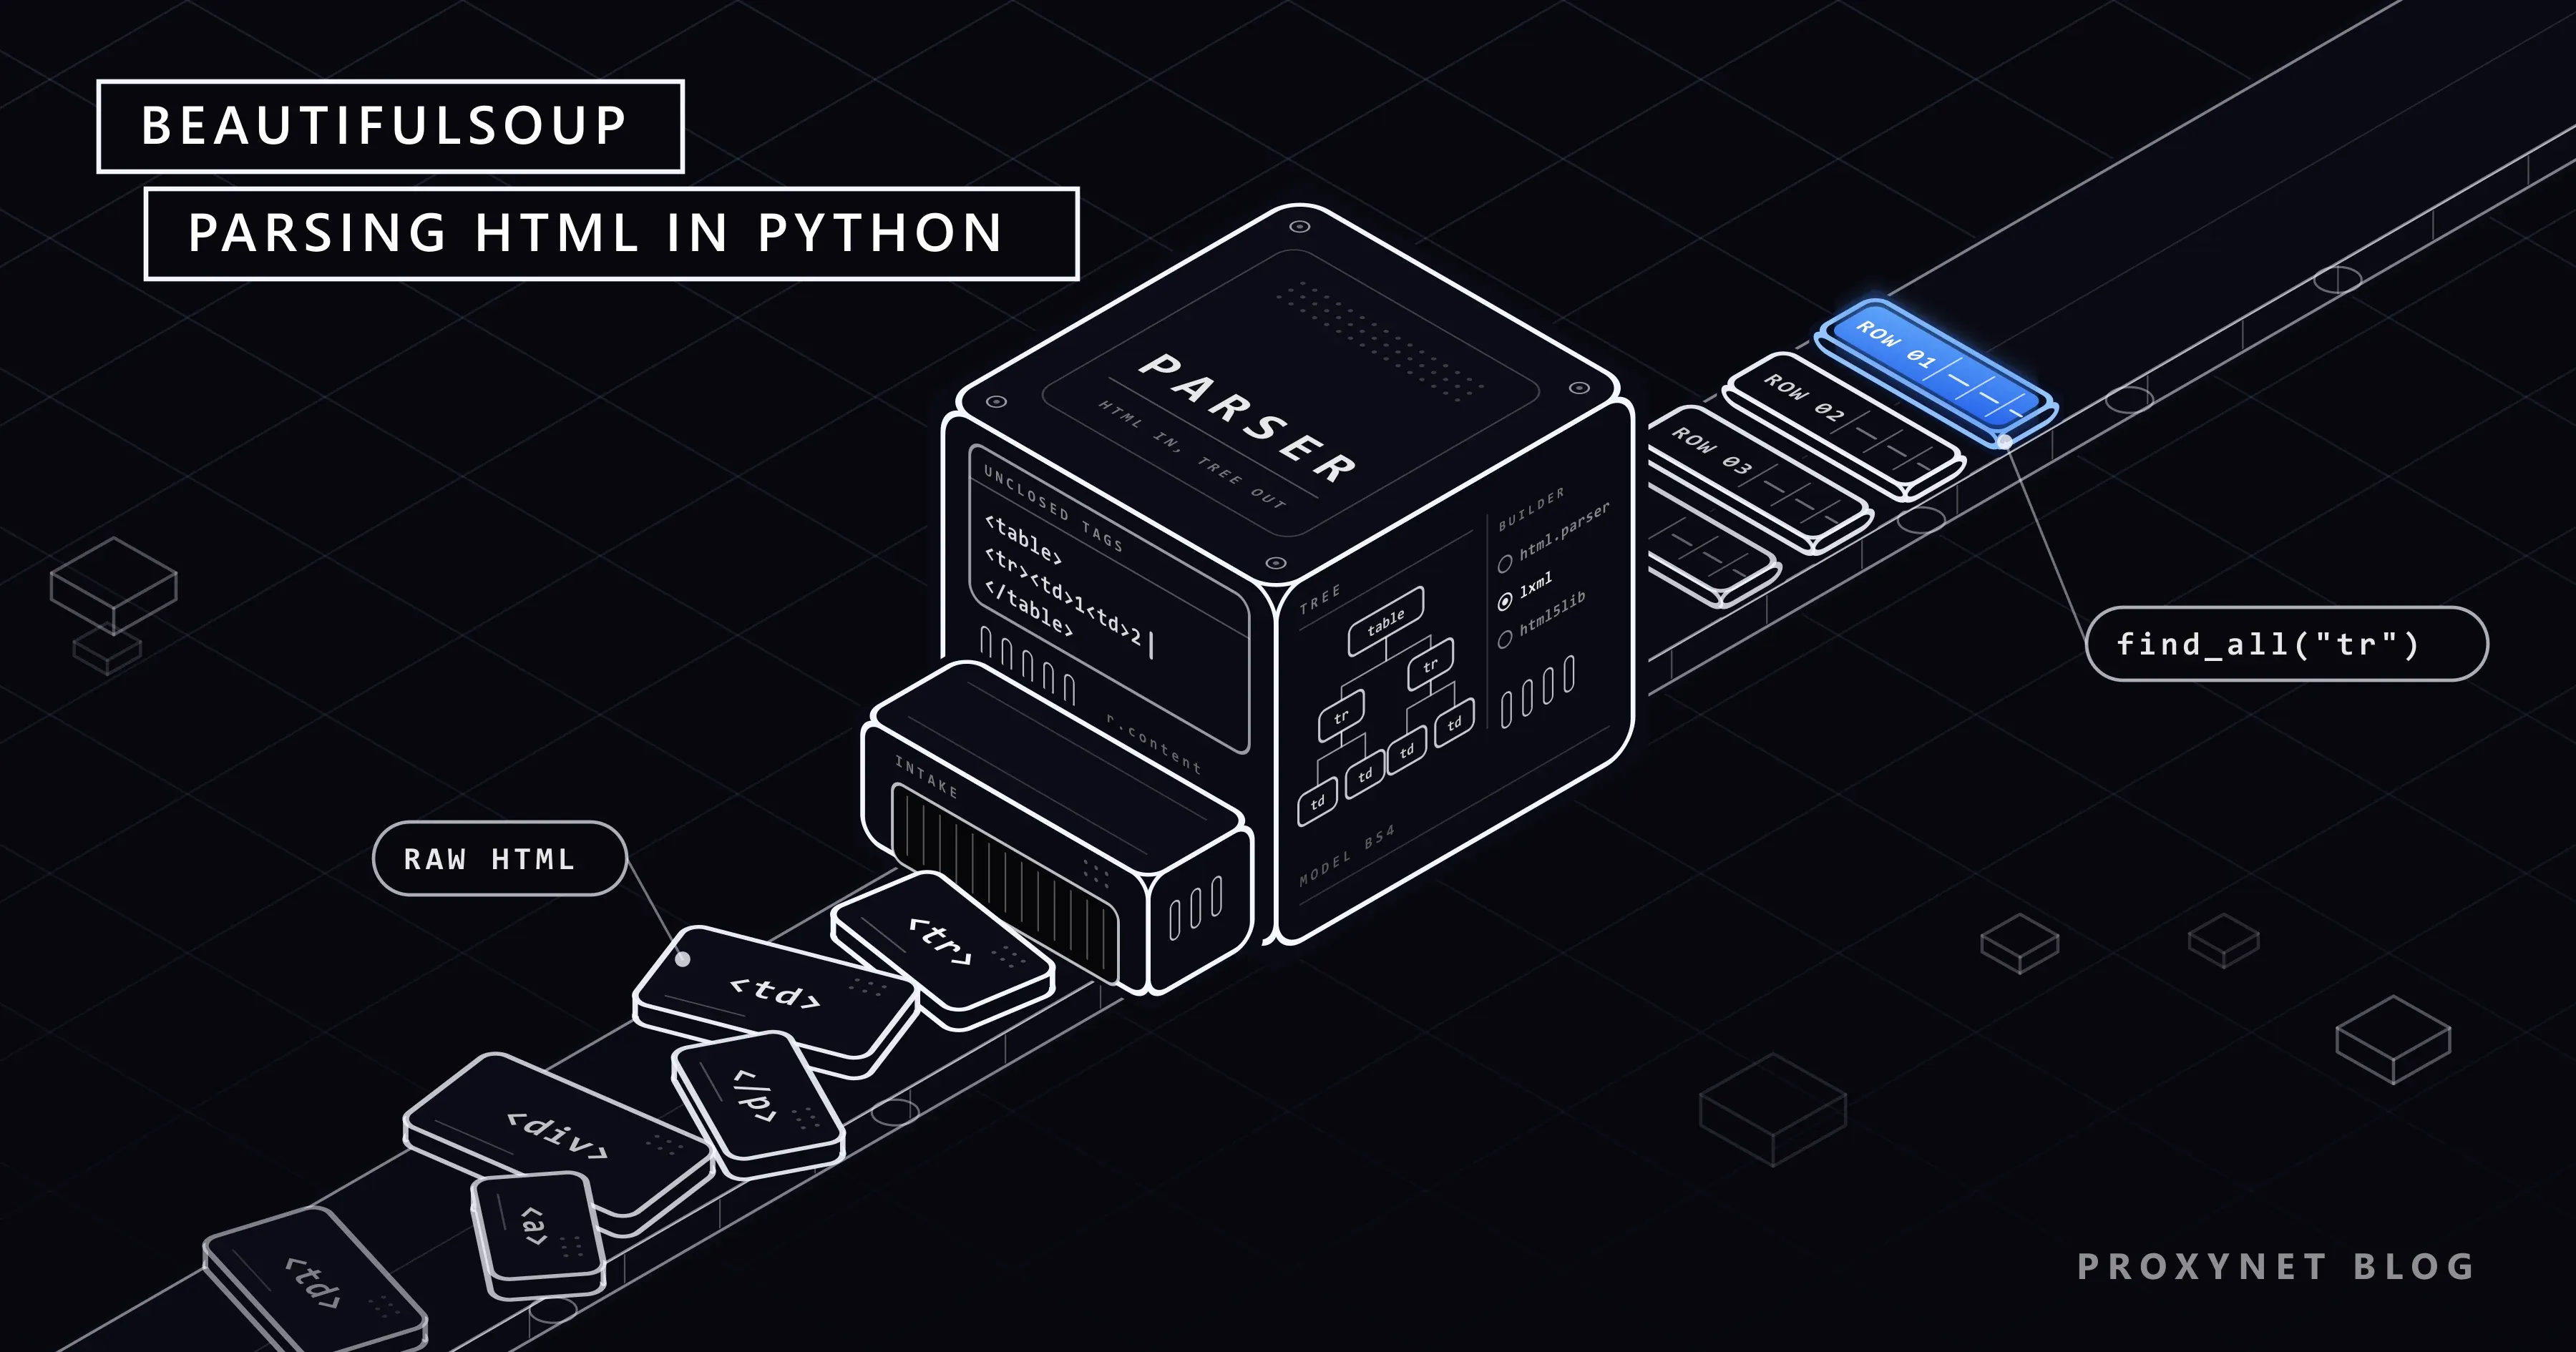
Veröffentlicht
Was ist BeautifulSoup und wie nutzt man es in Python?
BeautifulSoup ist eine Python-Bibliothek, die HTML in einen durchsuchbaren Baum verwandelt. Wir erklären Parser-Wahl, find_all oder select und HTML-Tabellen.
Autor:Acar Diveroli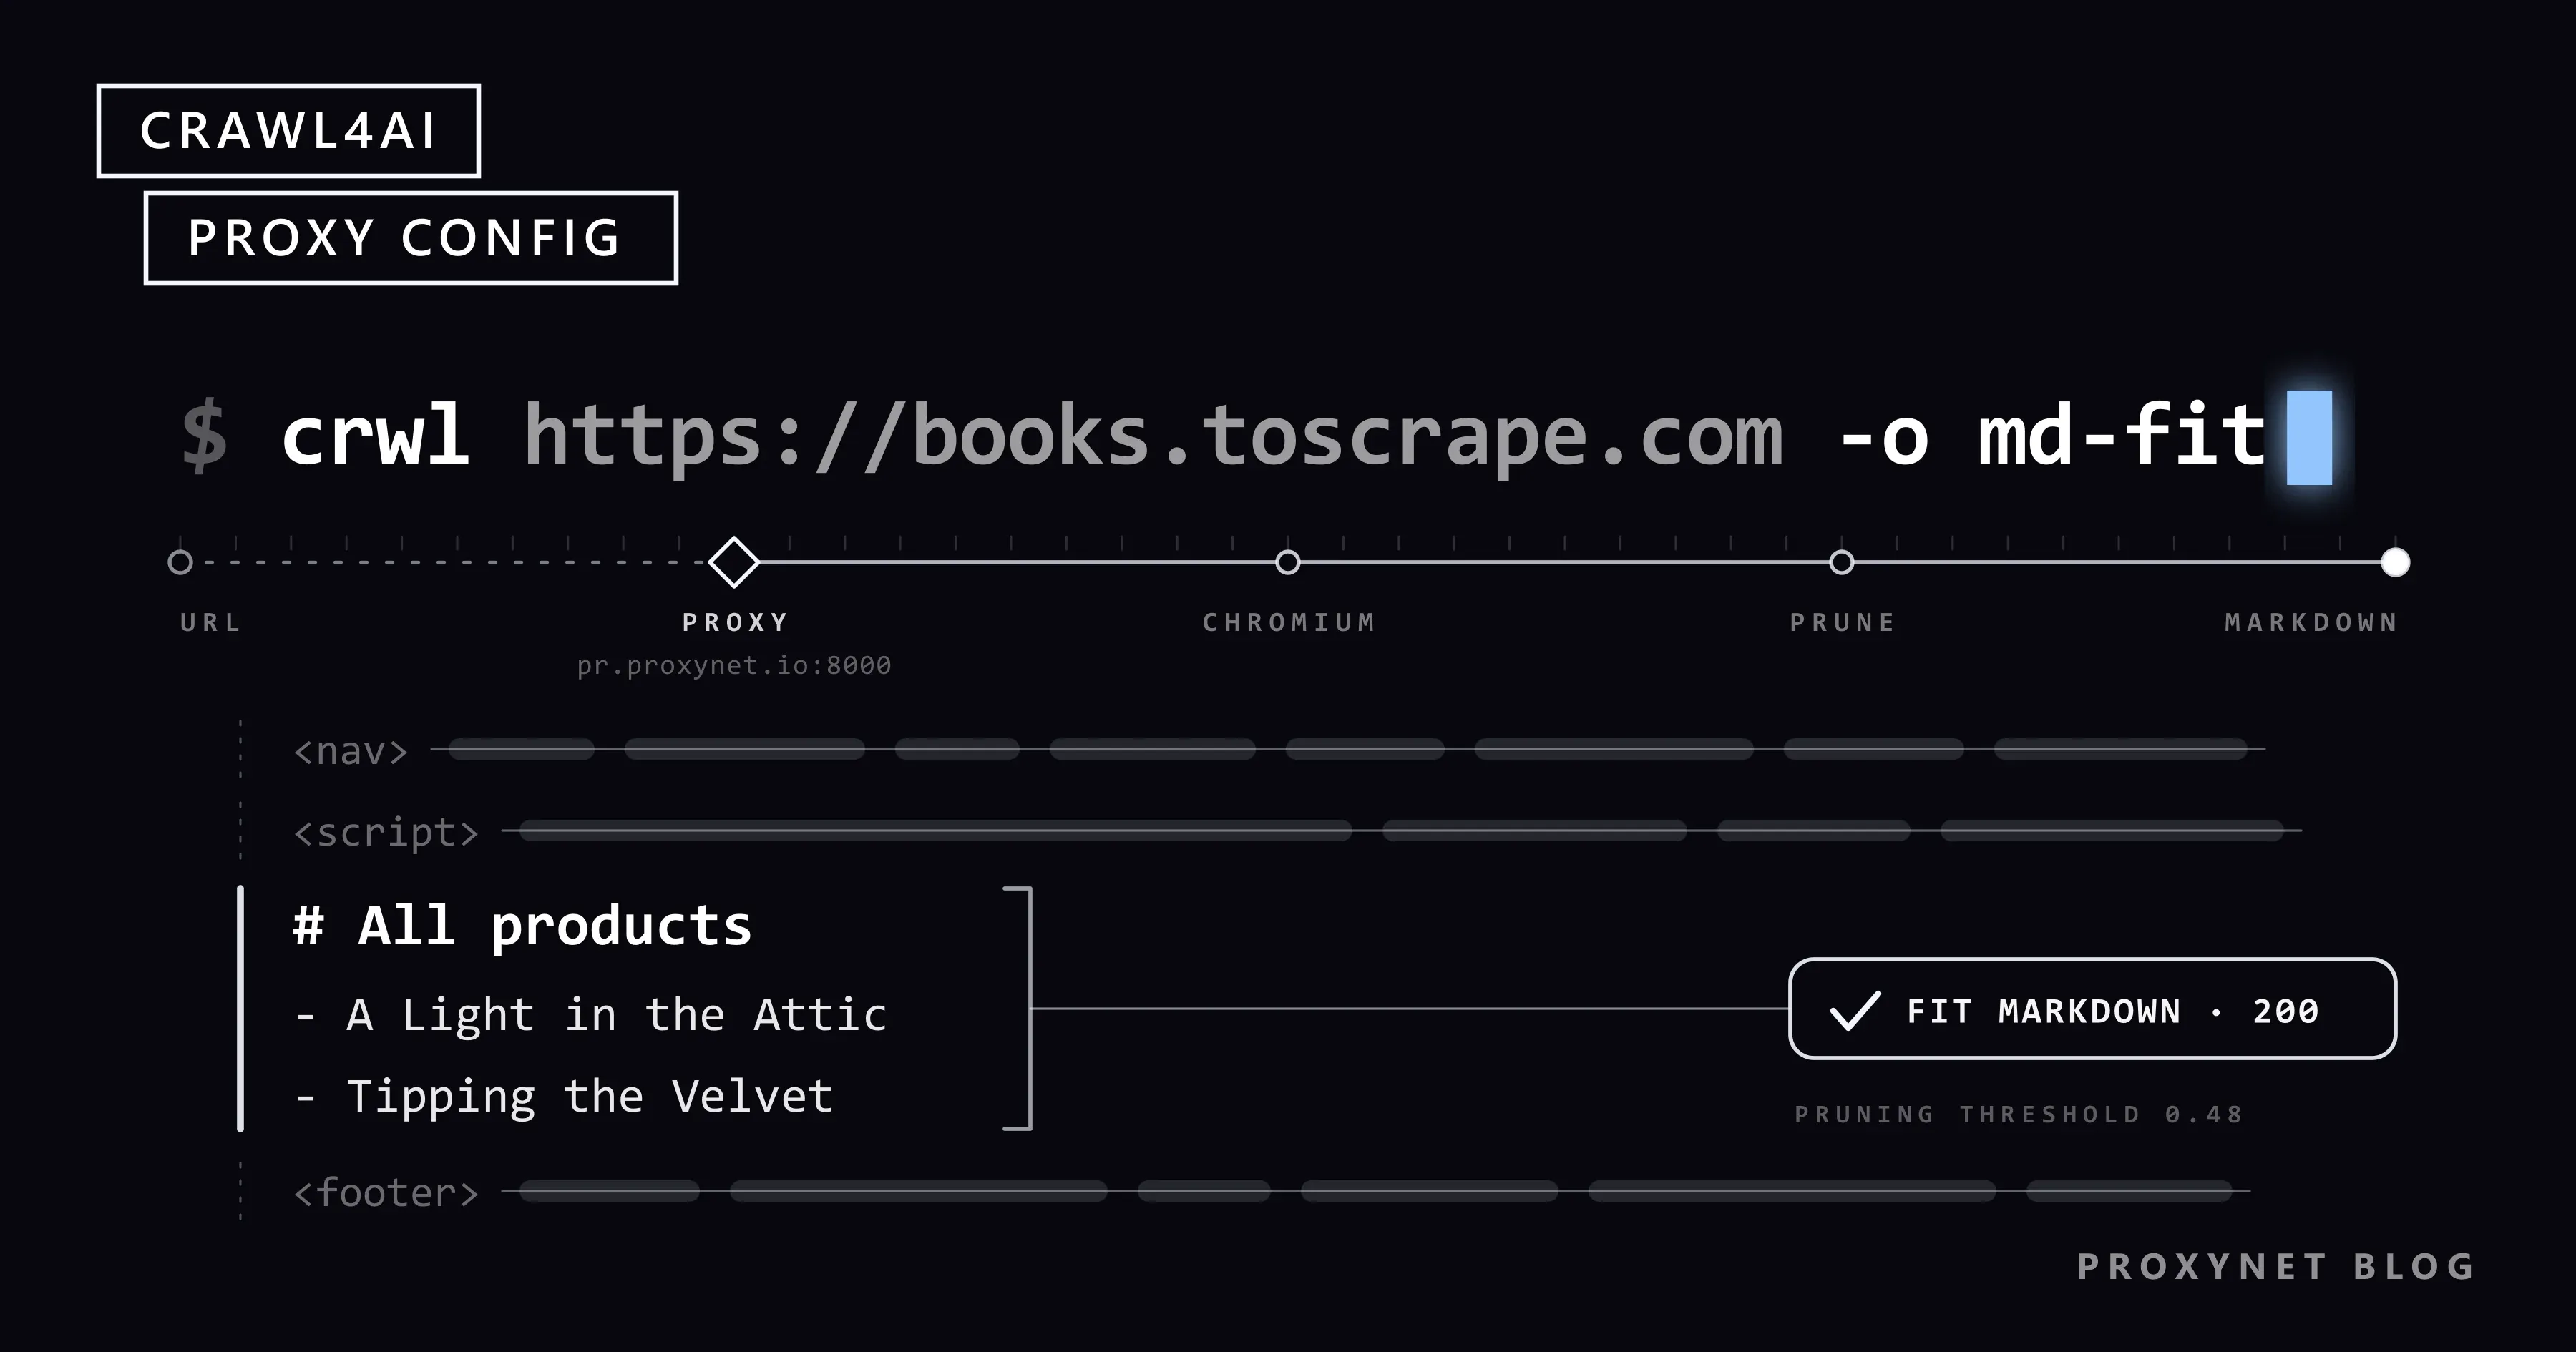
Veröffentlicht
Was ist Crawl4AI? Einrichtung und Proxy-Konfiguration
Crawl4AI wandelt als Open-Source-Crawler in Python Webseiten in Markdown für LLMs um. Wir zeigen die Installation mit pip und Docker und Proxys per ProxyConfig.
Autor:Acar Diveroli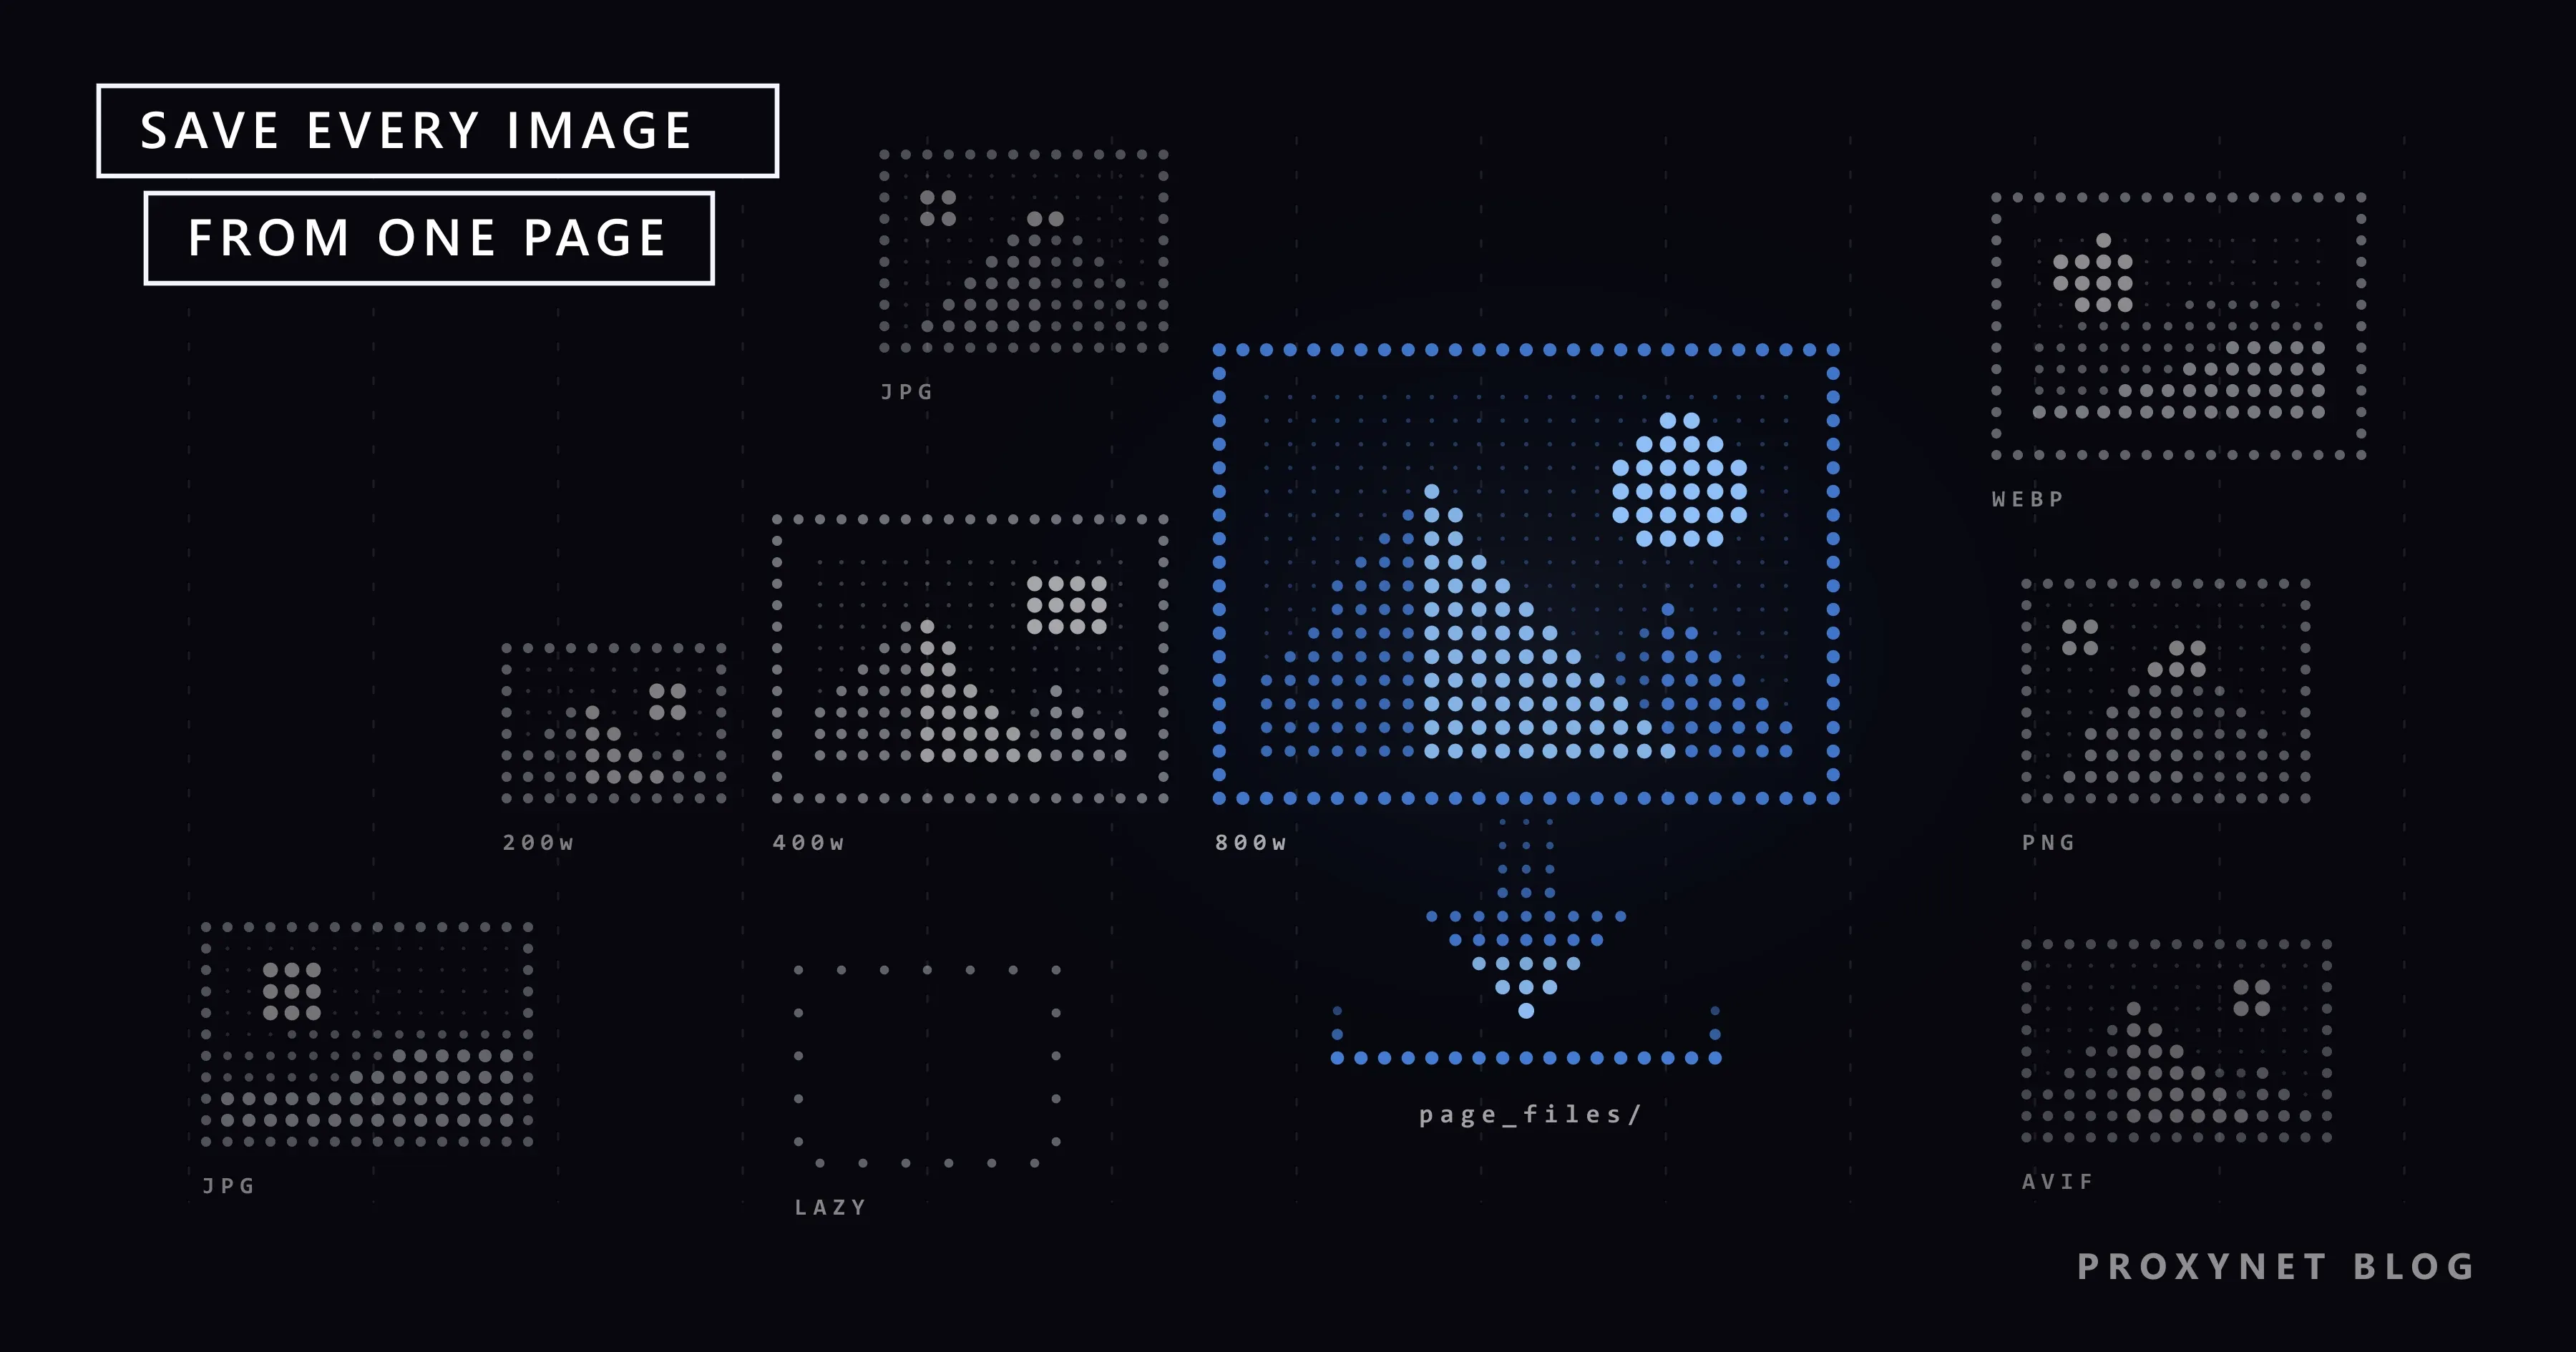
Veröffentlicht
Alle Bilder von einer Website ohne Code herunterladen
Alle Bilder einer Webseite speichern Sie in Chrome mit „Webseite, vollständig“ oder per Erweiterung. Wir erklären auch, warum manche Bilder klein ankommen.
Autor:Enver Kaya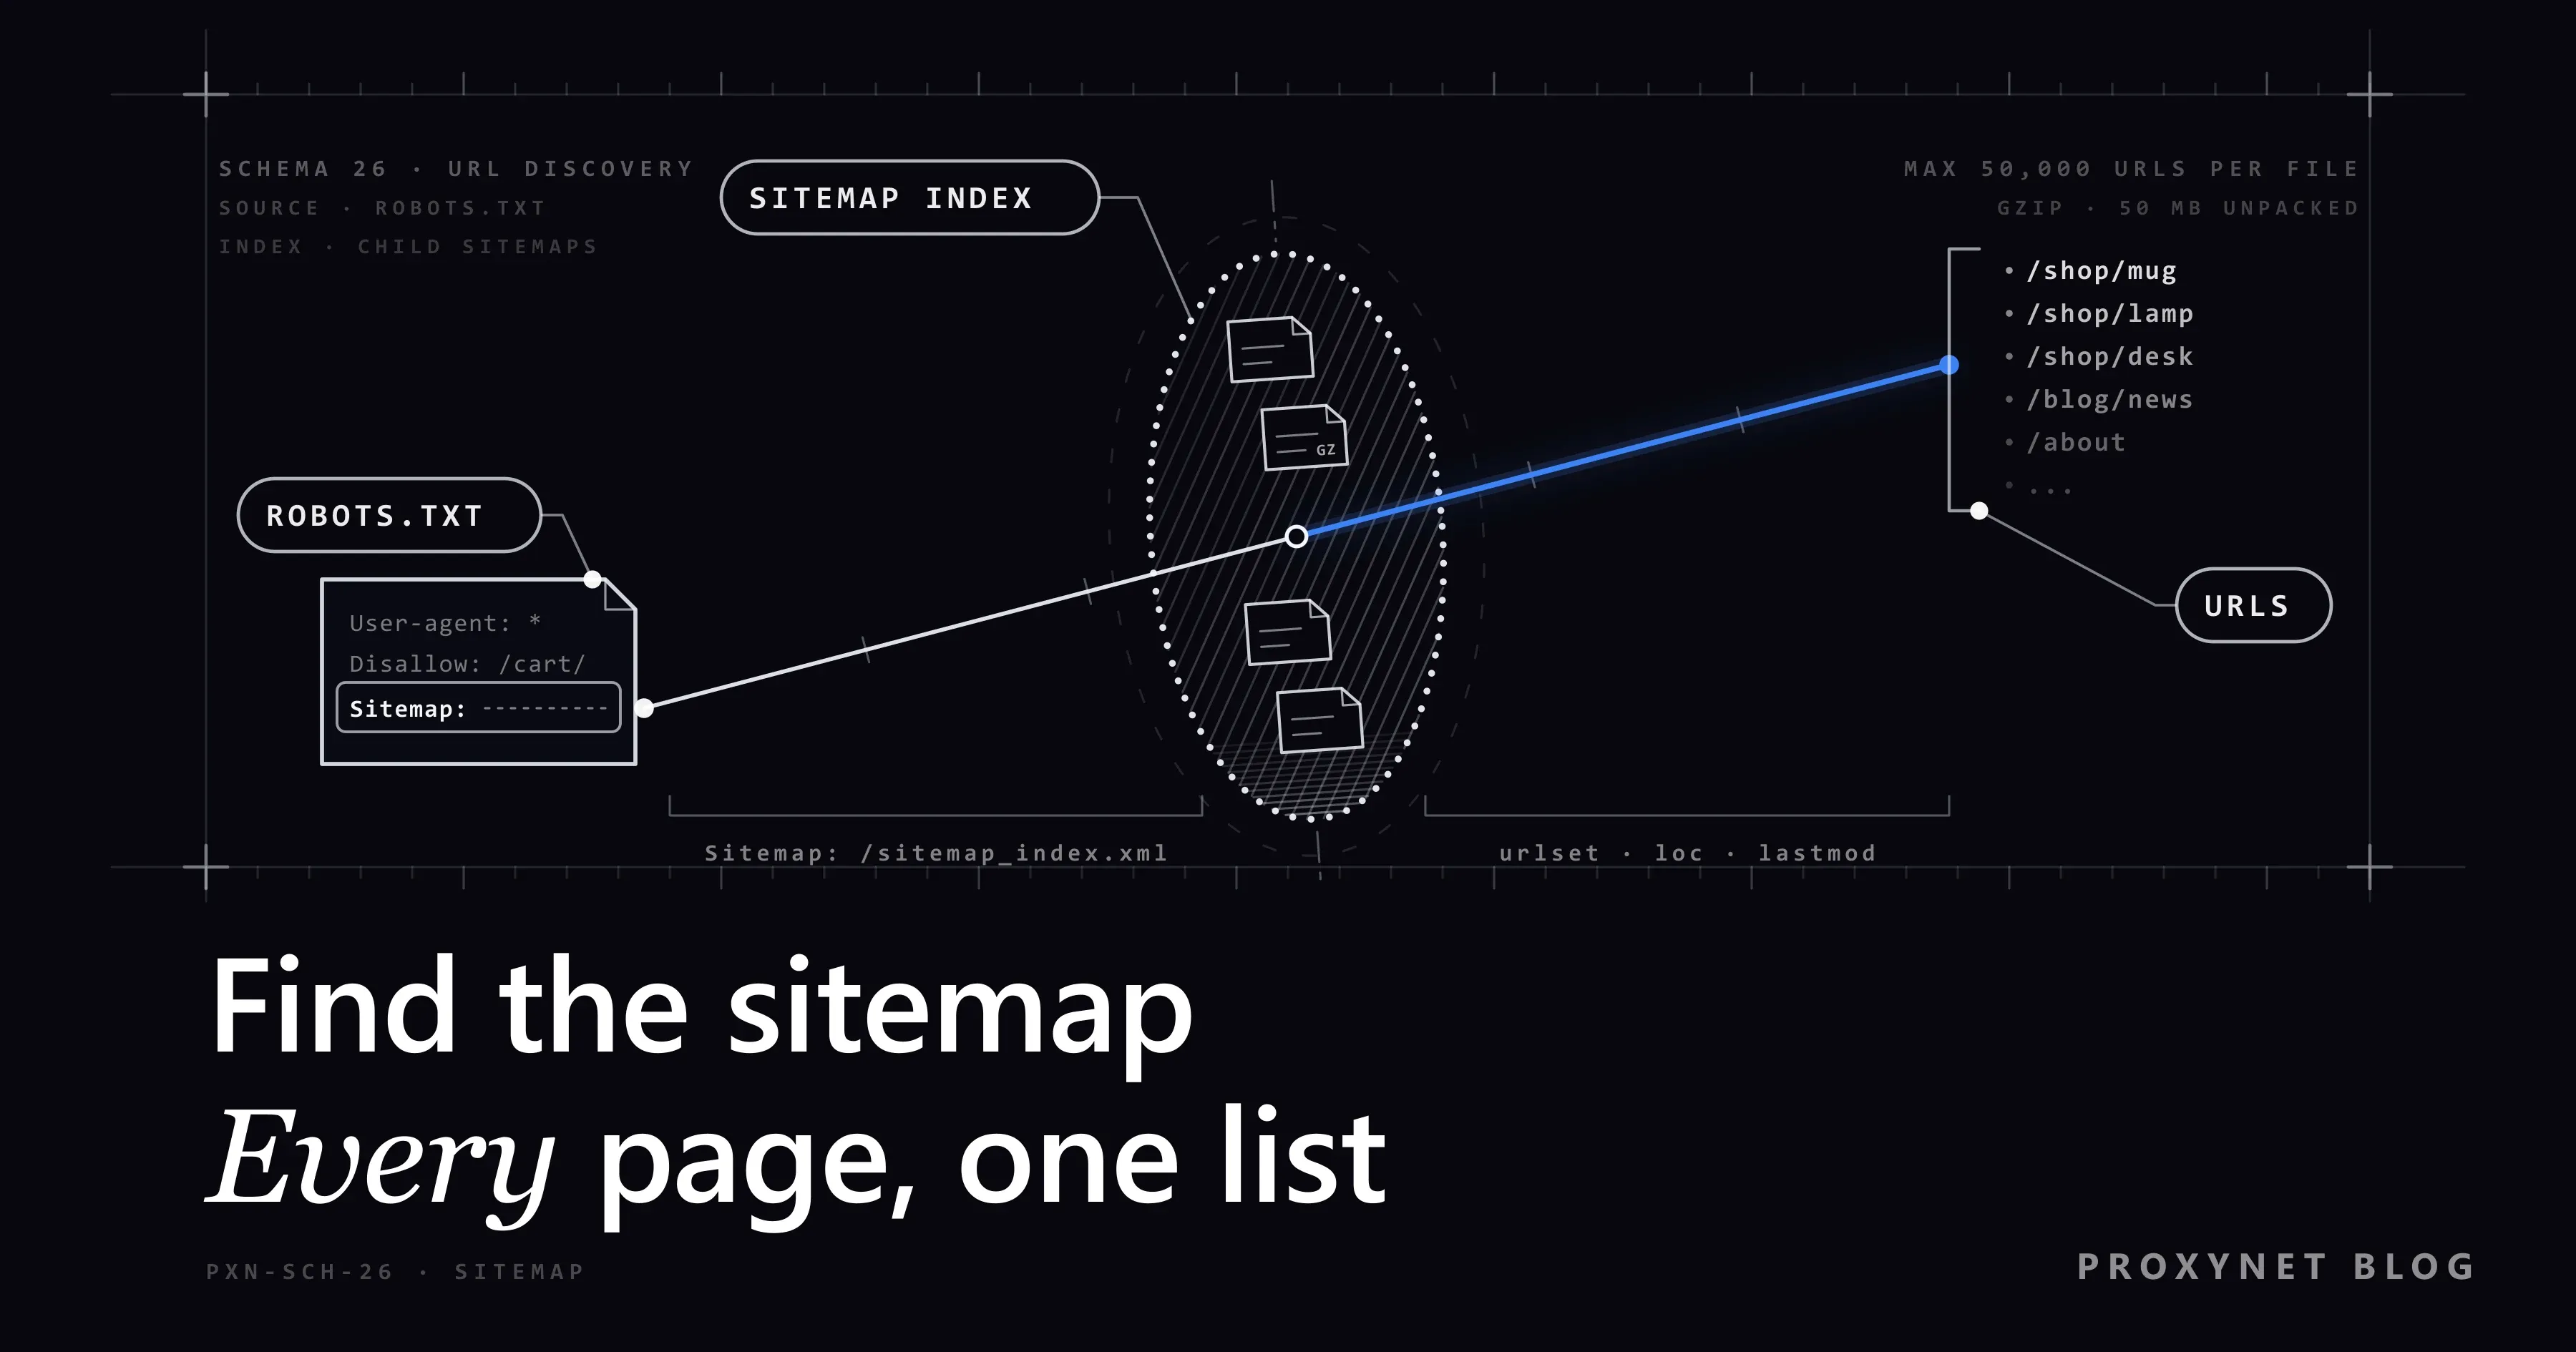
Veröffentlicht
Die Sitemap einer Website finden und alle Seiten auflisten
Prüfen Sie zuerst die Sitemap-Zeile in robots.txt, dann Pfade wie /sitemap.xml. Wir zeigen, wie Sie Sitemap-Indizes, .gz-Dateien und lastmod mit Python lesen.
Autor:Acar Diveroli
Was ist Geoblocking? So erkennen Websites Ihren Standort
Autor: Acar DiveroliProxy 101Veröffentlicht
Warum sieht jeder andere Google-Suchergebnisse?
Autor: Acar DiveroliProxy 101Veröffentlicht
X-Post in Ihrem Land zurückgehalten: Was bedeutet das?
Autor: Acar DiveroliProxy 101Veröffentlicht
Access Denied auf Websites: Was bedeutet Reference #18?
Autor: Enver KayaAnleitungenVeröffentlicht
JSON mit Python Requests per POST senden: cURL-Äquivalente
Autor: Acar DiveroliAnleitungenVeröffentlicht
Einen Web-Crawler in Python bauen: Schritt für Schritt
Autor: Acar DiveroliWeb ScrapingVeröffentlicht
Was ist Uptime Kuma? Einrichtung und Überwachung per Proxy
Autor: Enver KayaAnwendungsfälleVeröffentlicht
Was ist ein CAPTCHA? Warum schlägt die Prüfung fehl?
Autor: Enver KayaProxy 101Veröffentlicht
Was ist BeautifulSoup und wie nutzt man es in Python?
Autor: Acar DiveroliWeb ScrapingVeröffentlicht
Was ist Crawl4AI? Einrichtung und Proxy-Konfiguration
Autor: Acar DiveroliKIVeröffentlicht
Alle Bilder von einer Website ohne Code herunterladen
Autor: Enver KayaWeb ScrapingVeröffentlicht
Die Sitemap einer Website finden und alle Seiten auflisten
Autor: Acar DiveroliWeb ScrapingVeröffentlicht
Keine passenden Beiträge
Veröffentlicht
Veröffentlicht