Ihr Zugriffsprotokoll zeigt 40.000 Anfragen von gestern, die alle ExampleBot/1.0 (+https://bot.example/about) angeben. Ein Teil kommt aus den Adressbereichen, die der Betreiber des Bots veröffentlicht, viele aus dem gemeinsam genutzten Bereich eines Cloud-Anbieters, einige aus privaten Internetanschlüssen. Welche davon stammen vom echten Crawler, und welche leihen sich nur seinen Namen? Die Zeile User-Agent kann das nicht beantworten: Jeder Client kann sie frei eintragen.
Web Bot Auth ist die Antwort, die die IETF, das Gremium hinter vielen Internetprotokollen, gerade standardisiert: Der Bot signiert jede Anfrage mit einem privaten Schlüssel, und Ihre Website prüft die Signatur mit einem öffentlichen Schlüssel, den der Betreiber veröffentlicht. Dieser Beitrag erklärt, was Web Bot Auth ist und wo der Standard steht, warum ältere Prüfungen zu kurz greifen, wie eine signierte Anfrage aussieht, wer das Verfahren unterstützt, was es für Website-Betreiber und Bot-Entwickler bedeutet und was eine Signatur nicht beweist.
Was ist Web Bot Auth?
Web Bot Auth ist ein Protokoll, bei dem ein automatisierter Client seine HTTP-Anfragen signiert, damit die empfangende Website prüfen kann, welcher Betreiber sie geschickt hat. Es baut auf HTTP Message Signatures auf, einem IETF-Standard, der im Februar 2024 als RFC 9421 erschienen ist und das Signieren ausgewählter Teile einer HTTP-Nachricht regelt. Web Bot Auth ergänzt die Regeln für Bots: welche Teile signiert werden müssen, einen festen tag-Wert, einen Header, der auf die Schlüssel des Betreibers verweist, und ein Format, in dem diese veröffentlicht werden.
Denselben Namen trägt eine IETF-Arbeitsgruppe, webbotauth. Ihr Arbeitsauftrag (Charter) umfasst Such-Crawler, Webarchive, Linkprüfer, Crawler für KI-Training und KI-Agenten, die im Auftrag eines Nutzers handeln, und zwar auf Websites, die sich vor allem an Menschen richten. Die API-Authentifizierung zwischen Diensten und die Anmeldung von Menschen liegen außerhalb des Auftrags.
Stand 19. November 2026 ist das einzige angenommene Dokument der Gruppe der Internet-Draft HTTP Message Signatures for automated traffic (draft-ietf-webbotauth-httpsig-protocol-01, 29. Oktober 2026). Geschrieben haben ihn Autoren von Cloudflare und Google, Ziel ist der Standards Track, also der Weg zum offiziellen Standard. Er ersetzt zwei frühere Entwürfe, einen zur Architektur und einen zum Schlüsselverzeichnis. Ein Internet-Draft ist ein Arbeitsstand; Feldnamen und Regeln können sich noch ändern.
Warum reichen User-Agent und IP-Listen nicht aus?
Der User-Agent-Header und IP-Allowlists erkennen einen Bot an Merkmalen, die andere Clients kopieren oder mitbenutzen können; keines von beiden beweist, wer eine Anfrage geschickt hat. Der User-Agent ist eine Textzeile, die der Client selbst schreibt; wie sie aufgebaut ist, erklären wir in Was ist ein User-Agent? Ein ordentlicher Crawler trägt dort seinen Namen und eine Info-URL ein, aber nichts hindert einen anderen Client daran, genau dieselbe Zeile zu senden.
Auf unserem Testrechner haben wir einen kleinen Server auf 127.0.0.1 gestartet, der die Anfrage-Header zurückgibt, und ihm dann curl -A "ExampleBot/1.0 (+https://example.com/bot)" geschickt. Der Server erhielt genau diese Zeichenkette als User-Agent, ohne dass irgendetwas in der Anfrage eine Verbindung zu example.com belegte.
IP-Listen sind belastbarer, scheitern aber in drei häufigen Fällen. Bots auf gemeinsam genutzter Cloud-Infrastruktur senden von Adressen, die auch andere Kunden verwenden. KI-Agenten, die für einen Nutzer handeln, laufen womöglich in dessen Browser und senden daher von einem privaten oder Büroanschluss. Und Betreiber ändern ihre Adressbereiche, sodass die Liste vom letzten Monat heute falsch sein kann.
Die klassische Prüfung für große Crawler ist das vorwärts bestätigte Reverse DNS (PTR-Eintrag): Die Website schlägt den Hostnamen hinter der IP nach, prüft, ob er zur Domain des Betreibers gehört, löst diesen Hostnamen dann wieder auf und kontrolliert, ob dieselbe IP herauskommt. Das funktioniert bei Betreibern mit eigenem Adressraum, aber nicht bei einem Agenten auf einer geteilten Cloud-Adresse oder dem Laptop eines Nutzers.
Wie funktioniert Web Bot Auth?
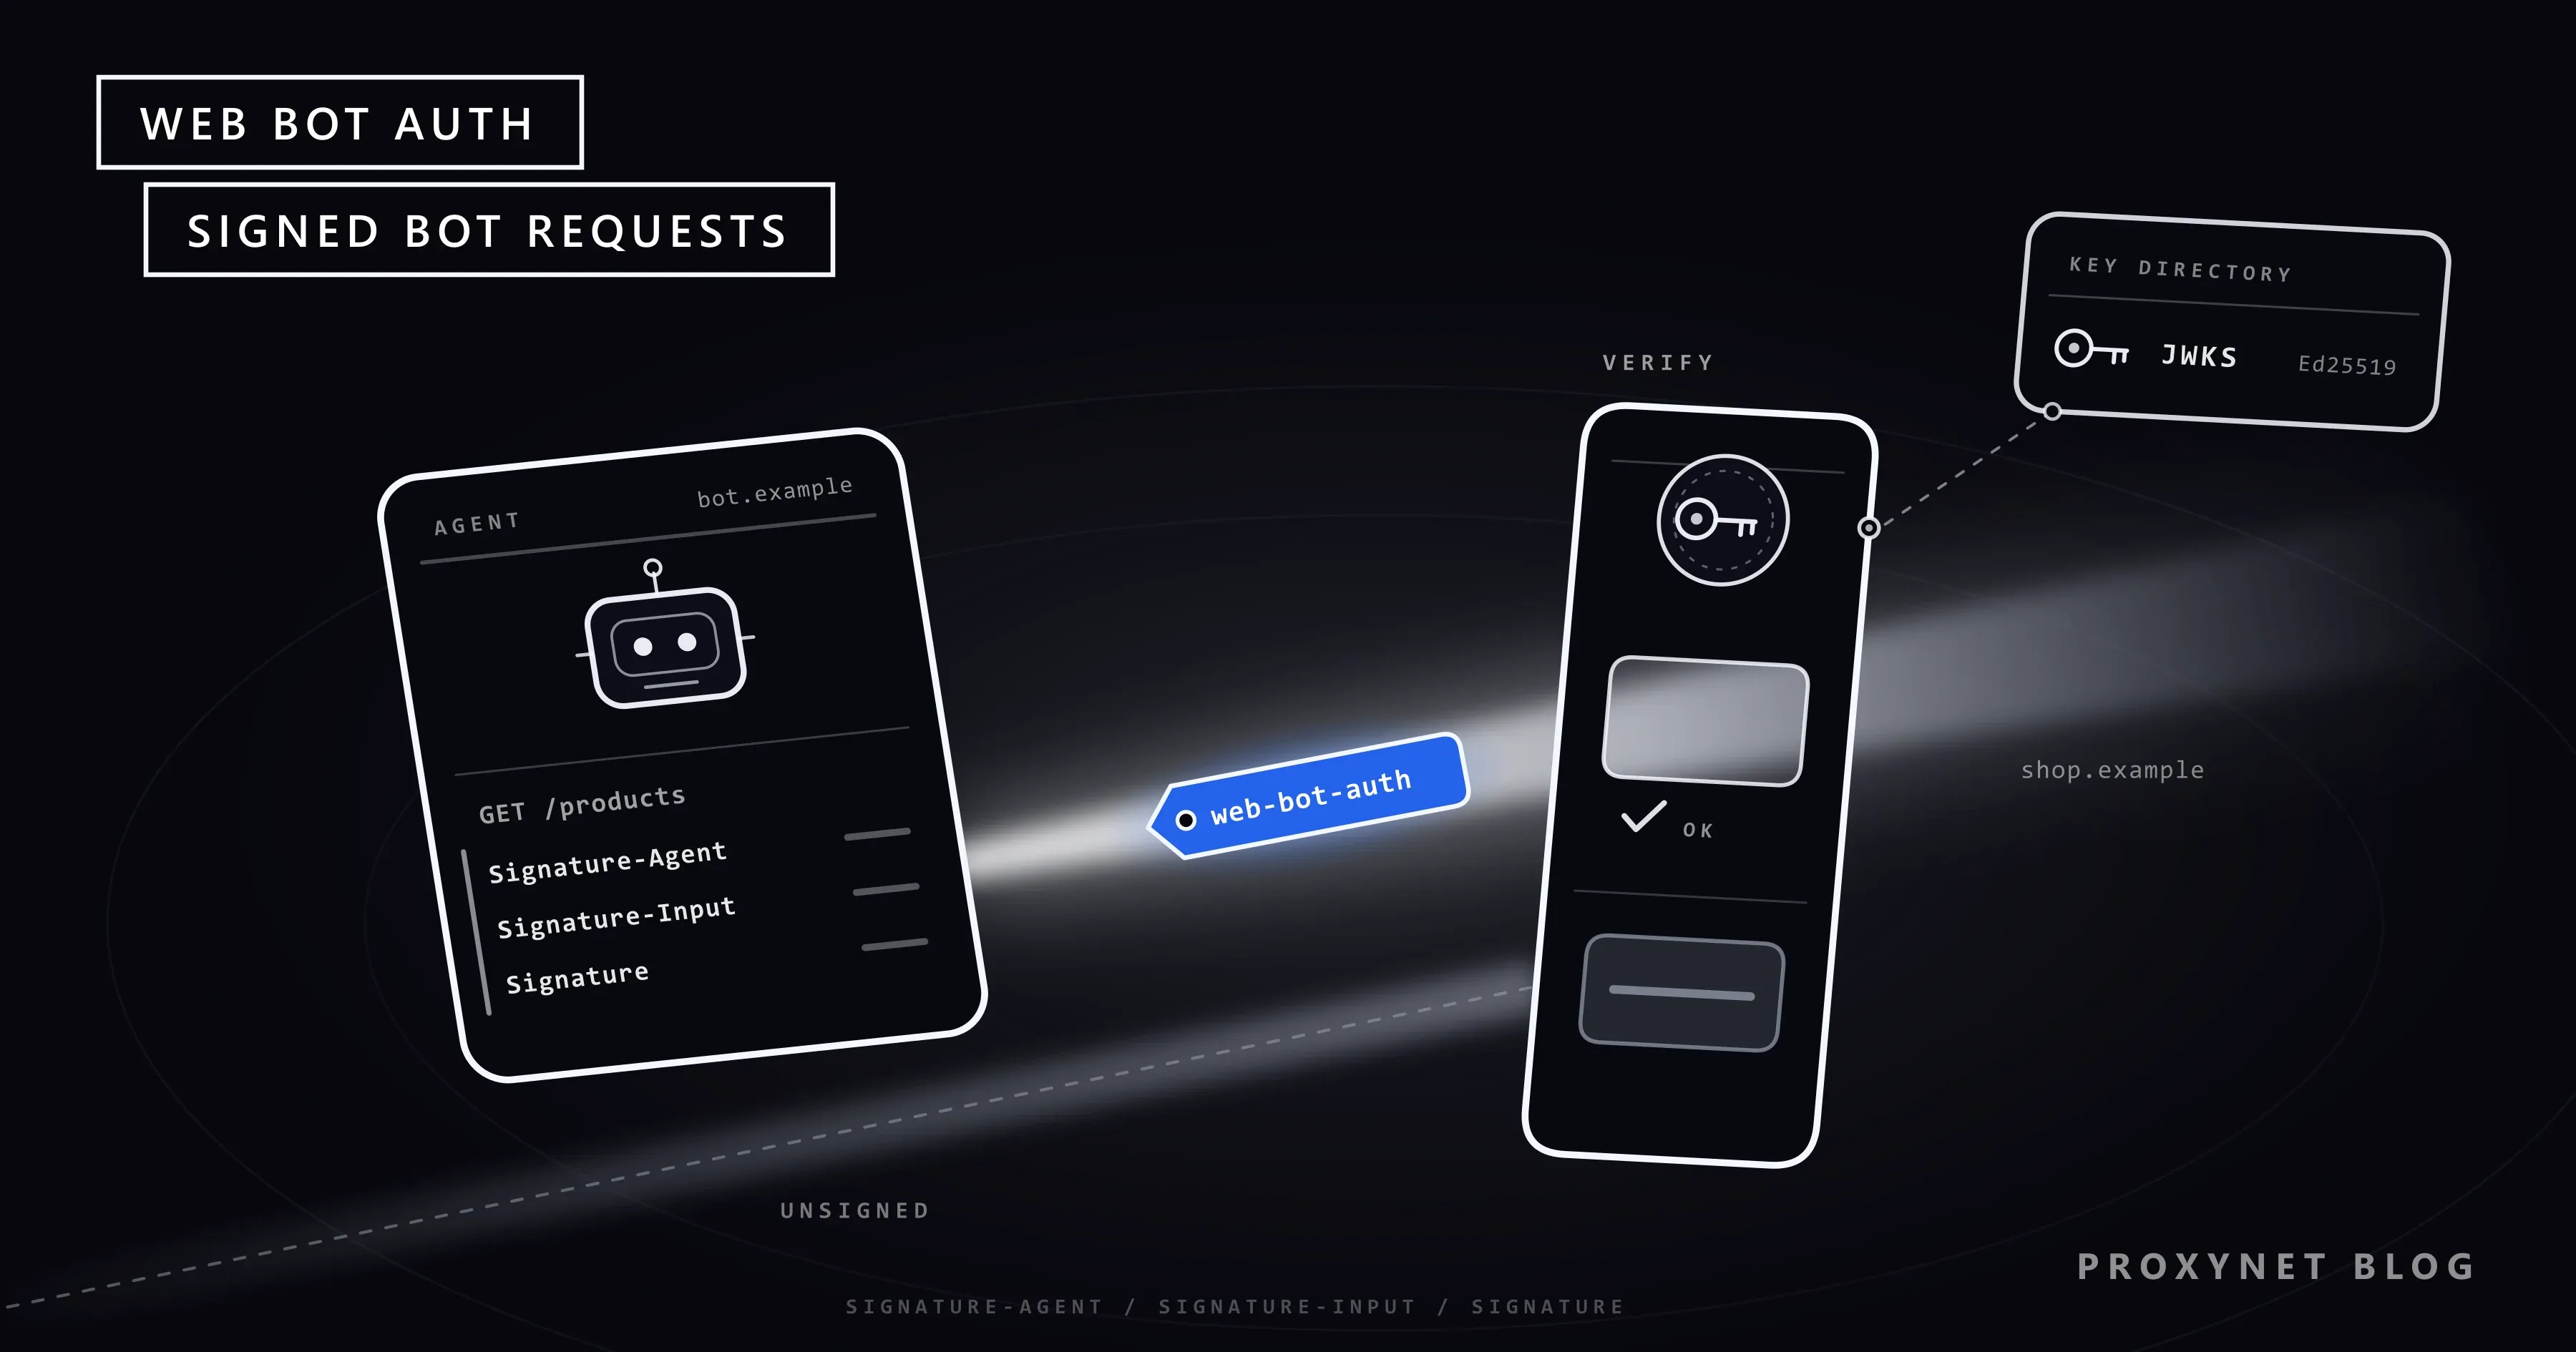
Web Bot Auth besteht aus einem Signaturschritt auf der Seite des Bots und einem Schritt aus Abrufen und Prüfen auf der Seite der Website:
- Der Betreiber erzeugt ein Schlüsselpaar. Der private Schlüssel bleibt beim Bot. Ed25519, ein modernes Signaturverfahren mit kurzen Schlüsseln, wird in den Beispielen des Entwurfs verwendet und ist das Verfahren, das Cloudflare akzeptiert.
- Der Betreiber veröffentlicht den öffentlichen Schlüssel. Er landet in einem Schlüsselverzeichnis, einem JSON Web Key Set (JWKS), das per HTTPS ausgeliefert wird; der Entwurf legt dafür auch einen festen Pfad fest,
/.well-known/http-message-signatures-directory. - Der Bot signiert jede Anfrage. Er erfasst mindestens den Host (
@authority) oder die vollständige Ziel-URI sowie den HeaderSignature-Agent, ergänzt Erstellungszeit, Ablaufzeit, Schlüsselkennung und das Tagweb-bot-authund signiert dann. - Der Bot sendet drei zusätzliche Header.
Signature-Inputlistet auf, was signiert wurde,Signatureenthält die Signatur, undSignature-Agentnennt die Adresse des Schlüsselverzeichnisses. - Die Website lädt den Schlüssel. Der Verifizierer, oft ein CDN oder eine Web Application Firewall, lädt das Verzeichnis herunter, speichert es zwischen und wählt den Schlüssel, der zur
keyidpasst. - Die Website prüft und entscheidet. Sie setzt die signierten Daten aus der empfangenen Anfrage neu zusammen, prüft die Signatur und das Zeitfenster und wendet dann ihre eigene Richtlinie an: zulassen, drosseln oder sperren.
Weil die Signatur den Host einschließt, lässt sich eine für eine Website erzeugte Signatur auf einer anderen nicht verifizieren; der Entwurf empfiehlt zudem, dass sie innerhalb von 24 Stunden abläuft.
Wie sieht eine signierte Anfrage aus?
Eine signierte Anfrage ist eine gewöhnliche HTTP-Anfrage mit drei weiteren Headern. Das Beispiel nutzt erfundene, gekürzte Werte für einen fiktiven Bot unter bot.example, der eine Seite von shop.example abruft.
GET /products HTTP/1.1
Host: shop.example
User-Agent: ExampleBot/1.0 (+https://bot.example/about)
Signature-Agent: sig1="https://bot.example/.well-known/http-message-signatures-directory"
Signature-Input: sig1=("@authority" "signature-agent";key="sig1");created=1795046400;expires=1795050000;keyid="x7Qp…3kLa";tag="web-bot-auth"
Signature: sig1=:jR3x…Q2Bw==:
Die Kennzeichnung sig1 verbindet die drei Header miteinander, sodass eine Anfrage mehr als eine Signatur tragen kann. created und expires sind Unix-Zeitstempel, hier eine Stunde auseinander.
| Header | Was er enthält | Wer ihn liest |
|---|---|---|
Signature-Agent | Adresse des Schlüsselverzeichnisses | Verifizierer, um Schlüssel zu laden |
Signature-Input | Signierte Teile, Zeiten, Schlüsselkennung, Tag | Verifizierer, um die Daten nachzubauen |
Signature | Die Signatur selbst | Verifizierer, um sie zu prüfen |
User-Agent | Bot-Name und Info-URL | Protokolle und Menschen |
Die keyid ist der JWK-Thumbprint des Schlüssels, ein SHA-256-Hash des öffentlichen Schlüssels. Auf unserem Testrechner ergab ein Wegwerf-Schlüssel vom Typ Ed25519, in Node.js erzeugt, eine Schlüsselkennung mit 43 Zeichen und eine Signatur mit 64 Byte, in Base64 also 88 Zeichen. Als wir den signierten Host von shop.example auf shop.example.net änderten, schlug die Verifizierung fehl.
Wie schneiden alte und neue Prüfungen im Vergleich ab?
Web Bot Auth verlagert den Identitätsnachweis von der Netzwerkadresse auf einen Schlüssel, den der Betreiber kontrolliert.
| Prüfung | Worauf die Website schaut | Wo sie scheitert |
|---|---|---|
| User-Agent | Einen Text-Header | Jeder kann ihn kopieren |
| IP-Allowlist | Die Absenderadresse | Geteilte Cloud, Nutzergeräte |
| Reverse DNS | Hostname der IP | Braucht eigenen IP-Raum |
| Web Bot Auth | Eine Signatur und einen Schlüssel | Websites müssen sie prüfen |
In der Praxis werden diese Prüfungen kombiniert, nicht ausgetauscht: Google rät, IP-, Reverse-DNS- und User-Agent-Prüfungen neben Signaturen beizubehalten, weil noch nicht jede Anfrage signiert ist.
Was beweist eine gültige Signatur, und was nicht?
Eine gültige Signatur beweist, dass die Anfrage mit einem Schlüssel signiert wurde, der im Verzeichnis unter der Signature-Agent-Adresse steht, und nicht mehr. Der Entwurf sagt das klar: Die Signatur verrät weder, wer den Agenten betreibt, noch ob er harmlos ist oder ob die Anfrage erlaubt ist.
- Identität ist keine Erlaubnis. Auch ein verifizierter Bot kann gedrosselt, von Pfaden ausgeschlossen oder gesperrt werden; robots.txt und die Nutzungsbedingungen einer Website gelten weiter.
- Wem das Verzeichnis gehört, der ist die Identität. Wird ein Schlüssel gestohlen, verifizieren damit signierte Anfragen so lange, bis der Betreiber ihn aus dem Verzeichnis entfernt.
- Signierte Anfragen lassen sich verknüpfen. Websites können Anfragen mit derselben Kennung einander zuordnen; für Agenten, die anonym bleiben müssen, eignet sich das Protokoll daher nicht.
Ebenso wenig regelt es, was ein Agent mit den abgerufenen Inhalten macht: Auch ein verifizierter Agent kann durch Anweisungen in die Irre geführt werden, die in einer Seite versteckt sind, ein eigenes Risiko namens Prompt Injection.
Wer unterstützt Web Bot Auth heute?
Stand 19. November 2026 prüfen Cloudflare und AWS WAF Signaturen nach Web Bot Auth, Google signiert einen Teil des Traffics eines Agenten, und Shopify fordert Bots zum Signieren auf. Die Details ändern sich mit dem Entwurf; prüfen Sie daher jeweils die aktuelle Seite des Anbieters.
- Cloudflare. Laut seiner Web-Bot-Auth-Dokumentation nutzt Cloudflare das Verfahren, um Bots in seinem Programm Verified bots zu verifizieren: Betreiber hosten ein Schlüsselverzeichnis, melden es an und signieren mit Ed25519. Seit dem 1. Juli 2026 werden signierte Agenten ebenfalls unter Verified bots geführt.
- AWS WAF. Die Regelgruppe AWS WAF Bot Control prüft Signaturen ab Version 4.0 und versieht jede Anfrage mit dem Label
verified,invalid,expiredoderunknown_bot, sodass Website-Betreiber Regeln auf das Ergebnis aufbauen können. - Google. Googles Seite zu Web Bot Auth bezeichnet die eigene Umsetzung als experimentell: Ein Teil der Anfragen von
Google-Agentwird alshttps://agent.bot.googsigniert. - Shopify. Ein Entwickler-Changelog vom Mai 2026 fordert Bots und Agenten auf Shopify-Storefronts auf, mit Web Bot Auth zu signieren; unsignierter Traffic erhält die strengsten Rate Limits.
Was bedeutet Web Bot Auth für Website-Betreiber?
Für Website-Betreiber wird die Frage „Ist das wirklich dieser Bot?“ mit Web Bot Auth von einer Vermutung zu einer Prüfung, und der größte Teil der Arbeit passiert im CDN oder in der Firewall, nicht in Ihrer Anwendung.
Eine vernünftige Ausgangsrichtlinie: Lassen Sie die verifizierten Crawler, die Sie haben möchten, mit normaler Rate durch, und geben Sie unsignierter Automatisierung ein niedrigeres Rate Limit statt einer pauschalen Sperre, denn die meisten Bots signieren noch nicht. Beobachten Sie die Ergebnisse invalid und expired; sie deuten auf fehlerhafte Einrichtungen oder kopierte Header hin. Wenn Sie Signaturen selbst prüfen, speichern Sie Schlüsselverzeichnisse zwischen, folgen Sie beim Abruf keinen Weiterleitungen und beantworten Sie unsignierte Anfragen an geschützte Pfade mit einem 403 und einem Accept-Signature-Header, wie der Entwurf es empfiehlt.
Eine signierte Identität macht auch Ihre veröffentlichten Vorgaben leichter durchsetzbar. Die robots.txt legt fest, welche Pfade ein Bot crawlen darf, wie in Was ist robots.txt und wie liest man die Datei? beschrieben, und mit Web Bot Auth können Sie prüfen, ob ein Bot, der diese Regeln zu befolgen behauptet, auch wirklich der ist, für den er sich ausgibt.
Was bedeutet es für Entwickler von Bots und Agenten?
Für Betreiber von Crawlern und Agenten ist Web Bot Auth ein Weg, erkannt zu werden, ohne dass jede Website eine IP-Liste für sie pflegen muss; der Preis dafür ist die Schlüsselverwaltung.
- Getrennte Identitäten verwenden. Laut Entwurf sollen ein Crawler und ein Agent, der für einen Nutzer handelt, eigene
Signature-Agent-URLs, Schlüssel und Verzeichnisse nutzen. - Signaturen kurzlebig halten. Setzen Sie
expiresnah ancreated. - Schlüssel rotieren. Veröffentlichen Sie den neuen Schlüssel, bevor Sie ihn verwenden, und entfernen Sie danach den alten.
- Den privaten Schlüssel schützen. Bewahren Sie ihn auf wie jede andere Zugangsinformation; gemeinsame geheime Schlüssel (HMAC) sind nicht zulässig.
- Gute Umgangsformen behalten. Ein klarer
User-Agent, die robots.txt und ein maßvolles Anfragetempo zählen weiterhin.
Für Agenten, die für einen Nutzer einkaufen oder bezahlen, ist die Signatur nur die halbe Geschichte; die Zahlungsseite behandelt Warum werden KI-Shopping-Agenten auf Websites blockiert?
Ändert ein Proxy die Identität eines Bots bei Web Bot Auth?
Nein. Bei Web Bot Auth steckt die Identität eines Bots in seinem Schlüssel, nicht in der IP-Adresse, von der sein Traffic ausgeht; ein Proxy bestimmt also, wo eine Anfrage austritt, aber nicht, wer der Bot ist. Der Entwurf hält fest, dass die Signatur nicht von der IP abhängt und dass ein Proxy die Signatur-Header nicht entfernen sollte. Bei HTTPS leitet ein Proxy die verschlüsselte Verbindung nur durch, sodass die signierten Header so ankommen, wie der Bot sie gesendet hat.
Diese Trennung ist für Crawler-Teams nützlich: Die Signatur beantwortet „Wer ist das?“, der Austrittsort beantwortet „Was zeigt diese Seite Besuchern in Deutschland oder Brasilien?“, etwa beim Prüfen lokalisierter Preise. Unsere Seite Web-Crawler-Proxy beschreibt Geo-Targeting und einstellbare Wartezeiten zwischen Anfragen für diese Art des rücksichtsvollen Crawlings.
Braucht ein Crawler eine feste, bekannte Austrittsadresse, etwa um eine Firewall-Regel auf Ihren eigenen Websites zu treffen, liefern Datacenter-Proxy dedizierte IPv4-Adressen. So oder so unterliegt eine signierte Anfrage über einen Proxy weiterhin der Richtlinie der jeweiligen Website.
Wo begegnet Ihnen Web Bot Auth?
- Dashboards von CDN und Firewall: Kategorien verifizierter Bots, Signaturergebnisse und darauf aufbauende Regeln.
- Such- und KI-Crawler: Betreiber, die Schlüsselverzeichnisse neben ihrer Crawler-Dokumentation veröffentlichen.
- KI-Agenten im Auftrag von Nutzern: Browsing- und Shopping-Agenten, die einige oder alle ihrer Anfragen signieren.
- Shop-Plattformen: Storefronts, die signierten Bots höhere Rate Limits einräumen.
- Monitoring und Linkprüfung: Uptime-Monitore, die sich von Angriffen unterscheiden lassen wollen.
Häufige Fehler
- Es als RFC bezeichnen. Web Bot Auth ist ein Entwurf einer Arbeitsgruppe, der auf RFC 9421 aufbaut; er kann sich noch ändern.
- Eine gültige Signatur als Erlaubnis werten. Sie beweist den Schlüssel, nicht gute Absichten oder ein Recht zum Crawlen.
- Alle unsignierten Bots sperren. Der meiste automatisierte Traffic ist noch nicht signiert; Rate Limits sind ein sanfterer erster Schritt.
- Die alten Prüfungen streichen. Google selbst rät, IP-, Reverse-DNS- und User-Agent-Prüfungen während der Einführung beizubehalten.
- Langlebige Signaturen. Eine tagelang gültige Signatur verlängert das Leben kopierter Header.
- Ein Schlüssel für alles. Ein Crawler und ein nutzergesteuerter Agent sollten keine Identität teilen.
Entscheidungshilfe
| Ihre Situation | Was zu tun ist |
|---|---|
| Ihre Website steht hinter einem CDN oder einer WAF | Signaturprüfung einschalten, Regeln auf das Ergebnis aufbauen |
| Gefälschter Crawler-Traffic füllt Ihre Protokolle | Verifizierte Bots zulassen, unverifizierte drosseln |
| Sie betreiben einen Crawler | Schlüsselverzeichnis veröffentlichen, jede Anfrage signieren |
| Sie betreiben einen KI-Agenten für Nutzer | Eigenen Schlüssel und eigenes Verzeichnis getrennt vom Crawler nutzen |
| Sie prüfen Signaturen selbst | Verzeichnisse zwischenspeichern, keine Weiterleitungen, kurze Zeitfenster |
| Sie brauchen eine feste oder lokale Austritts-IP | Proxy nutzen; die Signatur bleibt dieselbe |
Häufige Fragen
Ist Web Bot Auth ein offizieller Standard?
Noch nicht. Es ist ein Internet-Draft der IETF-Arbeitsgruppe Web Bot Auth mit Ziel Standards Track. Das darunterliegende Signaturverfahren, HTTP Message Signatures, ist bereits ein Standard: RFC 9421.
Ist Web Bot Auth dasselbe wie Verified bots bei Cloudflare?
Nein. Web Bot Auth ist ein offenes Protokoll, das jede Website, jedes CDN und jede Firewall prüfen kann. Das Programm Verified bots von Cloudflare ist ein Ort, an dem es genutzt wird, neben anderen Prüfungen wie veröffentlichten IP-Listen und Reverse DNS.
Unterstützt AWS WAF Web Bot Auth?
Ja. AWS WAF Bot Control prüft Signaturen ab Version 4.0 der Regelgruppe und fügt ein Label mit dem Ergebnis hinzu, etwa verified oder unknown_bot, auf das Ihre eigenen Regeln reagieren können.
Brauche ich Cloudflare, um Anfragen mit Web Bot Auth zu signieren?
Nein. Sie brauchen ein Schlüsselpaar, ein Schlüsselverzeichnis unter einer HTTPS-Adresse, die Sie kontrollieren, und Signaturcode in Ihrem Bot. Shopify etwa erklärt, dass Bots sich nicht bei Cloudflare registrieren müssen, um Anfragen an seine Storefronts zu signieren.
Ersetzt Web Bot Auth die robots.txt?
Nein. Die robots.txt sagt Bots, welche Pfade sie crawlen dürfen; Web Bot Auth sagt der Website, welcher Bot fragt. Beides arbeitet zusammen.
Kann jemand eine signierte Anfrage kopieren und wiederverwenden?
Nur in engen Grenzen. Die Signatur umfasst den Host, scheitert also auf einer anderen Website, und sie trägt eine Ablaufzeit. Websites, die strengeren Schutz brauchen, können eine nonce verlangen, einen Einmalwert, und bereits gesehene Signaturen ablehnen.
Fazit
Web Bot Auth gibt Bots und KI-Agenten eine überprüfbare Identität: Der Betreiber veröffentlicht einen öffentlichen Schlüssel, der Bot signiert jede Anfrage mit HTTP Message Signatures, und die Website prüft die Signatur, statt einer User-Agent-Zeichenkette oder einer IP-Liste zu vertrauen. Es ist noch ein IETF-Entwurf, wird aber bereits von Cloudflare und AWS WAF geprüft und von Google erprobt. Eine Signatur beweist, wer fragt, nicht, was er darf; robots.txt, Rate Limits und die Richtlinien der Website entscheiden weiterhin. Wo die Anfragen Ihres Crawlers austreten, ist eine eigene Frage, und diese Seite decken unsere Proxy-Dienste ab.