Ein kleiner Onlineshop verkauft über die eigene Website und auf zwei Marktplätzen. Am Montagmorgen stellt die Inhaberin eine einzige Frage: Wie viel haben wir gestern verkauft? Die Antwort steckt in drei Exporten mit drei Spaltenaufbauten, zwei Währungen und Zeitstempeln in zwei Zeitzonen, und eine Bestellung taucht doppelt auf, weil sie erstattet und neu aufgegeben wurde. Aus diesen Dateien eine ehrliche Zahl zu machen, ist Datenaggregation.
Dieser Beitrag behandelt die zwei Bedeutungen des Begriffs, die Schritte eines Aggregationsjobs, die Funktionen, die zusammenfassen, die Aggregation nach Zeit und Ort, Beispiele vom Preisvergleich bis zum Open Banking, die Grenze, an der aggregierte Daten nicht mehr anonym sind, und die Fehler, die eine Summe verfälschen.
Was ist Datenaggregation?
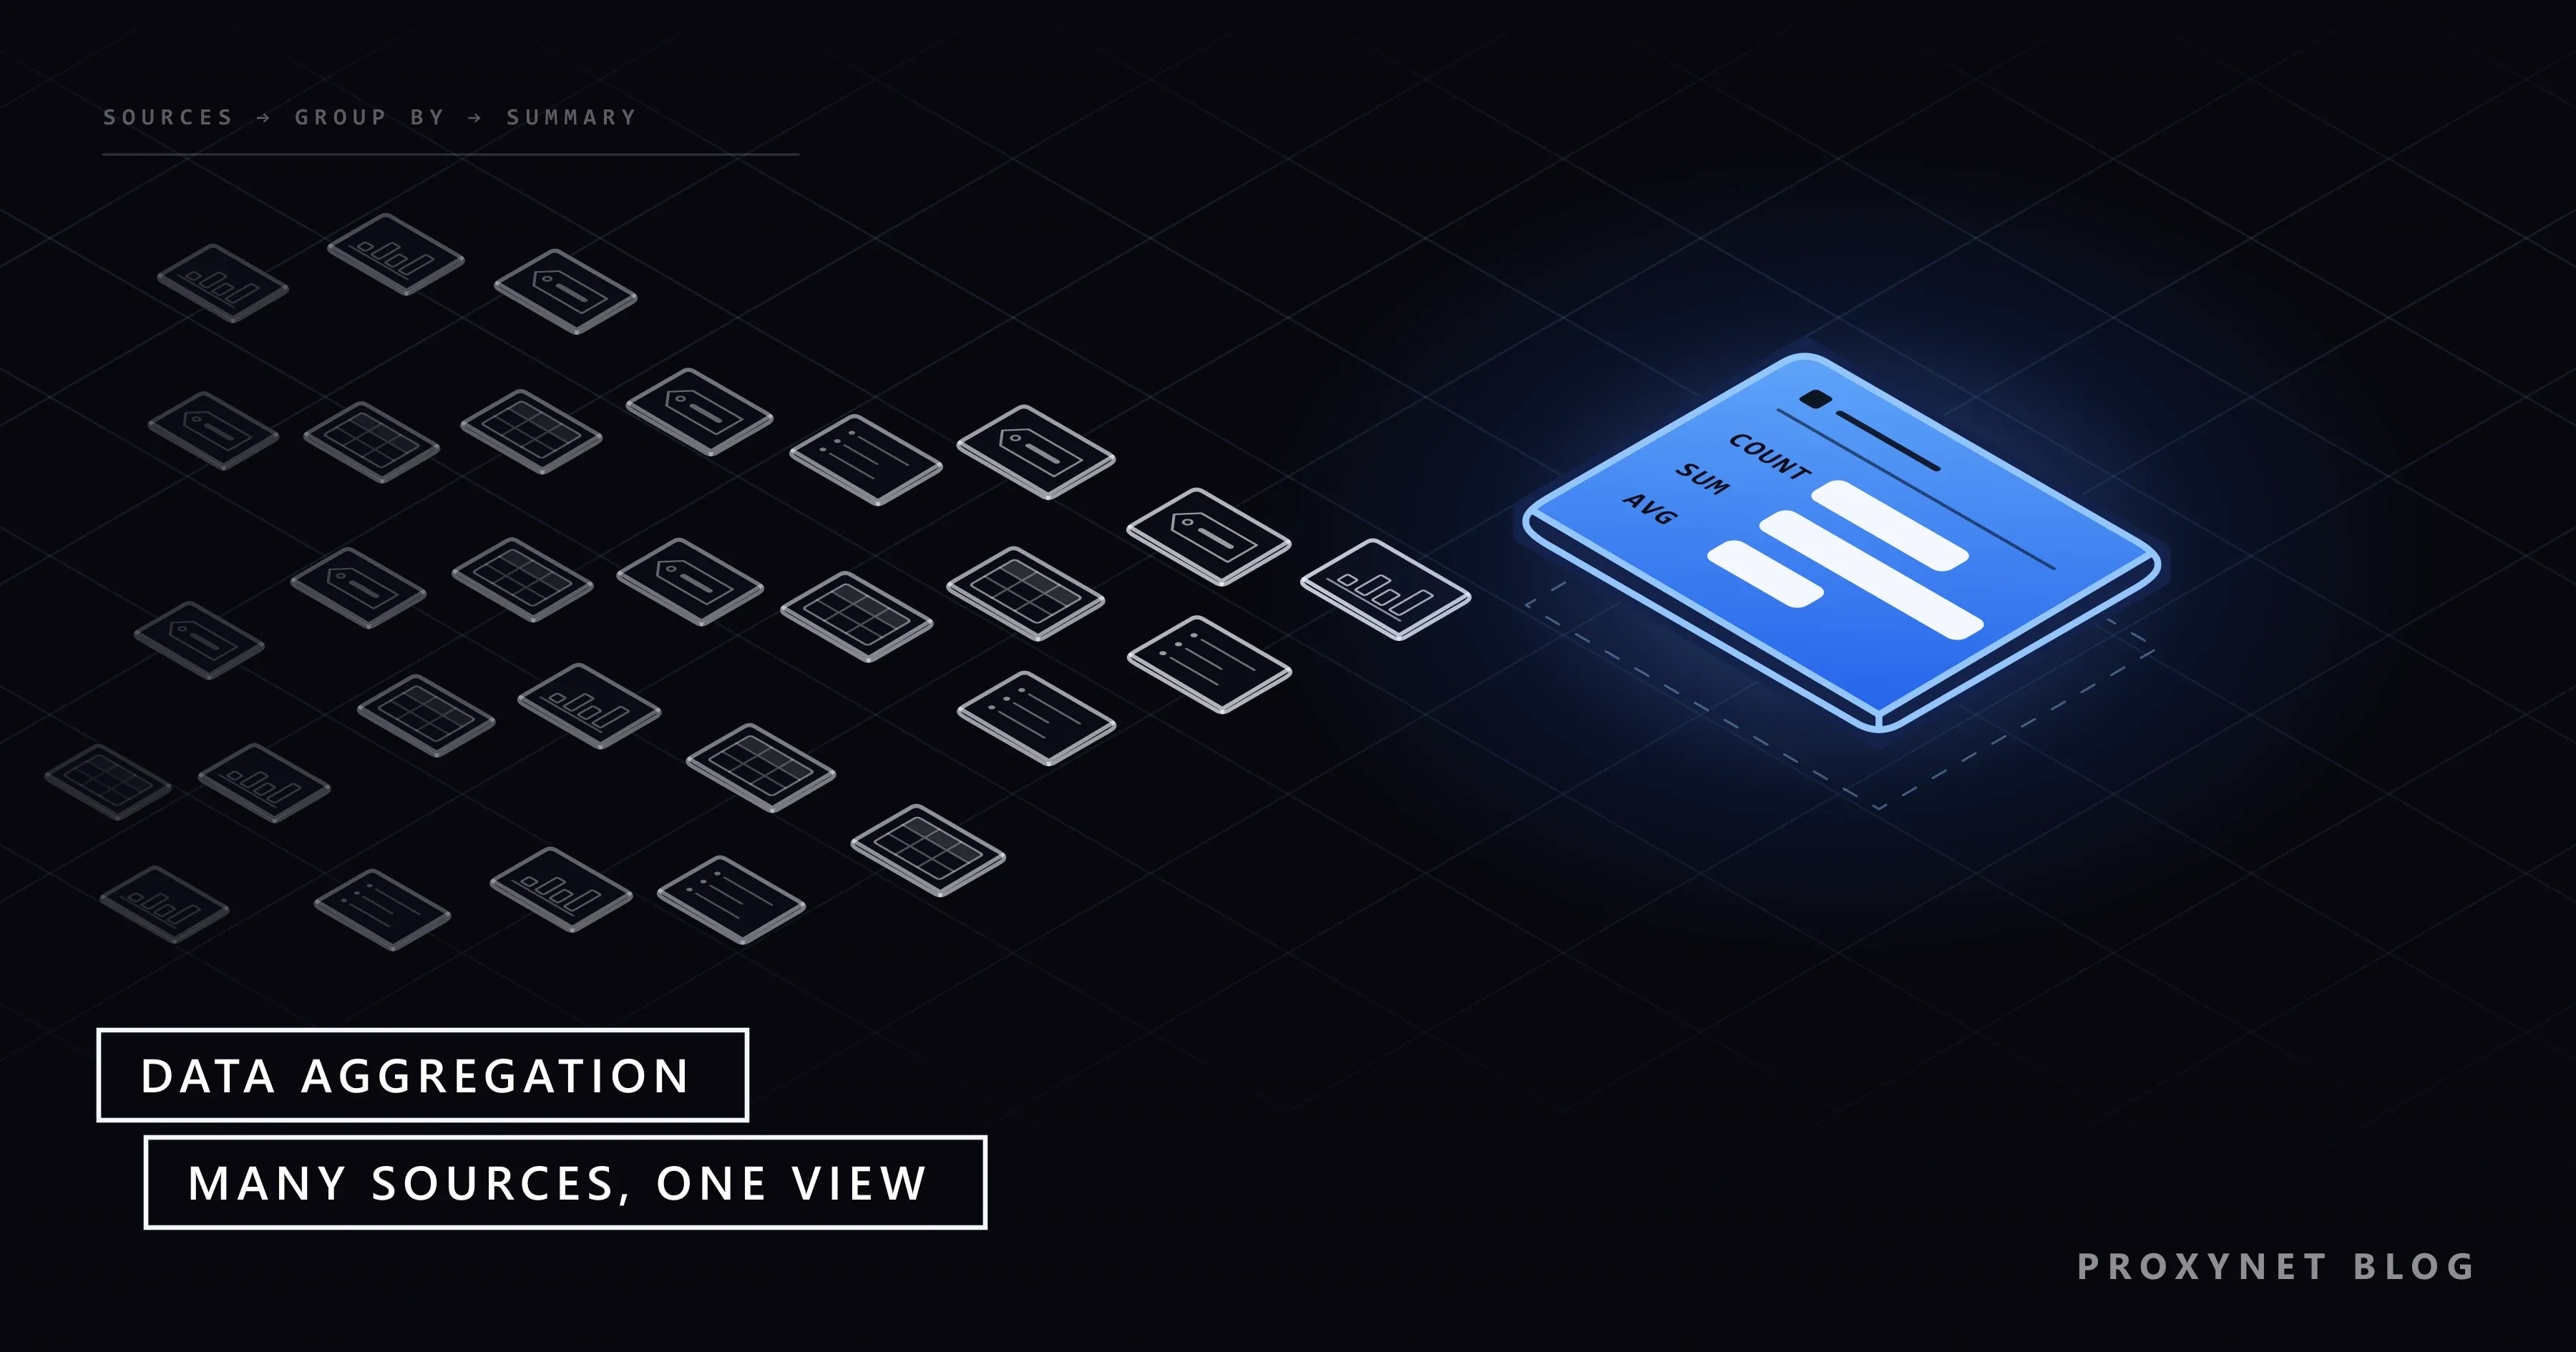
Datenaggregation heißt, Daten aus mehreren Quellen oder vielen Einträgen zusammenzuführen und als Zusammenfassung darzustellen. Das Wort wird in zwei verwandten Bedeutungen verwendet, und die meisten realen Jobs umfassen beide.
Die erste Bedeutung ist das Zusammentragen aus vielen Quellen: Einträge aus verschiedenen Systemen, Dateien oder Websites werden in einem Datensatz mit einheitlicher Struktur vereint. Ein Reiseportal, das Tarife vieler Fluggesellschaften zeigt, ist in diesem Sinn ein Aggregator.
Die zweite Bedeutung ist das Zusammenfassen: Viele Zeilen werden auf wenige Werte reduziert. Aus Tausenden Bestellpositionen wird pro Tag „1.284 Bestellungen, 52.300 Euro Umsatz, 40,73 Euro pro Bestellung“. In Statistik und Datenbanken meint Aggregation meist diesen zweiten Schritt, und das Ergebnis heißt aggregierte Daten oder zusammengefasste Daten.
Das Glossar des US-Normungsinstituts NIST beschreibt Aggregation knapp als Zusammenführung gleichartiger oder zusammengehöriger Informationen.
Was unterscheidet Rohdaten, aggregierte und disaggregierte Daten?
Rohdaten sind die einzelnen Einträge so, wie sie erfasst wurden, aggregierte Daten sind eine Zusammenfassung dieser Einträge, und disaggregierte Daten sind eine Zusammenfassung, die wieder in Untergruppen aufgeteilt ist. In der Statistik heißen die einzelnen Einträge auch Mikrodaten.
Eine Liste von 5.000 Käufen mit Uhrzeit, Produkt und Filiale sind Rohdaten. „Umsatz pro Tag“ sind aggregierte Daten. „Umsatz pro Tag, aufgeteilt nach Filiale und Kategorie“ sind disaggregierte Daten: weiterhin eine Zusammenfassung, nur feiner aufgelöst.
Die Granularität, also der Detailgrad, den eine Zeile abbildet, ist die entscheidende Wahl. Ist sie zu grob, verschwindet das Muster, das Sie suchen, etwa eine Filiale, die den Durchschnitt nach unten zieht. Ist sie zu fein, werden die Gruppen so klein, dass die Zusammenfassung Einzelpersonen offenlegt.
Wie funktioniert Datenaggregation?
Ein Aggregationsjob bringt die Quellen in eine gemeinsame Form, bereinigt sie und berechnet dann Zusammenfassungen je Gruppe. Sieben Schritte decken die meisten Jobs ab, ob ein Mensch sie in einer Tabellenkalkulation erledigt oder ein Scheduler sie stündlich ausführt:
- Frage und Einheit festlegen. „Umsatz pro Tag und Land, in Euro, nach Bestelldatum in der Zeitzone des Shops“ ist eine Definition; „Verkaufszahlen“ ist keine.
- Aus jeder Quelle erheben. Exporte, Datenbankabfragen, offizielle APIs oder öffentliche Webseiten, jeweils mit notiertem Abrufzeitpunkt.
- Vereinheitlichen. Einheiten, Währungen und Zeitzonen umrechnen und abweichende Kategorienamen und Spalten auf ein Schema abbilden.
- Abgleichen und deduplizieren. Entscheiden, welche Einträge dieselbe Bestellung, dasselbe Produkt oder dasselbe Unternehmen beschreiben, und jeweils einen behalten.
- Gruppieren und berechnen. Die Gruppierungsschlüssel wählen, etwa Tag, Land oder Kategorie, und die Aggregatfunktionen anwenden.
- Ergebnis prüfen. Summen mit einer Quelle vergleichen, der Sie vertrauen, und hinter jeder auffälligen Zahl ein paar Rohzeilen lesen.
- Speichern und aktualisieren. Die Zusammenfassung mit Definition, Quellen und Zeitpunkt sichern und neu berechnen, sobald neue Daten eintreffen.
Die Schritte 3 und 4 kosten den meisten Aufwand. Eine geplante Aggregation sitzt meist in einer Pipeline aus Extrahieren, Transformieren und Laden; Was ist ETL? zeigt, wie ein solcher Job aufgebaut wird.
Welche Funktionen werden zum Aggregieren verwendet?
Die zentralen Aggregatfunktionen sind Anzahl, Summe, Mittelwert, Minimum und Maximum, oft ergänzt um Median, Anzahl eindeutiger Werte und Perzentile. Das PostgreSQL-Handbuch fasst die Idee in einem Satz zusammen: Eine Aggregatfunktion berechnet aus mehreren Eingabezeilen ein einziges Ergebnis (PostgreSQL-Tutorial zu Aggregatfunktionen).
In SQL legt die Klausel GROUP BY fest, welche Zeilen gemeinsam zusammengefasst werden. Diese Abfrage liefert eine Zeile pro Tag und Land mit der Zahl der Bestellungen und dem Umsatz:
SELECT order_day, country, COUNT(*) AS orders, SUM(amount_eur) AS revenue
FROM orders
WHERE status = 'paid'
GROUP BY order_day, country;
Zwei Details bringen viele aus dem Tritt. WHERE filtert Zeilen, bevor sie gruppiert werden, HAVING filtert dagegen die Gruppen danach, etwa um nur Länder mit mehr als 100 Bestellungen zu behalten. Und ein Mittelwert aus Mittelwerten ist meist falsch: Hat eine Filiale 10 Bestellungen mit durchschnittlich 80 und eine andere 1.000 Bestellungen mit durchschnittlich 20, liegt der gemeinsame Durchschnitt bei etwa 20,6, nicht bei 50. Berechnen Sie Mittelwerte neu aus den zugrunde liegenden Summen und Anzahlen. Pivot-Tabellen in Tabellenkalkulationen gruppieren genauso, nur mit einer anderen Oberfläche.
Welche Arten der Datenaggregation gibt es?
Die wichtigsten Arten unterscheiden sich darin, wonach sie gruppieren: Zeit, Ort, Kategorie oder Quelle. Ein Job kombiniert oft mehrere davon.
| Art | Gruppiert nach | Beispiel | Achten Sie auf |
|---|---|---|---|
| Zeitlich | Stunde, Tag, Monat | Tagesumsatz | Zeitzonen, angebrochene Zeiträume |
| Räumlich | Region, Stadt, Rasterzelle | Umsatz pro Region | Grenzen, kleine Gebiete |
| Kategorie | Produkt, Segment, Kanal | Umsatz pro Kategorie | Abweichende Kategorielisten |
| Über Quellen | Shop, Lieferant, Bank | Alle Angebote in einer Ansicht | Duplikate, Einheiten |
Zeitliche Aggregation fasst Ereignisse zu Zeiträumen zusammen: Klicks pro Stunde, Bestellungen pro Tag, Preise pro Woche. Der Zeitraum verändert, was Sie sehen; Tagesdaten zeigen Wochenenden, Monatsdaten verbergen sie.
Räumliche Aggregation fasst Daten nach Gebiet zusammen: Punkte auf einer Karte werden zu Anzahlen je Postleitzahlbezirk, Stadt oder Land. Dieselben Kunden, einmal nach Bezirk und einmal nach Stadt gruppiert, können unterschiedliche Geschichten erzählen, und ein sehr kleines Gebiet kann so wenige Menschen umfassen, dass die Zusammenfassung einen einzelnen Haushalt beschreibt.
Aggregation nach Kategorie und Quelle gruppiert nach Merkmalen wie Produktart, Kanal oder Lieferant. Schwierig ist die Einigung auf die Merkmale, denn zwei Marktplätze teilen selten denselben Kategoriebaum.
Warum verändern Zeitzonen aggregierte Summen?
Zeitzonen verändern aggregierte Summen, weil „ein Tag“ in jeder Zone zu einem anderen Zeitpunkt beginnt, sodass Bestellungen kurz vor Mitternacht von einem Tag in den nächsten rutschen. Die Summe über alle Tage bleibt gleich, die Tageswerte aber nicht.
Auf unserem Testrechner haben wir sechs Bestellungen mit UTC-Zeitstempeln in eine SQLite-Tabelle im Arbeitsspeicher geschrieben und zweimal pro Tag summiert: einmal nach dem UTC-Datum und einmal nach dem Datum eines Shops, der in UTC+3 arbeitet. Beide Varianten ergaben insgesamt dieselben 240, doch der erste Tag lag in UTC bei 160 und in der Ortszeit des Shops bei 65, weil zwei Bestellungen am späten Abend über Mitternacht fielen.
Keine der beiden Zahlen ist falsch; sie beantworten verschiedene Fragen. Legen Sie für jeden Bericht eine Zeitzone fest, schreiben Sie sie in die Definition und rechnen Sie jede Quelle vor dem Gruppieren in diese Zone um.
Manuelle oder automatisierte Aggregation: Was brauchen Sie?
Manuelle Aggregation heißt, dass ein Mensch Dateien in einer Tabellenkalkulation zusammenfasst; automatisierte Aggregation heißt, dass ein geplanter Job dieselben Schritte ausführt. Die Wahl hängt davon ab, wie oft sich die Frage wiederholt und wie viele Quellen einfließen.
Eine einmalige Übersicht aus vier Preislisten ist von Hand schneller erstellt, und ein Mensch bemerkt unterwegs ungewöhnliche Werte. Ein tägliches Dashboard mit zwanzig Quellen braucht Automatisierung, denn handgemachte Kopien laufen auseinander und Schritte werden übersprungen. Automatisierung wiederholt allerdings auch eine falsche Definition getreu, deshalb gehören die Prüfungen aus Schritt 6 in den Job selbst.
Worin unterscheidet sich Datenaggregation von Datenintegration und Datenanreicherung?
Aggregation fasst zusammen, Integration verbindet, und Anreicherung vervollständigt. Sie laufen oft in derselben Pipeline, erfüllen aber unterschiedliche Zwecke.
Datenintegration (manchmal auch Konsolidierung genannt) führt Daten aus verschiedenen Systemen Eintrag für Eintrag in ein einheitliches Modell zusammen, ohne dabei zwingend etwas zusammenzufassen. Ein Kundeneintrag, der den CRM-Eintrag mit dem Abrechnungskonto verknüpft, ist Integration.
Datenanreicherung ergänzt vorhandene Einträge um fehlende Merkmale, etwa einen Branchencode aus einem Register; Was ist Datenanreicherung? zeigt, wie ein Eintrag abgeglichen und vervollständigt wird. Die Aggregation verdichtet diese Einträge anschließend zu den Kennzahlen, die ein Bericht braucht.
Was sind typische Beispiele für Datenaggregation?
Die bekanntesten Beispiele sind Dienste, die Ihnen viele Quellen auf einmal zeigen.
Preisvergleichsportale sammeln Angebote für dasselbe Produkt aus vielen Shops, ordnen sie einem Produkt zu und zeigen den niedrigsten Preis, die Preisspanne oder den Preisverlauf. Der Abgleich ist der schwierige Teil: Dasselbe Smartphone erscheint unter verschiedenen Namen, in Bundles und mit unterschiedlichem Speicher.
Reise-Metasuchmaschinen sammeln Flugpreise und Zimmerpreise von Fluggesellschaften, Hotels und Agenturen, sortieren sie auf einer Seite und leiten Sie zur Buchung an den Verkäufer weiter.
Kontoaggregation zeigt Salden und Umsätze mehrerer Banken in einer App. In der EU ist das ein regulierter Zahlungsdienst: Die Zahlungsdiensterichtlinie (PSD2) definiert einen „Kontoinformationsdienst“ als Online-Dienst zur Mitteilung konsolidierter Informationen über ein oder mehrere Zahlungskonten, die ein Nutzer bei einem anderen oder bei mehreren Zahlungsdienstleistern hält (PSD2 auf EUR-Lex). Nach Artikel 67 darf ein solcher Dienst nur mit der ausdrücklichen Zustimmung des Nutzers tätig werden, nur die vom Nutzer bestimmten Konten abrufen und die Daten nur für den angeforderten Dienst verwenden.
Log- und Monitoring-Werkzeuge machen aus Tausenden identischen Fehlerzeilen einen Eintrag mit Zähler. Amtliche Statistiken tun dasselbe im nationalen Maßstab und veröffentlichen Erhebungs- und Registerdaten als Tabellen.
Sind aggregierte Daten anonym?
Aggregierte Daten sind nur dann anonym, wenn sich keine Person aus ihnen herausgreifen lässt, und das garantiert das Zusammenfassen allein nicht. Nach der DSGVO der EU gelten die Datenschutzregeln nicht für anonyme Informationen, auch nicht für statistische Zwecke; ob Daten anonym sind, bemisst sich aber an allen Mitteln, die zur Identifizierung „nach allgemeinem Ermessen wahrscheinlich genutzt werden“ (Erwägungsgrund 26 der DSGVO auf EUR-Lex).
Kleine Gruppen sind das übliche Problem. „Durchschnittsgehalt der Beschäftigten ab 60 im Büro Lissabon“ ist eine Zusammenfassung, doch wenn nur eine Person auf diese Beschreibung passt, ist es deren Gehalt. Statistikämter unterdrücken oder verschmelzen kleine Zellen deshalb, bevor sie eine Tabelle veröffentlichen.
Viele Zusammenfassungen derselben Daten lassen sich außerdem kombinieren, um die Zeilen dahinter wiederherzustellen. Forschende der US-Statistikbehörde Census Bureau haben gezeigt, dass die veröffentlichten Tabellen der Volkszählung von 2010 zusammen mit öffentlichen Informationen ausreichten, um 97 Millionen Personendatensätze exakt zu rekonstruieren (Abowd et al. auf arXiv). Für 2020 wechselte die Behörde zu einem Verfahren der Differential Privacy, das den veröffentlichten Zahlen kalibriertes statistisches Rauschen hinzufügt.
Die praktischen Regeln: Legen Sie vor der Veröffentlichung eine Mindestgruppengröße fest, vermeiden Sie viele überlappende Aufschlüsselungen derselben kleinen Population und behandeln Sie eine Zusammenfassung, die noch jemanden beschreibt, als personenbezogene Daten.
Was bedeutet Datenaggregation in der OPSEC?
In der operativen Sicherheit (OPSEC) bedeutet Datenaggregation, dass harmlose Fakten zusammengenommen etwas Sensibles offenbaren können. Eine Mitarbeiterliste, ein Lieferplan und ein paar öffentliche Fotos sind einzeln unbedenklich; zusammen zeigen sie womöglich, wer wo arbeitet und wann ein Standort leer ist.
Der Gedanke steht sogar in Vorschriften: Die US-Executive-Order 13526 erlaubt, eine Zusammenstellung einzeln nicht eingestufter Angaben als Verschlusssache einzustufen, wenn die Kombination einen Zusammenhang offenlegt, den die einzelnen Angaben für sich nicht zeigen. Für ein Unternehmen heißt das: Stellenanzeigen, öffentliche Dokumente und Beiträge von Beschäftigten gemeinsam prüfen, nicht einzeln.
Welche Rolle spielen Proxys bei der Datenaggregation?
Proxys sind wichtig, wenn ein Aggregationsjob öffentliche Webquellen liest, die je nach Land anders aussehen. Preis, Bestand und Lieferoptionen eines Händlers hängen oft vom Standort des Besuchers ab, sodass ein Vergleich, der von einem einzigen Büro aus erstellt wird, von jeder Seite nur die Version eines Landes sieht; Warum Preise je nach Land variieren erklärt die Gründe.
Ein Residential-Proxy lässt jede Anfrage über einen privaten Internetanschluss in dem Land oder der Stadt laufen, die die Daten beschreiben, und zwar in einem Tempo, das die Website verkraftet. Proxys ändern nichts an den Regeln: Die Nutzungsbedingungen der Website, die robots.txt und die offizielle API, sofern es eine gibt, haben weiterhin Vorrang.
Für Kataloge auf Marktplätzen sind unsere E-Commerce-Proxys darauf ausgelegt, Preise und Bestände so zu lesen, wie ein Käufer vor Ort sie sieht.
Teams, die den Erhebungsschritt nicht selbst betreiben möchten, können unser Vertriebsteam nach der Web Scraping API fragen, einem Dienst für verwaltete Seitenextraktion.
Wo wird Datenaggregation eingesetzt?
- Handel und E-Commerce: Umsatz pro Kanal, Preisspannen über Shops hinweg, Bestände pro Lager.
- Finanzen: Kontoaggregation in Banking-Apps, Depotsummen über mehrere Broker, Ausgaben nach Kategorie.
- Reisen: Flug- und Zimmerpreise vieler Anbieter auf einer Ergebnisseite.
- Marketing: Kampagnenergebnisse, über mehrere Werbeplattformen summiert.
- Betrieb und IT: Log-Ereignisse und Fehlerraten pro Dienst und Stunde.
- Marktforschung: Wettbewerberpreise und Preisspannen, nach Land zusammengefasst.
Häufige Fehler
- Doppelzählung. Dieselbe Bestellung in zwei Feeds, oder eine Erstattung und eine neue Bestellung als zwei Verkäufe gezählt.
- Einheiten und Währungen mischen. Gramm neben Kilogramm, Preise mit und ohne Steuer, Euro neben Dollar.
- Zeitzonen ignorieren. Tagessummen, die sich ändern, je nachdem, nach welcher Uhr der Bericht rechnet.
- Mittelwerte mitteln. Gemeinsame Durchschnitte müssen aus Summen und Anzahlen neu berechnet werden.
- Unterschiedliche Definitionen je Quelle. Ein Shop zählt Bestellungen an der Kasse, ein anderer beim Versand.
- Angebrochene Zeiträume vergleichen. Der laufende Monat ohne Kennzeichnung neben vollen Monaten.
- Winzige Gruppen veröffentlichen. Eine Zusammenfassung über ein oder zwei Personen gibt deren personenbezogene Daten preis.
- Keine Quelle und kein Zeitpunkt je Zahl. Später kann niemand sagen, aus welchen Daten eine Zahl entstanden ist.
Entscheidungshilfe
| Bedarf | Empfehlung |
|---|---|
| Eine Antwort aus wenigen Dateien, einmalig | Tabellenkalkulation und Pivot-Tabelle |
| Derselbe Bericht täglich aus vielen Quellen | Geplanter Job mit eingebauten Prüfungen |
| Summen über Zeitzonen hinweg | Eine Zone in der Definition festlegen |
| Gemeinsamer Durchschnitt mehrerer Gruppen | Aus Summen und Anzahlen neu berechnen |
| Preise, die je nach Land abweichen | Jedes Land aus dem jeweiligen Land erheben |
| Bankkonten in einer App | Zugelassener Kontoinformationsdienst |
| Zusammenfassungen über Personen veröffentlichen | Mindestgruppengröße; DSGVO prüfen |
Häufige Fragen
Was ist Datenaggregation einfach erklärt?
Datenaggregation heißt, Daten von verschiedenen Stellen zu sammeln und zusammenzufassen, zum Beispiel die Verkäufe aus drei Shops zu einer Tagessumme zu addieren. Das Ergebnis beantwortet eine Frage, die keine einzelne Quelle allein beantworten kann.
Was ist ein Beispiel für Datenaggregation?
Ein Preisvergleichsportal ist ein gängiges Beispiel: Es sammelt Angebote für dasselbe Produkt aus vielen Shops und zeigt den niedrigsten Preis. Ein täglicher Umsatzbericht über mehrere Shops und eine Banking-App, die mehrere Banken anzeigt, sind weitere.
Was bedeutet Datenaggregation in SQL?
In SQL bedeutet Datenaggregation, Aggregatfunktionen wie COUNT, SUM, AVG, MIN und MAX zu verwenden, meist zusammen mit GROUP BY, um viele Zeilen zu einer Zeile pro Gruppe zu verdichten. HAVING filtert anschließend die gruppierten Ergebnisse.
Was bedeutet Datenaggregation in der OPSEC?
In der OPSEC ist Datenaggregation das Risiko, dass Informationen, die für sich genommen harmlos sind, zusammengefügt etwas Sensibles offenbaren. Organisationen prüfen deshalb, was sie veröffentlichen, im Zusammenhang und nicht Stück für Stück.
Sind aggregierte Daten personenbezogene Daten im Sinne der DSGVO?
Aggregierte Daten fallen nur dann aus der DSGVO heraus, wenn sie wirklich anonym sind, also keine Person mit Mitteln identifiziert werden kann, die nach allgemeinem Ermessen wahrscheinlich genutzt werden. Zusammenfassungen sehr kleiner Gruppen können Personen weiterhin identifizieren und bleiben dann personenbezogene Daten.
Was ist der Unterschied zwischen Datenaggregation und Datenintegration?
Datenintegration verbindet Daten aus verschiedenen Systemen Eintrag für Eintrag zu einem einheitlichen Modell. Datenaggregation fasst Einträge zu Summen, Mittelwerten oder Anzahlen zusammen. Die Integration kommt meist zuerst, damit die Aggregation mit abgeglichenen und bereinigten Einträgen arbeitet.
Fazit
Datenaggregation macht aus vielen Quellen und Zeilen eine einzige Sicht: erhoben, bereinigt, gruppiert und zusammengefasst. Der größte Teil der Arbeit ist Vorbereitung, denn Duplikate, gemischte Einheiten und Zeitzonen verfälschen Summen, ohne einen Fehler auszulösen. Zusammenfassungen über Personen sind nicht automatisch anonym, kleine Gruppen verlangen daher Sorgfalt. Und wenn die Quellen öffentliche Webseiten sind, die sich je nach Land ändern, erheben Sie die Daten jedes Marktes aus diesem Markt, über einen Proxy vor Ort.