Ihr Skript, das Produktnamen und Preise von einem Onlineshop sammelt, lief monatelang fehlerfrei. Der Shop erneuerte sein Design, das Element <span class="price"> zog in eine andere Komponente um, und über Nacht begann das Skript, leere Datensätze zu schreiben. Die klassische Antwort auf dieses Szenario ist, den Selektor neu zu schreiben. Das Versprechen eines AI Web Scrapers ist ein anderes: Die Anweisung „Finde Produktname und Preis" behält ihre Bedeutung, auch wenn sich der Aufbau der Seite ändert.
In diesem Artikel erklären wir, was ein AI Web Scraper ist, wie er eine Seite in fünf Schritten in strukturierte Daten übersetzt, welche vier Typen von Tools es gibt, bei welchen Arbeiten er gute Ergebnisse liefert und ob er bei der Sperrung einen Unterschied zu einem klassischen Scraper hat. Die agentische Variante, die den Weg selbst wählt und durch Klicken vorankommt, ist ein eigenes Thema; im letzten Abschnitt ziehen wir die Linie zwischen beiden und verweisen auf jenen Artikel.
Was ist ein AI Web Scraper?
Web Scraping besteht aus zwei getrennten Aufgaben: den Inhalt der Seite abrufen und aus dem eingehenden Inhalt die Felder parsen und in strukturierte Daten übersetzen. Diese Unterscheidung haben wir, an den realen Platz des Modells in diesem Ablauf gebunden, in unserem Artikel Web Scraping mit GPT-6 Astra erzählt; hier geht es um den Begriff. Wenn von einem „AI Web Scraper" die Rede ist, versteht man meist das Werkzeug, das die Parsing-Seite dieser beiden Aufgaben an das Modell übergibt. Das Abrufen geschieht weiterhin mit einem HTTP-Client oder einem Headless-Browser; es ändert sich der Code, der entscheidet, welches Element der Seite als „Preis" oder „Lagerbestand" gilt.
Zwei Fälle außerhalb dieser Definition sorgen für Verwirrung. Der erste sind No-Code-Tools: Einige Dienste lassen Sie die gewünschten Felder auf der Seite mit der Maus auswählen und bringen das Modell dazu, Ihre Auswahl zu verallgemeinern und auf ähnliche Seiten anzuwenden. Die ganze Leiter des Datenabrufts ohne Code (von Excel bis zum Headless-Browser) haben wir in unserem Artikel Daten von Websites extrahieren aufgelistet; der AI-Scraper steht der obersten Sprosse dieser Leiter nahe. Der zweite sind agentische Systeme, die auch den Weg dem Modell überlassen; sie sind nicht Gegenstand dieses Artikels, sondern von Agentic Web Scraping.
Wie macht ein AI-Scraper aus einer Seite Daten?
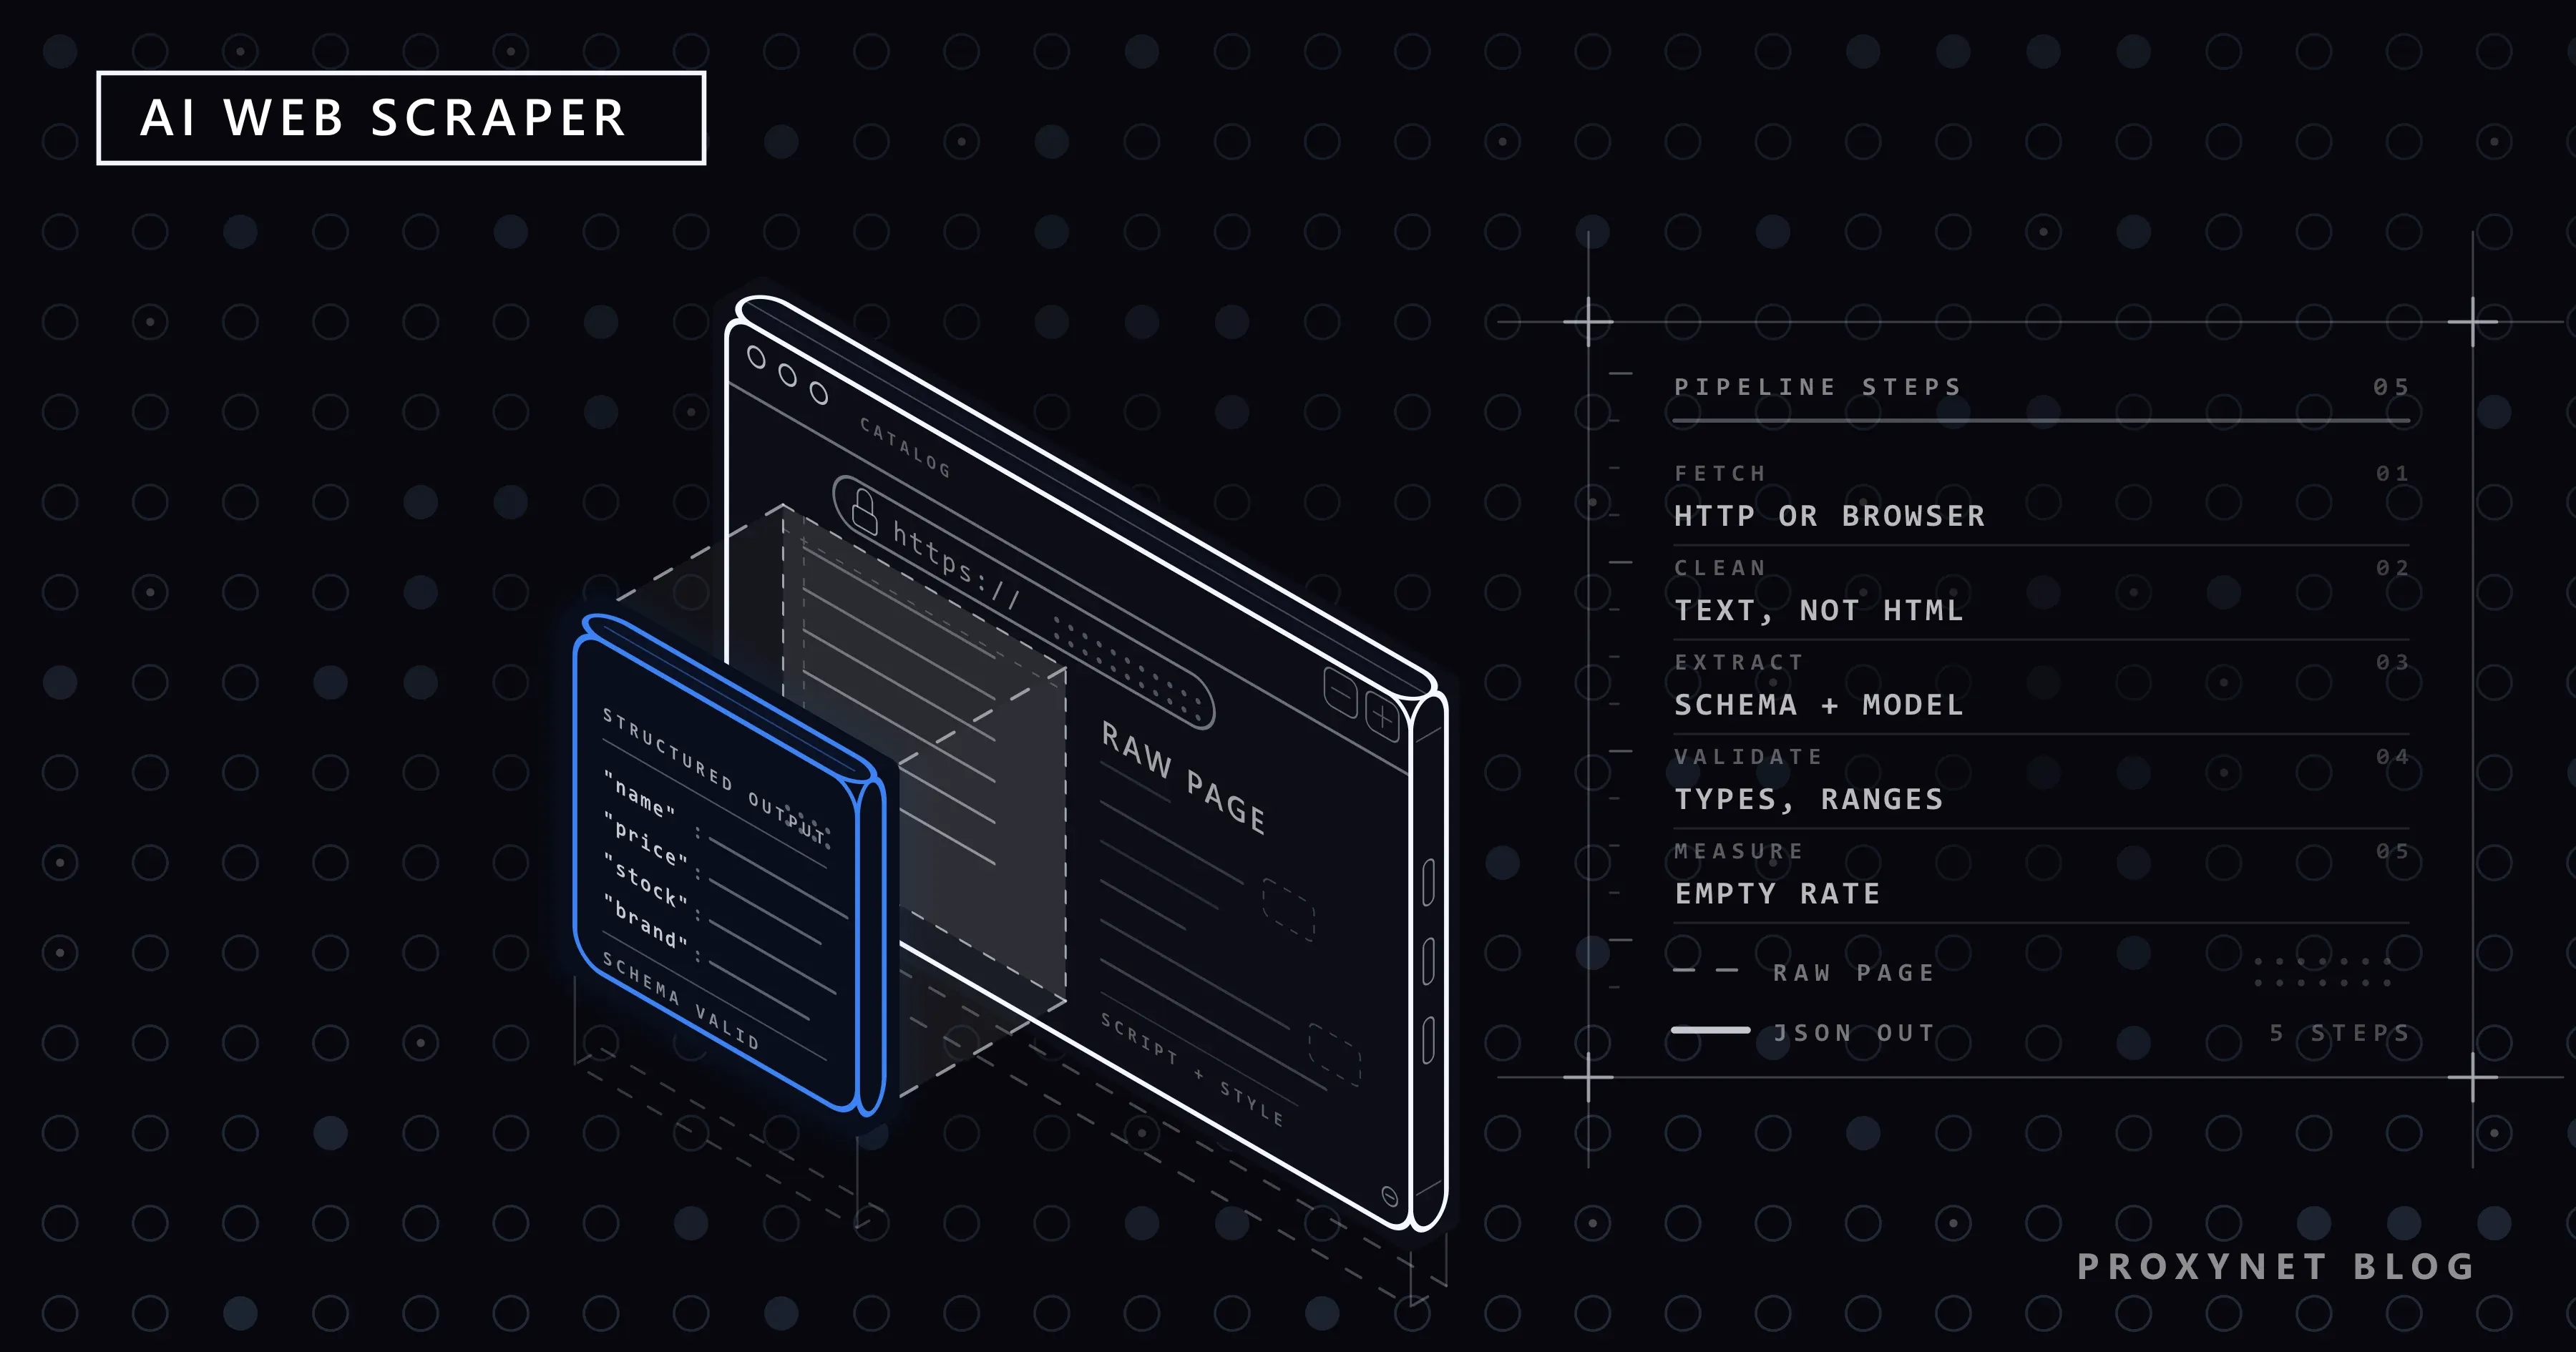
Welche Marke das Tool auch hat, der Ablauf besteht aus fünf Schritten. Der Unterschied liegt meist darin, wie viele dieser Schritte bei Ihnen und wie viele im Dienst liegen.
- Seite abrufen. Für statisches HTML genügt eine einfache HTTP-Anfrage. Füllt die Seite ihren Inhalt mit JavaScript, wird sie mit einem Headless-Browser gerendert. Die in diesem Schritt genutzte IP, die Anfragegeschwindigkeit und der Browser-Fingerprint sind hier entscheidend; mit dem Modell hat das nichts zu tun.
- Rauschen entfernen. Das rohe HTML einer Produktseite ist ein Vielfaches des sichtbaren Texts; landen Skript- und Navigationsblöcke beim Modell, wird es langsam und teuer. Skript- und Stil-Elemente werden entfernt, bei Bedarf wird nur der Hauptinhaltsblock extrahiert. Die Readability-Bibliothek von Mozilla, die Open-Source-Fassung des Algorithmus hinter der „Leseransicht" des Browsers, ist die bekannteste Referenz für diese Arbeit.
- Schema und Anweisung liefern. Sie definieren die gewünschten Felder als JSON-Schema: welches Feld Pflicht ist, welches eine Zahl ist, welches ein Datum. Moderne Modell-APIs erzwingen mit Unterstützung für strukturierte Ausgaben, dass die Antwort des Modells diesem Schema entspricht; darin unterscheidet sie sich von einer freien Antwort in Textform.
- Ausgabe validieren. Eine schemakonforme Antwort kann trotzdem falsch sein: Im Preisfeld kommt der Text „1.299 TL" an, die Währung fehlt, ein nicht vorrätiges Produkt liefert „true". Typ-, Bereichs- und Pflichtfeld-Prüfungen werden im Code gemacht; ein verdächtiger Datensatz wandert nicht in die Datenbank, sondern in eine separate Warteschlange.
- Speichern und messen. Gültige Datensätze gehen in den Speicher; beobachtet wird der Anteil der Seiten, die leer bleiben, Korrektur brauchen oder dem Schema nicht entsprechen. Steigt dieser Anteil still, hat sich entweder die Website geändert, oder das Modell bekommt diese Seitenstruktur nicht gelöst; beides ist kein Fehler des von Ihnen geschriebenen Codes und wird nur durch Messen sichtbar.
Der Vertrag des dritten Schritts sieht so aus. Das Schema:
{
  "name": "string (Pflichtfeld)",
  "price": "number (Pflichtfeld)",
  "currency": "string",
  "in_stock": "boolean"
}
Die Antwort, die das Modell zurückgeben soll:
{
  "name": "Kabellose Maus",
  "price": 1299,
  "currency": "TRY",
  "in_stock": true
}
Typen und Tools von AI-Scrapern
Die Tools am Markt lassen sich in vier Gruppen einteilen. Die Frage bei der Wahl lautet nicht, „welches das beste ist", sondern welche Schritte bei Ihnen bleiben und welche beim Dienst.
| Typ | Code nötig? | Vertreter | Passende Arbeit |
|---|---|---|---|
| No-Code-Tools | Nein | Monitoring-Tools wie Browse AI | Wiederkehrende Seitenüberwachung, Änderungsalarme |
| Scraping-APIs mit AI-Parsing | Auf dem Niveau eines Endpunkt-Aufrufs | Firecrawl, Apify | Fertige Integrationen, mittelgroße Aufgaben |
| Bibliotheken für die Code-Seite | Ja | ScrapeGraphAI, LangChain-Extraktionsketten | Teams, die ihre Pipeline selbst aufbauen und anpassen |
| Agenten-Frameworks | Ja | Browser Use, Playwright MCP | Mehrstufige Aufgaben, deren Weg vorab unbekannt ist |
Kurz geöffnet. Firecrawl ist eine Open-Source-Scraping-API, die eine URL entgegennimmt und die Seite in sauberes, für Sprachmodelle geeignetes Markdown und auf Wunsch in schemagebundenes JSON übersetzt. Apify ist eine Plattform, auf der fertige Scraper in der Cloud laufen; Sie wählen aus Hunderten fertiger „Actors" und führen sie aus. ScrapeGraphAI ist eine Open-Source-Python-Bibliothek, die die Abruf- und Parsing-Pipeline um ein Sprachmodell herum aufbaut; Sie sagen „extrahiere diese Informationen aus dieser Website" und überlassen den Rest der Pipeline der Bibliothek. LangChain ist ein universelles Framework für Sprachmodelle; Ketten, die Felder aus Dokumenten extrahieren, bauen Sie in diesem Framework. Die vierte Zeile verlässt die Pipeline: Bei Agenten-Frameworks entscheidet das Modell auch, welche Seite aufgerufen und was geklickt wird.
Die ersten beiden Gruppen in der Tabelle beschleunigen die Arbeit, die letzten beiden verändern, wie Sie die Arbeit definieren. Die meisten Teams beginnen mit der zweiten Gruppe und wechseln mit wachsendem Maßstab und Anpassungsbedarf zur dritten; der Platz der vierten Gruppe ist ein eigener Artikel.
Was kann er gut, und was kann er nicht?
Die starke Seite des modellbasierten Parsens ist genau dort, wo das klassische Skript bricht:
- Widerstandsfähigkeit gegen Website-Änderungen. Wird das Design erneuert, ziehen Elemente um oder ändern sich Klassennamen, bleibt die Anweisung dieselbe. Der Posten „Selektor reparieren" verschwindet nicht von der Pflegeliste, wird aber seltener.
- Long-Tail-Websites. Für Hunderte kleiner Websites mit unterschiedlichen Strukturen jeweils eigene Selektoren zu schreiben, ist in den meisten Projekten unmöglich; jedem dasselbe Schema und dieselbe Anweisung zu geben, ist möglich.
- Freier Text. Aus dem Satz „Lieferung innerhalb von zwei Tagen" die Lieferzeit oder aus einer Wohnungsanzeige das Stockwerk zu extrahieren, schreibt man nicht mit einem Selektor; das ist eine Aufgabe der Bedeutungsextraktion.
Auf der Gegenseite stehen drei bleibende Kosten. Kosten und Geschwindigkeit: Ein Selektor läuft in Millisekunden und gratis; das Modell braucht Sekunden und verlangt für jede Seite Token. Auf einer festen Pipeline, die täglich Hunderttausend Seiten verarbeitet, dreht dieser Unterschied die Rechnung um. Konsistenz: Dieselbe Eingabe liefert nicht jedes Mal dieselbe Ausgabe; deshalb ist der vierte Schritt unverzichtbar. Halluzination: Das Modell kann ein Feld, das auf der Seite nicht existiert, aus eigenem Wissen füllen. Wegen dieser beiden Risiken in der Struktur ist auf einer einzelnen Website, deren Aufbau seit Monaten unverändert ist, der CSS-Selektor weiterhin der schnellste und günstigste Weg; AI ist hier keine Verbesserung, sondern ein Kostenposten.
Was ändert sich bei der Sperrung?
Nichts ändert sich, eine Sache wird schwerer. Weil das Modell nicht ändert, wie die Seite erreicht wird, sind IP-Reputation, Anfragetakt und Standortbeschränkungen dieselben wie beim klassischen Scraping; die zurückkommende 429 hat nichts mit dem Modell zu tun. Schwerer wird Folgendes: Um JavaScript auswerten zu können, arbeiten AI-Scraper meist mit einem Headless-Browser — jede Anfrage öffnet also einen Browser, führt ihn aus und schließt ihn. Das ist ein langsameres und auffälligeres Fußabdruck-Bild als eine einfache HTTP-Anfrage; bei hoher Geschwindigkeit läuft man früher gegen die Zahl der erlaubten Anfragen.
Aus diesem Grund ist die Abrufschicht beim AI-Scraper wichtiger als früher. Ausgangspunkt bleiben die eigenen Regeln der Website: Erlaubt die Datei robots.txt nichts, wird nicht gescraped; hat die Website eine API, wird die API genutzt; Rate-Limits werden eingehalten. Den Rahmen davon haben wir in unserem Artikel Web Scraping ohne Sperren aufgelistet. Bei voluminösen, unordentlichen Aufgaben wird die Adresse schnell markiert, wenn die Anfragen aus einer einzigen IP kommen; ein Residential-Proxy, der von echten Nutzeradressen kommt, landet in der Vertrauensrechnung der Ziel-Website an besserer Stelle, und ein Rotierender Proxy, der bei jeder Anfrage die Adresse wechselt, verteilt die Last auf den Pool. Die Anbieterwahl haben wir in einem eigenen Abschnitt behandelt: Die besten Proxys für Web Scraping.
Kurz gesagt: Die Erwartung „mit AI zu scrapen schützt vor Sperren" ist falsch; im Gegenteil, ein AI-Scraper schickt in einem typischen Projekt Traffic, der für den Bot-Schutz schwerer aussieht. Deshalb wird die Abrufschicht separat gestaltet und separat überwacht.
Worin unterscheidet sich ein AI-Scraper vom agentic Scraping?
Die beiden Begriffe werden oft verwechselt, weil in beiden Fällen ein Sprachmodell die Seite liest. Der Unterschied liegt darin, wer die Entscheidung hält. Ein AI Web Scraper ist eine feste Pipeline: Die Schritte schreibt der Entwickler, das Modell läuft nur im Parsingschritt. Die Seite wird abgerufen, geparst, fertig; über die nächste Runde des Ablaufs entscheidet das Modell nicht.
Beim agentic Web Scraping steht das Modell in der Schleife: Es entscheidet selbst, welchem Link es folgt, wann es aufhört, ob der Plan aufgegangen ist. Das bedeutet den Übergang von Einseitenaufgaben zu mehrstufigen Aufgaben; der Preis ist, dass Kosten und Dauer an die Zahl der Schritte gebunden werden. Wie die allgemeine Agentenschleife funktioniert, haben wir in unserem Artikel Wie funktionieren KI-Agenten? erklärt; die scrapingspezifische Fassung, die Bausteine und die Fehlermodi behandeln wir in Agentic Web Scraping.
Anwendungsfälle
- Preis- und Bestandsüberwachung. Die Produktseiten von Hunderten Händlern laufen in ein einziges Schema; Designänderungen werfen die Pipeline nicht um. Das Ende-zu-Ende-Setup haben wir in unserem Artikel Wettbewerberpreise im E-Commerce überwachen erklärt.
- Datensammlung im Long-Tail. Aus Hunderten kleiner Websites mit unterschiedlichen Strukturen dieselben Felder zu extrahieren, kommt viel günstiger, als für jede Website einen Selektor zu schreiben.
- Informationen aus freiem Text extrahieren. In unstrukturiertem Text wie Bewertungen, Anzeigenbeschreibungen oder Stellenangeboten hat ein Selektor keinen Platz; die extrahierten Felder werden Eingabe für die Data-Mining-Pipeline.
- Aktuelle Daten für Sprachmodellanwendungen. Muss das Modell aktuelle Informationen wie Produktkatalog, Dokumentation oder Preise erhalten, erledigt der AI-Scraper diese Aufgabe in strukturierter Form; für eine sichere Konstruktion der Zugriffsschicht sehen Sie sich unseren Artikel Sicherer Webzugriff für LLMs an.
Häufige Fehler
- Jede Seite an das Modell schicken. Der stabile Bereich, in dem der Selektor funktioniert, sollte nicht zum Modell gehen; den Bereich mit einem groben Selektor einzugrenzen und sein Inneres dem Modell zu überlassen, vereint die Vorteile beider Methoden.
- Rohes HTML schicken. Skript- und Stilblöcke verbrennen das Token-Budget; wird der Bereinigungsschritt übersprungen, kommt dieselbe Arbeit ein Mehrfaches teurer heraus.
- Ausgabe ohne Validierung. Dem Schema zu entsprechen heißt nicht, dass die Daten korrekt sind. Ohne Typ-, Bereichs- und Pflichtfeld-Prüfung landet eine einzige falsche Modellantwort still in Ihrer Datenbank.
- Kein Schema definieren. Eine freie Anweisung wie „gib mir die Produktinformationen auf dieser Seite" wird auf jeder Seite in anderer Form beantwortet; die Pipeline aufzubauen, ohne den Feldsatz an einen Vertrag zu binden, ist vergebene Arbeit.
- Sperrsymptome beim Modell kurieren. Eine 429-Antwort, leerer Inhalt oder ein CAPTCHA zeigt sich als Parsproblem; das Prompt zu ändern löst das nicht, die Abrufschicht zu reparieren (Geschwindigkeit, IP-Strategie) schon.
- Private Seiten in einem Drittanbieter-Tool öffnen. Seiten, die eine Sitzung verlangen oder personenbezogene Daten enthalten, in das Fenster eines No-Code-Dienstes zu laden, transportiert diese Daten zum Drittanbieter; solche Seiten werden in Ihrer eigenen Infrastruktur verarbeitet.
Entscheidungshilfe
| Bedarf | Empfehlung |
|---|---|
| Eine einzige Seite mit selten wechselndem Aufbau; hohes Volumen | Klassischer Selektor; kein AI nötig |
| Wiederkehrende Überwachung ohne Code | No-Code-Tool |
| Mittelgroße Aufgabe auf einer Website mit häufig wechselnder Struktur | API mit AI-Parsing oder eine Bibliothek |
| Hunderte Websites mit unterschiedlichen Strukturen, freier Text | Parsing mit LLM + zwingende Validierungsschicht |
| Mehrstufige Aufgaben, deren Schritte vorab unbekannt sind | Agenten-Framework (Agentic Web Scraping) |
Häufig gestellte Fragen
Braucht man Programmierkenntnisse, um einen AI Web Scraper zu nutzen?
Nicht unbedingt. No-Code-Tools ermöglichen Ihnen, Felder auf der Seite auszuwählen und eine wiederkehrende Überwachung einzurichten; Bibliotheken für die Code-Seite geben denen Flexibilität, die die Pipeline selbst bauen wollen. Wächst die Aufgabe und steigt der Anpassungsbedarf, wird die Code-Seite unvermeidlich.
Werden AI-Scraper leichter gesperrt als klassische Scraper?
Grund der Sperrung ist nicht das Modell, sondern der Traffic selbst; weil ein AI-Scraper aber typischerweise mit einem Headless-Browser arbeitet, ist jede Anfrage langsamer und auffälliger. Bei hoher Geschwindigkeit kann das früher an ein Limit stoßen als eine klassische einfache Anfrage. Deshalb ist es wichtig, die Abrufschicht separat zu gestalten.
Ist das Extrahieren von Daten mit AI legal?
Der Einsatz von AI ändert die rechtliche Frage nicht: Personenbezogene Daten, Inhalte hinter dem Login und Urheberregeln gelten unverändert; robots.txt und die Bedingungen der Website bleiben der Ausgangspunkt. Den Rahmen haben wir in unserem Artikel Ist Web Scraping legal? erklärt. Ein zusätzlicher Punkt: Seiteninhalte an die Modell-API eines Drittanbieters zu senden, ist für sich genommen eine Datenübermittlung.
Kann ich mit ChatGPT Daten von einer Website ziehen?
Für kleine Aufgaben auf einer Seite: ja. Sie kopieren die Seite aus dem Browser, geben Ihr Schema und erhalten eine bearbeitete Ausgabe. Das ist keine Pipeline; kein Abrufen, keine Validierung, keine Wiederholung. Bei dauerhaften oder viele-Seiten-Aufgaben braucht es eine mit Skript und API-Aufrufen gebaute Pipeline.
Kann man den Daten, die ein AI-Scraper extrahiert, vertrauen?
Eine schemakonforme Ausgabe ist nicht dasselbe wie eine korrekte Ausgabe. Typ- und Pflichtfeld-Prüfungen, Bereichskontrollen und der manuelle Abgleich an Stichproben sind die Standardpraxis; verdächtige Datensätze werden in eine Warteschlange gestellt, bevor sie in den Hauptspeicher geschrieben werden. Was das Vertrauen stärkt, ist nicht ein größeres Modell, sondern eine ernsthaft gebaute Validierungsschicht.
In welchem Fall ist ein klassisches Skript die bessere Wahl?
Bei Aufgaben, deren Seitenstruktur seit Monaten unverändert ist, deren Volumen hoch ist und deren Feldsatz feststeht. Der Selektor läuft in Millisekunden und ohne Token; das Modell ist hier keine Verbesserung, sondern eine dauerhafte Kostenposition. Die Ausnahmen, an denen der Selektor bricht, und die Long-Tail-Websites sollten AI überlassen bleiben.
Fazit
Ein AI Web Scraper gibt die zerbrechliche Seite des Scrapings — das Extrahieren der Felder — an das Sprachmodell ab; Abrufen, Validieren und Messen bleiben bei klassischer Disziplin. Der kurzfristige Gewinn sind Zeilen, die von der Pflegeliste verschwinden; der Preis dafür sind Token-Kosten für jede Seite. Das Team, das beides ausbalanciert, nutzt den Selektor auf stabilen Seiten und das Modell auf wechselnden Strukturen. Beim Aufbau Ihrer Datenerfassungspipeline können Sie sich unsere Datenerfassungslösungen ansehen.