Betiğiniz her gece 2.000 ürün sayfası okuyor. İlk 300 sayfa sorunsuz geliyor, sonra yanıtlar 429 Too Many Requests'e dönüyor, birkaç dakika sonra da her istek 403 alıyor. Kodda hiçbir şey değişmedi; site adresinizden kaç istek geldiğini saydı ve hiçbir ziyaretçinin böyle davranmadığına karar verdi. Rotating proxy bunun standart cevabıdır, ama kötü bağlanırsa yeni sorunlar çıkarır: IP beklediğiniz anda değişmez, giriş yarı yolda kopar ya da yirmi işçi nazik bir scraper'ı sele çevirir.
Bu rehber kurulumu Python'da baştan sona kuruyor: tek IP neden hız sınırına takılır, rotating gateway çıkışları nasıl atar, requests'te proxies sözlüğü, oturum yeniden kullanımı ve rotasyonu neden sessizce durdurduğu, Retry-After'a uyan yeniden deneme, iş parçacığı havuzu ve httpx/asyncio sürümü, istek başına rotasyon ile sticky arasındaki seçim, çıkış IP'si kontrolü ve uymanız gereken sınırlar. Bütün örnekler 29 Eylül 2026'da Python 3.13.9, requests 2.34.2, httpx 0.28.1 ve tenacity 9.1.4 ile çalıştırıldı. Kavram tarafı IP Rotasyonu Nedir ve Nasıl Çalışır? ve Web Scraping'de Engellenmeden Veri Toplama Yöntemleri yazılarında; bu yazı kodun kendisi.
Tek IP neden 429 ya da 403 alır?
Siteler istekleri istemci başına sayar, en kolay istemci kimliği de kaynak IP adresidir. Hız sınırlayıcı (rate limiter) her adres için bir zaman penceresinde sayaç tutar; sayaç eşiği geçince 429 Too Many Requests döner. RFC 6585'in 4. bölümü bu kodu tam bu durum için tanımlar ve yanıtın ne kadar bekleneceğini söyleyen bir Retry-After başlığı taşıyabileceğini belirtir. Sayma algoritmaları 429 Too Many Requests ve Rate Limit Hatası Nedir? yazısında.
Art arda gelen 429'lardan sonraki 403 başka bir katmandır: sınırlayıcı yavaşlamanızı istedi, yavaşlamadınız ve bir kural adresinizi betiğinizden daha uzun yaşayan bir engel listesine taşıdı. Çıkışları döndürmek istekleri birçok adrese yayar, böylece hiçbir adres tek başına eşiği geçmez; ama rotasyon yavaşlamanın yerini tutmaz: dakikada 60 isteğe izin veren siteye on adresten 600 istek gönderirseniz bir yerine on engellenmiş adresiniz olur.
Rotating proxy gateway'i nasıl çalışır?
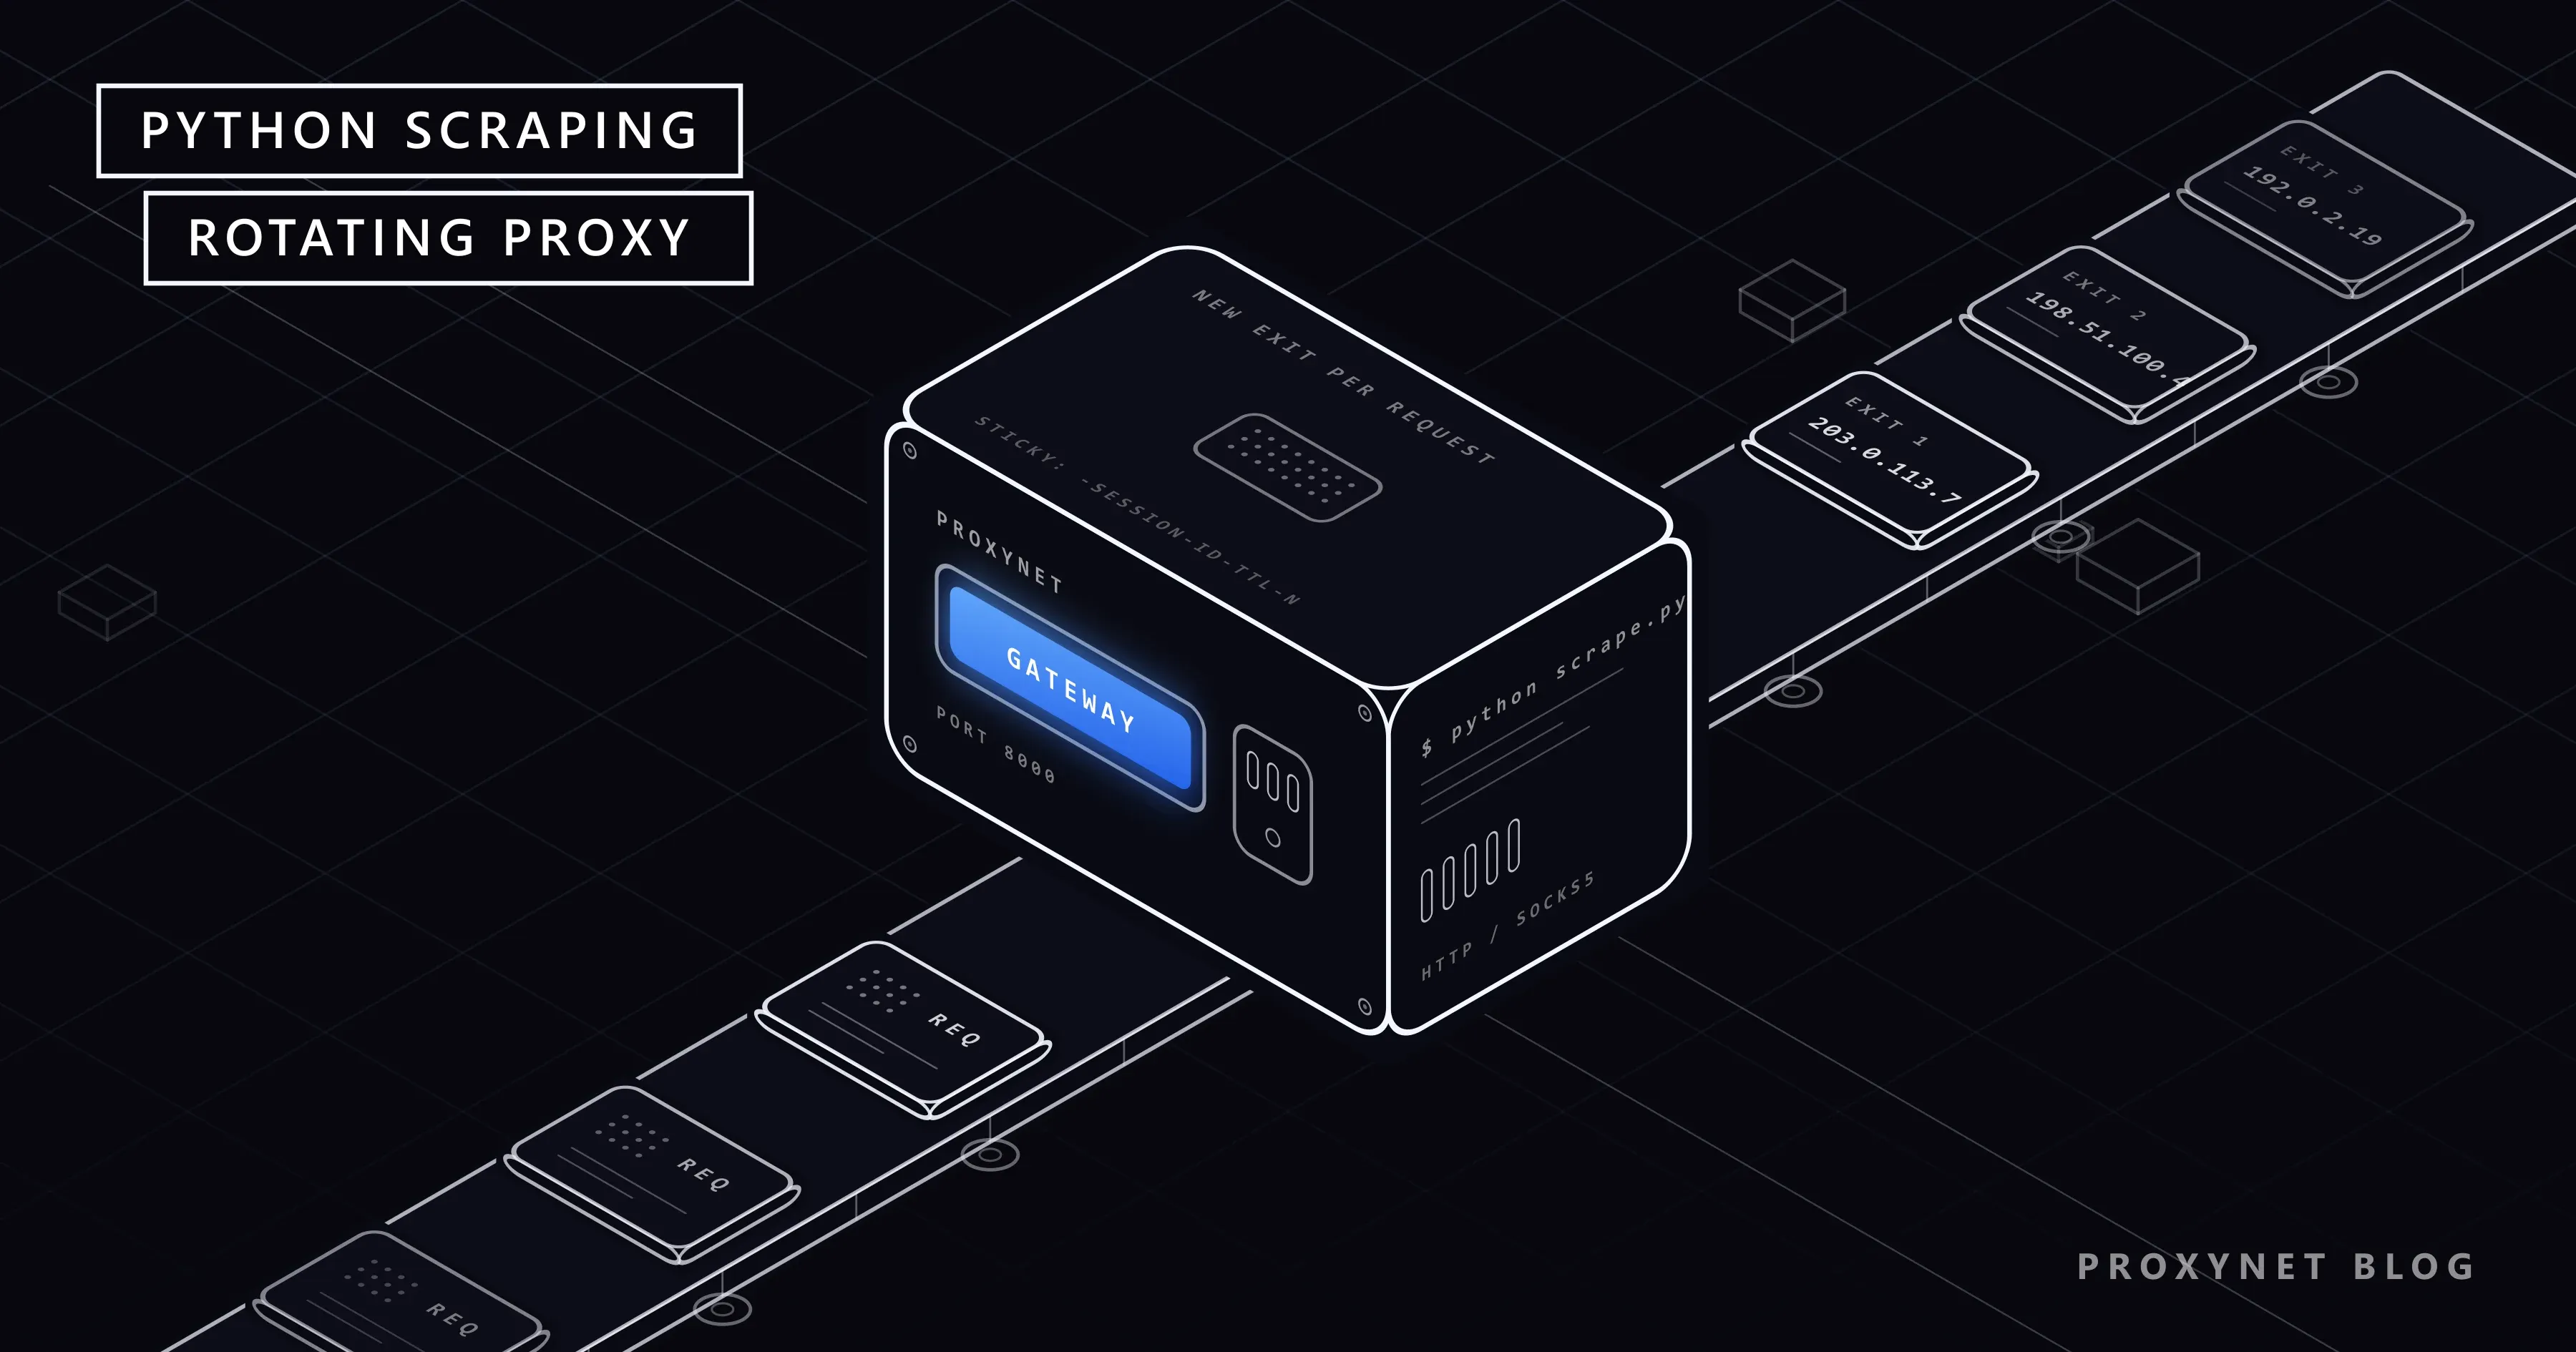
Ağ geçidi (gateway, backconnect) modelinde kodunuz tek bir adres bilir, örneklerde pr.proxynet.io:8000; havuzu sağlayıcı yönetir. Bir HTTPS isteği şu yolu izler:
- İstemciniz gateway'e TCP bağlantısı açar ve
user:passçiftinden üretilmişProxy-Authorization: Basic ...başlığıylaCONNECT hedef:443gönderir. - Gateway kullanıcı adını okur. Hesap kısmından sonra gelen her şey parametredir:
-country-trhavuzu tek ülkeye daraltır,-session-<id>-ttl-<saniye>sticky oturum ister. - Gateway daraltılmış havuzdan bir çıkış seçer: istek başına modda her yeni tünel için yeni bir çıkış, sticky modda oturum kimliğinize zaten bağlı olan çıkış.
- Tünel kurulur, TLS istemcinizle hedef arasında çalışır ve hedef çıkışın IP'sini görür.
- Tünel kapanınca bağ çözülür. Bir oturum kimliği tutmuyorsa sonraki bağlantı yeni bir çıkış alır.
Bu rehberin bütün hikâyesi 3. adımdır. Rotasyonun birimi HTTP isteği değil tüneldir: bir CONNECT tüneli açık kaldığı sürece içinden geçen her istek aynı çıkıştan çıkar. Her modern istemcinin varsayılan olarak açtığı keep-alive, "istek başına" ifadesinin pratikte ne anlama geldiğini bu yüzden değiştirir. Ürün tarafı Rotating Proxy sayfasında; buradaki çıkışlar bir Residential Proxy havuzundan gelir, yani hedef sıradan bir ev adresi görür. Gerçek kullanıcı adını panel üretir (proxynet-xxxxxxxx-country-tr-session-…-ttl-1800); aşağıda user olarak kısaltıldı.
İstek başına rotasyon, sticky oturum ve sabit IP
| İstek başına rotasyon | Sticky oturum | Sabit IP | |
|---|---|---|---|
| IP'yi değiştiren olay | Her yeni bağlantı | Oturum kimliğinin değişmesi ya da TTL'nin dolması (1-60 dakika) | Hiçbir şey; adres sizindir |
| Kullanıcı adı | user | user-session-<id>-ttl-<saniye> | Ayrı ürün, sabit host:port |
| Çerez ve giriş | Kopar; site aynı çerezi birçok şehirden görür | TTL boyunca korunur | Süresiz korunur |
| İstek başına maliyet | Her seferinde yeni TCP ve TLS el sıkışması | Bir kez el sıkışma, sonra keep-alive | Bir kez el sıkışma, sonra keep-alive |
| Paralel işçiler | Her bağlantı kendi çıkışını alır | İşçi başına bir kimlik, kimlik başına bir çıkış | Kiraladığınız adres kadar çıkış |
| Tipik iş | Bağımsız ürün ve liste sayfaları | Giriş, sepet, çok sayfalı sayfalama | API izin listeleri, uzun ömürlü hesaplar |
Sticky, çıkışı tutma isteğidir, garanti değil; bir residential cihaz çevrimdışı olabilir ve gateway oturumu erken taşır. Ürünün davranışı Sticky Proxy sayfasında.
requests kurulumu: proxies sözlüğü
requests'in proxy dokümantasyonu, session.proxies üzerine yazılan değerler HTTP_PROXY ve HTTPS_PROXY ortam değişkenleriyle ezilebildiği için proxies parametresini her istekte açıkça vermeyi önerir. Anahtarlar hedef URL'nin şemasıdır ve HTTPS trafiği tünellendiği için ikisi de aynı http:// gateway adresine bakar:
import os
import requests

# Bu dizgiyi panel üretir; git'e değil ortam değişkenine koyun.
GATEWAY = os.environ.get("PROXY_URL", "http://user:pass@pr.proxynet.io:8000")
PROXIES = {"http": GATEWAY, "https": GATEWAY}
HEADERS = {"User-Agent": "price-monitor/1.0 (+mailto:you@example.com)"}

resp = requests.get("https://httpbin.org/ip", proxies=PROXIES, headers=HEADERS, timeout=(5, 30))
print(resp.status_code, resp.json())
timeout demeti 5 saniyelik bağlanma ve 30 saniyelik okuma sınırı koyar; onsuz takılan bir çıkış işçiyi sonsuza kadar bekletebilir. User-Agent betiğinizi adlandırır ve site sahibine size ulaşacak bir yol verir; User Agent Nedir? yazısı tarayıcı taklidi yerine bunu önerir. Kimlik bilgileri ortam değişkeninde durur, çünkü aynı dokümantasyon sürüm kontrolündeki dosyalara karşı uyarır. SOCKS5 için requests[socks] kurun ve socks5h://user:pass@pr.proxynet.io:1080 kullanın; h harfi DNS çözümlemesini proxy'ye bırakır, SOCKS5 portu da aynı şekilde döner.
Oturum yeniden kullanımı: IP neden değişmedi?
requests.Session TCP bağlantısını yeniden kullanır; proxy arkasında bu, tünelin ve dolayısıyla çıkışın yeniden kullanılması demektir. Bunu her CONNECT'i kaydeden yerel bir test proxy'siyle ölçtük:
Aynı sunucuya üç GET | Açılan tünel | Atanan çıkış (tünel başına bir) |
|---|---|---|
Üç kez requests.get(...), oturum yok | 3 | 3 |
Tek Session, üç s.get(...) | 1 | 1 |
Tek Session, headers={"Connection": "close"} | 3 | 3 |
Tek httpx.AsyncClient, art arda üç await client.get(...) | 1 | 1 |
Kural buradan çıkar: istek başına rotasyon için requests.get'i oturumsuz çağırın ya da Connection: close gönderin; sticky işlerde Session ile oturum kimliğini birlikte kullanın, çünkü kopan bir bağlantı aksi hâlde çıkışı yeniden atar.
Retry-After'a uyan backoff ile yeniden deneme
Rotating gateway arkasında iki şey bozulur: ağ (bir çıkış düşer, tünel reddedilir, okuma zaman aşımına uğrar) ve hedef (429 ya da 5xx). İkisi de yeniden denenmeyi hak eder, ama aynı beklemeyi değil. 429 sitenin kendi sayısını Retry-After içinde taşıyabilir; o sayı kazanır. Geri kalan her şey jitter'lı üstel backoff alır, böylece birlikte düşen dört işçi birlikte yeniden denemez:
import logging
import random
import time

import requests

MAX_ATTEMPTS = 4         # ilk deneme + 3 yeniden deneme
RETRY_STATUS = {429, 500, 502, 503, 504}
TIMEOUT = (5, 30)        # bağlanma, okuma - saniye
log = logging.getLogger("scraper")


def backoff(attempt: int) -> float:
    """1, 2, 4, 8 sn ... artı jitter; işçiler aynı anda yeniden denemesin."""
    return min(2 ** (attempt - 1), 30) + random.uniform(0, 1)


def fetch(url: str) -> requests.Response:
    """Tek URL'yi yeniden denemelerle GET eder. Son başarısız denemeden sonra hata fırlatır."""
    for attempt in range(1, MAX_ATTEMPTS + 1):
        try:
            resp = requests.get(url, proxies=PROXIES, headers=HEADERS, timeout=TIMEOUT)
        except (requests.ConnectionError, requests.Timeout) as exc:
            # ProxyError da buraya girer: gateway tüneli reddetti ya da düşürdü.
            log.warning("deneme %d/%d %s: %s", attempt, MAX_ATTEMPTS, url, exc.__class__.__name__)
            if attempt == MAX_ATTEMPTS:
                raise
            time.sleep(backoff(attempt))
            continue

        if resp.status_code not in RETRY_STATUS:
            return resp  # 200, 404, 301 ... kararı çağıran versin

        # Site yavaşlamamızı istedi. Onun sayısı bizim takvimimizden önce gelir.
        retry_after = resp.headers.get("Retry-After")
        wait = float(retry_after) if retry_after and retry_after.isdigit() else backoff(attempt)
        log.warning("deneme %d/%d %s: HTTP %d, %.1f sn bekleniyor", attempt, MAX_ATTEMPTS, url, resp.status_code, wait)
        if attempt == MAX_ATTEMPTS:
            resp.raise_for_status()
        time.sleep(wait)
raise RuntimeError("buraya ulaşılmaz")requests.ProxyError, ConnectionError'ın alt sınıfıdır; bu yüzden CONNECT'e hata dönen bir gateway yeni bir tünelde yeniden denenir, istek başına modda bu yeni bir çıkış demektir. 404 olduğu gibi döndürülür: sayfa yok ve başka bir adres onu geri getirmez.
Aynı politika tenacity dekoratörüyle daha kısadır; bedeli Retry-After'ı bir istisnaya çevirmek zorunda kalmanızdır, yani başlık yerine tenacity'nin kendi takvimi uygulanır:
from tenacity import retry, retry_if_exception_type, stop_after_attempt, wait_exponential_jitter


class RetryableStatus(Exception):
    """429 ve 5xx için fırlatılır; tenacity onları ağ hatası gibi yeniden dener."""


@retry(
    stop=stop_after_attempt(4),
    wait=wait_exponential_jitter(initial=1, max=20),
    retry=retry_if_exception_type((requests.ConnectionError, requests.Timeout, RetryableStatus)),
    reraise=True,
)
def fetch_with_tenacity(url: str) -> requests.Response:
    resp = requests.get(url, proxies=PROXIES, headers=HEADERS, timeout=TIMEOUT)
    if resp.status_code in RETRY_STATUS:
        raise RetryableStatus(f"HTTP {resp.status_code} for {url}")
    return resp
https://httpbin.org/status/503 karşısında 1,5, 2,8 ve 4,8 saniye sonra yeniden denedi, sonra RetryableStatus fırlattı.
Tam scraper: iş parçacığı havuzu, yeniden deneme ve günlük
ThreadPoolExecutor dört fetch çağrısını aynı anda çalıştırır, as_completed sonuçları bittikçe verir ve bozuk bir sayfa çalışmayı durdurmadan günlüğe yazılır. scrape.py olarak kaydedin:
"""scrape.py - bir sayfa listesini rotating proxy gateway'i üzerinden çeker."""
import logging
import os
import random
import sys
import time
from concurrent.futures import ThreadPoolExecutor, as_completed

import requests

GATEWAY = os.environ.get("PROXY_URL", "http://user:pass@pr.proxynet.io:8000")
PROXIES = {"http": GATEWAY, "https": GATEWAY}
HEADERS = {"User-Agent": "price-monitor/1.0 (+mailto:you@example.com)"}

MAX_WORKERS = 4          # aynı anda yolda olan istek sayısı
MAX_ATTEMPTS = 4
RETRY_STATUS = {429, 500, 502, 503, 504}
TIMEOUT = (5, 30)

log = logging.getLogger("scraper")


def backoff(attempt: int) -> float:
    return min(2 ** (attempt - 1), 30) + random.uniform(0, 1)


def fetch(url: str) -> requests.Response:
    # önceki bölümdeki yeniden deneme döngüsü, değişmeden
    ...


def scrape(url: str) -> dict:
    started = time.monotonic()
    resp = fetch(url)
    return {
        "url": url,
        "status": resp.status_code,
        "bytes": len(resp.content),
        "seconds": round(time.monotonic() - started, 2),
    }


def main(urls: list[str]) -> None:
    logging.basicConfig(level=logging.INFO, format="%(asctime)s %(levelname)s %(message)s")
    results, failed = [], []
    with ThreadPoolExecutor(max_workers=MAX_WORKERS) as pool:
        futures = {pool.submit(scrape, url): url for url in urls}
        for future in as_completed(futures):
            url = futures[future]
            try:
                row = future.result()
                results.append(row)
                log.info("ok   %s -> %d, %.1f sn", url, row["status"], row["seconds"])
            except Exception as exc:  # tek bozuk sayfa çalışmayı durdurmamalı
                failed.append((url, repr(exc)))
                log.error("hata %s -> %s", url, exc)
    log.info("bitti: %d ok, %d hata", len(results), len(failed))
    for row in results:
        print(row)


if __name__ == "__main__":
    targets = sys.argv[1:] or [f"https://httpbin.org/ip?n={i}" for i in range(8)]
    main(targets)
Yeniden deneme yolunu çalıştırmak için betiği her üçüncü tüneli 429 ile reddeden yerel bir test proxy'sinden geçirdik. Sekiz URL, dört işçi, sekiz tünel, üç yapay hata, sıfır kayıp sayfa:
03:32:27 WARNING attempt 1/4 https://httpbin.org/ip?n=2: ProxyError
03:32:28 INFO ok   https://httpbin.org/ip?n=3 -> 200 in 1.1s
03:32:28 INFO ok   https://httpbin.org/ip?n=1 -> 200 in 1.1s
03:32:28 INFO ok   https://httpbin.org/ip?n=0 -> 200 in 1.1s
03:32:28 WARNING attempt 1/4 https://httpbin.org/ip?n=5: ProxyError
03:32:29 INFO ok   https://httpbin.org/ip?n=4 -> 200 in 0.9s
03:32:29 WARNING attempt 1/4 https://httpbin.org/ip?n=7: ProxyError
03:32:29 INFO ok   https://httpbin.org/ip?n=6 -> 200 in 0.9s
03:32:30 INFO ok   https://httpbin.org/ip?n=2 -> 200 in 2.6s
03:32:31 INFO ok   https://httpbin.org/ip?n=5 -> 200 in 2.4s
03:32:31 INFO ok   https://httpbin.org/ip?n=7 -> 200 in 2.0s
03:32:31 INFO done: 8 ok, 0 failed
Günlük tasarımın parçasıdır: her satırdaki URL, deneme numarası, durum kodu ya da istisna sınıfı ve bekleme süresi, hiçbir şeyi yeniden çalıştırmadan "site bizi sınırlıyor" ile "gateway tünelleri düşürüyor" durumlarını ayırmaya yeter. Dört işçi bilerek düşük tutuldu; eşzamanlılık istek hızınızı çarpar, hedefin ölçtüğü şey de hızdır. results satırlarını Kazınan Veriyi CSV, JSON ve SQLite'a Kaydetme yazısındaki gibi dosyaya yazın; resp.text ile satır arasındaki ayrıştırma adımı Web Sitesinden Veri Çekme yazısında.
Aynı iş httpx ve asyncio ile
httpx proxy'yi httpx proxy dokümantasyonunda anlatıldığı gibi istemci üzerinde alır. Eşzamanlılık sınırı olarak iş parçacığı havuzunun yerini Semaphore alır; yeniden deneme döngüsü biçimini korur, yalnız beklemeler await olur:
import asyncio
import random

import httpx

MAX_IN_FLIGHT = 4


async def fetch(client: httpx.AsyncClient, url: str) -> httpx.Response:
    for attempt in range(1, MAX_ATTEMPTS + 1):
        try:
            resp = await client.get(url)
        except (httpx.TransportError, httpx.ProxyError) as exc:
            log.warning("deneme %d/%d %s: %s", attempt, MAX_ATTEMPTS, url, exc.__class__.__name__)
            if attempt == MAX_ATTEMPTS:
                raise
            await asyncio.sleep(2 ** (attempt - 1) + random.uniform(0, 1))
            continue
        if resp.status_code not in RETRY_STATUS:
            return resp
        retry_after = resp.headers.get("Retry-After")
        wait = float(retry_after) if retry_after and retry_after.isdigit() else 2 ** (attempt - 1) + random.uniform(0, 1)
        log.warning("deneme %d/%d %s: HTTP %d, %.1f sn bekleniyor", attempt, MAX_ATTEMPTS, url, resp.status_code, wait)
        if attempt == MAX_ATTEMPTS:
            resp.raise_for_status()
        await asyncio.sleep(wait)
    raise RuntimeError("buraya ulaşılmaz")


async def main(urls: list[str]) -> None:
    gate = asyncio.Semaphore(MAX_IN_FLIGHT)
    async with httpx.AsyncClient(proxy=GATEWAY, headers=HEADERS, timeout=httpx.Timeout(30, connect=5)) as client:

        async def one(url: str):
            async with gate:
                resp = await fetch(client, url)
                return {"url": url, "status": resp.status_code}

        rows = await asyncio.gather(*(one(u) for u in urls), return_exceptions=True)
    for url, row in zip(urls, rows):
        print("HATA" if isinstance(row, Exception) else "ok  ", url, row)


asyncio.run(main([f"https://httpbin.org/ip?n={i}" for i in range(8)]))
Tek istemci tek bağlantı havuzu demektir ve havuzdaki bağlantılar tünelleri yeniden kullanır: dört istek yolda ve sekiz URL varken çalıştırmamız dört tünel açtı, yani sayfa çiftleri aynı çıkışı paylaştı. Her sayfa kendi adresinden çıkmalıysa headers={"Connection": "close"} gönderin; bir grup sayfa aynı adresi paylaşmalıysa bu bir sticky oturumdur, havuzun rastlantısı değil. Hangi kütüphanenin hangi işe uyduğu HTTPX, Requests ve AIOHTTP Karşılaştırması yazısında.
İstek başına mı sticky mi: seçim ve çıkış IP'sinin doğrulanması
Kararı iş başına verin. Ürün sayfaları, arama listeleri ve herkese açık profiller bağımsızdır: istek başına rotasyon, oturum nesnesi yok. Girişten sonra yirmi sayfalık bir sayfalama tek bir konuşmadır: çerezler için bir Session, çıkış için bir oturum kimliği, bir işçi. IP değişirken çerez kavanozunun aynı kalması, çalışma ortasında oturumdan düşmenin en yaygın yoludur; giriş tarafı Python'da Oturum ve Çerez Yönetimi yazısında kuruluyor.
İki moda da güvenmeden önce bir echo servisine hangi adresi gördüğünü sorun: oturumsuz üç çağrı üç farklı adres, aynı oturum kimliğiyle üç çağrı aynı adresi döndürmelidir:
import uuid
import requests

HOST = "pr.proxynet.io:8000"
USER, PASSWORD = "user", "pass"
ECHO = "https://httpbin.org/ip"


def proxies_for(username: str) -> dict:
    url = f"http://{username}:{PASSWORD}@{HOST}"
    return {"http": url, "https": url}


print("istek basina:")
for _ in range(3):  # Session yok, her çağrı yeni bir tünel açar
    print("  ", requests.get(ECHO, proxies=proxies_for(USER), timeout=20).json()["origin"])

sid = uuid.uuid4().hex[:8]
sticky = proxies_for(f"{USER}-session-{sid}-ttl-600")  # en fazla 600 sn aynı çıkış
print(f"sticky {sid}:")
with requests.Session() as s:
    for _ in range(3):
        print("  ", s.get(ECHO, proxies=sticky, timeout=20).json()["origin"])
Bunu işin başında bir kez çalıştırın ve sonucu günlüğe yazın. "istek basina" üç kez aynı adresi basıyorsa önce bağlantı yeniden kullanımına bakın; "sticky" üç farklı adres basıyorsa oturum kimliği gateway'e ulaşmıyordur, genellikle bir URL kodlama adımı kullanıcı adını bozmuştur.
Hız sınırı, robots.txt ve uyduğunuz sınırlar
Rotating proxy sitenin hangi adresi gördüğünü değiştirir, neye izin verdiğini değil:
- Önce robots.txt'yi okuyun.
urllib.robotparserüç satırdacan_fetch(user_agent, url)cevabını verir; izin verilmeyen yol URL listesinin dışında kalır. Dosyanın neyi ifade edebildiği robots.txt Nedir? yazısında. Retry-After'ı olduğu gibi uygulayın. Yeniden deneme döngüsü, rotasyon başka bir çıkıştan devam etmenize izin verse bile sitenin sayısı kadar bekler.- İşçi sayısını değil hızı sınırlayın. Gecikmesiz dört işçi hızlı bir sitede hâlâ saniyede 40 istek gönderebilir; site bir sınır yayınlıyorsa işçi başına kısa bir
time.sleepekleyin. - Resmi API varsa onu tercih edin. İki taraf için de HTML'i proxy üzerinden ayrıştırmaktan ucuzdur.
- CAPTCHA çözdürme servisi ve tespit atlatma eklentisi yok. CAPTCHA sitenin bir insan istediği anlamına gelir; cevap daha düşük hız, API ya da erişim istemektir.
Bu kurulum nerede kullanılır?
- Fiyat takibi. Günde binlerce bağımsız ürün sayfası, istek başına rotasyon, dört ila sekiz işçi; havuz boyutlandırması veri kazıma sayfasında.
- Kendi hesabınızın olduğu paneller. Hesap başına bir sticky oturum, bir işçi, çalıştırmalar arasında saklanan çerezler; Python'da Oturum ve Çerez Yönetimi yazısındaki gibi.
- Elle tutulan proxy listesinin yerine. Listeyi kodda döndürmek, Python'da Proxy'ler Nasıl Döndürülür? yazısındaki gibi, eski yaklaşımdır; gateway listeyi ve ölü adres takibini ortadan kaldırır.
Sık yapılan hatalar
Session'ı yeniden kullanıp sayfa başına yeni IP beklemek. Bir tünel, bir çıkış. Oturumu bırakın ya daConnection: closegönderin.Sessionolmadan sticky kimlik. Çıkış sabitlenir ama her çağrı yeni el sıkışma öder ve çerezler kaybolur. İkisini birlikte kullanın.404'ü yeniden denemek. Sayfa yok; başka bir çıkış onu bulmaz. Yalnız429,5xxve ağ hatalarını yeniden deneyin.- Zaman aşımı yok. Takılan bir çıkış işçiyi süreç öldürülene kadar bloke eder. Her zaman
timeout=(5, 30)verin. - Kimlik bilgileri betiğin içinde. Git geçmişine düşer. Ortam değişkeninden okuyun.
Karar rehberi
| İhtiyaç | Öneri |
|---|---|
| Çok sayıda bağımsız sayfa, giriş yok | İstek başına rotasyon, oturumsuz requests.get, başlangıç için 4 işçi |
| Giriş, sonra çok sayfa | Sticky oturum (-session-<id>-ttl-<saniye>) artı tek requests.Session, hesap başına bir işçi |
| Binlerce küçük istek, G/Ç ağırlıklı | Semaphore ile httpx AsyncClient; her biri kendi çıkışını almalıysa Connection: close |
| Site bir hız sınırı yayınlıyor | Önce işçi sayısını ve gecikmeyi o sınırın altına çekin, rotasyon ikinci sırada |
| Ülkeye özel fiyatlar | Kullanıcı adında -country-xx, o ülke içinde istek başına rotasyon |
| Adres hiç değişmemeli (API izin listesi) | Rotating ürün değil; sabit IP kullanın |
Sıkça sorulan sorular
IP neden her istekte değişmiyor?
Çünkü istemciniz bağlantıyı yeniden kullanıyor. requests'in Session'ı ve httpx'in Client'ı TCP bağlantısını, dolayısıyla proxy tünelini istekler arasında açık tutar; çıkış tünel açılırken seçilir. İstek başına yeni çıkış için düz requests.get çağrıları ya da Connection: close başlığı kullanın.
Python'da sticky oturum nasıl kullanılır?
Proxy URL'sindeki kullanıcı adının sonuna -session-<id>-ttl-<saniye> ekleyin, bütün konuşma boyunca aynı kimliği koruyun ve çağrıları tek bir requests.Session üzerinden yapın ki çerezler ve tünel yeniden kullanılsın. TTL 1 ile 60 dakika arasında olabilir; işten uzun bir değer seçin.
Proxy ile scraping için requests mi httpx mi?
Gecede birkaç yüz sayfa için iş parçacığı havuzlu requests yeterlidir ve hata ayıklaması daha kolaydır. On binlerce küçük istek için Semaphore ile httpx'in asenkron istemcisi daha az kaynak kullanır. İkisi de aynı gateway URL'sini ve aynı yeniden deneme mantığını alır.
Kaç eşzamanlı işçi güvenlidir?
Dörtle başlayın ve yanıtları izleyin. Önemli olan hedefin gördüğü dakikadaki istek sayısıdır; cevap havuz boyutuna değil sitenin sınırına bağlıdır. Dört işçide 429 görüyorsanız sayıyı düşürün ya da gecikme ekleyin.
Rotating proxy 429'u aşar mı?
İstekleri daha çok adrese yayar, böylece her biri eşiğin altında kalır; eşiği kaldırmaz. Site bir sınır koyduysa Retry-After'a uyun, hızı düşürün ya da API'yi kullanın. 429'u görüp daha hızlı döndürmek, adreslerin engel listesine düşme yoludur.
Proxy'nin çalıştığını nasıl doğrularım?
Proxy üzerinden https://httpbin.org/ip gibi bir IP echo ucuna istek atın ve cevabı kendi adresinizle karşılaştırın: rotasyonu görmek için oturumsuz üç kez, sticky davranışı görmek için oturum kimliğiyle üç kez.
Özet
Python'da rotating proxy, proxies sözlüğündeki tek bir gateway URL'si, Retry-After'a uyan bir yeniden deneme döngüsü, birkaç işçilik bir eşzamanlılık sınırı ve bir sayfanın öncekiyle ne zaman aynı çıkışı paylaşabileceğine dair net bir kuraldır. Giriş gerektiren işlerde oturum nesnesiyle oturum kimliğini birlikte tutun, bağımsız sayfalarda ikisini de uzak tutun ve ilk gerçek çalıştırmadan önce çıkış IP'sini kontrol edin. Gateway'in arkasındaki havuz proxy sayfasında.