Her sabah aynı listeye ihtiyacınız var: bir GitHub deposundaki açık issue'lar (hata ve öneri kayıtları), bir mağazanın kategori sayfasındaki fiyatlar ya da bir sitedeki alıntılar. GitHub issue'lar için belgelenmiş bir API sunuyor; betiğiniz bunları isteyip JSON olarak alabiliyor. Mağazanın ise sayfalarından başka sunduğu bir şey olmayabilir; bu durumda betik HTML'i indirip fiyatları içinden ayıklamak zorunda kalır. API ile web scraping (veri kazıma) arasındaki fark özünde budur ve çoğu projede seçimi zevkiniz değil, karşı tarafın ne sunduğu belirler.
Bu yazıda API'nin ve scraping'in ne olduğunu anlatıyor, ikisini on başlıkta karşılaştırıyor, ardından aynı 100 kaydı Python ile iki yoldan topluyoruz: bir kez HTML sayfalarından, bir kez de sitenin kendi sayfasının çağırdığı JSON endpoint'inden. Sonra gizli JSON endpoint'lerine, scraping API hizmetlerine, hız sınırlarına, IP whitelist'e, maliyete ve iki yolun birlikte kullanımına geçiyoruz. Kod örneklerinin hepsini 29 Eylül 2026'da Python 3.13, Requests 2.34.2 ve beautifulsoup4 4.15.0 ile çalıştırdık.
API nedir?
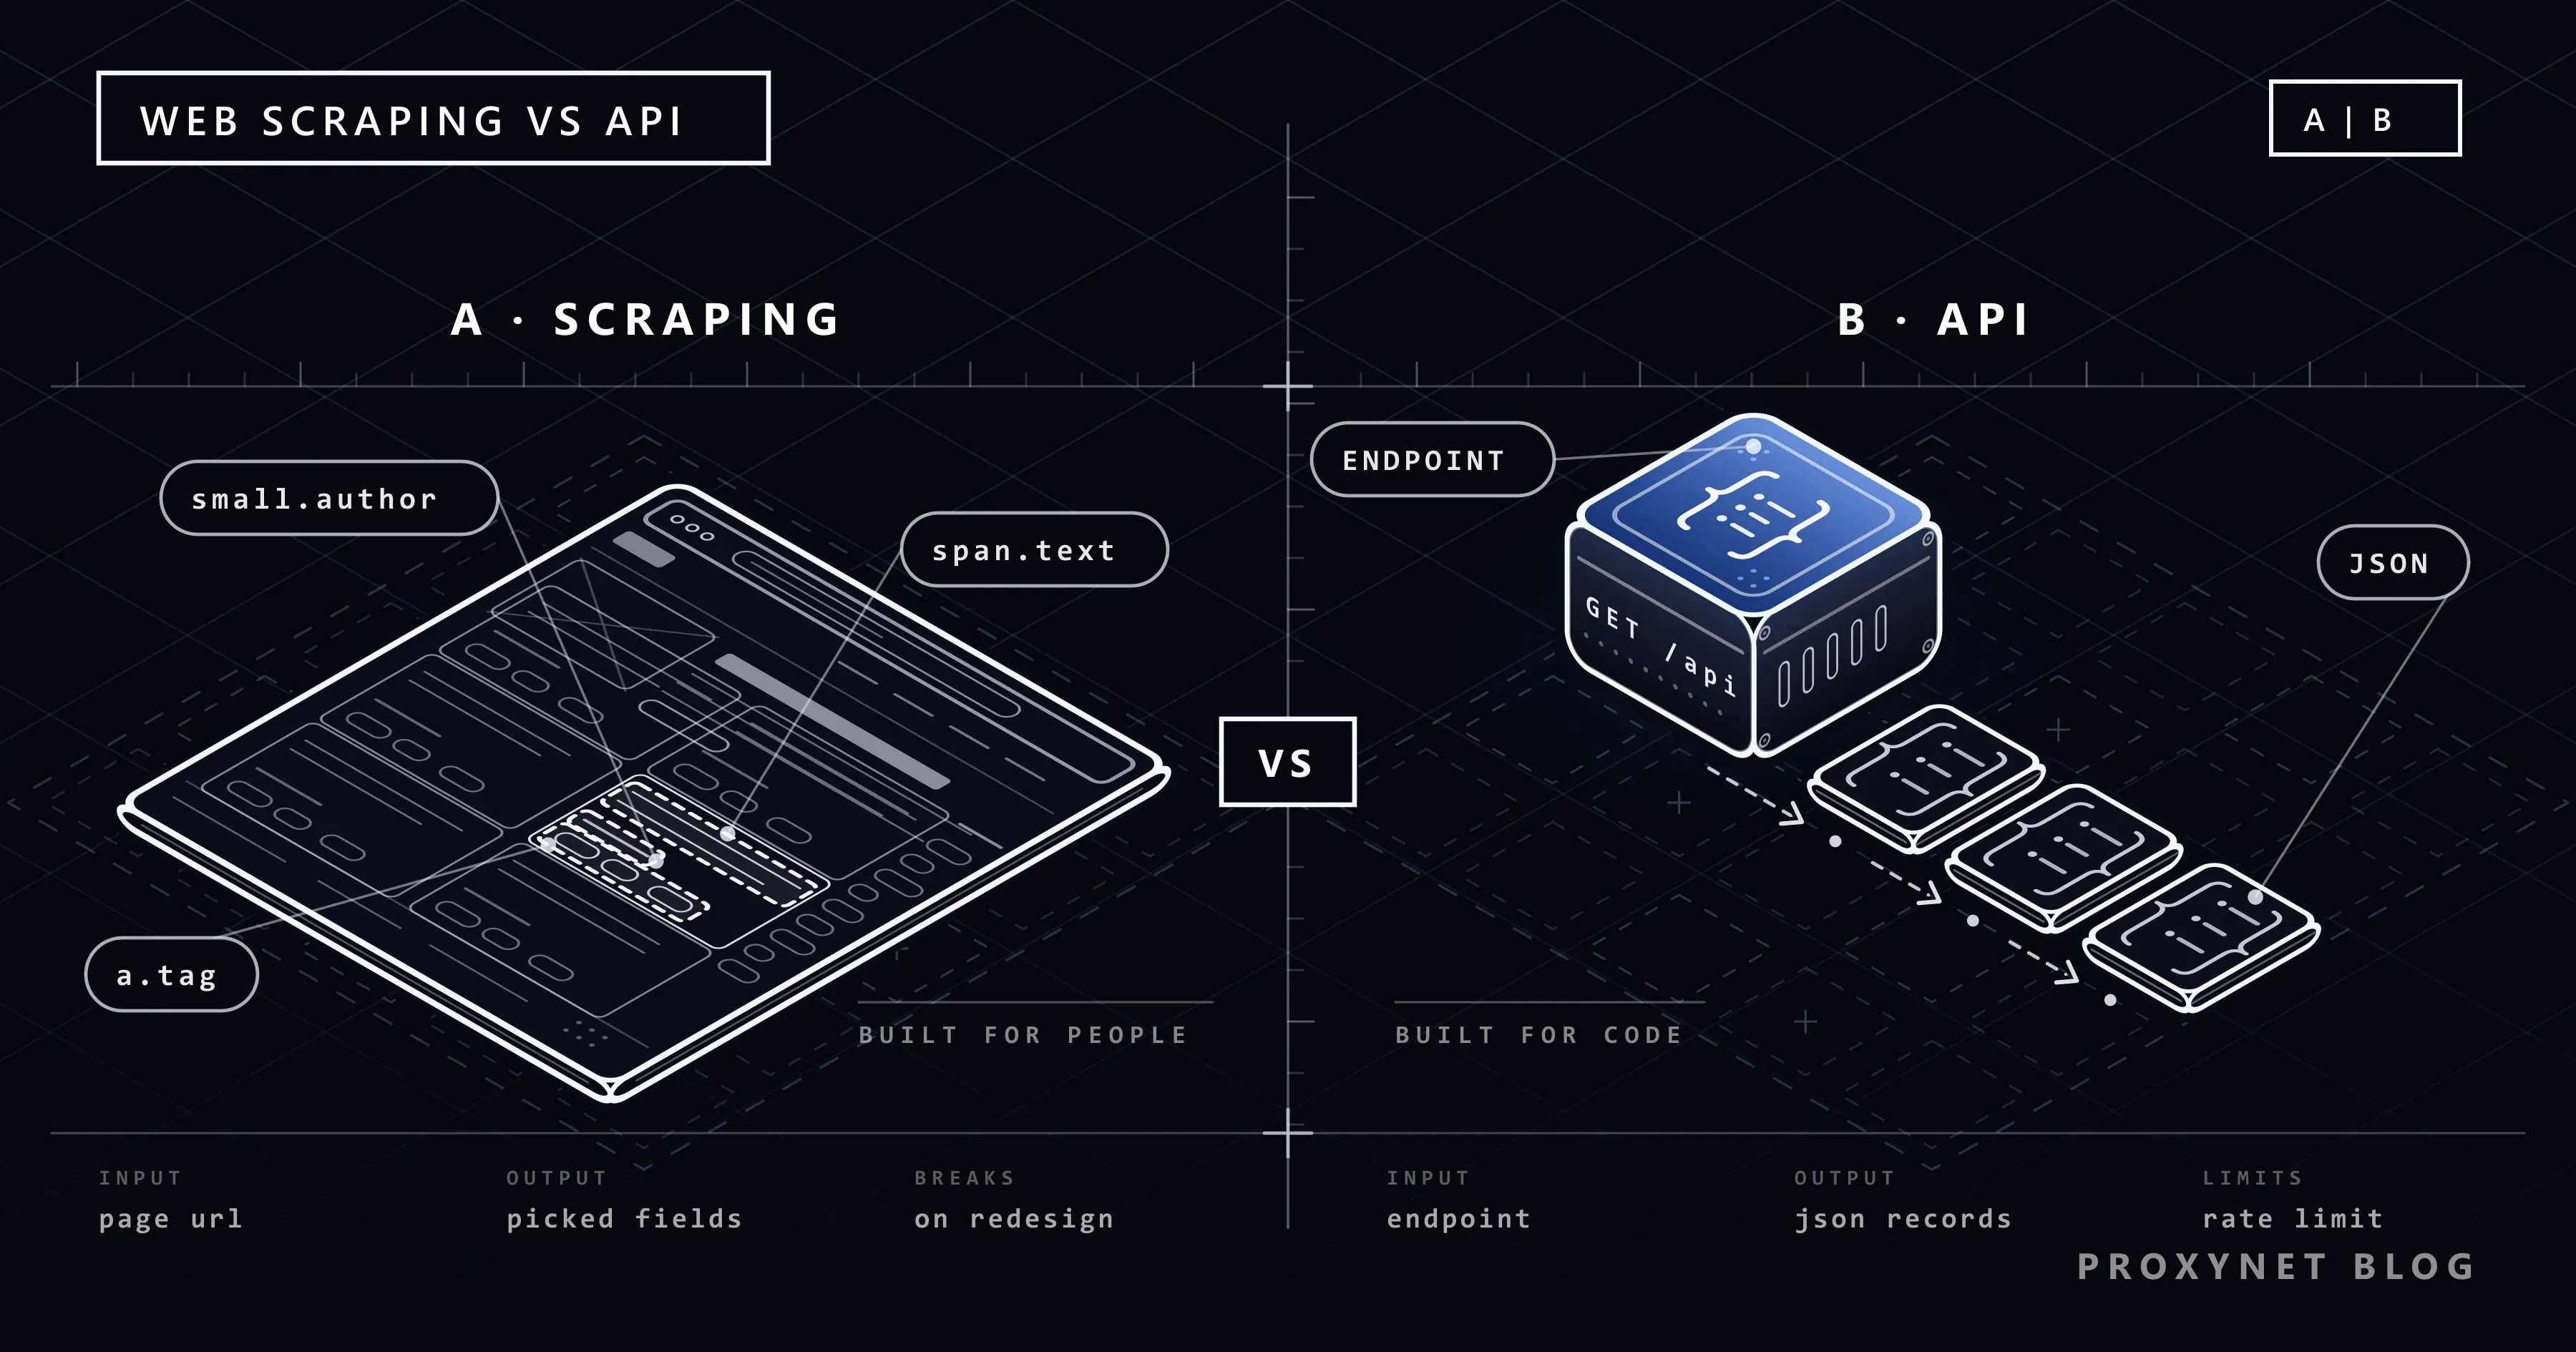
API (application programming interface, uygulama programlama arayüzü), bir programın başka bir programa gönderebileceği sabit istekler ve bu isteklerde neyin gönderilip neyin geri döneceğini belirleyen kurallardır. Web'de bu genellikle https://api.github.com/repos/python/cpython/issues gibi bir adrese yapılan HTTP isteği ve JSON biçiminde bir cevap demektir. Web sayfası insanın okuması için yazılır; API cevabı ise programın ayrıştırması için.
Bir web API'si birkaç parçadan oluşur:
- Endpoint: tek bir işlemin adresi; "issue'ları listele" ya da "tek bir ürünü getir" gibi.
- Parametreler: ne istediğiniz, örneğin
state=openya dapage=2. - Kimlik doğrulama: servise çağrıyı kimin yaptığını söyleyen API anahtarı, token ya da OAuth. Birçok API anonim çağrılara da cevap verir, ama daha düşük bir sınırla.
- Cevap biçimi: genellikle JSON; alan adları her çağrıda aynı kalır.
- Sınırlar ve şartlar: saatte kaç çağrı yapabileceğiniz ve veriyle ne yapabileceğiniz.
- Dokümantasyon: birçok API, makinenin okuyabileceği bir tanımı OpenAPI biçiminde yayımlar. OpenAPI Specification 10 Eylül 2026'dan beri 3.2.1 sürümündedir ve kendini HTTP API'leri için standart, programlama dilinden bağımsız bir arayüz tanımı olarak anlatır. Amaç, insanların ve araçların bir servisin neler sunduğunu kaynak koduna bakmadan öğrenebilmesidir.
Her API herkese açık değildir. Bankalar, borsalar ve birçok kurumsal servis anahtarı yalnız hesap sahiplerine verir; bazıları ise yalnızca önceden kaydedilmiş IP adreslerinden gelen çağrıları kabul eder. Bu konuya aşağıda döneceğiz.
Web scraping nedir?
Web scraping, bir programın tarayıcınızın yaptığı işi yapıp yalnızca veriyi saklamasıdır: sayfayı indirir, HTML'i okur ve değerleri CSS seçicileri ya da XPath ile içinden seçer. Site sizinle hiçbir konuda anlaşmış değildir. Ortadaki tek "sözleşme" sayfanın düzenidir ve site onu kendi gerekçeleriyle istediği gün değiştirebilir. Sürecin tamamını Web Scraping (Veri Kazıma) Nedir ve Nasıl Çalışır? yazımızda, bağlantıları izlemek ile alanları çıkarmak arasındaki farkı Web Scraping ve Web Crawling Farkı yazımızda anlattık.
Scraping'in gücü erişimidir: bir ziyaretçinin oturum açmadan görebildiği her şey kapsama girer. Bedeli ise her değeri, veri için değil tasarım için yazılmış bir HTML'in içinde yeniden bulmak zorunda kalmanızdır.
İki yol veriye nasıl ulaşır?
Uzaktan bakınca adımlar birbirine benzer. Fark, cevabın biçimine kimin karar verdiğindedir.
API ile:
- Dokümantasyonu okursunuz; endpoint'i, parametreleri ve sınırları bulursunuz.
- API istiyorsa bir anahtar alırsınız ve onu kodun içinde değil bir ortam değişkeninde tutarsınız.
- Parametrelerle bir istek gönderirsiniz, örneğin
?page=2. - Servis JSON döner; alanlar adlıdır ve çoğu zaman bir alan ya da başlık bir sonraki sayfayı gösterir.
- Alanları adlarıyla okursunuz. Sitenin yeniden tasarlanması bu alanlara dokunmaz.
Scraping ile:
- Sayfayı ve arkasındaki HTML'i incelersiniz; her değerin nerede durduğunu bulursunuz.
robots.txtdosyasına ve sitenin kullanım şartlarına bakarsınız (robots.txt nasıl okunur).- Sayfayı bir tarayıcının indirdiği gibi indirirsiniz; içeriği JavaScript kuruyorsa headless tarayıcıda (penceresiz çalışan gerçek bir tarayıcıda) açarsınız.
- HTML'i ayrıştırırsınız ve her değeri
span.textgibi bir seçiciyle alırsınız (veri ayrıştırma (parsing) nedir). - Değerleri temizleyip saklarsınız; düzen değiştiğinde işi yeniden yaparsınız.
Web scraping ve API: karşılaştırma tablosu
| Resmî API | Sitenin kendi JSON endpoint'i | Web scraping (HTML) | |
|---|---|---|---|
| Veri kapsamı | Yalnız sağlayıcının açtığı alanlar | Sayfanın kendini çizmek için ihtiyaç duyduğu veri | Ziyaretçinin görebildiği her şey |
| Biçim | Belgelenmiş JSON ya da XML | JSON, belgesiz | Ayrıştırmanız gereken HTML |
| Kararlılık | Sürümlü; değişiklikler duyurulur | Ön yüzün her sürümüyle değişebilir | Düzen değişince bozulur |
| Hız sınırı (rate limit) | Yayımlanır, çoğu zaman cevap başlıklarında | Yayımlanmaz; hızı siz belirlersiniz | Yayımlanmaz; hızı siz belirlersiniz |
| Kimlik doğrulama | Anahtar, token ya da OAuth; bazen IP whitelist | Bazen sayfa oturumunun çerezleri ya da token'ları | Herkese açık sayfalarda genellikle yok |
| Kullanım şartları | API şartları neye izin verildiğini söyler | Sitenin şartları geçerli; siteden bir söz yok | Sitenin şartları ve robots.txt geçerli |
| Maliyet | Ücretsiz kota ya da ücretli plan | Ücret yok; zamanınız ve trafiğiniz | Ücret yok; geliştirme, bakım, proxy, tarayıcıda işleme (render) |
| Bakım | Düşük; bir sürümün desteği bitince güncellenir | Orta; alan adları değişebilir | Yüksek; seçiciler yeniden tasarımda kırılır |
| Cevabın boyutu | Küçük, yalnız veri | Küçük, yalnız veri | Düzeni ve işaretlemesiyle bütün sayfa |
| JavaScript ile kurulan içerik | Sorun değil | Sorun değil | Headless tarayıcı ya da JSON yolu gerekir |
"Sürümlü" sözünün pratikte ne demek olduğunu GitHub'ın REST API'si gösteriyor. Bir istek hangi sürümü kullanacağını X-GitHub-Api-Version başlığında söyleyebilir; yeni bir sürüm çıktığında önceki sürüm en az 24 ay daha desteklenir (GitHub REST API sürümleri). Bir cevap alanını kaldırmak ya da adını değiştirmek orada geriye dönük uyumu bozan değişiklik sayılır ve yeni bir sürümü beklemek zorundadır. Başlık göndermeyen istekler hâlâ 2022-11-28 sürümünü alır ve bu sürüm 10 Mart 2028'e kadar desteklenir. Hiçbir web sitesi CSS sınıfları için böyle bir söz vermez.
Aynı veri iki yoldan: test edilmiş Python örneği
quotes.toscrape.com scraping alıştırması için kurulmuş bir deneme sitesidir; alt bilgisinde Zyte'ın adı geçer. 100 alıntıyı /page/1/ ile /page/10/ arasındaki on HTML sayfasında listeler. Sonsuz kaydırmalı sürümü /scroll ise aynı alıntıları bir JSON endpoint'inden, /api/quotes?page=N adresinden yükler; her cevapta bir has_next alanı bulunur. Site /robots.txt için 404 döner; robots.txt standardına göre bu, tarama kuralı olmadığı anlamına gelir. Betik yine de sayfalar arasında bir saniye bekler.
Betik 100 alıntının hepsini tek bir ortak oturumla iki yoldan da toplar. Her istek bir zaman aşımıyla gider; oturum User-Agent'ta kendini tanıtır ve 429 ile 5xx cevaplarında isteği yeniden dener:
"""Aynı alıntılar iki kez: HTML sayfalarından ayrıştırılarak ve JSON endpoint'inden okunarak."""
import os
import time

import requests
from bs4 import BeautifulSoup
from requests.adapters import HTTPAdapter
from urllib3.util import Retry

BASE = "https://quotes.toscrape.com"
DELAY = 1.0  # sayfalar arası bekleme (saniye)


def make_session():
    retry = Retry(
        total=4,
        backoff_factor=1,  # denemeler arasında 0, 2, 4, 8 sn bekler
        status_forcelist=[429, 500, 502, 503, 504],
        allowed_methods=["GET"],
        respect_retry_after_header=True,  # Retry-After başlığı varsa bekleme ondan alınır
    )
    session = requests.Session()
    session.mount("https://", HTTPAdapter(max_retries=retry))
    session.mount("http://", HTTPAdapter(max_retries=retry))
    session.headers["User-Agent"] = "quotes-compare/1.0 (contact: you@example.com)"
    proxy = os.environ.get("PROXY_URL")  # ör. http://user:pass@pr.proxynet.io:8000
    if proxy:
        session.proxies = {"http": proxy, "https": proxy}
    return session


def scrape_html(session):
    """1. yol: her HTML sayfasını indir, alanları CSS seçicilerle ayıkla."""
    quotes, page, size = [], 1, 0
    while True:
        r = session.get(f"{BASE}/page/{page}/", timeout=(5, 20))
        r.raise_for_status()
        size += len(r.content)
        soup = BeautifulSoup(r.content, "lxml")
        for q in soup.select("div.quote"):
            quotes.append({
                "text": q.select_one("span.text").get_text(strip=True),
                "author": q.select_one("small.author").get_text(strip=True),
                "tags": [a.get_text(strip=True) for a in q.select("a.tag")],
            })
        if soup.select_one("li.next > a") is None:  # "Next" bağlantısı yok: son sayfa
            return quotes, page, size
        page += 1
        time.sleep(DELAY)


def fetch_api(session):
    """2. yol: sitenin kendi kaydırma sayfasının çağırdığı JSON endpoint'i."""
    quotes, page, size = [], 1, 0
    while True:
        r = session.get(f"{BASE}/api/quotes", params={"page": page}, timeout=(5, 20))
        r.raise_for_status()
        size += len(r.content)
        data = r.json()
        for q in data["quotes"]:
            quotes.append({
                "text": q["text"],
                "author": q["author"]["name"],
                "tags": q["tags"],
            })
        if not data["has_next"]:  # listenin bittiğini API kendisi söylüyor
            return quotes, page, size
        page += 1
        time.sleep(DELAY)


session = make_session()
results = {}
for name, collect in (("HTML", scrape_html), ("API", fetch_api)):
    quotes, pages, size = collect(session)
    results[name] = quotes
    print(f"{name}: {pages} sayfadan {len(quotes)} alıntı, {size / 1024:.1f} KiB")

print("aynı veri:", results["HTML"] == results["API"])
print(results["API"][0])
Betiği doğrudan da, PROXY_URL ile yerel bir test proxy'si üzerinden de çalıştırdık; iki çıktı birebir aynıydı:
HTML: 10 sayfadan 100 alıntı, 106.1 KiB
API: 10 sayfadan 100 alıntı, 30.2 KiB
aynı veri: True
{'text': '“The world as we have created it is a process of our thinking. It cannot be changed without changing our thinking.”', 'author': 'Albert Einstein', 'tags': ['change', 'deep-thoughts', 'thinking', 'world']}
İki yolun 100 kaydı alan alan örtüştü. HTML yolu bunlar için 106,1 KiB, JSON yolu 30,2 KiB indirdi (sıkıştırma açıldıktan sonraki boyut). HTML sayfaları düzeni, gezinme menüsünü, etiket kenar çubuğunu ve her değerin çevresindeki işaretlemeyi de taşıyor. Proxy üzerinden yapılan çalıştırmada tek Session nesnesi 20 isteğin hepsini tek bir proxy tüneli üzerinden gönderdi.
İki döngü durma sinyalini farklı yerlerde arar. HTML yolu sayfada "Next" bağlantısı kalmayınca durur; API ise bunu has_next: false ile açıkça söyler. Bu sitede hata alana kadar sayfa numarası saymak işe yaramaz: /page/11/ alıntısız bir sayfayla, /api/quotes?page=11 de boş bir listeyle 200 döner. Diğer durma koşullarını Sayfalama (Pagination) Nedir, Scraping'de Nasıl Taranır? yazımızda anlattık.
Yeniden deneme ayarı iki yola da hizmet eder. Oturumu, iki kez Retry-After: 2 ile 429 dönen yerel bir test sunucusuna yönlendirdik: oturum her seferinde iki saniye bekledi, üçüncü cevabı 4,0 saniye sonunda döndürdü ve çağıran kod hiç 429 görmedi. Bu başlığı göndermeden sürekli 503 dönen bir sunucuda ise 0, 2, 4 ve 8 saniye bekledi, 14 saniyenin sonunda "too many 503 error responses" mesajıyla requests.exceptions.RetryError fırlattı. allowed_methods=["GET"] bilinçli bir seçim: RFC 9110, POST gibi idempotent olmayan (tekrarlandığında aynı etkiyi garanti etmeyen) bir yöntemle yapılan isteğin istemci tarafından otomatik olarak yeniden denenmemesi gerektiğini söyler.
Bir yolda olup ötekinde olmayan alanlar
İki yol tam olarak aynı alanları taşımıyor. Her API kaydında yazarın Goodreads bağlantısı ve kısa adı (slug) var; liste sayfası bunları göstermiyor:
{
  "author": {
    "goodreads_link": "/author/show/9810.Albert_Einstein",
    "name": "Albert Einstein",
    "slug": "Albert-Einstein"
  },
  "tags": [
    "change",
    "deep-thoughts",
    "thinking",
    "world"
  ],
  "text": "“The world as we have created it is a process of our thinking. It cannot be changed without changing our thinking.”"
}
HTML liste sayfası ise her yazarı doğum tarihi ve yerinin yazdığı bir "about" sayfasına bağlıyor (Einstein için "March 14, 1879" ve "in Ulm, Germany"). O sayfanın JSON karşılığı yok: /api/author/Albert-Einstein 404 döner. Gerçek projeler de buna benzer. API'de iç kimlik numaraları ve kesin stok sayıları bulunur; ziyaretçinin gerçekten gördüğü metin, rozet ve fiyat ise sayfadadır.
API de koddan bakınca tuhaf görünen biçimlerde hata verebilir. /api/quotes?page=abc bir HTML hata sayfasıyla 500 döner ve bu gövdede .json() çağrısı JSONDecodeError: Expecting value: line 1 column 1 (char 0) hatası verir. Yukarıdaki betikte 500'ü önce yeniden deneme adaptörü yakalar ve iş RetryError ile biter; adaptör olmasaydı raise_for_status() çalışmayı .json()'dan önce durdururdu. Bu hatanın diğer nedenleri JSONDecodeError: Expecting Value Hatası Nasıl Çözülür? yazımızda.
Gizli JSON endpoint'leri: ortadaki yol
Düz HTML gibi görünen birçok sayfa verisini arka planda JSON olarak yükler; yukarıdaki /scroll sayfasının /api/quotes adresini çağırması gibi. Bu istekleri tarayıcının geliştirici araçlarında bulursunuz: Ağ (Network) panelini açın, Fetch/XHR filtresini seçin, sayfayı yenileyin ve verinizi taşıyan cevaplara bakın. Adımların tamamı Statik ve Dinamik Sayfalar yazımızda, kopyalanan isteği Python'a çevirmek ise Python Requests ile POST ve JSON yazımızda.
Böyle bir endpoint çoğu zaman en iyi orta yoldur: sayfa boyutunun küçük bir kısmıyla yapılandırılmış veri. Yine de herkese açık bir API değildir; bu yüzden birkaç kural geçerlidir:
- Yalnız herkese açık veri. İstek yalnızca oturum açmış hesabınızın çereziyle çalışıyorsa veri herkese açık değildir; çerezinizle çalışan zamanlanmış bir betik kendi hesabınızı riske atar.
- Kararlılık sözü yok. Alan adları ve parametreler sitenin ön yüzünün her yeni sürümüyle, haber verilmeden değişebilir. Her çalıştırmada cevabın yapısını kontrol edin ve bir anahtar eksikse betiği açık bir hatayla durdurun.
- Aynı şartlar, aynı hız. Sitenin kullanım şartları ve
robots.txtkuralları sayfalar için olduğu gibi endpoint için de geçerlidir. JSON istekleri küçük olduğu için bir insanın yapacağından çok daha hızlı gönderilmeleri kolaydır; beklemeyi kaldırmayın. - İmzalı parametrede durun. İstek, sayfanın betiğinin ürettiği bir imza ya da kısa ömürlü bir token taşıyorsa yeniden kullanılmak için tasarlanmamıştır. Resmî bir API arayın ya da siteyle iletişime geçin.
- Belgelenmiş yolu tercih edin. Site aynı veri için resmî bir API sunuyorsa onu kullanın.
Herkese açık veri toplamanın ülkeden ülkeye değişen hukuki yanı Web Scraping (Web Kazıma) Yasal mı? yazımızda.
Scraping API nedir?
"Scraping API" bir tür ticari hizmetin de adıdır ve bir sitenin kendi API'sinden farklı bir şeydir. Hizmete hedef adresi gönderirsiniz; sayfayı sizin yerinize, çoğu zaman bir headless tarayıcıda ve kendi proxy havuzu üzerinden indirir, başarısız istekleri yeniden dener ve HTML'i ya da ayıkladığı alanları JSON olarak döndürür. Onu bir API gibi çağırırsınız, ama veri yine hedef sayfanın kazınmasından gelir.
Bu hizmetler, tarayıcıları ve proxy rotasyonunu kendileri yönetmeden pek çok siteden sayfa toplaması gereken ekiplere uyar. Üzerlerinden gönderdiğiniz istekler için ücret alırlar; asıl karşılaştırma bu fatura ile kendi scraper'ınızın maliyeti arasındadır. Hangi kuralların geçerli olduğunu da değiştirmezler: hedef sitenin şartları ve robots.txt kuralları sizi bağlamaya devam eder ve scraping API, zaten var olan resmî bir API'yi atlamak için gerekçe olamaz.
Hız sınırları, 429 ve API anahtarları
Resmî bir API sınırlarını size söyler, çoğu zaman her cevapta. GitHub'ın REST API'si kimlik doğrulaması olmadan saatte 60 istek tanır ve bunu isteğin geldiği IP adresine göre sayar; kişisel erişim token'ıyla sınır saatte 5.000 isteğe çıkar (GitHub REST API hız sınırları). /rate_limit endpoint'i nerede durduğunuzu gösterir ve bu çağrı birincil sınırdan düşülmez:
import requests

r = requests.get(
    "https://api.github.com/rate_limit",
    headers={"Accept": "application/vnd.github+json"},
    timeout=(5, 20),
)
core = r.json()["resources"]["core"]
print(r.status_code, "limit:", core["limit"], "kalan:", core["remaining"], "sıfırlanma:", core["reset"])
print({k: v for k, v in r.headers.items() if k.lower().startswith("x-ratelimit")})200 limit: 60 kalan: 58 sıfırlanma: 1790650244
{'X-RateLimit-Limit': '60', 'X-RateLimit-Remaining': '58', 'X-RateLimit-Used': '2', 'X-RateLimit-Resource': 'core', 'X-RateLimit-Reset': '1790650244'}Sıfırlanma değeri UTC cinsinden bir Unix zaman damgasıdır; bu çalıştırmada 29 Eylül 2026, 02:50:44'ü gösteriyordu. O saat içinde adresimizden iki istek zaten yapılmıştı. Sınır dolduğunda GitHub x-ratelimit-remaining değeri 0 olan bir 403 ya da 429 döner; x-ratelimit-reset başlığındaki zamana kadar beklemeniz gerekir. İkincil sınırlarda ise mümkünse retry-after gönderir, göndermediğinde en az bir dakika beklemenizi ister.
Genel amaçlı bir yeniden deneme ayarı burada yetersiz kalır. Betiğimizdeki oturum 429'u yeniden dener ama 403'ü denemez; üstelik saatte bir sıfırlanan bir pencereye karşı 14 saniyelik bekleme hiçbir işe yaramaz. API kullanırken başlıkları okuyun ve sıfırlanma anına kadar bekleyin.
Durum kodunun kendisi RFC 6585'ten gelir: 429 Too Many Requests, istemcinin belli bir sürede çok fazla istek gönderdiği anlamına gelir; cevap durumu açıklamalı, Retry-After başlığını da içerebilir. RFC, sunucunun istemciyi nasıl tanıyacağını ve istekleri nasıl sayacağını bilerek açık bırakır; bu yüzden sınır IP başına, anahtar başına ya da hesap başına olabilir. RFC 9110 ise Retry-After değerini ya bir tarih ya da saniye sayısı olarak tanımlar; urllib3 iki biçimi de okur. Kazıdığınız web sitesi bunların neredeyse hiçbirini yayımlamaz; hızı kendiniz belirleyin ve ilk 429'da yavaşlayın (429 Too Many Requests ve Rate Limit Hatası Nedir?).
Bazı API'ler neden sabit bir IP adresi ister?
Bazı API'ler çağrının hangi anahtarı taşıdığının yanında nereden geldiğine de bakar. Borsalar, pazaryerleri, bankalar ve birçok kurumsal veri servisi bir anahtara bir ya da birkaç IP adresi kaydetmenize izin verir; başka bir adresten gelen çağrı, anahtar doğru olsa bile reddedilir. Betik adresi değişen bir yerde çalışmaya başladığı anda iş bozulur: bir ev hattı, yolda kullanılan bir dizüstü bilgisayar, sabit bir çıkış IP'si olmayan sunucusuz (serverless) bir fonksiyon. Giden adresinizi nasıl bulacağınızı ve bunu sabitlemenin dört yolunu API için Statik IP yazımızda, borsa örneğini Kripto Borsası API'sinde IP Whitelist Nasıl Kurulur? yazımızda anlattık.
Ödeme, kart verisi ya da sağlık kaydı taşıyan entegrasyonlarda kaydedilen adres sizin kendi sunucunuz ya da hattınız olmalıdır. Hassas veri taşımayan test ortamlarında ve istemcilerde sabit adresli bir proxy de işi görür: ISP Proxy ya da Datacenter Proxy betiğinize, API'ye bir kez kaydedeceğiniz tek bir çıkış IP'si verir. IP başına satılan bu ürünler varsayılan olarak hedef site kısıtlamasıyla gelir; sipariş verirken API'nin alan adını hedef olarak belirtirsiniz, tüm sitelere erişim ise ücretli bir eklentidir.
Scraping'in ihtiyacı bunun tersidir: zaman içinde çok sayıda sayfa, bazen de başka bir ülkedeki ziyaretçinin gördüğü hâliyle. Rotating Proxy bunun içindir. İki proxy türü de yukarıdaki kuralları değiştirmez: adresi değiştirirler; sitenin şartlarını ya da uymanız gereken istek hızını değil.
Hangi yol ne kadara mal olur?
Resmî API. Fiyat, sağlayıcının fiyat sayfasındadır. Bazı API'ler belli bir kotaya kadar ücretsizdir, bazıları ilk çağrıdan itibaren ücret alır, bazılarına ise yalnızca kurumsal sözleşmeyle erişilir. Mühendislik maliyeti düşüktür: belgelenmiş bir JSON API'si için istemci, yukarıdaki gibi çoğu zaman birkaç düzine satırdır. Gizli maliyetler kota ve sağlayıcının denetimidir. Planın izin verdiğinden fazla çağrı gerektiren bir iş ya bekler ya da ek ücret öder; şartlar, fiyatlar ve erişim değişebilir, bir API kapatılabilir.
Scraping. Siteye bir ücret ödemezsiniz, ama geri kalan her şey size aittir: ayrıştırıcıyı yazmak, yeniden tasarımlardan sonra onarmak, sayfayı JavaScript kuruyorsa headless tarayıcı çalıştırmak (düz bir istekten çok daha ağırdır; Statik ve Dinamik Sayfalar yazısının maliyet bölümüne bakın), hacim ya da ülke gerektirdiğinde proxy ve bir seçici sessizce boş dönmeye başladığında bunu fark edecek bir izleme. Boyut da birikir. Testimizde HTML yolu aynı kayıtlar için yaklaşık 3,5 kat fazla bayt indirdi; proxy planınız trafiğe göre ücretlendiriliyorsa bu oran faturaya da yansır.
Scraping API hizmeti. İstek başına ödersiniz; tarayıcı ya da proxy çalıştırmazsınız. Hizmet ham HTML döndürüyorsa ayrıştırmanın bakımı yine sizdedir.
Scraping ve API ne zaman birlikte kullanılır?
İkisini birlikte kullanmak yaygındır ve genellikle dört kalıptan birine uyar:
- Liste API'den, ayrıntı sayfalardan. Örneğimizde 100 alıntıyı JSON endpoint'inden alır, doğum tarihleri için 50 yazar sayfasının her birini bir kez ziyaret ederdiniz.
- Kendi veriniz API'den, herkese açık görünüm sayfalardan. Satıcı API'si ilanlarınızı kimlik numaraları ve stoklarıyla döner; herkese açık ürün sayfası ise müşterinin gördüğü rozetleri ve yorum sayısını gösterir. İkisini ürün kimliği üzerinden birleştirin.
- Kayıt API'den, ülke görünümü sayfadan. Bir API tek bir liste fiyatı dönebilir; başka bir ülkedeki ziyaretçi ise sayfada yerel para birimini, vergiyi ve kampanyayı görür. Bu karşılaştırma için sayfanın o ülkeden açılması gerekir.
- Sayfa, API'nin sağlaması olarak. Günde birkaç sayfayı örnekleyen küçük bir scraper, API'nin döndürdüğünün ziyaretçinin gördüğüyle hâlâ örtüştüğünü doğrular.
Kullanım alanları
- Fiyat ve stok takibi: kendi ilanlarınız platformun API'siyle, rakiplerin herkese açık sayfaları scraper ile (rakip fiyat takibi).
- Depo, issue ve sürüm verisi:
Linkbaşlığıyla sayfalanan GitHub API'si (API'de sayfalama). - Borsa verisi ve alım satım botları: kayıtlı bir adrese bağlı API anahtarı (borsa API'sinde IP whitelist).
- Tek seferlik tablo aktarımı: bir sayfadaki tabloyu elektronik tabloya almak için içe aktarma işlevi ya da birkaç satır Python (web sitesinden veri çekme).
- Sonuçları saklamak: aynı kayıtları CSV, JSON ya da SQLite'a yazmak (kazınan veriyi kaydetme).
- Çıkarmadan önce bütün sayfaları bulmak: siteyi baştan sona tarayıp adresleri keşfeden bir crawler (web crawler).
- Büyük, zamanlanmış veri toplama: kuyruklar, hız denetimi ve birkaç ülkeden çıkış (veri kazıma).
Sık yapılan hatalar
- Aynı veri için API sunan bir siteyi kazımak. Bakım yükünü boşuna üstlenirsiniz; üstelik otomatik erişime izin veren tek şartlar API'ninkiler olabilir.
- Gizli bir endpoint'i herkese açık API gibi görmek. Ne sürümü ne de bir sözü vardır; cevabın yapısını her çalıştırmada kontrol edin.
- Her hata için tek bir yeniden deneme kuralı. Kısa bekleme kısa süren bir
503'e uyar; saatlik kotax-ratelimit-resetister, yukarıdaki ayar ise403'ü hiç yeniden denemez. - POST isteklerini otomatik yeniden denemek. Bir sipariş ya da mesaj iki kez gidebilir; otomatik yeniden denemeyi GET ile sınırlayın.
- Gelen her cevapta
.json()çağırmak. Önce durum kodunu veContent-Typebaşlığını kontrol edin; hata sayfası HTML'dir. - Bir şey bozulana kadar sayfa numarası saymak. Deneme sitesinde 11. sayfa içi boş bir
200döndü;has_nextalanını ya da "Next" bağlantısını izleyin. - API anahtarını kodun içinde tutmak. Anahtarı bir ortam değişkeninden okuyun ve depoya koymayın.
- Proxy hatasını sitenin suçu sanmak. Yeniden deneme adaptörü başarısız bir proxy girişini de yeniden dener: yanlış proxy parolasıyla betiğimiz 14 saniye içinde beş kez denedi, sonra
407 Proxy Authentication Requirediçeren birProxyErrorfırlattı. Önce kimlik bilgilerini kontrol edin.
Karar rehberi
| İhtiyaç | Öneri |
|---|---|
| Sitenin ihtiyacınız olan alanları veren resmî bir API'si var | API'yi kullanın; önce sınırlarını ve şartlarını okuyun |
| API var ama bazı alanlar eksik | Temel kayıtlar API'den, eksikler scraping ile; ikisini bir kimlik üzerinden birleştirin |
| API yok, veri HTML'in içinde | Requests ve BeautifulSoup, sayfalar arasında bekleme ile |
| API yok, veriyi JavaScript yüklüyor | Önce JSON isteğini arayın; headless tarayıcıyı yalnız istek yeniden kullanılamıyorsa kullanın |
| API yalnız kayıtlı IP'lerden gelen çağrıyı kabul ediyor | Sabit bir çıkış adresi: kendi sunucunuz ya da hassas veri taşımayan istemciler için statik ISP veya datacenter proxy |
| API kotası her saat doluyor | Hız sınırı başlıklarını okuyun, çağrıları zamana yayın, daha yüksek bir plan isteyin |
| Kendi altyapınız olmadan pek çok siteden sayfa | Hedef sitelerin şartları izin veriyorsa bir scraping API hizmeti |
| Değerlendirdiğiniz sitelerden günde binlerce sayfa | Rotating Proxy ve site başına bir istek bütçesiyle kendi scraper'ınız |
Sıkça sorulan sorular
Web scraping ile API arasındaki fark nedir?
API, sağlayıcının programlar için kurduğu yoldur: belgelenmiş bir istek gönderirsiniz, yayımlanmış sınırlar ve şartlar altında yapılandırılmış veri alırsınız. Web scraping ise insanlar için kurulmuş sayfaları okur ve değerleri HTML'in içinden seçer. Hangi alanları alacağınıza API karar verir; scraping görünen her şeye ulaşabilir ama sayfa değiştiğinde bozulur.
Web scraping API kullanmaktan daha mı iyi?
Genel olarak hayır. Resmî bir API ihtiyacınız olan alanları veriyorsa onunla çalışan bir betik daha çabuk yazılır ve site yeniden tasarlandığında da çalışmaya devam eder. API yoksa, sayfanın gösterdiği veriyi API vermiyorsa ya da kotası veya fiyatı işinize uymuyorsa scraping daha doğru seçimdir.
Her web sitesinin bir API'si var mı?
Hayır. Birçok sitenin herkese açık bir API'si hiç yoktur; birçoğununki de verinin yalnız bir kısmını kapsar ya da kurumsal hesap ister. Bazı siteler sayfalarını iç JSON endpoint'lerinden yükler; bunlar herkese açık veri için dikkatle kullanılabilir, ama yayımlanmış bir API değildir.
Bir sitenin gizli API'sini kullanmak yasal mı?
Cevap veriye, sitenin kullanım şartlarına ve sizin ile sitenin bulunduğu ülkelerin hukukuna bağlıdır. Sayfanın kendisinin çağırdığı bir endpoint'ten herkese açık veri okumak teknik olarak sayfayı okumakla aynıdır ve aynı şartlar geçerlidir. Başkasının hesabıyla oturum açmak, erişim denetimlerini aşmak ya da kişisel veri toplamak ise başka soruları gündeme getirir. Genel çerçeve Web Scraping (Web Kazıma) Yasal mı? yazımızda.
Scraping API ile bir sitenin API'si aynı şey mi?
Hayır. Sitenin API'sini site yayımlar ve verisini sabit bir biçimde döndürür. Scraping API ise hedef sayfayı sizin yerinize indirip HTML'i ya da ayıklanmış alanları döndüren üçüncü taraf bir hizmettir. Veri yine sayfadan gelir ve hedef sitenin şartları yine geçerlidir.
API çağırmak için proxy gerekir mi?
Genellikle hayır. API yalnız kayıtlı IP adreslerinden gelen çağrıları kabul ediyorsa ve sizin adresiniz değişiyorsa ya da bir API'nin veya sayfanın başka bir ülkeden nasıl cevap verdiğini görmeniz gerekiyorsa proxy gerekir. Ödeme ve diğer hassas entegrasyonlarda bunun yerine kendi sunucunuzun adresini kaydedin.
Özet
API, bir sağlayıcının programlar için kurduğu yoldur; biçimi sürümlüdür, sınırları yazılıdır. Scraping ise sağlayıcının insanlar için kurduğunu okur; görünen her şeye ulaşır, sayfa değişince bozulur. Önce resmî bir API olup olmadığına bakın, yoksa sitenin kendi JSON endpoint'ini dikkatle kullanın, geriye kalanı HTML'den kazıyın. Bir API sabit bir adres istediğinde ya da bir scraping işi birkaç ülkede hacim gerektirdiğinde proxy paketlerimizi karşılaştırın.