


































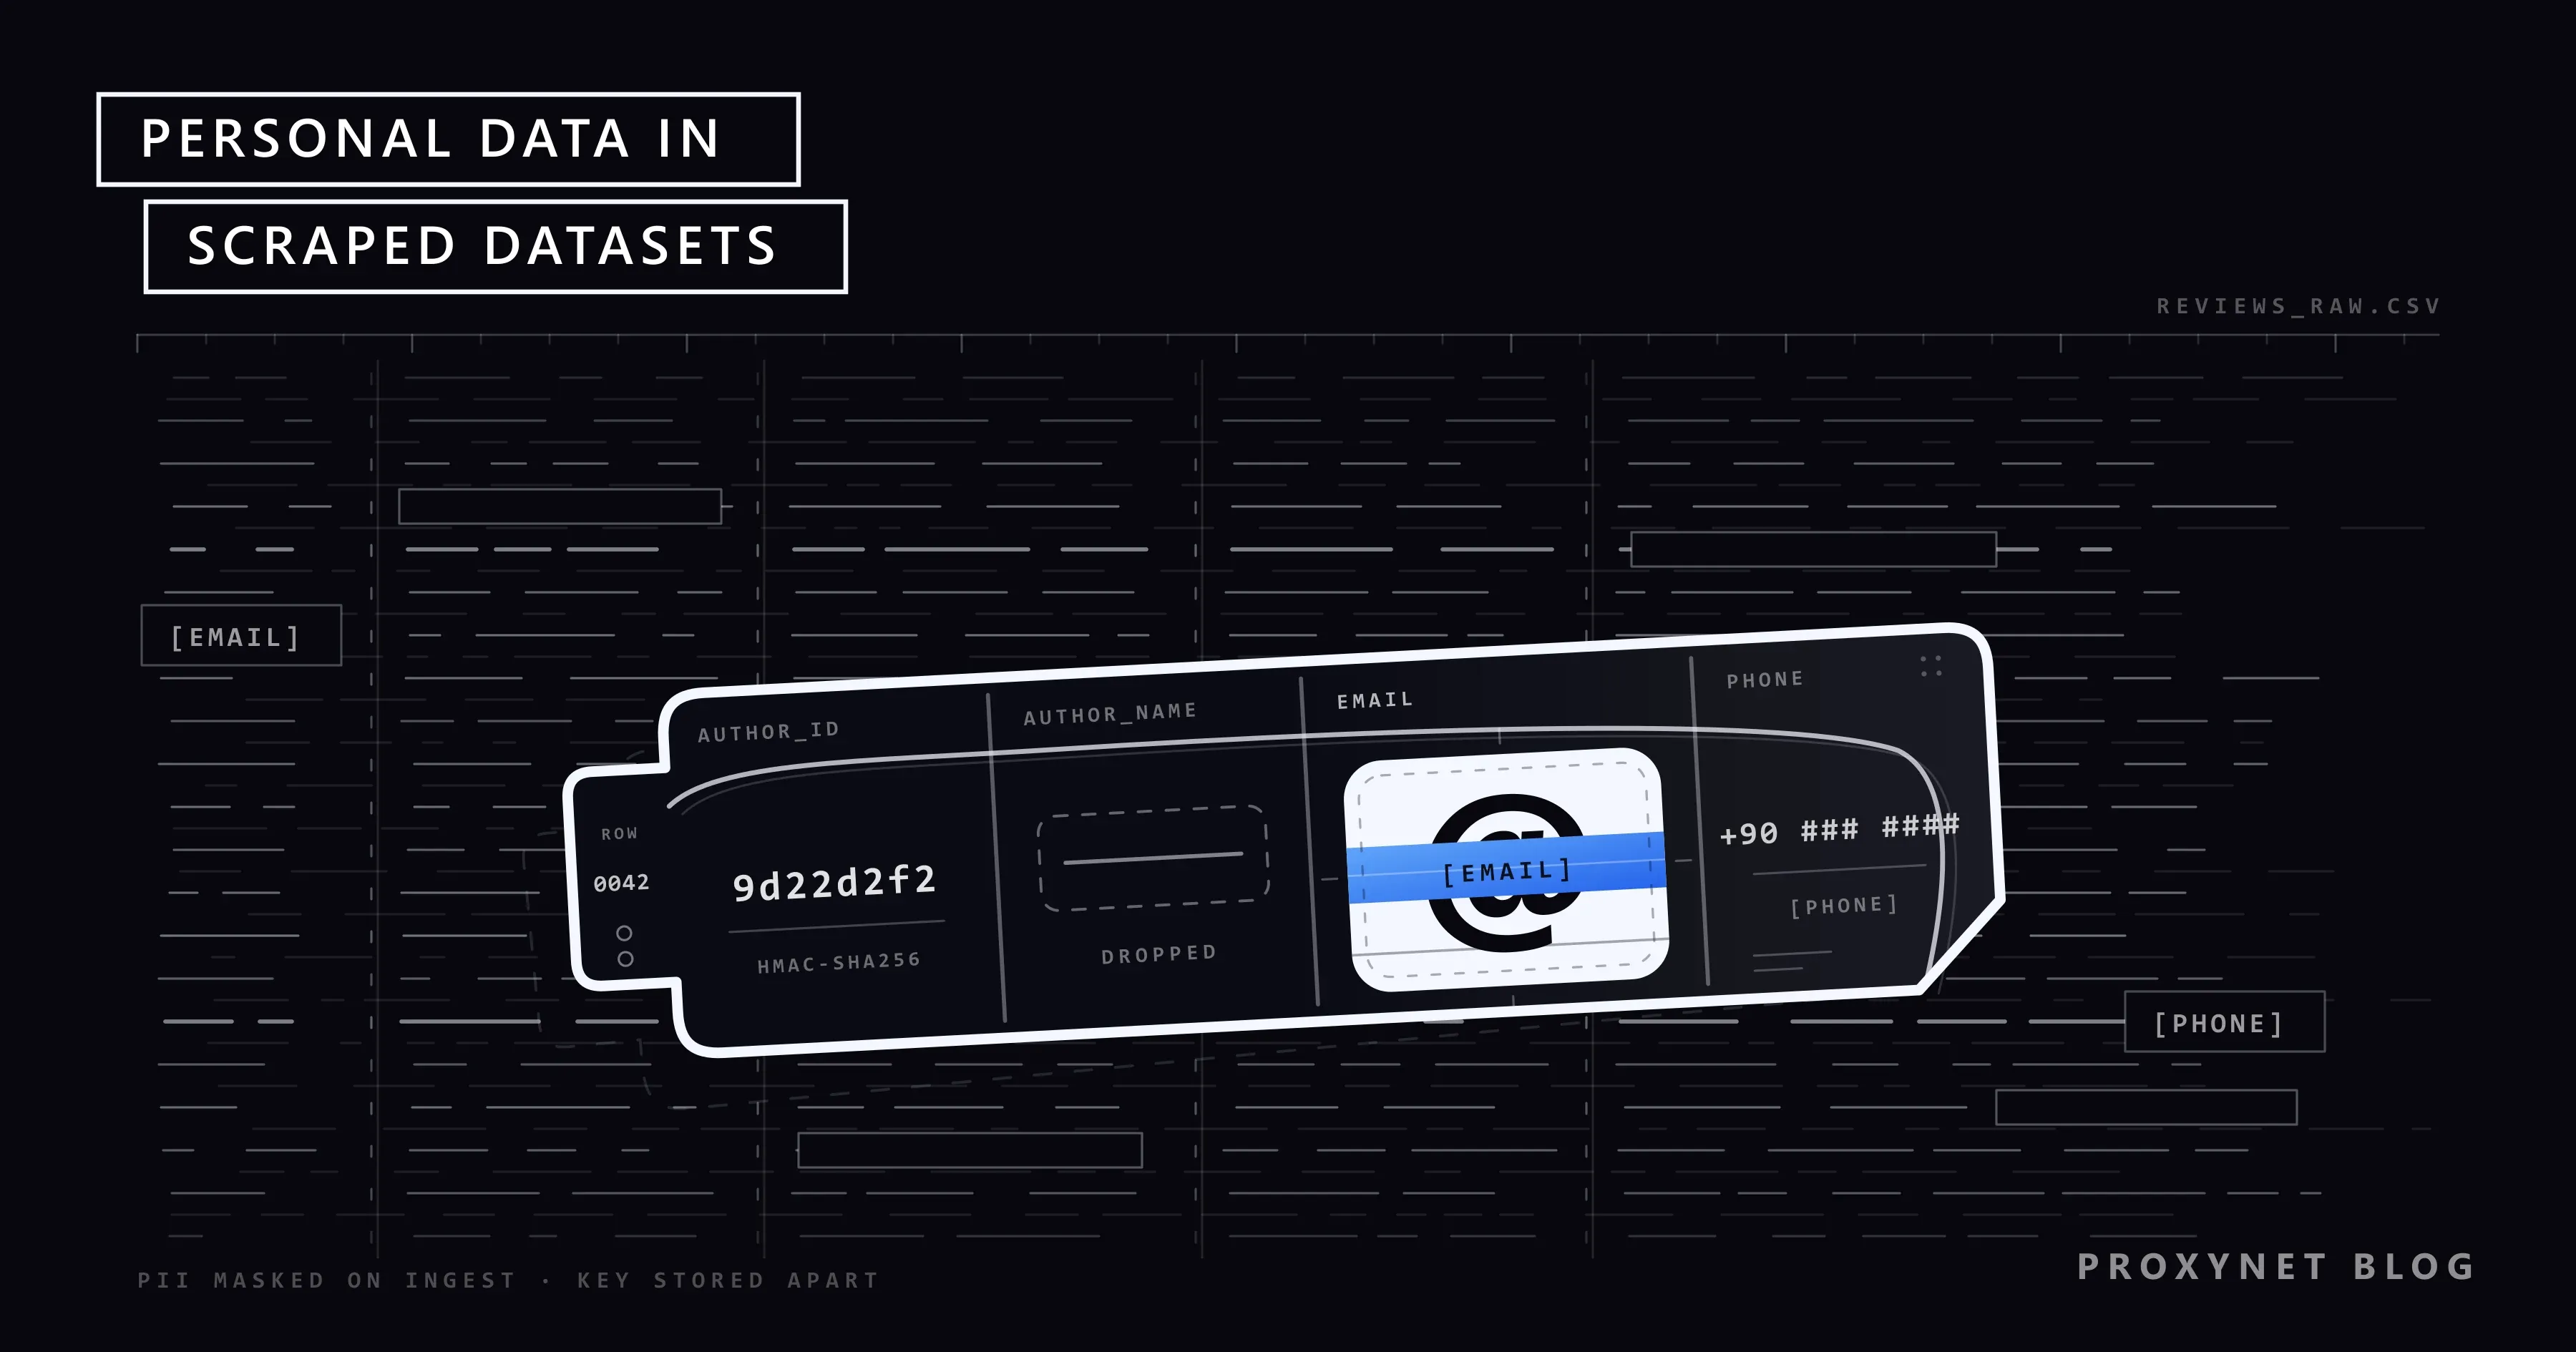
Você faz scraping de 20.000 avaliações de produtos para ver quais reclamações aparecem mais. O plano era ficar com a nota e o texto. Ao abrir o CSV, você encontra também o nome dos autores, links para as páginas de perfil deles e, em algumas centenas de avaliações, um endereço de e-mail ou um número de telefone que o autor digitou no texto. Nada disso ajuda na análise, mas agora está no seu notebook e no backup de ontem à noite.
Este artigo mostra o que conta como dado pessoal em um conjunto de dados obtido por scraping (muitas vezes chamado de PII, do inglês personally identifiable information, informação de identificação pessoal: tudo o que aponta para uma pessoa específica), por que "era público" não resolve a questão e como tratar esses dados: coletar menos, mascarar o que escapa, pseudonimizar as chaves de que você precisa e apagar dentro de um prazo. Também mostra por que o hash de um e-mail é mais fraco do que parece, traz um script de mascaramento em Python testado e aponta para o Regulamento Geral sobre a Proteção de Dados da UE (GDPR), a KVKK da Türkiye e o CCPA da Califórnia. Se as pessoas do seu conjunto de dados estão no Brasil, a LGPD também entra na conta.
O que conta como dado pessoal em um conjunto de dados de scraping?
A definição do GDPR no artigo 4.º, ponto 1 é ampla: "informação relativa a uma pessoa singular identificada ou identificável", de forma direta ou indireta, com exemplos como um nome, um número de identificação, dados de localização e um identificador por via eletrônica. A Lei n.º 6698 de Proteção de Dados Pessoais da Türkiye (KVKK) usa essencialmente a mesma formulação no artigo 3.
Em um projeto de scraping, dados pessoais aparecem em três lugares:
- Campos que você seleciona de propósito. Nomes de autor, nomes de usuário, URLs de perfil, avatares, cargos na página de uma empresa, nomes de vendedores em um marketplace.
- Texto livre. Avaliações, comentários, posts de fóruns e descrições de anúncios, onde as pessoas escrevem e-mail, telefone, rua ou placa do carro.
- Seus próprios logs. Logs de requisições e dumps de erro costumam guardar o HTML completo da página, com tudo o que está acima.
Mais difícil de perceber: campos que sozinhos não identificam ninguém. Um nome de usuário, uma cidade, uma data e um produto raro podem, juntos, apontar para uma única pessoa, então um conjunto de dados sem coluna "nome" ainda pode conter dados pessoais.
"Público" significa livre para usar?
Em geral, não, e a resposta muda de lei para lei.
- GDPR. Não existe exceção para dados pessoais disponíveis publicamente. Dados obtidos por scraping ainda precisam de uma base legal e devem seguir os princípios do artigo 5. O artigo 14 define o que você deve às pessoas cujos dados não foram coletados junto delas.
- KVKK. O artigo 5 lista as condições para tratar dados sem consentimento explícito. Uma delas é que a própria pessoa tenha tornado os dados públicos. Não é um cheque em branco: os princípios do artigo 4, como finalidade determinada e proporcionalidade, continuam valendo.
- CCPA. A definição californiana de informação pessoal no Civil Code 1798.140 inclui endereços IP e de e-mail entre os identificadores e depois exclui a informação "publicly available" (disponível publicamente), definida de forma estrita: por exemplo, registros públicos do governo ou informação que o consumidor disponibilizou ao público em geral.
A questão jurídica mais ampla, incluindo termos de uso e direitos autorais, está em Web scraping é legal?.
Como tratar dados pessoais em um pipeline de scraping
O artigo 25 do GDPR exige "proteção de dados desde a conceção e por defeito" (na versão oficial em português europeu): as salvaguardas fazem parte do projeto, não de uma limpeza no fim. Junto com o princípio da "minimização dos dados" do artigo 5, para um scraper isso significa:
- Escreva a finalidade. "Encontrar as reclamações de entrega mais comuns por produto" é uma finalidade. "Coletar avaliações caso sejam úteis" não é.
- Liste os campos que a atendem. No exemplo acima: produto, data, nota e texto. Nome do autor e URL do perfil não estão na lista.
- Filtre na coleta. Não selecione o que você não vai usar.
- Mascare o texto livre na ingestão. Substitua e-mails e telefones por marcadores antes de a linha ser gravada em qualquer lugar.
- Pseudonimize as chaves de que você precisa. Se precisa contar autores recorrentes, guarde um hash com chave do ID do autor em vez do ID.
- Guarde a chave separada. A chave de pseudonimização fica em um gerenciador de segredos ou em uma variável de ambiente, nunca no conjunto de dados nem no mesmo repositório.
- Proteja o armazenamento. Criptografe em repouso, restrinja o acesso às pessoas que trabalham no projeto e mantenha os dumps brutos fora de drives compartilhados.
- Apague dentro de um prazo. HTML bruto e arquivos não mascarados têm um prazo de retenção curto; o conjunto de dados limpo tem o seu, ligado à finalidade.
- Registre o que você fez. Finalidade, campos, prazo de retenção e base legal, em uma nota curta.
Mascaramento, pseudonimização e anonimização: a diferença
Esses termos não são intercambiáveis, e a diferença decide se a lei ainda se aplica aos seus dados.
| Técnica | O que faz | A pessoa pode ser reidentificada? | Ainda é dado pessoal? |
|---|---|---|---|
| Exclusão na coleta | O campo nunca é armazenado | Não, o dado não existe | Não, para esse campo |
| Mascaramento | Substitui um valor por um marcador como [EMAIL] | Não a partir do valor mascarado, mas talvez por outros campos | Depende do que sobra na linha |
| Pseudonimização | Substitui um identificador por um token; o vínculo fica em informação separada e protegida | Sim, com a chave ou a tabela de correspondência | Sim (considerando 26 do GDPR) |
| Anonimização | Remove ou generaliza dados até que ninguém possa ser identificado por meios razoavelmente prováveis | Não | Não |
| Criptografia | Torna os dados ilegíveis sem uma chave | Sim, para quem tem a chave | Sim |
| Agregação | Mantém só contagens, médias ou grupos | Só se os grupos forem muito pequenos | Em geral não, se os grupos forem grandes o bastante |
O que o GDPR diz sobre pseudonimização
O artigo 4.º, ponto 5, define pseudonimização como o tratamento de dados pessoais de forma que "deixem de poder ser atribuídos a um titular de dados específico sem recorrer a informações suplementares", desde que essas informações sejam mantidas separadamente e protegidas. O considerando 26 traça então a linha: dados pseudonimizados que possam ser atribuídos a uma pessoa com informações suplementares "deverão ser considerados informações sobre uma pessoa singular identificável". Informações anônimas ficam fora do Regulamento.
Para decidir se alguém é identificável, o considerando 26 manda considerar "todos os meios suscetíveis de ser razoavelmente utilizados", seja pelo responsável pelo tratamento, seja por outra pessoa, incluindo custo, tempo e a tecnologia disponível. É por isso que anonimizar texto obtido por scraping é difícil: tirar o nome raramente adianta quando a avaliação ainda menciona a cidade, a data e o modelo do carro.
O Comitê Europeu para a Proteção de Dados adotou as Diretrizes 01/2025 sobre pseudonimização em janeiro de 2025. A proposta "Digital Omnibus" da Comissão Europeia, de novembro de 2025, mudaria a forma como a definição de dados pessoais se aplica a dados pseudonimizados; segundo a página do trem legislativo do Parlamento Europeu, ela ainda não tinha sido adotada quando este artigo foi escrito. Até que uma mudança entre em vigor, trate dados pseudonimizados como dados pessoais.
A KVKK não define pseudonimização. O artigo 3 define anonimização como tornar os dados impossíveis de associar a uma pessoa "mesmo cruzando-os com outros dados", e o artigo 7 exige exclusão, destruição ou anonimização quando o motivo do tratamento deixa de existir.
Por que o hash de um e-mail não é anonimização
Um atalho comum é rodar sha256(email) e chamar a coluna de anônima. Ela não é, por dois motivos.
Primeiro, o hash é sempre o mesmo. Quem tem uma lista de endereços de e-mail, como uma vazada em um incidente de segurança, pode calcular o hash de cada endereço e procurar coincidências; no nosso teste, uma lista de dois palpites encontrou na hora o endereço "anônimo". As mesmas listas vazadas alimentam o credential stuffing, mais um motivo para não guardar e-mails em texto claro de que você não precisa.
Segundo, alguns identificadores têm um espaço de busca pequeno. Um número de telefone nacional tem uma quantidade limitada de dígitos, então calcular o hash de todos os números possíveis dessa faixa é viável em hardware comum, e o token que coincide devolve o número.
O que funciona melhor:
- Um hash com chave (HMAC) com uma chave secreta guardada longe dos dados. O resultado são dados pseudonimizados, não anônimos.
- Um token aleatório e uma tabela de correspondência guardada separadamente, se você precisa reverter o mapeamento.
- Nenhum identificador, se você só precisa de contagens. Agregue primeiro e descarte a chave.
Exemplo em Python: mascarar e-mails e telefones
O script lê um CSV de avaliações obtidas por scraping e grava uma cópia limpa: descarta colunas desnecessárias, mascara e-mails e telefones na coluna de texto livre e substitui o ID do autor por um hash com chave, para que ainda seja possível contar autores recorrentes. Só biblioteca padrão, testado com Python 3.13.
import csv
import hashlib
import hmac
import os
import re

# Colunas de que a análise nunca precisa: descartadas na ingestão
DROP_COLUMNS = {"author_name", "profile_url"}
# Coluna mantida só como pseudônimo, para contar autores recorrentes
PSEUDONYM_COLUMN = "author_id"
# Colunas de texto livre onde as pessoas digitam dados de contato; as estruturadas ficam intactas
TEXT_COLUMNS = {"text"}

EMAIL_RE = re.compile(r"[A-Za-z0-9._%+-]+@[A-Za-z0-9.-]+\.[A-Za-z]{2,}")
# Sequências com cara de telefone: + ou ( opcional, depois 9-15 dígitos com espaços, pontos, hifens ou parênteses entre eles
PHONE_RE = re.compile(r"(?<!\w)[+(]?\d(?:[\s.()-]*\d){8,14}(?!\w)")

# A chave fica fora do conjunto de dados (variável de ambiente, gerenciador de segredos), nunca no mesmo arquivo
SECRET = os.environ.get("PSEUDONYM_KEY", "").encode()


def mask_text(text: str) -> str:
    text = EMAIL_RE.sub("[EMAIL]", text)
    return PHONE_RE.sub("[PHONE]", text)


def pseudonym(value: str) -> str:
    # Hash com chave (HMAC-SHA256): sem a chave, ninguém reconstrói o mapeamento calculando o hash de palpites
    return hmac.new(SECRET, value.encode(), hashlib.sha256).hexdigest()[:16]


def clean_row(row: dict) -> dict:
    out = {}
    for col, value in row.items():
        if col in DROP_COLUMNS:
            continue
        if col == PSEUDONYM_COLUMN:
            out[col] = pseudonym(value)
        elif col in TEXT_COLUMNS:
            out[col] = mask_text(value)
        else:
            out[col] = value
    return out


def main(src: str, dst: str) -> None:
    if not SECRET:
        raise SystemExit("Set PSEUDONYM_KEY first")
    with open(src, newline="", encoding="utf-8") as f_in, \
         open(dst, "w", newline="", encoding="utf-8") as f_out:
        reader = csv.DictReader(f_in)
        fields = [c for c in reader.fieldnames if c not in DROP_COLUMNS]
        writer = csv.DictWriter(f_out, fieldnames=fields)
        writer.writeheader()
        for row in reader:
            writer.writerow(clean_row(row))


if __name__ == "__main__":
    main("reviews_raw.csv", "reviews_clean.csv")
Rode o script com a chave definida no ambiente (export PSEUDONYM_KEY=... no Linux e no macOS, $env:PSEUDONYM_KEY="..." no PowerShell) e depois python mask_pii.py. Na nossa amostra inventada, "Me ligue no +90 532 000 00 00 ou no (0212) 000-0000" virou "Me ligue no [PHONE] ou no [PHONE]", os e-mails viraram [EMAIL] e as duas avaliações de um mesmo autor receberam o mesmo token.
Conheça os limites:
- A regex mascara demais. Nos nossos testes, o padrão de telefone também cobriu um ISBN de 13 dígitos, um número de pedido de 10 dígitos e uma data escrita junto com um horário. Por isso o script só mexe nas colunas de texto livre.
- A regex deixa passar. Números escritos por extenso, "nome arroba domínio ponto com", IBANs, endereços e nomes dentro do texto não são pegos; para isso é preciso um modelo de reconhecimento de entidades nomeadas ou a revisão manual de uma amostra.
- Mascarar não é anonimizar. A linha mantém texto, data e produto; verifique se só isso já pode apontar para uma pessoa.
Execute esta etapa onde as linhas são gravadas pela primeira vez, não como um job posterior. O guia de limpeza com pandas mostra onde ela entra em uma limpeza completa, e como salvar dados de scraping em CSV, JSON e SQLite trata do armazenamento.
Segurança do armazenamento, acesso e retenção
O artigo 32 do GDPR exige um nível de segurança "adequado ao risco" e cita a pseudonimização e a cifragem, sistemas resilientes, a restauração dos dados após um incidente e testes regulares. O artigo 12 da KVKK define um dever parecido. Para um scraper, isso significa:
- Criptografia em repouso para discos, buckets e bancos de dados com dados brutos de scraping.
- Zonas separadas. HTML bruto e linhas não mascaradas em um lugar restrito; o conjunto de dados limpo onde os analistas trabalham.
- Acesso mínimo. Só as pessoas e contas de serviço que precisam da zona bruta podem lê-la.
- Retenção como código. Um job agendado de exclusão vale mais que um documento de política.
- Backups contam. Um arquivo que continua vivo em um backup de um ano atrás não foi apagado. Alinhe os dois prazos de retenção.
Nossa página de segurança de dados trata de proxies no trabalho de segurança; um proxy muda o IP de onde sai uma requisição, não o que você armazena.
Onde isso aparece
- Monitoramento de preços e estoque. Páginas de produto raramente têm dados pessoais, mas nomes de vendedores em marketplaces podem ter. Veja como monitorar preços da concorrência.
- Análise de avaliações e de sentimento. Campos de autor e dados de contato no texto. Veja pesquisa de mercado.
- Pesquisa e mineração de dados. Posts de fóruns são cheios de dados pessoais; agregue cedo. Veja o que é mineração de dados.
- Rastreamentos grandes. Um web crawler genérico coleta páginas inteiras, então tudo o que há nelas vai parar no seu armazenamento se você não filtrar.
- Listas de leads. Coletar dados de contato de pessoas físicas para prospecção é o caso de maior risco aqui; verifique antes a lei e os termos do site.
Erros comuns
- Fazer scraping da página inteira "por garantia" e deixar o dump bruto armazenado por tempo indeterminado.
- Chamar de "anonimizado" um SHA-256 de um e-mail.
- Guardar a chave de pseudonimização no mesmo repositório ou bucket que os dados.
- Mascarar a tabela de análise, mas não os logs, os dumps de erro ou o HTML de depuração.
- Ignorar o
robots.txte os termos do site porque os dados "já são públicos". O robots.txt diz o que o dono do site permite que os crawlers busquem. - Manter os dados depois do fim do projeto porque ninguém é responsável pela exclusão.
- Supor que valem as regras do seu país quando as pessoas do conjunto de dados moram em outro.
Guia de decisão
| Necessidade | Recomendação |
|---|---|
| Análise de preços, estoque ou dados de produto | Não colete campos de vendedores nem de usuários |
| Análise de texto de avaliações ou comentários | Descarte os campos de autor e mascare dados de contato no texto na ingestão |
| Contar autores recorrentes ou acompanhar uma conta ao longo do tempo | Hash com chave (HMAC) do ID, com a chave guardada separadamente |
| Compartilhar um conjunto de dados com um cliente ou publicá-lo | Agregue e depois verifique grupos pequenos e combinações raras |
| Manter HTML bruto para depuração | Retenção curta, zona restrita, criptografado |
| Dados de contato de pessoas físicas são a finalidade | Pare e busque orientação jurídica antes de coletar |
Perguntas frequentes
Dados públicos obtidos por scraping estão isentos do GDPR?
Não. O GDPR não tem nenhuma exceção geral para dados pessoais disponíveis publicamente. Você ainda precisa de uma base legal, o artigo 5 continua valendo e o artigo 14 trata das informações devidas às pessoas cujos dados você não coletou junto delas.
Um endereço IP é dado pessoal?
Pode ser. O GDPR cita identificadores por via eletrônica no artigo 4.º, ponto 1, e o CCPA menciona o "Internet Protocol address" (endereço IP) entre seus exemplos de identificadores. No scraping, isso pesa sobretudo nos seus próprios logs.
O hash torna os dados anônimos?
Não. Um hash simples de um e-mail ou telefone pode ser revertido calculando o hash de uma lista de palpites. Um hash com uma chave secreta guardada em outro lugar é pseudonimização, que o GDPR continua tratando como dado pessoal.
O que a KVKK diz sobre dados que a própria pessoa tornou públicos?
O artigo 5 permite o tratamento sem consentimento explícito quando a própria pessoa tornou os dados públicos. Os princípios do artigo 4, como finalidade determinada e proporcionalidade, continuam valendo.
Por quanto tempo posso guardar dados pessoais obtidos por scraping?
Só pelo tempo que a finalidade exigir. O artigo 5 do GDPR chama isso de "limitação da conservação", e o artigo 7 da KVKK exige exclusão, destruição ou anonimização quando o motivo do tratamento deixa de existir.
Usar um proxy muda minhas obrigações?
Não. Um proxy encaminha as requisições por outro endereço IP. Ele não muda o que você coleta, onde armazena nem quais leis se aplicam.
Em resumo
Dados pessoais raramente chegam a um conjunto de dados de scraping porque alguém os quis; eles vêm junto com a página. A solução é principalmente de engenharia: defina a finalidade, colete só os campos que a atendem, mascare o que escapa para o texto livre, pseudonimize as chaves com um segredo guardado em outro lugar, criptografe o armazenamento e apague dentro de um prazo. Dados pseudonimizados continuam sendo dados pessoais para o GDPR; anônimo significa que ninguém pode ser identificado por meios razoavelmente prováveis. Para a parte da coleta, veja extração de dados da web: um Proxies residenciais permite escolher país e cidade, um Proxies rotativos distribui as requisições e nossa página de proxies reúne todos os produtos.


