Bir yazılımcı yeni faturalama sistemini test etmek için on bin müşteri kaydına ihtiyaç duyuyor, ama gerçek kayıtların canlı veritabanından çıkmasına izin yok. Bir makine öğrenmesi ekibinin elinde, yakalamak istediği dolandırıcılık örüntüsünden yalnızca birkaç düzine örnek var. Bir yapay zekâ ekibi de, bir dil modeli istendiği anda eğitim örneği yazabildiğine göre web sayfası toplamaya hâlâ gerek olup olmadığını merak ediyor. Üçü de aynı seçeneğe bakıyor: birinin topladığı değil, bir programın ürettiği veriye, yani sentetik veriye.
Bu yazıda sentetik verinin ne olduğunu, nasıl üretilip denetlendiğini, başlıca türlerini ve kullanım alanlarını, neleri yapamadığını (model çöküşü dahil), gerçek web verisiyle nasıl karşılaştırıldığını ve gizlilik açısından ne anlama geldiğini anlatıyoruz.
Sentetik veri nedir?
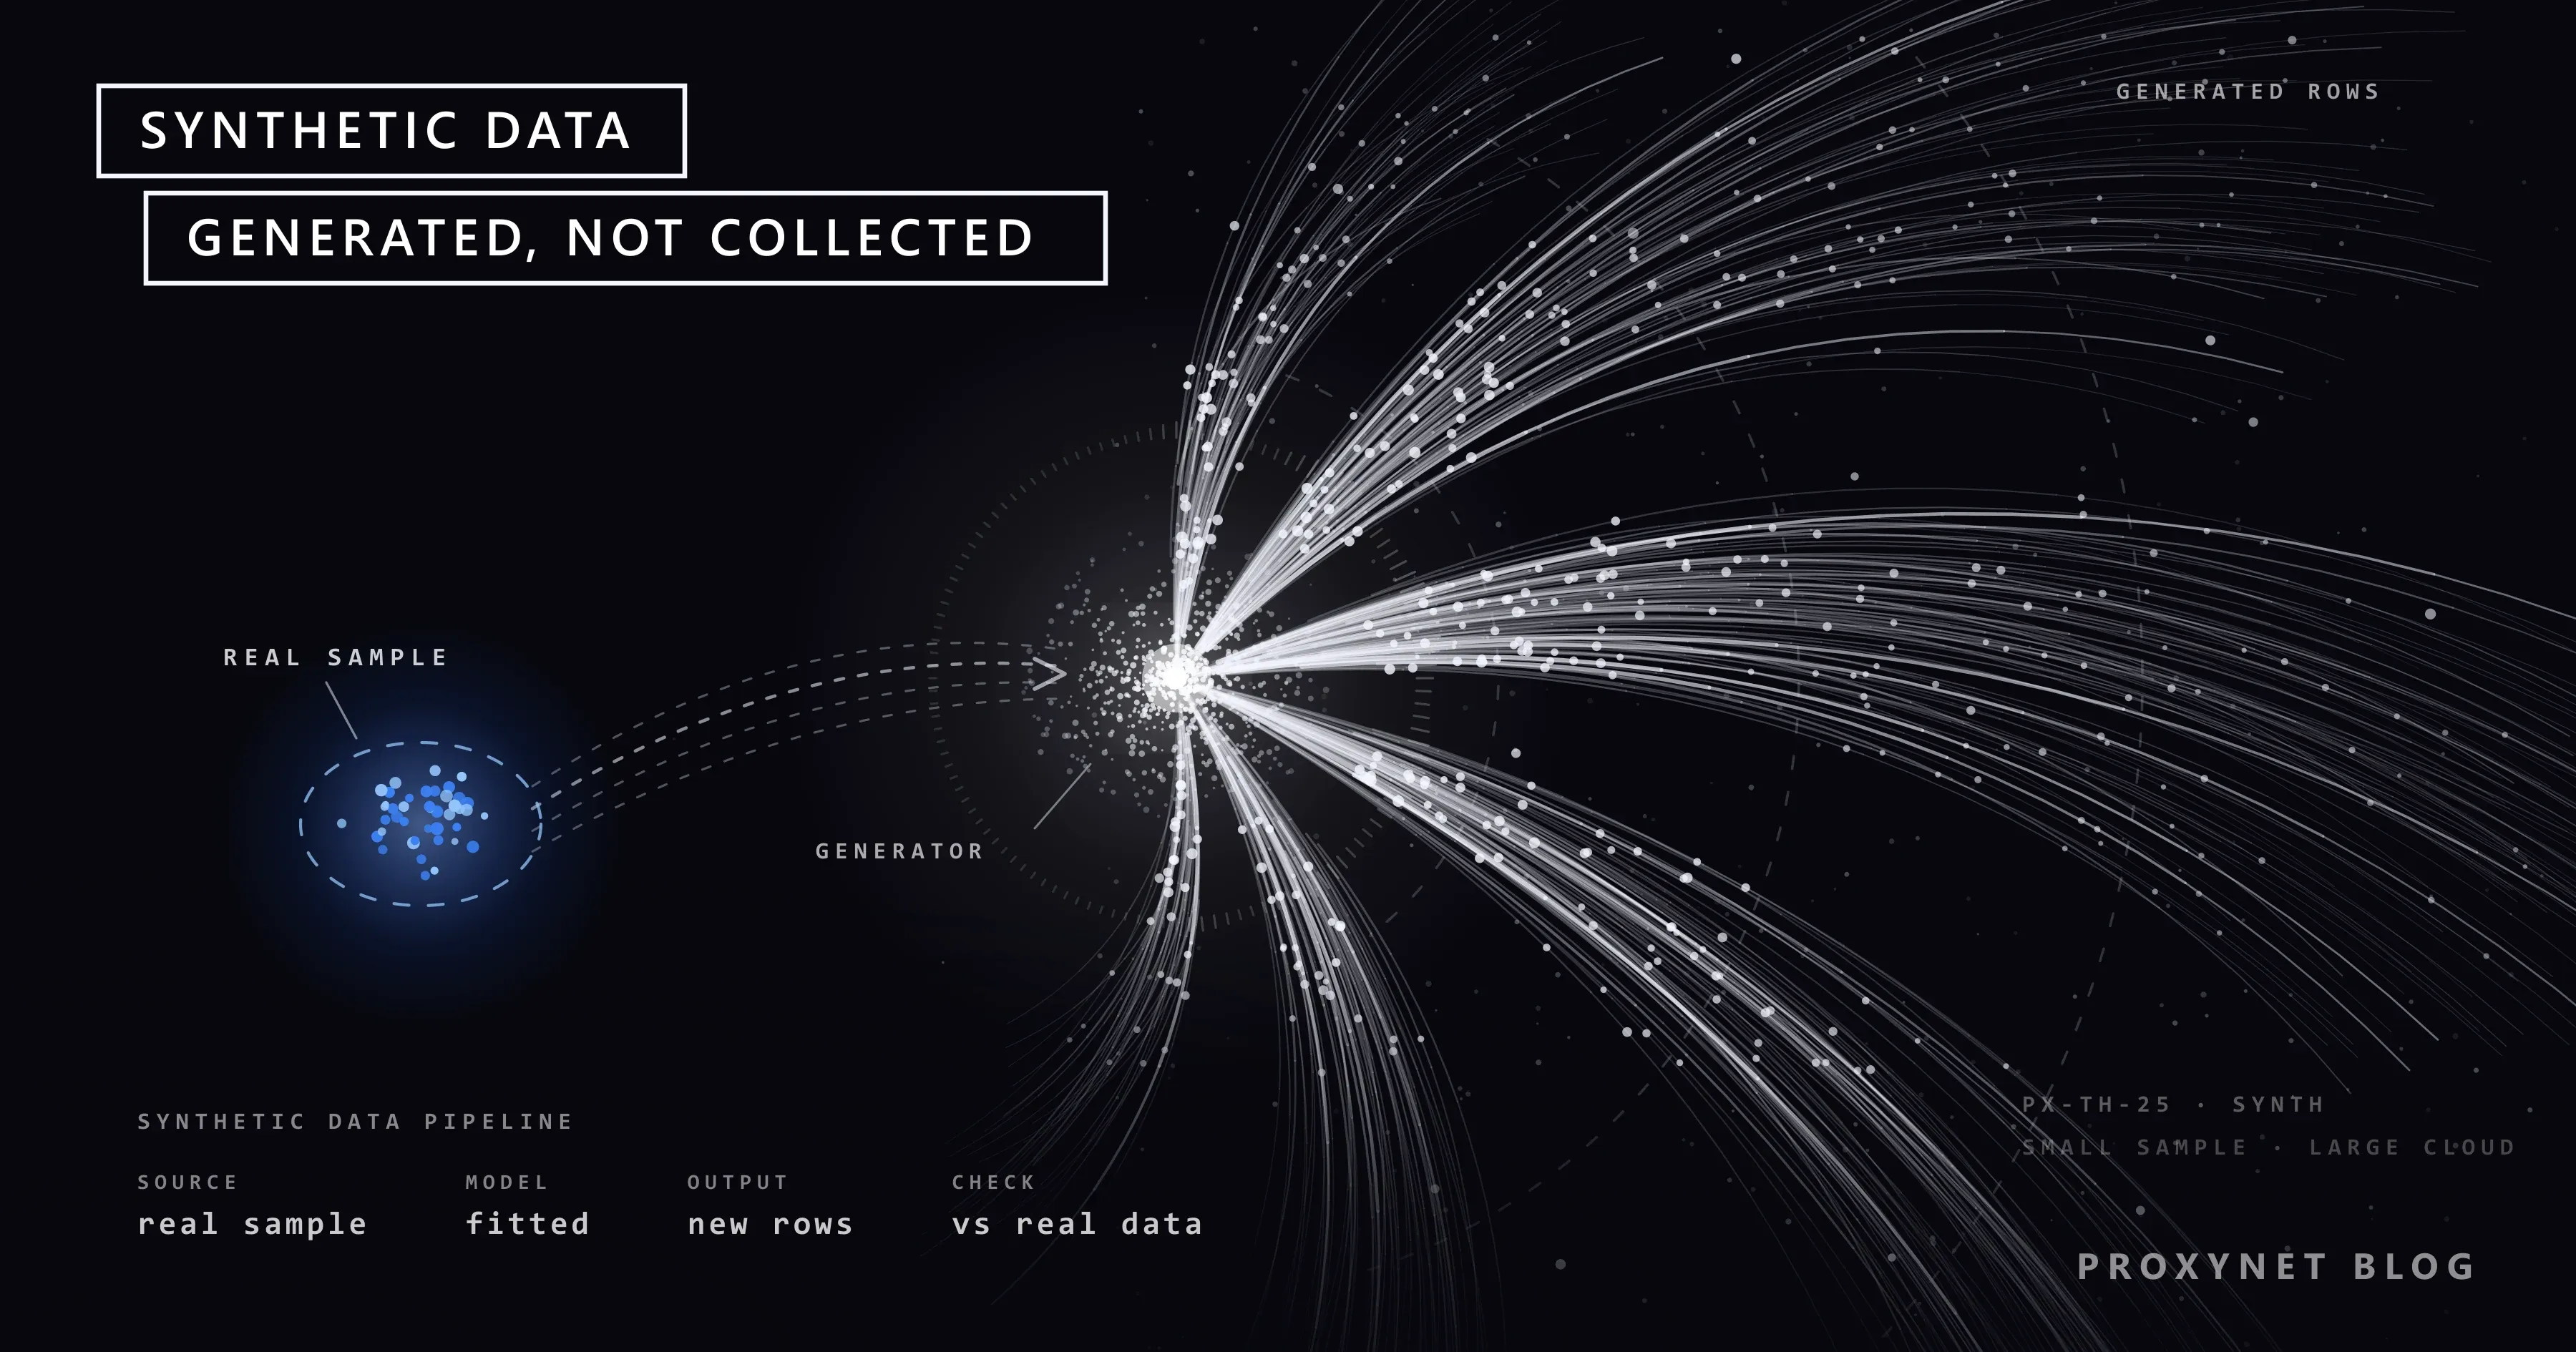
Sentetik veri, gerçek işlemlerden, sensörlerden, kişilerden ya da web sayfalarından toplanmak yerine gerçek veriye benzemesi için bir programla üretilen veridir. ABD'nin standartlar enstitüsü NIST, kimliksizleştirme (de-identification) rehberi SP 800-188'de süreci şöyle tarif eder: tohum veri (seed data) kullanılarak, tohum verinin bazı istatistiksel özelliklerini koruyan yapay veri oluşturulur.
Herkesin kabul ettiği tek bir tanım yoktur. Royal Society'nin hazırlattığı bir derleme çalışması geniş bir tanım önerir: bir veri bilimi görevini çözmek için bu işe özel kurulmuş bir matematiksel model ya da algoritmayla üretilen veri. Uydurma müşteri tabloları da, bir dil modelinin yazdığı yorumlar da, bir 3B simülatörün çizdiği sokak sahneleri de bu tanıma girer. Fikrin kökü 1940'lardaki Monte Carlo simülasyonuna uzanır; üretken yapay zekâ ise onu çok daha yaygın hâle getirdi.
NIST'in rehberi "sentetik" sözcüğünün derecelerini de birbirinden ayırır:
- Kısmen sentetik veri gerçek kayıtları korur, ama alışılmadık bir gelir gibi riskli hücreleri modelden gelen değerlerle ya da gürültüyle değiştirir.
- Tamamen sentetik veri baştan sona bir modelden üretilir; hiçbir satır gerçek bir kayda birebir karşılık gelmez.
- Test verisi bir veri setinin yalnızca yapısını ve değer aralıklarını kopyalar. Yazılım testi içindir ve istatistikleri tutturmaya çalışmaz.
Sentetik veri nasıl üretilir?
Sentetik veri; bir model eğitilerek, kurallar yazılarak ya da bir simülasyon kurularak, bunlardan yeni kayıtlar örneklenerek ve ardından bu kayıtlar gerçek veriyle karşılaştırılarak üretilir. Tipik bir proje yedi adımda ilerler:
- İşi tanımlayın. Verinin neyi desteklemesi gerektiğine karar verin: bir formu test etmek, bir sınıflandırıcı eğitmek, bir tabloyu iş ortağıyla paylaşmak. Hangi özelliklerin korunacağını ve hangilerinden vazgeçilebileceğini bu karar belirler.
- Başlangıç noktasını seçin. Bu ya gerçek bir örnek (tohum veri), ya geçerli posta kodları ve fiyat aralıkları gibi işe özgü kurallar ya da hiç gerçek kayıt gerektirmeyen, sürecin kendisinin simülasyonudur.
- Üreteci seçin. Seçenekler basit kurallar ve rastgele değerlerden, dağılımları ve ilişkileri (korelasyonları) öğrenen istatistiksel modellere, oradan da makine öğrenmesi üreteçlerine uzanır: çekişmeli üretici ağlar (GAN), varyasyonel otokodlayıcılar (VAE), görseller için difüzyon modelleri ve metin için büyük dil modelleri (LLM).
- Üretin. Gerektiği kadar satır, metin ya da görsel örnekleyin ve bunları verinin içinde sentetik olarak işaretleyin. NIST, kimse bir test dosyasını gerçek müşteri verisi sanmasın diye "FIRSTNAME1 LASTNAME1" gibi açıkça yapay değerler kullanmayı önerir.
- Gerçek veriyle doğrulayın. Dağılımları ve korelasyonları kaynakla karşılaştırın (aslına uygunluk, fidelity); sentetik setle eğitilen bir modelin, ayrı tutulmuş gerçek veride de iyi sonuç verip vermediğine bakın (fayda, utility).
- Gizliliği denetleyin. Gerçek kayıtlara fazla yakın düşen üretilmiş kayıtları arayın ve aykırı değerlerin bir kişiye kadar izlenip izlenemeyeceğini test edin.
- Belgeleyin ve gerçek bir test seti ayırın. Verinin nasıl üretildiğini kayda geçirin; son değerlendirme için gerçek veriyi bir kenarda tutun.
Verinin güvenilir olup olmadığına doğrulama adımı karar verir. ABD Nüfus Sayım Bürosu (Census Bureau), vergi ve sosyal yardım kayıtlarıyla eşleştirilmiş bir hane halkı anketinin sentetik sürümü olan SIPP Synthetic Beta'yı yayımlar. Araştırmacılar analizlerini sentetik dosya üzerinde hazırlar; ardından büro çalışanları aynı programları gizli veride çalıştırır ve çıktıyı yayımlamadan önce inceler.
Sentetik verinin türleri nelerdir?
Başlıca türler, verinin biçimine ve nasıl üretildiğine göre ayrılır:
| Tür | Nasıl üretilir? | Tipik kullanım | Dikkat edilecek nokta |
|---|---|---|---|
| Tablo kayıtları | Tablo üzerinde eğitilen istatistiksel model, GAN ya da VAE | Veri paylaşımı, analitik, dolandırıcılık modelleri | Bozulan korelasyonlar, kopyalanan aykırı değerler |
| Metin | Bir dil modeli verilen prompt'lardan örnek yazar | Sohbet botlarını ve sınıflandırıcıları eğitme, test etme | Bilgi hataları, kendini tekrar eden anlatım |
| Görsel ve video | 3B simülasyon ya da görsel üreteçleri | Sürücüsüz araçlar, robotik, kusur tespiti | Simülasyon ile gerçek sahne arasındaki fark |
| Yazılım test verisi | Kurallar ve sahte değer üreteçleri | Yazılım testi, demolar, yük testleri | Gerçek veri sanılması |
"Gerçek web verisinin yerini tutar mı?" sorusu en çok metin için sorulur. Yayımlanmış çalışmalarda üretilmiş metin genellikle filtrelenmiş gerçek metnin yerine değil, yanına konur. Microsoft Research'ün 2023 tarihli "Textbooks Are All You Need" makalesinde küçük bir kod modeli olan phi-1, "ders kitabı kalitesinde" seçilmiş yaklaşık 6 milyar token (kelime parçası) tutarında web verisiyle ve GPT-3.5'e ürettirilmiş yaklaşık 1 milyar token'lık ders kitabı ve alıştırmayla eğitildi.
Şirketler sentetik veriyi neden kullanır?
Şirketler, gerçek veri az, hassas, etiketlemesi pahalı ya da henüz hiç yokken sentetik veriye başvurur:
- Gizlilik. Bir banka ya da hastane, yazılımcılara ve tedarikçilere müşteri ya da hasta kayıtları yerine bir tablonun sentetik kopyasını verebilir; aşağıda anlatılan çekinceler yine geçerlidir.
- Nadir durumlar. Dolandırıcılık, makine arızaları ve tehlikeli trafik durumları gerçek veride seyrek görülür; daha fazla örnek üretmek, modelin bunları öğrenmesine yardım eder.
- Yazılım testi. Yeni bir uygulamanın, henüz kullanıcısı yokken gerçekçi görünen hesaplara ve siparişlere ihtiyacı vardır. Test verisinin geçerli olması, yani doğru biçim ve aralıklarda olması yeter; istatistiksel olarak aslına uygun olması gerekmez.
- Etiketleme maliyeti. Bir simülatör, sahnesindeki her aracın ve yayanın nerede olduğunu zaten bilir; etiketler kendiliğinden çıkar. Gerçek fotoğrafları elle etiketlemek ise yavaştır.
- Dengeleme. Üretilmiş örnekler az temsil edilen sınıfları tamamlayabilir; ama bu yalnızca üretecin kendisi önyargılı değilse işe yarar.
Sentetik verinin sınırları nelerdir?
Sentetik veri, kaynağında hiç bulunmayan bilgiyi ekleyemez: üreteç, eğitim verisindeki, kurallarındaki ya da simülasyonundaki örüntüleri yeniden üretir ve ötesine geçmez. NIST'in rehberi bunu açıkça söyler: tamamen sentetik veri, kullanıcıya üretildiği modelde bulunandan fazla bilgi veremez.
Bu sınır birkaç biçimde kendini gösterir:
- Yeni bilgi yok. Geçen yılın fiyatlarıyla eğitilmiş bir üreteç, geçen yıla uyan makul fiyatlar üretir; bu haftaki indirimden ya da dün satışa çıkan üründen habersizdir.
- Kaybolan aykırı değerler. Üreteç nadir ve uç değerleri ya törpüler, böylece veri gerçekte olduğundan daha "ortalama" görünür, ya da onları gerçek kaydı ele verecek kadar yakın kopyalar.
- Kopyalanan önyargı. Kaynakta bir grup az temsil ediliyor ya da haksız muamele görüyorsa sentetik veri bunu devralır, üstelik tarafsız veriymiş gibi gösterebilir.
- Akıcı hatalar. LLM'lerin ürettiği örnekler hem kendinden emin hem yanlış olabilir. Akıcı okunan bir metnin bilgileri de kontrol edilmelidir.
- Yanıltıcı bulgular. Sentetik veride görülen bir örüntü üretecin kendi izi olabilir; NIST'in analistlere bulguları özgün veride doğrulamalarını önermesinin nedeni budur.
Model çöküşü nedir?
Model çöküşü (model collapse), üretken modeller nesilden nesile önceki modellerin ürettiği içerikle eğitildiğinde ortaya çıkan kalite kaybıdır. Shumailov ve arkadaşları bunu 2024 tarihli Nature makalesinde anlattı. Makaleye göre modellerin ürettiği içeriğin eğitimde gelişigüzel kullanılması, ortaya çıkan modellerde geri dönüşü olmayan kusurlara yol açıyor; özgün içerik dağılımının kuyrukları kayboluyor. Araştırmacılar etkiyi dil modellerinde ve iki farklı üretken model türünde gösterdi.
Dil modeli deneyinde küçük bir modelin her nesli, bir önceki neslin yazdığı metinle ince ayardan geçirildi. Özgün veriden hiçbir şey saklanmadığında modelin asıl görevdeki başarısı düştü; özgün, insan yazımı verinin %10'unun korunduğu düzende ise bozulma küçük kaldı. Buradan çıkan ders, her sentetik örneğin zararlı olduğu değil; modeller yalnızca kendi çıktılarıyla beslendiğinde önce nadir durumların, yani dağılımın kuyruklarının kaybolduğudur.
Yazarlar, yapay zekânın ürettiği içerik yaygınlaşmadan önce internetten taranmış verilere erişim olmadan yeni modelleri eğitmenin zorlaşabileceği uyarısını da yapıyor. Common Crawl gibi açık tarama arşivleri herkese açık sayfaların tarihli kopyalarını saklar; önemlerinin bir nedeni de budur.
Sentetik veri gerçek web verisiyle nasıl karşılaştırılır?
Gerçek web verisi, herkese açık bir sayfanın belirli bir anda gerçekten ne gösterdiğini kaydeder; sentetik veri ise bir modelin ne beklediğini. Fark en çok güncellikte ve bir modelin ölçüldüğü doğrulanmış gerçek değerlerde (ground truth) ortaya çıkar:
| Soru | Sentetik veri | Herkese açık gerçek web verisi |
|---|---|---|
| Ne kadar güncel? | Kaynağı kadar eski | Son toplama kadar yeni |
| Doğrulanmış gerçek değer mi? | Hayır, bir modeli yansıtır | Evet, sayfanın gösterdiği şey için |
| Yeni fiyat, ürün, olay | Yer almaz | Yayımlanınca yer alır |
| İstendiğinde nadir durum | Evet | Yalnızca gerçekten yaşandıysa |
| Kişisel veri riski | İyi yapılırsa düşük, sıfır değil | Var; toplarken en aza indirin |
| Konuma özgü ayrıntı | Yalnızca kaynakta varsa | Nereden topladığınıza bağlı |
Yapay zekâ ekipleri neden hâlâ gerçek web verisi topluyor?
Yapay zekâ ekipleri herkese açık gerçek web verisini hâlâ topluyor, çünkü değerlendirme, kaynağa dayandırma ve güncellik, bir üretecin uyduramayacağı bilgilere ihtiyaç duyar.
Değerlendirme. Royal Society'nin hazırlattığı derleme, gerçek dünyada kullanılacak araçların gerçek veriyle değerlendirilmesini, gerekirse de bu veriyle ince ayardan geçirilmesini önerir. Sentetik bir test seti çoğu zaman yalnızca modelin üreteci ne kadar iyi taklit ettiğini ölçer.
Kaynağa dayandırma (grounding). Pek çok yapay zekâ ürünü RAG (getirmeyle zenginleştirilmiş üretim) yöntemiyle cevap verir: soru geldiği anda güncel belgeleri getirir ve modelin cevabı bu belgelere dayandırmasını sağlar. Bu ancak belgeler gerçek ve güncelse işe yarar; RAG Nedir? Web Verisini Temiz Markdown Parçalarına Çevirme yazısında anlattığımız veri hattı da budur.
Güncellik ve tohum veri. Yeni ürünler, fiyatlar ve düzenlemeler önce web'de görünür; sentetik metin üreten hatlar bile genellikle gerçek örneklerle işe başlar. Model çöküşü araştırması, karışımda neden bir miktar gerçek verinin kalması gerektiğini gösteriyor.
Sentetik veri anonim midir?
Sentetik veri kendiliğinden anonim değildir: kişisel verilerden üretildiyse o verideki kişiler hakkında hâlâ bilgi açığa çıkarabilir. Royal Society'nin hazırlattığı derleme, sentetik verinin doğası gereği mahremiyeti koruduğu inancını "yaygın bir yanılgı" olarak niteler ve üreteçlerin eğitim kayıtlarını ezberleyip yeniden üretebildiğini belirtir.
NIST de aynı noktaya dikkat çeker: hem modeller hem de ürettikleri sentetik veri, yeniden kimliklendirilebilecek kişisel bilgiler sızdırabilir. Yaygın çözümlerden biri diferansiyel gizliliktir (differential privacy): tek bir kişinin kaydının sonucu ne kadar değiştirebileceğini sınırlayan matematiksel bir yöntem. Bedeli ise bir miktar doğruluk kaybıdır.
Hukuki bakış da aynı mantığı izler. AB'deki GDPR'a ve Türkiye'deki KVKK'ya göre veri, ancak artık kimliği belirli ya da belirlenebilir bir kişiyle ilişkilendirilemiyorsa anonim sayılır; müşteri kayıtlarından bir üreteç kurmak da başlı başına kişisel veri işlemektir. Kaynak veriniz web scraping (veri kazıma) ile toplanmış sayfalardan geliyorsa maskeleme, takma adlandırma ve anonim hâle getirme arasındaki farkı Kazınan Verilerde Kişisel Veri (PII) Nasıl Yönetilir? yazısında anlattık.
Gerçek veri gerektiğinde proxy'ler nerede devreye girer?
Bir modelin fiyatlar, ilanlar ya da iş ilanları gibi konuma göre değişen, gerçek ve güncel herkese açık verilere dayanması ya da bu verilerle test edilmesi gerekiyorsa sentetik veri bunu sağlayamaz; verinin doğru yerden toplanması gerekir. Birçok site, ziyaretçinin IP adresinin bağlı olduğu ülkeye göre farklı fiyat, para birimi, stok ve dil gösterir; tek bir ofisten yapılan toplama bu yüzden yalnızca bir sürümü görür.
Residential Proxy kullandığınızda her istek, seçtiğiniz ülke ve şehirdeki bir ev bağlantısı üzerinden gider; böylece sayfa, oradaki yerel ziyaretçilere gösterdiğini döndürür. Yalnızca herkese açık sayfaları toplayın, robots.txt'ye ve sitenin kullanım şartlarına uyun, istek hızını düşük tutun, varsa resmî API'yi kullanın ve ihtiyacınız olmayan kişisel verileri dışarıda bırakın.
Toplama işini kendiniz yürütmek istemiyorsanız Web Scraping API'miz üzerinden sunduğumuz yönetilen sayfa çıkarma hizmeti için satış ekibimizle görüşebilirsiniz.
Sık yapılan hatalar
- Sentetik veriyi kendiliğinden anonim saymak. Veriyi sızıntıya karşı test edin ya da matematiksel güvence veren bir yöntem kullanın.
- Göz kararı doğrulamak. "Gerçek gibi görünüyor" demek korelasyonlar, nadir durumlar ya da fayda hakkında hiçbir şey söylemez.
- Son modeli yalnızca sentetik veriyle test etmek. Ayrı tutulmuş gerçek bir test seti saklayın.
- Kayıtları işaretlememek. Gerçek gibi görünen sentetik satırlar raporlara gerçekmiş gibi girer.
- Modeli döngü hâlinde kendi çıktısıyla eğitmek. Taze gerçek veri eklenmeyen her nesil, nadir durumların biraz daha fazlasını kaybeder.
- Üretecin yakın tarihli olayları bilmesini beklemek. Kaynak toplandıktan sonra olan her şey eksiktir.
- Kaynaktaki önyargıyı görmezden gelmek. Üreteç onu kopyalar ve temiz veriymiş gibi sunar.
Karar rehberi
| İhtiyaç | Kullanın |
|---|---|
| Uygulamayı yayına çıkmadan test etmek | Açıkça işaretlenmiş, kurallara dayalı test verisi |
| Müşteri tablosunu bir tedarikçiyle paylaşmak | Gizlilik testinden geçmiş sentetik veri ve hukuki inceleme |
| Nadir durumlar için daha fazla örnek | Gerçek vakalarla değerlendirilen sentetik çoğaltma |
| Bir sohbet botuna görev biçimini öğretmek | İnsanların kontrol ettiği, LLM'e ürettirilmiş örnekler |
| Güncel fiyatlar, ilanlar ya da iş ilanları | Siteleri yormayan bir hızla toplanan gerçek web verisi |
| Yakın tarihli olaylar hakkında cevaplar | Güncel gerçek kaynaklardan getirme (retrieval) |
| Son model değerlendirmesi | Ayrı tutulmuş gerçek bir test seti |
Sıkça sorulan sorular
Sentetik veriye örnek nedir?
Yaşları, şehirleri ve harcama tutarları gerçek bir müşteri veritabanıyla aynı örüntüleri izleyen 10.000 uydurma müşteriden oluşan bir tablo sentetik veridir. Bir sınıflandırıcıyı eğitmek için dil modeline yazdırılan ürün yorumları ve bir sürüş simülatörünün her aracı önceden etiketlenmiş olarak çizdiği yol sahneleri de öyle.
Sentetik veri güvenilir midir?
Doğrulandığı iş için güvenilirdir, ötesi için değil. Dolandırıcılık modeli eğitmek gibi bir görevde aslına uygunluk ve fayda testlerinden geçen veri, nadir olayları tahmin etmek gibi başka bir görevde yine de yanıltabilir. Sentetik veriden çıkan bulguları hipotez olarak görün ve gerçek veride doğrulayın.
Sentetik veri ile mock veri arasındaki fark nedir?
Mock ya da dummy (sahte) verinin yalnızca geçerli görünmesi yeter: doğru biçimler, makul aralıklar, gerçek kişi yok. Daha dar anlamıyla sentetik veri ise gerçek bir veri setinin istatistiksel örüntülerini de korur; böylece onunla yapılan analiz ya da model eğitimi benzer sonuçlar verir. Mock veri yazılım testlerine, istatistiksel olarak aslına uygun sentetik veri ise analitiğe ve makine öğrenmesine uygundur.
Yapay zekâ modelleri yalnızca sentetik veriyle eğitilebilir mi?
Bazı dar kapsamlı modeller, özellikle robotik gibi simülasyonun ağır bastığı alanlarda eğitilebilir; ama büyük dil modelleri hâlâ gerçek metne dayanır. Yayımlanmış çalışmalar phi-1'de olduğu gibi ikisini karıştırır; model çöküşü araştırması da nesilden nesile yalnızca üretilmiş metinle eğitimin kaliteyi düşürdüğünü gösterir.
Pazar araştırmasında sentetik veri nedir?
Pazar araştırmasında sentetik veri çoğu zaman "sentetik katılımcı" anlamına gelir: bir dil modeli, anket sorularını belirli bir müşteri tipinin vereceğini tahmin ettiği biçimde cevaplar. Bu, bir anketi taslak hâline getirmeye ve denemeye yardım edebilir; ama gerçek insanların bugün ne düşündüğünü ya da yeni bir şeye nasıl tepki verdiğini söyleyemez. Bu yüzden kararlar hâlâ gerçek anketlere ve rakip fiyatları ya da ilanlar gibi gerçek pazar verilerine dayanır.
Sentetik verinin kalitesi nasıl ölçülür?
Kalite üç eksende ölçülür: aslına uygunluk (dağılımların ve korelasyonların gerçek veriye ne kadar yakın olduğu), fayda (onunla eğitilen bir modelin gerçek veride iyi sonuç verip vermediği) ve gizlilik (ondan gerçek kayıtların çıkarılıp çıkarılamayacağı). Bir eksende alınan güçlü sonuç çoğu zaman başka bir eksende bedel ister; hedefleri kullanım amacına göre belirleyin.
Özet
Sentetik veri, gerçek olayları ya da kişileri kaydetmeden gerçek veriye benzeyecek biçimde bir model, kurallar ya da bir simülasyonla üretilen veridir. Gerçek veriyle doğrulanması ve gizlilik sızıntılarına karşı denetlenmesi şartıyla yazılım testlerinde, daha güvenli veri paylaşımında, nadir durumlarda ve eğitim örneği oluşturmakta işe yarar. Gerçek verinin yerini tutamaz: kaynağında olmayan hiçbir şeyi içermez, sonradan olan her şeyi kaçırır, önyargıyı kopyalar ve kendi çıktısıyla beslenen modelleri bozar. Fiyatlar, ilanlar ve iş ilanları gibi güncel ve konuma özgü bilgilerin kaynağı hâlâ herkese açık gerçek web'dir; bu veri siteleri yormayan bir hızla ve doğru ülkeden toplanmalıdır.