Ein Entwickler braucht zehntausend Kundendatensätze, um ein neues Abrechnungssystem zu testen, doch die echten Datensätze dürfen die Produktionsdatenbank nicht verlassen. Ein Team für maschinelles Lernen hat nur ein paar Dutzend Beispiele für das Betrugsmuster, das es erkennen soll. Ein KI-Team fragt sich, ob es überhaupt noch Webseiten sammeln muss, wenn ein Sprachmodell Trainingsbeispiele auf Abruf schreibt. Alle drei denken über dieselbe Möglichkeit nach: synthetische Daten, also Daten, die ein Programm erzeugt, statt dass jemand sie erhoben hat.
Dieser Beitrag erklärt, was synthetische Daten sind, wie sie erzeugt und geprüft werden, welche Arten und Einsatzzwecke es gibt, was sie nicht leisten können (Modellkollaps eingeschlossen), wie sie sich zu echten Webdaten verhalten und was sie für den Datenschutz bedeuten.
Was sind synthetische Daten?
Synthetische Daten sind Daten, die ein Programm so erzeugt, dass sie echten Daten ähneln, statt sie aus realen Transaktionen, Sensoren, bei Personen oder auf Webseiten zu erfassen. Das NIST, das Normungsinstitut der USA, beschreibt den Vorgang in seinem Leitfaden zur De-Identifizierung SP 800-188: Aus Ausgangsdaten (Seed Data) werden künstliche Daten erzeugt, die einige statistische Merkmale dieser Ausgangsdaten behalten.
Eine allgemein anerkannte Definition gibt es nicht. Eine von der Royal Society in Auftrag gegebene Übersichtsarbeit schlägt eine weite vor: Daten, die mit einem eigens dafür gebauten mathematischen Modell oder Algorithmus erzeugt werden, um eine Data-Science-Aufgabe zu lösen. Darunter fallen erfundene Kundentabellen ebenso wie Bewertungen aus einem Sprachmodell und Straßenszenen aus einem 3D-Simulator. Die Idee reicht bis zur Monte-Carlo-Simulation der 1940er-Jahre zurück; generative KI hat sie weit verbreitet.
Der NIST-Leitfaden unterscheidet außerdem Grade von „synthetisch“:
- Teilsynthetische Daten behalten die echten Datensätze, ersetzen aber riskante Zellen, etwa ein ungewöhnliches Einkommen, durch modellierte Werte oder Rauschen.
- Vollsynthetische Daten werden vollständig aus einem Modell erzeugt, sodass keine Zeile eins zu eins einem echten Datensatz entspricht.
- Testdaten übernehmen nur die Struktur und die Wertebereiche eines Datensatzes. Sie dienen Softwaretests und sollen die Statistik des Originals gar nicht nachbilden.
Wie werden synthetische Daten erzeugt?
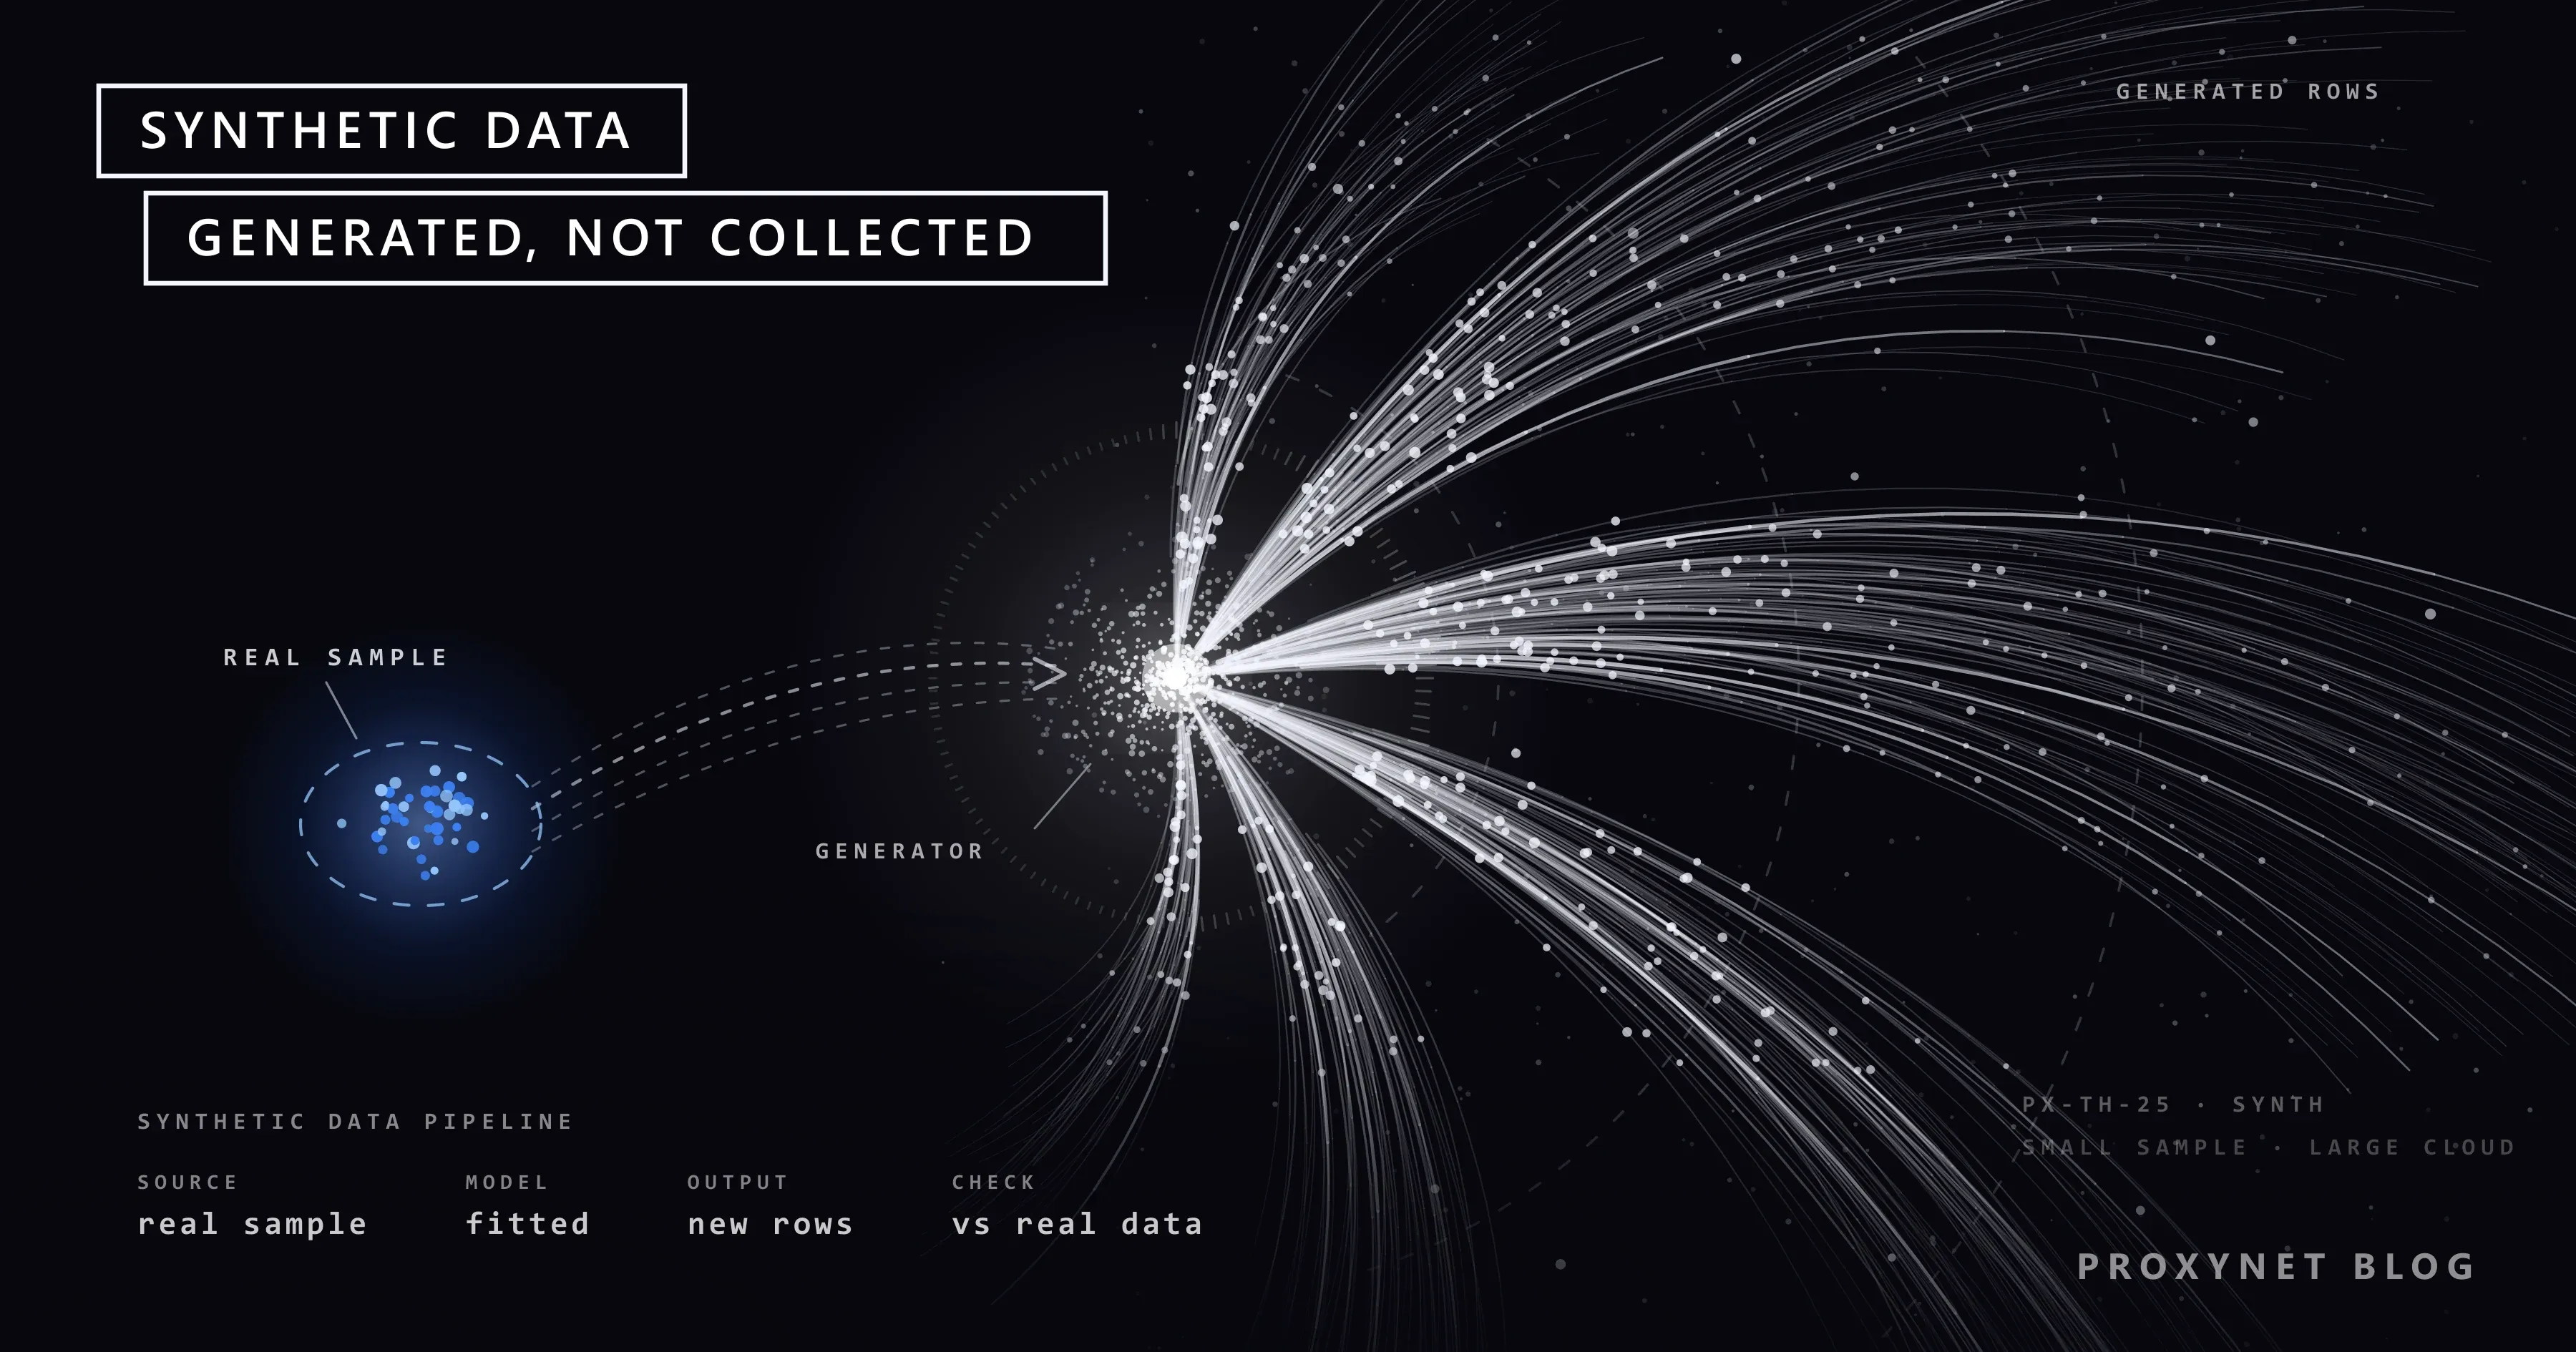
Synthetische Daten entstehen, indem man ein Modell anpasst, Regeln schreibt oder eine Simulation baut, daraus neue Datensätze zieht und diese anschließend mit echten Daten abgleicht. Ein typisches Projekt läuft in sieben Schritten ab:
- Die Aufgabe festlegen. Entscheiden Sie, was die Daten leisten müssen: ein Formular testen, einen Klassifikator trainieren, eine Tabelle mit einem Partner teilen. Davon hängt ab, welche Eigenschaften erhalten bleiben müssen und welche wegfallen dürfen.
- Den Ausgangspunkt wählen. Das ist eine echte Stichprobe (die Ausgangsdaten), ein Satz fachlicher Regeln wie gültige Postleitzahlen und Preisspannen oder eine Simulation des Prozesses selbst, die gar keine echten Datensätze braucht.
- Den Generator wählen. Die Optionen reichen von einfachen Regeln und Zufallswerten über statistische Modelle, die Verteilungen und Korrelationen lernen, bis zu Generatoren aus dem maschinellen Lernen: Generative Adversarial Networks (GANs), Variational Autoencoder (VAEs), Diffusionsmodelle für Bilder und große Sprachmodelle (LLMs) für Text.
- Erzeugen. Ziehen Sie so viele Zeilen, Texte oder Bilder wie nötig und kennzeichnen Sie sie in den Daten selbst als synthetisch. Das NIST empfiehlt offensichtlich künstliche Werte wie „FIRSTNAME1 LASTNAME1“, damit niemand eine Testdatei für echte Kundendaten hält.
- Mit echten Daten validieren. Vergleichen Sie Verteilungen und Korrelationen mit der Quelle (Wiedergabetreue, Fidelity) und prüfen Sie, ob ein mit dem synthetischen Satz trainiertes Modell auf echten, zurückgehaltenen Daten noch funktioniert (Nutzen, Utility).
- Den Datenschutz prüfen. Suchen Sie nach erzeugten Datensätzen, die echten zu nahe kommen, und testen Sie, ob sich Ausreißer auf eine Person zurückführen lassen.
- Dokumentieren und einen echten Testdatensatz zurückhalten. Halten Sie fest, wie die Daten entstanden sind, und legen Sie echte Daten für die abschließende Bewertung beiseite.
Ob man den Daten trauen kann, entscheidet die Validierung. Das US Census Bureau, die Statistikbehörde der USA, veröffentlicht SIPP Synthetic Beta, eine synthetische Fassung einer Haushaltsbefragung, die mit Steuer- und Sozialleistungsdaten verknüpft ist. Forschende entwickeln ihre Auswertung an der synthetischen Datei; danach lassen Mitarbeitende der Behörde dieselben Programme auf den vertraulichen Daten laufen und prüfen die Ergebnisse, bevor sie freigegeben werden.
Welche Arten synthetischer Daten gibt es?
Die wichtigsten Arten unterscheiden sich nach der Form der Daten und nach der Art ihrer Erzeugung:
| Art | Wie sie entstehen | Typischer Einsatz | Worauf achten |
|---|---|---|---|
| Tabellarische Datensätze | Statistisches Modell, GAN oder VAE, an eine Tabelle angepasst | Datenweitergabe, Analysen, Betrugsmodelle | Zerstörte Korrelationen, kopierte Ausreißer |
| Text | Ein Sprachmodell schreibt Beispiele nach Prompts | Training und Test von Chatbots, Klassifikatoren | Sachfehler, sich wiederholende Formulierungen |
| Bilder und Video | 3D-Simulation oder Bildgeneratoren | Autonomes Fahren, Robotik, Fehlererkennung | Lücke zwischen simulierten und realen Szenen |
| Software-Testdaten | Regeln und Generatoren für Fantasiewerte | Qualitätssicherung, Demos, Lasttests | Verwechslung mit echten Daten |
Bei Text stellt sich die Frage „Ersetzt das echte Webdaten?“ am häufigsten. In veröffentlichten Arbeiten wird generierter Text meist zu gefiltertem echtem Text hinzugefügt, statt ihn zu ersetzen. Im Paper „Textbooks Are All You Need“ von Microsoft Research aus dem Jahr 2023 wurde ein kleines Code-Modell namens phi-1 mit rund 6 Milliarden Tokens (Wortteilen) an Webdaten in „Lehrbuchqualität“ trainiert, ergänzt um rund 1 Milliarde Tokens an Lehrbüchern und Übungen, die mit GPT-3.5 erzeugt wurden.
Warum setzen Unternehmen synthetische Daten ein?
Unternehmen greifen zu synthetischen Daten, wenn echte Daten knapp oder sensibel sind, ihre Annotation teuer ist oder es sie noch gar nicht gibt:
- Datenschutz. Eine Bank oder ein Krankenhaus kann Entwicklern und Dienstleistern statt Kunden- oder Patientendaten eine synthetische Kopie einer Tabelle geben, mit den weiter unten beschriebenen Einschränkungen.
- Seltene Fälle. Betrug, Maschinenausfälle und gefährliche Verkehrssituationen kommen in echten Daten selten vor; zusätzlich erzeugte Beispiele helfen einem Modell, sie zu lernen.
- Softwaretests. Eine neue App braucht realistisch wirkende Konten und Bestellungen, bevor sie Nutzer hat. Testdaten müssen nur gültig sein, also die richtigen Formate und Wertebereiche haben, nicht statistisch getreu.
- Annotationskosten. Ein Simulator weiß bereits, wo jedes Auto und jeder Fußgänger in seiner Szene steht, die Labels gibt es also gratis; echte Fotos von Hand zu annotieren dauert lange.
- Ausgleich. Erzeugte Beispiele können unterrepräsentierte Klassen auffüllen. Das hilft allerdings nur, wenn der Generator selbst nicht verzerrt ist.
Wo liegen die Grenzen synthetischer Daten?
Synthetische Daten können keine Information hinzufügen, die ihre Quelle nie hatte: Ein Generator gibt Muster aus seinen Trainingsdaten, Regeln oder seiner Simulation wieder und nichts darüber hinaus. Der NIST-Leitfaden sagt es direkt: Vollsynthetische Daten können dem Nutzer nicht mehr Information liefern als das Modell, aus dem sie stammen.
Das zeigt sich auf mehrere Arten:
- Keine neuen Fakten. Ein Generator, der mit den Preisen des Vorjahres trainiert wurde, erzeugt plausible Vorjahrespreise; von der Preissenkung dieser Woche oder dem gestrigen Produktstart weiß er nichts.
- Verlorene Ausreißer. Ein Generator glättet seltene Extremwerte entweder weg, sodass die Daten durchschnittlicher wirken als die Wirklichkeit, oder er kopiert sie so genau, dass der echte Datensatz offenliegt.
- Übernommene Verzerrung. Ist eine Gruppe in der Quelle unterrepräsentiert oder wird sie unfair behandelt, erben die synthetischen Daten das und können es wie neutrale Daten aussehen lassen.
- Flüssige Fehler. Von LLMs erzeugte Beispiele können selbstsicher und zugleich falsch sein. Auch Text, der sich gut liest, braucht einen Faktencheck.
- Scheinbare Entdeckungen. Ein Muster in synthetischen Daten kann ein Artefakt des Generators sein. Deshalb rät das NIST Analysten, Befunde an den Originaldaten zu bestätigen.
Was ist Modellkollaps?
Modellkollaps ist der Qualitätsverlust, der auftritt, wenn generative Modelle Generation um Generation mit Inhalten trainiert werden, die frühere Modelle erzeugt haben. Shumailov und Kollegen haben ihn in einem Nature-Artikel von 2024 beschrieben. Laut dem Artikel führt der wahllose Einsatz modellgenerierter Inhalte im Training zu bleibenden Schäden an den so entstandenen Modellen: Die Randbereiche (Tails) der ursprünglichen Verteilung verschwinden. Die Autoren zeigten den Effekt bei Sprachmodellen und bei zwei weiteren Arten generativer Modelle.
Im Sprachmodell-Experiment wurde jede Generation eines kleinen Modells mit Text der jeweils vorherigen Generation feinabgestimmt. Ohne erhaltene Originaldaten sank die Leistung bei der ursprünglichen Aufgabe; in einer Variante, die 10 % der ursprünglichen, von Menschen geschriebenen Daten behielt, blieb die Verschlechterung gering. Die Lehre lautet nicht, dass jedes synthetische Beispiel schadet, sondern dass die seltenen Fälle, also die Randbereiche, zuerst verschwinden, wenn Modelle nur noch ihre eigene Ausgabe verarbeiten.
Die Autoren warnen außerdem, dass das Training neuer Modelle schwieriger werden könnte, wenn der Zugang zu Daten fehlt, die vor der massenhaften Verbreitung KI-generierter Inhalte im Internet gesammelt wurden. Offene Crawl-Archive wie Common Crawl bewahren datierte Kopien öffentlicher Seiten auf, und das ist ein Grund, warum sie wichtig sind.
Wie schneiden synthetische Daten im Vergleich zu echten Webdaten ab?
Echte Webdaten halten fest, was eine öffentliche Seite zu einem bestimmten Zeitpunkt tatsächlich gezeigt hat; synthetische Daten halten fest, was ein Modell erwartet. Der Unterschied zählt vor allem bei der Aktualität und bei der Ground Truth, also den geprüften realen Werten, an denen ein Modell gemessen wird:
| Frage | Synthetische Daten | Echte öffentliche Webdaten |
|---|---|---|
| Wie aktuell? | So alt wie ihre Quelle | So neu wie die letzte Erhebung |
| Ground Truth? | Nein, sie spiegeln ein Modell | Ja, für das, was die Seite zeigte |
| Neue Preise, Produkte, Ereignisse | Nicht enthalten | Enthalten, sobald veröffentlicht |
| Seltene Fälle auf Abruf | Ja | Nur, wenn sie vorkamen |
| Risiko personenbezogener Daten | Geringer, wenn gut gemacht, nicht null | Vorhanden; bei der Erhebung minimieren |
| Standortbezogene Details | Nur, wenn die Quelle sie hatte | Je nachdem, von wo Sie erheben |
Warum sammeln KI-Teams weiterhin echte Webdaten?
KI-Teams sammeln weiterhin echte öffentliche Webdaten, weil Evaluierung, Grounding und Aktualität Fakten brauchen, die ein Generator nicht erfinden kann.
Evaluierung. Die von der Royal Society in Auftrag gegebene Übersichtsarbeit empfiehlt, Werkzeuge für den Einsatz in der realen Welt an echten Daten zu bewerten und bei Bedarf auch damit feinabzustimmen. Ein synthetischer Testdatensatz misst meist vor allem, wie gut ein Modell den Generator nachahmt.
Grounding. Viele KI-Produkte stützen ihre Antworten auf Quellen und nutzen dafür RAG (Retrieval-Augmented Generation, abrufgestützte Generierung): Sie holen zum Zeitpunkt der Frage aktuelle Dokumente und lassen das Modell auf deren Grundlage antworten. Das funktioniert nur, wenn die Dokumente echt und aktuell sind. Genau diese Pipeline beschreibt Web Scraping für RAG: Von HTML zu sauberen Markdown-Chunks.
Aktualität und Ausgangsdaten. Neue Produkte, Preise und Vorschriften erscheinen zuerst im Web, und selbst Pipelines für synthetischen Text beginnen meist mit echten Beispielen. Die Forschung zum Modellkollaps zeigt, warum ein Anteil echter Daten in der Mischung bleiben muss.
Sind synthetische Daten anonym?
Synthetische Daten sind nicht automatisch anonym: Wurden sie aus personenbezogenen Daten erzeugt, können sie weiterhin Informationen über die Personen in diesen Daten preisgeben. Die von der Royal Society in Auftrag gegebene Übersichtsarbeit nennt die Annahme, synthetische Daten seien von Natur aus privat, „ein verbreiteter Irrtum“ und weist darauf hin, dass Generatoren ihre Trainingsdatensätze auswendig lernen und wiedergeben können.
Das NIST sieht es genauso: Sowohl die Modelle als auch die synthetischen Daten, die sie erzeugen, können personenbezogene Informationen preisgeben, die sich re-identifizieren lassen. Eine gängige Abhilfe ist Differential Privacy (differenzielle Privatsphäre), ein mathematisches Verfahren, das begrenzt, wie stark der Datensatz einer einzelnen Person das Ergebnis verändern kann. Der Preis dafür ist etwas Genauigkeit.
Die rechtliche Sicht folgt derselben Logik. Nach der DSGVO in der EU und dem KVKK in Türkiye gelten Daten erst dann als anonym, wenn sie sich keiner identifizierbaren Person mehr zuordnen lassen, und schon der Aufbau eines Generators aus Kundendaten ist eine Verarbeitung personenbezogener Daten. Stammen Ihre Ausgangsdaten aus Seiten, die per Web Scraping gesammelt wurden, erklärt Personenbezogene Daten (PII) in Scraping-Datensätzen den Unterschied zwischen Maskierung, Pseudonymisierung und Anonymisierung.
Wo kommen Proxys ins Spiel, wenn Sie echte Daten brauchen?
Muss ein Modell auf echten, aktuellen öffentlichen Daten aufbauen, die je nach Standort variieren, etwa Preisen, Inseraten oder Stellenanzeigen, oder an solchen Daten getestet werden, helfen synthetische Daten nicht weiter; dann müssen die Daten vom richtigen Ort aus erhoben werden. Viele Websites zeigen je nach Land der IP-Adresse des Besuchers andere Preise, Währungen, Lagerbestände und Sprachen. Eine Erhebung aus einem einzigen Büro sieht deshalb nur eine Version.
Ein Residential-Proxy leitet jede Anfrage über einen privaten Internetanschluss in dem Land und der Stadt Ihrer Wahl, sodass die Seite zurückgibt, was lokale Besucher sehen. Erheben Sie nur öffentliche Seiten, beachten Sie robots.txt und die Nutzungsbedingungen der Website, senden Sie Anfragen in gemäßigtem Tempo, nutzen Sie eine offizielle API, wo es eine gibt, und lassen Sie personenbezogene Daten weg, die Sie nicht brauchen.
Teams, die die Erhebung lieber nicht selbst betreiben, können mit unserem Vertriebsteam über die verwaltete Seitenextraktion unserer Web Scraping API sprechen.
Häufige Fehler
- Synthetische Daten pauschal für anonym halten. Testen Sie sie auf Datenlecks oder nutzen Sie ein Verfahren mit formaler Garantie.
- Nach Augenschein validieren. „Sieht echt aus“ sagt nichts über Korrelationen, seltene Fälle oder den Nutzen.
- Das finale Modell nur an synthetischen Daten testen. Behalten Sie einen echten, zurückgehaltenen Testdatensatz.
- Datensätze nicht kennzeichnen. Synthetische Zeilen, die echt aussehen, landen in Berichten, als wären sie echt.
- In einer Schleife mit Modellausgaben trainieren. Jede Generation ohne frische echte Daten verliert mehr von den seltenen Fällen.
- Erwarten, dass ein Generator aktuelle Ereignisse kennt. Alles, was nach der Erhebung der Quelle geschah, fehlt.
- Verzerrungen in der Quelle ignorieren. Der Generator kopiert sie und präsentiert sie dann als saubere Daten.
Entscheidungshilfe
| Bedarf | Lösung |
|---|---|
| Eine App vor dem Start testen | Regelbasierte Testdaten, klar gekennzeichnet |
| Eine Kundentabelle mit einem Dienstleister teilen | Synthetische Daten mit Datenschutztest, dazu rechtliche Prüfung |
| Mehr Beispiele seltener Fälle | Synthetische Ergänzung, an echten Fällen bewertet |
| Einem Chatbot ein Aufgabenformat beibringen | Von einem LLM erzeugte Beispiele, von Menschen geprüft |
| Aktuelle Preise, Inserate oder Stellenanzeigen | Echte öffentliche Webdaten, rücksichtsvoll erhoben |
| Antworten zu aktuellen Ereignissen | Abruf aus aktuellen echten Quellen |
| Abschließende Modellbewertung | Ein echter, zurückgehaltener Testdatensatz |
Häufige Fragen
Was ist ein Beispiel für synthetische Daten?
Eine Tabelle mit 10.000 erfundenen Kunden, deren Alter, Wohnorte und Kaufbeträge denselben Mustern folgen wie eine echte Kundendatenbank, besteht aus synthetischen Daten. Dasselbe gilt für Produktbewertungen, die ein Sprachmodell schreibt, um einen Klassifikator zu trainieren, und für Straßenszenen aus einem Fahrsimulator, in denen jedes Auto bereits annotiert ist.
Sind synthetische Daten zuverlässig?
Sie sind zuverlässig für die Aufgabe, für die sie validiert wurden, und nicht darüber hinaus. Daten, die für eine Aufgabe wie das Training eines Betrugsmodells die Prüfungen auf Wiedergabetreue und Nutzen bestehen, können bei einer anderen, etwa der Schätzung seltener Ereignisse, trotzdem in die Irre führen. Behandeln Sie Befunde aus synthetischen Daten als Hypothesen und bestätigen Sie sie an echten Daten.
Was ist der Unterschied zwischen synthetischen Daten und Mock-Daten?
Mock- oder Dummy-Daten müssen nur gültig aussehen: richtige Formate, plausible Wertebereiche, keine echten Personen. Synthetische Daten im engeren Sinn bewahren zusätzlich die statistischen Muster eines echten Datensatzes, sodass Analysen oder Modelltraining damit ähnliche Ergebnisse liefern. Mock-Daten eignen sich für Softwaretests, statistisch getreue synthetische Daten für Analysen und maschinelles Lernen.
Lassen sich KI-Modelle nur mit synthetischen Daten trainieren?
Manche eng begrenzten Modelle schon, vor allem in simulationslastigen Bereichen wie der Robotik, doch große Sprachmodelle sind weiterhin auf echten Text angewiesen. Veröffentlichte Arbeiten mischen beides, wie bei phi-1, und die Forschung zum Modellkollaps zeigt, dass Training allein mit generiertem Text über mehrere Generationen hinweg die Qualität verschlechtert.
Was sind synthetische Daten in der Marktforschung?
In der Marktforschung sind mit synthetischen Daten meist „synthetische Befragte“ gemeint: Ein Sprachmodell beantwortet Umfragefragen so, wie es das von einem bestimmten Kundentyp erwartet. Das kann helfen, einen Fragebogen zu entwerfen und zu testen, verrät aber nicht, was echte Menschen heute denken oder wie sie auf etwas Neues reagieren. Entscheidungen stützen sich deshalb weiterhin auf echte Umfragen und auf echte Marktdaten wie Preise und Angebote der Konkurrenz.
Wie misst man die Qualität synthetischer Daten?
Die Qualität wird auf drei Achsen gemessen: Wiedergabetreue (wie genau Verteilungen und Korrelationen den echten Daten entsprechen), Nutzen (ob ein damit trainiertes Modell auf echten Daten gut abschneidet) und Datenschutz (ob sich echte Datensätze daraus ableiten lassen). Ein starkes Ergebnis auf einer Achse kostet oft etwas auf einer anderen; legen Sie die Ziele deshalb nach dem Anwendungsfall fest.
Fazit
Synthetische Daten werden von einem Modell, von Regeln oder einer Simulation erzeugt, um echten Daten zu ähneln, ohne reale Ereignisse oder Personen zu erfassen. Sie helfen bei Softwaretests, sichererer Datenweitergabe, seltenen Fällen und Trainingsbeispielen, sofern sie an echten Daten validiert und auf Datenschutzlecks geprüft werden. Echte Daten ersetzen sie nicht: Sie enthalten nichts, was ihrer Quelle fehlte, verpassen alles, was danach geschah, übernehmen Verzerrungen und verschlechtern Modelle, die nur ihre eigene Ausgabe verarbeiten. Für aktuelle, standortbezogene Fakten wie Preise, Inserate und Stellenanzeigen bleibt das echte öffentliche Web die Quelle, erhoben in rücksichtsvollem Tempo und aus dem richtigen Land.