


































Una viajera fotografía una señal de estacionamiento escrita en un idioma que no sabe leer y le pregunta a su teléfono si puede dejar el auto ahí hasta las 18:00. Un agente de soporte recibe, en lugar de una descripción, una captura de pantalla borrosa de un cuadro de error. El dueño de una tienda habla con un asistente mientras apunta la cámara a una etiqueta. Los tres usan el mismo tipo de sistema: un modelo de IA que trabaja con imágenes y sonido, además de con palabras.
Este artículo explica qué son la IA multimodal y una «modalidad», cómo estos modelos convierten imágenes y audio en algo que un modelo de lenguaje puede usar, qué hacen los modelos de visión y lenguaje, dónde fallan y qué revisar antes de subir una foto.
¿Qué es la IA multimodal?
La IA multimodal es un modelo o sistema de IA que trabaja con más de un tipo de datos, como texto, imágenes, audio o vídeo, en la entrada, en la salida o en ambas. Un chatbot que solo maneja texto es unimodal: entran palabras y salen palabras. Un modelo que mira una foto de tu refrigerador y te sugiere una receta, o que escucha una pregunta y responde en voz alta, es multimodal.
La palabra en sí solo significa «que usa varios modos», y por eso también aparece en el transporte (un mismo envío por camión, tren y barco), en medicina (un tratamiento que combina varios métodos) y en educación, donde el aprendizaje multimodal consiste en enseñar con texto, imágenes y sonido a la vez. Este artículo se queda con el significado que tiene en la IA.
Muchos asistentes de chat ya aceptan imágenes y voz. Por dentro, la mayoría se construye alrededor de un modelo de lenguaje grande, es decir, un modelo entrenado con enormes cantidades de texto para predecir el siguiente fragmento de texto, al que se añaden piezas que le permiten manejar otros tipos de datos.
¿Qué es una modalidad en la IA?
Una modalidad es un tipo de datos, definido por la forma en que se capta o se experimenta la información: lenguaje, imágenes, vídeo, sonido. Una revisión sobre aprendizaje automático multimodal muy citada, de Baltrusaitis, Ahuja y Morency (2017), define la modalidad como «la forma en que algo ocurre o se experimenta» y considera multimodal un problema cuando abarca varias de ellas.
La revisión se centra en tres: el lenguaje natural, escrito o hablado; las señales visuales, como imágenes y vídeo; y las señales vocales, que transmiten sonidos y el tono de la voz. Los campos especializados añaden otras, como lecturas de sensores o imágenes médicas.
¿Cómo funciona la IA multimodal?
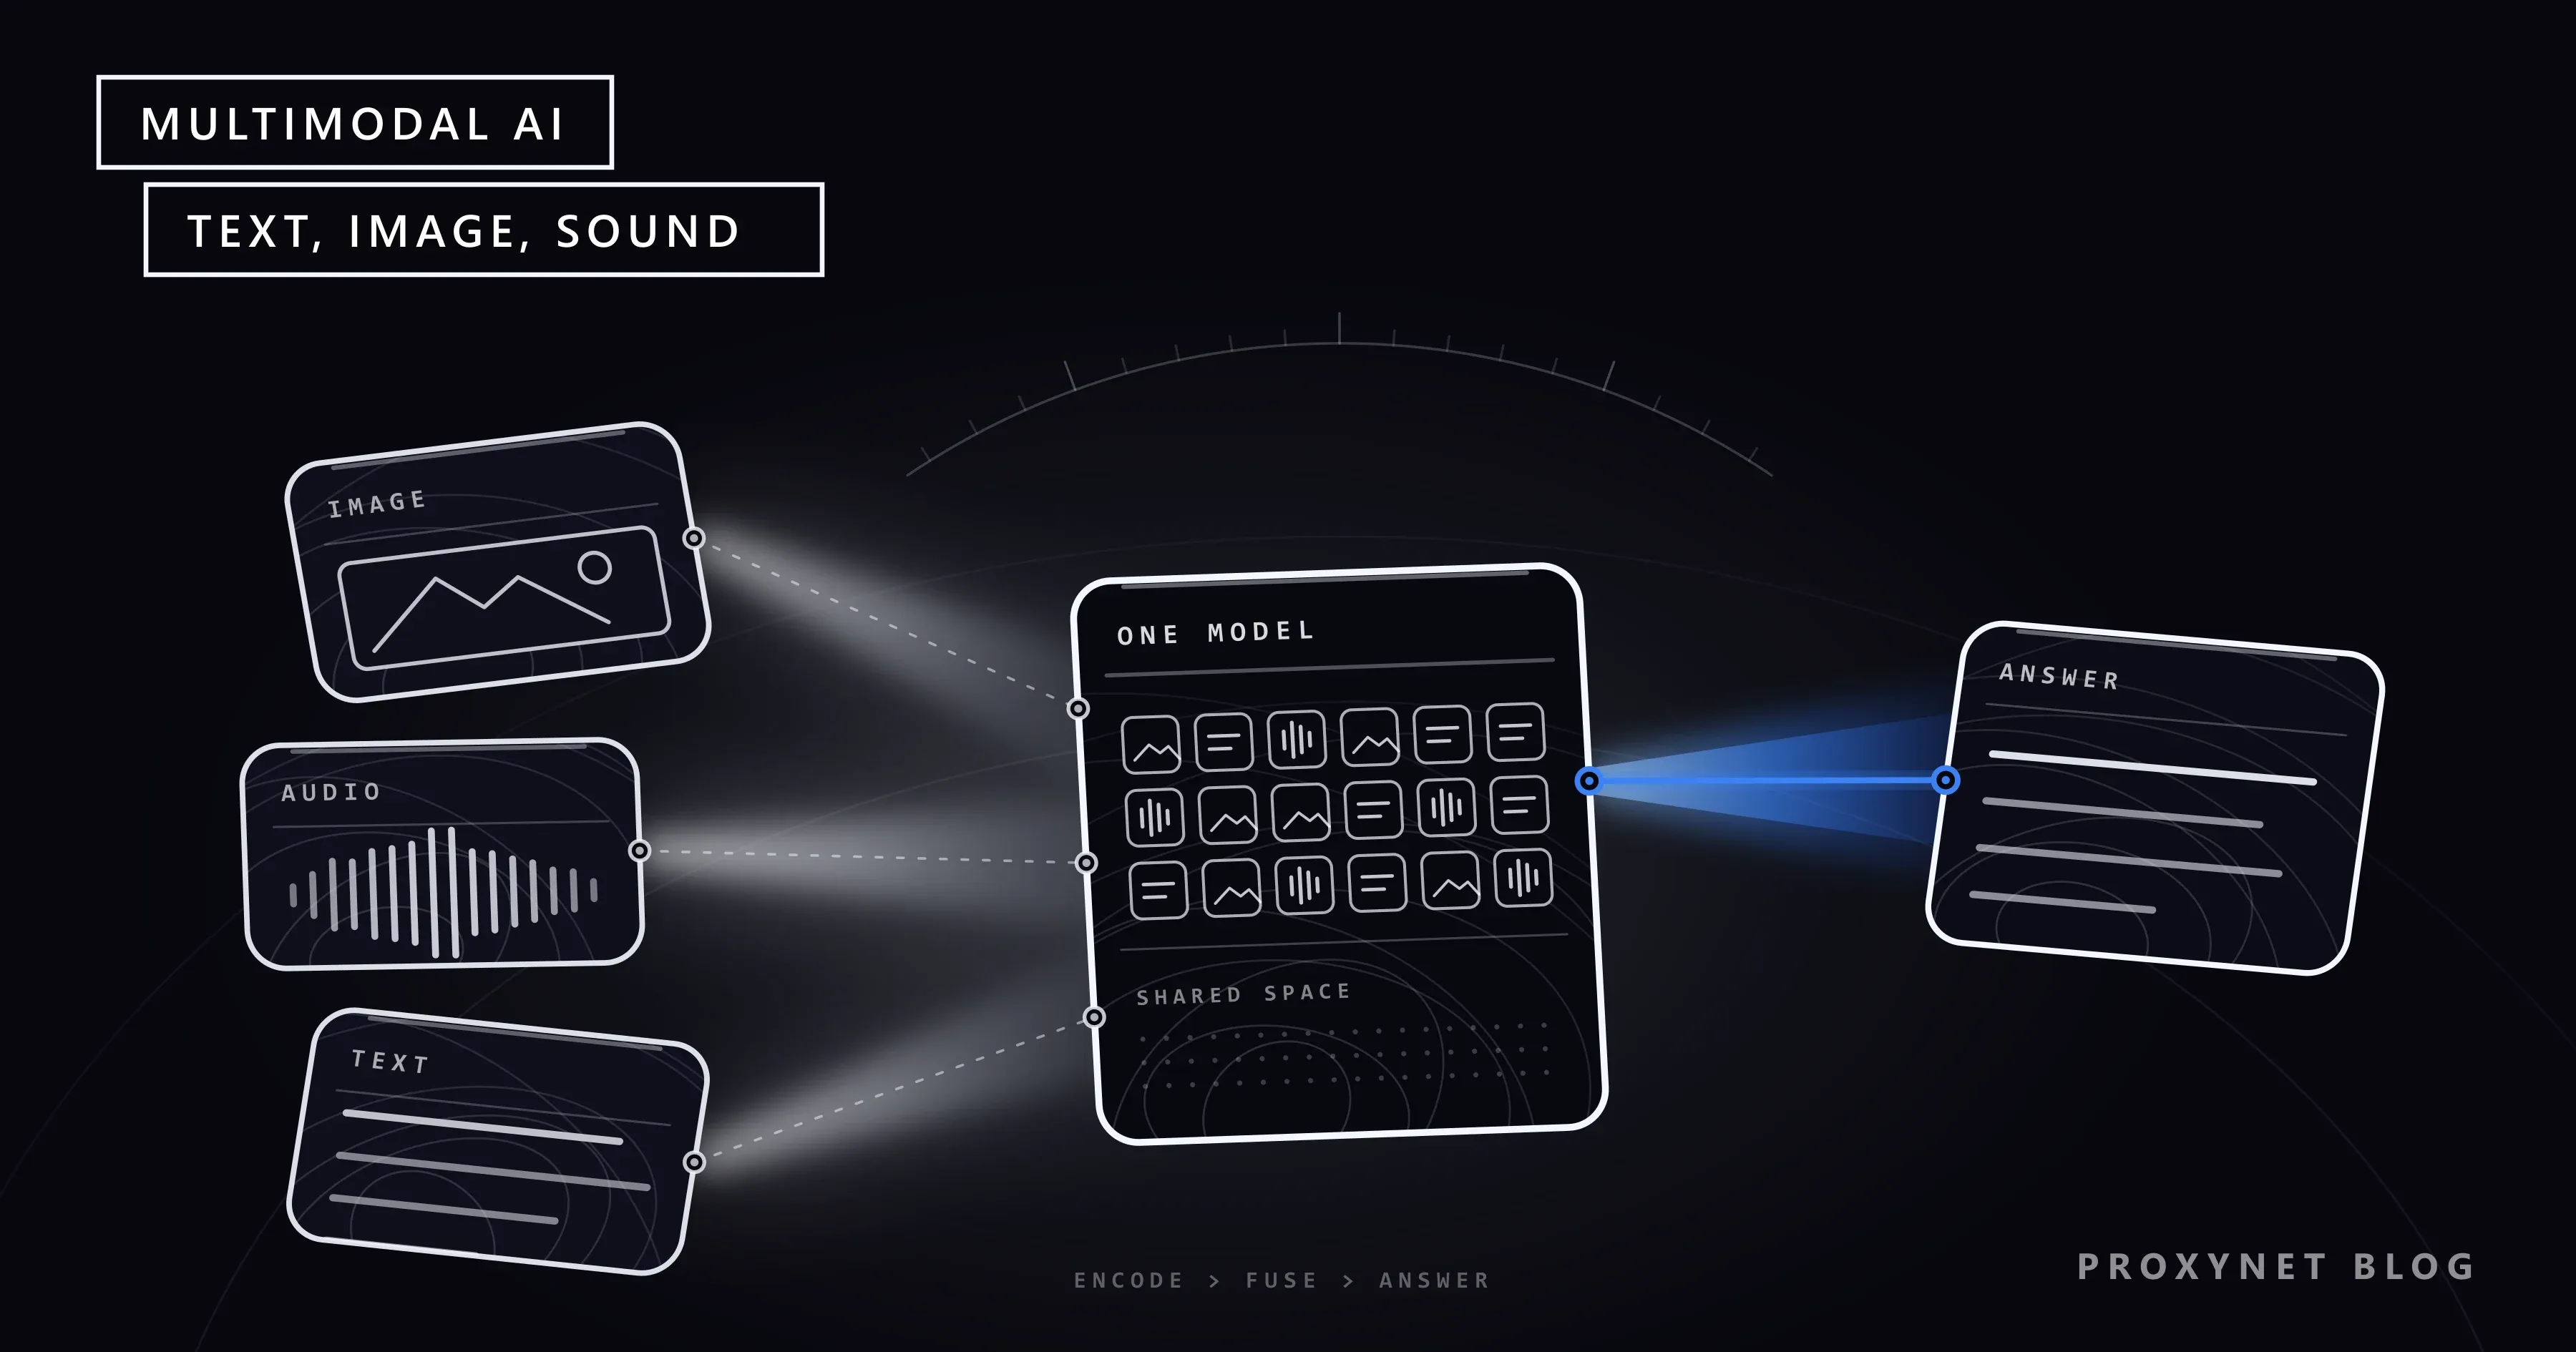
Un modelo multimodal convierte cada entrada en la misma moneda, vectores en un espacio compartido, y deja que un solo modelo razone sobre todos ellos. Un modelo típico funciona en cinco pasos:
- Enviar cada entrada a su codificador. El texto se divide en tokens, pequeños fragmentos de palabras; las imágenes van a un codificador visual y el audio a un codificador de audio. Cada uno es una red neuronal entrenada para su tipo de datos.
- Cortar la entrada en piezas. Un transformer de visión (vision transformer) corta la imagen en pequeños parches cuadrados (patches) y los trata como las palabras de una oración. El audio suele convertirse en un espectrograma, una imagen de cómo cambian las frecuencias del sonido a lo largo del tiempo, y se lee en fragmentos cortos.
- Llevar las piezas al espacio del modelo de lenguaje. Cada parche o fragmento se convierte en un vector, y una pequeña red conectora, a veces una sola capa, traslada esos vectores al espacio que el modelo de lenguaje usa para los tokens de palabras.
- Razonar sobre una única secuencia combinada. El modelo de lenguaje lee los vectores de imagen, los vectores de audio y los tokens de texto como una sola secuencia. Su mecanismo de atención, la parte que pondera qué piezas importan entre sí, puede relacionar «el rojo» de tu pregunta con el parche correcto de la foto.
- Producir la salida. Normalmente es texto. Los modelos que también hablan o dibujan añaden decodificadores que vuelven a convertir los tokens de salida en sonido o en píxeles.
El espacio compartido es la idea clave. El modelo CLIP de OpenAI, descrito en un artículo científico de 2021, aprendió uno con una tarea sencilla: predecir qué descripción corresponde a qué imagen, a partir de 400 millones de pares de imagen y texto recopilados de internet. Tras el entrenamiento, la foto de un perro y las palabras «a photo of a dog» («una foto de un perro») quedan cerca como vectores, y modelos posteriores reutilizan el codificador de imágenes de CLIP como sus ojos.
¿Qué diferencia hay entre la fusión temprana y la tardía?
La fusión es el paso en el que se combina la información de distintas modalidades, y la diferencia está en cuándo ocurre. La revisión citada arriba describe la división clásica:
- La fusión temprana une las características de cada modalidad justo después de extraerlas.
- La fusión tardía deja que cada modalidad llegue primero a su propia decisión y luego combina las decisiones.
- La fusión híbrida mezcla las dos.
La fusión tardía es fácil de montar con piezas existentes, pero pierde los vínculos entre modalidades, como un pie de foto que solo resulta sarcástico por la imagen. El informe técnico de Google sobre Gemini, en cambio, dice que los modelos se entrenaron de forma conjunta con imagen, audio, vídeo y texto, y los llama multimodales de forma nativa. El diseño opuesto es una cadena de modelos (pipeline): el reconocimiento de voz convierte tu voz en texto, un modelo que solo maneja texto responde y un sintetizador lee la respuesta. El tono de voz y las pausas se pierden ya en el primer paso.
¿Qué tipos de datos puede manejar la IA multimodal?
Los modelos multimodales manejan sobre todo cuatro modalidades:
| Modalidad | Entrada típica | Tarea de ejemplo |
|---|---|---|
| Texto | Preguntas, documentos, código | Resumir un contrato |
| Imagen | Fotos, capturas de pantalla, gráficos, escaneos | Describir una foto, leer un gráfico |
| Audio | Voz, llamadas, grabaciones | Responder una pregunta hablada |
| Vídeo | Clips, grabaciones de pantalla | Encontrar el momento en que aparece algo |
Los documentos como los PDF quedan en medio: un modelo puede leer su capa de texto o tratar cada página como una imagen cuando importan el diseño, las tablas o la escritura a mano.
¿Multimodal en la entrada o en la salida?
Un modelo puede ser multimodal en la entrada, en la salida o en ambas, y la palabra «multimodal» en una página de producto rara vez dice cuál de ellas.
- Entrada multimodal, salida de texto. El modelo entiende imágenes, audio o vídeo, pero solo responde con texto. Así funcionan los modelos de visión y lenguaje.
- Entrada de texto, otra salida. Los modelos de texto a imagen y de texto a voz cruzan dos modalidades en una sola dirección; no todo el mundo los llama multimodales.
- Multimodal en la entrada y en la salida. La ficha de sistema (system card) que OpenAI publicó para GPT-4o (2024) describe un modelo que acepta texto, audio, imagen y vídeo y genera texto, audio e imágenes, con una sola red neuronal que lo procesa todo.
Haz una lista de las modalidades que entran y de las que salen; eso te dice más que la etiqueta.
¿Qué es un modelo de visión y lenguaje?
Un modelo de visión y lenguaje (VLM, por sus siglas en inglés) es un modelo multimodal que recibe imágenes y texto como entrada y responde con texto. Es el tipo más común de IA multimodal, y es el que trabaja cuando adjuntas una imagen a un chat y preguntas sobre ella.
La receta habitual une un codificador visual preentrenado, un conector y un modelo de lenguaje preentrenado. El artículo de LLaVA (Visual Instruction Tuning, 2023) es un ejemplo público claro: usó el codificador visual de CLIP, una simple capa lineal para llevar las características de la imagen al espacio de palabras del modelo de lenguaje y un modelo de lenguaje abierto llamado Vicuna. Sus conversaciones de entrenamiento las escribió una versión de GPT-4 que solo manejaba texto y nunca vio las imágenes: recibió sus descripciones y los cuadros delimitadores de los objetos en forma de texto.
Leer texto de una imagen es una tarea más antigua y más acotada, llamada OCR (reconocimiento óptico de caracteres). ¿Qué es el OCR? explica cómo funciona y cuándo un motor de OCR dedicado sigue siendo la herramienta más adecuada.
¿Qué puedes hacer con la IA multimodal?
La IA multimodal ayuda siempre que una pregunta depende de algo que se puede ver u oír. Ejemplos comunes:
- Describir una foto: texto alternativo para un sitio web, una descripción para una persona ciega o con baja visión, un pie de foto para la imagen de un producto.
- Leer un gráfico o un panel: subir una captura de pantalla y preguntar en qué mes fue la caída, y después comprobar el número tú mismo.
- Preguntar sobre un documento: un contrato escaneado, una página llena de tablas, un formulario rellenado a mano.
- Hablar por voz: una conversación hablada con preguntas de seguimiento, a veces mientras le muestras a la cámara lo que quieres decir.
- Buscar dentro de un vídeo: encontrar el minuto de una grabación de dos horas en que aparece una diapositiva o un producto.
- Trabajar en una pantalla: los agentes que manejan un navegador o un escritorio leen capturas de pantalla para decidir dónde hacer clic, así que también son multimodales.
Probablemente ya la usas: en los botones de imagen y micrófono de las apps de chat, en las cámaras del teléfono que traducen menús, en las herramientas de reuniones que resumen una grabación junto con sus diapositivas.
¿Cuáles son los límites de la IA multimodal?
Los modelos multimodales cometen los mismos errores que los modelos de texto, más algunos propios de las imágenes, el sonido y el vídeo:
- Describir lo que no está. Un modelo puede nombrar un objeto, una palabra o un número que no aparece en la imagen, con el mismo tono seguro que una respuesta correcta. Es la forma visual de la alucinación de IA, y la defensa es la misma: pide pruebas y compruébalas.
- Contar y ver detalles finos. Un estudio de 2024 titulado «Vision language models are blind» («Los modelos de visión y lenguaje son ciegos») puso a prueba cuatro VLM de última generación en siete tareas muy simples. Los modelos fallaron en preguntas como si dos círculos se superponen, cuántas veces se cruzan dos líneas o qué letra de una palabra está rodeada con un círculo.
- Texto pequeño y girado. Las imágenes grandes se reducen antes de que el modelo las vea, así que la letra pequeña puede volverse ilegible. Las imágenes borrosas, giradas o diminutas aumentan la tasa de error.
- Sesgo. Los pares de imagen y texto de la web arrastran los desequilibrios de la web: algunos idiomas, sistemas de escritura, regiones y grupos de personas aparecen mucho más que otros.
- No detecta falsificaciones. Un modelo general no puede saber con fiabilidad si una imagen fue creada con IA.
- Costo. Las imágenes y el audio consumen muchos tokens. En la documentación de visión de Anthropic para sus modelos Claude, una imagen se divide en parches de 28 × 28 píxeles y cada uno es un token visual, de modo que una imagen de 1.000 × 1.000 píxeles cuesta 1.296 tokens antes de que escribas una sola palabra.
¿Cómo debes tratar las fotos, las caras y la privacidad?
Trata una foto como dato personal siempre que muestre a una persona o algo que la identifique. Una imagen puede mostrar caras, personas al fondo, el número de una casa, la placa de un auto o un documento de identidad sobre la mesa, y los metadatos del archivo pueden registrar dónde y cuándo se tomó.
La ley es estricta con las caras. Según el Reglamento General de Protección de Datos (RGPD) de la UE, las imágenes faciales tratadas con medios técnicos específicos para identificar a una persona son datos biométricos. El artículo 9 prohíbe tratar datos biométricos dirigidos a identificar de manera unívoca a una persona física, salvo que se aplique alguna de sus excepciones, y el considerando 51 añade que una fotografía corriente no entra automáticamente en esa categoría. En Türkiye, el artículo 6 de la Ley n.º 6698 de Protección de Datos Personales (KVKK) también incluye los datos biométricos entre las categorías especiales de datos personales.
Una empresa necesita una base jurídica antes de subir fotos de clientes o empleados a una herramienta de IA, y debe comprobar si el proveedor entrena sus modelos con los archivos que recibe. El reconocimiento facial necesita, además, una base jurídica clara propia.
¿De dónde salen los datos de entrenamiento de la IA multimodal?
Los modelos multimodales aprenden de conjuntos muy grandes de datos emparejados, como imágenes con descripciones, audio con transcripciones y vídeos con subtítulos, en gran parte procedentes de páginas web públicas; los 400 millones de pares de CLIP salieron de internet.
La cobertura importa tanto como el tamaño. Un modelo que solo ha visto menús, carteles y recibos en unos pocos sistemas de escritura leerá mal el resto, y un conjunto de prueba armado con páginas de un solo país oculta ese problema. Las páginas con muchas imágenes también suelen estar localizadas: las tiendas y los sitios de viajes muestran fotos, banners y textos dentro de las imágenes distintos según el país del visitante. Para recopilar esas páginas tal como las ve un visitante local encajan los Proxies residenciales, ya que cada solicitud sale por una conexión doméstica del país y la ciudad que elijas.
Recopila solo páginas públicas, revisa la licencia de las imágenes antes de entrenar con ellas, respeta robots.txt y los términos del sitio, mantén un ritmo de solicitudes bajo y deja fuera las caras y los datos personales que no necesites. Si prefieres no encargarte tú de la recopilación, puedes consultar a nuestro equipo de ventas sobre la extracción gestionada de páginas de nuestra Web Scraping API.
Errores frecuentes
- Fiarse de los conteos y las medidas. Toma como una estimación el número de artículos de un estante que da un VLM.
- Enviar una captura enorme para leer la letra pequeña. Primero se reduce; recorta la parte que importa.
- Dar por verificada una descripción fluida. Contrasta números, nombres y citas con la imagen.
- Subir sin pensarlo caras o documentos de identidad de otras personas. Son datos personales, y las caras pueden entrar en las categorías especiales.
- Probar solo con muestras limpias. Prueba primero con poca luz, otros sistemas de escritura, páginas giradas y audio con ruido.
- Pagar por una resolución que no necesitas. Los tokens de imagen se acumulan rápido cuando hay miles de archivos.
Guía de decisión
| Necesidad | Usa |
|---|---|
| Leer texto impreso de muchos escaneos | OCR dedicado; VLM para los casos difíciles |
| Preguntar sobre un gráfico o una captura | Un modelo de visión y lenguaje, y luego revisar los números |
| Conversación por voz sin usar las manos | Un modelo que procesa la voz de forma nativa o una cadena de voz |
| Encontrar un momento en un vídeo largo | Un modelo con entrada de vídeo o una transcripción |
| Conteos o medidas exactos | Visión artificial clásica o una revisión humana |
| Fotos con caras o documentos de identidad | Ocultar datos primero; base jurídica para uso empresarial |
| Datos de prueba de muchos países | Páginas públicas recopiladas por país, con licencias revisadas |
Preguntas frecuentes
¿ChatGPT es multimodal?
Sí. La ficha de sistema de GPT-4o que publicó OpenAI (GPT-4o System Card, 2024) describe GPT-4o, el modelo que OpenAI usó para Advanced Voice Mode, la función de conversación por voz de ChatGPT. Según ese documento, acepta texto, audio, imagen y vídeo, produce texto, audio e imágenes y es una sola red entrenada de extremo a extremo con todas esas modalidades. Los modelos y las funciones de ChatGPT cambian a menudo y varían según la suscripción, así que comprueba qué ofrece tu versión.
¿Qué diferencia hay entre la IA multimodal y la IA generativa?
La IA generativa produce contenido nuevo, mientras que la IA multimodal maneja más de un tipo de datos. Un asistente que mira una foto y escribe una respuesta es las dos cosas. Un clasificador que marca publicaciones dañinas a partir de su texto y su imagen es multimodal pero no generativo; un chatbot que solo maneja texto es lo contrario.
¿Qué es un modelo de visión y lenguaje?
Un modelo de visión y lenguaje es un modelo multimodal que recibe imágenes y texto como entrada y responde con texto. Suele combinar un codificador visual, un pequeño conector y un modelo de lenguaje grande, y está detrás de la mayoría de las funciones del tipo «pregunta sobre esta imagen».
¿La IA multimodal puede entender vídeo?
Sí, sobre todo tomando fotogramas a intervalos y leyéndolos junto con la pista de audio o una transcripción. El informe de Google sobre Gemini describe cómo el vídeo se codifica como una secuencia de fotogramas dentro de la ventana de contexto del modelo. Como solo se leen algunos fotogramas, un suceso rápido entre dos muestras puede pasar inadvertido, y los vídeos largos consumen muchos tokens.
¿Es IA multimodal o multimodelo?
Los dos términos existen y significan cosas distintas. Multimodal se refiere a varios tipos de datos; multimodelo, a varios modelos que trabajan juntos, como un reconocedor de voz, un modelo de lenguaje y un sintetizador de voz encadenados. Un sistema puede ser las dos cosas.
¿Es seguro subir fotos a una herramienta de IA?
Con fotos corrientes es razonablemente seguro si revisas la configuración de datos de la herramienta y dejas fuera los detalles sensibles. No subas documentos de identidad, documentos bancarios, historias clínicas ni fotos de otras personas sin su consentimiento, recorta lo que la tarea no necesita y da por hecho que lo que subes puede quedar guardado. Las empresas también deben confirmar si los archivos subidos se usan para entrenar modelos.
En resumen
La IA multimodal trabaja con más de un tipo de datos. Los codificadores convierten imágenes, sonido y vídeo en vectores del mismo espacio que el texto, de modo que un solo modelo puede razonar sobre todo ello y responder con texto, voz o imágenes. Los modelos de visión y lenguaje, la forma más común, te permiten hacer preguntas sobre fotos, gráficos y documentos. Todavía cuentan mal, leen mal el texto pequeño y describen cosas que no están, y las fotos de personas son datos personales. Revisa las respuestas, recorta antes de subir y prueba los modelos con páginas públicas recopiladas allí donde están sus usuarios.


