


































Uma viajante fotografa uma placa de estacionamento escrita em um idioma que ela não sabe ler e pergunta ao celular se pode deixar o carro ali até as 18h. Um atendente de suporte recebe, em vez de uma descrição, uma captura de tela borrada de uma janela de erro. O dono de uma loja conversa com um assistente enquanto aponta a câmera para um rótulo. Os três estão usando o mesmo tipo de sistema: um modelo de IA que trabalha com imagens e som, além de palavras.
Este post explica o que são IA multimodal e uma "modalidade", como esses modelos transformam imagens e áudio em algo que um modelo de linguagem consegue usar, o que fazem os modelos de visão e linguagem, onde eles falham e o que verificar antes de enviar uma foto.
O que é IA multimodal?
IA multimodal é um modelo ou sistema de IA que trabalha com mais de um tipo de dado, como texto, imagens, áudio ou vídeo, na entrada, na saída ou em ambas. Um chatbot só de texto é unimodal: entram palavras, saem palavras. Um modelo que olha a foto da sua geladeira e sugere uma receita, ou que ouve uma pergunta e responde em voz alta, é multimodal.
A palavra em si só significa "que usa vários modos", e por isso também aparece no transporte (uma mesma remessa por caminhão, trem e navio), na medicina (um tratamento que combina vários métodos) e na educação, em que a aprendizagem multimodal é o ensino com texto, imagens e som ao mesmo tempo. Este post fica com o sentido da palavra na IA.
Muitos assistentes de chat já aceitam imagens e voz. Por baixo, a maioria é construída em torno de um modelo de linguagem grande, ou seja, um modelo treinado com enormes quantidades de texto para prever o próximo trecho de texto, com partes extras que permitem lidar com outros tipos de dado.
O que é uma modalidade em IA?
Uma modalidade é um tipo de dado, definido pela forma como a informação é captada ou vivenciada: linguagem, imagens, vídeo, som. Uma revisão sobre aprendizado de máquina multimodal muito citada, de Baltrusaitis, Ahuja e Morency (2017), define modalidade como "a forma como algo acontece ou é vivenciado" e chama um problema de multimodal quando ele envolve várias delas.
A revisão se concentra em três: a linguagem natural, escrita ou falada; os sinais visuais, como imagens e vídeo; e os sinais vocais, que carregam sons e o tom de voz. Áreas especializadas acrescentam outras, como leituras de sensores ou exames médicos de imagem.
Como a IA multimodal funciona?
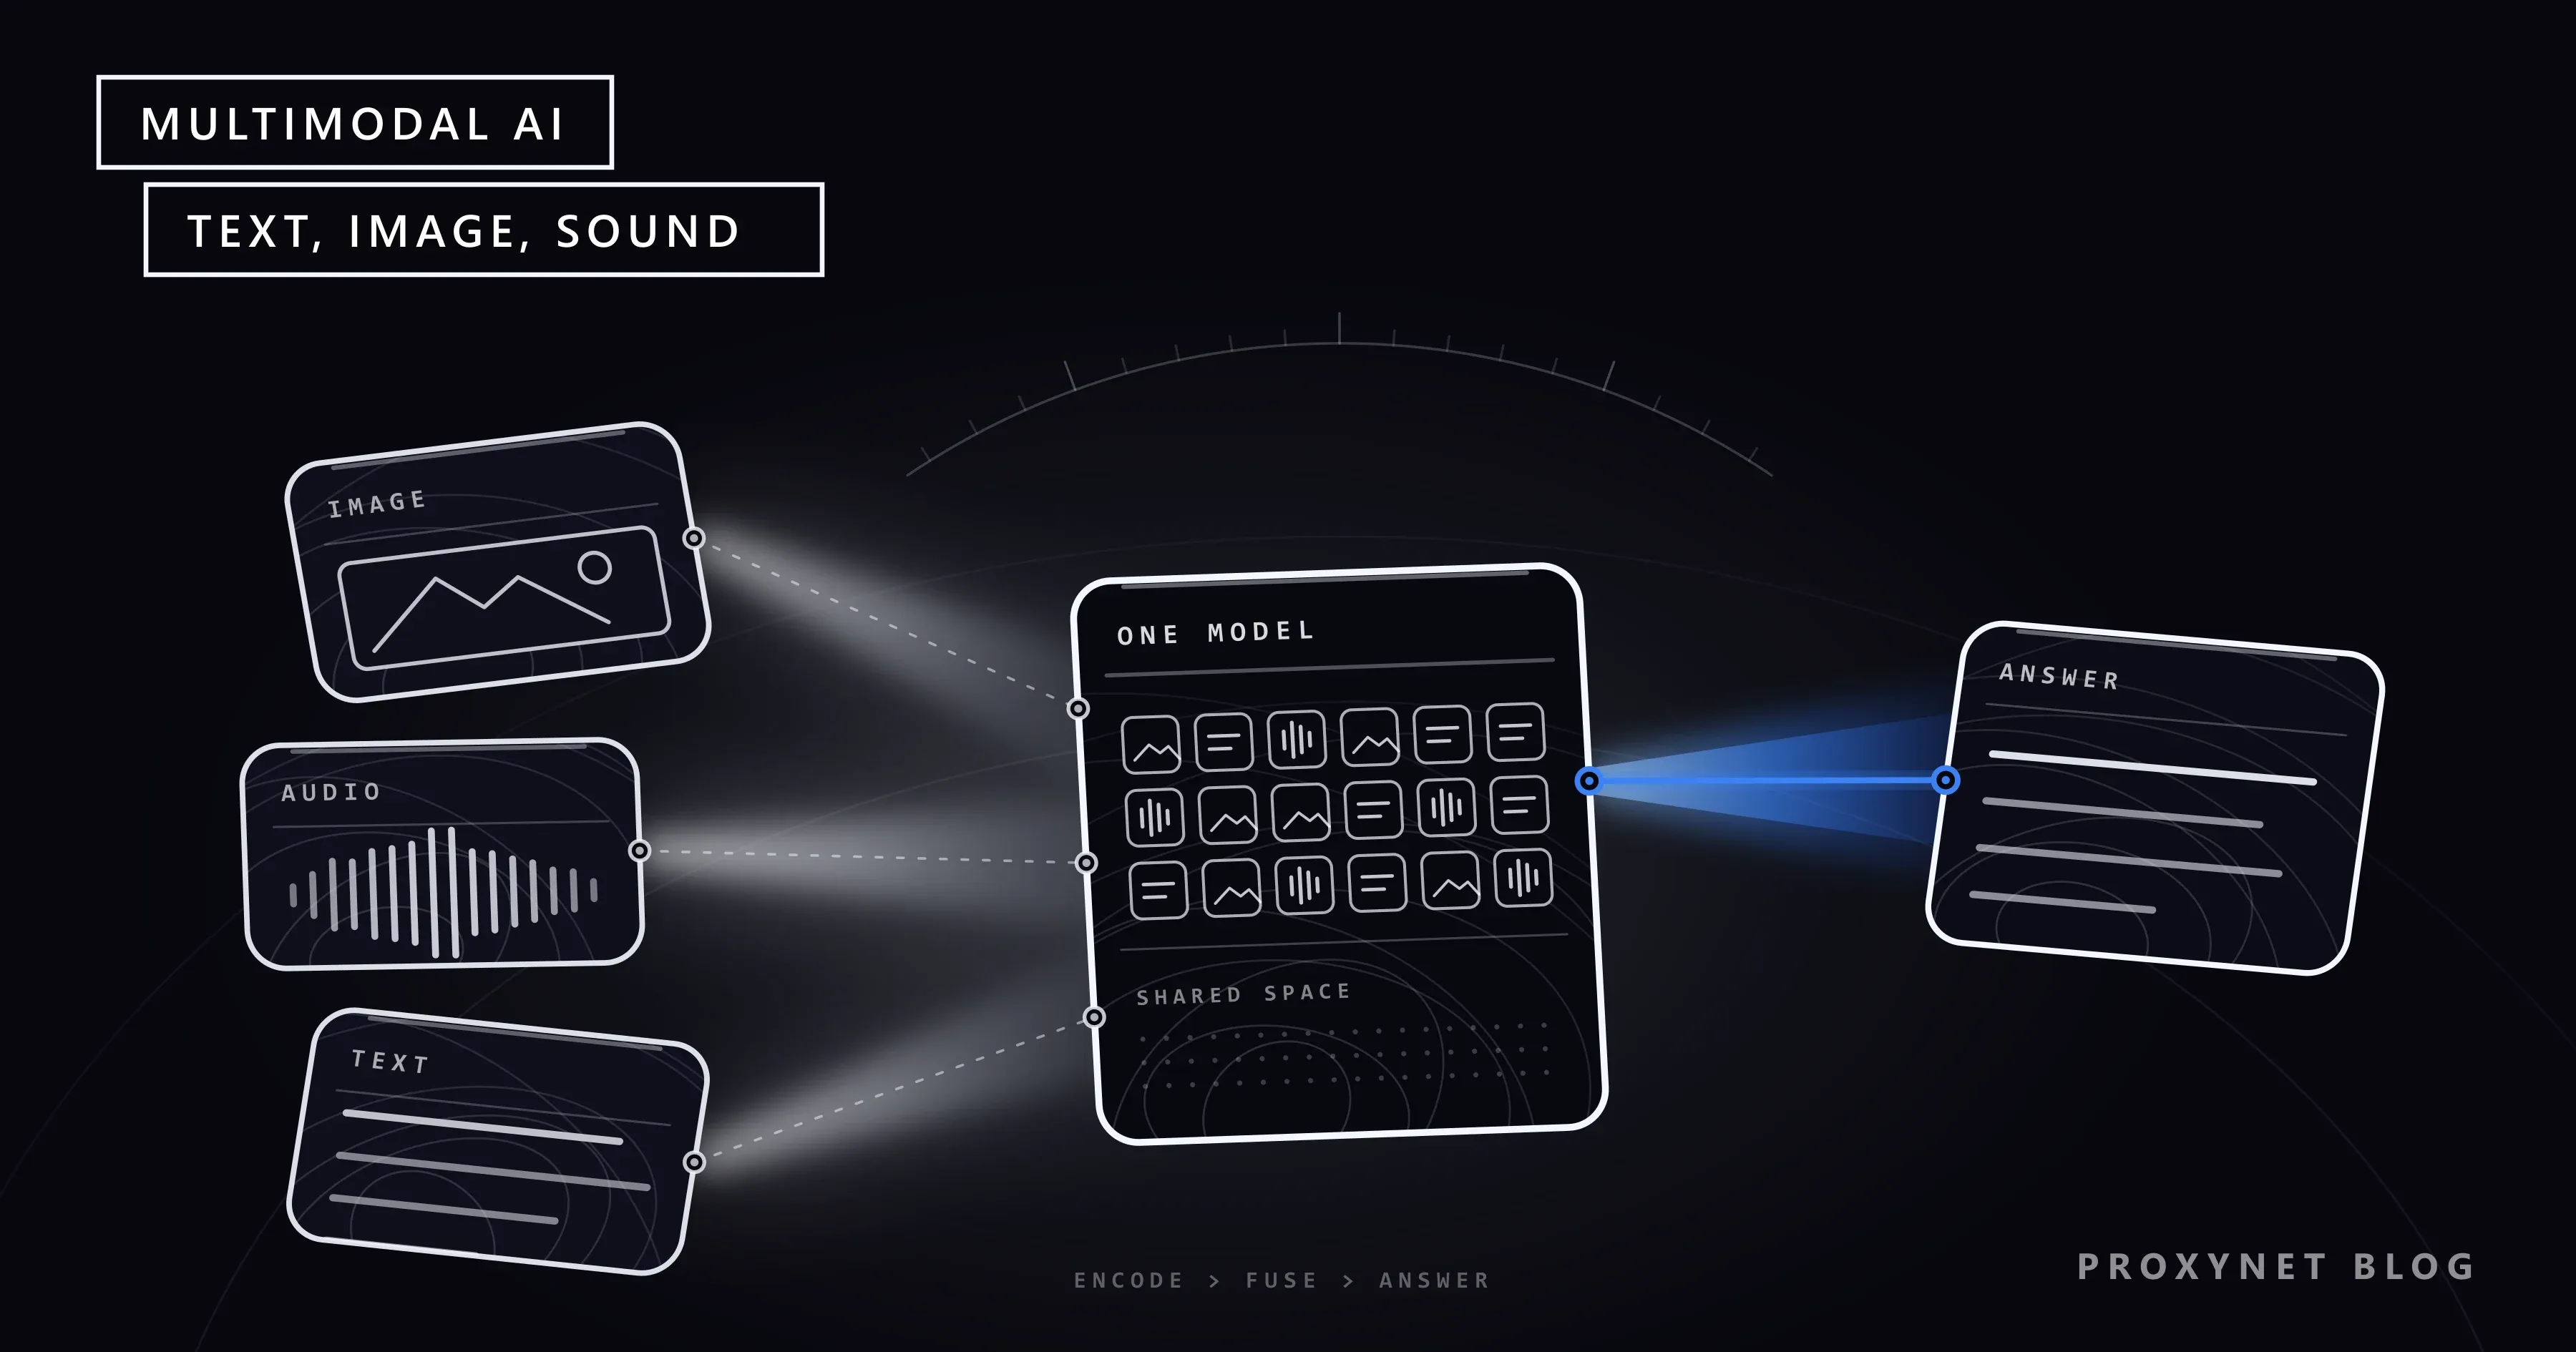
Um modelo multimodal converte toda entrada na mesma moeda, vetores em um espaço compartilhado, e deixa um único modelo raciocinar sobre todos eles. Um modelo típico funciona em cinco etapas:
- Enviar cada entrada ao codificador certo. O texto é dividido em tokens, pequenos pedaços de palavras; as imagens vão para um codificador visual e o áudio para um codificador de áudio. Cada um deles é uma rede neural treinada para o seu tipo de dado.
- Cortar a entrada em pedaços. Um transformer de visão (vision transformer) corta a imagem em pequenos recortes quadrados (patches) e os trata como palavras em uma frase. O áudio costuma virar um espectrograma, uma imagem de como as frequências do som mudam ao longo do tempo, e é lido em fatias curtas.
- Levar os pedaços para o espaço do modelo de linguagem. Cada recorte ou fatia vira um vetor, e uma pequena rede conectora, às vezes uma única camada, leva esses vetores para o espaço que o modelo de linguagem usa para os tokens de palavras.
- Raciocinar sobre uma única sequência combinada. O modelo de linguagem lê vetores de imagem, vetores de áudio e tokens de texto como uma só sequência. O mecanismo de atenção, a parte que pesa quais pedaços importam uns para os outros, consegue ligar "o vermelho" da sua pergunta ao recorte certo da foto.
- Produzir a saída. Geralmente é texto. Modelos que também falam ou desenham acrescentam decodificadores que transformam os tokens de saída de volta em som ou pixels.
O espaço compartilhado é a ideia central. O modelo CLIP, da OpenAI, descrito em um artigo científico de 2021, aprendeu um espaço assim com uma tarefa simples: prever qual legenda combina com qual imagem, em 400 milhões de pares de imagem e texto coletados da internet. Depois do treinamento, a foto de um cachorro e as palavras "a photo of a dog" ("uma foto de um cachorro") ficam próximas como vetores, e modelos posteriores reutilizam o codificador de imagens do CLIP como seus olhos.
Qual é a diferença entre fusão precoce e fusão tardia?
A fusão é a etapa em que a informação de modalidades diferentes é combinada, e a diferença está no momento em que isso acontece. A revisão citada acima descreve a divisão clássica:
- Fusão precoce junta as características de cada modalidade logo depois de extraídas.
- Fusão tardia deixa cada modalidade chegar primeiro à própria decisão e depois combina as decisões.
- Fusão híbrida mistura as duas.
A fusão tardia é fácil de montar com peças prontas, mas perde as ligações entre modalidades, como uma legenda que só é sarcástica por causa da foto. O relatório técnico do Google sobre o Gemini, por outro lado, diz que os modelos foram treinados em conjunto com imagem, áudio, vídeo e texto e os chama de nativamente multimodais. O projeto oposto é uma cadeia de modelos (pipeline): o reconhecimento de fala transforma a sua voz em texto, um modelo só de texto responde e um sintetizador lê a resposta. O tom de voz e as pausas se perdem já na primeira etapa.
Que tipos de dados a IA multimodal consegue processar?
Os modelos multimodais processam com mais frequência quatro modalidades:
| Modalidade | Entrada típica | Tarefa de exemplo |
|---|---|---|
| Texto | Perguntas, documentos, código | Resumir um contrato |
| Imagem | Fotos, capturas de tela, gráficos, digitalizações | Descrever uma foto, ler um gráfico |
| Áudio | Fala, ligações, gravações | Responder a uma pergunta falada |
| Vídeo | Clipes, gravações de tela | Achar o momento em que algo aparece |
Documentos como PDFs ficam no meio do caminho: um modelo pode ler a camada de texto ou tratar cada página como imagem quando o layout, as tabelas ou a escrita à mão importam.
Multimodal na entrada ou na saída?
Um modelo pode ser multimodal na entrada, na saída ou em ambas, e a palavra "multimodal" numa página de produto raramente diz qual dos casos é.
- Entrada multimodal, saída em texto. O modelo entende imagens, áudio ou vídeo, mas responde só em texto. Os modelos de visão e linguagem funcionam assim.
- Entrada em texto, outra saída. Modelos de texto para imagem e de texto para fala cruzam duas modalidades em uma só direção; nem todo mundo os chama de multimodais.
- Multimodal na entrada e na saída. O cartão de sistema (system card) que a OpenAI publicou para o GPT-4o (2024) descreve um modelo que aceita texto, áudio, imagem e vídeo e gera texto, áudio e imagens, com uma única rede neural processando tudo.
Liste as modalidades que entram e as que saem; isso diz mais do que o rótulo.
O que é um modelo de visão e linguagem?
Um modelo de visão e linguagem (VLM, na sigla em inglês) é um modelo multimodal que recebe imagens e texto como entrada e responde em texto. É o tipo mais comum de IA multimodal, e é ele que entra em ação quando você anexa uma imagem a um chat e faz uma pergunta sobre ela.
A receita usual junta um codificador visual pré-treinado, um conector e um modelo de linguagem pré-treinado. O artigo do LLaVA (Visual Instruction Tuning, 2023) é um exemplo público claro: ele usou o codificador visual do CLIP, uma simples camada linear para levar as características da imagem ao espaço de palavras do modelo de linguagem e um modelo de linguagem aberto chamado Vicuna. As conversas de treinamento foram escritas por um GPT-4 só de texto que nunca viu as imagens; ele recebeu as legendas e as caixas delimitadoras dos objetos em forma de texto.
Ler texto em uma imagem é uma tarefa mais antiga e mais restrita, chamada OCR (reconhecimento óptico de caracteres). O que é OCR? explica como ela funciona e quando um mecanismo de OCR dedicado ainda é a ferramenta mais adequada.
O que dá para fazer com IA multimodal?
A IA multimodal ajuda sempre que uma pergunta depende de algo que se pode ver ou ouvir. Exemplos comuns:
- Descrever uma foto: texto alternativo para um site, uma descrição para uma pessoa cega ou com baixa visão, uma legenda para a imagem de um produto.
- Ler um gráfico ou painel: enviar uma captura de tela e perguntar em que mês houve a queda, depois conferir o número você mesmo.
- Perguntar sobre um documento: um contrato digitalizado, uma página cheia de tabelas, um formulário preenchido à mão.
- Conversar por voz: uma conversa falada com perguntas de acompanhamento, às vezes mostrando para a câmera o que você quer dizer.
- Buscar dentro de um vídeo: achar o minuto de uma gravação de duas horas em que aparece um slide ou um produto.
- Trabalhar numa tela: agentes que operam um navegador ou um desktop leem capturas de tela para decidir onde clicar, então eles também são multimodais.
Você provavelmente já usa essa tecnologia: nos botões de imagem e de microfone dos apps de chat, nas câmeras de celular que traduzem cardápios, nas ferramentas de reunião que resumem uma gravação junto com os slides.
Quais são os limites da IA multimodal?
Os modelos multimodais cometem os mesmos erros dos modelos de texto, além de alguns próprios de imagens, som e vídeo:
- Descrever o que não está lá. Um modelo pode citar um objeto, uma palavra ou um número que não está na imagem, com o mesmo tom confiante de uma resposta correta. Essa é a forma visual da alucinação de IA, e a defesa é a mesma: peça evidências e confira.
- Contagem e detalhes finos. Um estudo de 2024 intitulado "Vision language models are blind" ("Modelos de visão e linguagem são cegos") testou quatro VLMs de ponta em sete tarefas muito simples. Os modelos falharam em perguntas como se dois círculos se sobrepõem, quantas vezes duas linhas se cruzam ou qual letra de uma palavra está circulada.
- Texto pequeno e girado. Imagens grandes são reduzidas antes que o modelo as veja, então letras miúdas podem ficar ilegíveis. Imagens borradas, giradas ou minúsculas aumentam a taxa de erro.
- Viés. Pares de imagem e texto da web carregam os desequilíbrios da web: alguns idiomas, sistemas de escrita, regiões e grupos de pessoas aparecem muito mais do que outros.
- Não é detector de falsificações. Um modelo genérico não consegue dizer com segurança se uma imagem foi criada por IA.
- Custo. Imagens e áudio usam muitos tokens. Na documentação de visão da Anthropic para os modelos Claude, uma imagem é dividida em recortes de 28 × 28 pixels, cada um deles um token visual, então uma imagem de 1.000 × 1.000 pixels custa 1.296 tokens antes de você digitar uma única palavra.
Como lidar com fotos, rostos e privacidade?
Trate uma foto como dado pessoal sempre que ela mostrar uma pessoa ou algo que a identifique. Uma imagem pode mostrar rostos, pessoas ao fundo, o número de uma casa, a placa de um carro ou um documento de identidade em cima da mesa, e os metadados do arquivo podem registrar onde e quando ela foi tirada.
A lei é rigorosa com rostos. Pelo Regulamento Geral sobre a Proteção de Dados (GDPR) da União Europeia, imagens faciais tratadas por meios técnicos específicos para identificar uma pessoa são dados biométricos. O artigo 9º proíbe o tratamento de dados biométricos para identificar uma pessoa de forma inequívoca, a menos que se aplique uma de suas exceções, e o considerando 51 acrescenta que uma fotografia comum não entra automaticamente nessa categoria. Na Türkiye, o artigo 6 da Lei nº 6698 de Proteção de Dados Pessoais (KVKK) também inclui os dados biométricos entre as categorias especiais de dados pessoais.
Uma empresa precisa de uma base legal antes de colocar fotos de clientes ou funcionários em uma ferramenta de IA e deve verificar se o fornecedor treina modelos com os arquivos enviados. O reconhecimento facial exige, além disso, uma base legal clara própria.
De onde vêm os dados de treinamento da IA multimodal?
Os modelos multimodais aprendem com conjuntos muito grandes de dados pareados, como imagens com descrições, áudio com transcrições e vídeos com legendas, em boa parte vindos de páginas web públicas; os 400 milhões de pares do CLIP vieram da internet.
A cobertura importa tanto quanto o tamanho. Um modelo que viu cardápios, placas e recibos em só alguns sistemas de escrita vai ler errado o resto, e um conjunto de teste montado com páginas de um único país esconde essa falha. Páginas cheias de imagens também costumam ser localizadas: lojas e sites de viagem mostram fotos, banners e textos dentro das imagens diferentes conforme o país do visitante. Para coletar essas páginas como um visitante local as vê, entram os Proxies residenciais, já que cada requisição sai por uma conexão residencial no país e na cidade que você escolher.
Colete apenas páginas públicas, verifique a licença das imagens antes de treinar com elas, siga o robots.txt e os termos do site, mantenha um ritmo baixo de requisições e deixe de fora rostos e dados pessoais de que você não precisa. Equipes que preferem não cuidar da coleta podem falar com o nosso time de vendas sobre a extração gerenciada de páginas da nossa Web Scraping API.
Erros comuns
- Confiar em contagens e medidas. Trate como estimativa a contagem de itens numa prateleira feita por um VLM.
- Enviar uma captura de tela enorme para ler letras miúdas. Ela é reduzida antes; recorte a parte que importa.
- Tomar uma descrição fluente como verificada. Confira números, nomes e citações com a imagem.
- Enviar rostos ou documentos de outras pessoas sem pensar. São dados pessoais, e rostos podem entrar nas categorias especiais.
- Testar só com amostras limpas. Experimente antes pouca luz, outros sistemas de escrita, páginas giradas e áudio com ruído.
- Pagar por uma resolução de que você não precisa. Os tokens de imagem se acumulam rápido quando há milhares de arquivos.
Guia de decisão
| Necessidade | Use |
|---|---|
| Ler texto impresso de muitas digitalizações | OCR dedicado; VLM para os casos difíceis |
| Perguntar sobre um gráfico ou captura de tela | Um modelo de visão e linguagem, depois conferir os números |
| Conversa por voz sem usar as mãos | Um modelo que processa fala diretamente ou um pipeline de voz |
| Achar um momento em um vídeo longo | Um modelo com entrada de vídeo ou uma transcrição |
| Contagens ou medidas exatas | Visão computacional clássica ou conferência humana |
| Fotos com rostos ou documentos de identidade | Ocultar dados antes; base legal para uso empresarial |
| Dados de teste de muitos países | Páginas públicas coletadas por país, com licenças verificadas |
Perguntas frequentes
O ChatGPT é multimodal?
Sim. O cartão de sistema do GPT-4o publicado pela OpenAI (GPT-4o System Card, 2024) descreve o GPT-4o, o modelo que a OpenAI usou no Advanced Voice Mode, o recurso de conversa por voz do ChatGPT. Segundo o documento, ele aceita texto, áudio, imagem e vídeo, produz texto, áudio e imagens e é uma única rede treinada de ponta a ponta com todas essas modalidades. Os modelos e recursos do ChatGPT mudam com frequência e variam conforme a assinatura, então verifique o que a sua versão oferece.
Qual é a diferença entre IA multimodal e IA generativa?
A IA generativa produz conteúdo novo, enquanto a IA multimodal lida com mais de um tipo de dado. Um assistente que olha uma foto e escreve uma resposta é as duas coisas. Um classificador que sinaliza posts nocivos pelo texto e pela imagem é multimodal, mas não generativo; um chatbot só de texto é o contrário.
O que é um modelo de visão e linguagem?
Um modelo de visão e linguagem é um modelo multimodal que recebe imagens e texto como entrada e responde em texto. Em geral ele combina um codificador visual, um pequeno conector e um modelo de linguagem grande, e está por trás da maioria dos recursos do tipo "pergunte sobre esta imagem".
A IA multimodal consegue entender vídeo?
Sim, na maioria das vezes extraindo quadros em intervalos e lendo esses quadros junto com a faixa de áudio ou uma transcrição. O relatório do Google sobre o Gemini descreve a codificação do vídeo como uma sequência de quadros dentro da janela de contexto do modelo. Como só alguns quadros são lidos, um evento rápido entre duas amostras pode passar despercebido, e vídeos longos usam muitos tokens.
É IA multimodal ou multimodelo?
Os dois termos existem e significam coisas diferentes. Multimodal se refere a vários tipos de dado; multimodelo, a vários modelos trabalhando juntos, como um reconhecedor de fala, um modelo de linguagem e um sintetizador de voz em cadeia. Um sistema pode ser as duas coisas.
É seguro enviar fotos para uma ferramenta de IA?
Para fotos comuns, é razoavelmente seguro se você verificar as configurações de dados da ferramenta e deixar de fora detalhes sensíveis. Não envie documentos de identidade, documentos bancários, prontuários médicos ou fotos de outras pessoas sem o consentimento delas, recorte o que a tarefa não exige e parta do princípio de que o envio pode ficar armazenado. As empresas também devem confirmar se os arquivos enviados são usados para treinar modelos.
Em resumo
A IA multimodal trabalha com mais de um tipo de dado. Os codificadores transformam imagens, som e vídeo em vetores no mesmo espaço do texto, para que um único modelo consiga raciocinar sobre tudo isso e responder em texto, voz ou imagens. Os modelos de visão e linguagem, a forma mais comum, permitem fazer perguntas sobre fotos, gráficos e documentos. Eles ainda contam errado, leem mal textos pequenos e descrevem coisas que não estão lá, e fotos de pessoas são dados pessoais. Confira as respostas, recorte antes de enviar e teste os modelos com páginas públicas coletadas onde estão os seus usuários.


