


































Yurt dışındaki bir yolcu, dilini bilmediği bir park tabelasının fotoğrafını çekip telefonuna arabayı akşam 6'ya kadar orada bırakıp bırakamayacağını soruyor. Bir destek temsilcisine sorunun açıklaması yerine bulanık bir hata ekranı görüntüsü geliyor. Bir dükkân sahibi, kamerayı bir ürün etiketine tutarken asistanla sesli konuşuyor. Üçü de aynı türden bir sistem kullanıyor: kelimelerin yanında görüntü ve sesle de çalışan bir yapay zekâ modeli.
Bu yazıda multimodal yapay zekânın ve "modalite" kavramının ne olduğunu, bu modellerin görüntüyü ve sesi bir dil modelinin kullanabileceği biçime nasıl çevirdiğini, görsel-dil modellerinin ne yaptığını, nerede yanıldıklarını ve bir fotoğrafı yüklemeden önce nelere bakmanız gerektiğini anlatıyoruz.
Multimodal yapay zekâ nedir?
Multimodal yapay zekâ; metin, görsel, ses ya da video gibi birden fazla veri türüyle girdide, çıktıda ya da her ikisinde çalışan bir yapay zekâ modeli veya sistemidir. Yalnızca metinle çalışan bir sohbet botu tek modludur (unimodal): içeri kelime girer, dışarı kelime çıkar. Buzdolabınızın fotoğrafına bakıp tarif öneren ya da sorunuzu duyup sesli cevap veren bir model ise multimodaldir.
Sözcüğün kendisi yalnızca "birden çok yolla" anlamına gelir. Bu yüzden taşımacılıkta (bir yükün kara, demir ve deniz yoluyla tek sevkiyatta taşınması), tıpta (birkaç yöntemi birleştiren tedavi ya da ağrı yönetimi) ve eğitimde (metin, resim ve sesle birlikte öğretim) de kullanılır. Bu yazı, sözcüğün yapay zekâdaki anlamını ele alıyor.
Pek çok sohbet asistanı artık görsel ve ses de kabul ediyor. Bunların çoğunun temelinde, çok büyük miktarda metinle bir sonraki metin parçasını tahmin etmek üzere eğitilmiş bir büyük dil modeli (LLM) ve ona başka veri türlerini işleme yeteneği kazandıran ek parçalar bulunur.
Yapay zekâda modalite nedir?
Modalite (modality), bilginin nasıl yakalandığına ya da algılandığına göre tanımlanan veri türüdür: dil, görüntü, video, ses. Baltrusaitis, Ahuja ve Morency'nin 2017 tarihli, sık atıf alan multimodal makine öğrenmesi derlemesi, modaliteyi "bir şeyin gerçekleşme ya da deneyimlenme biçimi" olarak tanımlar ve birden fazla modalite içeren bir problemi multimodal sayar.
Derleme üç modaliteye odaklanır: yazılı ya da sözlü doğal dil; resim ve video gibi görsel sinyaller; sesleri ve konuşmanın tonunu taşıyan ses sinyalleri. Uzmanlık alanları, sensör ölçümleri ya da tıbbi taramalar gibi başka modaliteler de ekler.
Multimodal yapay zekâ nasıl çalışır?
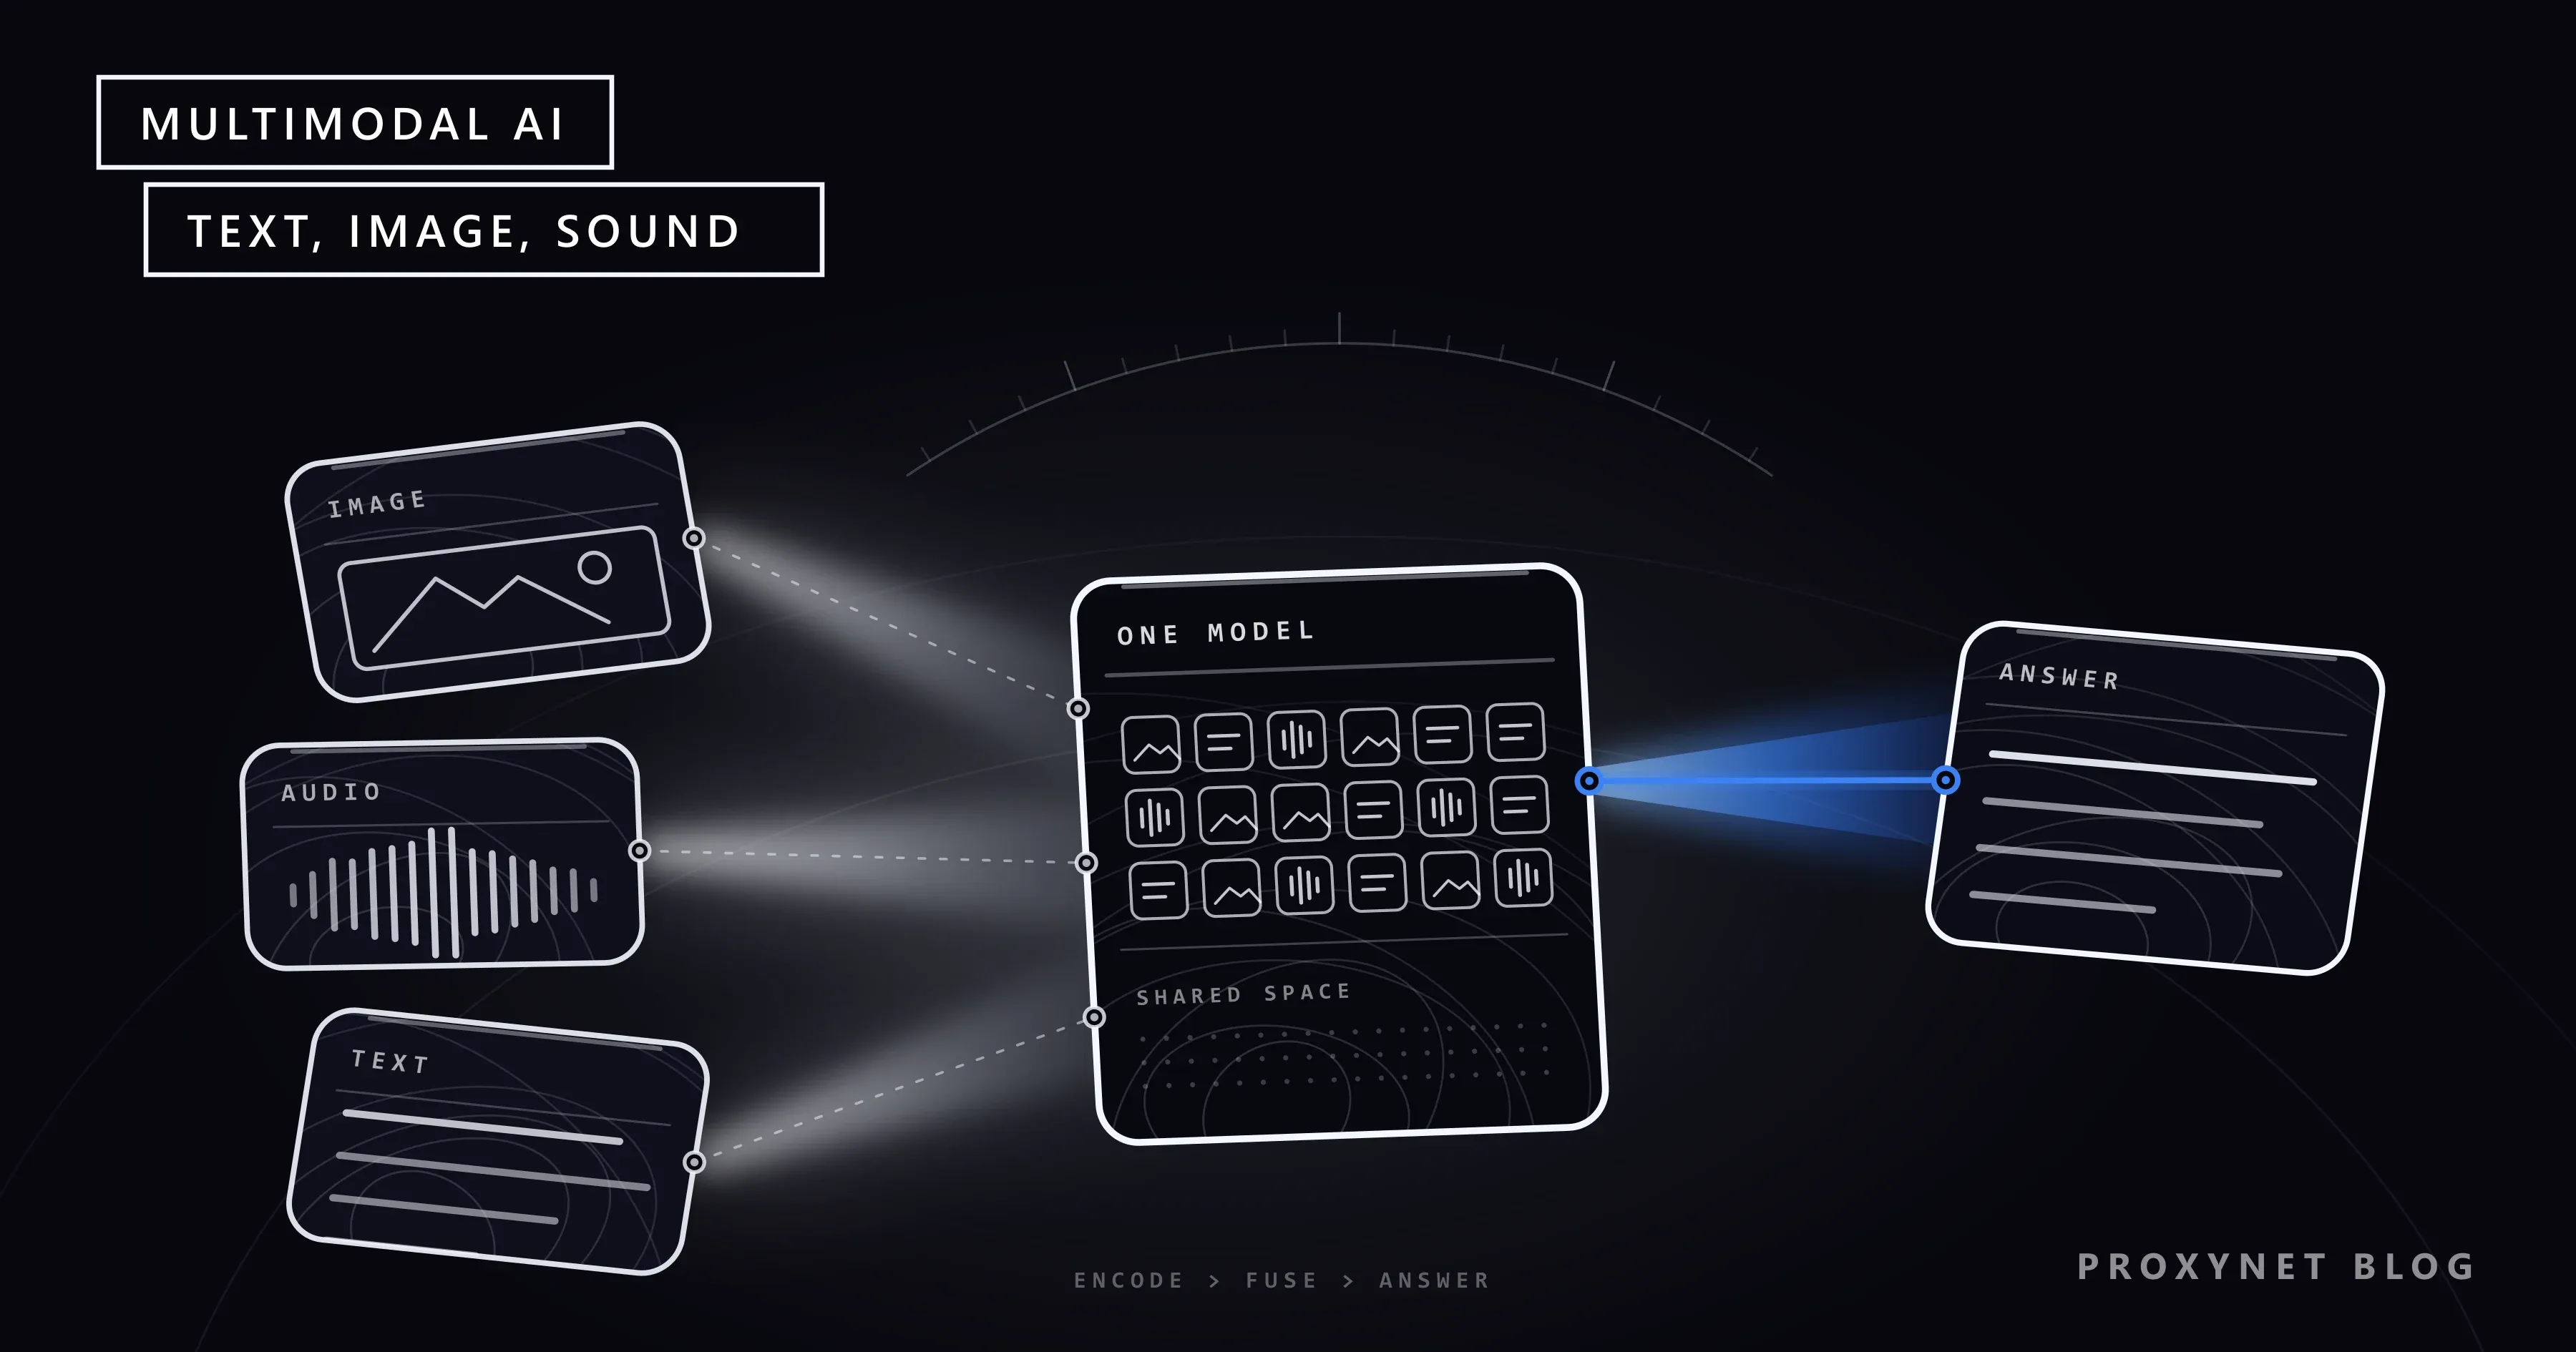
Multimodal bir model her girdiyi aynı birime, yani ortak bir uzaydaki vektörlere çevirir ve hepsini tek bir modelin değerlendirmesine bırakır. Tipik bir model beş adımda çalışır:
- Her girdi uygun kodlayıcıya gider. Metin, kelime parçaları olan token'lara bölünür; görsel bir görsel kodlayıcıya, ses de bir ses kodlayıcısına gider. Her kodlayıcı, kendi veri türü için eğitilmiş bir sinir ağıdır.
- Girdi parçalara ayrılır. Bir görsel transformer (vision transformer), görüntüyü küçük kare yamalara (patch) böler ve onları bir cümledeki kelimeler gibi ele alır. Ses ise çoğu zaman frekanslarının zaman içinde nasıl değiştiğini gösteren bir resme, yani spektrograma çevrilir ve kısa dilimler hâlinde okunur.
- Parçalar dil modelinin uzayına taşınır. Her yama ya da dilim bir vektöre dönüşür; bazen tek bir katmandan oluşan küçük bir bağlayıcı ağ, bu vektörleri dil modelinin kelime token'ları için kullandığı uzaya taşır.
- Model tek bir birleşik dizi üzerinde akıl yürütür. Dil modeli görsel vektörlerini, ses vektörlerini ve metin token'larını tek bir dizi olarak okur. Hangi parçanın hangisiyle ilgili olduğunu tartan dikkat (attention) mekanizması, sorunuzdaki "kırmızı olan" ifadesini fotoğrafın doğru yamasına bağlayabilir.
- Çıktı üretilir. Çıktı çoğunlukla metindir. Konuşabilen ya da görsel çizebilen modeller, çıktı token'larını yeniden sese ya da piksele çeviren kod çözücüler (decoder) ekler.
İşin anahtarı ortak uzaydır. OpenAI'ın CLIP modeli, 2021'de yayımlanan makalesinde anlatıldığı gibi, böyle bir uzayı basit bir görevle öğrendi: internetten toplanmış 400 milyon görsel-metin çiftinde hangi açıklamanın hangi görsele ait olduğunu tahmin etmek. Eğitimden sonra bir köpek fotoğrafı ile "a photo of a dog" (bir köpek fotoğrafı) metni vektör olarak birbirine yakın düşer; sonraki modeller de CLIP'in görsel kodlayıcısını kendi "gözü" olarak yeniden kullanır.
Erken ve geç birleştirme arasındaki fark nedir?
Birleştirme (fusion), farklı modalitelerden gelen bilginin bir araya getirildiği adımdır; aradaki fark, bunun ne zaman yapıldığıdır. Yukarıdaki derleme klasik ayrımı şöyle anlatır:
- Erken birleştirme (early fusion), her modalitenin özniteliklerini çıkarılır çıkarılmaz birleştirir.
- Geç birleştirme (late fusion), önce her modalitenin kendi kararını vermesini bekler, sonra bu kararları birleştirir.
- Karma birleştirme (hybrid fusion) ikisini bir arada kullanır.
Geç birleştirme hazır parçalarla kolayca kurulur ama modaliteler arasındaki bağı kaçırır; yalnızca fotoğrafla birlikte okununca alaycı olduğu anlaşılan bir gönderi metni buna örnektir. Google'ın Gemini teknik raporu ise modellerin görsel, ses, video ve metin üzerinde birlikte eğitildiğini söyler ve onları en baştan multimodal (natively multimodal) olarak niteler. Bunun karşıtı zincir (pipeline) tasarımıdır: konuşma tanıma sesinizi metne çevirir, yalnızca metinle çalışan bir model cevap verir, bir ses sentezleyici de cevabı okur. Ses tonu ve duraklamalar daha ilk adımda kaybolur.
Multimodal yapay zekâ hangi veri türlerini işler?
Multimodal modeller en çok dört modaliteyle çalışır:
| Modalite | Tipik girdi | Örnek görev |
|---|---|---|
| Metin | Sorular, belgeler, kod | Sözleşme özetlemek |
| Görsel | Fotoğraf, ekran görüntüsü, grafik, tarama | Fotoğraf betimlemek, grafik okumak |
| Ses | Konuşma, telefon görüşmesi, kayıt | Sesli bir soruyu cevaplamak |
| Video | Klip, ekran kaydı | Bir şeyin göründüğü anı bulmak |
PDF gibi belgeler metinle görselin arasında durur: model metin katmanını okuyabilir ya da sayfa düzeni, tablolar veya el yazısı önemliyse her sayfayı bir görsel gibi ele alabilir.
Girdide mi multimodal, çıktıda mı?
Bir model girdi tarafında, çıktı tarafında ya da her ikisinde multimodal olabilir; ürün sayfasındaki "multimodal" sözcüğü ise çoğu zaman hangisini kastettiğini söylemez.
- Multimodal girdi, metin çıktı. Model görseli, sesi ya da videoyu anlar ama yalnızca metinle cevap verir. Görsel-dil modelleri böyle çalışır.
- Metin girdi, başka çıktı. Metinden görsel ve metinden ses üreten modeller iki modalite arasında tek yönde geçiş yapar; herkes bunlara multimodal demez.
- Hem girdide hem çıktıda multimodal. OpenAI'ın GPT-4o için yayımladığı sistem kartı (system card, 2024), metin, ses, görsel ve video alıp metin, ses ve görsel üreten, hepsini aynı sinir ağıyla işleyen bir modeli anlatır.
Giren ve çıkan modaliteleri tek tek sayın; bu, etiketten daha fazlasını söyler.
Görsel-dil modeli nedir?
Görsel-dil modeli (vision-language model, VLM), girdi olarak görsel ve metin alıp metinle cevap veren multimodal bir modeldir. Multimodal yapay zekânın en yaygın türüdür; bir sohbete resim ekleyip onunla ilgili soru sorduğunuzda çalışan da odur.
Yaygın tarif üç parçayı birleştirir: önceden eğitilmiş bir görsel kodlayıcı, bir bağlayıcı ve önceden eğitilmiş bir dil modeli. LLaVA makalesi (Visual Instruction Tuning, 2023) bunun herkese açık, anlaşılır bir örneğidir: CLIP'in görsel kodlayıcısını, görsel özniteliklerini dil modelinin kelime uzayına taşıyan basit bir doğrusal katmanı ve Vicuna adlı açık bir dil modelini kullanır. Eğitim konuşmalarını, görselleri hiç görmeyen ve yalnızca metin işleyen GPT-4 yazdı; ona görsellerin açıklamaları ve nesne kutuları metin olarak verildi.
Bir görseldeki yazıyı okumak, OCR (optik karakter tanıma) denen daha eski ve daha dar bir iştir; OCR Nedir? yazısı nasıl çalıştığını ve ayrı bir OCR motorunun hâlâ ne zaman daha uygun olduğunu anlatıyor.
Multimodal yapay zekâ ile neler yapılabilir?
Multimodal yapay zekâ, sorunun cevabı görülen ya da duyulan bir şeye bağlı olduğunda işe yarar. Yaygın örnekler:
- Fotoğraf betimlemek: bir web sitesi için alternatif metin (alt text), görme engelli ya da az gören bir kullanıcı için açıklama, bir ürün görseli için kısa bir başlık.
- Grafik ya da pano okumak: bir ekran görüntüsü yükleyip düşüşün hangi ayda olduğunu sormak, sonra sayıyı kendiniz kontrol etmek.
- Bir belge hakkında soru sormak: taranmış bir sözleşme, tablolarla dolu bir sayfa, elle doldurulmuş bir form.
- Sesli konuşmak: ek sorularla süren bir sesli sohbet; bazen ne demek istediğinizi kameraya göstererek.
- Video içinde arama yapmak: iki saatlik bir kayıtta bir slaydın ya da ürünün göründüğü dakikayı bulmak.
- Ekranda iş görmek: tarayıcıyı ya da masaüstünü kullanan yapay zekâ ajanları, nereye tıklayacaklarına ekran görüntülerini okuyarak karar verir; yani onlar da multimodaldir.
Muhtemelen bu teknolojiyi adını koymadan zaten kullanıyorsunuz: sohbet uygulamalarındaki resim ve mikrofon düğmeleri, menüleri çeviren telefon kameraları, bir toplantı kaydını sunum slaytlarıyla birlikte özetleyen araçlar.
Multimodal yapay zekânın sınırları nelerdir?
Multimodal modeller, metin modellerinin yaptığı hataları yapar; bunlara görsele, sese ve videoya özgü bazı hatalar da eklenir:
- Olmayanı anlatmak. Model, görselde bulunmayan bir nesneyi, kelimeyi ya da sayıyı doğru bir cevapla aynı kendinden emin tonla söyleyebilir. Bu, yapay zekâ halüsinasyonunun görsel biçimidir ve çaresi de aynıdır: kanıt isteyin ve kontrol edin.
- Sayma ve ince ayrıntı. 2024 tarihli "Vision language models are blind" (Görsel-dil modelleri kördür) başlıklı çalışma, o dönemin en gelişmiş sayılan dört görsel-dil modelini yedi çok basit görevde denedi. Modeller, iki dairenin üst üste binip binmediği, iki çizginin kaç kez kesiştiği ya da bir kelimede hangi harfin daire içine alındığı gibi sorularda başarısız oldu.
- Küçük ve döndürülmüş yazı. Büyük görseller model görmeden önce küçültülür; bu yüzden ince yazılar okunamaz hâle gelebilir. Bulanık, döndürülmüş ya da çok küçük görseller hata oranını artırır.
- Önyargı. Web'den toplanan görsel-metin çiftleri web'deki dengesizlikleri de taşır: bazı diller, yazı sistemleri, bölgeler ve insan grupları ötekilerden çok daha sık görünür.
- Sahte görsel dedektörü değildir. Genel amaçlı bir model, bir görselin yapay zekâyla üretilip üretilmediğini güvenilir biçimde söyleyemez.
- Maliyet. Görseller ve ses çok sayıda token tüketir. Anthropic'in Claude modelleri için yayımladığı görsel işleme dokümantasyonuna göre bir görsel 28 x 28 piksellik yamalara bölünür ve her yama bir görsel token sayılır; bu yüzden 1.000 x 1.000 piksellik bir görsel, siz tek kelime yazmadan 1.296 token tutar.
Fotoğraflar, yüzler ve gizlilik konusunda nelere dikkat etmelisiniz?
Bir kişiyi ya da bir kişiyi tanımlayan bir şeyi gösteren her fotoğrafı kişisel veri sayın. Bir resimde yüzler, arka plandaki insanlar, bir kapı numarası, bir araç plakası ya da masada duran bir kimlik kartı görünebilir; dosyanın meta verisi de fotoğrafın nerede ve ne zaman çekildiğini kaydedebilir.
Hukuk, yüzler konusunda katıdır. AB'nin Genel Veri Koruma Tüzüğü (GDPR) uyarınca, bir kişiyi tanımlamaya yönelik özel teknik işlemden geçirilen yüz görüntüleri biyometrik veridir. Tüzüğün 9. maddesi, bir kişiyi benzersiz biçimde tanımlamak amacıyla biyometrik veri işlemeyi, istisnalarından biri uygulanmadıkça yasaklar; 51 numaralı gerekçe (Recital 51) ise sıradan bir fotoğrafın kendiliğinden bu kategoriye girmediğini ekler. Türkiye'de 6698 sayılı Kişisel Verilerin Korunması Kanunu'nun (KVKK) 6. maddesi de biyometrik verileri özel nitelikli kişisel veri sayar.
Bir işletme, müşteri ya da çalışan fotoğraflarını bir yapay zekâ aracına yüklemeden önce hukuki bir dayanağa sahip olmalı ve sağlayıcının yüklemeleri model eğitiminde kullanıp kullanmadığını kontrol etmelidir. Yüz tanıma ise kendi başına açık bir hukuki dayanak ister.
Multimodal yapay zekânın eğitim verisi nereden gelir?
Multimodal modeller; açıklamalı görseller, metne dökülmüş ses kayıtları ve altyazılı videolar gibi çok büyük eşleştirilmiş veri setlerinden öğrenir. Bu verinin önemli bir kısmı herkese açık web sayfalarından gelir; CLIP'in 400 milyon çifti de internetten toplanmıştı.
Kapsam, boyut kadar önemlidir. Menüleri, tabelaları ve fişleri yalnızca birkaç yazı sisteminde görmüş bir model ötekileri yanlış okur; tek bir ülkenin sayfalarından kurulan bir test seti de bu açığı gizler. Görseli bol sayfalar da çoğu zaman yerelleştirilmiştir: alışveriş ve seyahat siteleri, ziyaretçinin ülkesine göre farklı fotoğraflar, afişler ve görsel içi yazılar gösterir. Bu sayfaları yerel bir ziyaretçinin gördüğü hâliyle toplamak gerektiğinde Residential Proxy işe yarar: her istek, seçtiğiniz ülke ve şehirdeki bir ev bağlantısı üzerinden çıkar.
Yalnızca herkese açık sayfaları toplayın, görsellerle model eğitmeden önce lisanslarını kontrol edin, robots.txt'ye ve sitenin kullanım şartlarına uyun, istek hızını düşük tutun ve ihtiyacınız olmayan yüzleri ve kişisel verileri dışarıda bırakın. Toplama işini kendiniz yürütmek istemiyorsanız Web Scraping API'miz üzerinden sunduğumuz yönetilen sayfa çıkarma hizmeti için satış ekibimizle görüşebilirsiniz.
Sık yapılan hatalar
- Sayımlara ve ölçümlere güvenmek. Bir görsel-dil modelinin raftaki ürünler için verdiği sayıyı tahmin olarak görün.
- İnce yazıyı okutmak için dev bir ekran görüntüsü göndermek. Görsel önce küçültülür; önemli kısmı kırpıp gönderin.
- Akıcı bir betimlemeyi doğrulanmış saymak. Sayıları, adları ve alıntıları görselle karşılaştırın.
- Başkalarının yüzlerini ya da kimliklerini düşünmeden yüklemek. Bunlar kişisel veridir; yüzler özel nitelikli veri de olabilir.
- Yalnızca temiz örneklerle test etmek. Modele güvenmeden önce kötü ışığı, başka yazı sistemlerini, döndürülmüş sayfaları ve gürültülü sesi deneyin.
- İhtiyacınız olmayan çözünürlüğe para ödemek. Binlerce dosyada görsel token'ları hızla birikir.
Karar rehberi
| İhtiyaç | Kullanın |
|---|---|
| Çok sayıda taramadan basılı metin okumak | Ayrı bir OCR aracı, zor örnekler için VLM |
| Grafik ya da ekran görüntüsü hakkında soru | Görsel-dil modeli, ardından sayı kontrolü |
| Eller serbest sesli konuşma | Sesi doğrudan işleyen model ya da konuşma zinciri |
| Uzun bir videoda belirli bir anı bulmak | Video girdisi alan model ya da metin dökümü |
| Kesin sayım ya da ölçüm | Klasik bilgisayarlı görü ya da insan kontrolü |
| Yüz ya da kimlik kartı içeren fotoğraflar | Önce maskeleme; ticari kullanımda hukuki dayanak |
| Birçok ülkeden test verisi | Ülke ülke toplanan herkese açık sayfalar, lisans kontrolüyle |
Sıkça sorulan sorular
ChatGPT multimodal mı?
Evet. OpenAI'ın GPT-4o Sistem Kartı (2024), şirketin ChatGPT'deki Advanced Voice Mode adlı gelişmiş sesli sohbet özelliği için kullandığı GPT-4o'yu anlatır: model metin, ses, görsel ve video alır; metin, ses ve görsel üretir ve bunların hepsi üzerinde uçtan uca eğitilmiş tek bir ağdır. ChatGPT'deki modeller ve özellikler sık değişir ve plana göre farklılık gösterir; kendi sürümünüzün neler sunduğuna bakın.
Multimodal yapay zekâ ile üretken yapay zekâ arasındaki fark nedir?
Üretken yapay zekâ yeni içerik üretir; multimodal yapay zekâ ise birden fazla veri türüyle çalışır. Bir fotoğrafa bakıp cevap yazan bir asistan ikisi birden olur. Zararlı gönderileri metni ve görseliyle birlikte değerlendirerek işaretleyen bir sınıflandırıcı multimodaldir ama üretken değildir; yalnızca metinle çalışan bir sohbet botu ise bunun tersidir.
Görsel-dil modeli nedir?
Görsel-dil modeli, girdi olarak görsel ve metin alıp metinle cevap veren multimodal bir modeldir. Genellikle bir görsel kodlayıcıyı, küçük bir bağlayıcıyı ve büyük bir dil modelini birleştirir; "bu resim hakkında soru sor" türündeki özelliklerin çoğunun arkasında o vardır.
Multimodal yapay zekâ videoyu anlayabilir mi?
Evet; çoğunlukla videodan kareler seçip bunları ses kaydıyla ya da metin dökümüyle birlikte okuyarak. Google'ın Gemini raporu, videonun modelin bağlam penceresinde bir kare dizisi olarak kodlandığını anlatır. Yalnızca bazı kareler okunduğu için iki örnek kare arasındaki hızlı bir olay gözden kaçabilir; uzun videolar da çok sayıda token tüketir.
Multimodal mı, multi-model mi?
İki terim de kullanılır ve farklı şeyleri anlatır. Multimodal, birden fazla veri türünü; multi-model (çok modelli) ise birlikte çalışan birden fazla modeli, örneğin bir zincir hâlinde bağlanmış konuşma tanıyıcıyı, dil modelini ve ses sentezleyiciyi anlatır. Bir sistem ikisi birden olabilir.
Bir yapay zekâ aracına fotoğraf yüklemek güvenli mi?
Sıradan fotoğraflar için, aracın veri ayarlarını kontrol eder ve hassas ayrıntıları dışarıda tutarsanız makul ölçüde güvenlidir. Kimlik kartı, banka belgesi, sağlık kaydı ya da başkalarının fotoğraflarını izinleri olmadan yüklemeyin; işin gerektirmediği kısmı kırpın ve yüklediğiniz şeyin saklanabileceğini varsayın. İşletmeler ayrıca yüklemelerin model eğitiminde kullanılıp kullanılmadığını teyit etmelidir.
Özet
Multimodal yapay zekâ birden fazla veri türüyle çalışır. Kodlayıcılar görseli, sesi ve videoyu metinle aynı uzaydaki vektörlere çevirir; böylece tek bir model hepsini birlikte değerlendirip metinle, sesle ya da görselle cevap verebilir. En yaygın biçimi olan görsel-dil modelleri, fotoğraflar, grafikler ve belgeler hakkında soru sormanızı sağlar. Ancak bu modeller hâlâ yanlış sayabiliyor, küçük yazıyı yanlış okuyabiliyor ve olmayanı anlatabiliyor; insanların fotoğrafları da kişisel veridir. Cevapları kontrol edin, yüklemeden önce kırpın ve modelleri, kullanıcılarının bulunduğu yerlerden toplanmış herkese açık sayfalarla test edin.


