


































Eine Reisende fotografiert ein Parkschild in einer Sprache, die sie nicht lesen kann, und fragt ihr Handy, ob sie das Auto bis 18 Uhr dort stehen lassen darf. Ein Supportmitarbeiter bekommt statt einer Beschreibung einen unscharfen Screenshot eines Fehlerdialogs. Ein Ladenbesitzer spricht mit einem Assistenten, während er die Kamera auf ein Etikett richtet. Alle drei nutzen dieselbe Art von System: ein KI-Modell, das neben Wörtern auch mit Bildern und Ton arbeitet.
Dieser Beitrag erklärt, was multimodale KI und eine „Modalität“ sind, wie diese Modelle Bilder und Audio in etwas umwandeln, mit dem ein Sprachmodell arbeiten kann, was Vision-Language-Modelle leisten, wo sie scheitern und was Sie prüfen sollten, bevor Sie ein Foto hochladen.
Was ist multimodale KI?
Multimodale KI ist ein KI-Modell oder -System, das mit mehr als einer Datenart arbeitet, etwa mit Text, Bildern, Audio oder Video, und zwar bei der Eingabe, bei der Ausgabe oder bei beidem. Ein reiner Text-Chatbot ist unimodal: Wörter gehen hinein, Wörter kommen heraus. Ein Modell, das ein Foto Ihres Kühlschranks ansieht und ein Rezept vorschlägt oder eine Frage hört und laut antwortet, ist multimodal.
Das Wort selbst bedeutet nur „mehrere Wege nutzend“. Deshalb taucht es auch im Verkehr auf (eine Sendung per Lkw, Bahn und Schiff), in der Medizin (eine Behandlung, die mehrere Verfahren kombiniert) und in der Bildung, wo multimodales Lernen Unterricht mit Text, Bildern und Ton zugleich meint. Dieser Beitrag bleibt bei der Bedeutung in der KI.
Viele Chat-Assistenten nehmen inzwischen Bilder und Sprache an. Im Kern sind die meisten um ein großes Sprachmodell gebaut, also ein Modell, das mit riesigen Textmengen darauf trainiert wurde, das nächste Textstück vorherzusagen. Zusätzliche Bausteine bringen ihm bei, andere Datenarten zu verarbeiten.
Was ist eine Modalität in der KI?
Eine Modalität ist eine Datenart, bestimmt dadurch, wie die Information erfasst oder wahrgenommen wird: Sprache, Bilder, Video, Ton. Eine viel zitierte Übersichtsarbeit zum multimodalen maschinellen Lernen von Baltrusaitis, Ahuja und Morency (2017) definiert Modalität als „die Art und Weise, wie etwas geschieht oder erlebt wird“, und nennt ein Problem multimodal, wenn es mehrere davon umfasst.
Die Arbeit konzentriert sich auf drei: natürliche Sprache, geschrieben oder gesprochen; visuelle Signale wie Bilder und Video; und stimmliche Signale, die Klänge und den Tonfall einer Stimme tragen. Fachgebiete fügen weitere hinzu, etwa Sensormesswerte oder medizinische Bildgebung.
Wie funktioniert multimodale KI?
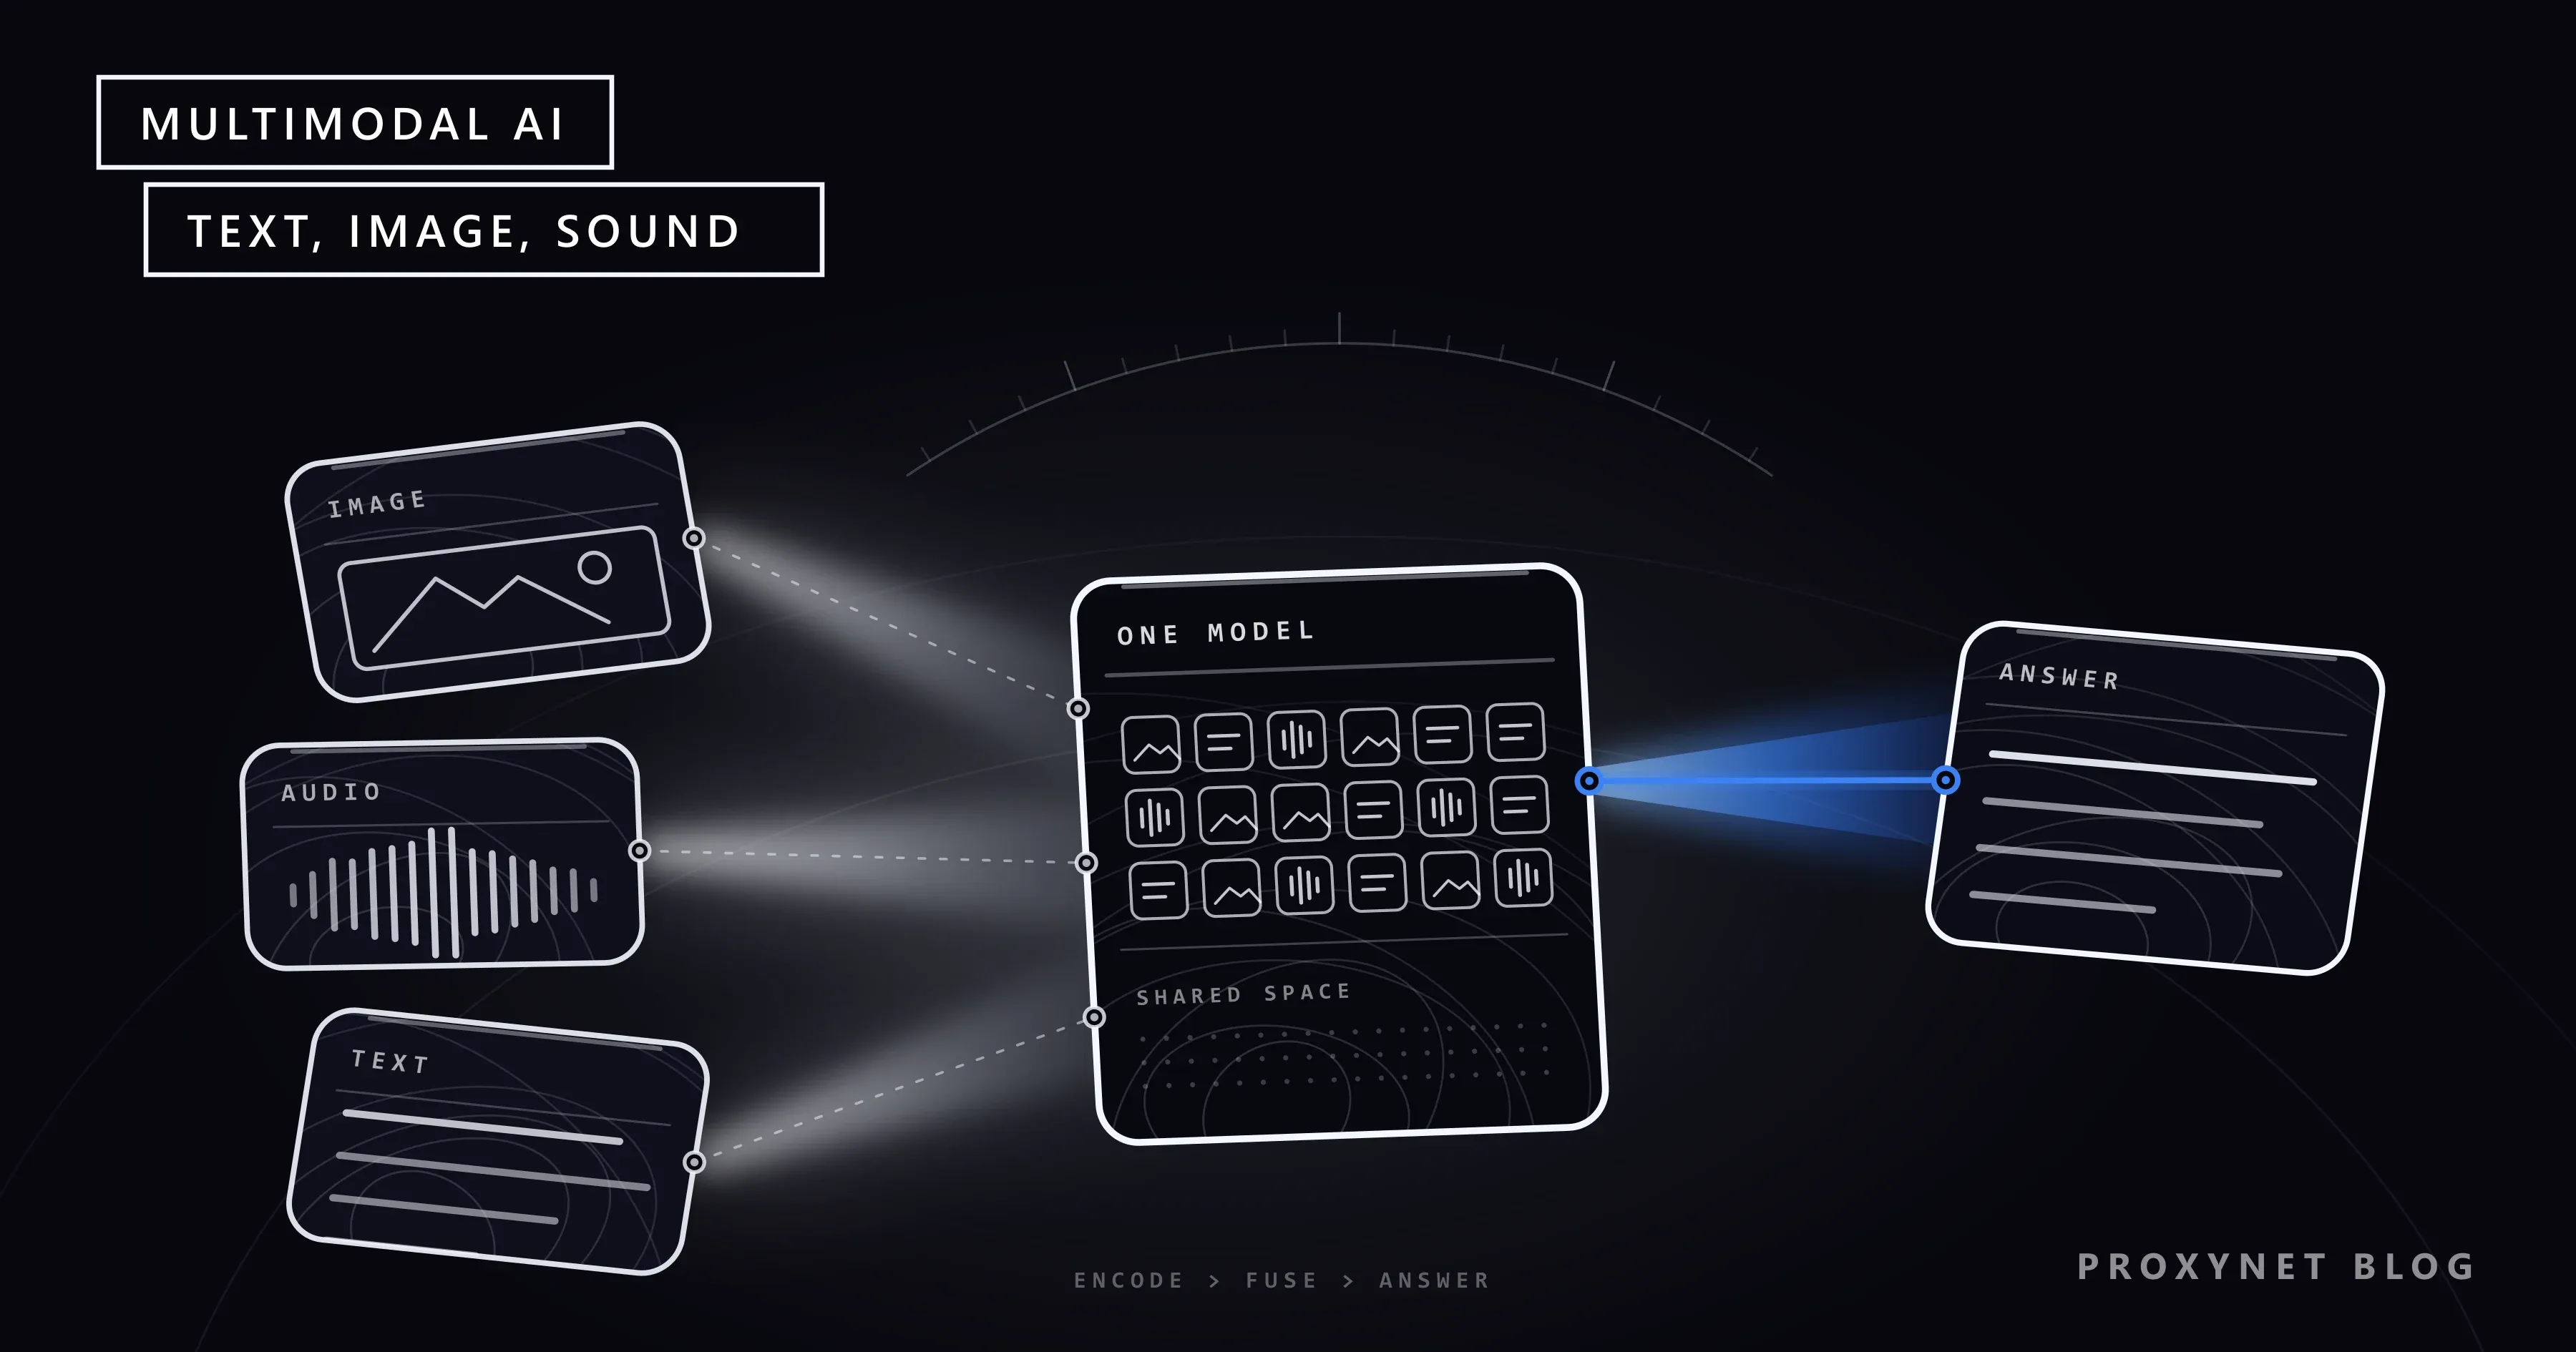
Ein multimodales Modell überführt jede Eingabe in dieselbe Währung, nämlich Vektoren in einem gemeinsamen Raum, und lässt ein einziges Modell über alle zusammen schlussfolgern. Ein typisches Modell arbeitet in fünf Schritten:
- Jede Eingabe an den passenden Encoder schicken. Text wird in Tokens zerlegt, kleine Wortteile; Bilder gehen an einen Bild-Encoder und Audio an einen Audio-Encoder. Jeder davon ist ein neuronales Netz, das für seine Datenart trainiert wurde.
- Die Eingabe in Stücke schneiden. Ein Vision Transformer zerlegt ein Bild in kleine quadratische Ausschnitte (Patches) und behandelt sie wie Wörter in einem Satz. Audio wird oft in ein Spektrogramm umgewandelt, ein Bild davon, wie sich die Frequenzen des Klangs über die Zeit ändern, und in kurzen Abschnitten gelesen.
- Die Stücke in den Raum des Sprachmodells abbilden. Jeder Patch oder Abschnitt wird zu einem Vektor. Ein kleines Verbindungsnetz (Connector), manchmal nur eine einzige Schicht, überträgt diese Vektoren in den Raum, den das Sprachmodell für Wort-Tokens nutzt.
- Über eine gemeinsame Folge schlussfolgern. Das Sprachmodell liest Bildvektoren, Audiovektoren und Text-Tokens als eine einzige Folge. Sein Aufmerksamkeitsmechanismus (Attention), also der Teil, der abwägt, welche Stücke füreinander wichtig sind, kann „das rote“ in Ihrer Frage mit dem richtigen Ausschnitt des Fotos verknüpfen.
- Die Ausgabe erzeugen. Meist ist das Text. Modelle, die auch sprechen oder zeichnen, ergänzen Decoder, die Ausgabe-Tokens wieder in Ton oder Pixel umwandeln.
Der gemeinsame Raum ist der Kerngedanke. Das CLIP-Modell von OpenAI, beschrieben in einem Fachartikel von 2021, hat einen solchen Raum über eine einfache Aufgabe gelernt: vorherzusagen, welche Bildunterschrift zu welchem Bild gehört, anhand von 400 Millionen Bild-Text-Paaren aus dem Internet. Danach liegen das Foto eines Hundes und die Wörter „a photo of a dog“ („ein Foto eines Hundes“) als Vektoren nah beieinander, und spätere Modelle nutzen den Bild-Encoder von CLIP als ihre Augen.
Was ist der Unterschied zwischen früher und später Fusion?
Fusion ist der Schritt, in dem Informationen aus verschiedenen Modalitäten zusammengeführt werden, und der Unterschied liegt im Zeitpunkt. Die oben genannte Übersichtsarbeit beschreibt die klassische Einteilung:
- Frühe Fusion (Early Fusion) verbindet die Merkmale jeder Modalität direkt nach ihrer Extraktion.
- Späte Fusion (Late Fusion) lässt jede Modalität zuerst eine eigene Entscheidung treffen und kombiniert dann die Entscheidungen.
- Hybride Fusion mischt beides.
Späte Fusion lässt sich leicht aus vorhandenen Bausteinen bauen, übersieht aber Zusammenhänge zwischen den Modalitäten, etwa eine Bildunterschrift, die erst durch das Bild sarkastisch wird. Der technische Bericht von Google zu Gemini sagt dagegen, die Modelle seien gemeinsam mit Bild, Audio, Video und Text trainiert worden, und nennt sie nativ multimodal. Das Gegenmodell ist eine Pipeline: Eine Spracherkennung wandelt Ihre Stimme in Text um, ein reines Textmodell antwortet und eine Sprachsynthese liest die Antwort vor. Tonfall und Pausen gehen dabei schon im ersten Schritt verloren.
Welche Daten kann multimodale KI verarbeiten?
Multimodale Modelle verarbeiten am häufigsten vier Modalitäten:
| Modalität | Typische Eingabe | Beispielaufgabe |
|---|---|---|
| Text | Fragen, Dokumente, Code | Einen Vertrag zusammenfassen |
| Bild | Fotos, Screenshots, Diagramme, Scans | Ein Foto beschreiben, ein Diagramm lesen |
| Audio | Sprache, Anrufe, Aufnahmen | Eine gesprochene Frage beantworten |
| Video | Clips, Bildschirmaufnahmen | Den Moment finden, in dem etwas auftaucht |
Dokumente wie PDFs liegen dazwischen: Ein Modell kann ihre Textebene lesen oder jede Seite als Bild behandeln, wenn Layout, Tabellen oder Handschrift wichtig sind.
Multimodal bei der Eingabe oder bei der Ausgabe?
Ein Modell kann auf der Eingabeseite, auf der Ausgabeseite oder auf beiden multimodal sein, und das Wort „multimodal“ auf einer Produktseite verrät selten, was davon gemeint ist.
- Multimodale Eingabe, Textausgabe. Das Modell versteht Bilder, Audio oder Video, antwortet aber nur in Text. So arbeiten Vision-Language-Modelle.
- Texteingabe, andere Ausgabe. Text-zu-Bild- und Text-zu-Sprache-Modelle verbinden zwei Modalitäten in einer Richtung; nicht alle nennen sie multimodal.
- Multimodal bei Ein- und Ausgabe. Die System Card von OpenAI zu GPT-4o (2024) beschreibt ein Modell, das Text, Audio, Bilder und Video annimmt und Text, Audio und Bilder erzeugt, wobei ein einziges neuronales Netz alles verarbeitet.
Notieren Sie, welche Modalitäten hineingehen und welche herauskommen; das sagt mehr als das Etikett.
Was ist ein Vision-Language-Modell?
Ein Vision-Language-Modell (VLM) ist ein multimodales Modell, das Bilder und Text als Eingabe nimmt und in Text antwortet. Es ist die verbreitetste Form multimodaler KI, und genau dieses Modell arbeitet, wenn Sie einem Chat ein Bild anhängen und dazu eine Frage stellen.
Das übliche Rezept verbindet einen vortrainierten Bild-Encoder, einen Connector und ein vortrainiertes Sprachmodell. Das LLaVA-Paper (Visual Instruction Tuning, 2023) ist ein anschauliches öffentliches Beispiel: Es nutzte den Bild-Encoder von CLIP, eine einfache lineare Schicht, die Bildmerkmale in den Wortraum des Sprachmodells überträgt, und ein offenes Sprachmodell namens Vicuna. Die Trainingsdialoge schrieb ein reines Text-GPT-4, das die Bilder nie gesehen hat; es erhielt ihre Bildunterschriften und die Bounding Boxes der Objekte als Text.
Text aus einem Bild zu lesen ist eine ältere und engere Aufgabe, die OCR (Texterkennung) heißt, kurz für optische Zeichenerkennung. Was ist OCR? erklärt, wie sie funktioniert und wann eine spezialisierte OCR-Engine weiterhin das passendere Werkzeug ist.
Was können Sie mit multimodaler KI tun?
Multimodale KI hilft überall dort, wo eine Frage von etwas abhängt, das man sehen oder hören kann. Typische Beispiele:
- Ein Foto beschreiben: Alternativtext für eine Website, eine Beschreibung für blinde oder sehbehinderte Menschen, eine Bildunterschrift für ein Produktbild.
- Ein Diagramm oder Dashboard lesen: einen Screenshot hochladen und fragen, in welchem Monat der Einbruch kam, und die Zahl dann selbst prüfen.
- Fragen zu einem Dokument stellen: ein gescannter Vertrag, eine Seite voller Tabellen, ein handschriftlich ausgefülltes Formular.
- Sprachgespräche führen: ein gesprochener Dialog mit Rückfragen, manchmal während Sie der Kamera zeigen, was Sie meinen.
- In Videos suchen: in einer zweistündigen Aufnahme die Minute finden, in der eine Folie oder ein Produkt erscheint.
- Am Bildschirm arbeiten: Agenten, die einen Browser oder Desktop bedienen, lesen Screenshots, um zu entscheiden, wohin sie klicken; auch sie sind also multimodal.
Wahrscheinlich begegnen Sie ihr schon: in den Bild- und Mikrofon-Schaltflächen von Chat-Apps, in Handykameras, die Speisekarten übersetzen, in Meeting-Tools, die eine Aufzeichnung samt Folien zusammenfassen.
Wo liegen die Grenzen multimodaler KI?
Multimodale Modelle machen dieselben Fehler wie Textmodelle und dazu einige, die zu Bildern, Ton und Video gehören:
- Beschreiben, was nicht da ist. Ein Modell kann ein Objekt, ein Wort oder eine Zahl nennen, die im Bild nicht vorkommt, im selben selbstsicheren Ton wie eine richtige Antwort. Das ist die visuelle Form der KI-Halluzination, und die Abhilfe ist dieselbe: Belege verlangen und prüfen.
- Zählen und feine Details. Eine Studie von 2024 mit dem Titel „Vision language models are blind“ („Vision-Language-Modelle sind blind“) testete vier VLMs auf dem damaligen Stand der Technik mit sieben sehr einfachen Aufgaben. Die Modelle scheiterten an Fragen wie der, ob sich zwei Kreise überlappen, wie oft sich zwei Linien kreuzen oder welcher Buchstabe in einem Wort eingekreist ist.
- Kleine und gedrehte Schrift. Große Bilder werden verkleinert, bevor das Modell sie sieht, sodass Kleingedrucktes unlesbar werden kann. Unscharfe, gedrehte oder winzige Bilder erhöhen die Fehlerquote.
- Verzerrung (Bias). Bild-Text-Paare aus dem Web tragen die Ungleichgewichte des Webs in sich: Manche Sprachen, Schriften, Regionen und Personengruppen kommen weit häufiger vor als andere.
- Kein Fälschungsdetektor. Ein allgemeines Modell kann nicht zuverlässig erkennen, ob ein Bild von einer KI erzeugt wurde.
- Kosten. Bilder und Audio verbrauchen viele Tokens. Laut der Vision-Dokumentation von Anthropic für die Claude-Modelle wird ein Bild in Patches von 28 × 28 Pixeln zerlegt, von denen jeder ein visuelles Token ist. Ein Bild mit 1.000 × 1.000 Pixeln kostet so 1.296 Tokens, bevor Sie ein einziges Wort tippen.
Wie gehen Sie mit Fotos, Gesichtern und Datenschutz um?
Behandeln Sie ein Foto als personenbezogene Daten, sobald es eine Person zeigt oder etwas, das eine Person identifiziert. Auf einem Bild können Gesichter zu sehen sein, Menschen im Hintergrund, eine Hausnummer, ein Kfz-Kennzeichen oder ein Ausweis auf dem Tisch, und die Metadaten der Datei können festhalten, wo und wann es aufgenommen wurde.
Bei Gesichtern ist das Recht streng. Nach der Datenschutz-Grundverordnung (DSGVO) der EU sind Gesichtsbilder, die mit speziellen technischen Verfahren verarbeitet werden, um eine Person zu identifizieren, biometrische Daten. Artikel 9 untersagt die Verarbeitung biometrischer Daten zur eindeutigen Identifizierung einer natürlichen Person, sofern keine seiner Ausnahmen greift, und Erwägungsgrund 51 stellt klar, dass ein gewöhnliches Foto nicht automatisch in diese Kategorie fällt. In Türkiye zählt auch Artikel 6 des Gesetzes Nr. 6698 über den Schutz personenbezogener Daten (KVKK) biometrische Daten zu den besonderen Kategorien personenbezogener Daten.
Ein Unternehmen braucht eine Rechtsgrundlage, bevor Fotos von Kunden oder Beschäftigten in ein KI-Werkzeug gelangen, und sollte prüfen, ob der Anbieter mit hochgeladenen Dateien trainiert. Gesichtserkennung braucht eine eigene, klare Rechtsgrundlage.
Woher kommen die Trainingsdaten für multimodale KI?
Multimodale Modelle lernen aus sehr großen Mengen gepaarter Daten, etwa Bildern mit Bildunterschriften, Audio mit Transkripten und Video mit Untertiteln, vieles davon von öffentlichen Webseiten; auch die 400 Millionen Paare von CLIP stammten aus dem Internet.
Die Abdeckung zählt so viel wie die Menge. Ein Modell, das Speisekarten, Schilder und Kassenbons nur in wenigen Schriften gesehen hat, liest die übrigen falsch, und ein Testdatensatz aus den Seiten eines einzigen Landes verdeckt diese Lücke. Bildlastige Seiten sind zudem oft lokalisiert: Shops und Reiseportale zeigen je nach Land des Besuchers andere Fotos, Banner und Texte in Bildern. Um diese Seiten so zu erheben, wie ein lokaler Besucher sie sieht, eignet sich ein Residential-Proxy, denn er leitet jede Anfrage über einen privaten Internetanschluss in dem Land und der Stadt Ihrer Wahl ins Netz.
Erheben Sie nur öffentliche Seiten, prüfen Sie die Lizenz von Bildern, bevor Sie damit trainieren, beachten Sie robots.txt und die Nutzungsbedingungen der Website, halten Sie die Anfragerate niedrig und lassen Sie Gesichter und personenbezogene Daten weg, die Sie nicht brauchen. Wenn Sie die Erhebung nicht selbst betreiben möchten, können Sie mit unserem Vertriebsteam über die verwaltete Seitenextraktion unserer Web Scraping API sprechen.
Häufige Fehler
- Zählungen und Messungen vertrauen. Behandeln Sie die Zahl der Artikel in einem Regal, die ein VLM nennt, als Schätzung.
- Einen riesigen Screenshot schicken, um Kleingedrucktes zu lesen. Er wird vorher verkleinert; schneiden Sie den wichtigen Teil zu.
- Eine flüssige Beschreibung für geprüft halten. Gleichen Sie Zahlen, Namen und Zitate mit dem Bild ab.
- Gesichter oder Ausweise anderer Menschen leichtfertig hochladen. Das sind personenbezogene Daten, und Gesichter können zu den besonderen Kategorien gehören.
- Nur mit sauberen Beispielen testen. Probieren Sie zuerst schlechtes Licht, andere Schriften, gedrehte Seiten und verrauschtes Audio.
- Für Auflösung zahlen, die Sie nicht brauchen. Bild-Tokens summieren sich bei Tausenden Dateien schnell.
Entscheidungshilfe
| Bedarf | Lösung |
|---|---|
| Gedruckten Text aus vielen Scans lesen | Spezialisierte OCR, VLM für schwierige Fälle |
| Fragen zu einem Diagramm oder Screenshot | Ein Vision-Language-Modell, danach Zahlen prüfen |
| Sprachgespräch ohne Hände | Ein Modell, das Sprache direkt verarbeitet, oder eine Sprach-Pipeline |
| Einen Moment in einem langen Video finden | Ein Modell mit Videoeingabe oder ein Transkript |
| Exakte Zählungen oder Messungen | Klassisches maschinelles Sehen oder menschliche Prüfung |
| Fotos mit Gesichtern oder Ausweisen | Zuerst schwärzen; Rechtsgrundlage bei geschäftlicher Nutzung |
| Testdaten aus vielen Ländern | Öffentliche Seiten, pro Land erhoben, Lizenzen geprüft |
Häufige Fragen
Ist ChatGPT multimodal?
Ja. Die GPT-4o System Card von OpenAI (2024) beschreibt GPT-4o, das Modell, das OpenAI für die Sprachfunktion Advanced Voice Mode in ChatGPT eingesetzt hat. Es nimmt laut dem Dokument Text, Audio, Bilder und Video an, erzeugt Text, Audio und Bilder und ist ein einziges Netz, das durchgängig (End-to-End) über all diese Modalitäten trainiert wurde. Die Modelle und Funktionen in ChatGPT ändern sich oft und unterscheiden sich je nach Abo; prüfen Sie daher, was Ihre Version bietet.
Was ist der Unterschied zwischen multimodaler KI und generativer KI?
Generative KI erzeugt neue Inhalte, multimodale KI verarbeitet mehr als eine Datenart. Ein Assistent, der ein Foto ansieht und eine Antwort schreibt, ist beides. Ein Klassifikator, der schädliche Beiträge anhand von Text und Bild markiert, ist multimodal, aber nicht generativ; ein reiner Text-Chatbot ist das Gegenteil.
Was ist ein Vision-Language-Modell?
Ein Vision-Language-Modell ist ein multimodales Modell, das Bilder und Text als Eingabe nimmt und in Text antwortet. Meist kombiniert es einen Bild-Encoder, einen kleinen Connector und ein großes Sprachmodell, und es steckt hinter den meisten Funktionen nach dem Muster „Frag etwas zu diesem Bild“.
Kann multimodale KI Videos verstehen?
Ja, meist indem sie in Abständen Einzelbilder (Frames) entnimmt und sie zusammen mit der Tonspur oder einem Transkript liest. Der Gemini-Bericht von Google beschreibt, dass Video als Folge von Einzelbildern im Kontextfenster des Modells kodiert wird. Weil nur ein Teil der Bilder gelesen wird, kann ein kurzes Ereignis zwischen zwei Stichproben untergehen, und lange Videos verbrauchen viele Tokens.
Heißt es multimodale oder Multi-Model-KI?
Beide Begriffe gibt es, und sie meinen Verschiedenes. Multimodal bezieht sich auf mehrere Datenarten, Multi-Model auf mehrere Modelle, die zusammenarbeiten, etwa eine Spracherkennung, ein Sprachmodell und eine Sprachsynthese in einer Kette. Ein System kann beides sein.
Ist es sicher, Fotos in ein KI-Tool hochzuladen?
Bei gewöhnlichen Bildern ist es einigermaßen sicher, wenn Sie die Dateneinstellungen des Tools prüfen und sensible Details weglassen. Laden Sie keine Ausweise, Bankunterlagen, Krankenakten oder Fotos anderer Menschen ohne deren Einwilligung hoch, schneiden Sie weg, was die Aufgabe nicht braucht, und gehen Sie davon aus, dass der Upload gespeichert werden kann. Unternehmen sollten außerdem klären, ob hochgeladene Dateien für das Training genutzt werden.
Fazit
Multimodale KI arbeitet mit mehr als einer Datenart. Encoder wandeln Bilder, Ton und Video in Vektoren im selben Raum wie Text um, sodass ein Modell über alles zusammen schlussfolgern und in Text, Sprache oder Bildern antworten kann. Vision-Language-Modelle, die häufigste Form, ermöglichen Fragen zu Fotos, Diagrammen und Dokumenten. Sie verzählen sich noch, lesen kleine Schrift falsch und beschreiben Dinge, die nicht da sind, und Fotos von Menschen sind personenbezogene Daten. Prüfen Sie die Antworten, schneiden Sie Bilder vor dem Hochladen zu und testen Sie Modelle mit öffentlichen Seiten, die dort erhoben wurden, wo ihre Nutzer sind.


