Bir belediyenin açık veri portalından air-quality-2025.zip adlı bir dosya indiriyorsunuz. İçinden üç dosya çıkıyor: her ölçüm istasyonu için saatte bir satır içeren bir CSV, "veri sözlüğü" adlı kısa bir PDF ve lisans metnini taşıyan bir metin dosyası. Sayılar CSV'de duruyor, ama CSV tek başına pm25 sütununun saatlik mi günlük mü ortalama olduğunu, saatlerin yerel saat mi UTC mi olduğunu ya da bu veriden yaptığınız bir grafiği yayımlayıp yayımlayamayacağınızı söylemiyor. Veri seti bu üç dosyanın toplamıdır; CSV tek başına yalnızca veridir.
Bu yazıda veri setinin ne olduğunu, satırlarını, sütunlarını ve türlerini, bir veri setinin nasıl oluşturulduğunu ve makine öğrenmesi için nasıl bölündüğünü, bilinen örnekleri, kaynakları, dosya biçimlerini, lisansları, belgelemeyi ve kişisel verileri ele alıyoruz.
Veri seti nedir?
Veri seti, tek bir konu hakkında, aynı ayrıntı düzeyinde kaydedilmiş ve bir bütün olarak analiz edilmek üzere bir arada tutulan verilerdir. Bir mağazanın sipariş geçmişi, bir meteoroloji istasyonunun saatlik ölçümleri ve trafik işaretlerinin etiketlenmiş 10.000 fotoğrafı birer veri setidir; çünkü her birinde bütün kayıtlar aynı türden bir şeyi aynı biçimde anlatır.
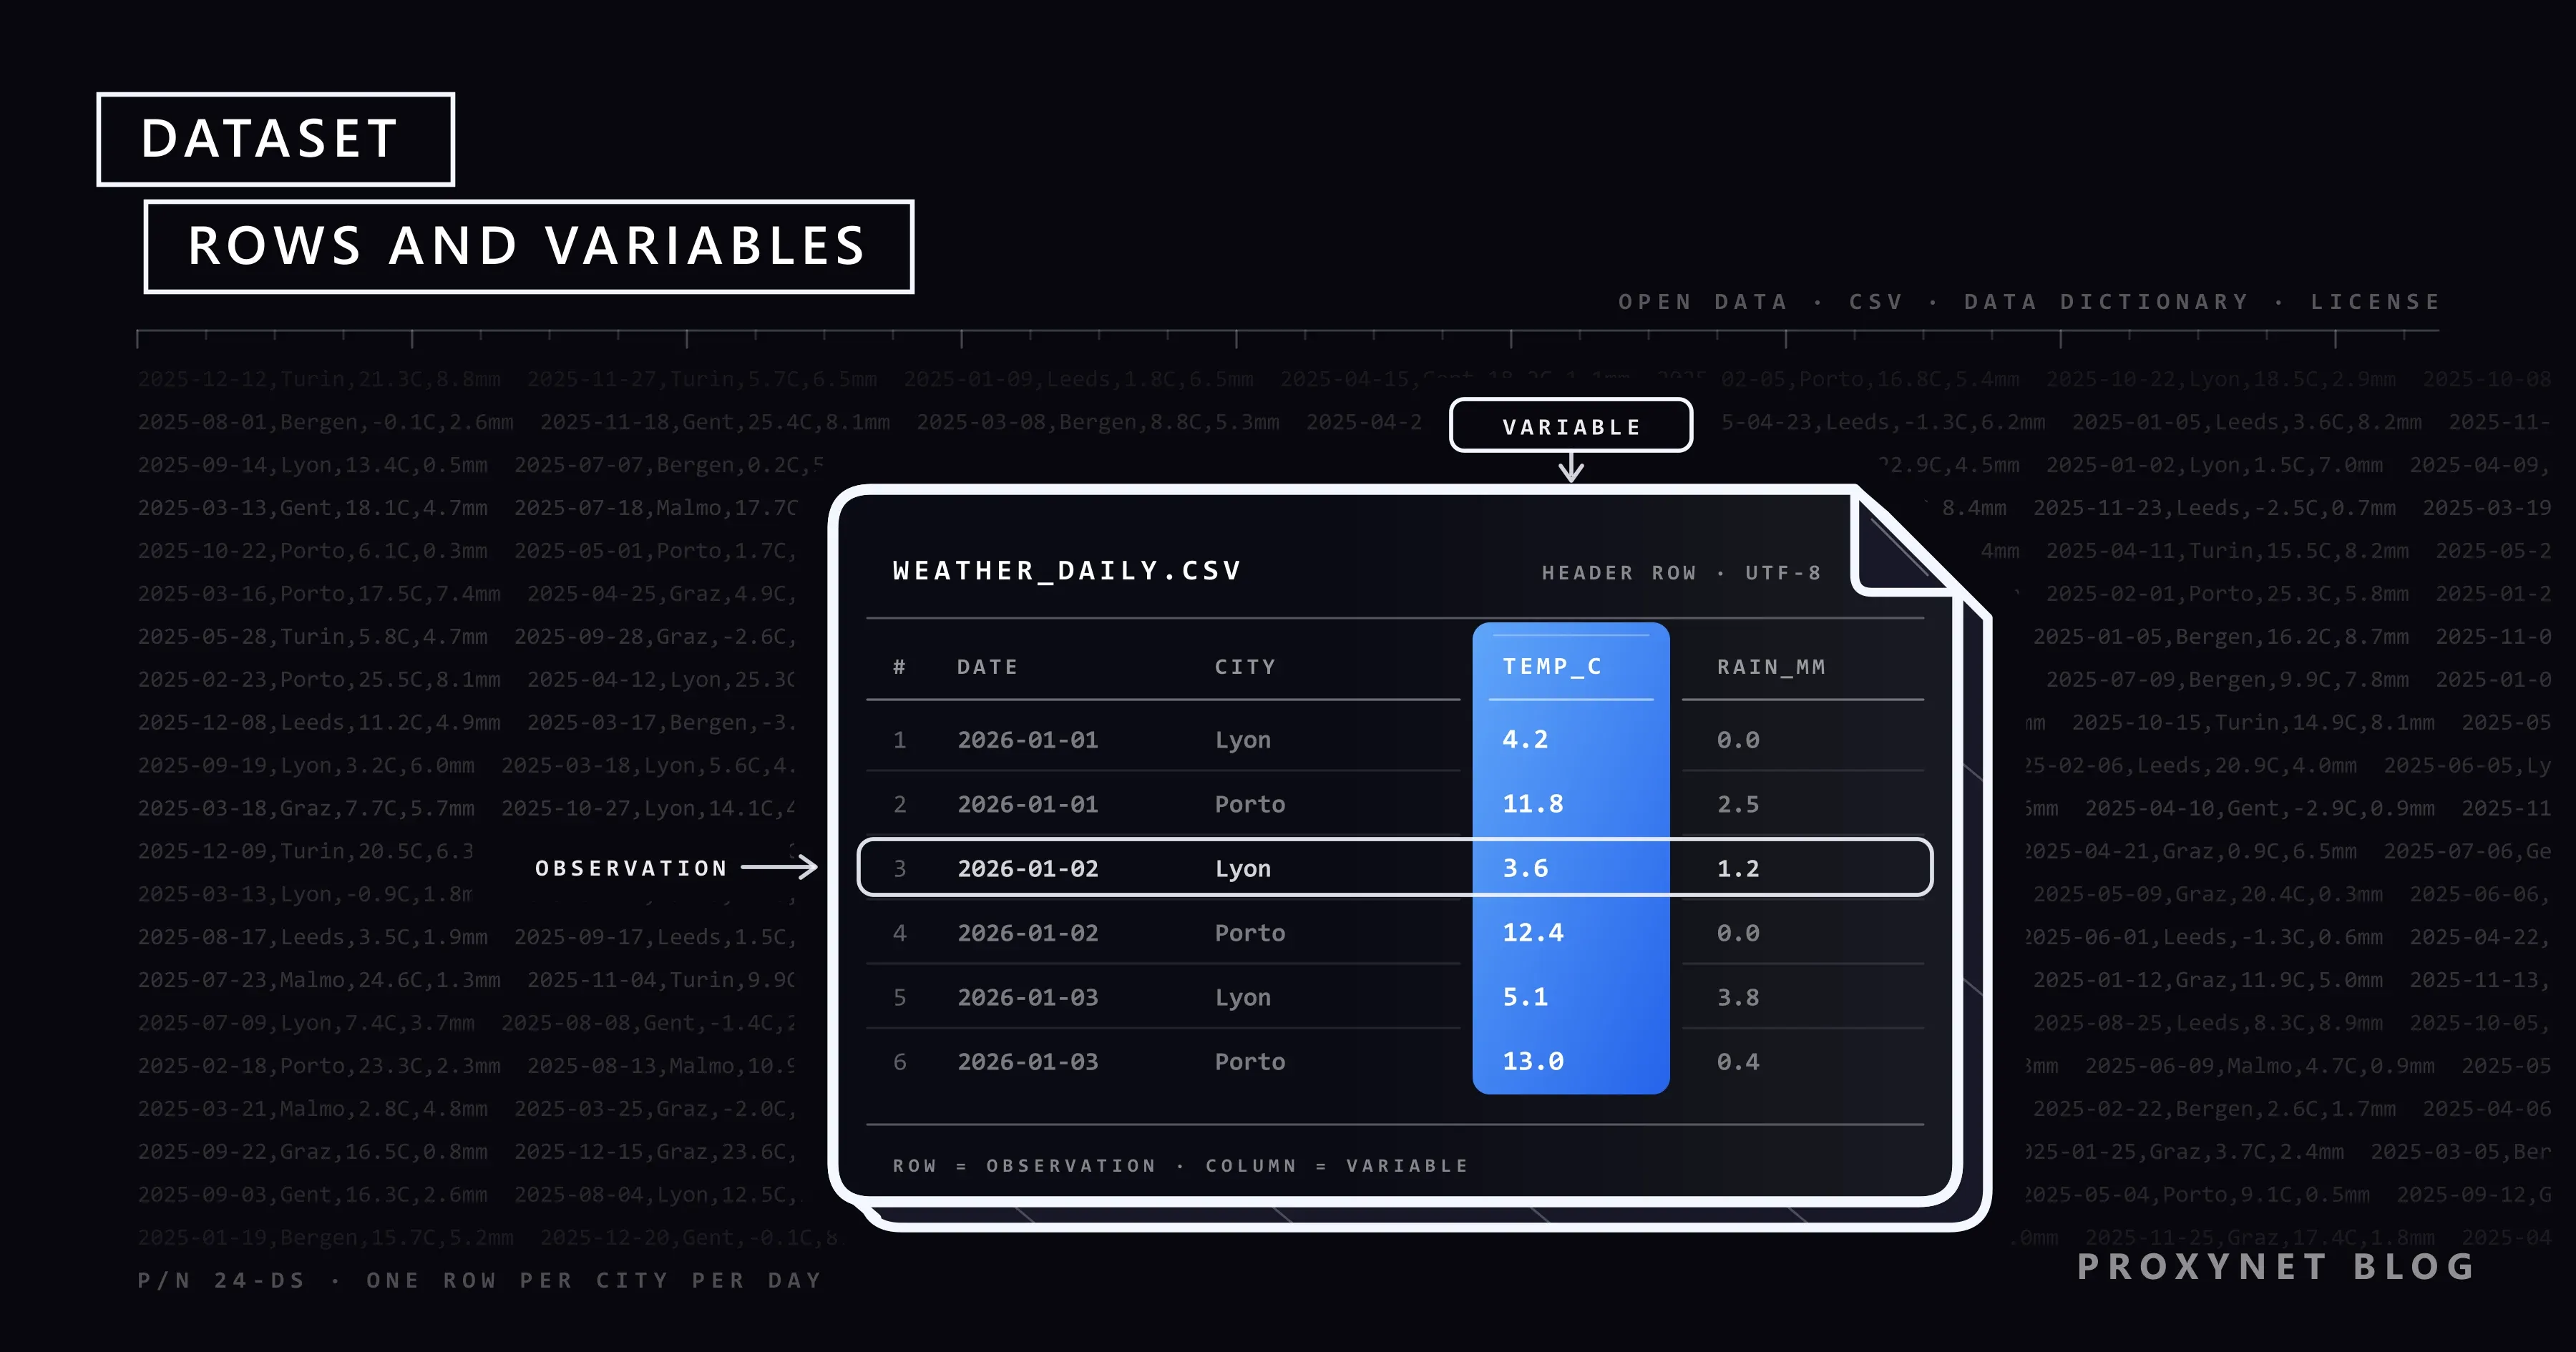
İş hayatında karşılaşılan veri setlerinin çoğu tablodur. Aşağıda küçük bir hava durumu veri setinin ilk satırları CSV biçiminde, yani değerleri virgülle ayrılmış olarak duruyor:
date,city,temp_c,rain_mm
2026-01-01,Lyon,4.2,0.0
2026-01-01,Porto,11.8,2.5
2026-01-02,Lyon,3.6,1.2
Başlıktan sonraki her satır bir gözlemdir: bir şehrin bir günü. Her sütun, her gözlem için kaydedilen bir değişkendir; bir satırla bir sütunun kesiştiği yerde de 4,2 derece gibi bir değer bulunur. Bir satırın anlattığı şeye gözlem birimi denir. Onu baştan belirlemek (her sensör ölçümü için değil, her şehrin her günü için bir satır) veri setinin geri kalanını şekillendirir.
Veri setinde satır, sütun ve değer nedir?
Satırlar gözlemdir, sütunlar değişkendir ve her hücrede tam olarak bir değer bulunur. Çoğu zaman "tidy data" (düzenli veri) diye anılan bu düzen, veri setini filtrelemeyi, toplamayı ve başka bir tabloyla birleştirmeyi kolaylaştırır; çünkü analiz araçlarının neredeyse hepsi her satırda bir gözlem bekler. Birleştirilmiş hücreleri ve arada ara toplamları olan bir elektronik tablo, tabloya benzese de bu kuralı bozar.
Değişkenin türü, onunla neyi hesaplayabileceğinizi belirler:
- Sayısal: ölçümler (4,2 derece) ya da sayımlar (3 sipariş). Ortalama almak anlamlıdır.
- Kategorik: şehir gibi sabit bir kümeden gelen etiketler. Bunları sayarsınız; "ortalama şehir" diye bir şey yoktur.
- Tarih ve saat: biçimi ve saat dilimi bilindiğinde karşılaştırılabilir.
- Metin: yorumlar gibi serbest metin; analizden önce işlenmesi gerekir.
- Kimlik: bir satırı başka tablolara bağlayan sipariş numarası ya da ürün kodu. Sayıya benzer ama ortalaması alınmaz.
Veri sözlüğü, her değişkeni türü, birimi ve alabileceği değerlerle birlikte listeler. Veri sözlüğü yoksa temp adlı bir sütun Celsius da olabilir Fahrenheit de; boş bir hücre de sıfır, bilinmiyor ya da bu satır için geçerli değil anlamına gelebilir.
İstatistikte veri seti ne demektir?
İstatistikte ve okul matematiğinde veri seti, analiz ettiğiniz değerlerin listesidir ve çoğu zaman tek bir değişkenden oluşur. Bir sınavdan alınan 4, 7, 7, 9 ve 13 puanları, beş değerden oluşan bir veri setidir: açıklığı 13 − 4 = 9, ortancası (sıralanınca ortada kalan değer) 7, tepe değeri (en sık geçen değer) 7, aritmetik ortalaması da 40 ÷ 5 = 8'dir.
12 sütunlu bir tablo da aynı gözlemler için yan yana kaydedilmiş on iki listedir ve değişkenleri bu sayede karşılaştırabilirsiniz; örneğin yağmurlu günlerin daha soğuk olup olmadığına bakabilirsiniz.
Veri seti türleri nelerdir?
Veri setleri, verinin ne kadar katı bir yapıya sahip olduğuna ve tek bir kaydın neye benzediğine göre gruplanır. Yapılandırılmış veri, elektronik tablo gibi sabit sütunlara oturur. Yarı yapılandırılmış veri kendi etiketlerini taşır ama sabit bir tablosu yoktur; bir API'den gelen JSON ya da key=value çiftleri içeren log satırları buna örnektir. Serbest metin, görüntü ve ses gibi yapılandırılmamış verinin önceden tanımlanmış alanları yoktur ve analizden önce genellikle etiketlenmesi ya da özelliklerinin çıkarılması gerekir.
Tek bir kaydın biçimine göre en sık karşılaşılan türler şunlardır:
| Tür | Bir kayıt nedir? | Örnek | Yaygın biçim |
|---|---|---|---|
| Tablo | Sabit alanlı bir gözlem | Siparişler, anket cevapları | CSV, Excel, Parquet |
| Zaman serisi | Bir andaki bir değer | Saatlik sıcaklık | CSV, Parquet |
| Panel | Bir birimin bir andaki hâli | 500 ürünün günlük fiyatı | CSV, Parquet |
| Metin | Bir belge | Yorumlar, haberler | JSON Lines, TXT |
| Görüntü ya da ses | Bir dosya ve etiketi | "Kedi" etiketli fotoğraflar | Klasörler + etiket dosyası |
| Graf | Bir düğüm ya da bağlantı | Web sayfaları arası linkler | Kenar listeleri, JSON |
Zaman serisi tek bir şeyi zaman içinde izler, yatay kesit veri seti pek çok şeyin tek bir andaki fotoğrafıdır, panel veri ise ikisini birleştirir. Zaman serisinde her değer kendinden öncekilere bağlıdır; bu yüzden anket cevaplarının aksine satırlarının sırası değiştirilemez.
Veri seti nasıl oluşturulur?
Bir veri seti oluşturmak için önce tek bir satırın neyi temsil edeceğine karar verilir, sonra her satır aynı yöntemle toplanır ve bunun nasıl yapıldığı yazıya dökülür:
- Soruyu tanımlayın. "Fiyatlarımız her hafta üç rakibin fiyatlarına göre nerede duruyor?" sorusu kapsamı belirler.
- Gözlem birimini seçin. Bu örnekte: her ürün, her rakip ve her gün için bir satır.
- Değişkenleri seçin. Ürün kodu, rakip, fiyat, para birimi, stok durumu ve toplama zamanı; her biri türü ve birimiyle.
- Veriyi toplayın. Kendi sistemlerinizden, bir API'den, resmî bir indirme sayfasından ya da herkese açık web sayfalarından; her satır için aynı yöntemle.
- Kontrol edin ve temizleyin. Yinelenen kayıtları çıkarın, türleri düzeltin, eksik değerleri işaretleyin; bu kontrollerin her yeni partide çalışan kurallara nasıl dönüştürüleceğini Veri Kalitesi Nedir? yazısında anlattık.
- Belgeleyin. Veri sözlüğünü, kaynağı, toplama tarihlerini ve bilinen eksikleri yazın.
- Sürümleyin ve saklayın. Her yayına bir tarih ya da numara verin; böylece mart ayında hazırlanan bir grafik haziranda da aynı sonuçla yeniden üretilebilir.
Makine öğrenmesinde veri seti nasıl kullanılır?
Makine öğrenmesinde veri seti, bir modelin öğrendiği örneklerin bütünüdür: her satırda özellikler (feature, yani girdiler) ve denetimli öğrenmede bir etiket (modelin tahmin etmeyi öğreneceği doğru cevap) bulunur. Örneğin bir spam filtresi, insanların "spam" ya da "spam değil" diye etiketlediği binlerce e-postadan öğrenir.
Eğitimden önce veri seti, birbiriyle hiç örtüşmeyen üç parçaya bölünür:
- Eğitim seti: modelin öğrendiği örnekler; genellikle en büyük parça budur.
- Doğrulama seti: geliştirme sırasında ayarları karşılaştırmak ve eğitimin ne zaman durdurulacağına karar vermek için kullanılır.
- Test seti: sona kadar bir kenarda tutulur ve modelin hiç görmediği verideki başarısını ölçmek için bir kez kullanılır.
Aynı nesnenin iki fotoğrafı gibi neredeyse aynı satırlar hem eğitim hem test setine düşerse puan olduğundan iyi görünür; buna veri sızıntısı (data leakage) denir. Zaman serileri tarihe göre bölünür: model geçmiş dönemle eğitilir, daha sonraki dönemle test edilir; böylece geleceğe göz atamaz.
Bilinen veri seti örnekleri nelerdir?
Herkese açık üç veri seti, bu kavramın ne kadar geniş olduğunu gösterir:
- Iris: üç türden 150 çiçek ve her biri için dört ölçüm; istatistikçi R. A. Fisher 1936'da yayımlamıştır. UCI Machine Learning Repository onu CC BY 4.0 lisansıyla dağıtır.
- MNIST: el yazısı rakamlardan oluşan, her biri 28 × 28 piksel boyutunda 70.000 gri tonlamalı görüntü; 60.000'i eğitim, 10.000'i test için ayrılmıştır ve her görüntü 0 ile 9 arasında bir etiket taşır. Görüntü sınıflandırmada standart bir ilk alıştırmadır.
- Common Crawl: 2008'den beri düzenli olarak toplanan ve ücretsiz sunulan petabaytlarca web sayfası. Dil modellerini eğitmek için kullanılan pek çok metin veri seti bu arşivden süzülür; bir taramanın neler içerdiğini Common Crawl Nedir? yazısında anlattık.
Veri setleri nereden gelir?
Veri setleri birkaç ana kaynaktan gelir ve kaynak, veriye ne kadar güvenip onu ne ölçüde yeniden kullanabileceğinizi belirler:
- Resmî istatistikler: ulusal istatistik kurumları ve uluslararası kuruluşlar nüfus, fiyat ve dış ticaret verilerini yöntemleriyle birlikte yayımlar.
- Açık veri portalları: devlet kurumları ve belediyeler bütçeleri, toplu taşıma sefer saatlerini ve hava kalitesi ölçümlerini genellikle açık bir lisansla yayımlar.
- Araştırma arşivleri: üniversiteler ve dergiler, yayımlanan makalelerin dayandığı verileri barındırır.
- API'ler: servisler veriyi kendi sınırları ve kullanım koşulları olan, belgelenmiş endpoint'ler üzerinden sunar.
- Kendi sistemleriniz: siparişler, sunucu logları ve CRM kayıtları; çoğu zaman en değerli kaynaktır ve kişisel veri taşıma ihtimali en yüksek olandır.
- Herkese açık web sayfaları: fiyatlar, ürün ilanları, iş ilanları ve yorumlar; her sitenin kullanım koşullarına ve istek sınırlarına uyularak toplanır.
Hazır bir veri seti ararken önce o veriyi doğal olarak toplayacak kuruma bakın: işsizlik verisi için istatistik kurumuna, otobüs gecikmeleri için belediyenin açık veri portalına. Türkiye'de resmî istatistikler Türkiye İstatistik Kurumu'nun (TÜİK) veri portalında (veriportali.tuik.gov.tr) yayımlanır; İstanbul Büyükşehir Belediyesi'nin İBB Açık Veri Portalı (data.ibb.gov.tr) gibi belediye portalları da veri setlerini açık lisansla indirmeye sunar.
Veri setleri hangi dosya biçimlerini kullanır?
Tablo biçimindeki veri setlerinin çoğu CSV, iç içe kayıtlar JSON ya da JSON Lines, büyük analiz tabloları ise Parquet olarak paylaşılır. CSV, her kaydın ayrı bir satıra yazıldığı ve değerlerin virgülle ayrıldığı düz metindir; RFC 4180, içinde virgül, tırnak ya da satır sonu bulunan her değerin çift tırnak içine alınması dahil, bu biçimin yaygın hâlini belgeler.
Test makinemizde (Node.js 24) 1.000 satır ve 4 sütundan oluşan aynı tabloyu iki biçimde kaydettik: CSV dosyası 25.492 bayt, JSON dizisi ise 68.468 bayt tuttu. JSON dosyası yaklaşık 2,7 kat büyüktü, çünkü JSON her kayıtta bütün sütun adlarını yeniden yazar. 2026-01-01,"Washington, D.C.",4.2,0.0 satırını virgüllerden bölmek dört yerine beş alan verdi; tırnakları tanıyan bir ayrıştırıcı ise doğru dört alanı döndürdü. Bu yüzden CSV'yi her zaman gerçek bir CSV ayrıştırıcısıyla okuyun.
Parquet, her sütunun değerlerini bir arada saklayıp sıkıştıran, açık kaynaklı ve sütun odaklı bir biçimdir; 50 sütundan 2'sine ihtiyaç duyan bir sorgu yalnızca o 2 sütunu okur. JSON Lines her satıra bir kayıt yazar; büyümeye devam eden loglar ve metinler için uygundur.
Bir veri setinin lisansı nedir?
Bir veri setinin lisansı, veriyle neler yapabileceğinizi söyler; lisans yoksa veriyi yeniden kullanmak için açık bir izniniz de yoktur, çünkü telif ya da veritabanı hakları yine de geçerli olabilir. Yaygın açık lisanslar şunlardır:
- CC BY 4.0: eser sahibine atıf yapmanız, lisansa link vermeniz ve değişiklik yapıp yapmadığınızı belirtmeniz şartıyla veriyi ticari amaç dahil her amaçla paylaşabilir ve uyarlayabilirsiniz. Şartların tamamı Creative Commons özetinde yer alır.
- ODbL 1.0 (Open Database License): veri tabanları için yazılmıştır. Kaynağı anmanız, herkese açık kullandığınız uyarlanmış veritabanını aynı lisansla sunmanız ve teknik kısıtlama eklerseniz kısıtlamasız bir sürümünü de dağıtmanız gerekir.
- CC0: yayımcı, yasanın izin verdiği ölçüde haklarından vazgeçer; hiçbir şart uygulanmaz.
- Kullanım koşulları: bir API'den ya da web sitesinden gelen veri o servisin koşullarına tabidir ve bu koşullar herhangi bir açık lisanstan daha katı olabilir.
Lisans, verideki kişilerin değil yayımcının haklarını kapsar. İsim ve e-posta adresleri içeren CC BY lisanslı bir veri seti de kişisel veri taşır.
Bir veri seti nasıl belgelenmelidir?
Bir veri setinin belgeleri, onu hiç tanımayan birinin hazırlayana sormadan doğru kullanabileceği kadar ayrıntılı olmalıdır. Datasheets for Datasets makalesi (Gebru ve diğerleri, ilk sürümü 2018), elektronik parçaların teknik veri sayfasıyla (datasheet) satılması gibi, her veri setinin de amacını, içeriğini, toplama sürecini ve önerilen kullanımlarını anlatan böyle bir sayfayla yayımlanmasını önerir.
Kısa bir README bile çok iş görür: bir satırın neyi temsil ettiği, kaynak ve yöntem, kapsanan dönem, birimler ve saat dilimi, bilinen eksikler, lisans, sürüm ve bir iletişim adresi.
Veri setinde kişisel veri varsa ne olur?
Satırlardan biri bile kimliği belirlenebilir bir kişiyle ilgiliyse veri seti kişisel veri içerir ve veri koruma mevzuatı uygulanır. AB'nin Genel Veri Koruma Tüzüğü (GDPR) 4. maddesinin 1. fıkrasında kişisel veriyi, kimliği belirli ya da belirlenebilir bir gerçek kişiye ilişkin her türlü bilgi olarak tanımlar; kişi doğrudan ya da ad, kimlik numarası, konum verisi veya çevrim içi bir tanımlayıcı gibi bilgilerle belirlenebilir. 6698 sayılı Kişisel Verilerin Korunması Kanunu (KVKK) da 3. maddesinde kişisel veriyi "kimliği belirli veya belirlenebilir gerçek kişiye ilişkin her türlü bilgi" olarak tanımlar.
İsimleri silmek yetmez: isimlerin kodlarla değiştirildiği ve eşleştirme anahtarının başka bir yerde tutulduğu takma adlandırılmış (pseudonymised) veri de GDPR'a göre kişisel veri olmaya devam eder. Yalnızca gereken sütunları toplayın, doğrudan tanımlayıcıları maskeleyin, erişimi sınırlayın ve bir silme tarihi belirleyin; bu adımları web'den toplanan veri için Kazınan Verilerde Kişisel Veri (PII) Nasıl Yönetilir? yazısında adım adım anlattık.
Herkese açık web sayfalarından veri seti nasıl oluşturulur?
İndirilebilir bir dosya ya da API yoksa, herkese açık web sayfalarını kullanmanın zor yanı her satırı aynı koşullarda toplamaktır. Pek çok site fiyatı, para birimini, stoğu ve dili ziyaretçinin ülkesine göre gösterir; bu yüzden tek bir konumdan toplanan veri seti, fark ettirmeden yalnızca o konumu anlatır. Ülke ve şehir hedeflemesi sunan bir Residential Proxy ile her pazarın satırlarını, o pazardaki yerel bir ziyaretçinin göreceği biçimde toplayabilirsiniz; sticky oturum ise çok sayfalı bir kontrol boyunca aynı IP adresini 1 ile 60 dakika arasında korur.
Her satıra toplama ülkesini ve zamanını kaydedin, her sitenin robots.txt dosyasına, kullanım koşullarına ve istek sınırlarına uyun; resmî bir API ya da indirme seçeneği varsa onu kullanın. Veri toplamayı kendisi yürütmek istemeyen ekipler için Web Scraping API yönetilen sayfa çıkarma hizmeti sunar; bu hizmete satış ekibimiz üzerinden ulaşabilirsiniz.
Veri setleri nerelerde kullanılır?
- İş analitiği: gösterge panellerinin ve raporların arkasındaki satış ve maliyet tabloları.
- Makine öğrenmesi ve yapay zekâ: spam filtrelerinden dil modellerine kadar modellerin eğitim ve test verisi.
- Araştırma: yayımlanan çalışmaların dayandığı anketler, deneyler ve resmî istatistikler.
- Fiyatlandırma ve e-ticaret: zaman içinde izlenen rakip fiyatları ve stok bilgileri.
- Kamu ve gazetecilik: iddiaları doğrulanabilir kılan bütçe ve ulaşım verileri.
Sık yapılan hatalar
- Gözlem birimi belirlememek. Sipariş başına bir satırla müşteri başına bir satırı karıştırmak bütün toplamları bozar.
- Bir hücreye iki değer yazmak. "12 kg / 26 lb" ne toplanabilir ne de filtrelenebilir.
- Birimleri ve saat dilimlerini atlamak. Para birimi olmayan bir fiyat tahminden ibarettir.
- CSV'yi virgüllerden bölmek. İçinde virgül bulunan tırnaklı değerler sütunları kaydırır.
- Lisansı yok saymak. "İnternette buldum" bir lisans değildir.
- Test verisini eğitime sızdırmak. Bölünmüş setler arasındaki yinelenen kayıtlar her puanı şişirir.
- Sürüm ya da toplama tarihi tutmamak. Kimsenin yeniden üretemediği sonuçlara güvenilmez.
Karar rehberi
| İhtiyaç | Öneri |
|---|---|
| Elle düzenlenen küçük bir tablo | Veri sözlüğüyle birlikte Excel ya da CSV |
| Tabloyu başka araçlarla paylaşmak | Başlık satırlı, UTF-8, tırnaklı değerli CSV |
| Analiz için büyük tablolar | Tarihe göre bölümlenmiş Parquet |
| Bir API'den gelen iç içe kayıtlar | JSON Lines |
| Bir model eğitmek | Ayrı eğitim, doğrulama ve test setleri |
| Zamana göre sıralı veri | Rastgele değil, tarihe göre bölün |
| Başkasının verisini yeniden kullanmak | Önce lisansı ve şartlarını kontrol edin |
| Kişilerle ilgili veri | Yalnızca gerekeni toplayın; tanımlayıcıları maskeleyin |
| Birkaç ülkede fiyat ya da ilan | Her pazarın verisini o pazardan toplayın |
Sıkça sorulan sorular
Veri seti en basit anlamıyla nedir?
Veri seti, bir amaç için bir arada tutulan ilişkili verilerdir ve çoğu zaman bir tablodur. Her satır bir satış ya da bir gün gibi tek bir şeyi anlatır, her sütun da fiyat ya da sıcaklık gibi o şeyin bir özelliğini kaydeder.
Veri seti ile veritabanı arasındaki fark nedir?
Veri seti, bir amaç için toplanmış verinin kendisidir; veritabanı ise veriyi saklayan ve sorgulara cevap veren yazılımdır. Bir veritabanı pek çok veri seti barındırabilir, bir veri seti de bir veritabanında, bir CSV dosyasında ya da bir elektronik tabloda durabilir.
Veri seti örnekleri nelerdir?
Bir mağazanın sipariş listesi bir veri setidir: her sipariş için bir satır ve tarih, ürün, adet ve fiyat sütunları. Herkese açık bilinen örnekler Iris, MNIST ve Common Crawl'dur.
Makine öğrenmesinde veri seti nedir?
Bir modelin öğrendiği ve test edildiği örneklerin bütünüdür. Her örnekte özellikler (girdiler) ve çoğu zaman bir etiket (doğru cevap) bulunur; veri eğitim, doğrulama ve test setlerine bölünür.
Ücretsiz veri seti nereden bulunur?
Önce o veriyi toplayacak kuruma bakın: ulusal istatistik kurumları, devlet kurumlarının ve belediyelerin açık veri portalları, UCI Machine Learning Repository gibi araştırma arşivleri ve uluslararası kuruluşlar. İndirme ücretsiz olsa bile her veri setini yeniden kullanmadan önce lisansını kontrol edin.
Kendi veri setinizi nasıl oluşturursunuz?
Soruyu belirleyin, bir satırın neyi temsil edeceğini tanımlayın ve değişkenleri türleri ve birimleriyle seçin. Her satırı aynı yöntemle toplayın, sonucu kontrol edip temizleyin; ardından kaynağı, tarihleri ve lisansı anlatan kısa bir README yazın ve her yayına bir sürüm numarası verin.
Özet
Veri seti, bir amaç için düzenlenmiş ilişkili verilerdir; çoğu zaman gözlemlerden ve değişkenlerden oluşan bir tablo ile onu kullanılabilir kılan belge ve lisanstan oluşur. Veri toplamaya başlamadan önce bir satırın neyi temsil edeceğine karar verin, her hücreye tek bir değer yazın; birimleri, saat dilimlerini ve toplama tarihlerini kaydedin. Yeniden kullanmadan önce lisansı kontrol edin, kişisel veriyi hukuki bir yükümlülük olarak ele alın ve web sayfaları ülkeye göre değişiyorsa her pazarın verisini o pazardan toplayın.