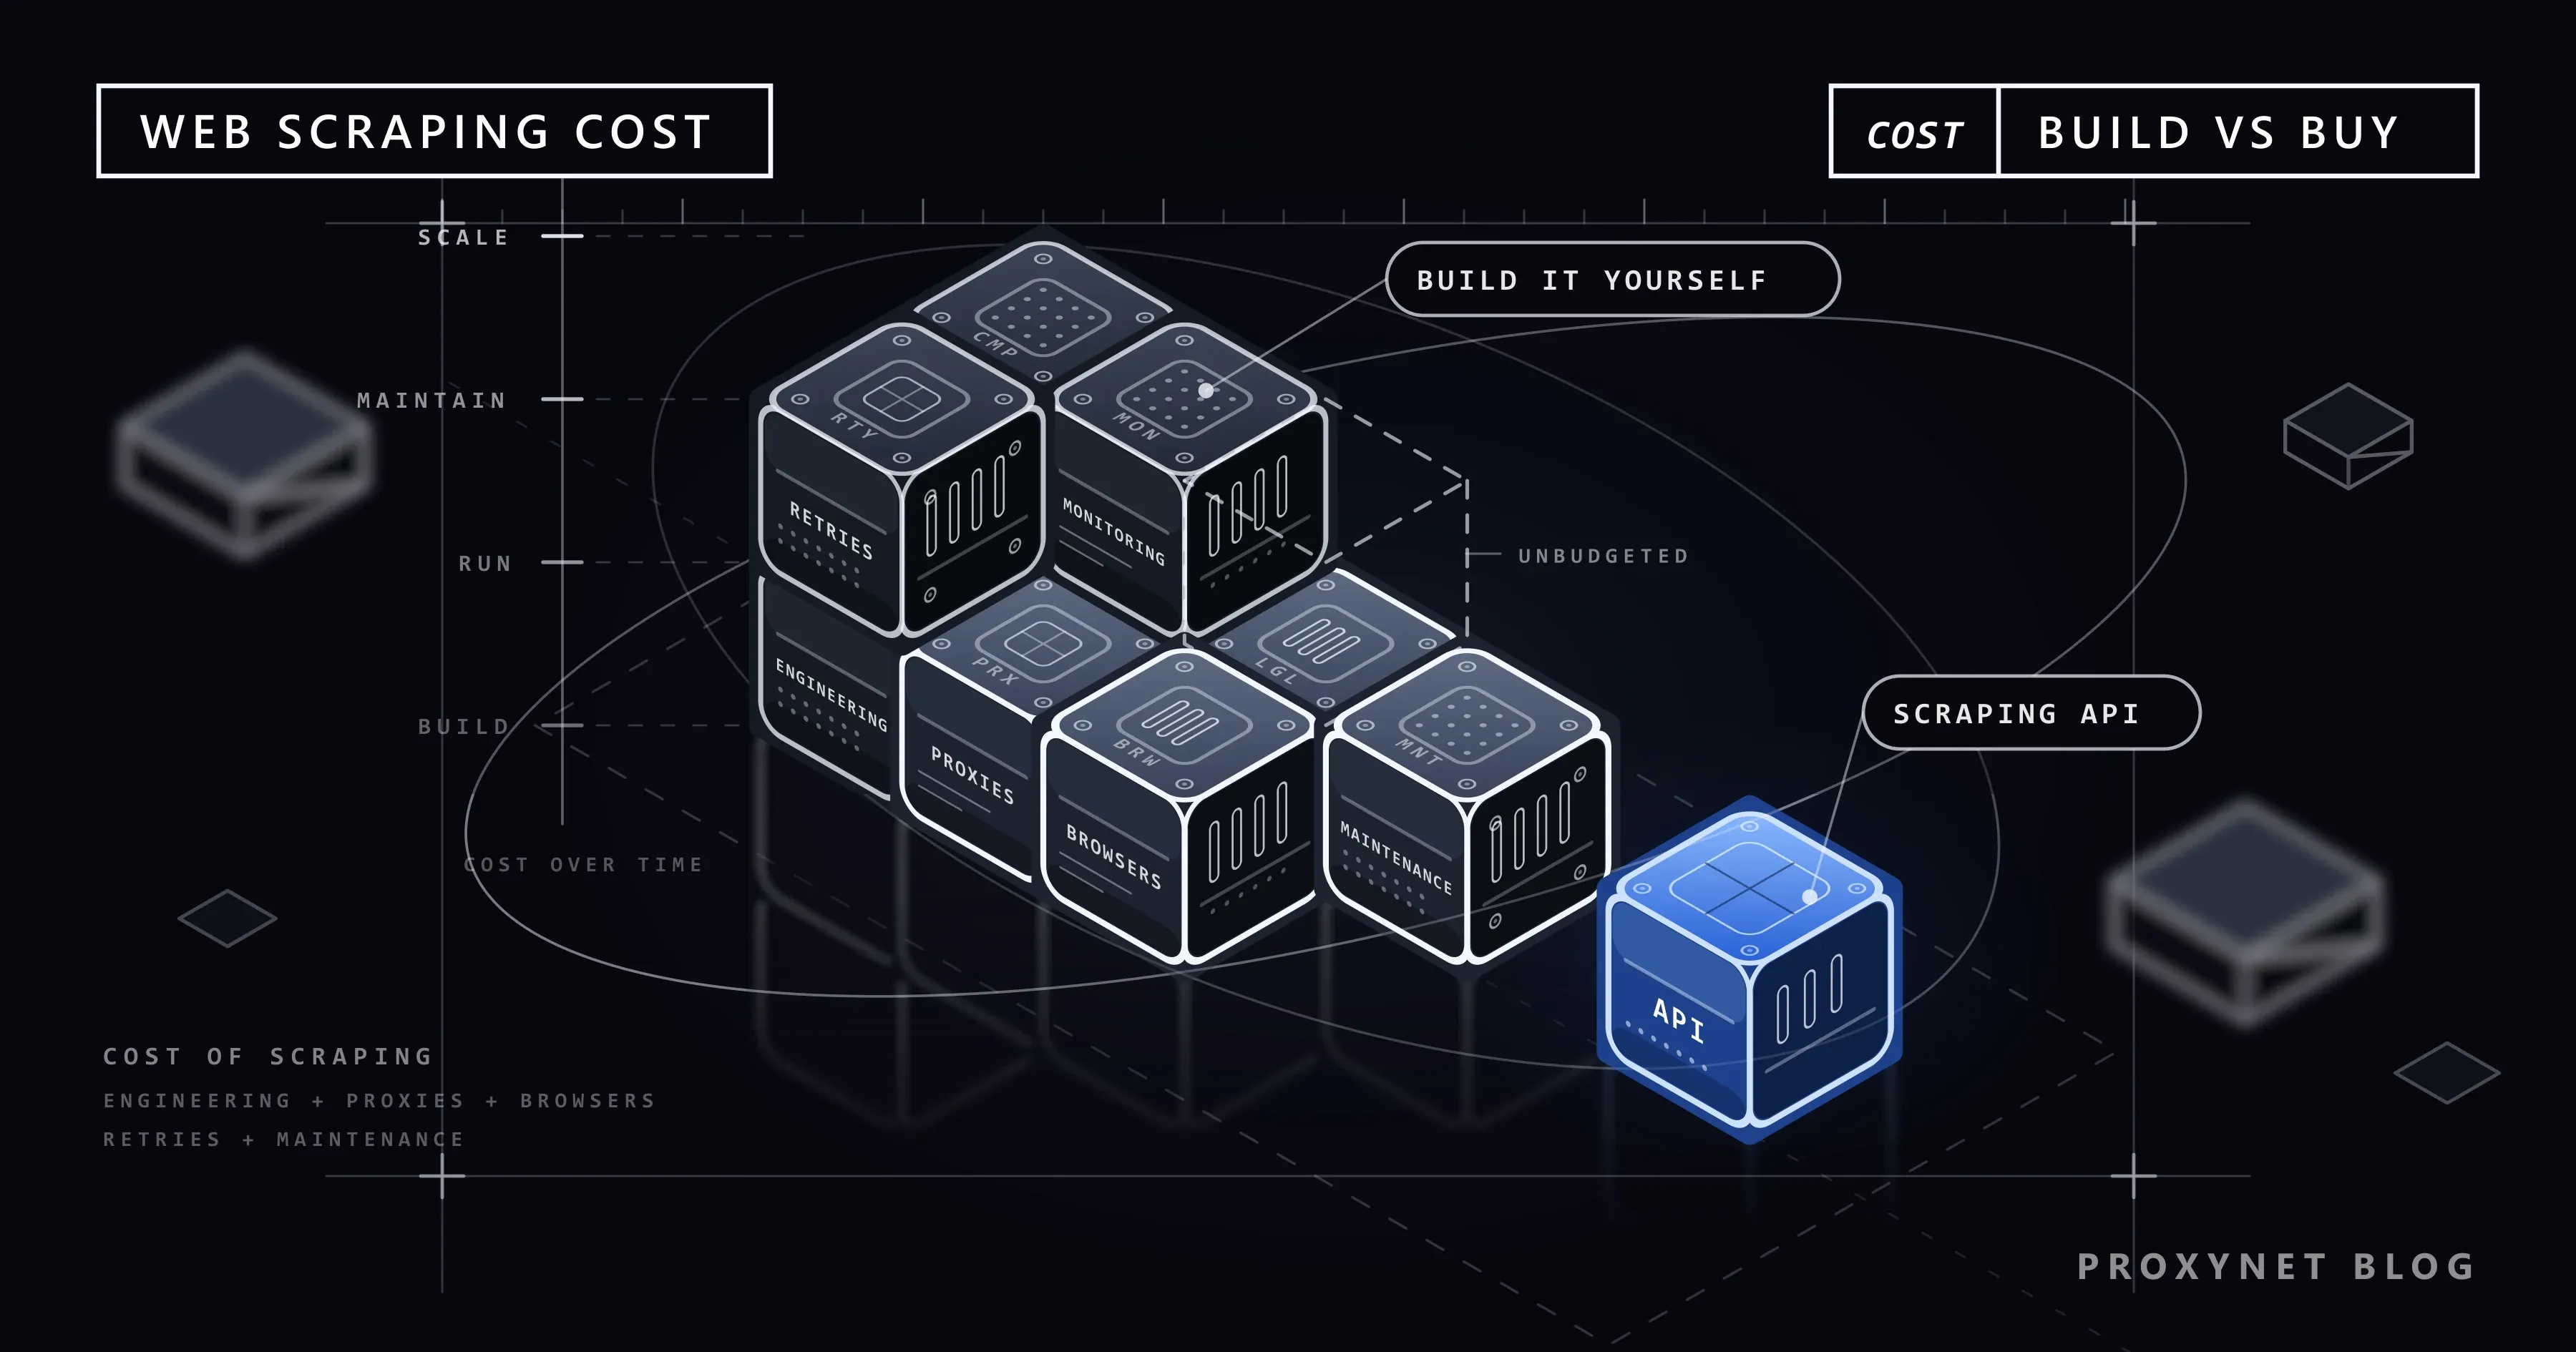
Ein Produktmanager fragt, was es kosten würde, jeden Morgen die Preise aus 60 Onlineshops zu sammeln. Der Entwickler antwortet, Scrapy und Playwright seien kostenlos, also „ein paar Tage Arbeit“. Sechs Monate später kommt die Rechnung dort an, wo niemand sie eingeplant hat: Parser-Reparaturen jede Woche, eine Proxy-Rechnung, die mit jedem neuen Versuch wächst, und ein Server voller Headless-Browser.
Dieser Beitrag listet die acht Kostenposten eines selbst gebauten Scrapers auf und zeigt, womit jeder wächst. Er misst, was ein einfacher HTML-Abruf und ein vollständiger Browser-Ladevorgang auf einer öffentlichen Seite wirklich übertragen, rechnet eine Beispielschätzung durch und stellt sie der Art gegenüber, wie Scraping-APIs abrechnen.
Kostet Web Scraping Geld?
Ja: Die Software ist kostenlos, der Betrieb nicht. Scrapy, Beautiful Soup, Playwright und Puppeteer kosten keine Lizenzgebühr, und ein erstes Skript läuft auf dem Laptop. Die Kosten beginnen, wenn es jeden Tag laufen muss, auf vielen Seiten, aus dem richtigen Land, und das nächste Redesign der Zielseite überstehen soll. Sie bezahlen einen Prozess, kein Werkzeug.
Eine Scraping-API ändert, wer welchen Posten bezahlt: Der Anbieter betreibt Browser, Proxys und Wiederholungen und rechnet pro gelieferter Seite ab. Wie ein solcher Dienst funktioniert, erklärt Was ist eine Web-Scraping-API?; in diesem Beitrag geht es ums Geld.
Was kostet es, einen eigenen Scraper zu bauen und zu betreiben?
Ein selbst gebauter Scraper hat acht Kostenposten, und nur der erste wird einmalig bezahlt.
Entwicklungszeit für den Aufbau. Fetcher, ein Parser pro Website, Scheduler, Speicher, Tests; der Posten wächst mit der Zahl der verschiedenen Websites, weil jedes Layout seinen eigenen Parser braucht.
Wartung, wenn sich Websites ändern. Der Posten, den alle vergessen. Ein Redesign, eine umbenannte CSS-Klasse, ein neuer Cookie-Dialog oder ein strengerer Bot-Schutz bricht einen Parser über Nacht, und die Daten bleiben stillschweigend aus oder kommen falsch an. Er wächst mit der Zahl der Websites mal ihrer Änderungsrate; planen Sie ihn als wiederkehrenden monatlichen Anteil der Aufbaukosten ein.
Rechenleistung: HTTP-Anfragen oder Headless-Browser. Eine einfache Anfrage lädt das HTML und sonst nichts; ein Headless-Browser lädt Skripte, Stylesheets, Schriften und Bilder wie ein Besucher, führt das JavaScript aus und rendert pro Server und Stunde weit weniger Seiten. Der nächste Abschnitt misst den Unterschied.
Proxy-Traffic. Viele Ziele zeigen je nach Land andere Preise, und ein gleichmäßiger Strom von einer einzigen Adresse ist das Erste, was ein Rate-Limit erwischt; deshalb schicken produktive Scraper ihre Anfragen über Proxys. Residential-Proxys werden pro Gigabyte abgerechnet (unsere beginnen bei 1,4 €), ihre Kosten wachsen also mit den Bytes: Seitengröße × Seiten × Wiederholungen. Statische ISP- und Datacenter-Proxys werden pro IP abgerechnet, mit Traffic ohne Kontingent; ihre Kosten wachsen mit der Zahl der Adressen.
Wiederholungen als Multiplikator. Timeouts,
5xx-Antworten und Sperrseiten bedeuten, eine Seite mehr als einmal abzurufen, und jeder Versuch kostet erneut Rechenleistung und Traffic: Bei einer Fehlerquote von 30 % bewegen Sie das 1,3-Fache des Traffics für dieselben brauchbaren Seiten. Ein429oder ein CAPTCHA ist ein Signal, langsamer zu werden, nicht härter zu wiederholen; Web Scraping ohne Sperren erklärt die Backoff-Regeln, die die Wiederholungsquote niedrig halten.Speicher, Parsing und Qualitätsprüfung. Rohes HTML, das zum erneuten Parsen aufbewahrt wird, summiert sich, und geparste Datensätze brauchen Schemaprüfung, Deduplizierung und Stichproben. Leere Preise nach einem Redesign kosten mehr als keine Daten, weil jemand danach handelt.
Monitoring und Alarmierung. Jemand muss innerhalb von Stunden erfahren, dass eine Website Sperrseiten zurückgibt oder die Erfolgsquote von 97 % auf 60 % gefallen ist. Dashboards, Alarme und Reaktionszeit kosten Geld, auch wenn nichts kaputtgeht.
Rechtliche Prüfung und Compliance. Die Bedingungen jedes Ziels lesen, die robots.txt prüfen, entscheiden, ob personenbezogene Daten betroffen sind, und die Rechtsgrundlage dokumentieren: Das kostet Stunden von Nicht-Entwicklern. Der robots.txt-Standard hält fest, dass seine Regeln „keine Form der Zugriffsautorisierung“ sind (RFC 9309): Die Datei erzwingt nichts, die Compliance bleibt also bei Ihnen. Für ein konkretes Projekt fragen Sie einen Anwalt.
Wie viel mehr überträgt ein Headless-Browser?
Auf der von uns gemessenen Seite übertrug ein vollständiger Ladevorgang im Headless-Browser das 18,7-Fache der Bytes eines einfachen HTML-Abrufs.
Am 9. November 2026 haben wir eine öffentliche Seite, die MDN-Referenzseite zum HTTP-Status 429 Too Many Requests (ihre robots.txt erlaubt den Pfad), auf drei Arten abgerufen: als einzelnen komprimierten HTTPS-GET des HTML, als vollständigen Ladevorgang in Headless-Chromium über Playwright mit leerem Cache und als denselben Ladevorgang mit abgebrochenen Bild-, Schrift- und Medienanfragen. Die Bytes sind Header plus kodierte Bodys aus Playwrights request.sizes(), dessen responseBodySize die komprimierte Größe auf der Leitung ist (Playwright: request.sizes()).
| Methode | Anfragen | Übertragen | Dauer |
|---|---|---|---|
| Einfacher HTML-Abruf | 1 | 23,4 KB | 47 ms |
| Headless-Browser, vollständiger Ladevorgang | 81 | 436,6 KB | 4,2 s |
| Headless-Browser, Bilder, Schriften und Medien blockiert | 64 | 209,3 KB | 1,5 s |
Das HTML war auch im Browser 23,3 KB groß; die übrigen 413 KB waren 39 Skripte (155,5 KB), zwei Schriften (133,3 KB), 15 Bilder (78 KB), 17 Stylesheets und ein paar Analytics-Pings. Das Abbrechen von Bild-, Schrift- und Medienanfragen mit page.route() (Playwright: Anfragen abbrechen) halbierte den Traffic und senkte die Ladezeit auf ein Drittel.
Diese Dokumentationsseite ist leicht: Der Web Almanac 2025 beziffert die mediane Startseite auf 2,86 MB am Desktop und 2,56 MB auf dem Smartphone, davon 22 KB HTML (Web Almanac 2025: Seitengewicht). Dort bewegt ein Browser-Ladevorgang Megabytes pro Seite, und mit Proxys, die pro Gigabyte abrechnen, wird das Rendering zum größten Posten auf der Rechnung.
Messen Sie zuerst Ihre eigenen Ziele: Das Network-Panel der Chrome DevTools zeigt die Zahl der Anfragen und die übertragene Größe eines Ladevorgangs, mit Disable cache (Cache deaktivieren) für die Sicht eines Erstbesuchers (Chrome DevTools: Network-Referenz). Stehen die Felder, die Sie brauchen, bereits im HTML oder in einer JSON-Antwort, brauchen Sie keinen Browser.
Wie vergleichen Sie einen API-Preis mit Ihren eigenen Kosten?
Rechnen Sie beides in die Kosten pro 1.000 brauchbare Seiten auf Ihren eigenen Zielen um; nichts anderes ist vergleichbar.
Scraping-APIs rechnen pro empfangener Seite ab, in Einheiten, die sich je nach Anbieter unterscheiden (pro Anfrage, Credits mit Multiplikatoren für Rendering und Residential-Ausgänge, monatliche Mindestbeträge, eine Definition von Erfolg); der Schwesterbeitrag erklärt diese Modelle. Bilden Sie dieselbe Zahl für Ihren eigenen Weg: Stunden zu Ihrem Satz plus Server, Proxy- oder IP-Gebühren, Speicher und Monitoring, geteilt durch brauchbare Seiten.
| Kostenposten | Selbst bauen | Scraping-API | Wächst mit |
|---|---|---|---|
| Aufbau | Ihre Stunden pro Website | Eine Integration | Zahl der Websites |
| Wartung | Ihre Stunden, bei jeder Änderung | Aufgabe des Anbieters | Websites × Änderungsrate |
| Rechenleistung | Server und Browser | Im Preis (Rendering-Stufe) | Seiten, Rendering-Anteil |
| Proxy-Traffic | Pro GB oder pro IP | Im Preis (Ausgangs-Stufe) | Bytes oder Zahl der IPs |
| Wiederholungen | Sie zahlen jeden Versuch | Meist nur Erfolge berechnet | Fehlerquote |
| Speicher, QA, Monitoring | Ihre Sache | Ihre Sache, plus deren Verfügbarkeit | Seiten, Websites |
| Rechtliche Prüfung | Ihre Sache | Ihre Sache | Ziele, personenbezogene Daten |
Ein Rechenbeispiel mit Variablen
Die Zahlen unten sind rund und erfunden, um die Rechnung zu zeigen; ersetzen Sie sie durch Ihre eigenen Messungen.
| Variable | Bedeutung | Beispielwert |
|---|---|---|
| P | Brauchbare Seiten pro Monat | 1.000.000 |
| r | Wiederholungsfaktor (1 + Anteil fehlgeschlagener Versuche) | 1,3 |
| s | Übertragene Bytes pro Versuch | 60 KB einfach, 1,5 MB gerendert |
| h | Entwicklungs- und Wartungsstunden pro Monat | 40 |
Rendering verändert den Traffic für dieselben Seiten um den Faktor 25:
| Zeile | Formel | Einfaches HTTP | Gerendert |
|---|---|---|---|
| Proxy-Traffic | P × r × s | 78 GB | 1.950 GB |
| Residential-Proxys | Traffic × Preis pro GB | 78 × G | 1.950 × G |
| ISP- oder Datacenter-Proxys | Adressen × Preis pro IP | n × I | n × I |
| Personal | h × Stundensatz | 40 × R | 40 × R, plus Browser-Pflege |
Bei Residential-Proxys mit GB-Abrechnung landet der Rendering-Multiplikator auf der Rechnung; bei Adressen ohne Kontingent auf Ihren Servern. Der Wiederholungsfaktor steckt in jeder Zeile: Wer die Fehlerquote von 30 % auf 10 % senkt, spart etwa 15 % des Traffics. Die API-Seite ist P mal ihr Preis pro 1.000 brauchbare Seiten, plus Ihre Stunden für Integration und Kontrollen.
Wann lohnt sich Selbstbauen, wann eine API?
Selbstbauen lohnt sich, wenn die Arbeit eng umrissen, stabil und langfristig ist; eine API, wenn sie breit, wechselhaft oder kurz ist.
Bauen Sie mit Proxys bei einer Handvoll stabiler Websites, einem Volumen, bei dem sich ein Preis pro Seite summieren würde, und einem Team, das bereits Scraper betreibt. Nutzen Sie eine Scraping-API, wenn die Liste der Websites lang ist oder sich jedes Quartal ändert, die meisten Ziele mit JavaScript rendern oder das Projekt in drei Monaten endet. Wählen Sie die Mischform, wenn wenige Websites das Volumen tragen und ein Long Tail die Komplexität.
Welche versteckten Kosten übersehen Schätzungen?
Vier Kosten tauchen in der Tabelle selten auf. Opportunitätskosten: Der Entwickler, der Parser wartet, baut nicht das Produkt, das die Daten speisen. Datenqualität: Ein Scraper, der stillschweigend veraltete Felder liefert, ist im Betrieb billiger als ein korrekter, bis eine Entscheidung darauf beruht. Compliance: Prüfung der Bedingungen, robots.txt-Kontrollen, Datenminimierung und ein Auftragsverarbeitungsvertrag mit jedem Anbieter, der personenbezogene Daten verarbeitet, kosten bei jedem neuen Ziel Zeit. Bus-Faktor: Eine Pipeline, die nur eine Person versteht, wird an dem Tag zur Belastung, an dem diese Person geht.
Wann sind Proxys allein der richtige Kauf?
Proxys allein sind der richtige Kauf, wenn Sie bereits einen funktionierenden Scraper betreiben und nur die Ausgänge fehlen: das richtige Land, genug verschiedene Adressen oder eine stabile IP für eine Sitzung.
Für Websites, deren Inhalt vom Standort abhängt, bietet ein Residential-Proxy rotierende oder Sticky-Sitzungen mit Länder- und Städte-Targeting, abgerechnet pro Gigabyte; rufen Sie also einfaches HTML ab, wo es geht, und blockieren Sie Bilder und Schriften, wo es nicht geht.
Für hohes Volumen auf stabilen Zielen wird ein ISP-Proxy pro IP abgerechnet, mit Traffic ohne Kontingent; Datacenter-Proxys folgen demselben Modell und kosten pro Adresse am wenigsten. Beide sind standardmäßig auf bestimmte Zielseiten beschränkt, und der Zugang zu allen Websites ist ein kostenpflichtiges Add-on. Bezahlt wird aus einem Guthaben, das nie verfällt, ohne Abonnement und ohne kostenlose Testphase.
Wann ist eine verwaltete Scraping-API der richtige Kauf?
Eine verwaltete API ist der richtige Kauf, wenn die Liste der Websites lang ist oder sich oft ändert, die meisten Seiten Rendering brauchen oder das Projekt zu kurz ist, um einen Eigenbau zu amortisieren: Sie schicken URLs und erhalten Seiten oder Felder, und der Anbieter trägt Browser, Ausgänge, Wiederholungen und Wartung. Fragen Sie vor der Unterschrift nach der Abrechnungseinheit, der Definition von Erfolg, ob robots.txt beachtet wird und wie Rendering bepreist ist. Unsere Web-Scraping-API, verwaltete Seitenextraktion, ist über das Vertriebsteam erhältlich; die Seite zum Data Scraping beschreibt den Proxy-Teil und wie Sie das Team erreichen.
Häufige Fehler
- Nur den Aufbau zählen. Über zwei Jahre ist die Entwicklung des ersten Monats der kleinste Posten.
- Wiederholungen ignorieren. Eine Fehlerquote von 30 % ist ein Aufschlag von 30 % auf Rechenleistung und Traffic.
- Residential-Proxys für jedes Ziel. Websites, die nicht vom Standort abhängen, sind auf IPs ohne Kontingent günstiger.
- Die Seitengröße nicht messen. Proxys mit GB-Abrechnung wählen, ohne zu wissen, ob eine Seite 25 KB oder 2,5 MB groß ist.
- Alles rendern. Viele Seiten tragen ihre Daten im HTML oder in einer JSON-Antwort.
- Kein Ausgabenlimit. Ein Scraper, ein Proxy-Konto und ein API-Schlüssel brauchen jeweils ein Monatslimit und einen Alarm.
Entscheidungshilfe
| Bedarf | Empfehlung |
|---|---|
| Drei stabile Websites, Millionen Seiten, eigenes Team | Selbst bauen; ISP- oder Datacenter-IPs ohne Kontingent |
| Preise, wie Besucher in zehn Ländern sie sehen | Residential-Ausgänge, einfache Anfragen |
| Sechzig Websites mit verschiedenen Layouts, kleines Team oder ein Dreimonatsprojekt | Scraping-API |
| Die meisten Ziele rendern mit JavaScript | API mit Rendering je Ziel |
| Gleichmäßiges Volumen auf wenigen Websites plus Long Tail | Mischform: eigener Scraper, API für den Long Tail |
| Die Website bietet eine offizielle API mit Ihren Feldern | Die offizielle API |
Häufige Fragen
Kostet Web Scraping Geld?
Ja. Die Bibliotheken sind kostenlos, aber der Betrieb eines Scrapers kostet Entwicklungszeit, Wartung, Server, Proxy-Traffic, Speicher, Monitoring und rechtliche Prüfung. Ein einmaliges Skript ist fast gratis; eine tägliche Pipeline über viele Websites ist ein laufender Kostenposten.
Was kostet ein Web Scraper?
Es gibt keine einzelne Zahl: Es hängt von der Zahl der Websites, den Seiten pro Monat, dem Rendering-Anteil und davon ab, wie oft sich die Ziele ändern. Schätzen Sie monatlich: Stunden zu Ihrem Satz plus Server, Proxy-Gebühren, Speicher und Monitoring, geteilt durch brauchbare Seiten.
Ist eine Scraping-API günstiger als Proxys?
Bei vielen verschiedenen oder JavaScript-lastigen Websites und einem kleinen Team meist ja, weil ihr Preis Browser, Wiederholungen und Wartung einschließt. Bei hohem Volumen auf wenigen stabilen Websites ist ein eigener Scraper mit Proxys ohne Kontingent pro Seite meist günstiger.
Wie schätze ich die Proxy-Bandbreite fürs Scraping?
Multiplizieren Sie die Seiten pro Monat mit dem Wiederholungsfaktor und den übertragenen Bytes pro Seite, gemessen auf Ihren echten Zielen; ein einfacher Abruf sind oft einige Dutzend Kilobyte, ein Browser-Ladevorgang Megabytes.
Warum steigen die Kosten für Web Scraping mit der Zeit?
Weil sich die Ziele ändern und das Volumen wächst: Redesigns kosten Wartungsstunden, neue Websites bringen neue Parser, Wiederholungen nehmen zu, wenn der Schutz strenger wird, und gespeicherte Rohseiten häufen sich an.
Sind kostenlose Scraping-Tools wirklich kostenlos?
Die Lizenz ist kostenlos, der Betrieb nicht. Open-Source-Scraper sparen die Softwarekosten; Server, Proxys, Pflege und die Verantwortung für das, was sie sammeln, bleiben bei Ihnen.
Fazit
Web Scraping kostet Geld, weil es ein Betrieb ist und kein Download, und Wiederholungen und Rendering vervielfachen jeden anderen Posten. Messen Sie Seitengröße und Fehlerquote auf Ihren echten Zielen, rechnen Sie jede Option in Kosten pro 1.000 brauchbare Seiten um und entscheiden Sie dann: eigener Scraper auf Proxys ohne Kontingent für wenige stabile Websites, Scraping-API für viele oder wechselnde Websites, Mischform für gleichmäßiges Volumen mit Long Tail. Fehlen Ihnen die Ausgänge und nicht der Scraper, beginnen Sie mit unseren Proxy-Diensten.