

































Blog de Proxynet – Página 16

Publicado
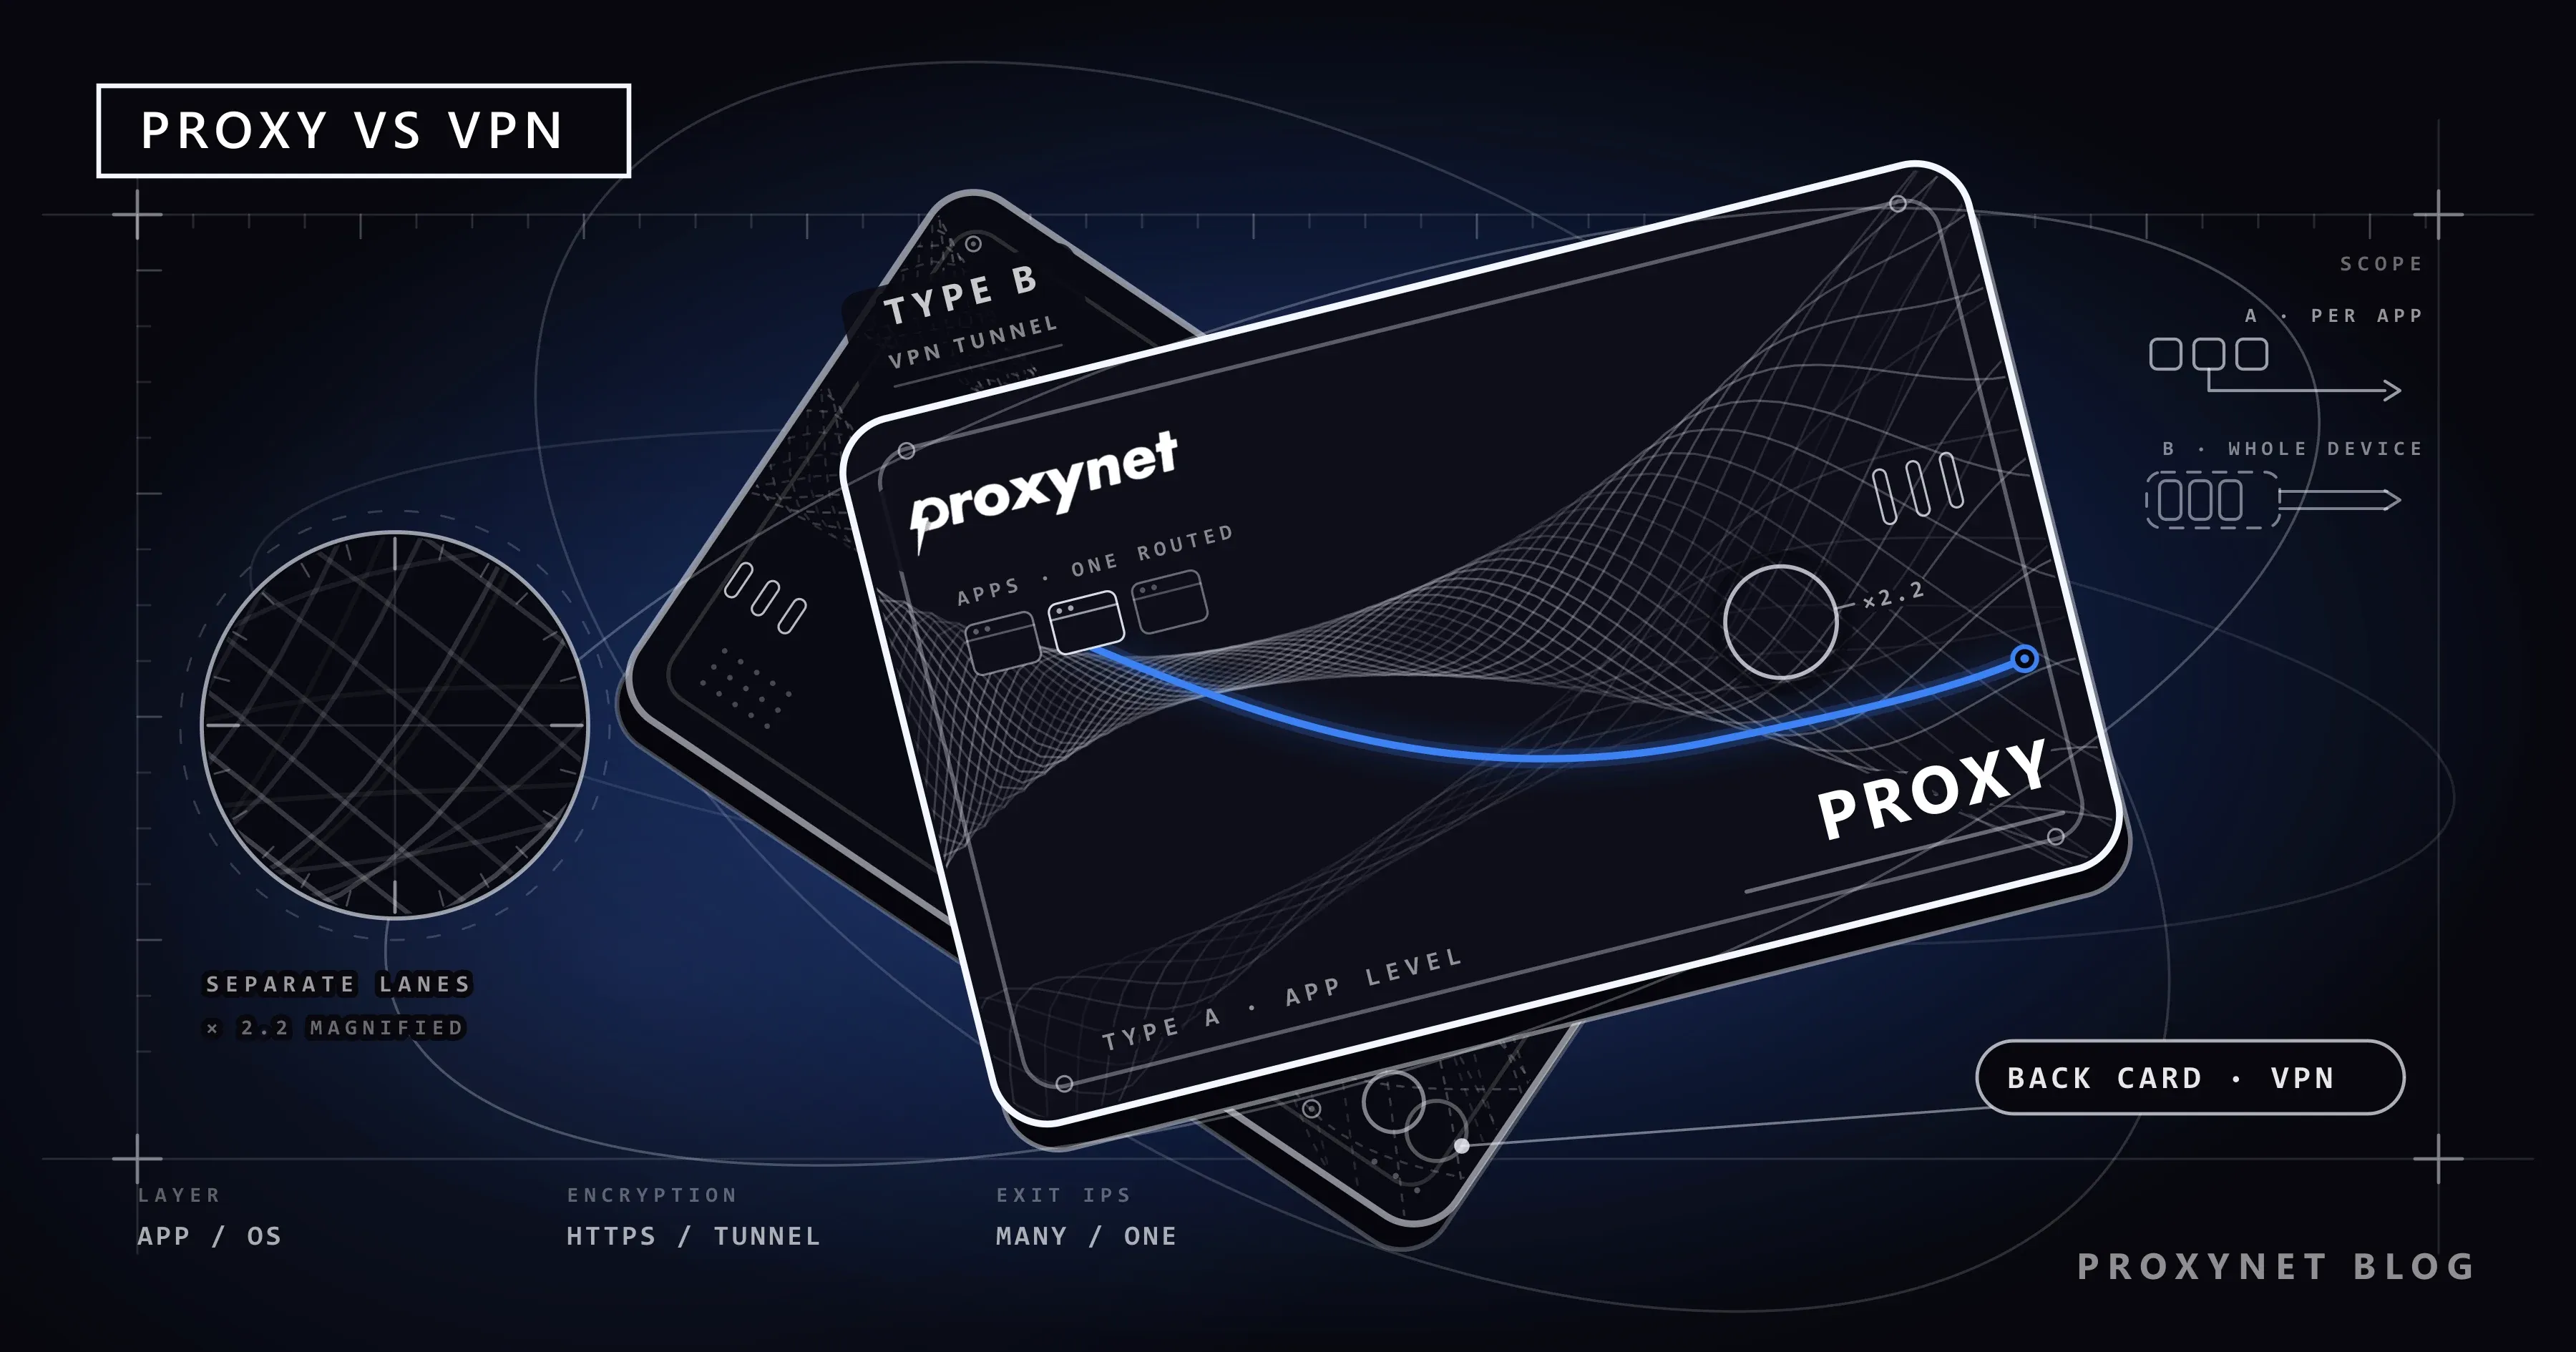
Proxy o VPN: diferencias y cuándo usar cada uno
Un proxy envía por otra IP el tráfico de la aplicación que elijas; una VPN cifra todo el tráfico del dispositivo. Te explicamos cuál conviene en cada caso.
Autor: Acar Diveroli
Publicado
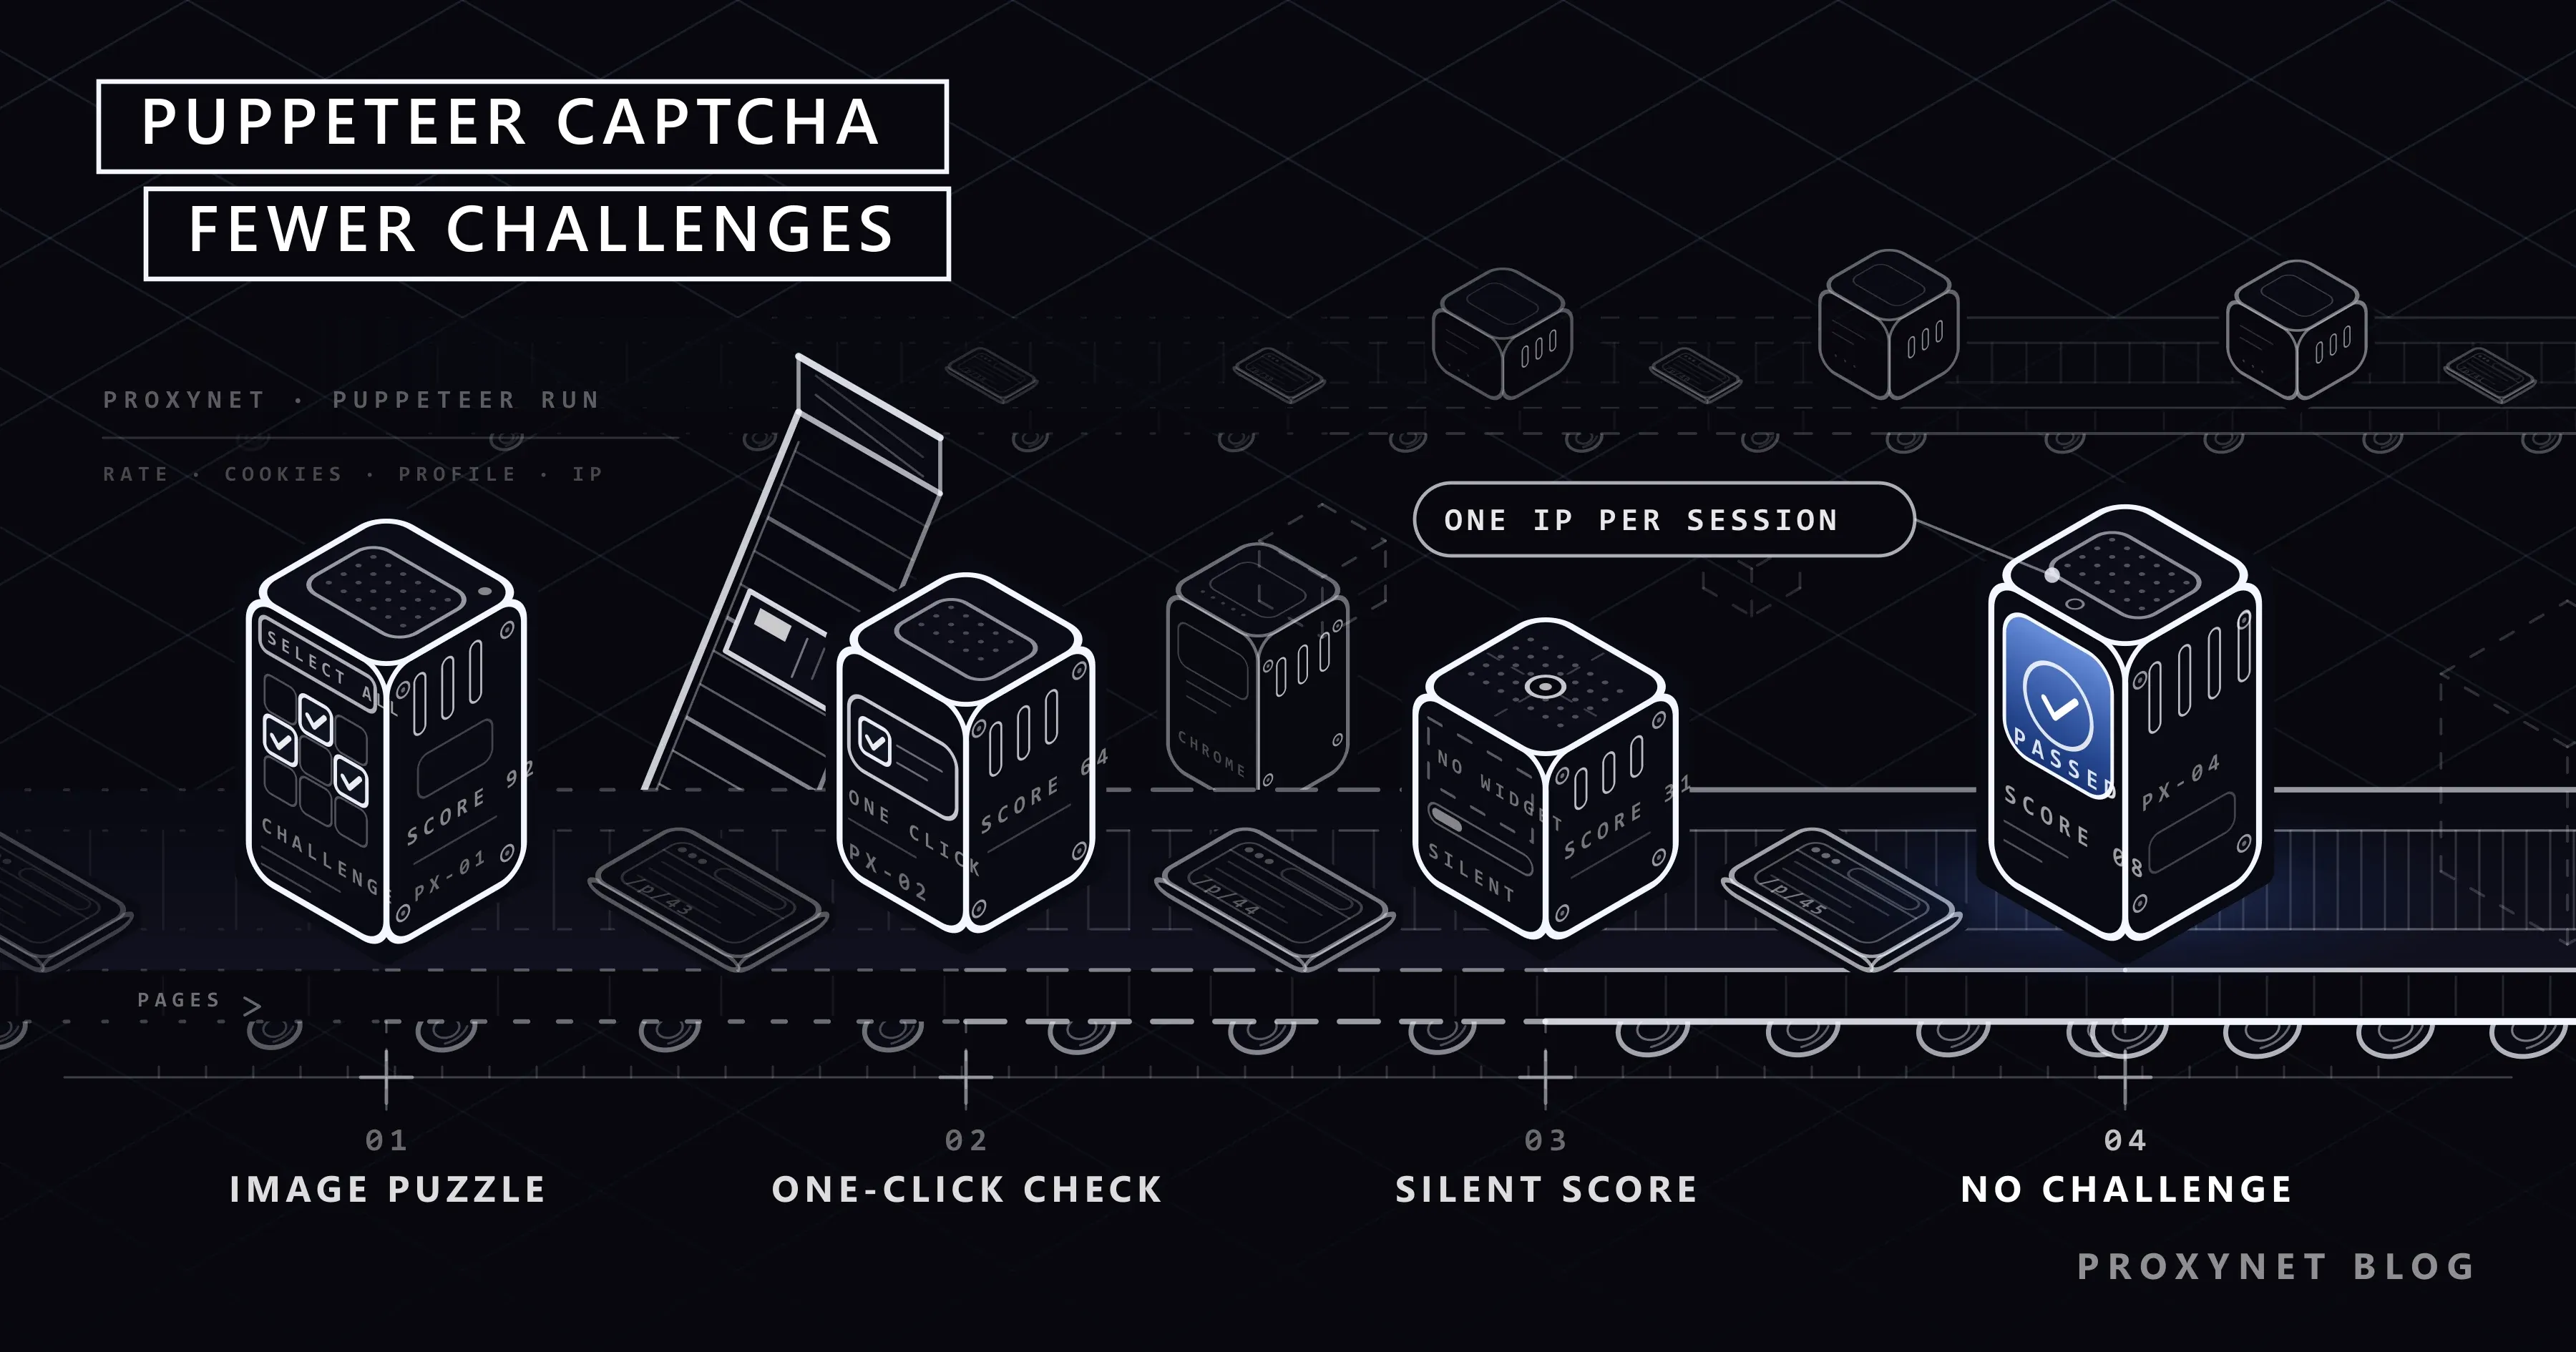
Puppeteer y CAPTCHA: por qué aparece y cómo reducirlo
En Puppeteer el CAPTCHA suele activarse por la reputación de la IP, la velocidad y las huellas del modo headless. Causas y soluciones legítimas.
Autor:Acar Diveroli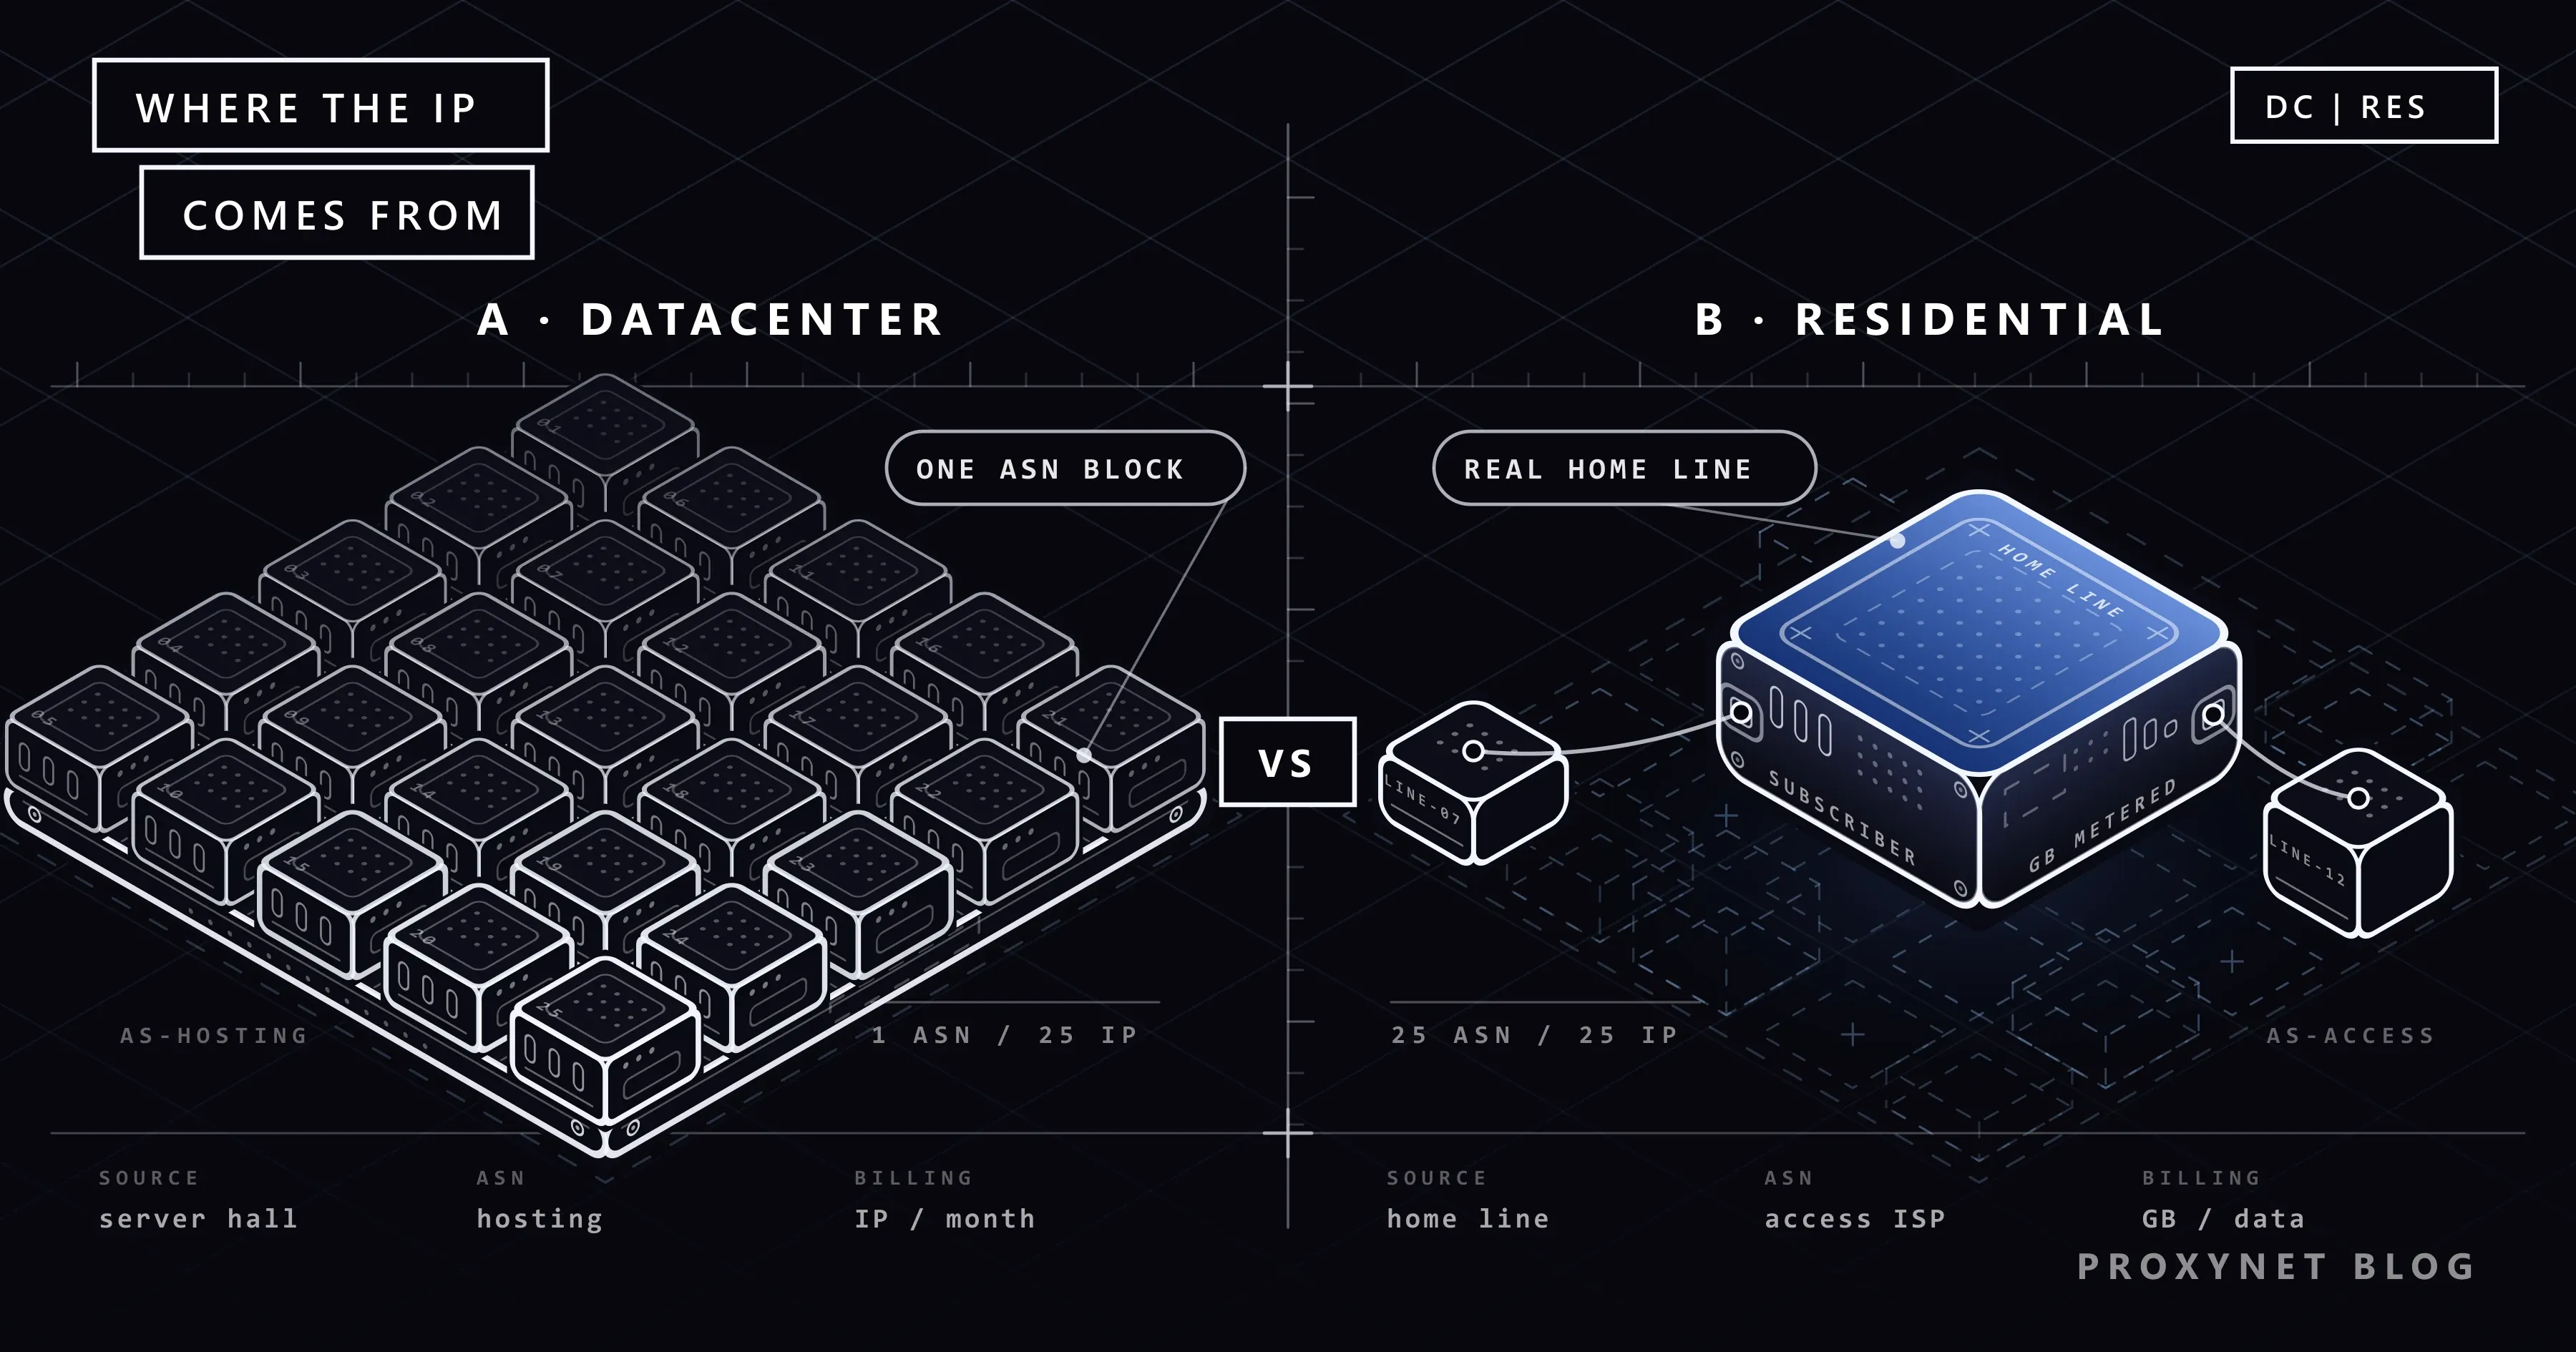
Publicado
Proxies residenciales y de centro de datos: diferencias
Un proxy residencial da IP de conexiones domésticas; uno de centro de datos, de servidores. Velocidad, riesgo de detección, costo y cuál elegir en cada caso.
Autor:Acar Diveroli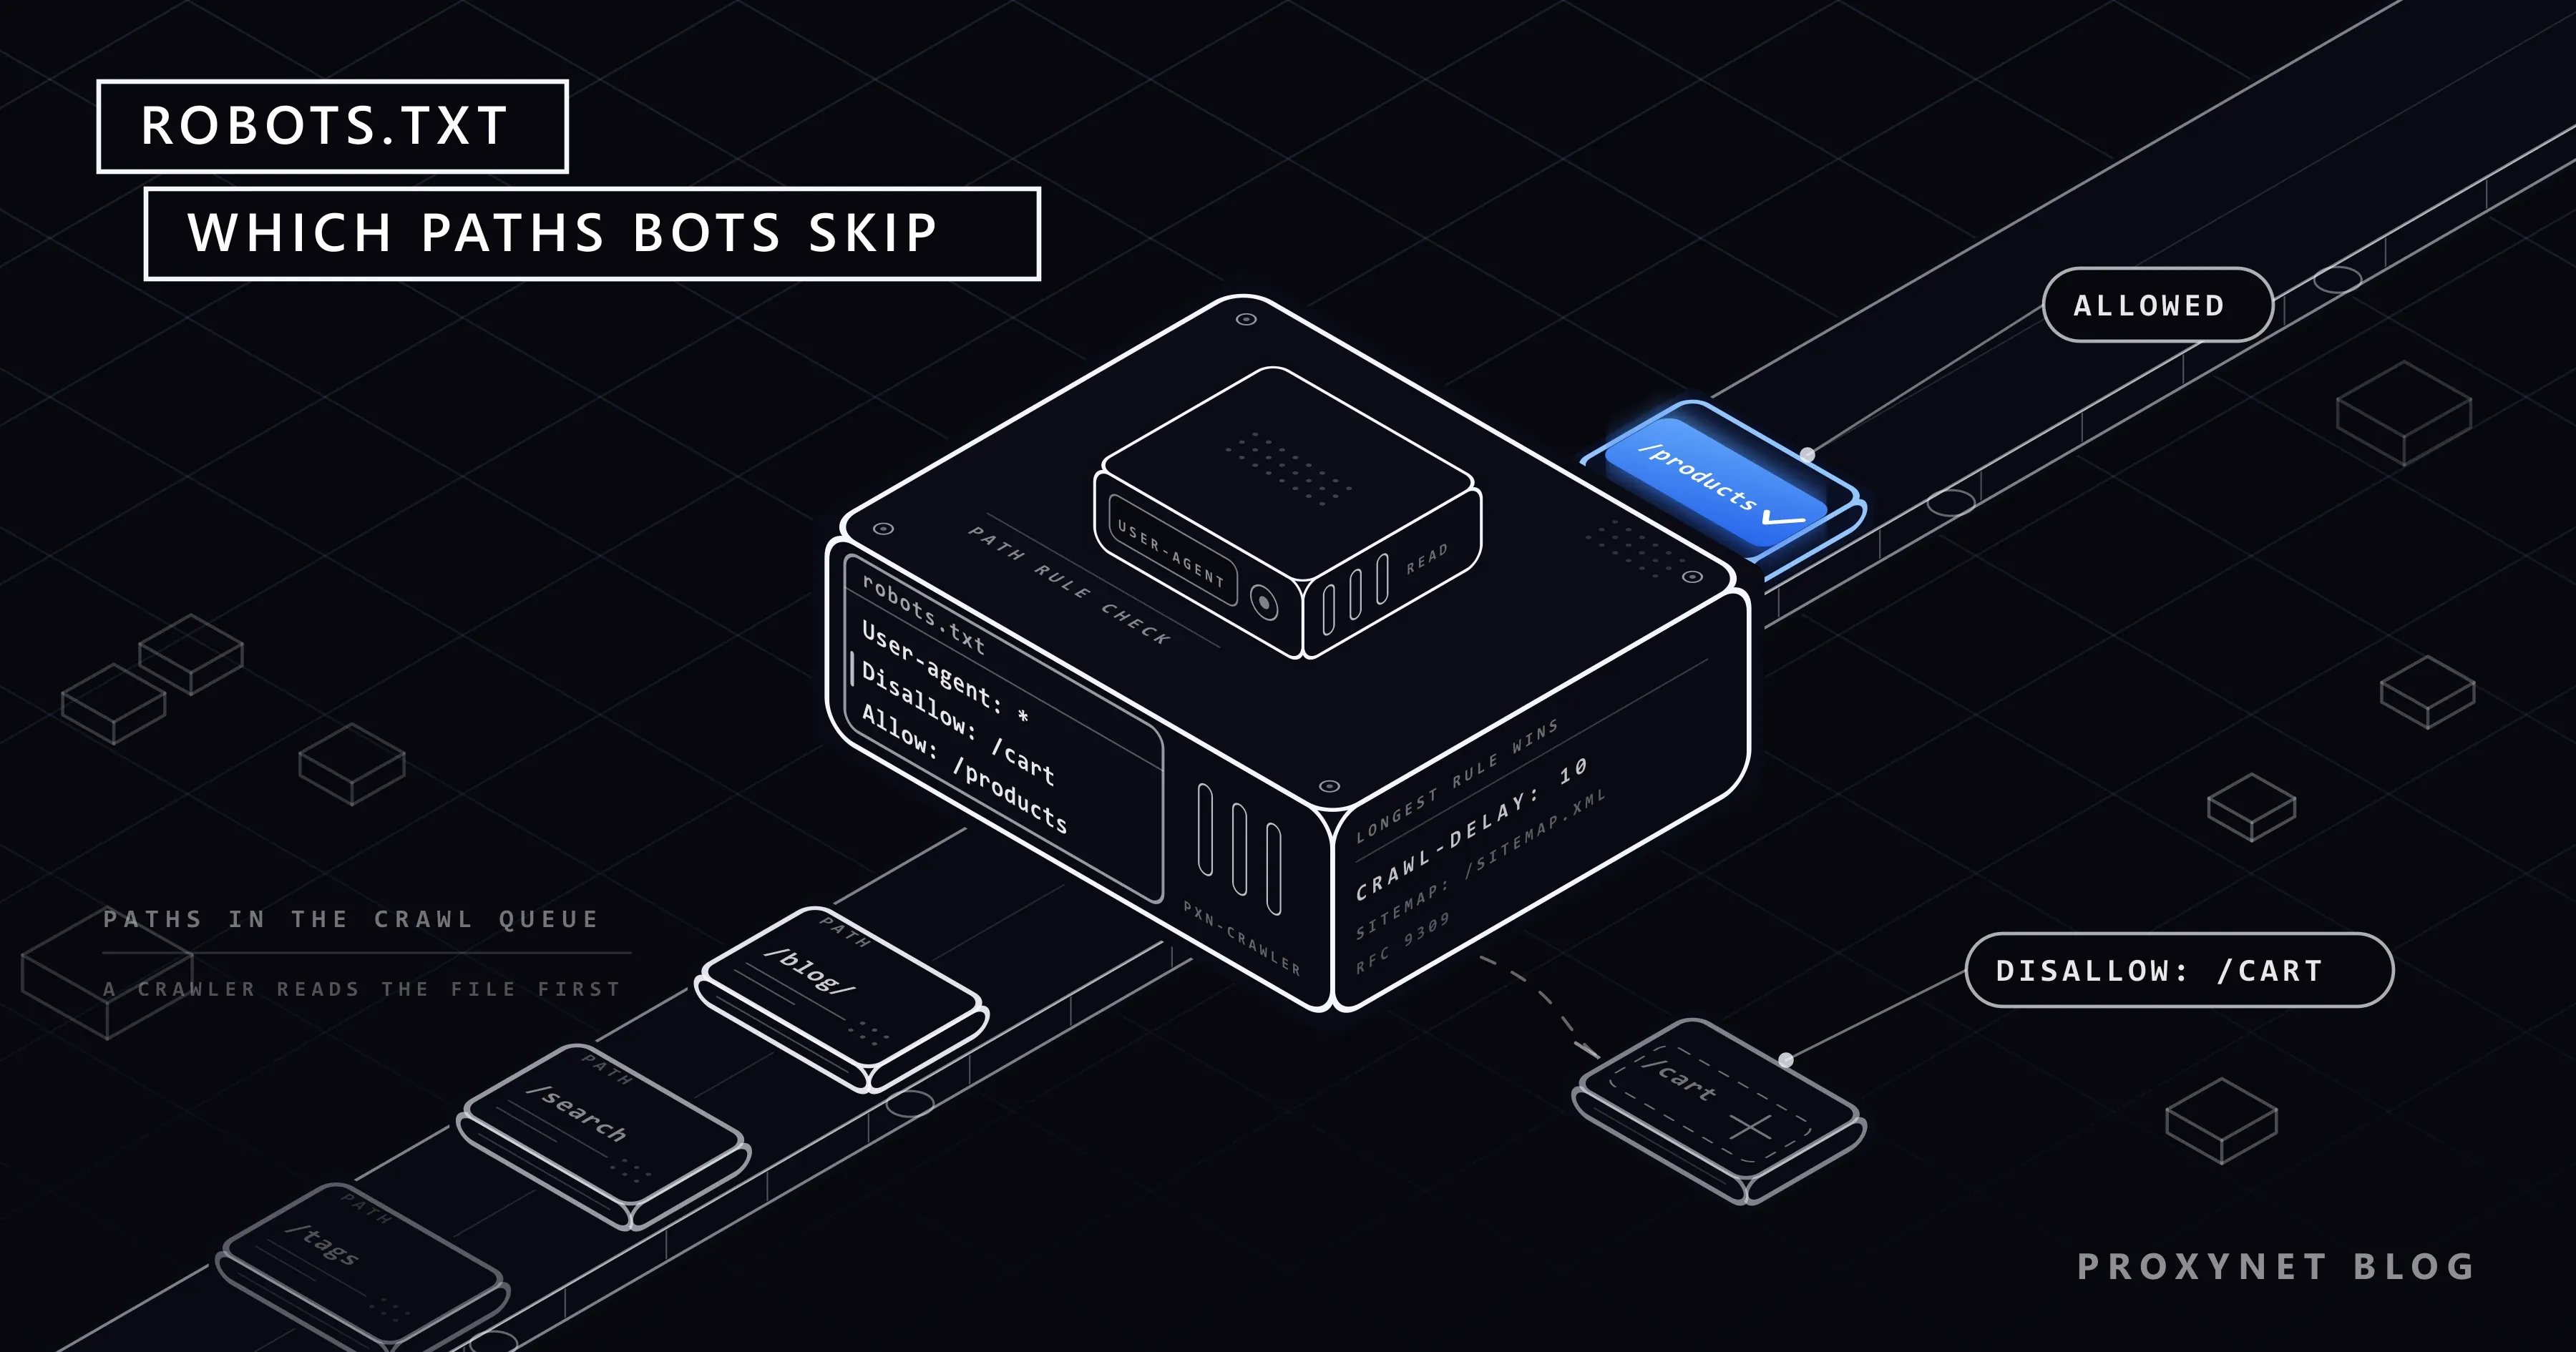
Publicado
Qué es robots.txt y cómo leerlo
robots.txt es el archivo donde un sitio indica a los bots qué rutas no rastrear. Explicamos Disallow, Allow, Crawl-delay y cómo leerlo con Python.
Autor:Acar Diveroli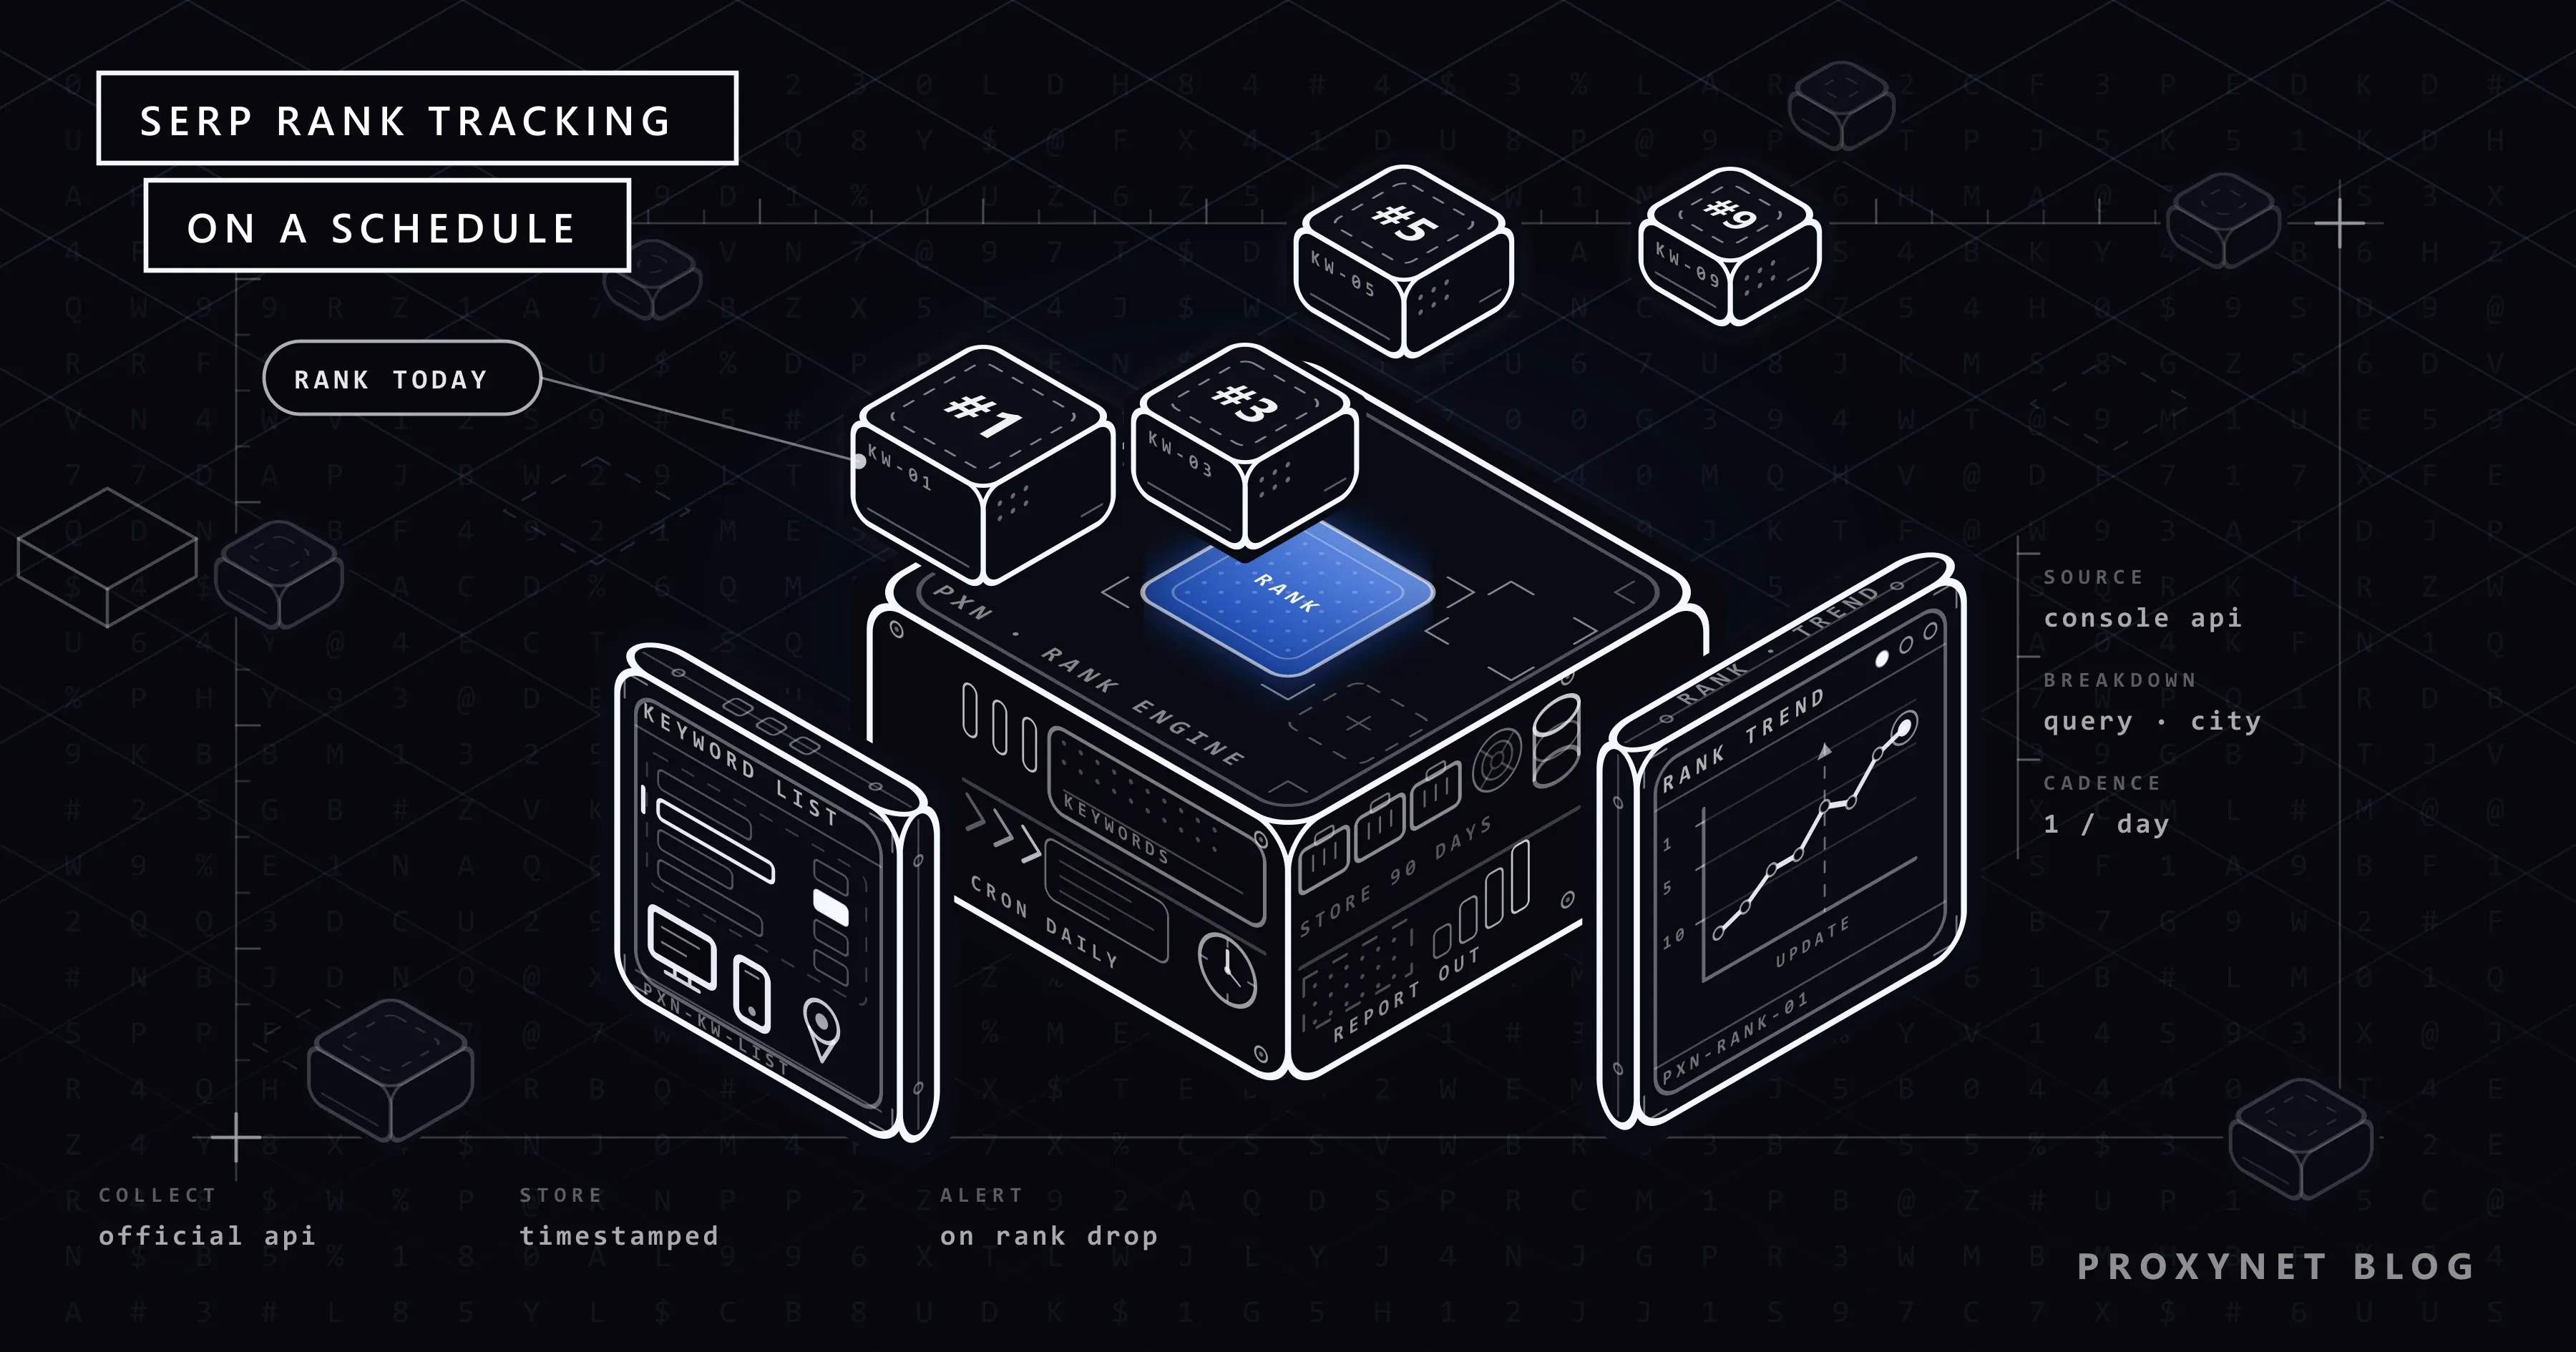
Publicado
Cómo automatizar el seguimiento de posiciones SEO
Revisar posiciones a mano no escala. Explicamos el seguimiento automático de rankings con la API de Search Console, datos SERP y consultas por ubicación.
Autor:Acar Diveroli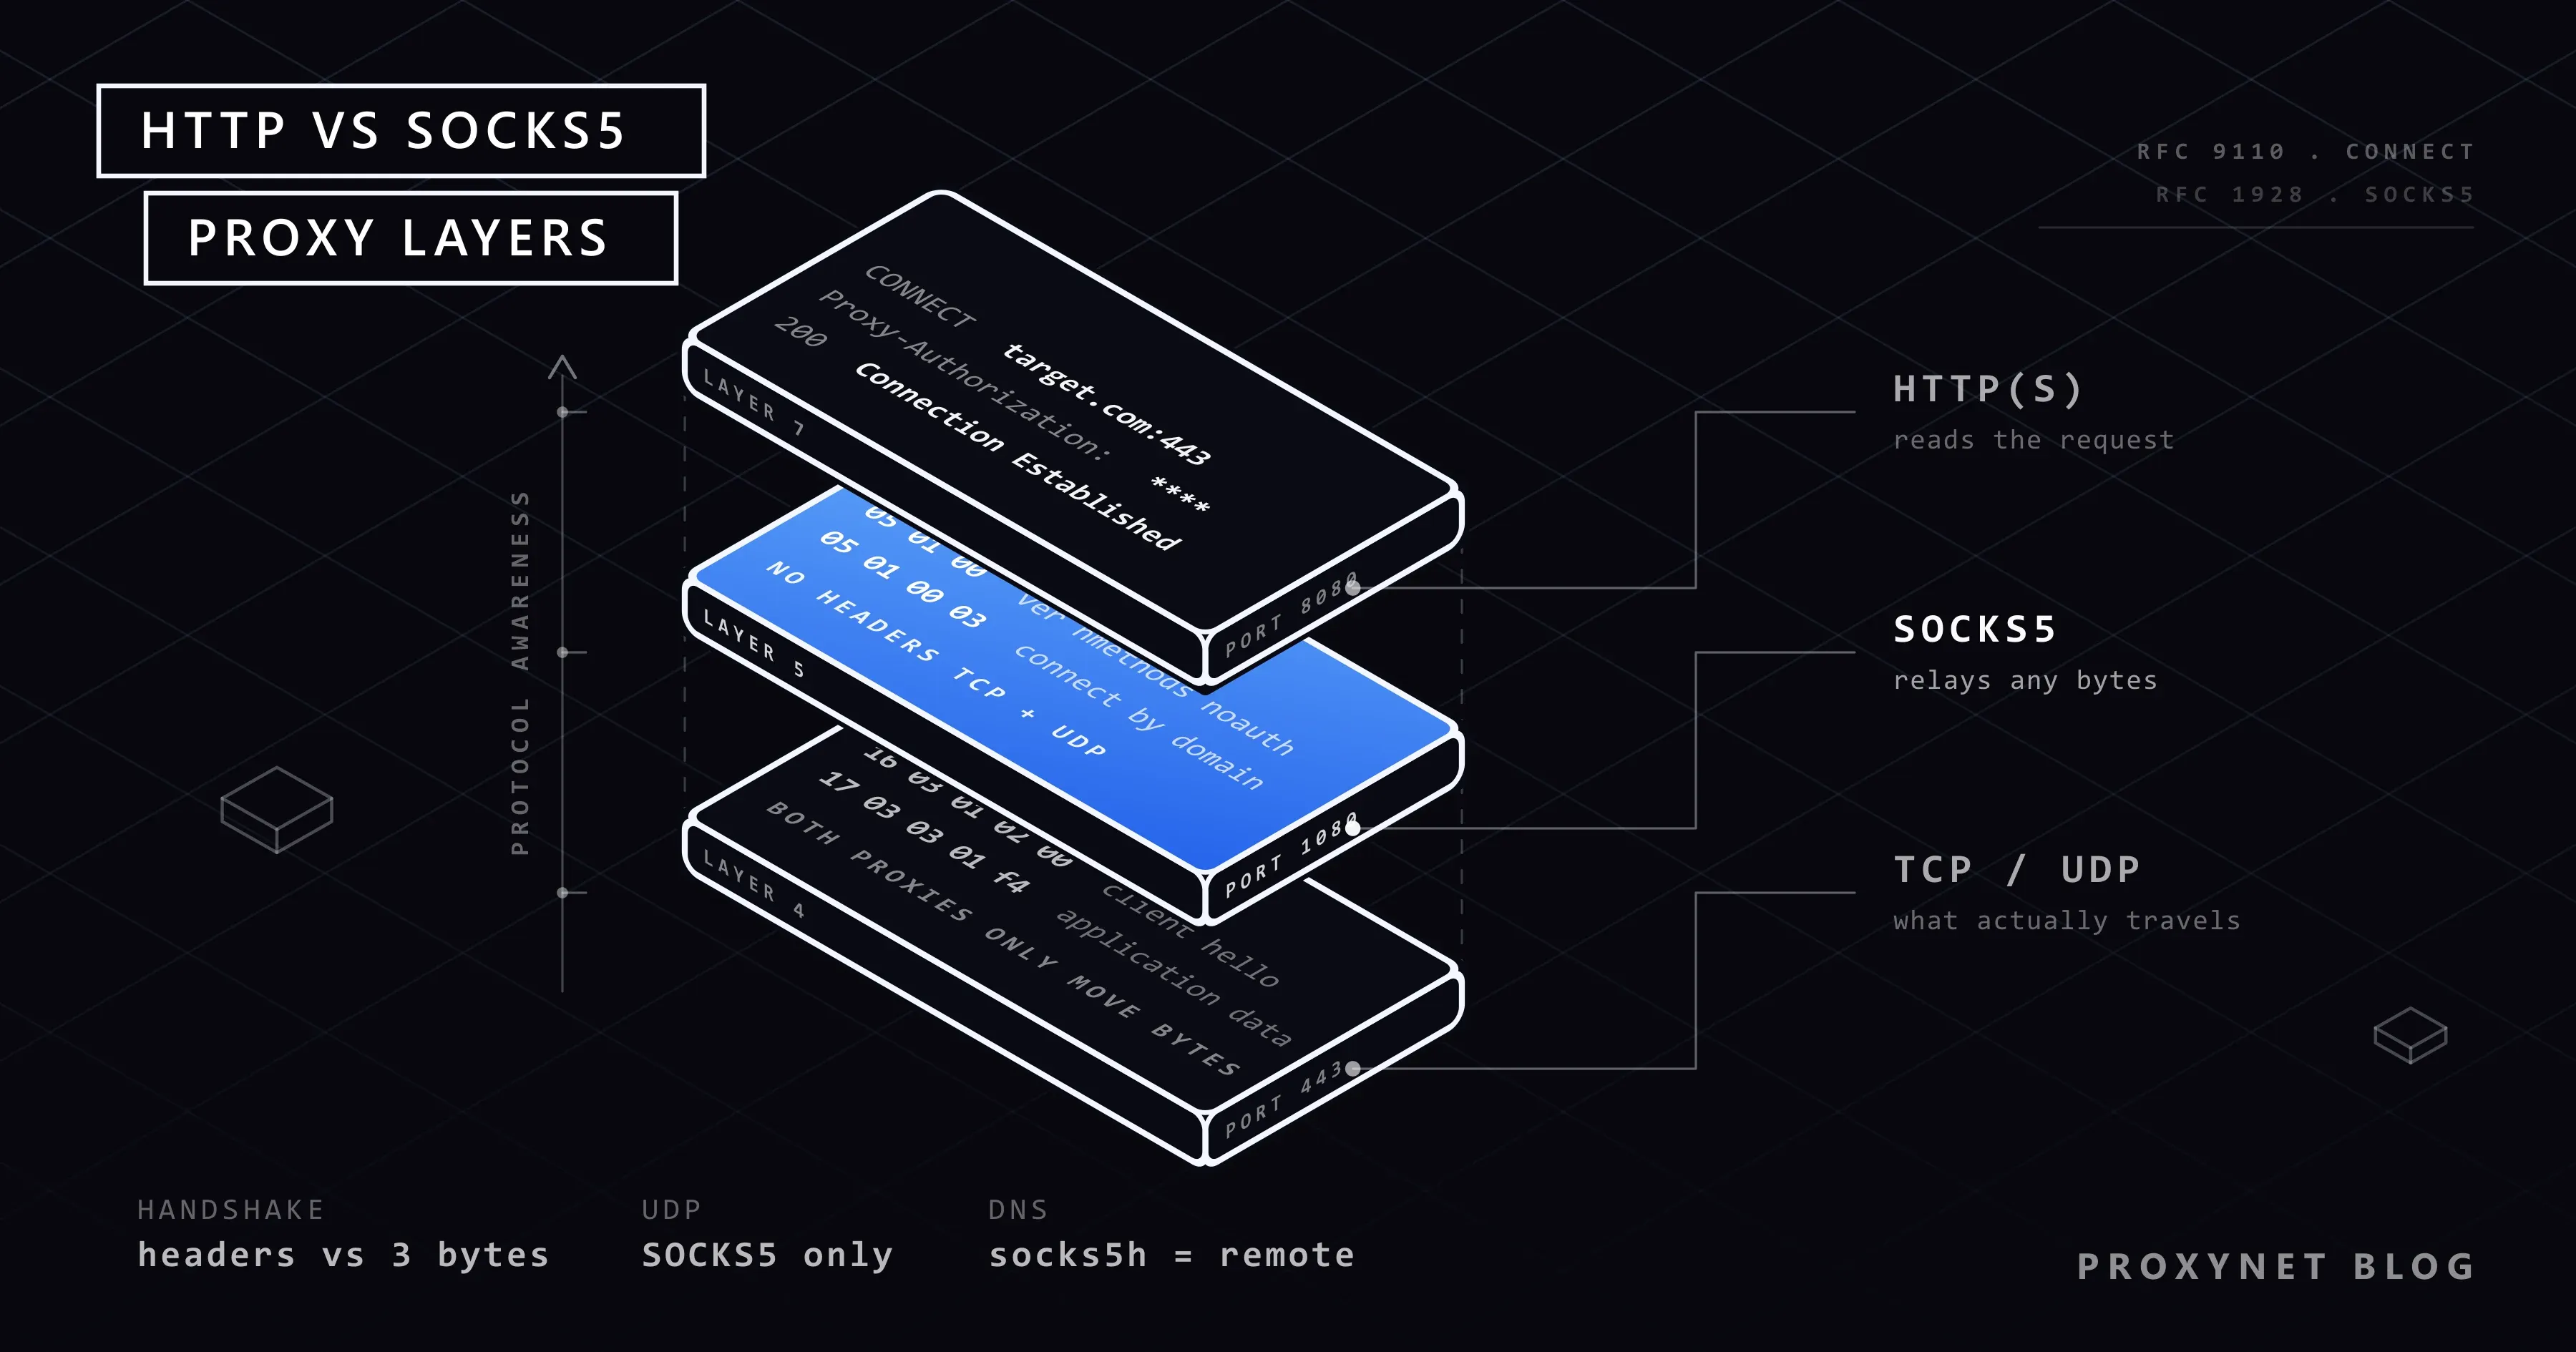
Publicado
Diferencia entre SOCKS y HTTP: ¿cuál elegir?
El proxy HTTP entiende las peticiones web; SOCKS5 mueve todo el tráfico TCP y UDP sin mirar el contenido. Según velocidad, compatibilidad y uso, ¿cuál conviene?
Autor:Acar Diveroli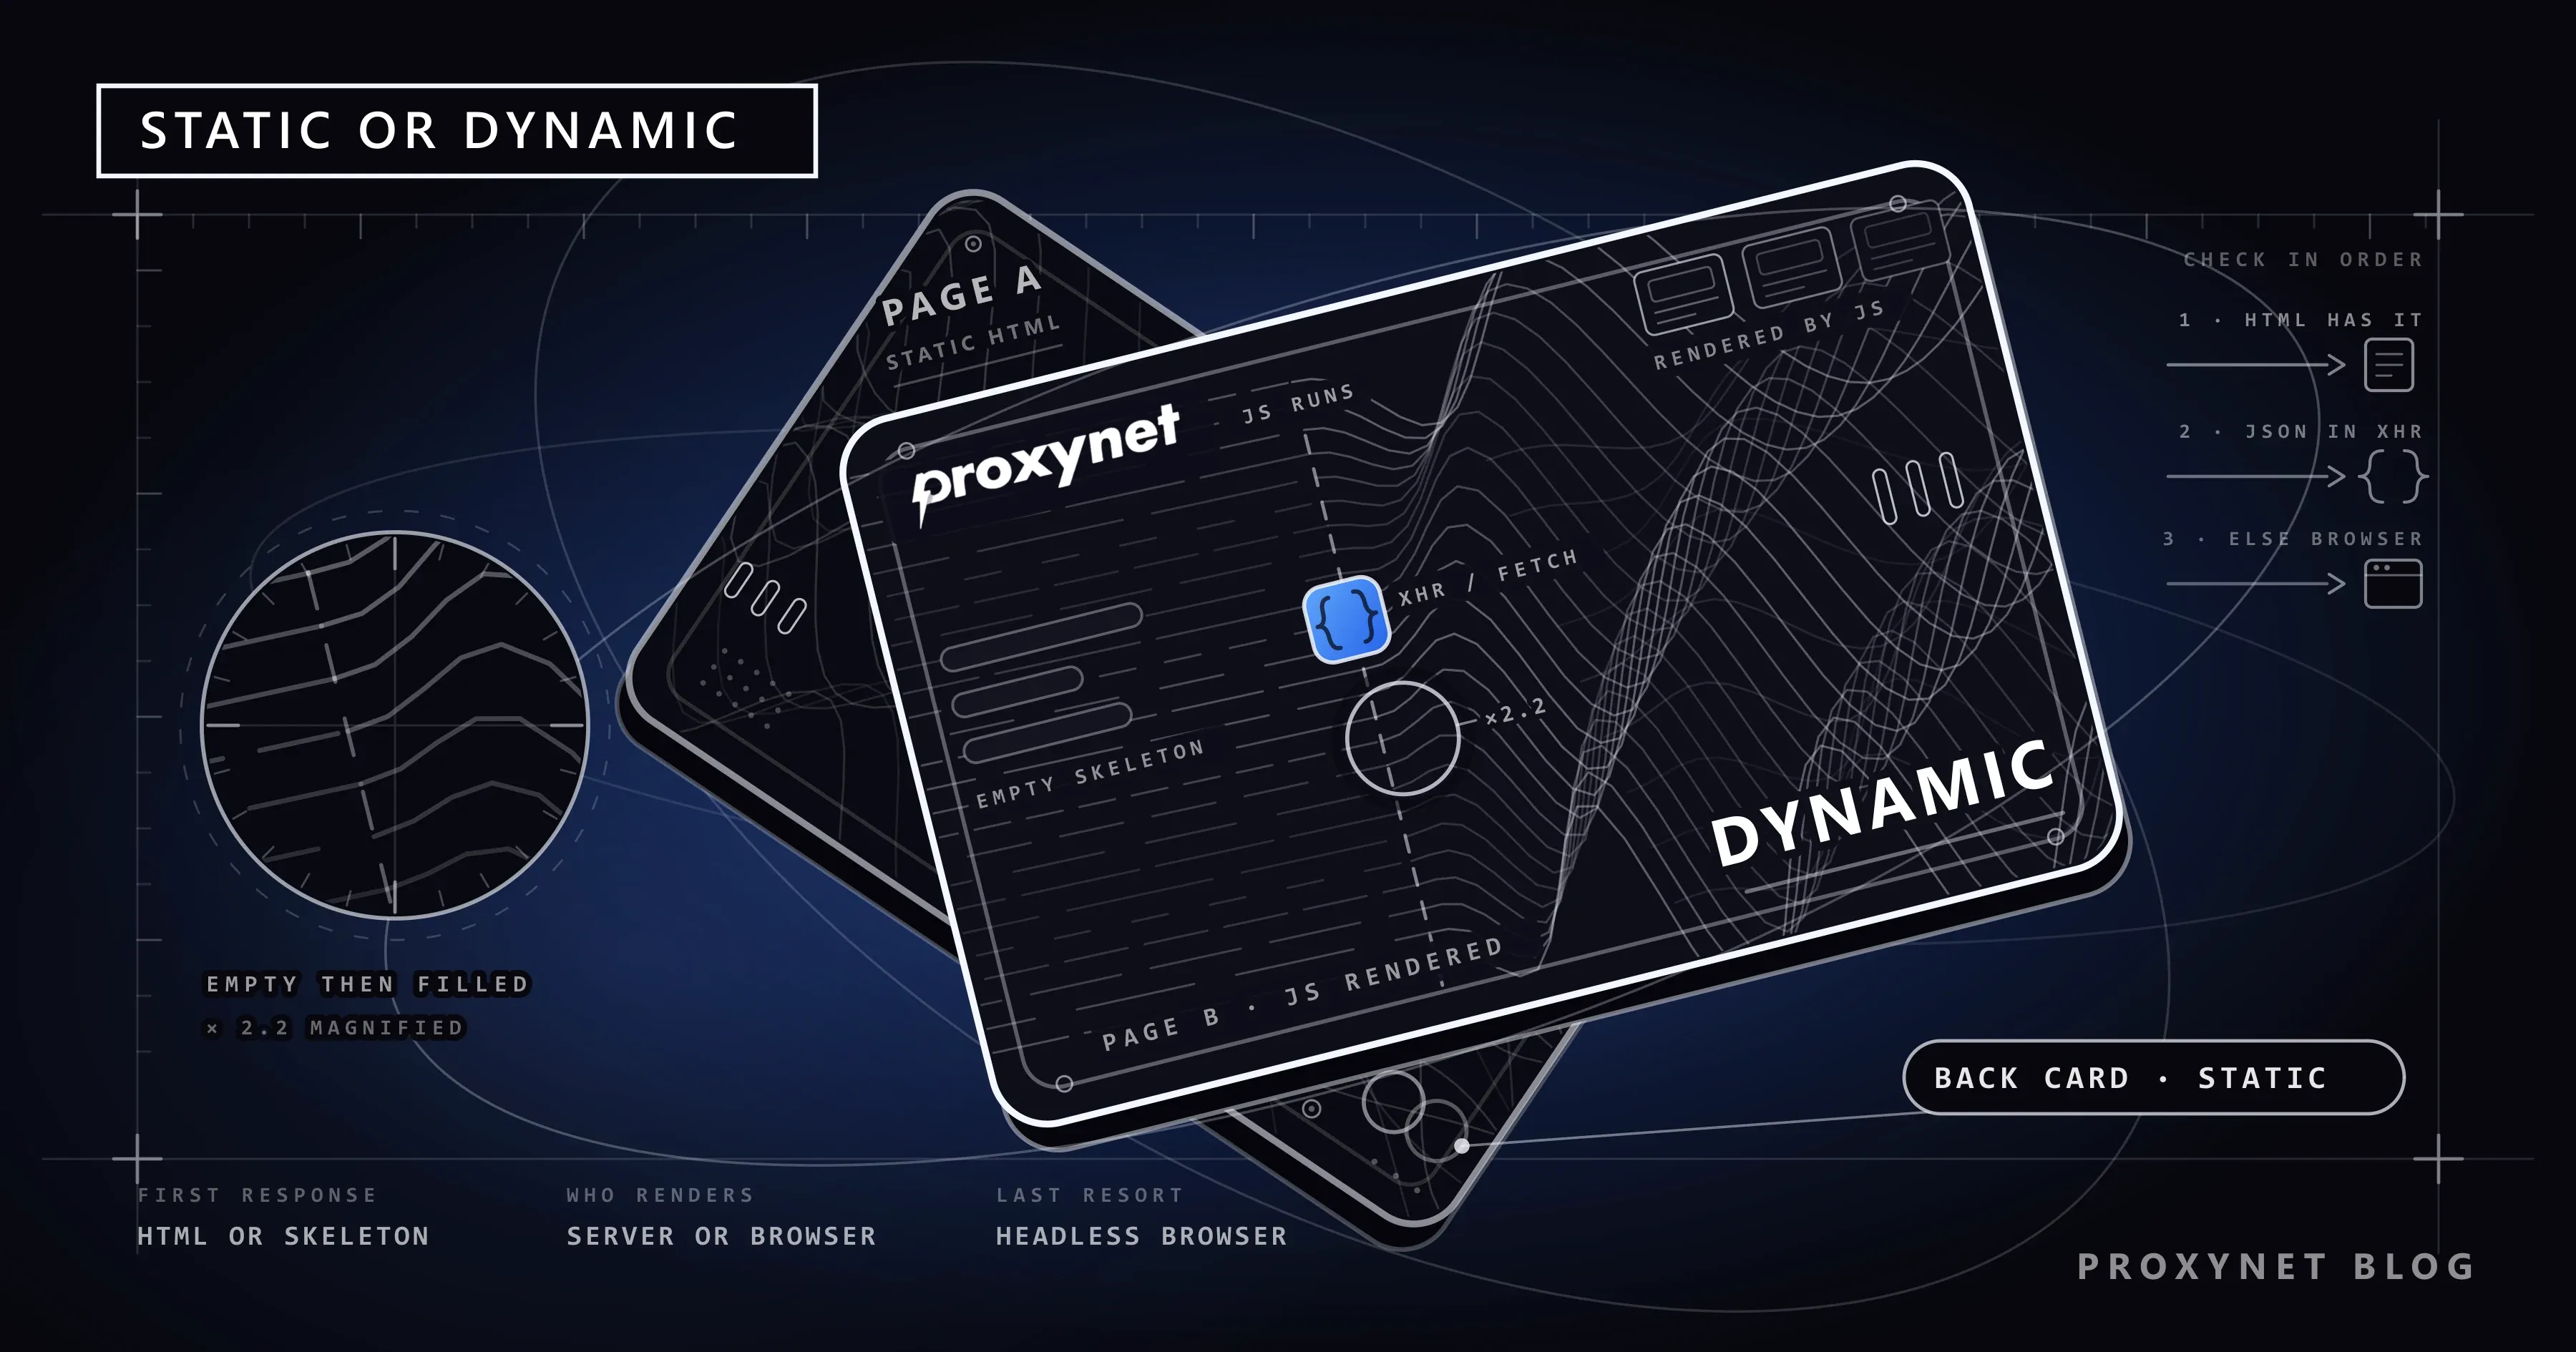
Publicado
Páginas estáticas y dinámicas en web scraping
Las páginas dinámicas cargan el contenido con JavaScript, así que una petición simple vuelve vacía. Explicamos cuándo hace falta un navegador headless.
Autor:Acar Diveroli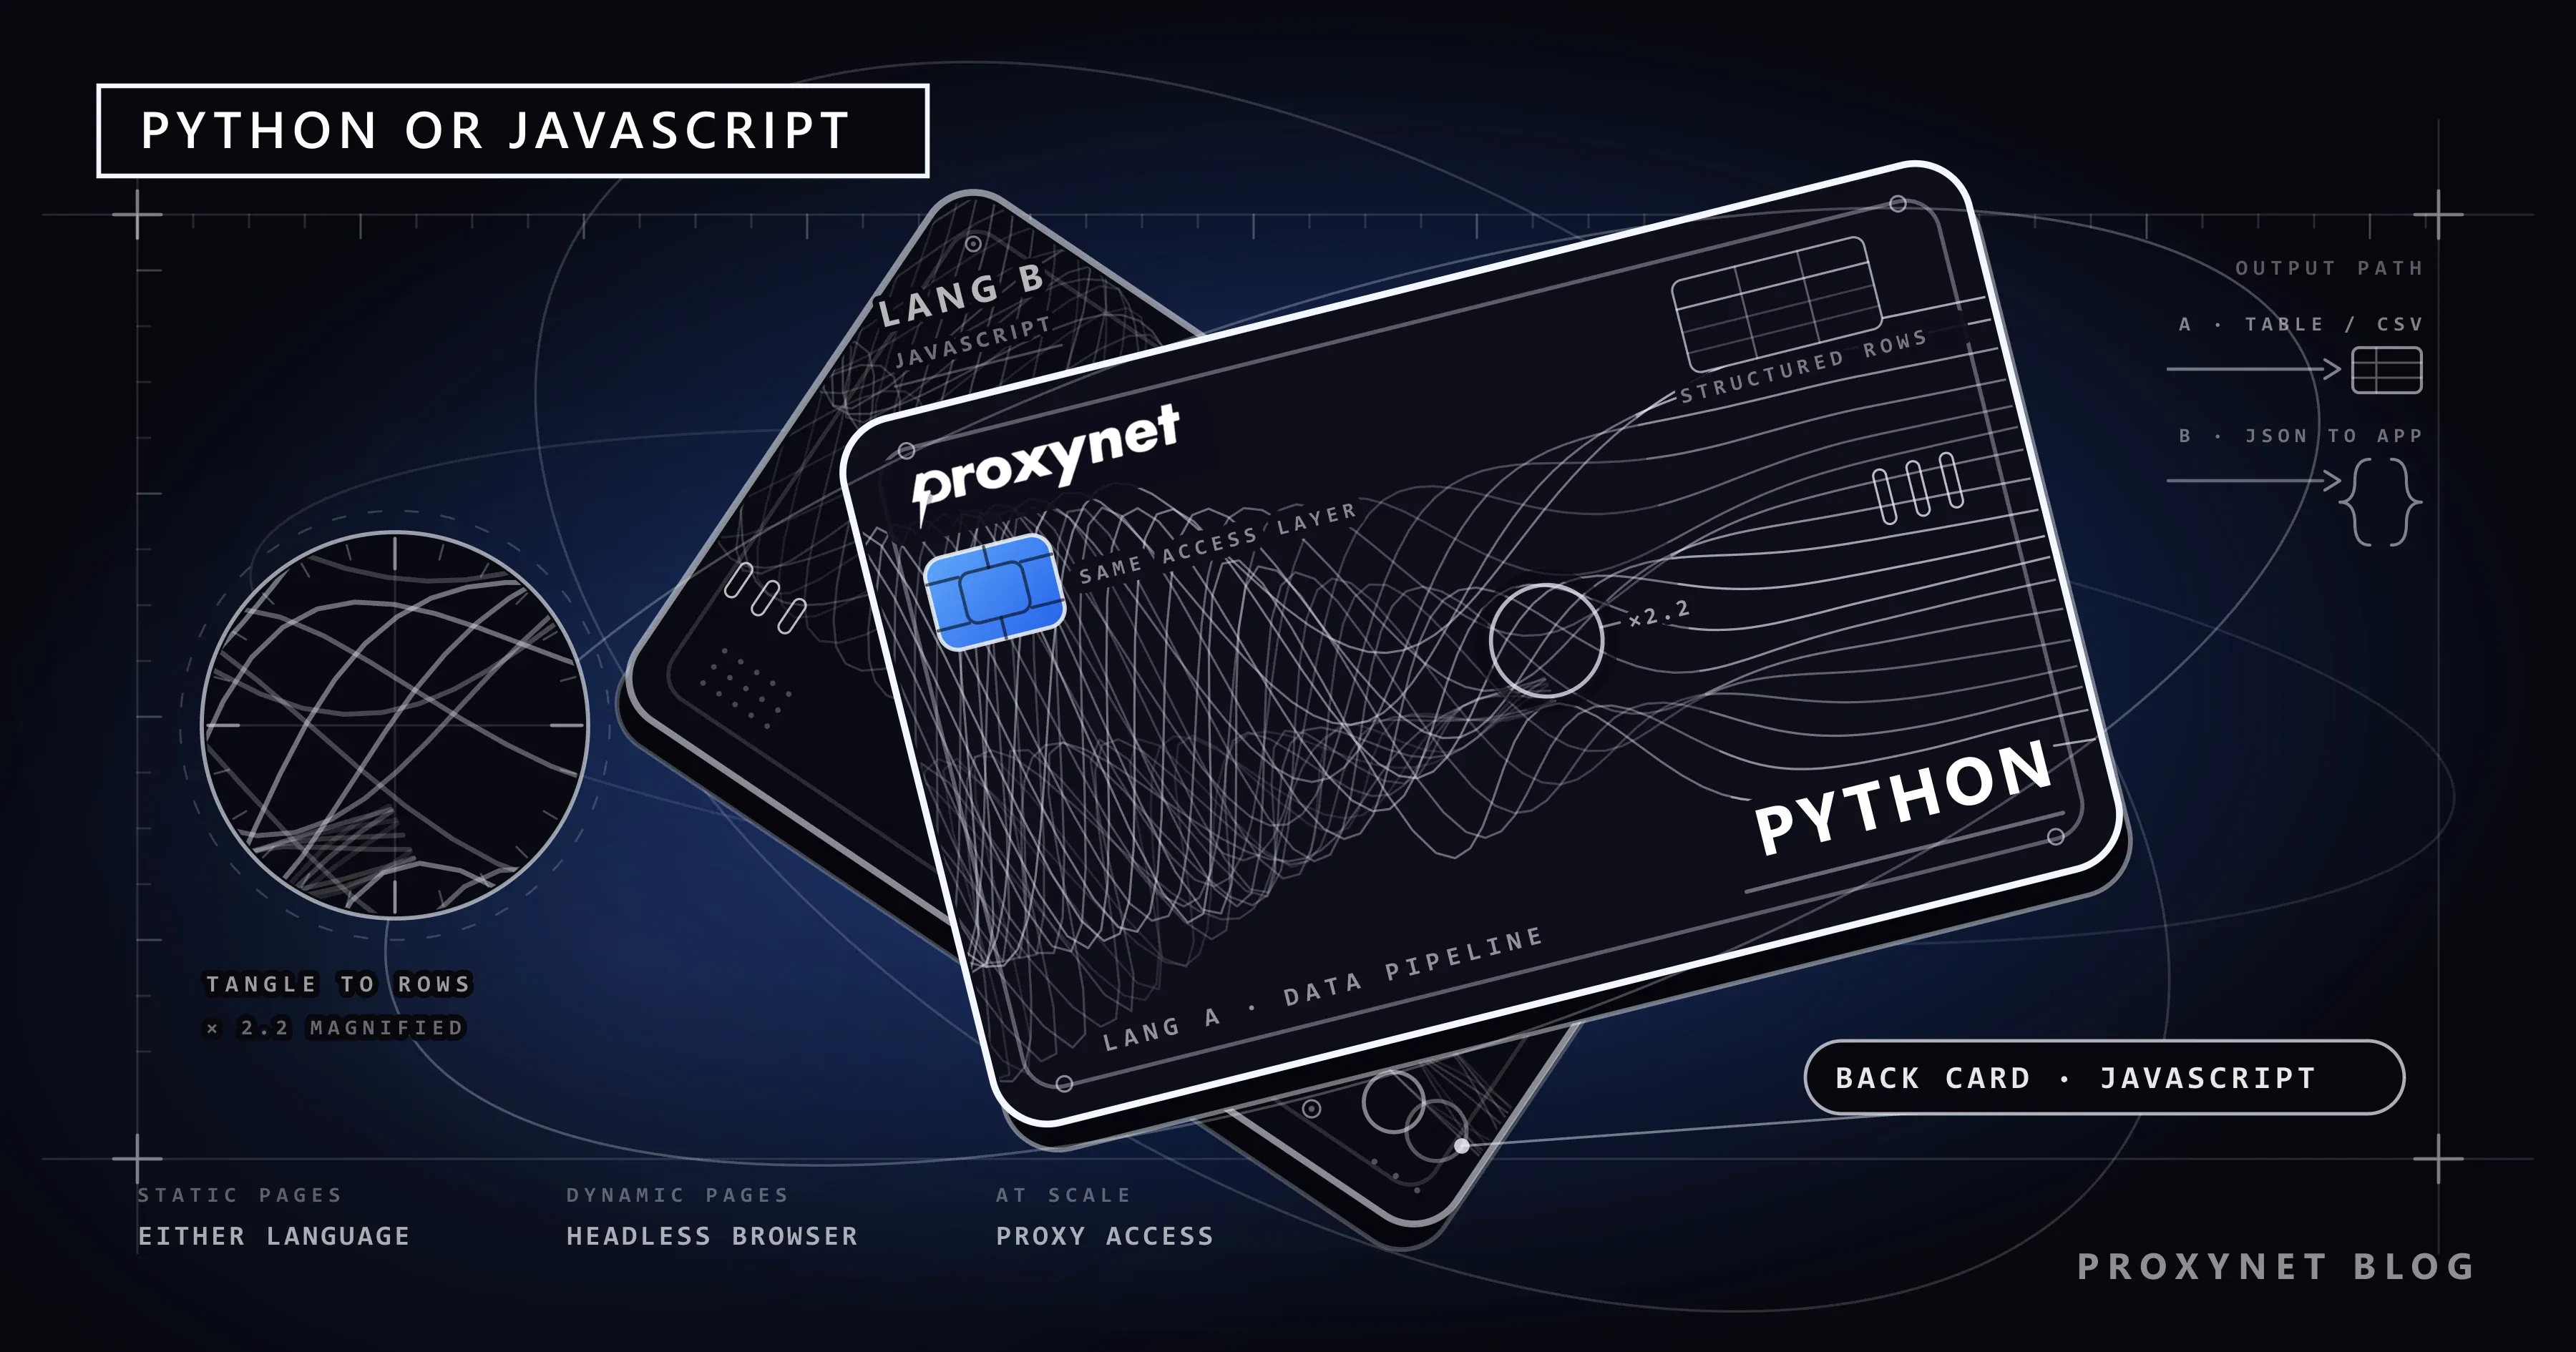
Publicado
Web scraping: ¿JavaScript o Python?
Python destaca por sus librerías de análisis de datos; JavaScript, por páginas dinámicas y automatización de navegador. Comparamos cuál conviene a tu proyecto.
Autor:Acar Diveroli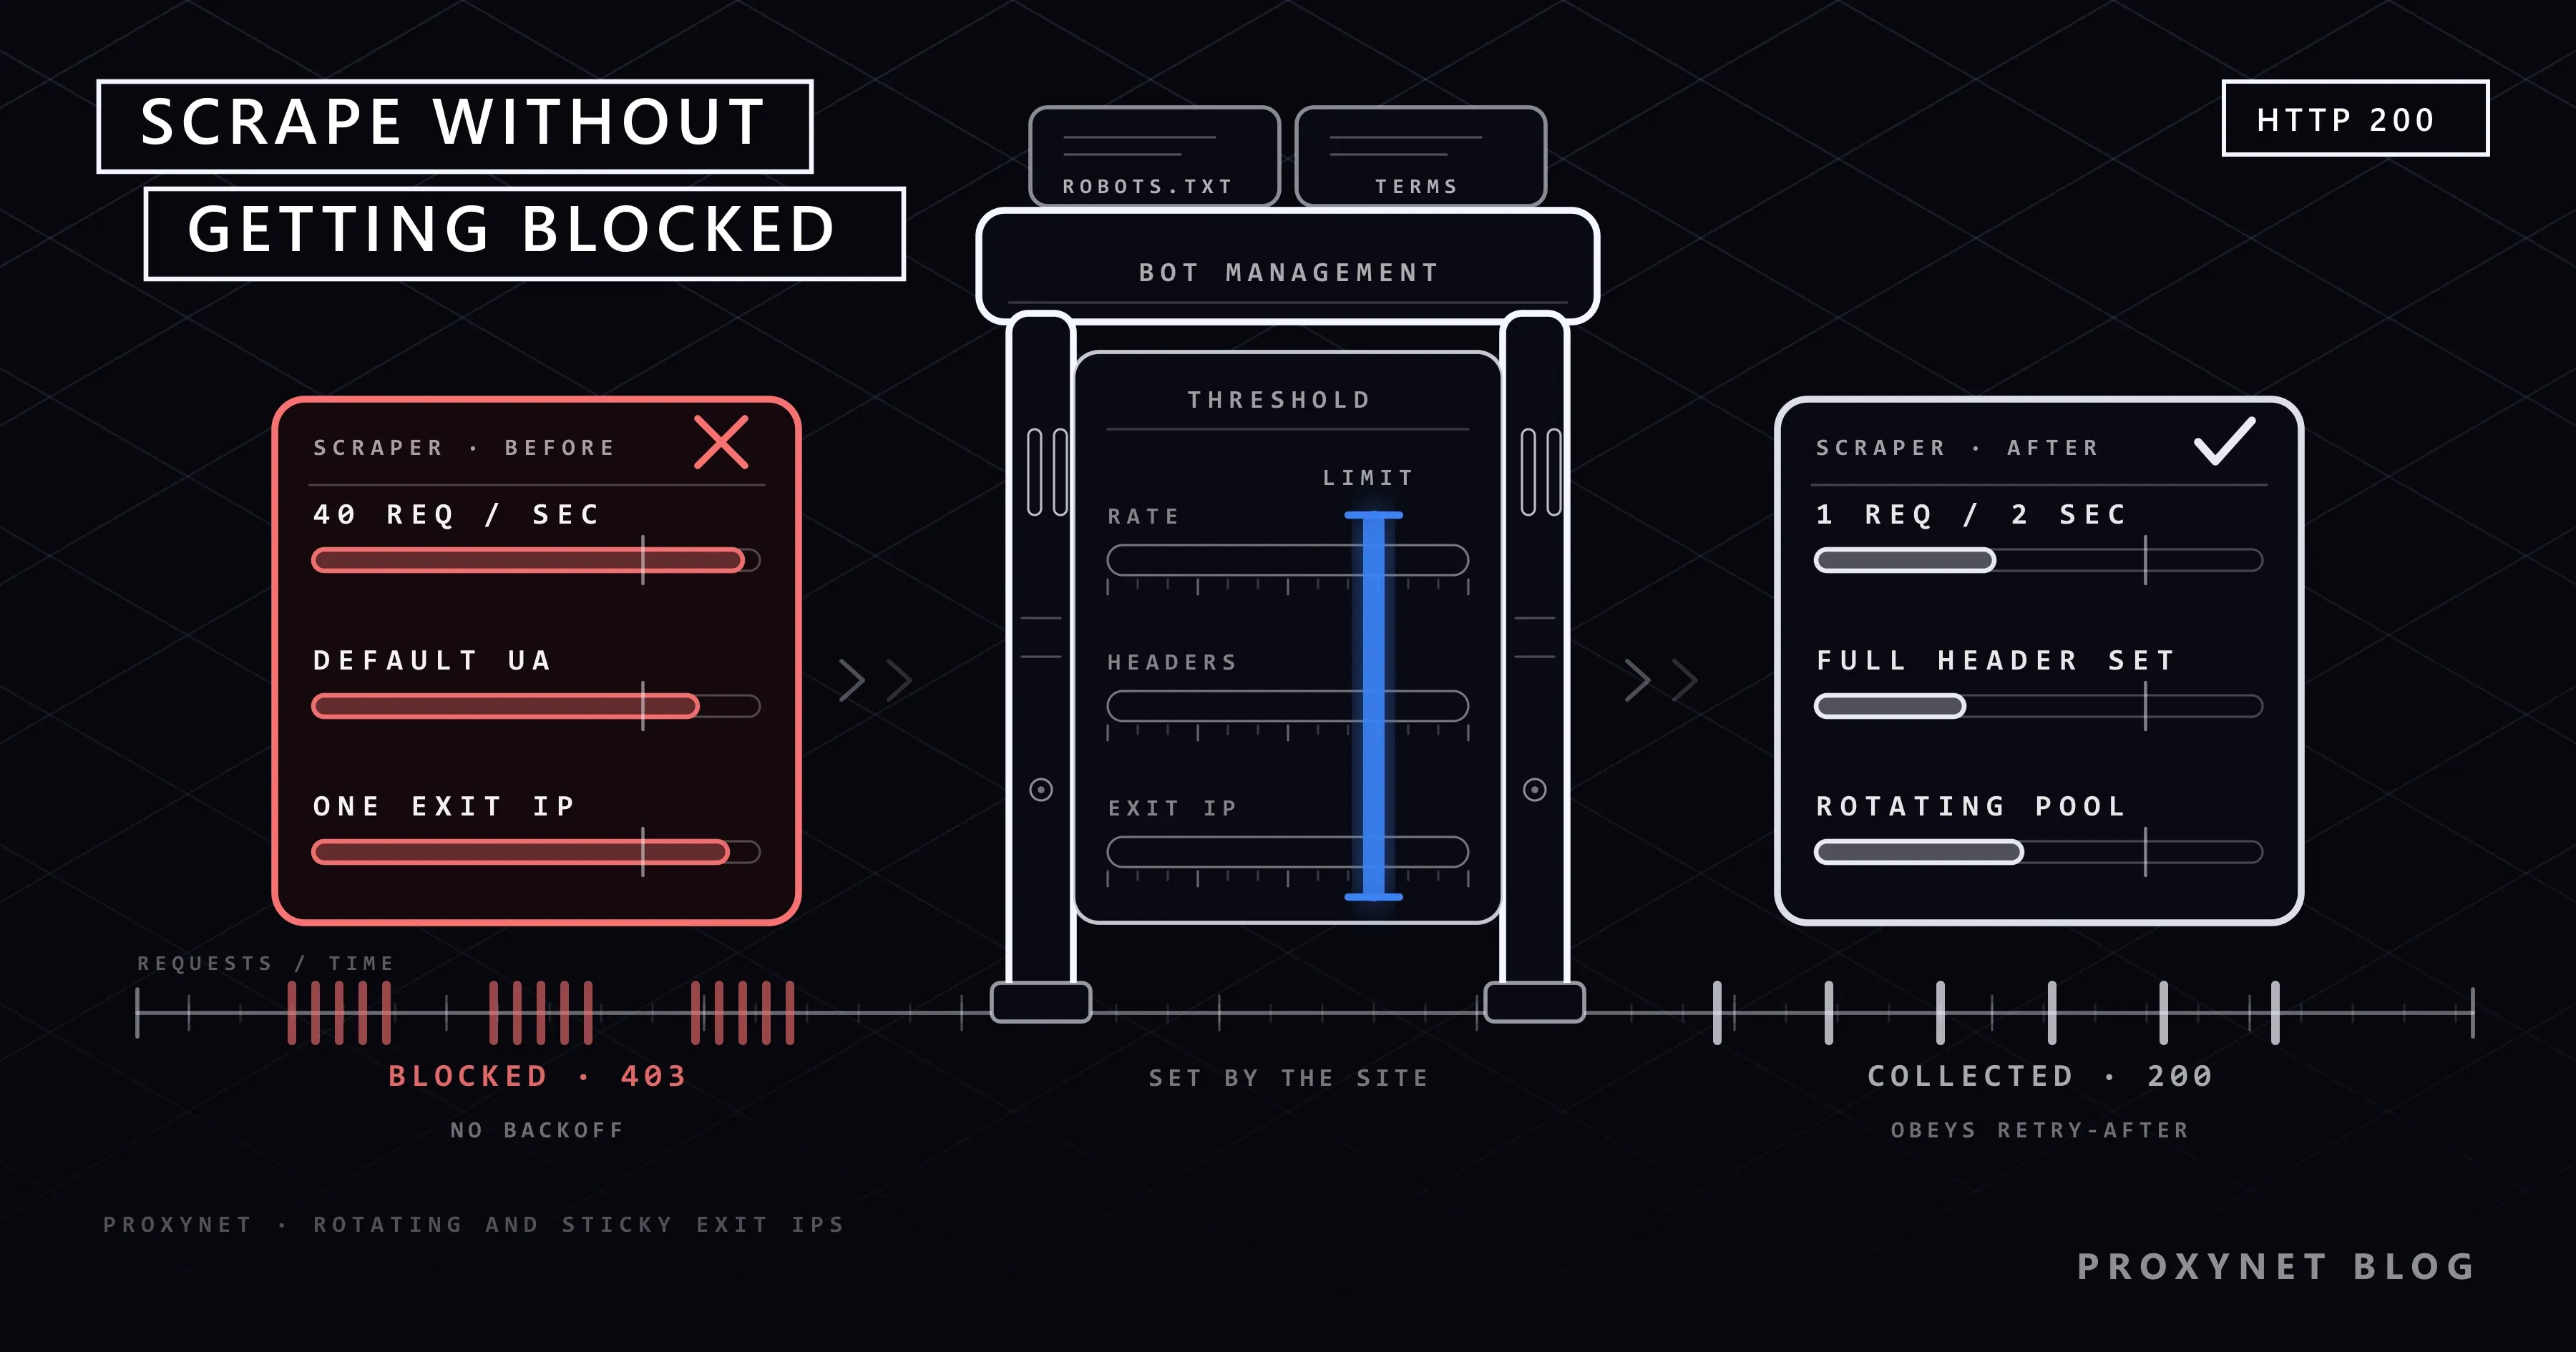
Publicado
Cómo hacer web scraping sin que te bloqueen
Los scrapers se bloquean sobre todo por límites de velocidad, cabeceras y una sola IP. Explicamos cómo recoger datos según las reglas sin saturar el sitio.
Autor:Acar Diveroli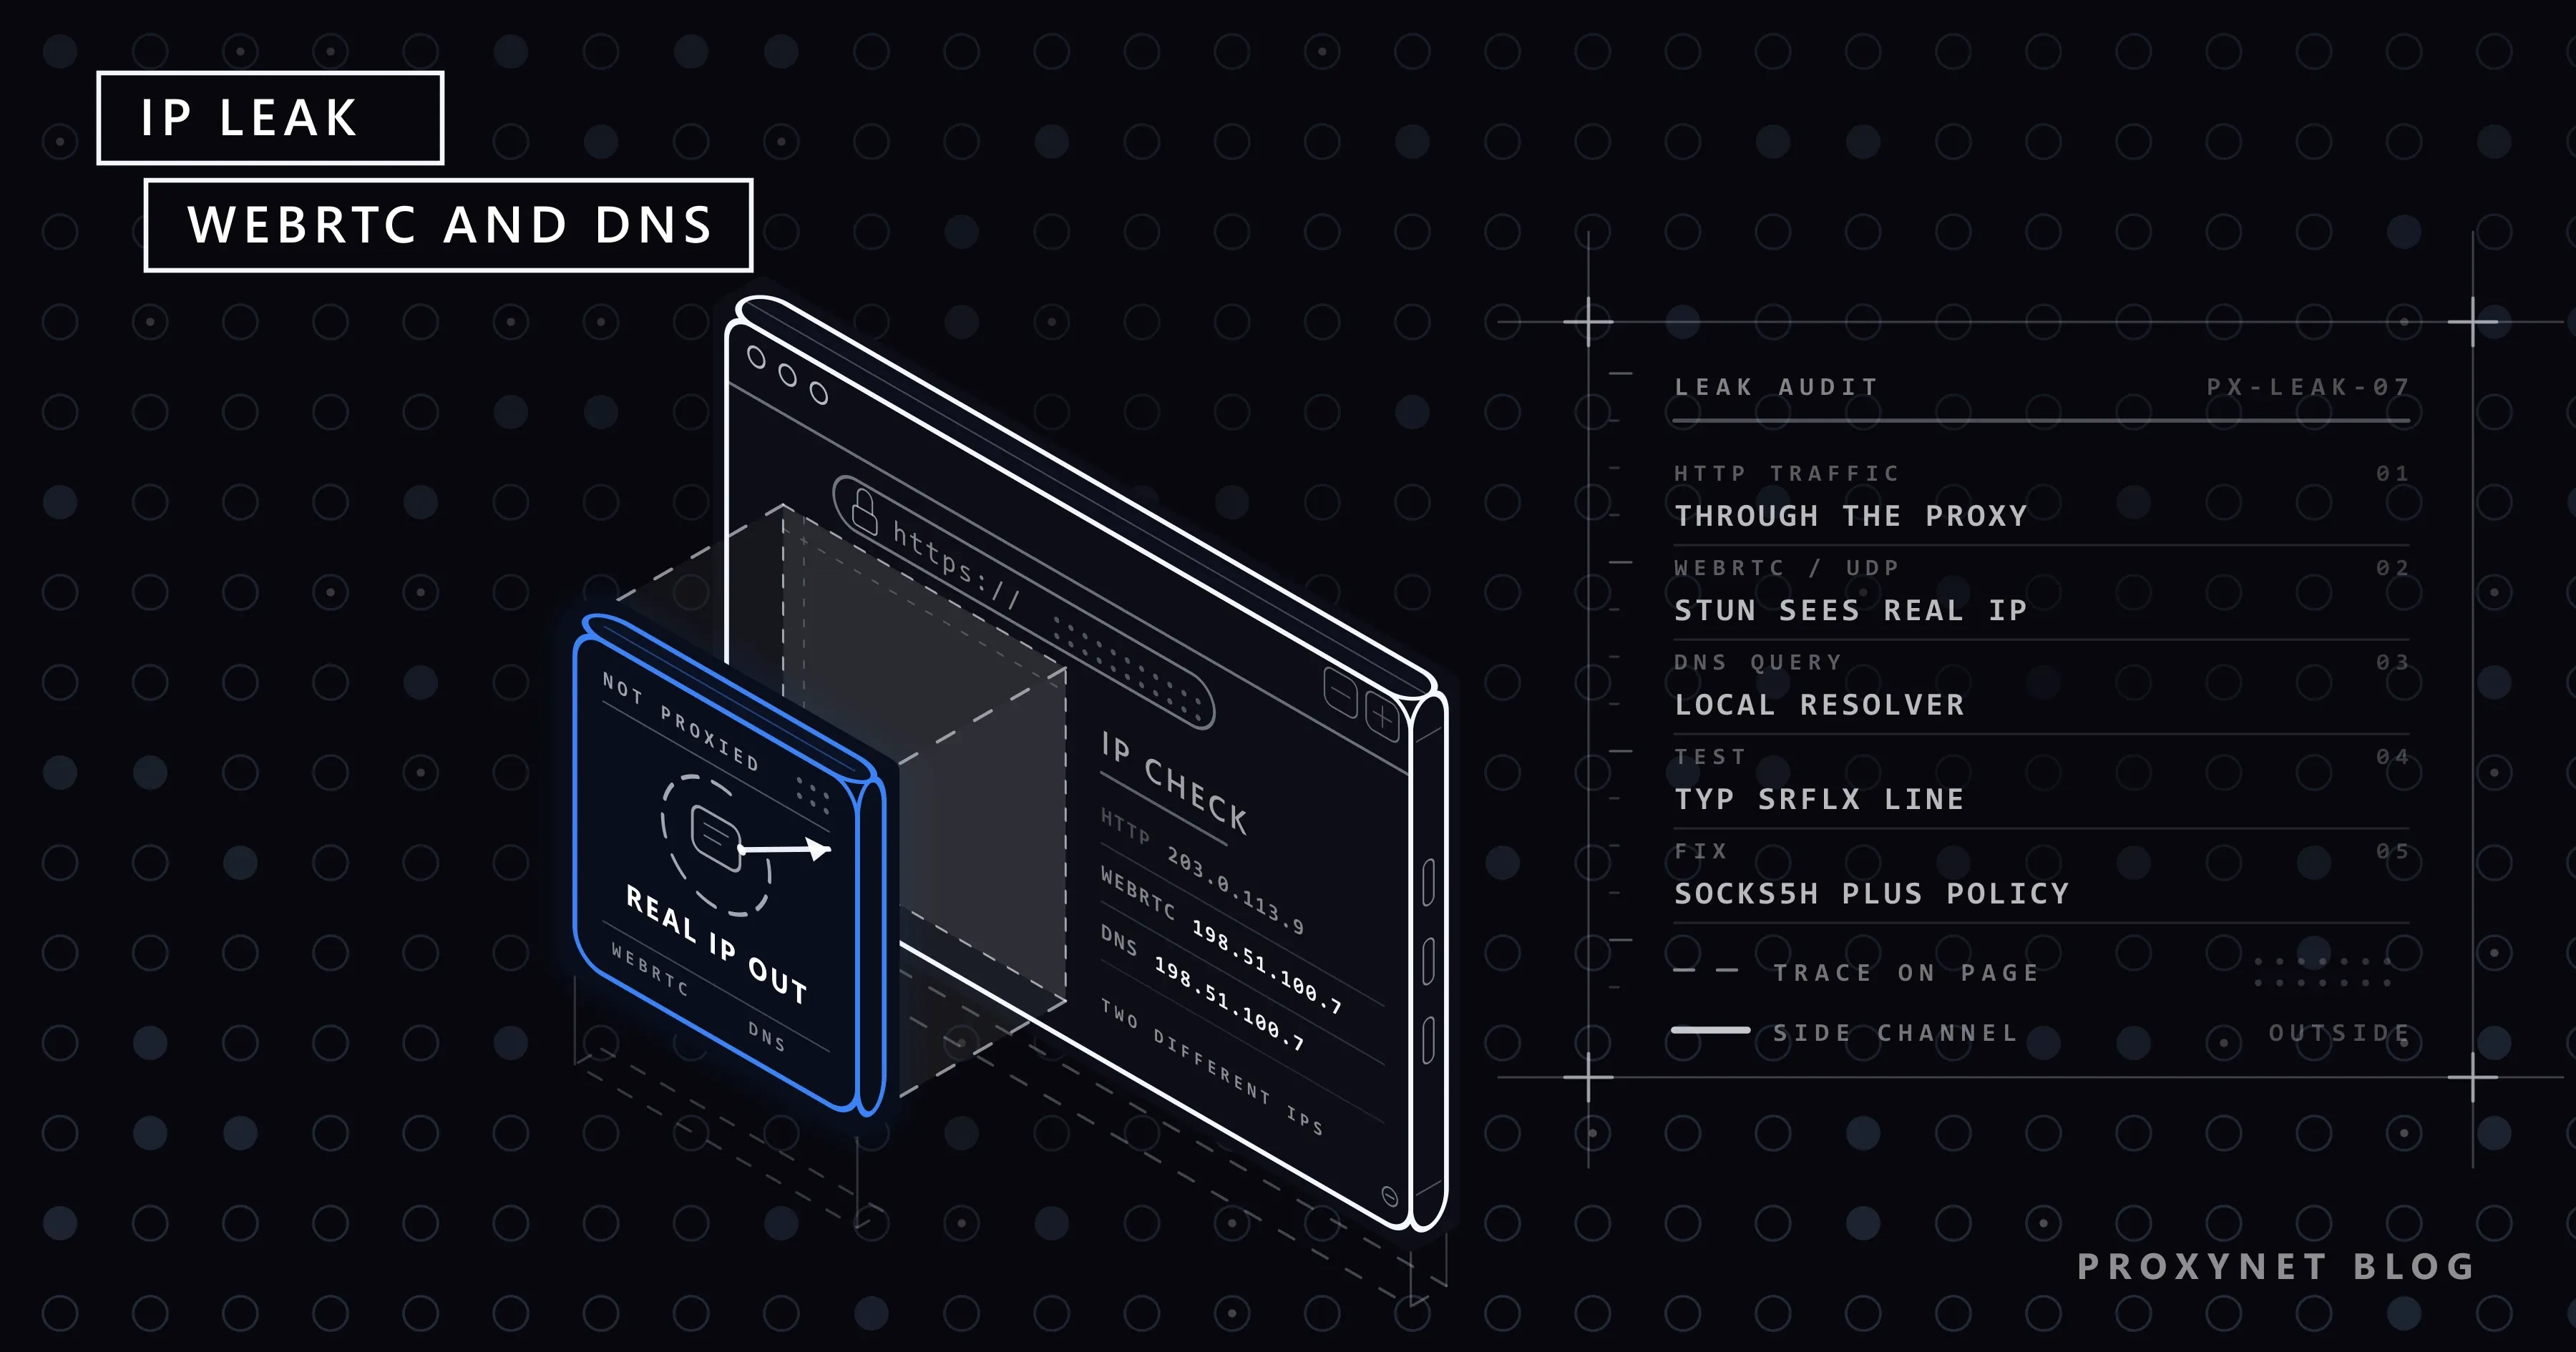
Publicado
Fugas de WebRTC y DNS: qué son y cómo evitarlas
Incluso con un proxy activo, el navegador puede revelar tu IP real por WebRTC o DNS. Explicamos por qué ocurren las fugas, cómo detectarlas y cerrarlas.
Autor:Acar Diveroli
Publicado
Proxy con wget: comandos y ejemplos
Puedes indicarle el proxy a wget con una variable de entorno, el archivo .wgetrc o la opción -e. Explicamos autenticación, HTTPS y errores comunes con ejemplos.
Autor:Acar Diveroli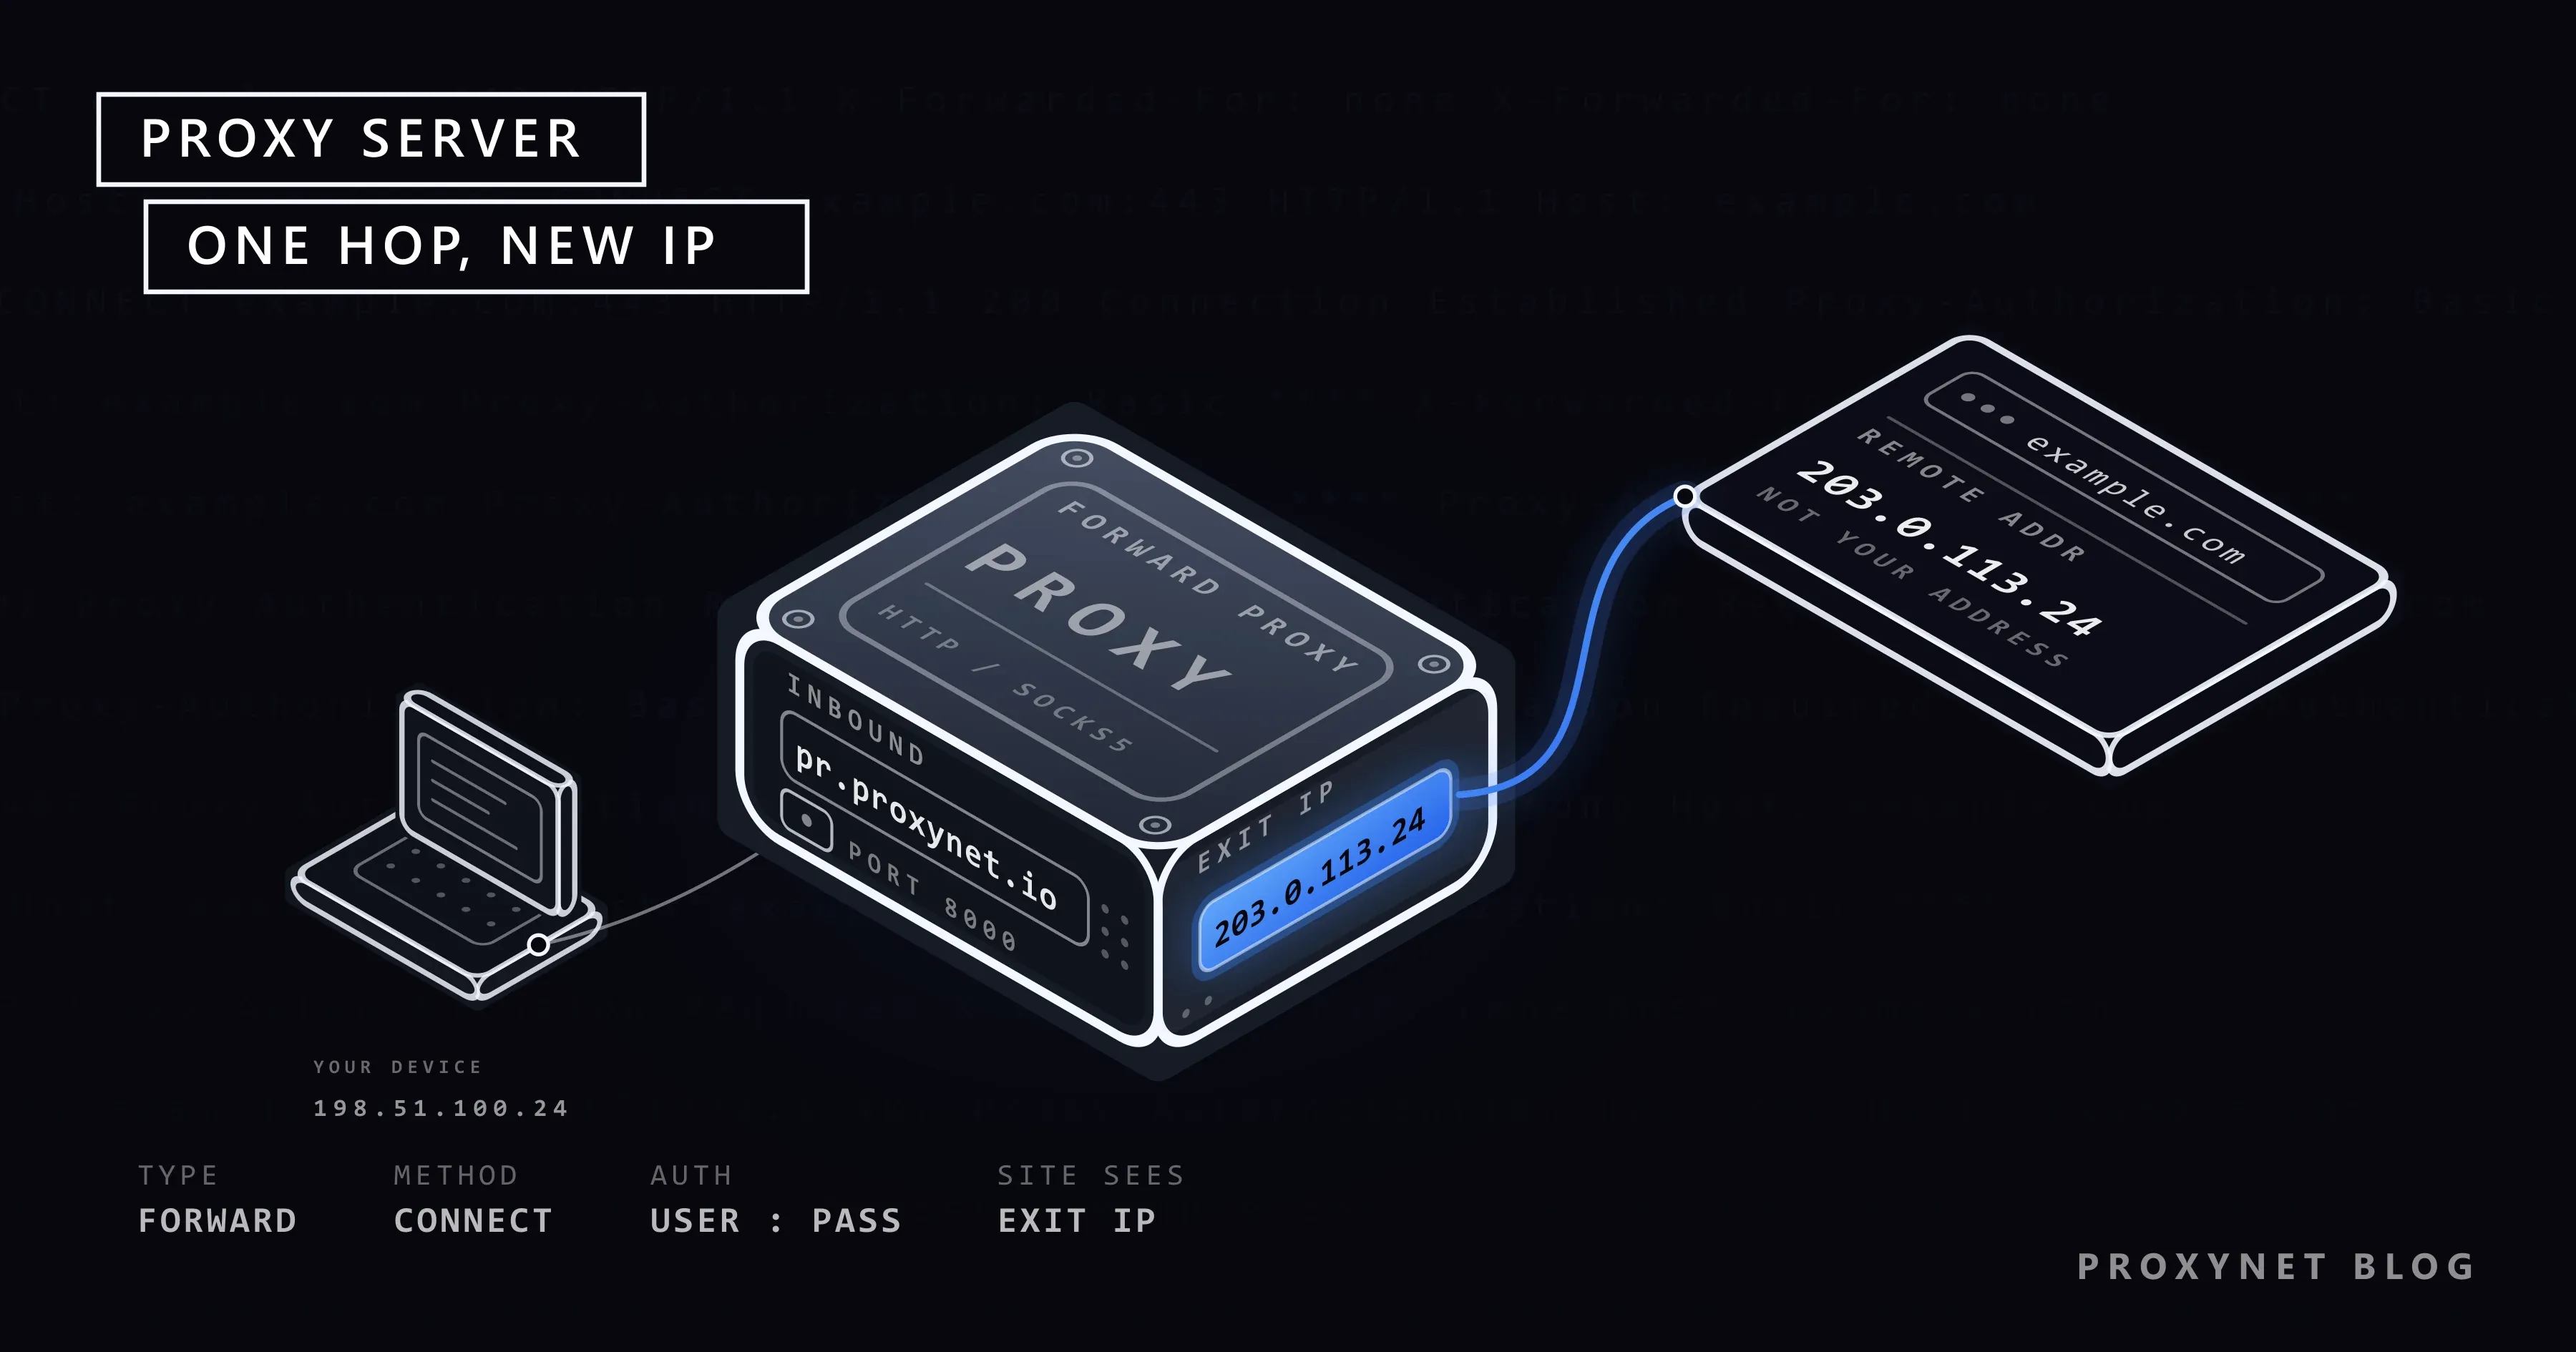
Publicado
Qué es un servidor proxy y cómo funciona
Un servidor proxy se sitúa entre tu dispositivo y el sitio de destino y reenvía las peticiones con su propia IP. Explicamos tipos, funcionamiento y usos.
Autor:Acar Diveroli
Proxy o VPN: diferencias y cuándo usar cada uno
Autor: Acar DiveroliComparativasPublicado
Puppeteer y CAPTCHA: por qué aparece y cómo reducirlo
Autor: Acar DiveroliTutorialesPublicado
Proxies residenciales y de centro de datos: diferencias
Autor: Acar DiveroliComparativasPublicado
Qué es robots.txt y cómo leerlo
Autor: Acar DiveroliWeb scrapingPublicado
Cómo automatizar el seguimiento de posiciones SEO
Autor: Acar DiveroliCasos de usoPublicado
Diferencia entre SOCKS y HTTP: ¿cuál elegir?
Autor: Acar DiveroliComparativasPublicado
Páginas estáticas y dinámicas en web scraping
Autor: Acar DiveroliComparativasPublicado
Web scraping: ¿JavaScript o Python?
Autor: Acar DiveroliComparativasPublicado
Cómo hacer web scraping sin que te bloqueen
Autor: Acar DiveroliWeb scrapingPublicado
Fugas de WebRTC y DNS: qué son y cómo evitarlas
Autor: Acar DiveroliProxy 101Publicado
Proxy con wget: comandos y ejemplos
Autor: Acar DiveroliTutorialesPublicado
Qué es un servidor proxy y cómo funciona
Autor: Acar DiveroliProxy 101Publicado
Ningún artículo coincide
Publicado
Publicado