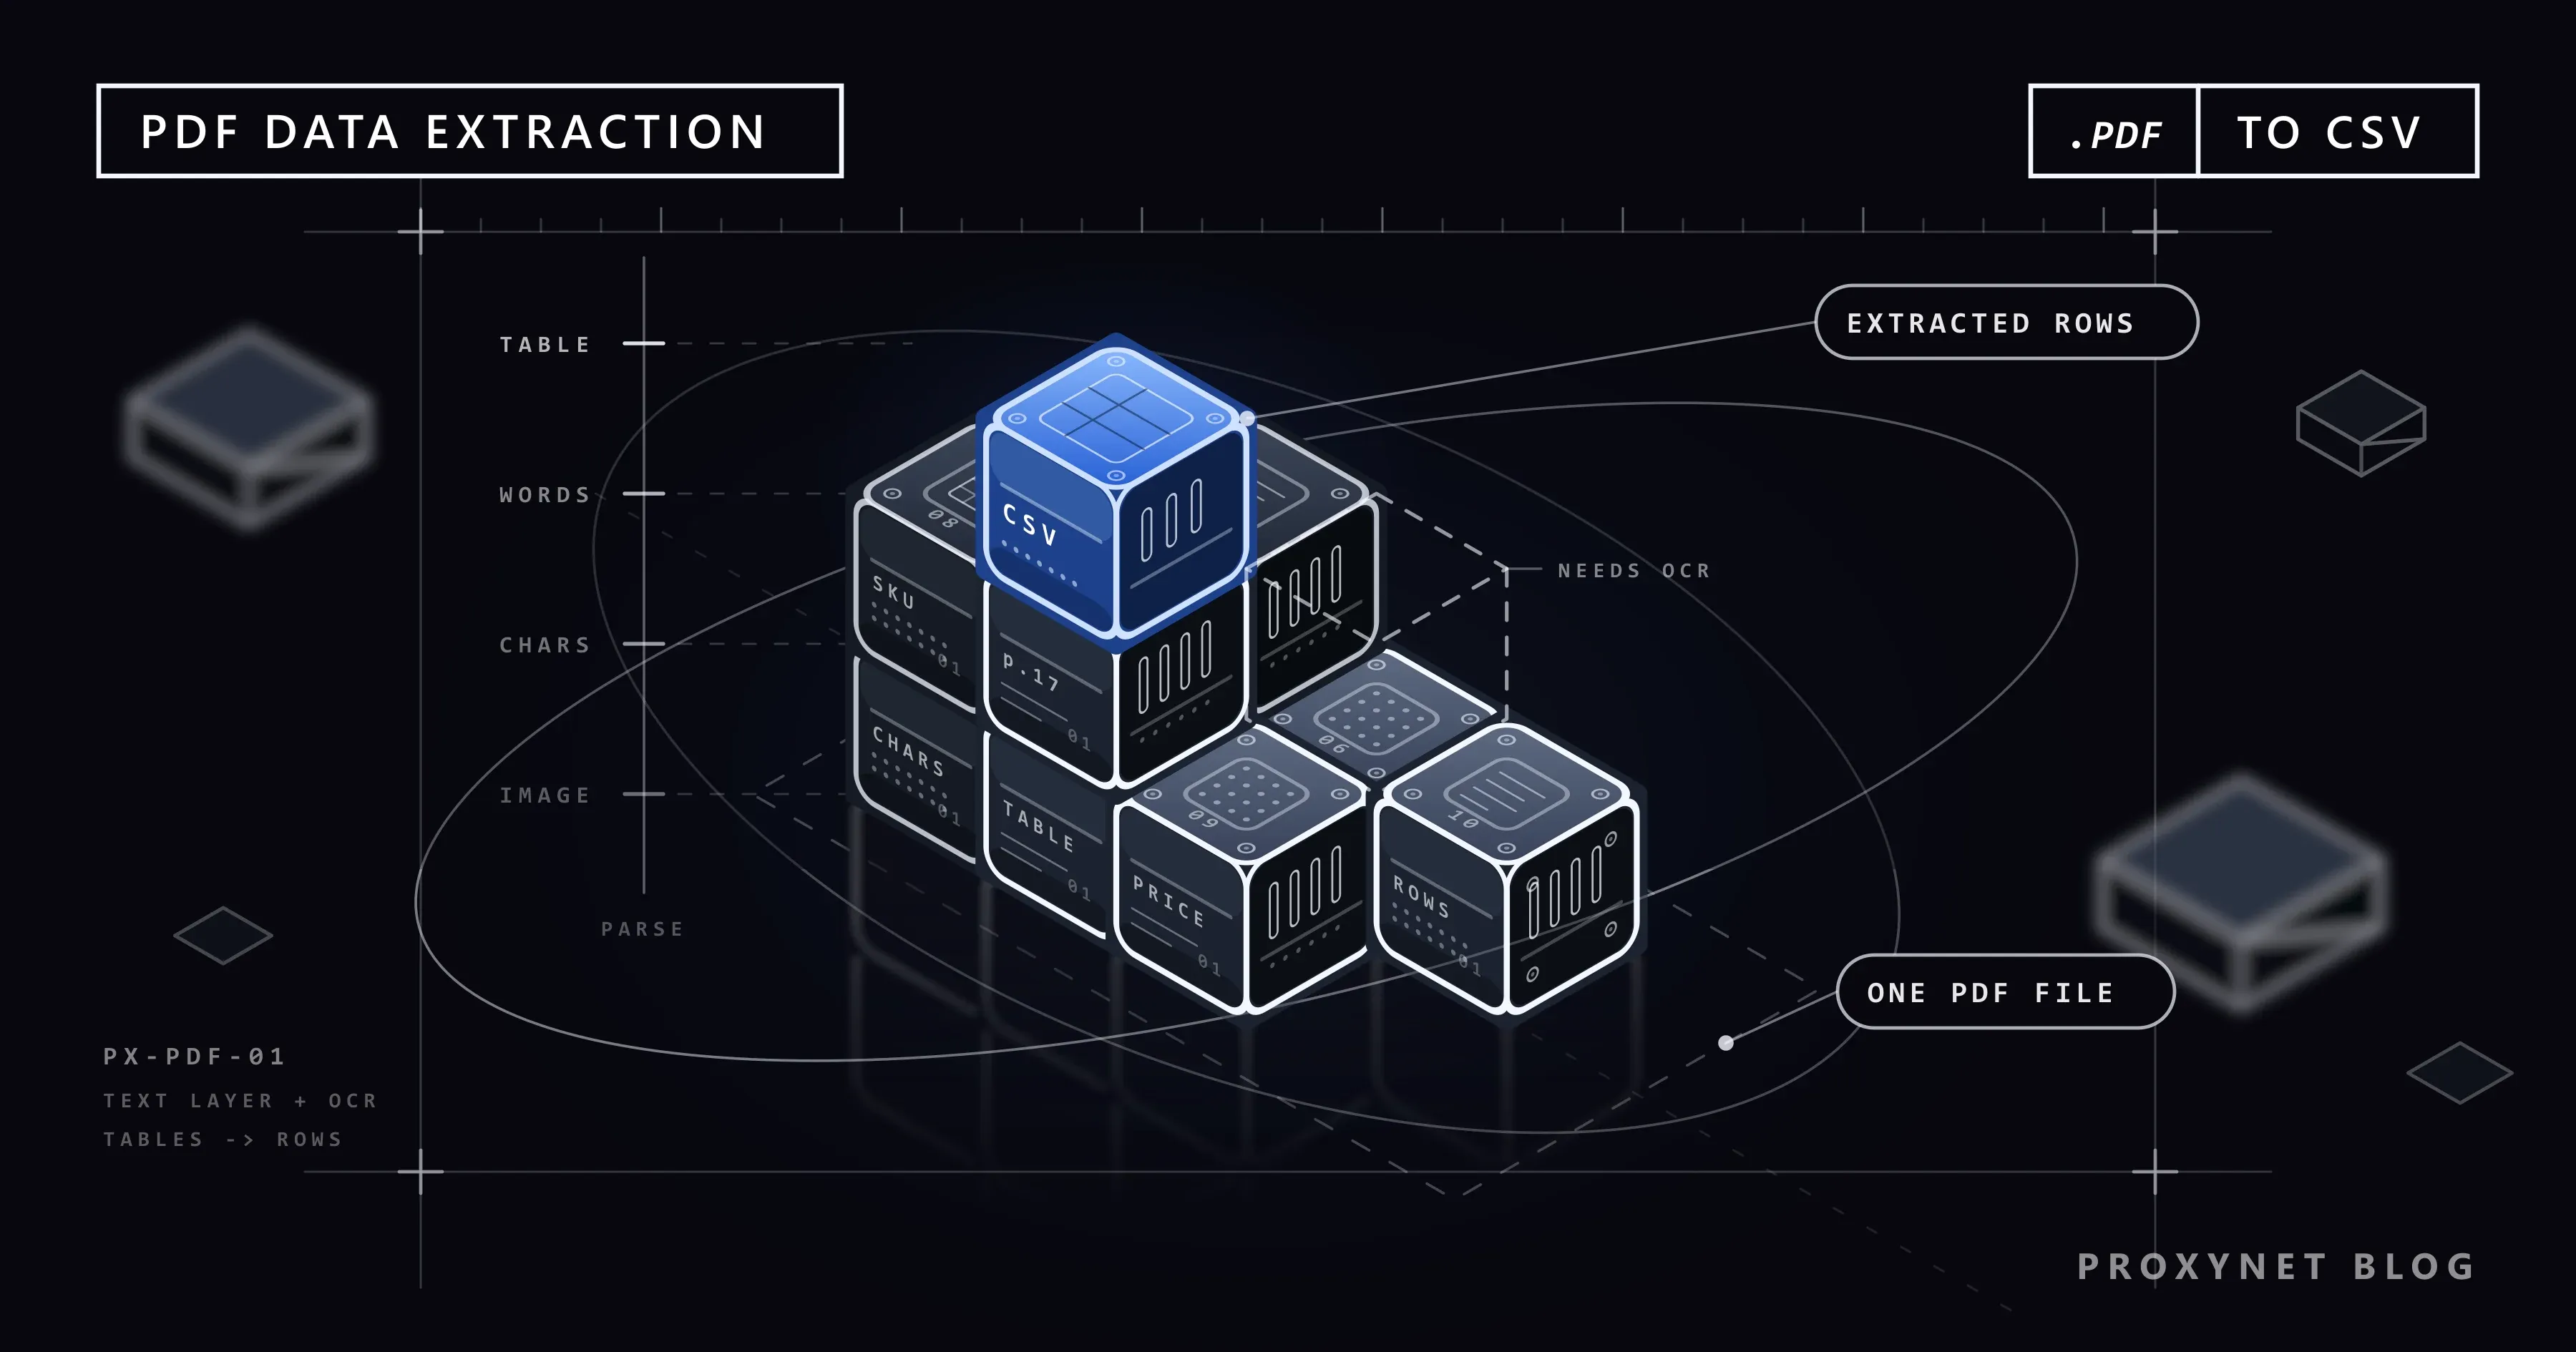
Tedarikçiniz fiyat listesini her ay 40 sayfalık bir PDF olarak gönderiyor. Finans ekibi banka ekstrelerini aynı biçimde alıyor, geçen hafta satın aldığınız pazar raporunun en işe yarar tablosu da 17. sayfada duruyor. Bu satırları bir elektronik tabloya aktarmanız gerekiyor. Elle kopyalamak sütunları bozuyor, eksi işaretlerini düşürüyor ve bir saatinizi alıyor; üstelik gelecek ay aynı saati yeniden harcayacaksınız.
Bu yazı, yöntemi belirleyen soruyla, yani dosyada metin katmanı olup olmadığıyla başlıyor. Ardından Excel'in PDF bağlayıcısını, pdfplumber'ı, Camelot ile tabula-py'ı, taranmış belgeler için Tesseract ile OCR'ı ve bir klasör dolusu PDF'i tek bir CSV'ye dönüştüren toplu işlem betiğini anlatıyoruz. Örneklerin hepsini ReportLab ile ürettiğimiz örnek PDF'ler üzerinde çalıştırdık.
PDF'den veri çıkarma ne demek?
PDF'den veri çıkarma, baskı için dizilmiş içeriği sıralayabileceğiniz ve başka bir yere yükleyebileceğiniz satırlara ve alanlara dönüştürmektir. Bir PDF "dört sütunlu bir tablo" saklamaz. "1,007.50 değerini bu konuma, bu yazı tipiyle çiz" ve "buradan şuraya bir çizgi çek" gibi talimatlar saklar. Her veri çıkarma aracı tabloyu bu koordinatlardan yeniden kurar; aynı dosyanın bir araçta temiz, başka bir araçta karmakarışık çıkmasının nedeni budur.
Yapılan iş, bir web sayfasından alanları ayıklamakla aynıdır (Web Sitesinden Veri Çekme); tek fark, HTML etiketlerinin yerini konumu belli karakterlerin almasıdır. Web sitelerinden çok sayıda PDF toplamak da daha geniş bir veri kazıma akışının parçasıdır.
Metin PDF'i mi, taranmış PDF mi: nasıl anlaşılır?
- Metin (dijital) PDF. Word'den, bir muhasebe sisteminden ya da raporlama aracından dışa aktarılmıştır. Karakterler metin olarak saklanır, dolayısıyla veri çıkarma dosyadaki rakamları birebir okur.
- Taranmış (görüntü) PDF. Her sayfa bir kâğıdın fotoğrafıdır. OCR (optik karakter tanıma) karakterleri piksellerden tahmin edene kadar ortada metin yoktur.
Hızlı test: Ctrl+F'ye basın ve ekranda gördüğünüz bir kelimeyi arayın. Kelime bulunuyorsa metin katmanı vardır. Kodda, pdfplumber'daki page.chars listesinin boş gelmesi o sayfanın taranmış olduğunu gösterir. Bazı dosyalarda ikisi bir arada bulunur (örneğin imza sayfası taranmış dijital bir rapor); bu yüzden kontrolü dosya başına değil, sayfa başına yapın.
PDF'den tablo çıkarma nasıl çalışır?
Excel, pdfplumber ya da Camelot kullanmanız fark etmez, arka planda aynı adımlar işler:
- Sayfa ayrıştırılır. Her karakter konumu, yazı tipi ve boyutuyla birlikte okunur; çizilen çizgiler ve dikdörtgenler de alınır.
- Karakterler kelimelere ve satırlara dönüşür. Aynı taban çizgisi üzerindeki yakın karakterler kelimeleri, aynı yükseklikteki kelimeler satırı oluşturur.
- Tablo alanları bulunur. Bunun için ızgara oluşturan çizgilere ya da aralarında boşluk bulunan hizalı kelime sütunlarına bakılır.
- Hücreler kurulur. Çizgi kesişimleri ya da sütun aralıkları hücre sınırlarını belirler, her kelime kendisini içeren hücreye yerleşir.
- Satırlar döndürülür. Sonuç, temizleyip kaydedeceğiniz bir satır listesi (ya da DataFrame) olur.
Sorunların çoğu 3. adımda çıkar. Tam ızgaralı bir tablo kolaydır; kenarlıksız bir tabloda araç sütunları boşluklardan tahmin etmek zorunda kalır ve tek bir uzun ürün adı bütün sütunları kaydırabilir.
PDF veri çıkarma yöntemlerinin karşılaştırması
| Yöntem | Kod gerekir mi? | Taranmış sayfaları okur mu? | En uygun olduğu iş | Nerede tıkanır |
|---|---|---|---|---|
| Kopyala yapıştır | Hayır | Hayır | Bir kez, tek bir küçük tablo | Sütunlar tek hücrede birleşir, çok sayfalı tablolar |
| Excel, Veri Al > PDF'den | Hayır | Hayır | Ayda birkaç dosya, analiz Excel'de | Kenarlıksız tablolar, düzeni farklı çok sayıda dosya |
| pdfplumber (Python) | Evet | Hayır | Metin ve tablo birlikte, toplu işler, ince ayar | Kenarlıksız tablolarda ayar ister |
| Camelot (Python) | Evet | İsteğe bağlı ek paketle | Çizgili tablolar, tablo başına doğruluk raporu | Tabloların çevresindeki serbest metin |
| tabula-py (Python) | Evet | Hayır | Tablo ağırlıklı dosyalardan hızlıca DataFrame | Makinede Java kurulu olmalı |
| pytesseract ile Tesseract | Evet | Evet | Taranmış sayfalar, belge fotoğrafları | Doğruluk tarama kalitesine bağlı; tablolar yapısını kaybeder |
Kodsuz yöntemler: kopyalama ve Excel
Kopyalama. Tek bir küçük tablo için tabloyu görüntüleyicide seçip yapıştırın. Her satır tek bir hücreye düşüyorsa Veri > Metni Sütunlara Dönüştür komutunu kullanın. Bir ürün adında boşluk olduğu anda bu yöntem de bozulur.
Excel'in PDF bağlayıcısı. Windows'taki Microsoft 365 için Excel, PDF dosyalarını Power Query üzerinden okuyabilir:
- Boş bir çalışma kitabı açın ve Veri > Veri Al > Dosyadan > PDF'den yolunu izleyin.
- PDF'i seçip Aç'a tıklayın.
- Gezgin penceresi Power Query'nin bulduklarını listeler: algılanan her tablo (Table001, Table002…) ve her sayfanın tamamı (Page001…). Önizlemek için bir öğeye tıklayın.
- Tabloyu bir sayfaya almak için Yükle'yi, önce Power Query Düzenleyicisi'nde temizlemek için Verileri Dönüştür'ü seçin (tekrarlanan başlık satırlarını kaldırın, fiyat sütununun türünü sayıya çevirin).
- Gelecek ay dosyayı değiştirip Veri > Tümünü Yenile'ye tıklayın; aynı adımlar yeniden çalışır.
Microsoft'un PDF bağlayıcısı belgeleri arka plandaki seçenekleri listeler: Pdf.Tables, büyük dosyalar için StartPage ve EndPage parametrelerini, sayfalar boyunca devam eden bir tabloyu birleştiren MultiPageTables seçeneğini de kabul eder. Bağlayıcı OCR yapmaz ve Mac için Excel'deki Power Query'de de kaynaklar arasında PDF yer almaz. Klasör bağlayıcısı aynı düzendeki PDF'leri birleştirir; düzenler farklılaştığında bir betiğin bakımı daha kolaydır.
pdfplumber ile metin ve tablo çıkarma
pdfplumber, pdfminer.six üzerine kurulu ve kendi tablo bulucusu olan bir Python kütüphanesidir. Güncel sürüm 0.11.10'dur (Haziran 2026); README dosyasına göre en iyi sonucu makinede üretilmiş PDF'lerde verir ve OCR yapmaz. Bir sanal ortama kurun:
python -m venv .venv
.venv\Scripts\activate        # macOS/Linux: source .venv/bin/activate
pip install pdfplumber pandas
Temel kullanım birkaç satıra sığar:
import pdfplumber

with pdfplumber.open("pdfs/price-list-2026-08.pdf") as pdf:
    page = pdf.pages[0]
    print(page.extract_text())          # tüm metin, satır satır
    table = page.extract_table()        # sayfadaki en büyük tablo
    print(table[:2])
# [['SKU', 'Product', 'Unit', 'Price'], ['B-001', 'Cable set 1', 'box', '13.40']]extract_tables(), sayfadaki her tabloyu hücre metinlerinden oluşan listeler olarak döndürür. pdfplumber varsayılan olarak çizilmiş çizgileri arar; kenarlıksız bir tabloda metin stratejisine geçin:
settings = {"vertical_strategy": "text", "horizontal_strategy": "text"}
rows = page.extract_tables(table_settings=settings)
Stratejiyi tabloya göre seçin. Çizgili fiyat listemizde metin stratejisi "Cable set 1" değerini iki sütuna böldü, "Unit" ile "Price" sütunlarını da birleştirdi; çünkü çizgilerin zaten gösterdiği sınırları kelime aralıklarından tahmin etmeye çalıştı. Sayfanın yalnızca bir bölümü tabloysa önce page.crop((x0, top, x1, bottom)) ile kırpın.
Eksiksiz bir betik: PDF klasöründen tek CSV'ye
Aşağıdaki betik bir klasördeki her PDF'i okur, belge numarasını ilk sayfanın metninden alır, her sayfadan tablo satırlarını çeker, tekrarlanan başlıkları atlar, fiyatları sayıya çevirir ve tek bir CSV yazar. Metin katmanı olmayan sayfalar OCR için günlüğe kaydedilir; bozuk bir dosya da toplu işlemi durdurmaz.
import csv
import logging
import re
from pathlib import Path

import pdfplumber

logging.basicConfig(level=logging.INFO, format="%(levelname)s %(message)s")

IN_DIR = Path("pdfs")
OUT_CSV = Path("price_lists.csv")
HEADER = ["SKU", "Product", "Unit", "Price"]
DOC_NO = re.compile(r"price list (\S+)", re.IGNORECASE)


def to_number(text):
    """'1,007.50' -> 1007.5; boş ya da bozuk hücrelerde None döndürür."""
    if not text:
        return None
    try:
        return float(text.replace(",", "").strip())
    except ValueError:
        return None


def rows_from_pdf(path):
    with pdfplumber.open(path) as pdf:
        first_text = pdf.pages[0].extract_text() or ""
        match = DOC_NO.search(first_text)
        doc_no = match.group(1) if match else path.stem

        for page in pdf.pages:
            if not page.chars:  # metin katmanı yok: büyük olasılıkla taranmış
                logging.warning("%s p.%d has no text layer, needs OCR", path.name, page.page_number)
                continue
            for table in page.extract_tables():
                for row in table:
                    cells = [(c or "").strip() for c in row]
                    if cells == HEADER:  # her sayfada tekrarlanan başlık
                        continue
                    if len(cells) != len(HEADER):
                        logging.warning("%s p.%d skipped row %r", path.name, page.page_number, cells)
                        continue
                    sku, product, unit, price = cells
                    yield {
                        "file": path.name,
                        "doc_no": doc_no,
                        "page": page.page_number,
                        "sku": sku,
                        "product": product,
                        "unit": unit,
                        "price": to_number(price),
                    }


def main():
    fields = ["file", "doc_no", "page", "sku", "product", "unit", "price"]
    count = 0
    with OUT_CSV.open("w", newline="", encoding="utf-8-sig") as f:
        writer = csv.DictWriter(f, fieldnames=fields)
        writer.writeheader()
        for path in sorted(IN_DIR.glob("*.pdf")):
            try:
                for row in rows_from_pdf(path):
                    writer.writerow(row)
                    count += 1
            except Exception as exc:  # bozuk bir dosya toplu işlemi durdurmamalı
                logging.error("%s failed: %s", path.name, exc)
    logging.info("wrote %d rows to %s", count, OUT_CSV)


if __name__ == "__main__":
    main()
Test klasörümüzde (iki sayfaya yayılan 70 satırlık bir fiyat listesi, 8 satırlık bir fiyat listesi ve taranmış bir kopya) çıktı şöyleydi:
WARNING price-list-scan.pdf p.1 has no text layer, needs OCR
INFO wrote 78 rows to price_lists.csvutf-8-sig, Excel'in "Café" gibi aksanlı adları doğru göstermesini sağlar; her satırdaki file, doc_no ve page alanları da her rakamın hangi dosyanın hangi sayfasından geldiğini gösterir. Satırları bundan sonra nerede saklayacağınızı Kazınan Veri CSV, JSON ve SQLite'a Nasıl Kaydedilir? yazısında, temizlik adımını da Kazınan Veri Pandas ile Nasıl Temizlenir? yazısında anlatıyoruz.
Camelot ve tabula-py: ne zaman kullanılır?
İki kütüphane daha var; ikisi de yalnızca tablolara odaklanır.
Camelot, Haziran 2026'da 2.0.0 sürümüne ulaştı. read_pdf() varsayılan olarak çizgili tablolar için lattice yöntemini kullanır; stream ve network kenarlıksız tabloları işler, auto ise her sayfa için seçimi kendisi yapar. Her tablonun, sorunlu sayfaları işaretlemeye yarayan bir doğruluk puanı içeren parsing_report alanı vardır. Ayrıntılar için Camelot belgelerine bakın.
tabula-py, tabula-java için yazılmış bir Python sarmalayıcısıdır; bu yüzden Java kurulu olmalıdır. tabula.read_pdf() doğrudan pandas DataFrame'lerinden oluşan bir liste döndürür.
import camelot
import tabula

PDF = "pdfs/price-list-2026-09.pdf"

tables = camelot.read_pdf(PDF, pages="1-end", flavor="lattice")
for t in tables:
    print(t.page, t.shape, t.parsing_report["accuracy"])
tables[0].df.to_csv("camelot_page1.csv", index=False)

dfs = tabula.read_pdf(PDF, pages="all", lattice=True)
print(len(dfs), [df.shape for df in dfs])
İki sayfalık fiyat listemizde ikisi de sayfa başına bir tablo buldu. Camelot 100.0 doğruluk bildirdi ve başlığı ilk satır olarak tuttu; tabula ise başlığı sütun adı olarak kullandı. Çizgili tabloyu üç kütüphane de doğru okudu. Bu durumda seçimi işin geri kalanı belirler: serbest metin de gerekiyorsa pdfplumber, tablo başına puan istiyorsanız Camelot, Java kuruluysa en az kodla DataFrame için tabula-py.
Taranmış PDF'ler: Tesseract ile OCR
Bir sayfada metin katmanı yoksa karakterleri görüntüden tanımanız gerekir. Tesseract yaygın kullanılan açık kaynaklı OCR motorudur; pytesseract ise onun Python sarmalayıcısıdır. Sarmalayıcı motoru içermez: önce Tesseract'ın kendisini kurun (kurulumdan sonra PATH'te değilse aşağıda gösterildiği gibi tesseract_cmd değerini ayarlayın), ardından:
pip install pytesseract pypdfium2Betik her sayfayı 300 DPI çözünürlükte gri tonlamalı bir görüntüye dönüştürür, OCR uygular ve ortalama kelime güven puanını yazdırır; bu puan hangi sayfalara bir insanın bakması gerektiğini gösterir:
import sys

import pypdfium2 as pdfium
import pytesseract

# Windows'ta PATH'te değilse pytesseract'a çalıştırılabilir dosyanın yolunu gösterin:
# pytesseract.pytesseract.tesseract_cmd = r"C:\Program Files\Tesseract-OCR\tesseract.exe"


def ocr_pdf(path, lang="eng", dpi=300):
    pdf = pdfium.PdfDocument(path)
    pages = []
    for i, page in enumerate(pdf, start=1):
        image = page.render(scale=dpi / 72).to_pil().convert("L")  # gri tonlama işe yarar
        text = pytesseract.image_to_string(image, lang=lang, config="--psm 6")
        pages.append(text)
        # Kelime düzeyinde güven: -1 "kelime değil" demektir, aksi hâlde 0-100.
        data = pytesseract.image_to_data(image, lang=lang, output_type=pytesseract.Output.DICT)
        confs = [float(c) for c in data["conf"] if float(c) >= 0]
        if confs:
            print(f"page {i}: mean confidence {sum(confs) / len(confs):.1f}")
    return pages


if __name__ == "__main__":
    try:
        for text in ocr_pdf(sys.argv[1] if len(sys.argv) > 1 else "scans/price-list-scan.pdf"):
            print(text)
    except pytesseract.TesseractNotFoundError:
        sys.exit("Tesseract is not installed or not on PATH")
300 DPI değeri Tesseract'ın kaliteyi artırma rehberinden geliyor. --psm 6 sayfayı tek ve düzgün bir metin bloğu olarak ele alır. Aynı rehber, tablolar için özel bölütleme gerektiğini ve tarama kenarlarının karakter olarak okunabileceğini de belirtir.
OCR 0 ile O'yu, 1 ile l'yi, bir fiyattaki virgülle noktayı karıştırır; soluk ya da eğik taramalarda durum kötüleşir. Önemli rakamlarda kalemlerin toplamı tutup tutmadığını kontrol edin ve güven puanı düşük sayfaları bir kişiye inceletin. OCR tablo yapısını değil, metni döndürür: sütunları her satıra uygulanan bir düzenli ifadeyle yeniden kurun ya da Camelot'un isteğe bağlı ocr ek paketini deneyin.
PDF'den veri çıkarma nerelerde kullanılır?
- Tedarikçi fiyat listeleri. Aylık PDF'ler, zaman içinde karşılaştırabileceğiniz bir fiyat geçmişine dönüşür; bu da fiyat takibi işinin girdisidir.
- Pazar ve sektör raporları. Kamuya açık raporlardaki tablolar yeniden yazılmak yerine bir pazar araştırması modeline aktarılır.
- Faturalar ve ekstreler. Toplamlar, tarihler ve referans numaraları muhasebeye ya da mutabakata aktarılır; bu, finans ekiplerinde sık görülen bir iştir.
- Kamuya açık resmî belgeler ve istatistikler. Birçok kurum tablolarını hâlâ yalnızca PDF olarak yayımlıyor; bir betik yılların birikimini tek bir veri setine çevirir. Bu, veri madenciliği öncesindeki tipik ilk adımdır.
- ETL akışları. PDF ayrıştırma, daha büyük bir akıştaki "extract" (çıkarma) adımıdır; dönüştürme ve yükleme adımlarının bunun etrafına nasıl yerleştiğini ETL Nedir? yazısında anlatıyoruz.
Web sitelerinden çok sayıda PDF indirme
PDF'ler çoğu zaman bir tedarikçi portalında ya da düzenleyici bir kurumun yayın sayfasında durur. Yüzlercesini indirmek bir veri kazıma işidir: resmî bir indirme yolu ya da API varsa onu kullanın, robots.txt dosyasını ve kullanım koşullarını okuyun, istekleri aralıklı gönderin. Aşağıdaki indirici daha önce indirilmiş dosyaları atlar, 4xx hatalarında yeniden denemez, HTTP 429'da Retry-After başlığına uyar ve yanıtın gerçekten PDF olup olmadığını kontrol eder:
import os
import time
from pathlib import Path
from urllib.parse import urlparse

import requests

PROXY = os.environ.get("PROXY_URL", "http://user:pass@pr.proxynet.io:8000")
URLS = os.environ.get("PDF_URLS", "https://example.com/reports/price-list.pdf").split()
OUT = Path("pdfs")
OUT.mkdir(exist_ok=True)

session = requests.Session()
session.proxies = {"http": PROXY, "https": PROXY}
session.headers["User-Agent"] = "price-list-archiver/1.0 (contact: data@example.com)"


def download(url, retries=3):
    target = OUT / Path(urlparse(url).path).name
    if target.exists():  # önceki bir çalıştırmada zaten indirildi
        return target
    for attempt in range(1, retries + 1):
        try:
            r = session.get(url, timeout=30)
            if r.status_code == 429:
                time.sleep(int(r.headers.get("Retry-After", 30)))
                continue
            if 400 <= r.status_code < 500:  # 403, 404...: yeniden denemek işe yaramaz
                print(f"{url} returned {r.status_code}, skipped")
                return None
            r.raise_for_status()
            if not r.content.startswith(b"%PDF"):  # PDF değil, bir HTML hata sayfası
                print(f"{url} did not return a PDF, skipped")
                return None
            target.write_bytes(r.content)
            return target
        except requests.RequestException as exc:
            print(f"attempt {attempt} failed: {exc}")
            time.sleep(2 ** attempt)
    return None


for url in URLS:
    print(url, "->", download(url))
    time.sleep(2)  # sunucuyu yormayın
user:pass isteyen yerel bir test proxy'siyle yaptığımız denemede geçerli PDF kaydedildi, sahte bir .pdf ile 404 veren adres atlandı, ikinci çalıştırmada da hiçbir dosya yeniden indirilmedi. Kaynak ülkeye göre farklı belgeler sunuyorsa (hedef ülke seçilen bir Residential Proxy) ya da uzun bir arşiv indirmesi IP başına sınırlara takılıyorsa (bir Rotating Proxy) proxy işe yarar. Yine de önce hızınızı düşürün; nedenini HTTP 429 Too Many Requests yazısında anlatıyoruz.
Sık karşılaşılan sorunlar ve çözümleri
- Birleştirilmiş hücreler
Noneolarak geliyor. pdfplumber birleştirilmiş hücrenin yalnızca ilk satırını doldurur; pandas'takiffill()değeri aşağıya kopyalar (örnek aşağıda). - Tablo sonraki sayfada devam ediyor. Sayfa sayfa çıkarın, tekrarlanan başlık satırlarını atın (yukarıdaki betiğin yaptığı gibi) ve birleştirin. Excel'de
MultiPageTablesseçeneği bunu sizin yerinize yapar. - Rakamlar metin olarak geliyor.
"1,007.50", negatifler için"(250.00)", Almanca bir dosyada"1.007,50". Her biçimi kendi kuralıyla normalleştirin; ondalık ayracını tek bir değere bakarak tahmin etmeyin. - Aksanlı harfler bozuk görünüyor. Genellikle sorun metinde değil, görüntüleyicidedir: bir Windows konsolu ya da UTF-8 dosyayı BOM olmadan açan Excel (Python Unicode kodlama hataları yazısına bakın).
extract_text()çıktısında tuhaf simgeler varsa yazı tipinin Unicode eşlemesi yoktur ve güvenilir yol OCR'dır. - Kenarlıksız tablolarda sütunlar kayıyor. Metin stratejisine geçin, tablo alanını kırpın ya da
"vertical_strategy": "explicit"ve"explicit_vertical_lines"ile sütun konumlarını açıkça verin. - Hata yok ama satır da yok. Sayfa taranmıştır, tablo bir görüntüdür ya da dosya parola korumalıdır (açma yetkiniz olan dosyalar için
pdfplumber.open(path, password="...")).
Birleştirilmiş hücre çözümünün tamamı aşağıda; "North" değerinin iki satırı kapladığı bir tablo üzerinde test edildi:
import pandas as pd
import pdfplumber

with pdfplumber.open("merged.pdf") as pdf:
    rows = pdf.pages[0].extract_table()

df = pd.DataFrame(rows[1:], columns=rows[0])
df["Region"] = df["Region"].ffill()  # birleştirilmiş hücre, ilk satırının altında None olarak gelir
df["Price"] = pd.to_numeric(df["Price"].str.replace(",", ""), errors="coerce")
print(df)
Hangi yöntemi seçmelisiniz?
| İhtiyaç | Öneri |
|---|---|
| Tek dosyadan bir kez tek tablo | Kopyala yapıştır, ardından Metni Sütunlara Dönüştür |
| Ayda birkaç metin PDF'i, analiz Excel'de | Excel, Veri > Veri Al > Dosyadan > PDF'den |
| Bir klasörden metin ve tablolar, her ay tekrar | CSV yazan pdfplumber betiği |
| Tablo başına kalite puanıyla çizgili tablolar | Camelot, lattice yöntemi |
| En az kodla DataFrame, Java kurulu | tabula-py |
| Taranmış sayfalar ya da fotoğraflar | pypdfium2 ile 300 DPI görüntü + Tesseract, rakamların insan tarafından kontrolüyle |
| Bir web sitesinden yüzlerce PDF | Önce resmî indirme ya da API; yoksa aralıklı çalışan bir indirici, kaynak bölgeselse proxy ile |
Sıkça sorulan sorular
PDF'den ücretsiz veri çıkarılabilir mi?
Evet. pdfplumber, Camelot, tabula-py ve Tesseract açık kaynaklıdır; PDF bağlayıcısı da Windows'taki Microsoft 365 için Excel'in bir parçasıdır. Ücretli araçlar çoğunlukla şablon düzenleyicileri ve kötü taramalarda daha iyi OCR ekler.
PDF'deki bir tabloyu Excel'e nasıl aktarırım?
Windows'taki Microsoft 365 için Excel'de Veri > Veri Al > Dosyadan > PDF'den yolunu izleyin, Gezgin'de tabloyu seçin ve Yükle'ye tıklayın. Python'da satırları pdfplumber ile çıkarın, ardından pandas to_excel() ile ya da Excel'in açabileceği bir CSV olarak yazın.
PDF'den veri çıkarırken neden boş metin geliyor?
Sayfada büyük olasılıkla metin katmanı yoktur. pdfplumber'da page.chars değerine bakın ya da bir görüntüleyicide Ctrl+F ile arama yapın; hiçbir şey bulunmuyorsa OCR uygulayın.
Tablolar için pdfplumber, PyPDF'ten daha mı iyi?
Tablolar için evet. pypdf, PDF bölme, birleştirme ve düz metin okuma işlerinde başarılıdır ama tablo bulucusu yoktur. pdfplumber her karakterin konumunu tutar ve hücreleri çizgilerden ya da hizalamadan yeniden kurar; tablo çıkarmanın ihtiyacı da tam olarak budur.
Taranmış PDF'lerde OCR ne kadar doğru?
Taramaya bağlıdır. 300 DPI'da taranmış temiz basılı sayfalar genellikle iyi sonuç verir; eğik, soluk ya da düşük çözünürlüklü taramalar, el yazısı ve küçük yazı tipleri vermez. Güven puanlarına bakın ve toplamları doğrulayın.
İndirdiğim PDF'lerden veri çıkarmak yasal mı?
Kullanma hakkınız olan dosyalardan (kendi faturalarınız, kamuya açık raporlar) veri çıkarmak normalde sorun değildir; ancak içerik yine de telif hakkıyla korunuyor olabilir, içindeki kişisel veriler de GDPR ya da KVKK gibi yasalara tabi olmaya devam eder. Toplu indirmeden önce kaynağın kullanım koşullarını okuyun; genel çerçeveyi web scraping'in yasallığı yazımızda anlatıyoruz. Bu bir hukuki tavsiye değildir.
Özet
Her PDF işi tek bir kontrolle başlar: metin katmanı var mı? Varsa ara sıra gereken tablolar için Excel'in PDF bağlayıcısı, bütün bir klasörü tek CSV'ye çevirmek için bir pdfplumber betiği yeter; yalnızca tablo gereken işlerde Camelot ya da tabula-py devreye girer. Yoksa sayfaları 300 DPI görüntüye dönüştürün, Tesseract'ı çalıştırın ve rakamları doğrulayın. Her satırda kaynak dosyayı ve sayfayı tutun, toplu PDF indirmelerini de diğer veri kazıma işleri gibi ele alın. Bu indirmeler bölgesel ya da hız sınırı uygulayan kaynaklardan geliyorsa proxy paketlerimiz akışın ihtiyaç duyduğu adresleri sağlar.