اسکریپت بررسی قیمت شما روی لپتاپتان کار میکند. آن را به سرور منتقل میکنید، ترافیکش را از پروکسی عبور میدهید و پس از نیم دقیقه این سطر در گزارش ظاهر میشود: TimeoutError: page.goto: Timeout 30000ms exceeded. در اجرای بعدی صفحه باز میشود، اما اسکریپت یک سطر پایینتر با locator.click: Timeout 30000ms exceeded. میایستد. عدد را به 60000 تغییر میدهید و حالا اسکریپت پس از یک دقیقه کامل شکست میخورد، چون مشکل هرگز خود عدد نبود.
در این راهنما چهار نوع مهلت (timeout)، گزارش فراخوانی (call log)، گزینه waitUntil، جای درست تعیین مهلتها، پروکسیهای کند و صفحههای مسدودی را که سر از «عنصر پیدا نشد» درمیآورند بررسی میکنیم. سپس یک اسکریپت آزموده با تلاش دوباره در Python و Node.js و معادل آن در Puppeteer را میآوریم. همه پیامهای این نوشته از اجراهای خود ما با Playwright 1.63 و Puppeteer 25.12 روی یک سایت آزمایشی محلی و یک پروکسی آزمایشی به دست آمده است.
پیام Timeout 30000ms exceeded در Playwright یعنی چه؟
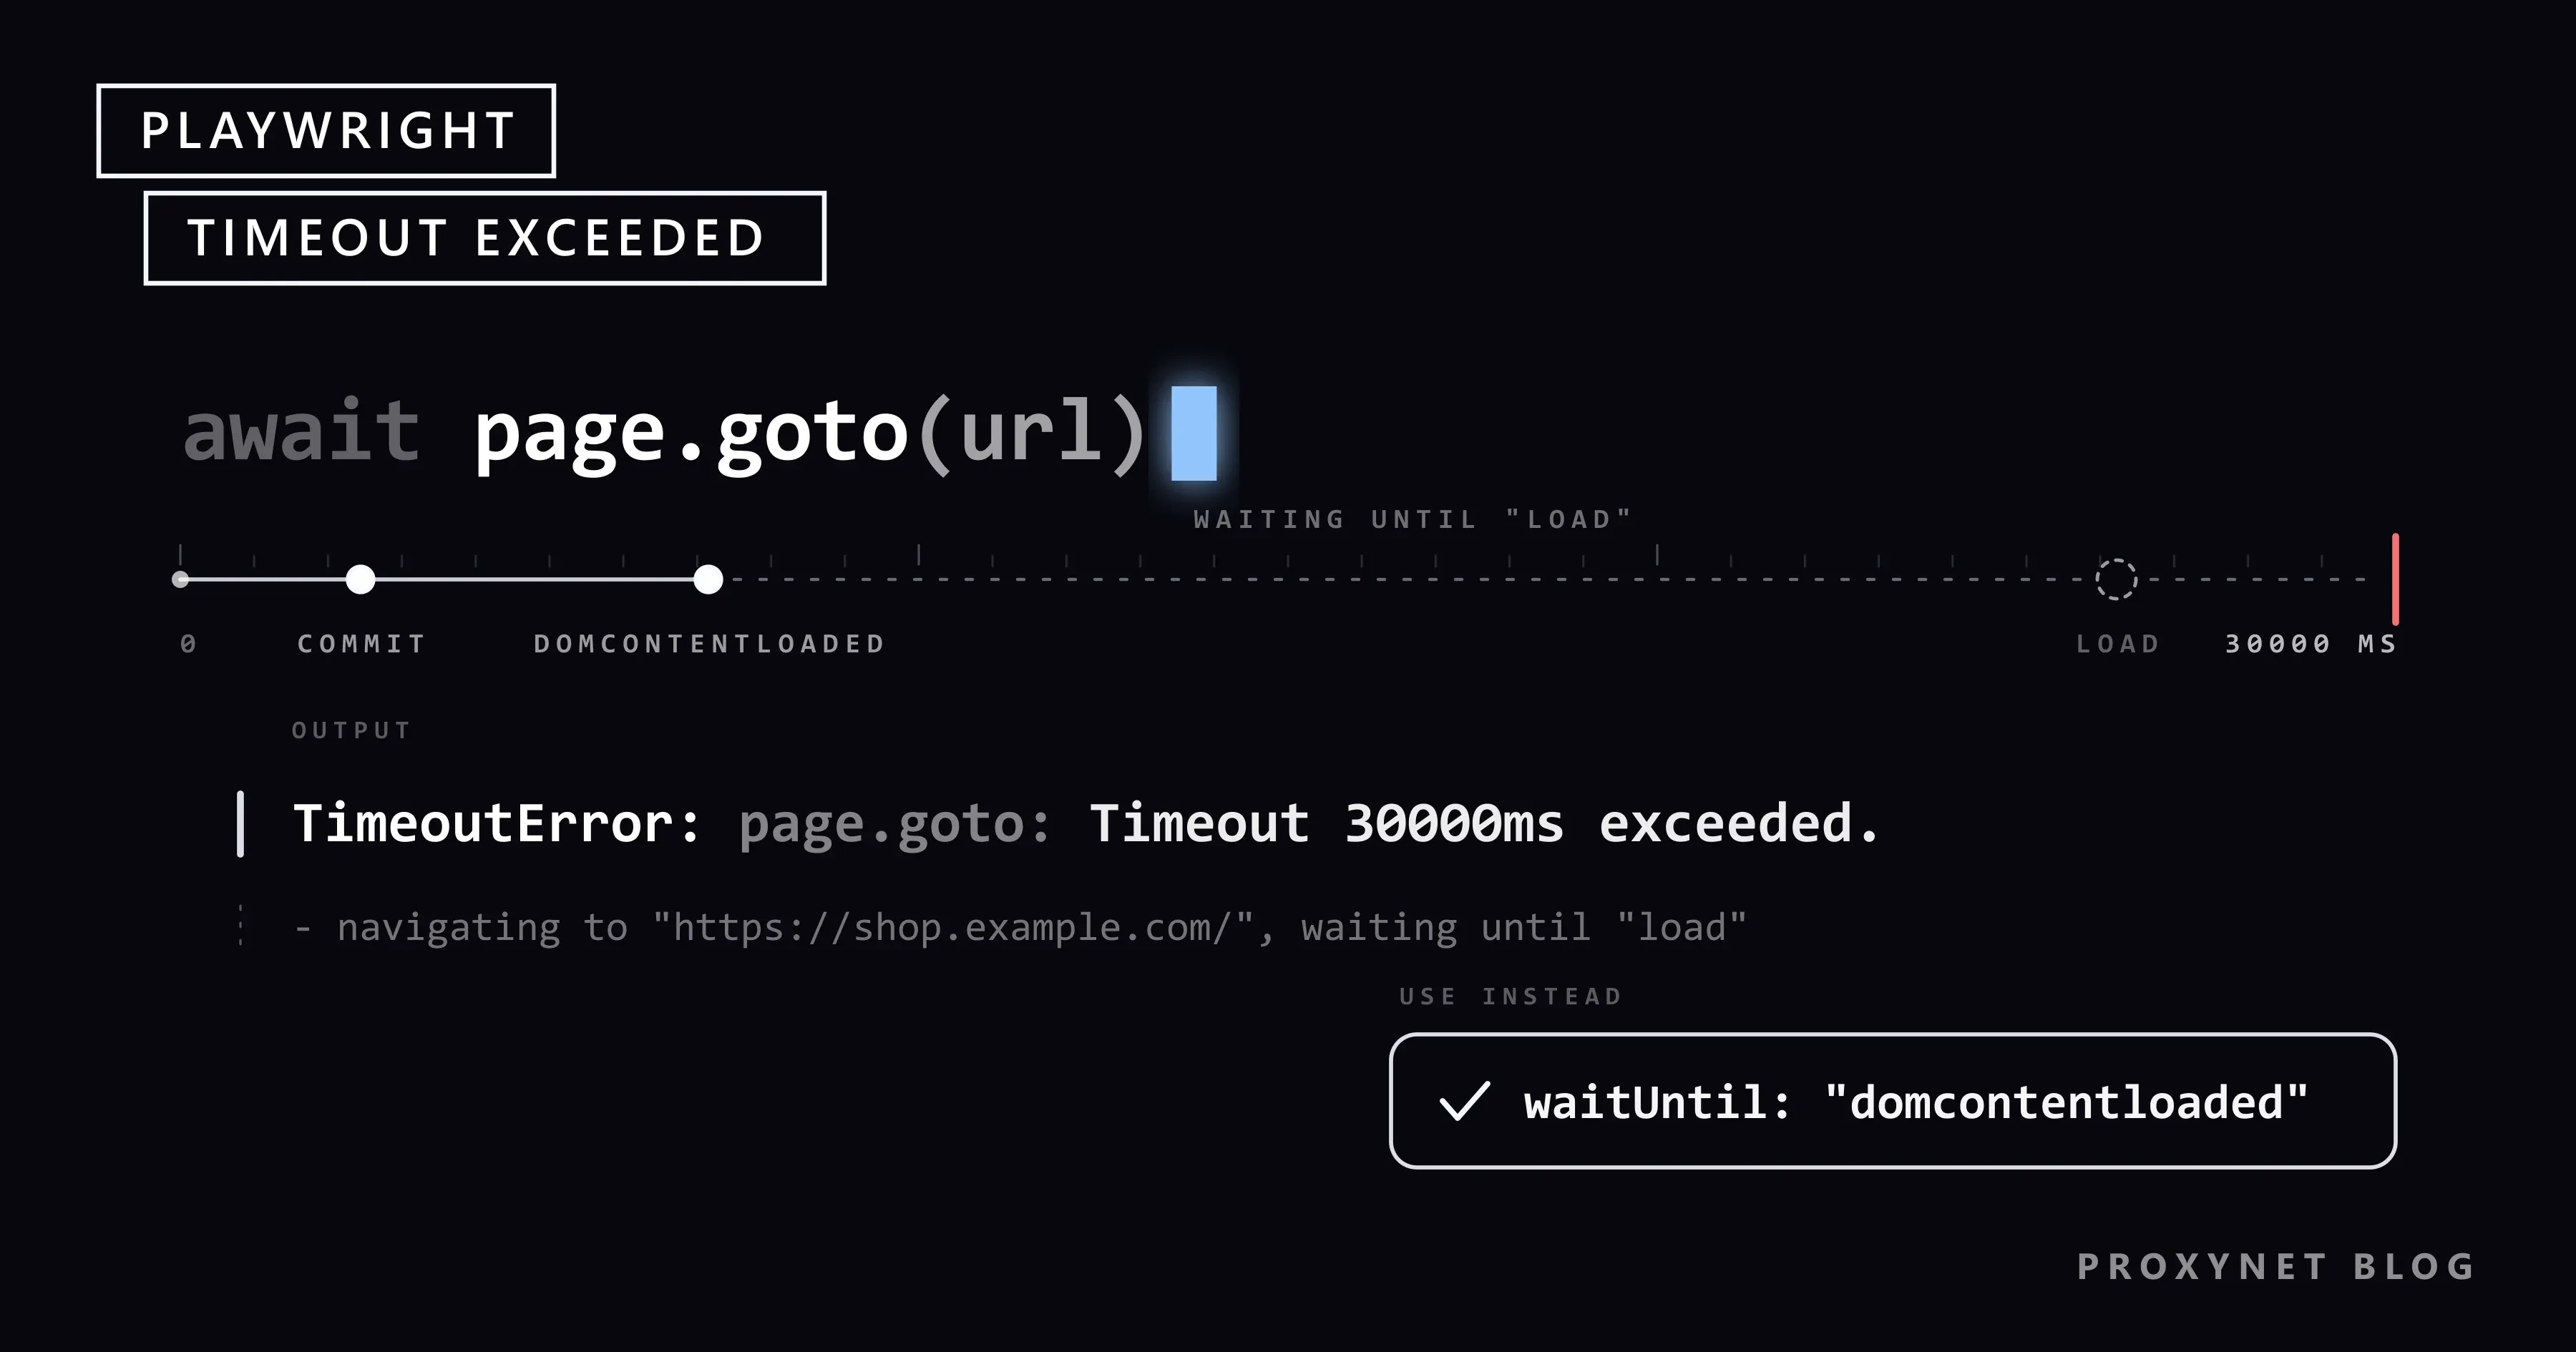
Playwright خودش منتظر میماند: page.goto() تا وقتی صفحه به یک وضعیت بارگذاری برسد و هر کنش (action) روی locator تا وقتی عنصر وجود داشته باشد و آماده آن کنش باشد. وقتی یک انتظار به مهلت خود برسد، Playwright خطای TimeoutError را پرتاب میکند. در کتابخانه این مهلت 30000 میلیثانیه یعنی 30 ثانیه است؛ اجراهای ما در Python و Node.js هر دو دقیقاً در 30.0 ثانیه متوقف شدند.
پیام نام متدی را که منتظر مانده، مقدار مهلت و در بخش call log کاری را که Playwright در آن لحظه انجام میداده نشان میدهد. پیام زیر از صفحهای آزمایشی آمده که سرورش هرگز پاسخ نداد:
TimeoutError: page.goto: Timeout 30000ms exceeded.
Call log:
  - navigating to "http://127.0.0.1:8090/slow", waiting until "load"
Python نامها را با حرف بزرگ چاپ میکند (Page.goto و Locator.click) و Node.js با حرف کوچک (page.goto و locator.click). در Python این کلاس را با نام دیگری import کنید، چون TimeoutError از playwright.sync_api کلاس داخلی همنام در خود Python را پنهان میکند. در Node.js این کلاس errors.TimeoutError از بسته playwright است.
کدام مهلت تمام شد؟ چهار نوع مهلت
کتابخانه، که اسکرپرها از آن استفاده میکنند، به هر ناوبری (باز کردن صفحه) و هر کنش 30 ثانیه مهلت میدهد. اجراکننده آزمون Playwright Test برای آنها مهلت جداگانهای در نظر نمیگیرد و در عوض به کل آزمون 30 ثانیه میدهد؛ این را مستندات مهلتها در Playwright فهرست کرده است و به همین دلیل مرجع API برای JavaScript مقدار پیشفرض goto را 0 مینویسد.
| پیام با این شروع میشود | نوع | پیشفرض | تغییر با |
|---|---|---|---|
page.goto: Timeout … | ناوبری | 30 ثانیه (کتابخانه)، بدون مهلت (Test) | timeout در خود فراخوانی، set_default_navigation_timeout()، navigationTimeout |
locator.click: Timeout … | کنش یا locator | 30 ثانیه (کتابخانه)، بدون مهلت (Test) | timeout در خود فراخوانی، set_default_timeout()، actionTimeout |
expect(locator)… failed همراه با Timeout: 5000ms | بررسی شرط (assertion) | 5 ثانیه | expect: { timeout }، در Python expect.set_options(timeout=…) |
Test timeout of 30000ms exceeded. | کل آزمون (Playwright Test) | 30 ثانیه | timeout در پیکربندی، test.setTimeout()، test.slow() |
دو نکته از اجراهای ما. در Python، expect() ناموفق یک AssertionError ساده پرتاب میکند که except PlaywrightTimeoutError آن را نمیگیرد. و وقتی مهلت آزمون در میانه page.goto تمام شود، Playwright Test زیر سطر پایان مهلت عبارت page.goto: net::ERR_ABORTED; maybe frame was detached? را هم میآورد. این خطای شبکه نیست: اجراکننده آزمون صفحه را در حالی بسته که فراخوانی هنوز منتظر بوده است.
گزارش فراخوانی (call log) را چگونه بخوانیم؟
call log سودمندترین بخش پیام است. نمونه زیر کلیک روی دکمهای است که بنر کوکی رویش را پوشانده؛ آن را از اجرای خودمان کوتاه کردهایم:
Locator.click: Timeout 5000ms exceeded.
Call log:
  - waiting for locator("#buy")
    - locator resolved to <button id="buy">Add to cart</button>
  - attempting click action
    2 × waiting for element to be visible, enabled and stable
      - element is visible, enabled and stable
      - scrolling into view if needed
      - done scrolling
      - <div id="cookie-banner">We use cookies</div> intercepts pointer events
    - retrying click action
آن را در چهار گام بخوانید:
- متد در سطر نخست نشان میدهد چه انتظاری بوده است:
goto،click،fill،textContent. - آخرین گام در گزارش میگوید کار کجا متوقف شد.
waiting for locator("#price")بدون هیچ سطری زیرش یعنی هیچ عنصری مطابقت نداشت؛locator resolved to …یعنی عنصر پیدا شد اما کنش اجرا نشد. - سطر علت، اگر باشد:
intercepts pointer events(چیزی روی عنصر قرار گرفته)،element is not visible،element is not enabled. - زمان سپریشده. شکستی که دقیقاً در مهلت شما رخ دهد یک انتظار واقعی است. خطای زودتر، مانند
net::ERR_PROXY_CONNECTION_FAILED، مشکل دیگری است که در نوشته Playwright چیست و چگونه با پروکسی استفاده میشود؟ به آن پرداختهایم.
پایان مهلت ناوبری: page.goto و waitUntil
page.goto() منتظر یک رویداد چرخه حیات صفحه میماند که با waitUntil (در Python wait_until) انتخاب میشود:
commit: پاسخ رسیده و بارگذاری سند آغاز شده است.domcontentloaded: HTML تجزیه شده است؛ تصویرها، فونتها و iframeها ممکن است هنوز در حال بارگذاری باشند.load(پیشفرض): صفحه و منابعی که فراخوانی میکند، از جمله تصویرها و فایلهای سبک، کامل بارگذاری شدهاند.networkidle: دستکم 500 میلیثانیه هیچ اتصال شبکهای در کار نبوده است. مرجع page.goto آن را discouraged (توصیهنشده) علامت زده و میگوید بهجای آن به assertionها تکیه کنید.
مقدار پیشفرض load علت بسیاری از پایان مهلتهای ناوبری است: یک تصویر کند، یک پیکسل ردیابی یا یک ویجت جلوی رخ دادن این رویداد را میگیرد، در حالی که متنی که میخواهید از قبل در صفحه است. در صفحه آزمایشی ما قیمت در HTML بود و یک تصویر هرگز کامل نشد. با load، فراخوانی goto پس از 10 ثانیه به پایان مهلت رسید؛ با domcontentloaded در 0.1 ثانیه برگشت و قیمت قابل خواندن بود. networkidle در صفحهای شکست خورد که هر 300 میلیثانیه یک نقطه پایانی را فراخوانی میکند، همان کاری که ویجتهای گفتوگو و قیمتهای زنده انجام میدهند.
الگویی که جواب میدهد: با domcontentloaded به صفحه بروید و سپس منتظر همان یک عنصری بمانید که لازم دارید.
response = page.goto(url, wait_until="domcontentloaded")
price = page.locator("#price").inner_text() # waits for the element, up to the action timeoutconst response = await page.goto(url, { waitUntil: "domcontentloaded" });
const price = await page.locator("#price").innerText();اگر goto با domcontentloaded هم به پایان مهلت برسد، خود HTML دیر رسیده است و این پرسشی مربوط به شبکه است (بخش پروکسی را ببینید). اگر داده در HTML یا در یک نقطه پایانی JSON قرار دارد، شاید اصلاً به مرورگر نیازی نداشته باشید؛ شیوه بررسی این موضوع در نوشته صفحههای ایستا و پویا در وب اسکرپینگ آمده است.
پایان مهلت locator و کنش: انتظار خودکار و آنچه جلویش را میگیرد
Playwright پیش از هر کلیک بررسی میکند که عنصر دیده میشود، پایدار است (حرکت نمیکند)، فعال است و کلیک در آن نقطه واقعاً به خود آن میرسد، و این بررسیها را تا تمام شدن مهلت تکرار میکند. پایان مهلت locator به فهرست کوتاهی از علتها برمیگردد:
- انتخابگر با هیچ عنصری مطابقت ندارد. یک غلط تایپی، نام کلاسی که با هر build عوض میشود یا متنی که در زبانهای مختلف فرق دارد. ویژگیهای پایدار (
id،data-*) یاget_by_role()عمر بیشتری دارند. - عنصر دیر ظاهر میشود. قیمتی که 12 ثانیه پس از بارگذاری ساخته میشود، با مهلت 10 ثانیه هر بار شکست میخورد.
- چیزی روی آن را پوشانده است. بنرهای کوکی و پنجرههای بازشو (modal) به شکل
intercepts pointer eventsدیده میشوند. لایه رویی را همانطور ببندید که یک بازدیدکننده میبندد؛force=Trueاین بررسی را کنار میگذارد و کلیک جایی فرود میآید که هیچ کاربری نمیتواند روی آن کلیک کند. - عنصر درون یک iframe است.
page.locator("#price")درون فریمها را جستوجو نمیکند؛ در آزمون ما به پایان مهلت رسید، در حالی کهpage.frame_locator("iframe").locator("#price")قیمت را بیدرنگ برگرداند. - در صفحهای غیر از آنچه فکر میکنید هستید. صفحه مسدودی یا دیوار ورود به حساب عنصری با شناسه
#priceندارد (پایینتر را ببینید).
page.wait_for_selector() هنوز کار میکند، اما مرجع API در Playwright آن را به سود locatorها discouraged علامت زده است؛ locator در هر تلاش عنصر را از نو پیدا میکند و به همین دلیل از بازسازی صفحه آسیب نمیبیند. تفاوت این روش با انتظارهای صریح (explicit wait) در Selenium در نوشته تفاوت Playwright و Selenium: کدام را انتخاب کنیم؟ آمده است.
تعیین آگاهانه مهلتها: در هر فراخوانی، در context و در پیکربندی
مقدار timeout که به یک فراخوانی داده شود بر همه چیز مقدم است. پس از آن، پیشفرضهای صفحه بر پیشفرضهای context مقدماند و پیشفرض ناوبری بر پیشفرض عمومی. در Python پیشفرضها را روی context تعیین کنید تا همه صفحههای درون آن، آنها را به ارث ببرند:
context = browser.new_context()
context.set_default_navigation_timeout(15_000)  # goto, reload, wait_for_url
context.set_default_timeout(10_000)             # locators, clicks, waits
page = context.new_page()
page.goto(slow_report_url, timeout=45_000)      # one known-slow page gets more
در Playwright Test مهلتها در فایل پیکربندی قرار میگیرند. با این پیکربندی، در اجرای ما عنصری که وجود نداشت با locator.click: Timeout 10000ms exceeded. و صفحهای که هرگز پاسخ نداد با page.goto: Timeout 15000ms exceeded. شکست خورد:
import { defineConfig } from "@playwright/test";

export default defineConfig({
  timeout: 60_000,              // whole test, including hooks and fixtures
  expect: { timeout: 10_000 },  // each expect(...) assertion
  use: {
    actionTimeout: 10_000,      // click, fill, textContent ...
    navigationTimeout: 15_000,  // goto, reload, waitForURL ...
  },
});
test.slow() مهلت یک آزمون کند را سه برابر میکند. در محیط عملیاتی از timeout=0 پرهیز کنید: در این حالت صفحهای که هرگز پاسخ نمیدهد یک context را برای همیشه اشغال میکند. مهلت دودقیقهای برای همه چیز هم چندان بهتر نیست؛ آنوقت صفی با صد URL از کارافتاده به بیش از سه ساعت زمان نیاز دارد.
پروکسی کند: نخست اندازه بگیرید، سپس مهلت را تعیین کنید
پروکسی به هر درخواست یک گام اضافه میکند و مرورگر برای هر صفحه درخواستهای زیادی میفرستد. خروجیهای پروکسی مسکونی (رزیدنتال) روی اتصالهای خانگی کار میکنند و معمولاً تأخیر بیشتری از خروجیهای دیتاسنتر میافزایند؛ بنابراین مهلتی که روی خط اینترنت دفترتان هرگز تمام نمیشود ممکن است از طریق یک نقطه خروج دوردست تمام شود. پیش از انتخاب عدد، اندازه بگیرید. این اسکریپت همان صفحه را پنج بار در contextهای تازه باز میکند و فقط برای اندازهگیری، مهلت را خاموش میکند:
import statistics
import time

from playwright.sync_api import sync_playwright

PROXY = {"server": "http://pr.proxynet.io:8000", "username": "user", "password": "pass"}
URL = "https://shop.example.com/product/42"

with sync_playwright() as p:
    browser = p.chromium.launch(proxy=PROXY)
    times = []
    for _ in range(5):
        context = browser.new_context()  # fresh session, no cache between runs
        page = context.new_page()
        start = time.monotonic()
        page.goto(URL, wait_until="domcontentloaded", timeout=0)  # no limit while measuring
        page.locator("#price").wait_for(timeout=0)
        times.append(time.monotonic() - start)
        context.close()
    browser.close()

print("runs:", " ".join(f"{t:.2f}s" for t in times))
print(f"median {statistics.median(times):.2f}s, slowest {max(times):.2f}s")
از طریق پروکسی آزمایشی محلی ما، که به هر درخواست 2 ثانیه میافزاید، این خروجی چاپ شد:
runs: 3.42s 3.38s 3.37s 3.38s 3.38s
median 3.38s, slowest 3.42s
مهلت را بر پایه کندترین اجرا و با فاصلهای بالاتر از آن تعیین کنید؛ ما 15 ثانیه را انتخاب کردیم. روی یک مقصد واقعی نمونههای بیشتری بگیرید و هر وقت کشور، نوع پروکسی یا سایت عوض شد دوباره اندازه بگیرید. سه نکته دیگر:
- کمتر بارگذاری کنید. مسدود کردن تصویرها، رسانهها و فونتها با
page.route()شمار درخواستهای هر صفحه را کم میکند؛ کد آن در راهنمای ما درباره Playwright و پروکسی آمده است. - نقطه خروج را متناسب با کار انتخاب کنید. خروجیهای پروکسی دیتاسنتر جایی که مقصد IP دیتاسنتر را میپذیرد سریعترند. جایی که سایت به IP خانگی یا شهر مشخصی نیاز دارد، از خروجیهای پروکسی مسکونی با مهلتی که جداگانه برایشان اندازه گرفتهاید استفاده کنید.
- اطلاعات ورود را بررسی کنید. وقتی رمز پروکسی روی یک سایت HTTPS نادرست بود، شنونده
requestfailedما بیدرنگnet::ERR_TUNNEL_CONNECTION_FAILEDرا چاپ کرد، اماpage.gotoفقط وقتی شکست خورد که مهلت 10 ثانیهایاش تمام شد. مشکل اطلاعات ورود میتواند شبیه پروکسی کند به نظر برسد، پس در زمان عیبیابی این شنونده را اضافه کنید:
page.on("requestfailed", lambda r: print("FAILED:", r.url, r.failure))بیرون از مرورگر، کتابخانه Requests در Python خطاهای پروکسی را با پیام «Max retries exceeded» گزارش میکند؛ شیوه خواندن آن در نوشته خطای Max Retries Exceeded With URL چیست و چگونه رفع میشود؟ آمده است.
وقتی صفحه مسدودی به «عنصر پیدا نشد» تبدیل میشود
این حالت بیش از همه وقت میگیرد. سایت درخواست را رد میکند و یک صفحه مسدودی با کد وضعیت 403 یا 429 برمیگرداند. page.goto() برای کدهای وضعیت خطای HTTP استثنا پرتاب نمیکند؛ goto ما با 403 بهطور عادی برگشت. سپس اسکریپت تمام مهلت را منتظر عنصری میماند که صفحه مسدودی هرگز آن را نخواهد داشت. گزارش از پایان مهلت حرف میزند، اما پاسخ واقعی یک رد بود.
عنوان صفحه مسدودی آزمایشی ما «Access denied» بود و خطای expect() در Python حتی snapshot دسترسپذیری آن را با heading "Access denied" چاپ کرد. پیش از انتظار، نگاه کنید:
- پاسخی را که
gotoبرمیگرداند نگه دارید و کد وضعیت آن را بخوانید. page.title()را بخوانید؛ صفحههای مسدودی و صفحههای چالش عنوانهای خاص خود را دارند.- اگر یکی از این دو از مسدودی خبر داد، متوقف شوید: نه تلاش دوباره، نه انتظار برای عنصر.
- علت را پیدا کنید: سرعت درخواستهای شما، فایل
robots.txtو شرایط استفاده سایت، یا اینکه آیا سایت API ارائه میدهد.
تلاش دوباره روی صفحه مسدودی وضع را بدتر میکند و عوض کردن IP برای گذشتن از یک رد، راهحل نیست: سایت پاسخ منفی داده است. 429 یعنی درخواستها بیش از حد بودهاند؛ سرعت را کم کنید و به Retry-After پایبند باشید (429 Too Many Requests چیست؟ خطای Rate Limit و رفع آن). اینکه سایتها چرا بازدیدکنندگان خودکار را علامت میزنند در نوشته تشخیص بات چگونه کار میکند؟ آمده است. روشهایی برای گذشتن از این صفحهها آموزش نمیدهیم؛ آنچه ماندگار است پیمایش آهستهتر، گرفتن اجازه یا API رسمی است (تفاوت وب اسکرپینگ و API).
نمونه کامل: مهلتهای اندازهگیریشده، بررسی مسدودی و تلاش دوباره
این اسکریپت صفحههای محصول را از طریق پروکسی باز میکند. هر تلاش یک context تازه با مهلتهای سنجیده میگیرد. اسکریپت پیش از انتظار برای محتوا کد وضعیت و عنوان را بررسی میکند، در برابر صفحه مسدودی میایستد و فقط پایان مهلتها را دوباره تلاش میکند؛ آن هم با انتظار نمایی (exponential backoff) بهاضافه یک جزء تصادفی (jitter) تا workerهای موازی همگام با هم دوباره تلاش نکنند.
"""Open product pages through a proxy with measured timeouts, a block check and retries."""
import random
import time

from playwright.sync_api import TimeoutError as PlaywrightTimeoutError
from playwright.sync_api import sync_playwright

PROXY = {"server": "http://pr.proxynet.io:8000", "username": "user", "password": "pass"}
URLS = [f"https://shop.example.com/product/{n}" for n in (42, 43, 44)]

NAV_TIMEOUT = 15_000     # ms: about 4x the slowest page we measured through the proxy
ACTION_TIMEOUT = 10_000  # ms: locators, clicks and waits
ATTEMPTS = 3
STOP_STATUS = {403, 429}  # a refusal or a rate limit: retrying makes it worse
STOP_WORDS = ("access denied", "blocked", "captcha", "verify you are human")  # adjust per site


class Blocked(Exception):
    """The site answered with a block or rate-limit page: stop and find out why."""


def fetch_price(browser, url):
    for attempt in range(1, ATTEMPTS + 1):
        context = browser.new_context()  # clean cookies and cache on every attempt
        context.set_default_navigation_timeout(NAV_TIMEOUT)
        context.set_default_timeout(ACTION_TIMEOUT)
        page = context.new_page()
        start = time.monotonic()
        try:
            response = page.goto(url, wait_until="domcontentloaded")
            status = response.status if response else None
            title = page.title()
            if status in STOP_STATUS or any(word in title.lower() for word in STOP_WORDS):
                raise Blocked(f"HTTP {status}, title {title!r}")
            return page.locator("#price").inner_text()  # auto-waits up to ACTION_TIMEOUT
        except PlaywrightTimeoutError as exc:
            print(f"  attempt {attempt}: {str(exc).splitlines()[0]} ({time.monotonic() - start:.1f}s)")
            if attempt == ATTEMPTS:
                raise
            time.sleep(2**attempt + random.random())  # 2-3 s, then 4-5 s
        finally:
            context.close()


with sync_playwright() as p:
    browser = p.chromium.launch(proxy=PROXY)
    for url in URLS:
        print(url)
        try:
            print("  price:", fetch_price(browser, url))
        except Blocked as exc:
            print("  stopped, not retrying:", exc)
        except PlaywrightTimeoutError:
            print(f"  gave up after {ATTEMPTS} attempts")
    browser.close()
این اسکریپت را با جایگزین کردن میزبان با سایت آزمایشی محلیمان (shop.test) و از طریق پروکسیای که به هر درخواست 2 ثانیه میافزاید اجرا کردیم؛ صفحه سوم طوری تنظیم شده بود که در دو درخواست نخست خود معطل بماند:
http://shop.test/product/42
  price: $19.90
http://shop.test/product/43
  stopped, not retrying: HTTP 403, title 'Access denied'
http://shop.test/product/44
  attempt 1: Page.goto: Timeout 15000ms exceeded. (15.0s)
  attempt 2: Page.goto: Timeout 15000ms exceeded. (15.0s)
  price: $19.90
صفحه مسدودی فقط یک درخواست هزینه داشت و هیچ انتظاری در پی نداشت؛ صفحه معطل دو پایان مهلت هزینه داشت و سپس با موفقیت باز شد. تلاشهای دوبارهای که بر پایه کد وضعیت انجام میشوند، مانند 503 همراه با Retry-After، به لایه جداگانهای تعلق دارند؛ کد آن در نوشته کدهای وضعیت HTTP در وب اسکرپینگ آمده است. همین هسته در Node.js:
import { chromium, errors } from "playwright";

const PROXY = { server: "http://pr.proxynet.io:8000", username: "user", password: "pass" };
const URLS = ["https://shop.example.com/product/42", "https://shop.example.com/product/45"];

const browser = await chromium.launch({ proxy: PROXY });
for (const url of URLS) {
  const context = await browser.newContext();
  context.setDefaultNavigationTimeout(15_000); // goto, reload, waitForURL
  context.setDefaultTimeout(10_000);           // locators, clicks, waits
  const page = await context.newPage();
  try {
    const response = await page.goto(url, { waitUntil: "domcontentloaded" });
    console.log(url, "status", response?.status(), "title", await page.title());
    console.log("  price:", await page.locator("#price").innerText());
  } catch (err) {
    if (!(err instanceof errors.TimeoutError)) throw err;
    console.log("  timeout:", err.message.split("\n")[0]);
  } finally {
    await context.close();
  }
}
await browser.close();
در سایت آزمایشی ما صفحه دوم قیمت خود را پس از 12 ثانیه نمایش میدهد:
http://shop.test/product/42 status 200 title Product
  price: $19.90
http://shop.test/product/45 status 200 title Product
  timeout: locator.innerText: Timeout 10000ms exceeded.
پیام Navigation timeout of 30000 ms exceeded در Puppeteer
Puppeteer همین الگو را با نامهای دیگری به کار میبرد. مهلت پیشفرض آن هم 30 ثانیه است، page.setDefaultNavigationTimeout() و page.setDefaultTimeout() آن را تغییر میدهند و waitUntil مقدارهای load، domcontentloaded، networkidle0 و networkidle2 را میپذیرد. مرجع رویدادهای چرخه حیات در Puppeteer دو مقدار آخر را چنین تعریف میکند: حداکثر 0 یا 2 اتصال باز به مدت 500 میلیثانیه. بنابراین در صفحههای پرترافیک درست مانند networkidle شکست میخورند.
import puppeteer, { TimeoutError } from "puppeteer";

const browser = await puppeteer.launch({ args: ["--proxy-server=http://pr.proxynet.io:8000"] });
const page = await browser.newPage();
await page.authenticate({ username: "user", password: "pass" });
page.setDefaultNavigationTimeout(15_000); // goto, reload, waitForNavigation
page.setDefaultTimeout(10_000);           // waitForSelector and other waits

try {
  const response = await page.goto("https://shop.example.com/product/45", { waitUntil: "domcontentloaded" });
  console.log("status", response?.status(), "title", await page.title());
  await page.waitForSelector("#price");
} catch (err) {
  if (!(err instanceof TimeoutError)) throw err;
  console.log(`${err.name}: ${err.message} (${err.cause?.message})`);
} finally {
  await browser.close();
}
اجراهای ما با Puppeteer 25.12 این پیامها را چاپ کردند؛ اولی از صفحهای است که هرگز پاسخ نداد و با مهلت پیشفرض اجرا شد:
TimeoutError: Navigation timeout of 30000 ms exceeded
TimeoutError: Waiting for selector `#price` failed (Waiting failed: 10000ms exceeded)
پیام انتخابگر خود مهلت را نمیآورد؛ مهلت در err.cause قرار دارد. پروکسی به شکل یک پرچم خط فرمان Chromium داده میشود و اطلاعات ورود از طریق page.authenticate()، که در پسزمینه رهگیری درخواستها (request interception) را روشن میکند. علتها و راهحلهای بالا بدون تغییر در اینجا هم صدق میکنند.
کجا با این خطا روبهرو میشوید
- اسکرپ کردن فروشگاههایی که با JavaScript ساخته میشوند: قیمتها پس از HTML بارگذاری میشوند، پس منتظر عنصر بمانید (راهحل استخراج داده).
- پیمایش یک صف طولانی: یک صفحه گیرکرده باید فقط یک پایان مهلت هزینه داشته باشد، نه کل اجرا را (راهحل خزنده وب).
- آزمودن برنامه خودتان از کشورهای دیگر: هر نقطه خروج تأخیر خودش را دارد، پس مهلتها را برای هر کشور جداگانه تعیین کنید (آزمون برنامه).
- عاملهای هوش مصنوعی که مرورگر را به کار میگیرند: عاملی که
gotoرا فراخوانی میکند به همین مهلتها برمیخورد (Playwright MCP چیست؟). - پیمایشهای زمانبندیشده: پیش از تنظیم سرعت، قواعد پیمایش سایت را بخوانید (فایل robots.txt چیست و چگونه آن را بخوانیم؟).
اشتباهات رایج
- بالا بردن مهلت پیشفرض به 60 یا 120 ثانیه. انتظاری که نمیتواند موفق شود فقط دیرتر شکست میخورد.
- «آماده» دانستن
networkidle. صفحههای پرترافیک هرگز آرام نمیشوند. - انتظارهای ثابت پیش از هر گام.
time.sleep()وwaitForTimeout()در صفحههای سریع بیش از حد طولانی و در صفحههای کند بیش از حد کوتاهاند. - گرفتن فقط
TimeoutErrorپیرامونexpect()در Python. این فراخوانیAssertionErrorپرتاب میکند. - نادیده گرفتن کد وضعیت و عنوان. آنوقت صفحه مسدودی به یک «عنصر پیدا نشد» 30 ثانیهای تبدیل میشود.
- تلاش دوباره برای درخواستهای مسدودشده. تلاش دوباره برای پایان مهلت و قطع شبکه است، نه برای
403و429. - ساکت کردن لایههای رویی با
force=True. کلیک جایی فرود میآید که کاربر نمیتوانست روی آن کلیک کند.
راهنمای انتخاب
| آنچه میبینید | چه باید کرد |
|---|---|
page.goto: Timeout همراه با waiting until "load" | domcontentloaded، سپس انتظار برای عنصر |
page.goto: Timeout همراه با waiting until "networkidle" | networkidle را کنار بگذارید؛ منتظر یک عنصر بمانید |
page.goto: Timeout با domcontentloaded | زمان بارگذاری را از طریق پروکسی اندازه بگیرید و مهلت را بر پایه آن تعیین کنید |
waiting for locator(...) بدون هیچ سطری زیرش | انتخابگر، فریمها و صفحهای را که در آن هستید بررسی کنید |
intercepts pointer events | لایه رویی را همانطور ببندید که یک کاربر میبندد |
کد وضعیت 403 یا 429، یا عنوانی که از مسدودی خبر میدهد | متوقف شوید؛ سرعت را کم کنید، robots.txt را بررسی کنید، اجازه بگیرید یا از API استفاده کنید |
Test timeout of 30000ms exceeded. | گامی را که گیر کرده پیدا کنید؛ مهلت را فقط برای آزمونهای کند بالا ببرید |
requestfailed خطای ERR_TUNNEL_CONNECTION_FAILED را نشان میدهد | پیش از دست زدن به مهلتها اطلاعات ورود پروکسی را درست کنید |
پرسشهای متداول
مهلت پیشفرض در Playwright چقدر است؟
در کتابخانه، 30 ثانیه برای ناوبریها و کنشها. در Playwright Test کل یک آزمون 30 ثانیه و هر expect() 5 ثانیه مهلت دارد؛ کنشها و ناوبریها مهلت جداگانهای ندارند.
چگونه مهلت page.goto را افزایش دهیم؟
آن را به خود فراخوانی بدهید (در Python page.goto(url, timeout=60_000) و در Node.js { timeout: 60_000 })، set_default_navigation_timeout() را روی context تنظیم کنید یا navigationTimeout را در پیکربندی Playwright Test بنویسید. فقط پس از اندازهگیری آن را بالا ببرید.
چرا page.goto با اینکه صفحه دیده میشود به پایان مهلت میرسد؟
goto بهطور پیشفرض منتظر رویداد load میماند و یک تصویر یا ویجت که هرگز کامل نمیشود جلوی آن را میگیرد. از domcontentloaded استفاده کنید و منتظر عنصری بمانید که لازم دارید.
آیا از networkidle استفاده کنیم؟
خیر. مرجع Playwright آن را discouraged علامت زده است و صفحههایی که درخواستهای دورهای (polling) یا گفتوگوی زنده دارند ممکن است هرگز به آن نرسند. بهجای آن منتظر یک عنصر مشخص بمانید.
چگونه TimeoutError در Playwright را در Python بگیریم؟
آن را به شکل from playwright.sync_api import TimeoutError as PlaywrightTimeoutError وارد کنید و همین نام را در except بگیرید. expect() ناموفق AssertionError پرتاب میکند.
آیا پروکسی میتواند باعث پایان مهلت در Playwright شود؟
بله. یک نقطه خروج کند میتواند زمان بارگذاری صفحهها را از مهلت فراتر ببرد و اطلاعات ورود نادرست روی یک سایت HTTPS میتواند به شکل پایان مهلت ظاهر شود. از طریق پروکسی اندازه بگیرید، مهلتها را بر پایه نتیجهها تعیین کنید و به رویداد requestfailed گوش دهید. صفحه مسدودی با عوض کردن پروکسی برطرف نمیشود.
خلاصه
پیام «Timeout 30000ms exceeded» انتظاری را که تمام شده نام میبرد، نه علت را. متد و پایان call log را بخوانید و سپس چیزی را که به آن اشاره میکنند رفع کنید: انتظار برای load یا networkidle، یک انتخابگر، یک لایه رویی، یک فریم، یک صفحه مسدودی یا یک نقطه خروج کند. مهلتها را روی context و بر پایه زمانهای بارگذاری اندازهگیریشده تعیین کنید، به صفحه کند استثنایی مهلت جداگانه بدهید، فقط پایان مهلتها را با backoff دوباره تلاش کنید و در برابر مسدودی متوقف شوید. برای انتخاب نقطه خروجی که با مقصدهای شما سازگار باشد، خدمات پروکسی ما را مقایسه کنید.