Ein Marketingteam möchte wissen, welche Zahlungsarten Onlineshops in fünf Ländern anbieten und welche im letzten Jahr dazugekommen sind. Ein normaler Chatbot antwortet in wenigen Sekunden, aus dem Gedächtnis und mit einer Handvoll Suchergebnissen. Dieselbe Frage im Deep-Research-Modus bringt zuerst ein paar Rückfragen, dann einen Rechercheplan, zehn Minuten Stille und schließlich einen langen Bericht mit einer Tabelle, einem Abschnitt pro Land und einer Quelle hinter jeder Aussage.
Dieser Beitrag erklärt, was Deep Research ist, welche Schritte ein KI-Recherche-Agent durchläuft, worin er sich von einem Chatbot und einer Suchmaschine unterscheidet und welche Assistenten die Funktion anbieten. Danach geht es darum, wo sie scheitert, wie Sie ihre Quellenangaben prüfen und einen guten Prompt schreiben, um die APIs für Entwickler und um die Frage, was sich ändert, wenn ein Unternehmen einen eigenen Recherche-Agenten betreibt. Die Angaben der Anbieter haben wir am 17. November 2026 auf ihren Hilfeseiten geprüft.
Was ist Deep Research?
Deep Research ist eine KI-Funktion, die eine mehrstufige Untersuchung einer Frage plant und durchführt und einen schriftlichen Bericht mit seinen Quellen zurückgibt. Das Modell antwortet nicht aus dem Gedächtnis: Es durchsucht das Web und die Dateien, die Sie verbinden, liest, was es findet, und baut die Antwort aus diesem Material.
Technisch ist Deep Research ein spezialisierter KI-Agent: ein Sprachmodell, das in einer Schleife arbeitet, seinen nächsten Schritt selbst wählt, Tools wie die Suche und das Lesen von Seiten aufruft und jedes Ergebnis prüft, bevor es weitermacht. Unser Beitrag darüber, wie KI-Agenten funktionieren, erklärt diese Schleife allgemein; Deep Research ist dieselbe Schleife, abgestimmt auf eine einzige Aufgabe: lesen und zusammenführen.
Der Name verbreitete sich im Dezember 2024, als Google Deep Research in Gemini einführte; OpenAI startete Deep Research in ChatGPT am 2. Februar 2025. Ein Paper aus dem Jahr 2025, Characterizing Deep Research, vertritt die These, dass nicht die Länge des Berichts das entscheidende Merkmal ist, sondern der „Fan-out“: wie viele getrennte Konzepte das System nachschlagen muss. Eine Frage nach einer einzelnen Tatsache braucht eine Suche; eine Frage zu fünf Märkten, drei Zahlungsarten und einem Zeitraum braucht Dutzende.
Wie funktioniert Deep Research Schritt für Schritt?
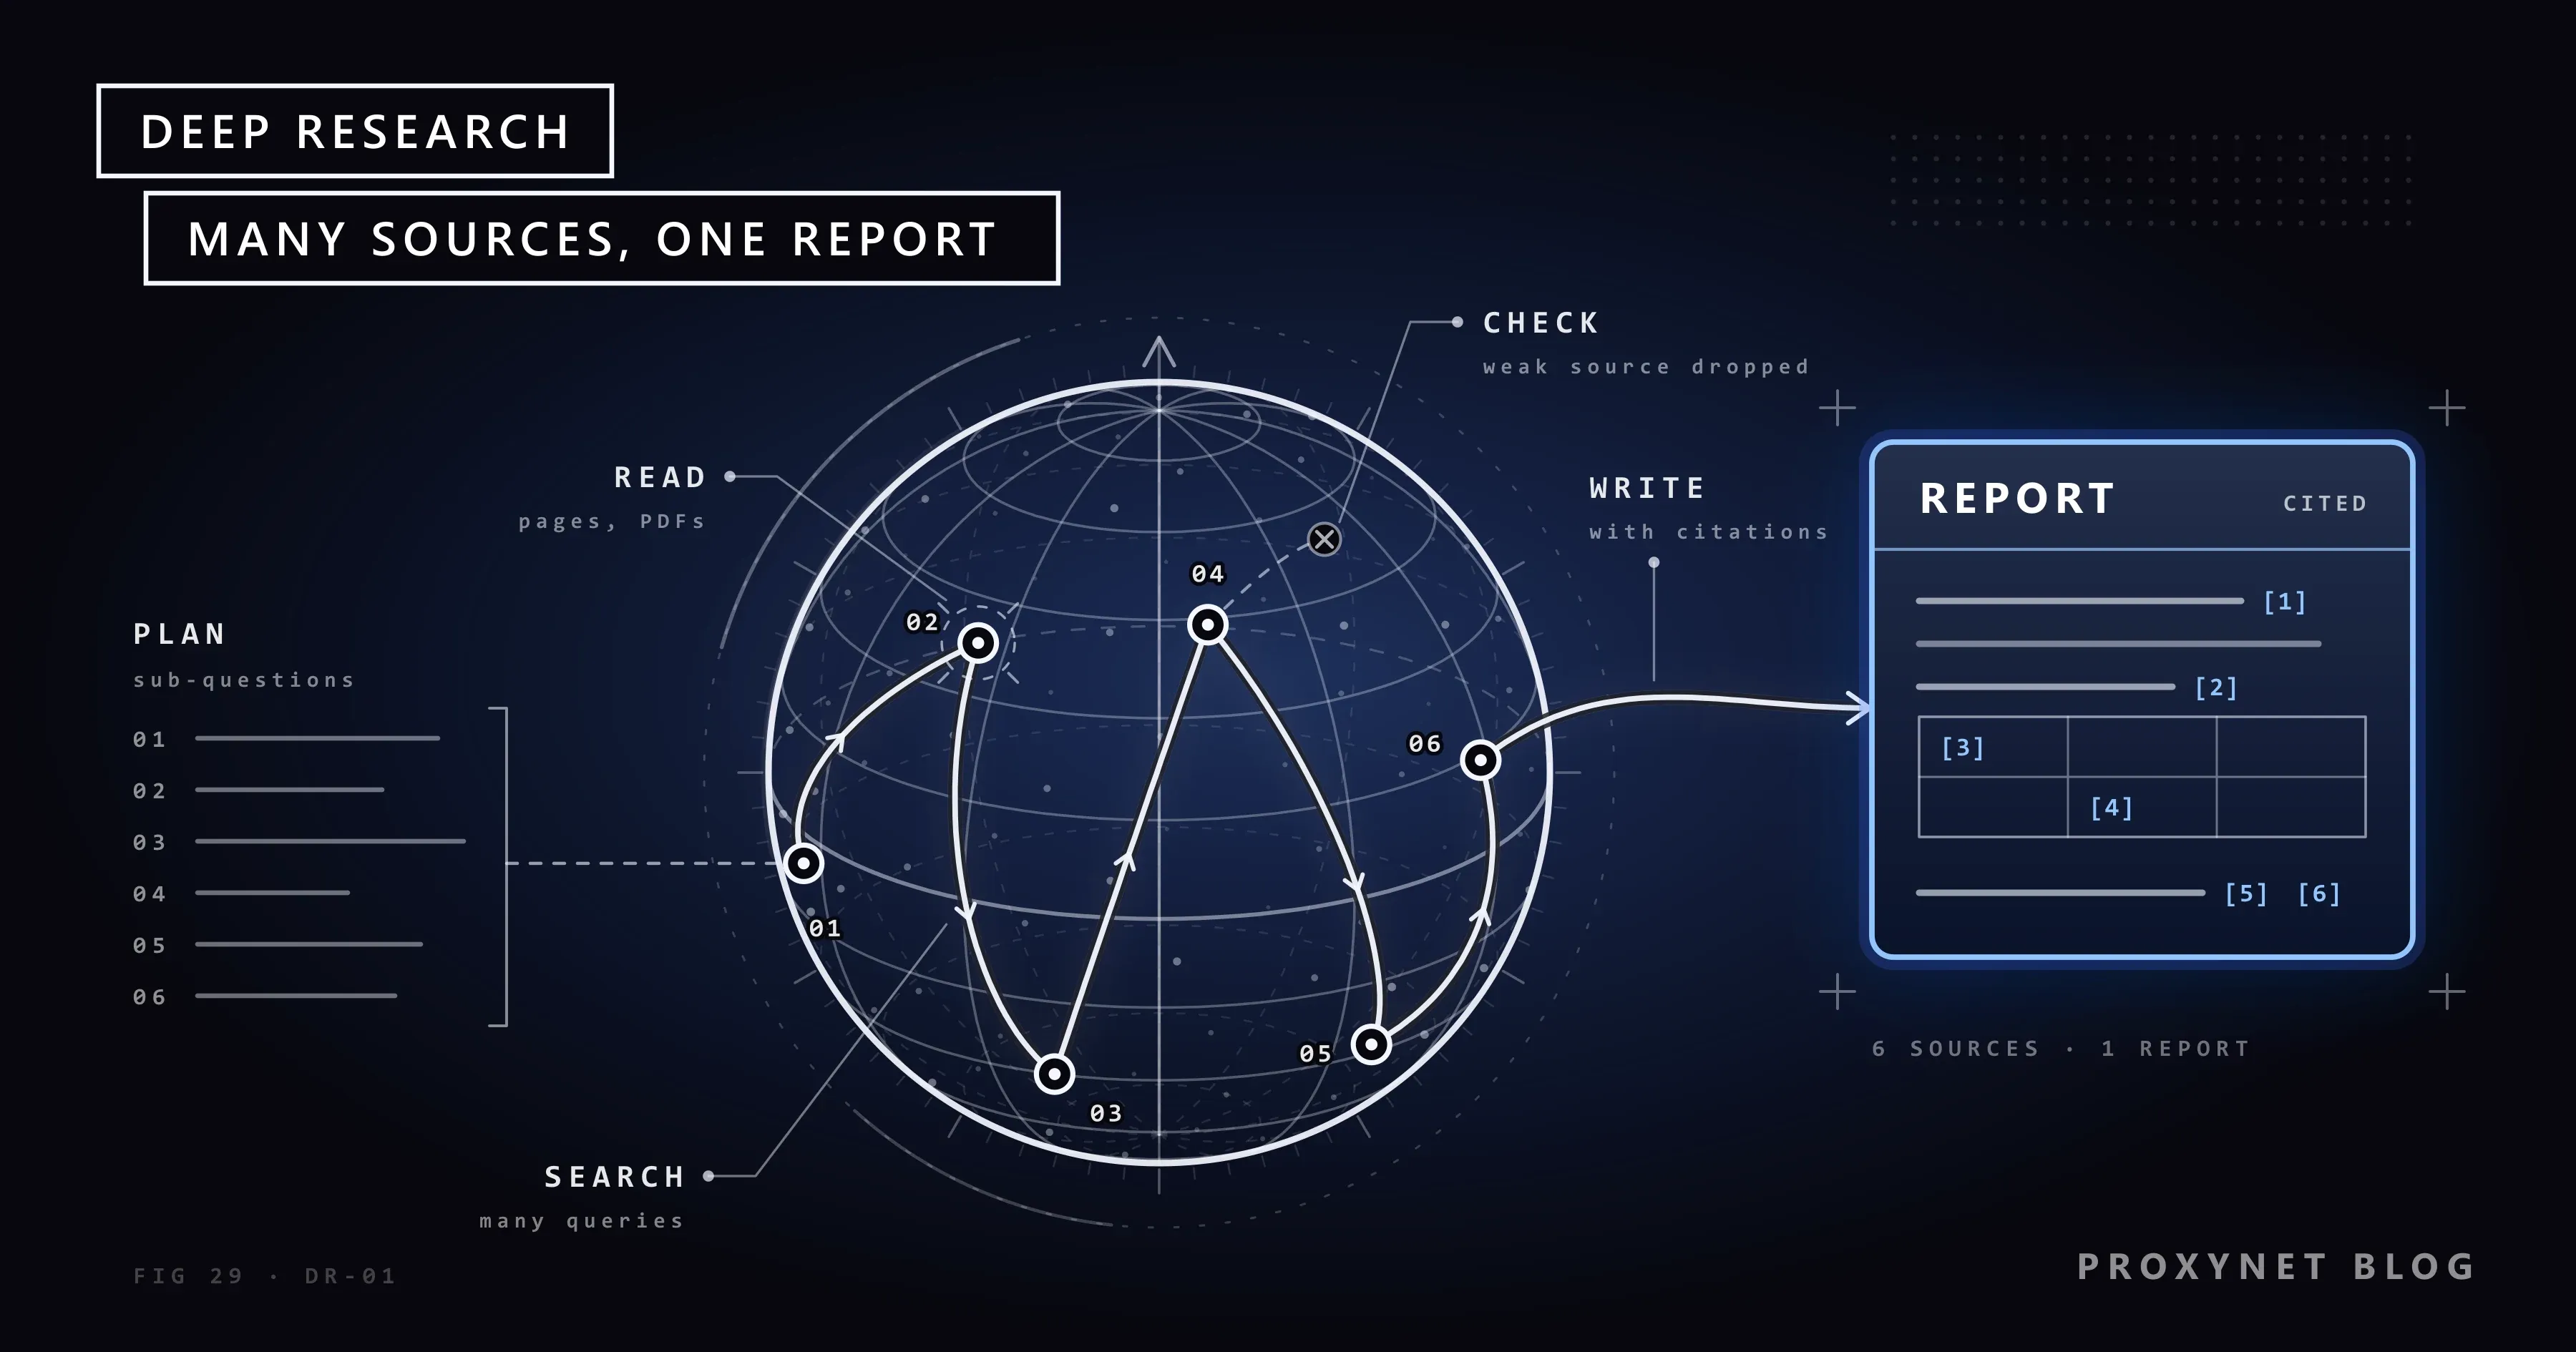
Deep Research arbeitet als Schleife aus Planen, Suchen, Lesen und Prüfen, die sich wiederholt, bis der Plan abgedeckt ist; danach folgt ein Schreibschritt, der die Quellenangaben anhängt.
- Die Frage klären. ChatGPT fragt zum Beispiel zuerst nach dem Umfang, etwa nach den Ländern oder dem Zeitraum, den Sie meinen.
- Einen Plan entwerfen. Das System zerlegt die Frage in Teilfragen und zeigt einen Rechercheplan; in Gemini und ChatGPT können Sie ihn bearbeiten, bevor die Arbeit beginnt.
- Breit suchen. Es formuliert viele Suchanfragen, anfangs meist kurz und allgemein, später enger, sobald es weiß, welche Quellen es gibt.
- Die Seiten lesen. Es öffnet Webseiten, PDFs und die Dateien oder verbundenen Quellen, die Sie freigegeben haben, und behält die Passagen, die eine Teilfrage beantworten.
- Bewerten und Lücken füllen. Es vergleicht die Funde mit dem Plan, bemerkt widersprüchliche Zahlen oder fehlende Teile und sucht erneut.
- Den Bericht schreiben. Ist der Plan abgedeckt oder ein Zeitlimit erreicht, schreibt es einen gegliederten Bericht.
- Quellen anhängen. Jede Aussage wird mit der Seite verknüpft, von der sie stammt, sodass Sie die Quelle öffnen und prüfen können.
Viele Systeme verteilen diese Arbeit auf mehrere Agenten. Anthropics Engineering-Beitrag über sein Multi-Agenten-Recherchesystem beschreibt einen Hauptagenten, der die Recherche plant und mehrere Unteragenten parallel suchen lässt, dazu einen eigenen Zitierschritt, der die Aussagen im fertigen Text ihren Quellen zuordnet. Laut dem Beitrag verbraucht dieser Aufbau etwa 15-mal so viele Tokens, also Texteinheiten, die ein Modell verarbeitet, wie ein normaler Chat. Deshalb begrenzt jeder Anbieter, wie viele Deep-Research-Aufgaben Sie ausführen können.
Worin unterscheidet sich Deep Research von einem Chatbot oder einer Suchmaschine?
Eine Suchmaschine liefert Ihnen eine sortierte Liste von Seiten, die Sie selbst lesen, ein Chatbot eine kurze Antwort aus wenigen Quellen und Deep Research einen Bericht aus vielen Seiten, die das System für Sie gelesen hat.
| Suchmaschine | Chatbot-Antwort | Deep Research | |
|---|---|---|---|
| Dauer | Sofort | Sekunden | Mehrere Minuten |
| Quellen | Links, die Sie öffnen | Wenige Seiten | Dutzende bis Hunderte |
| Ergebnis | Eine Trefferliste | Einige Absätze | Ein langer Bericht mit Quellen |
| Geeignet für | Eine Seite finden | Eine schnelle Tatsache | Eine Frage über viele Quellen |
Der eigentliche Unterschied ist, wer liest. Mit einer Suchmaschine öffnen Sie zehn Tabs und vergleichen sie; bei Deep Research übernimmt das System das Lesen, und Ihre Aufgabe verschiebt sich vom Lesen zum Prüfen.
Welche KI-Tools bieten Deep Research?
ChatGPT, Gemini, Claude und Perplexity bieten alle einen Deep-Research-Modus, mit unterschiedlichen Namen, Menüs und Limits, die sich oft ändern. Preise und Kontingente der einzelnen Tarife lassen wir weg, denn sie ändern sich noch schneller.
ChatGPT. Sie geben /Deepresearch im Prompt ein oder wählen Deep Research im Tool-Menü (+) oder in der Seitenleiste. Laut der Hilfeseite von OpenAI durchsucht die Funktion das öffentliche Web oder bestimmte Websites, liest hochgeladene Dateien und nutzt verbundene Apps; unter Sites > Websites verwalten beschränken Sie sie auf die Domains, die Sie eingeben. Sie können den Plan bearbeiten und die Recherche unterbrechen, und der Bericht lässt sich als Markdown, Word oder PDF herunterladen. Die Verfügbarkeit hängt von Ihrem Tarif und Ihrem Land ab.
Gemini. In der Gemini-App klicken Sie im Textfeld auf Dateien hinzufügen, wählen Deep Research und senden Ihre Frage ab; Gemini zeigt einen Plan, den Sie mit Plan bearbeiten ändern können, bevor Sie auf Recherche starten klicken. Standardquelle ist die Google Suche, und über Quellen fügen Sie Ihre Dateien, NotebookLM-Notebooks sowie Gmail und Drive hinzu, wenn Workspace verbunden ist. Laut der Hilfeseite von Google dauert ein Bericht im Schnitt 5 bis 10 Minuten, Sie müssen mindestens 18 Jahre alt sein, und die Zahl der Anfragen pro Tag ist begrenzt.
Claude. Anthropic nennt die Funktion Research, in der deutschen Oberfläche heißt sie „Recherche“. Sie steht in den kostenpflichtigen Claude-Tarifen zur Verfügung und setzt eine aktivierte Websuche voraus: Sie klicken unten links im Chat auf + und wählen Recherche. Laut der Hilfeseite von Anthropic führt Claude Suchen aus, die aufeinander aufbauen, kann verbundene Quellen wie Gmail und Google Docs nutzen und verbraucht die Limits des Tarifs schneller als ein normaler Chat.
Perplexity. Sie wählen in der Modusauswahl des Suchfelds Research (Recherche). Laut dem Hilfecenter von Perplexity erhalten kostenlose Nutzer eingeschränkten Zugang, die meisten Aufgaben sind in weniger als drei Minuten erledigt, und der Bericht lässt sich als PDF exportieren. Wie diese vier Tools das Web erreichen und ihre Quellen zeigen, vergleichen wir in ChatGPT vs. Claude vs. Gemini vs. Perplexity im Web.
Was kann Deep Research gut, und wo scheitert es?
Deep Research ist stark in der Breite und schwach im Urteil: Es liest mehr Seiten, als Sie lesen würden, weiß aber nicht immer, welche davon Vertrauen verdienen.
Gut ist es, wenn die Antwort über viele Seiten verteilt ist: ein Marktüberblick, Regeln in mehreren Ländern, der Hintergrund eines Unternehmens, eine erste Landkarte eines unbekannten Fachgebiets. Es findet auch Seiten, die eine schnelle Suche übersehen würde, weil es mit dem Vokabular weitersucht, das es unterwegs aufnimmt. Die Fehler kommen meist aus den Quellen:
- Schwache Quellen ranken hoch. Die Ingenieure von Anthropic beobachteten, dass frühe Versionen SEO-optimierte Content-Farmen gegenüber maßgeblichen Seiten bevorzugten, die weiter unten rankten.
- Paywalls und Logins halten es auf. Es liest das öffentliche Web und das, was Sie verbinden; die entscheidende Studie hinter einer Paywall erwähnt ein Bericht womöglich nie.
- Alte Seiten wirken aktuell. Ein undatierter Artikel von vor drei Jahren kann neben den Zahlen dieses Monats stehen.
- Quellenangaben können verrutschen. Der Link ist echt, aber der Satz ist eine Umschreibung, die den Sinn verändert hat, oder die Zahl stammt von einer anderen Seite.
- Unsicherheit geht verloren. OpenAI schrieb zum Start, das Modell könne Fakten erfinden, tue sich schwer, maßgebliche Informationen von Gerüchten zu unterscheiden, und zeige oft nicht, wie unsicher es ist.
Wie prüfen Sie einen Deep-Research-Bericht?
Sie prüfen einen Deep-Research-Bericht, indem Sie die Quellen hinter den Aussagen öffnen, auf die Sie handeln wollen, und bestätigen, dass jede davon sagt, was der Bericht behauptet.
- Die tragenden Aussagen auswählen. Markieren Sie die fünf bis zehn Fakten, von denen Ihre Entscheidung abhängt.
- Die zitierte Seite öffnen. Stellen Sie sicher, dass es die Seite ist, die der Bericht nennt, und nicht eine Startseite oder ein Suchergebnis.
- Den Satz finden. Suchen Sie auf der Seite nach der Zahl oder der Formulierung; steht sie nicht dort, behandeln Sie die Aussage als unbelegt.
- Das Datum prüfen und mit dem Zeitraum vergleichen, den Ihre Frage abdeckt.
- Zur Primärquelle gehen. Zitiert ein Nachrichtenartikel eine Aufsichtsbehörde, öffnen Sie die Seite der Behörde selbst.
- Nach der Gegenseite suchen. Fragen Sie „Welche Quellen widersprechen dem?“ oder führen Sie zur wichtigsten Aussage eine normale Suche durch.
Wie schreiben Sie einen guten Deep-Research-Prompt?
Ein guter Deep-Research-Prompt nennt die Frage, den Umfang, die Quellen, denen Sie vertrauen, den Zeitraum und das Format, das Sie zurückbekommen möchten. Das System plant aus Ihren Worten, also führt ein vager Prompt zu einem vagen Plan.
- Umfang: Länder, Branchen, Produkte, Unternehmensgröße.
- Quellen: offizielle Websites, Aufsichtsbehörden, Pflichtveröffentlichungen, Fachartikel oder Websites, die außen vor bleiben sollen. Quelleneinstellungen wie die Website-Liste von ChatGPT setzen das zuverlässiger durch als ein Satz im Prompt.
- Zeitraum: „Änderungen seit Januar 2026“ filtert das meiste veraltete Material heraus.
- Ausgabe: eine Vergleichstabelle, ein Abschnitt pro Markt, offene Fragen am Ende.
- Unsicherheit: Bitten Sie darum, Aussagen zu markieren, die nur auf einer einzigen Quelle beruhen.
Ein Beispiel, das alle fünf Punkte abdeckt:
Vergleiche die Online-Zahlungsarten, die die größten Mode-Onlineshops in
Deutschland, Spanien, Polen, Türkiye und Brasilien anbieten. Konzentriere dich
auf Änderungen seit Januar 2026. Bevorzuge offizielle Quellen: die
Zahlungsseiten der Shops selbst, Zentralbanken und Mitteilungen der
Zahlungssysteme. Liefere eine Tabelle (Land, Zahlungsart, erstmals gesehen) und
einen kurzen Abschnitt pro Land. Markiere jede Aussage, die nur auf einer
einzigen Quelle beruht, und liste die Fragen auf, die du nicht beantworten
konntest.
Gibt es eine Deep-Research-API?
Ja, mehrere Anbieter stellen Deep Research auch Entwicklern zur Verfügung, und das Angebot ändert sich schnell. Am 17. November 2026 führte die Dokumentation von Google einen Gemini-Deep-Research-Agenten als Vorschauversion, erreichbar über die Interactions API der Gemini API, und die API von Perplexity ordnete ihr Deep-Research-Modell der Aufwandsstufe „high“ ihrer Agent API zu. OpenAI hat seine eigens dafür gebauten Deep-Research-Modelle in der API laut seiner Seite zu eingestellten Modellen am 23. Juli 2026 abgeschaltet. Diese Aufgaben laufen minutenlang, deshalb startet eine Anwendung sie im Hintergrund und holt den Bericht ab, sobald er fertig ist.
Was ändert sich, wenn Sie einen eigenen Recherche-Agenten betreiben?
Betreibt eine Organisation einen eigenen Recherche-Agenten, werden seine Anfragen zu automatisiertem Traffic auf fremden Websites und müssen sich an deren Regeln halten. Eine einzige Aufgabe kann Hunderte Seiten öffnen, und ein Server, der zu viele Anfragen von einer Adresse sieht, antwortet mit 429 Too Many Requests oder sperrt sie.
Die Grundregeln sind die jedes rücksichtsvollen Crawlers: robots.txt lesen, pro Website ein Rate-Limit einhalten, den Agenten mit einem ehrlichen User-Agent ausweisen, Seiten zwischenspeichern, statt sie zweimal abzurufen, und die offizielle API der Website nutzen, wo es eine gibt. Seiten hinter einem Login oder einer Paywall bleiben außen vor, sofern Sie kein Recht haben, sie zu nutzen.
Der Standort ist die andere Hälfte. Preise, Währungen, Verfügbarkeit und rechtliche Hinweise ändern sich oft mit dem Land des Besuchers; ein Agent, der einen Markt aus einem Rechenzentrum in einem anderen Land untersucht, kann deshalb einen falschen Preis mit einer korrekt aussehenden Quellenangabe melden. Teams, die die lokale Ansicht brauchen, senden diese Anfragen über einen Residential-Proxy im Zielland und speichern zu jeder Seite das Land. Der Proxy ändert, woher die Anfrage kommt; er erhöht nicht die Zahl der Anfragen, die eine Website akzeptiert, und ist kein Weg, eine Sperre zu umgehen.
Wo wird Deep Research eingesetzt?
- Marktforschung: Wettbewerber, Preise und Vorschriften in mehreren Ländern.
- Literaturrecherche: eine erste Übersicht über die Fachliteratur, bevor Sie die wichtigen Arbeiten vollständig lesen.
- Due Diligence: die öffentliche Vorgeschichte eines Lieferanten, eines Partners oder eines Übernahmekandidaten.
- Regulierung und Compliance: was sich an einer Vorschrift geändert hat, wann und wer das sagt.
- Content- und SEO-Planung: was zu einem Thema bereits veröffentlicht ist und welche Fragen noch offen sind.
Häufige Fehler
- Den Bericht als fertige Arbeit behandeln. Er ist ein erster Entwurf; prüfen Sie die Aussagen, die Sie verwenden.
- Einen einzeiligen Prompt schreiben. Eine kurze Frage ergibt einen allgemeinen Plan.
- Die Prüfung des Plans überspringen. Eine falsche Teilfrage am Anfang kostet zehn Minuten.
- Deep Research für eine schnelle Tatsache nutzen. Eine Suche ist schneller und verbraucht keine Ihrer begrenzten Aufgaben.
- Annehmen, dass der Bericht alles abdeckt. Studien hinter Paywalls und private Datenbanken fehlen, solange Sie sie nicht verbinden.
- Den Bericht unverändert veröffentlichen. Schreiben Sie ihn um, prüfen Sie ihn und nennen Sie die Originalquellen; die Seiten, die er gelesen hat, gehören ihren Autoren.
Entscheidungshilfe
| Bedarf | Empfehlung |
|---|---|
| Eine Tatsache oder eine Definition | Eine Chatbot-Antwort oder eine Suche |
| Eine Frage, die über viele Seiten verteilt ist | Deep Research mit eingegrenztem Prompt |
| Nur vertrauenswürdige Quellen | Zuerst Websites oder Quellen einschränken |
| Ihre Dokumente plus das Web | Ein Tool, das Ihre Dateien verbindet |
| Recherche im eigenen Produkt | Die API eines Anbieters, im Hintergrund |
| Lokale Preise oder Bestände pro Land | Eigener Agent, standortgenaue Anfragen |
Häufige Fragen
Ist Deep Research kostenlos?
Teilweise. Am 17. November 2026 bot Gemini Deep Research angemeldeten Nutzern ab 18 Jahren mit täglichen Limits an, und Perplexity gab kostenlosen Nutzern eingeschränkten Zugang zu Research. Die Recherche-Funktion von Claude setzt einen kostenpflichtigen Tarif voraus, und das Kontingent in ChatGPT hängt von Ihrem Tarif und Ihrem Land ab; der Nutzungszähler im Produkt zeigt, was noch übrig ist.
Wie lange dauert Deep Research?
Meist zwischen etwa drei Minuten und einer halben Stunde. Perplexity sagt, die meisten Aufgaben seien in weniger als drei Minuten erledigt, Google nennt für Gemini im Schnitt 5 bis 10 Minuten, und OpenAI sprach zum Start von 5 bis 30 Minuten. Sie können den Chat verlassen, während die Recherche läuft.
Was ist der Unterschied zwischen Deep Research und einer Websuche?
Eine Websuche liefert eine schnelle Antwort oder eine Liste von Links aus wenigen Seiten; Deep Research plant eine Reihe von Suchen, liest viele Seiten und schreibt einen langen Bericht mit Quellen. Die Suche passt zu einer Tatsache, die Sie sofort brauchen, Deep Research zu einer Frage, die Stunden an Lektüre kosten würde.
Kann Deep Research Seiten hinter einer Paywall oder private Seiten lesen?
Nein, nicht von sich aus. Es liest das öffentliche Web und die Quellen, die Sie verbinden, etwa hochgeladene Dateien, einen Cloud-Speicher oder ein E-Mail-Konto. Inhalte hinter einer Paywall oder einem Login, die Sie nicht verbunden haben, fehlen, und der Bericht sagt das womöglich nicht.
Kann ich den Quellenangaben von Deep Research vertrauen?
Erst nachdem Sie die wichtigen geprüft haben. Die Links sind meist echt, aber der Satz, den sie stützen, kann eine freie Umschreibung, eine alte Zahl oder eine Aussage von einer schwachen Seite sein. Öffnen Sie die Seite, suchen Sie den genauen Satz, prüfen Sie das Datum und ziehen Sie die Primärquelle vor.
Ist Deep Research dasselbe wie ein KI-Agent?
Deep Research ist eine Art von KI-Agent. Ein allgemeiner Agent kann klicken, Formulare ausfüllen und auf Websites handeln; ein Deep-Research-Agent sucht, liest und schreibt vor allem. Die Hilfeseite von OpenAI sagt zum Beispiel, dass Deep Research nur die Leseaktionen verbundener Apps nutzt, nie deren Schreibaktionen.
Fazit
Deep Research ist ein KI-Agent, der aus einer Frage einen Plan macht, viele Suchen ausführt, die Seiten liest, die Lücken füllt und in Minuten einen Bericht mit Quellen schreibt. ChatGPT, Gemini, Claude und Perplexity bieten alle eine Version an, und einige Anbieter verkaufen sie über ihre APIs. Der Bericht ersetzt Stunden an Lektüre, aber nicht die Prüfung: Öffnen Sie die Quellen hinter den Aussagen, die Sie verwenden, ziehen Sie Primärseiten vor und achten Sie auf das Datum jeder Quelle. Für Recherchen, die davon abhängen, was eine Seite in einem bestimmten Land zeigt, betreiben Sie den Agenten mit standortgenauen Anfragen, oder sprechen Sie mit uns über unsere Web Scraping API für verwaltete Seitenextraktion.