Una pequeña tienda online sufre una filtración de su base de clientes. Semanas después, un servicio de streaming de vídeo recibe una oleada de inicios de sesión en cuentas que nunca le habían dado problemas; una plataforma de juegos ve lo mismo, y también un banco. Ninguno de ellos fue vulnerado. Los mismos pares de correo y contraseña de la tienda simplemente funcionaron en sus páginas de acceso, porque mucha gente usa una sola contraseña para todo.
Este artículo mira el credential stuffing desde el lado de quien defiende: en qué se diferencia de la fuerza bruta y del password spraying, por qué llega a través de miles de direcciones IP, qué señales deja en tus registros, qué controles lo detienen y qué pueden hacer los usuarios. Incluye dos ejemplos breves en Python, ambos defensivos.
¿Qué es el credential stuffing?
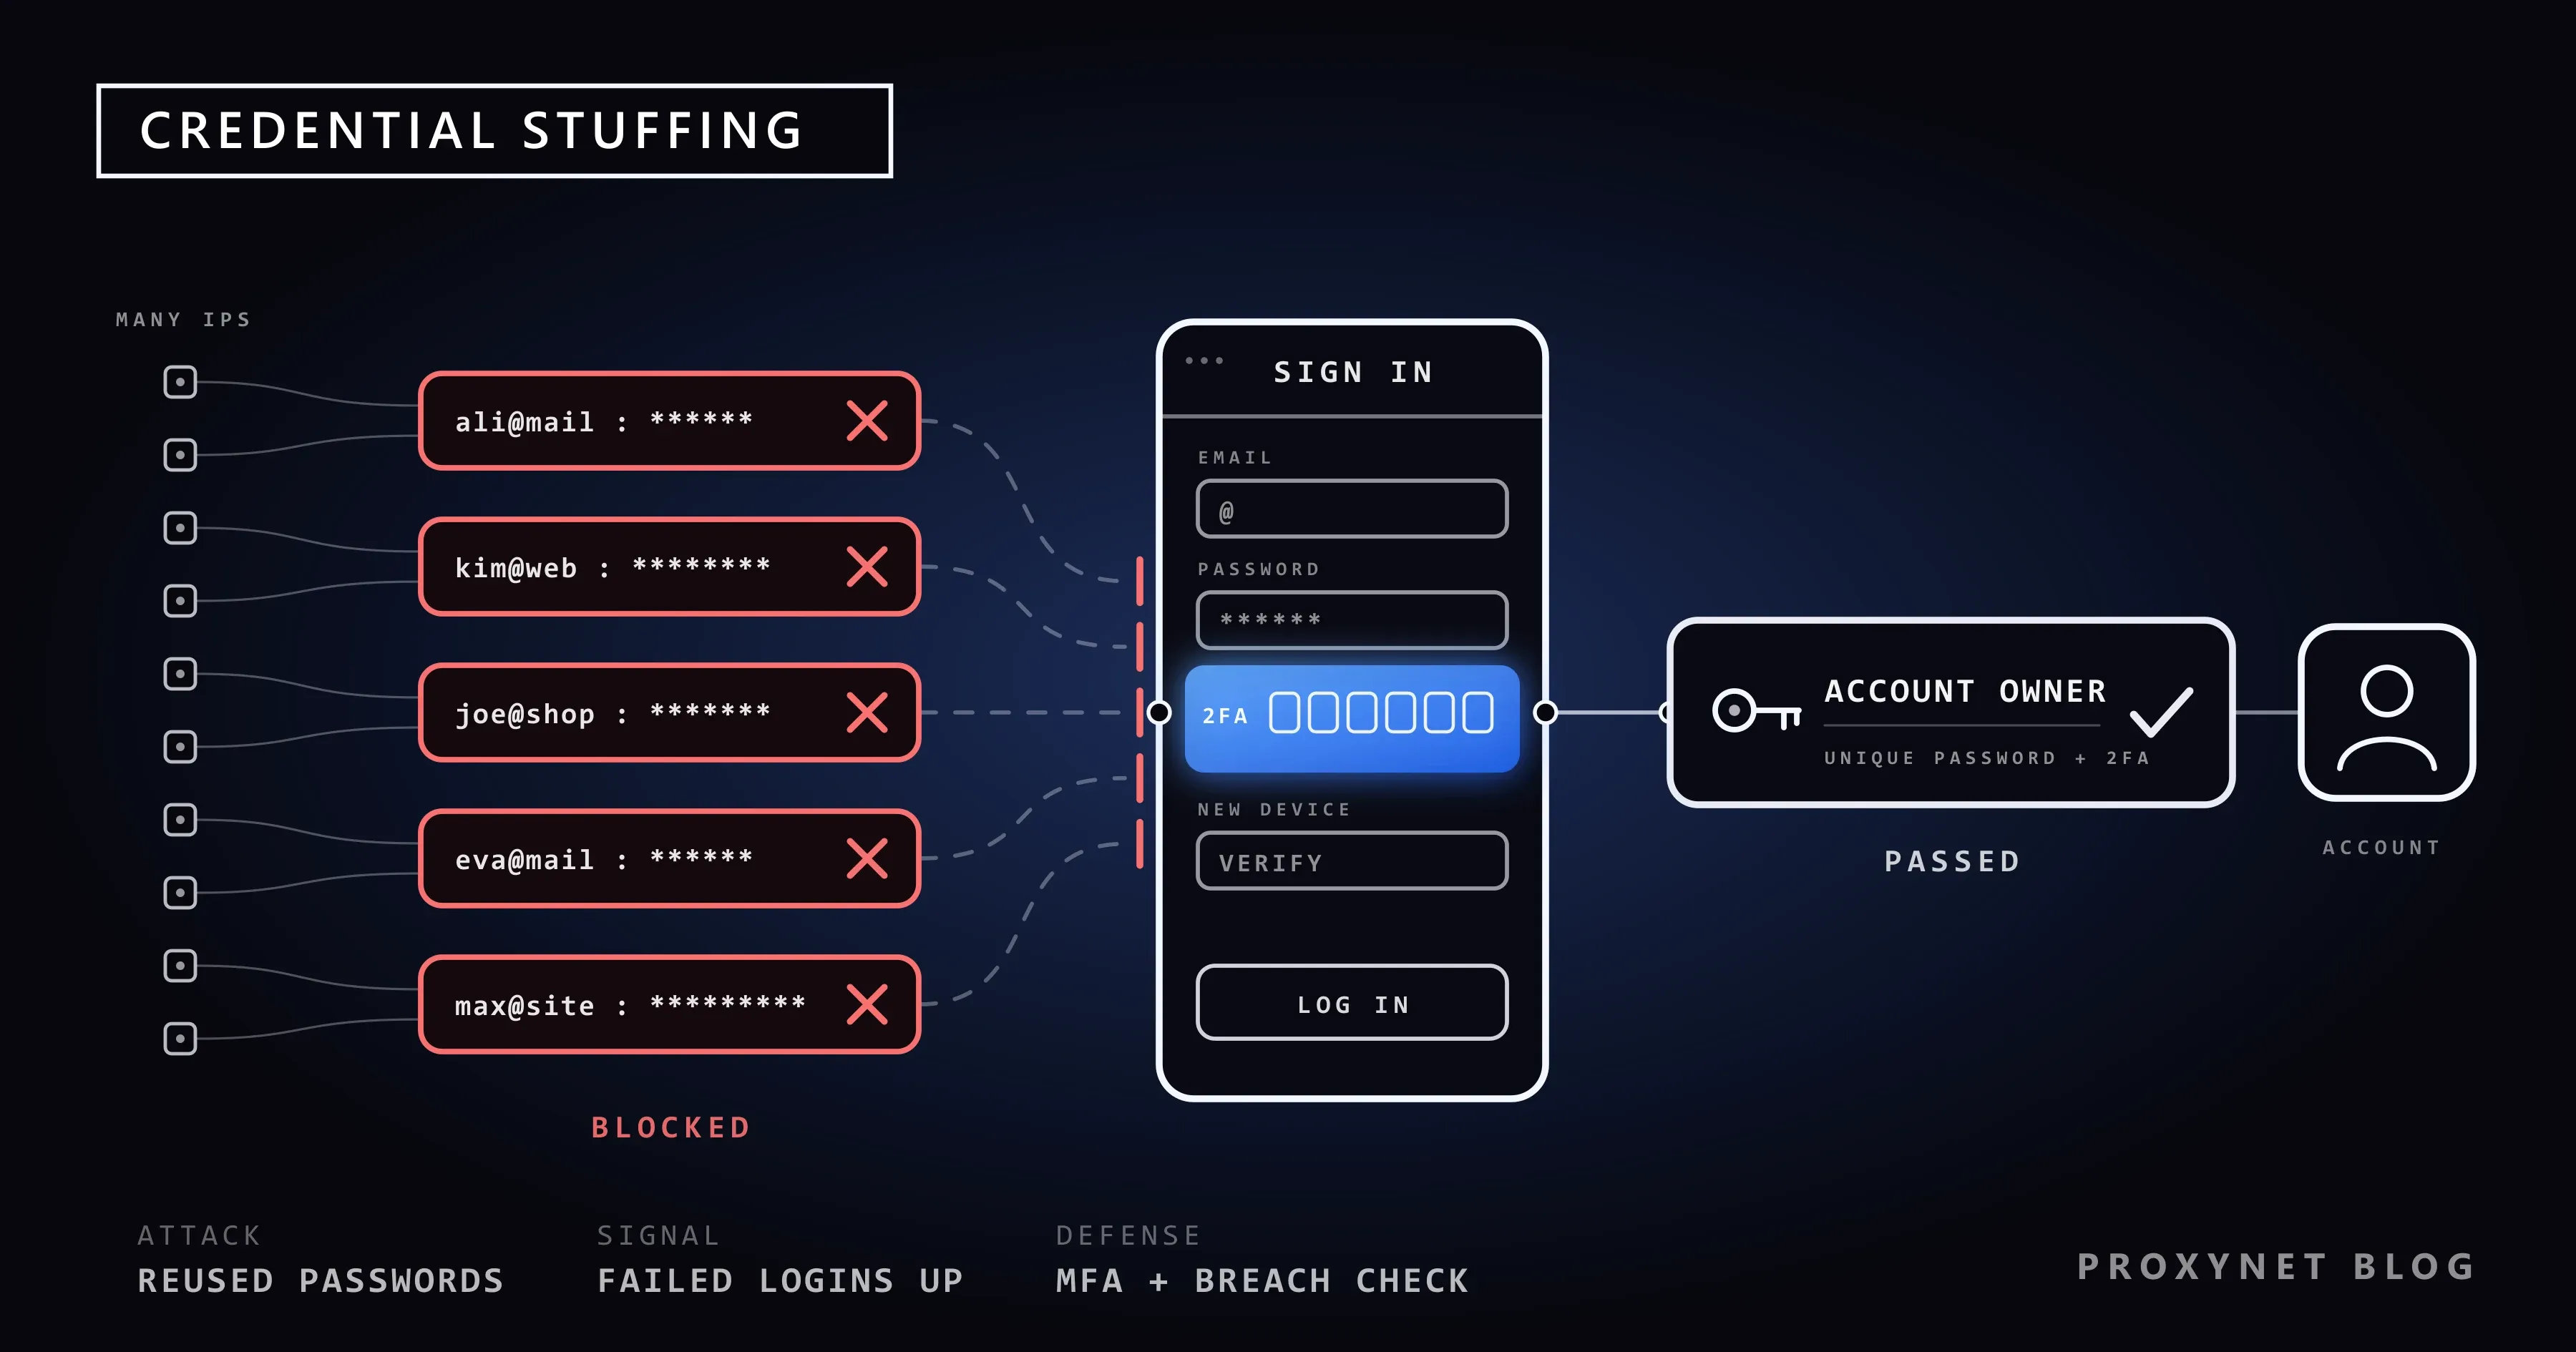
El credential stuffing es la reutilización a gran escala de datos de acceso robados. El atacante parte de pares que ya se sabe que son reales, obtenidos en una filtración anterior de otro servicio, y los introduce en un formulario de acceso con software automatizado. La mayoría de los pares fallan. Los que funcionan corresponden a cuentas cuyos dueños usaron la misma contraseña en el sitio filtrado y en el sitio objetivo.
La OWASP Credential Stuffing Prevention Cheat Sheet lo define como la prueba de pares de usuario y contraseña «obtenidos de la filtración de otro sitio». Las contraseñas del sitio atacado no fueron robadas y su código no tiene ningún fallo; la debilidad es la reutilización de contraseñas.
Lo que busca el atacante es la toma de control de cuentas (account takeover, ATO): un acceso válido a una cuenta que guarda algo de valor. Pueden ser puntos de fidelidad, una tarjeta de pago guardada, saldo en tarjetas regalo, datos personales o simplemente una cuenta de confianza desde la que enviar spam. Las cuentas tomadas se revenden con frecuencia.
¿Cómo funciona un ataque de credential stuffing?
A grandes rasgos, un ataque pasa por cinco etapas. Conocerlas te ayuda a decidir dónde colocar cada defensa.
- Una filtración en otro lugar. Un servicio es comprometido y su lista de usuarios, con correos y contraseñas (o hashes de contraseñas descifrados después), acaba circulando.
- Recopilación. Los pares filtrados de muchas brechas se fusionan en listas enormes. Las filtraciones antiguas conservan su valor durante años, porque mucha gente nunca cambia una contraseña reutilizada.
- Automatización. Un software envía los pares al formulario o a la API de acceso del objetivo, mucho más rápido de lo que una persona podría teclear.
- Distribución. Para esquivar los límites simples por IP, las peticiones se reparten entre muchas direcciones IP, a menudo mediante botnets de dispositivos infectados o redes de proxies alquiladas, de modo que cada dirección envía solo unos pocos intentos.
- Uso de los aciertos. Los pares que funcionan se revisan para ver su valor y luego se usan o se venden. Algunos atacantes cambian de inmediato el correo y la contraseña para dejar fuera al dueño real.
La etapa 1 ocurre en el servidor de otra persona. Tus defensas actúan en las etapas 3 a 5: encarecer los accesos automatizados, hacer que una contraseña correcta no baste por sí sola y detectar pronto una toma de control. Comprobar las contraseñas contra listas de filtraciones vuelve la etapa 2 en contra del atacante.
Credential stuffing, fuerza bruta y password spraying
Los tres ataques apuntan a las páginas de acceso, pero usan entradas distintas y dejan huellas distintas. Las definiciones siguientes siguen la cheat sheet de OWASP.
| Ataque | Qué se prueba | Patrón | Tasa de éxito típica por intento | Defensa principal |
|---|---|---|---|---|
| Fuerza bruta | Muchas contraseñas contra una cuenta | Una cuenta, muchas contraseñas | Muy baja, salvo que la contraseña sea débil | Límites de intentos por cuenta, contraseñas largas |
| Password spraying | Una contraseña común contra muchas cuentas | Muchas cuentas, una o pocas contraseñas | Baja, depende de contraseñas débiles | Lista de bloqueo de contraseñas comunes, MFA |
| Credential stuffing | Pares reales filtrados, cada uno probado una vez | Muchas cuentas, una contraseña cada una | Más alta, porque cada par fue real en algún sitio | MFA, comprobación de contraseñas filtradas, detección de bots |
Un bloqueo por cuenta tras cinco contraseñas incorrectas frena la fuerza bruta. Apenas afecta al credential stuffing, porque cada cuenta suele recibir un solo intento.
Por qué aparecen proxies e IP residenciales en estos ataques
Bloquear una dirección IP tras veinte accesos fallidos parece una protección, así que los atacantes envían las peticiones a través de muchas direcciones: routers domésticos secuestrados, dispositivos infectados, servidores en la nube y redes de proxies. Las direcciones de conexiones domésticas son difíciles de bloquear, porque también pueden usarlas clientes reales.
Por eso la cheat sheet de OWASP dice que el bloqueo por IP y la reputación de IP «no deben usarse como defensa única o principal». Hay tres problemas prácticos:
- Poco volumen por dirección. Cuando cada dirección envía uno o dos intentos, ningún umbral por IP se activa.
- Direcciones compartidas. Los operadores móviles y muchos proveedores domésticos ponen a muchos clientes detrás de una sola dirección pública (NAT de nivel operador, CGNAT). Bloquear esa dirección puede dejar fuera a usuarios reales.
- Rotación. Las direcciones cambian rápido, así que una lista de bloqueo queda desactualizada casi en cuanto se escribe.
Aun así, los datos de IP son útiles como una señal entre varias. Un IP fraud score o una coincidencia en una lista negra de IP puede elevar el riesgo de un acceso y activar una comprobación adicional en lugar de un bloqueo directo.
Una nota sobre nuestra propia red: los Términos del servicio de Proxynet prohíben los intentos de acceso no autorizado, y las cuentas que incumplen las normas de uso aceptable pueden suspenderse sin previo aviso. Los usos legítimos, como probar tu propio sitio desde otros países, se explican en nuestra página de seguridad de datos.
Señales de que estás bajo ataque
Ninguna señal aislada prueba un ataque, pero varias juntas son difíciles de pasar por alto. Estas son las que merece la pena llevar a un panel:
- Un salto en la tasa de accesos fallidos. La mayoría de los pares filtrados no coinciden, así que una oleada dispara una tasa que normalmente es estable.
- Muchos fallos de «usuario desconocido». Las listas filtradas contienen correos que nunca se registraron en tu sitio.
- Muchas cuentas, un intento cada una. La proporción entre nombres de usuario distintos e intentos se acerca a uno, lo contrario del patrón de fuerza bruta.
- Muchas direcciones IP, pocos intentos cada una, a menudo desde redes que rara vez te envían usuarios reales.
- Huellas de cliente idénticas en miles de usuarios «distintos»; cómo funciona la detección de bots explica estas señales.
- Accesos sin visita a la página. Peticiones que van directas a la API de acceso sin cargar la página de inicio de sesión, sus scripts ni sus imágenes.
- Lo que pasa después del acierto. Un acceso seguido, en cuestión de segundos, de un cambio de correo, contraseña o datos de cobro.
Los usuarios a menudo se dan cuenta antes que tú: una alerta de inicio de sesión sospechoso del banco o un correo de «nuevo inicio de sesión» que no provocaron. Ponles fácil avisarte.
Cómo evitar el credential stuffing en tu sitio
La cheat sheet de OWASP ordena las defensas, a grandes rasgos, por su valor. La lista siguiente mantiene ese espíritu y añade lo que NIST SP 800-63B (Revisión 4, definitiva desde agosto de 2025) exige a los sistemas de contraseñas.
- Autenticación multifactor. OWASP llama a la MFA «con diferencia, la mejor defensa» frente a los ataques a contraseñas: una contraseña filtrada correcta ya no basta. Exígela en las cuentas de administración y en las acciones de riesgo, y actívala cuando salten las señales anteriores.
- Passkeys. Una passkey sustituye la contraseña por un par de claves guardado en el dispositivo del usuario. La FIDO Alliance las describe como resistentes al phishing, y en tu servidor no hay ningún secreto compartido que pueda filtrarse o reutilizarse. Una cuenta que solo inicia sesión con passkey no le deja al credential stuffing nada que probar.
- Comprobación de contraseñas filtradas. NIST SP 800-63B, en su sección 3.1.1.2, establece que los verificadores deben comparar cada contraseña nueva con una lista de bloqueo de valores «de uso común, esperables o comprometidos». Compruébala en el registro y en el cambio de contraseña, y fuerza un cambio cuando haya indicios de compromiso.
- Límites de intentos que sigan a la cuenta, no solo a la IP. La sección 3.2.2 de NIST limita a un máximo de 100 los intentos fallidos consecutivos en una cuenta. Combínalo con límites por dispositivo, por rango de IP y por endpoint de acceso, y ralentiza las respuestas paso a paso en lugar de bloquear cuentas.
- Gestión de bots. Comprueba si el cliente ejecuta JavaScript y si la huella de su conexión coincide con el navegador que dice ser. Un CAPTCHA es un reductor de velocidad, no toda la defensa.
- La misma respuesta para cada fallo. Devuelve el mismo mensaje y un tiempo de respuesta similar para «contraseña incorrecta» y «usuario inexistente», para que el formulario de acceso no sirva para averiguar qué correos tienen cuenta.
- Avisa a los usuarios y vigila la cuenta tras el acceso. Envía alertas por inicios de sesión desde dispositivos nuevos y por cambios en la cuenta, y pide un segundo factor antes de esos cambios.
Código: comprobar contraseñas filtradas con k-anonimato
La API Pwned Passwords de Have I Been Pwned te permite comprobar una contraseña contra filtraciones conocidas sin enviar la contraseña, ni siquiera su hash completo. Solo envías los cinco primeros caracteres del hash SHA-1; el servicio devuelve todos los sufijos de hash que empiezan por ellos, con un recuento, y tú buscas tu sufijo en local. Este es el modelo de k-anonimato (k-anonymity). La API de rangos no necesita clave de API, y la cabecera Add-Padding añade filas señuelo (recuento 0) para que el tamaño de la respuesta no revele nada.
import hashlib
import time
import urllib.error
import urllib.request

API = "https://api.pwnedpasswords.com/range/"


def breach_count(password: str, retries: int = 3) -> int:
    """Devuelve cuántas veces aparece una contraseña en Pwned Passwords (0 = no encontrada)."""
    digest = hashlib.sha1(password.encode("utf-8")).hexdigest().upper()
    prefix, suffix = digest[:5], digest[5:]
    request = urllib.request.Request(
        API + prefix,
        headers={"User-Agent": "example-signup-check", "Add-Padding": "true"},
    )
    for attempt in range(retries):
        try:
            with urllib.request.urlopen(request, timeout=5) as response:
                body = response.read().decode("utf-8")
            break
        except (urllib.error.URLError, TimeoutError):
            if attempt == retries - 1:
                raise
            time.sleep(2 ** attempt)
    for line in body.splitlines():
        candidate, _, count = line.partition(":")
        if candidate == suffix:
            return int(count)  # las filas de relleno tienen recuento 0
    return 0


if __name__ == "__main__":
    for pw in ["password123", "correct horse battery staple", "vX9#qL2-mT8!rW4zK7"]:
        hits = breach_count(pw)
        verdict = "reject: seen in breaches" if hits else "not in the breach list"
        print(f"{pw!r}: {hits} -> {verdict}")
Al ejecutarlo, las dos primeras contraseñas aparecen como encontradas, con recuentos que crecen a medida que se actualiza el conjunto de datos; la cadena aleatoria devuelve 0. En un formulario de registro, llama a breach_count en el servidor, rechaza cualquier resultado distinto de cero con un mensaje claro y decide de antemano qué ocurre si la API no responde.
Código: detectar una oleada de stuffing en los registros de acceso
La mayoría de los sitios ya registran cada intento de acceso. El script siguiente lee un registro CSV con las columnas time, ip, username y result, agrupa los intentos por minuto y muestra los minutos en los que la tasa de fallos es anómala, junto con la proporción de usuarios desconocidos y el número de cuentas y direcciones distintas.
import csv
from collections import defaultdict

ALERT_FAIL_RATE = 0.50
MIN_ATTEMPTS = 50

# Agrupa los intentos de acceso en intervalos de un minuto.
buckets = defaultdict(lambda: {"total": 0, "failed": 0, "unknown": 0, "users": set(), "ips": set()})
with open("logins.csv", newline="") as f:
    for row in csv.DictReader(f):
        b = buckets[row["time"][:16]]          # "2026-09-28T10:41"
        b["total"] += 1
        b["users"].add(row["username"])
        b["ips"].add(row["ip"])
        if row["result"] != "ok":
            b["failed"] += 1
        if row["result"] == "unknown_user":
            b["unknown"] += 1

for minute in sorted(buckets):
    b = buckets[minute]
    fail_rate = b["failed"] / b["total"]
    unknown_share = b["unknown"] / b["total"]
    if b["total"] >= MIN_ATTEMPTS and fail_rate >= ALERT_FAIL_RATE:
        print(f"{minute}  attempts={b['total']}  failed={fail_rate:.0%}  "
              f"unknown-user={unknown_share:.0%}  accounts={len(b['users'])}  ips={len(b['ips'])}")
Con un registro de prueba que mezcla tráfico normal y una ráfaga simulada, la salida es esta:
2026-09-28T10:40  attempts=80  failed=78%  unknown-user=49%  accounts=80  ips=69
2026-09-28T10:41  attempts=80  failed=79%  unknown-user=45%  accounts=80  ips=70
Ochenta cuentas, casi otras tantas direcciones y la mitad de los usuarios desconocidos: el patrón del credential stuffing. Ajusta los umbrales a partir de tu propio tráfico normal.
Qué pueden hacer los usuarios
El credential stuffing solo funciona con contraseñas reutilizadas, así que los usuarios tienen un control real sobre él.
- Usa un gestor de contraseñas para que cada sitio tenga su propia contraseña aleatoria.
- Activa la autenticación en dos pasos, empezando por el correo y el banco; una app de autenticación o una llave de seguridad es mejor que los códigos por SMS.
- Pásate a las passkeys donde el sitio las admita. Ya no queda ninguna contraseña que filtrar o reutilizar.
- Comprueba tu correo en Have I Been Pwned y cambia cualquier contraseña que hayas reutilizado.
- Actúa ante las alertas de «nuevo inicio de sesión» que no provocaste: cambia la contraseña y cierra las demás sesiones.
- Evita iniciar sesión a través de redes desconocidas. Un proxy gratuito gestionado por un desconocido puede leer tu tráfico; consulta ¿Son seguros los proxies gratuitos?.
Dónde importa más
- Tiendas online y marketplaces. Las tarjetas guardadas, las tarjetas regalo y los puntos de fidelidad hacen que valga la pena tomar las cuentas; en nuestra página de e-commerce verás cómo las tiendas prueban sus propios escaparates.
- Bancos y fintech. La toma de control de una cuenta lleva directamente a mover dinero; la página de finanzas explica cómo los equipos financieros revisan sus páginas públicas desde otras regiones.
- Streaming y juegos. Las cuentas compartidas y revendidas son un mercado constante para los accesos robados.
- Cualquier sitio que recopile datos personales. Una toma de control expone los datos guardados del usuario, lo que es un problema de protección de datos además de fraude; Cómo tratar datos personales (PII) en datos de scraping cubre el tratamiento para los equipos de datos.
Errores frecuentes
- Confiar en el bloqueo por IP. Falla ante ataques distribuidos.
- Bloquear cuentas tras unos pocos fallos. Permite a los atacantes dejar fuera a tus clientes.
- Mensajes de error distintos para «contraseña incorrecta» y «cuenta inexistente». Convierte tu formulario de acceso en un comprobador de correos gratuito.
- Proteger el formulario web pero no la API. Las apps móviles y las versiones antiguas de la API suelen tener su propio endpoint de acceso con límites más débiles.
- Obligar a cambiar la contraseña periódicamente. NIST SP 800-63B dice que no se haga; fuerza un cambio solo cuando haya indicios de compromiso.
- Vigilar solo el acceso. La toma de control se ve con más claridad en lo que ocurre después.
Guía de decisión
| Tu situación | Qué hacer primero |
|---|---|
| Los accesos fallidos se disparan y la mayoría de los usuarios son desconocidos | Trátalo como credential stuffing: aumenta la fricción en las sesiones de riesgo y pide un segundo factor en los accesos correctos desde dispositivos nuevos |
| Tienes un sitio pequeño sin equipo de seguridad | Añade MFA, una comprobación de contraseñas filtradas en el registro y en el cambio, y un servicio gestionado de protección contra bots delante del acceso |
| Las cuentas de administración o del personal usan solo contraseña | Exige MFA o passkeys para ellas ya |
| Los clientes informan de accesos que no hicieron | Fuerza el restablecimiento en las cuentas afectadas, avísales y revisa qué cambió tras el acceso |
| Hoy solo bloqueas IP | Mantenlo como una señal más; añade límites por cuenta y por endpoint y comprobaciones del dispositivo |
| Eres un usuario que reutiliza contraseñas | Pásate a un gestor de contraseñas y activa la autenticación en dos pasos, empezando por el correo |
Preguntas frecuentes
¿El credential stuffing es ilegal?
Sí. Entrar en la cuenta de otra persona sin permiso es un acceso no autorizado según las leyes sobre delitos informáticos de la mayoría de los países, sea cual sea la herramienta. Las pruebas solo son legales en sistemas que te pertenecen o para los que tienes permiso por escrito.
¿En qué se diferencia el credential stuffing de una filtración de datos?
Una filtración es el robo de datos de un servicio. El credential stuffing es lo que viene después, cuando los pares robados se prueban en otros servicios. El sitio atacado puede no haber sufrido nunca una filtración.
¿Un CAPTCHA detiene el credential stuffing?
Lo ralentiza y encarece, pero no es una defensa completa. OWASP lo incluye como una capa entre varias, por detrás de la autenticación multifactor.
¿Por qué no bloquear una cuenta tras tres contraseñas incorrectas?
En el credential stuffing cada cuenta suele recibir un único intento, así que el bloqueo rara vez se activa. Cuando se activa, puede usarse para dejar fuera a usuarios reales. Funcionan mejor los límites repartidos entre cuenta, dispositivo y endpoint.
¿Es seguro para mis usuarios comprobar las contraseñas con Pwned Passwords?
Con la API de rangos solo envías los cinco primeros caracteres del hash SHA-1 de la contraseña, y la comparación se hace en tu servidor. El servicio nunca ve la contraseña completa ni su hash completo.
¿Las passkeys acaban con el credential stuffing?
En las cuentas que inician sesión solo con passkey, sí: no hay ninguna contraseña reutilizable que probar. Mientras un sitio siga aceptando contraseñas como alternativa, esa alternativa necesita las mismas protecciones.
En resumen
El credential stuffing convierte la filtración de un sitio en tomas de control de cuentas en muchos otros, porque la gente reutiliza contraseñas. Se reparte entre muchas direcciones IP, así que el bloqueo por IP no basta para detenerlo. Las defensas que funcionan son la autenticación multifactor o las passkeys, rechazar las contraseñas que aparecen en listas de filtraciones como exige NIST SP 800-63B, los límites de intentos ligados a cuentas y dispositivos, la detección de bots y la vigilancia de lo que ocurre tras cada acceso. Los usuarios cierran la puerta por su lado con un gestor de contraseñas y contraseñas únicas. Para probar de forma legítima tus propios flujos de acceso y tus páginas desde otras regiones, consulta nuestros servicios de proxy y Proxies residenciales.