Ein Support-Chatbot erklärt einem Kunden, ein Rabatt lasse sich auch nach der Reise noch beantragen, während die Richtlinienseite des Unternehmens das ausschließt. Ein Coding-Assistent schlägt vor, eine Bibliothek zu installieren, die nie veröffentlicht wurde. Ein Anwalt reicht einen Schriftsatz ein, der Gerichtsentscheidungen zitiert, die kein Gericht je geschrieben hat. Jede dieser Antworten war flüssig und konkret, ohne jeden Zweifel, und jede war falsch. In der KI hat dieser Fehler einen Namen: Halluzination.
Dieser Beitrag erklärt, was eine KI-Halluzination ist, warum Sprachmodelle sie erzeugen, welche Arten es gibt, welche Fälle dokumentiert sind, wie Sie eine Halluzination erkennen, wie Sie sie mit Grounding (Verankerung in Quellen) und Prüfung verringern und warum sie sich nicht vollständig beseitigen lässt.
Was ist eine KI-Halluzination?
Eine KI-Halluzination ist ein Inhalt, den ein KI-Modell als Tatsache präsentiert, der aber falsch, erfunden oder nicht durch seine Eingabe gedeckt ist. Der Begriff ist als Metapher aus der Psychologie entlehnt: Das Modell sieht und hört nichts. Es erzeugt Text, und ein Teil dieses Textes passt nicht zur Wirklichkeit oder zu dem Dokument, nach dem es gefragt wurde.
Das NIST, das Normungsinstitut der USA, bevorzugt ein anderes Wort. Sein Profil für generative KI, das Generative AI Profile (NIST AI 600-1), nennt dieses Risiko Konfabulation (confabulation) und beschreibt sie als die Erzeugung selbstsicher formulierter, aber fehlerhafter oder falscher Inhalte; umgangssprachlich heiße das Halluzination oder Erfindung (fabrication). Die Definition umfasst auch Ausgaben, die vom Prompt abweichen oder früheren Aussagen des Modells im selben Gespräch widersprechen.
Zwei Dinge sind im engeren Sinn keine Halluzinationen: einen Fehler zu wiederholen, der schon in dem von Ihnen gelieferten Dokument stand (das ist ein Quellenproblem), und das Erfinden in einer Geschichte oder einem Bild, wo Erfinden die Aufgabe ist. Zum Problem wird eine Halluzination, wenn der Leser Fakten erwartet.
Warum halluzinieren KI-Modelle?
KI-Modelle halluzinieren, weil ein Sprachmodell darauf trainiert ist, plausiblen Text vorherzusagen, nicht ihn zu prüfen: Es wählt das nächste Wortstück (Token), das am besten zu den gelernten Mustern passt, dann das nächste. Unser Beitrag darüber, wie große Sprachmodelle funktionieren, geht diese Schleife Schritt für Schritt durch. Nirgends darin wird ein Fakt nachgeschlagen; ein plausibler falscher Satz und ein plausibler richtiger entstehen deshalb im selben Prozess.
Forschung und Normungsgremien nennen dieselben Ursachen:
- Vorhersage belohnt Plausibilität. Das NIST bezeichnet Konfabulation als natürliche Folge der Bauweise generativer Modelle: Sie bilden die statistischen Muster ihrer Trainingsdaten nach, und Text, der richtig klingt, schneidet gut ab, ob er stimmt oder nicht.
- Seltene oder falsche Fakten in den Daten. Ein Fakt, der in den Trainingsdaten oft vorkommt, wird meist korrekt wiedergegeben; ein Fakt, der nur ein- oder zweimal auftaucht, eher nicht, und Fehler in den Daten werden flüssig wiederholt. Im Paper Why Language Models Hallucinate („Warum Sprachmodelle halluzinieren“) argumentieren Forschende von OpenAI und Georgia Tech, dass bei willkürlichen Fakten ohne erkennbares Muster, etwa dem Geburtstag einer Person, manche Fehler für ein Basismodell statistisch unvermeidbar sind.
- Training und Tests belohnen Raten. Dasselbe Paper stellt fest, dass die meisten Benchmarks Antworten nur als richtig oder falsch bewerten: „Ich weiß es nicht“ bringt nichts, ein geratener Wert dagegen manchmal einen Punkt. Ein Modell, das auf solche Tests abgestimmt wird, lernt zu raten.
- Trainingsdaten haben ein Enddatum. Ein Modell weiß nichts über die Zeit nach seinem Wissensstichtag und kann Fragen zu einem späteren Ereignis, einem neuen Preis oder einer neuen Regel aus älteren Mustern beantworten.
- Vage Prompts und falsche Prämissen. Wer fragt, warum ein Produkt eine Auszeichnung erhalten hat, die es nie erhielt, lädt zu einer Antwort ein, die auf dieser Prämisse aufbaut. Auch Präferenz-Tuning, also die Abstimmung auf menschliche Präferenzen, kann ein Modell allzu bereit machen, dem Nutzer zuzustimmen; die Forschung nennt das Sycophancy (Gefälligkeit).
- Langer oder verrauschter Kontext. In der Studie „Lost in the Middle“ (Liu und Kollegen, 2023) antworteten Modelle am besten, wenn die relevante Passage am Anfang oder Ende einer langen Eingabe stand, und schlechter, wenn sie in der Mitte stand.
- Einstellungen der Dekodierung. Die meisten Werkzeuge ziehen eine Stichprobe aus den vorhergesagten Wahrscheinlichkeiten, statt immer das wahrscheinlichste Wort zu nehmen; eine höhere Zufallseinstellung, meist Temperatur genannt, macht unwahrscheinliche Wörter und Behauptungen häufiger.
Welche Arten von KI-Halluzinationen gibt es?
KI-Halluzinationen fallen in zwei große Gruppen: Antworten, die realen Fakten widersprechen, und Antworten, die den Anweisungen oder dem Text, den das Modell erhalten hat, nicht folgen. Eine Übersichtsarbeit zu Halluzinationen in großen Sprachmodellen von Huang und Kollegen aus dem Jahr 2023 nennt sie Faktizitäts- und Treue-Halluzinationen (factuality und faithfulness). Ältere Forschung zur Textgenerierung sprach von intrinsisch (die Ausgabe widerspricht der Quelle) und extrinsisch (die Ausgabe fügt etwas hinzu, das die Quelle nicht bestätigen kann).
In der Praxis sehen die Arten so aus (die Beispiele sind erfunden):
| Art | Wie sie aussieht | Beispiel |
|---|---|---|
| Faktenfehler | Falsches Datum, falsche Zahl oder falscher Name | „Marke A wurde 2009 gegründet“; ihre Website nennt 2012 |
| Erfundene Quelle | Verweis, Zitat, Link oder Fall, den es nicht gibt | Eine Studie mit echt klingenden Autoren und totem Link |
| Erfundenes Paket | Code importiert eine nie veröffentlichte Bibliothek | Ein Installationsbefehl für einen unbekannten Namen |
| Widerspricht der Quelle | Eine Zusammenfassung, die das Dokument umkehrt | „Rückgabe innerhalb von 30 Tagen“; die Richtlinie sagt 14 |
| Ergänzt die Quelle | Details, die das Dokument nie erwähnt | Ein CEO-Zitat, das nicht im Artikel steht |
| Selbstwiderspruch | Widerspricht einer früheren Antwort | Zwei verschiedene Summen in einem Chat |
Erfundene Quellen wirken überzeugend, weil eine Quellenangabe ein Muster ist (Autoren, Titel, Zeitschrift, Jahr, DOI), das ein Modell nachbilden kann, ohne dass ein Paper dahintersteht. Bei Code ist es genauso: Eine Studie von 2024 zu codegenerierenden Modellen in Python und JavaScript, angenommen beim USENIX Security Symposium 2025, stellte fest, dass Modelle nicht existierende Pakete empfahlen und viele derselben erfundenen Namen immer wieder nannten. Ein Angreifer kann also unter einem solchen Namen ein Schadpaket veröffentlichen und abwarten.
Welche echten Beispiele für KI-Halluzinationen gibt es?
Die am besten dokumentierten Fälle stammen von Gerichten und Schlichtungsstellen, deren Entscheidungen festhalten, was gesagt wurde und was es gekostet hat.
Erfundene Rechtsprechung vor einem US-Gericht. Im Fall Mata v. Avianca verhängte ein Bundesgericht in New York am 22. Juni 2023 Sanktionen gegen zwei Anwälte und ihre Kanzlei, weil sie nicht existierende Gerichtsentscheidungen mit gefälschten Zitaten und Fundstellen eingereicht hatten, die ChatGPT erzeugt hatte. Als einer der Anwälte den Chatbot fragte, ob ein Fall echt sei, bejahte dieser und sagte, der Fall sei in juristischen Datenbanken zu finden. Das Gericht schrieb, es sei an sich nicht unzulässig, ein zuverlässiges KI-Werkzeug zur Unterstützung zu nutzen, Anwälte müssten aber prüfen, was sie einreichen. Es verhängte eine Geldsanktion von 5.000 US-Dollar und ordnete Schreiben an den Mandanten und an jeden Richter an, der fälschlich als Verfasser einer der gefälschten Entscheidungen genannt worden war.
Die falsche Richtlinienauskunft eines Chatbots. Im Fall Moffatt v. Air Canada (2024 BCCRT 149) teilte der Website-Chatbot einer Fluggesellschaft einem Passagier mit, ein ermäßigter Tarif für Trauerfälle (Bereavement Fare) lasse sich innerhalb von 90 Tagen nach Ausstellung des Tickets beantragen, während die Richtlinienseite der Fluggesellschaft selbst sagte, dass er nach der Reise nicht mehr gilt. Am 14. Februar 2024 wies das Civil Resolution Tribunal, eine Streitbeilegungsstelle der kanadischen Provinz British Columbia, das Argument zurück, die Fluggesellschaft hafte nicht für ihren Chatbot. Es erklärte sie für alle Informationen auf ihrer Website verantwortlich und verurteilte sie zur Zahlung von 812,02 kanadischen Dollar. Die Entscheidung sagt nicht, welche Technik hinter dem Chatbot steckte; ihre Lehre lautet, dass eine automatische Antwort trotzdem die Antwort des Unternehmens ist.
Selbstsicher und jedes Mal anders. Im Paper von OpenAI und Georgia Tech fragten die Autoren drei verbreitete Chatmodelle nach dem Titel der Doktorarbeit eines der Autoren. Jedes nannte einen anderen Titel und ein anderes Jahr, und keine Antwort war richtig.
Wie erkennen Sie eine KI-Halluzination?
Sie erkennen eine Halluzination, indem Sie die konkreten Behauptungen mit einer Quelle abgleichen, die Sie selbst öffnen können, denn der Ton der Antwort verrät nichts. Diese Anzeichen verdienen einen zweiten Blick:
- Genaue Details ohne Quelle. Exakte Zahlen, Datumsangaben, Zitate oder Aktenzeichen ohne Link oder Beleg.
- Quellen, die sich nicht öffnen lassen. Ein Link, der einen Fehler liefert, eine DOI, die ins Leere führt, ein Zitat, das im zitierten Text nicht zu finden ist.
- Viele Details zu einem abgelegenen Thema. Je seltener das Thema, desto weniger hat das Modell darüber gelernt und desto mehr füllt es selbst auf.
- Antworten, die sich ändern. Fragen Sie in einem neuen Chat erneut oder formulieren Sie um. Ändern sich die Fakten, ist mindestens eine Version falsch.
- Selbstbestätigung. Dasselbe Modell zu fragen „Ist das echt?“, beweist nichts, wie der Fall Mata gezeigt hat.
- Eine Zusammenfassung, die zu viel weiß. Jedes Detail, das Sie im zusammengefassten Dokument nicht finden.
Wie lassen sich KI-Halluzinationen verringern?
Sie verringern Halluzinationen, indem Sie dem Modell die nötigen Fakten geben, ihm erlauben abzulehnen, wenn es etwas nicht weiß, und seine Behauptungen vor der Verwendung prüfen. Teams kombinieren mehrere Schritte:
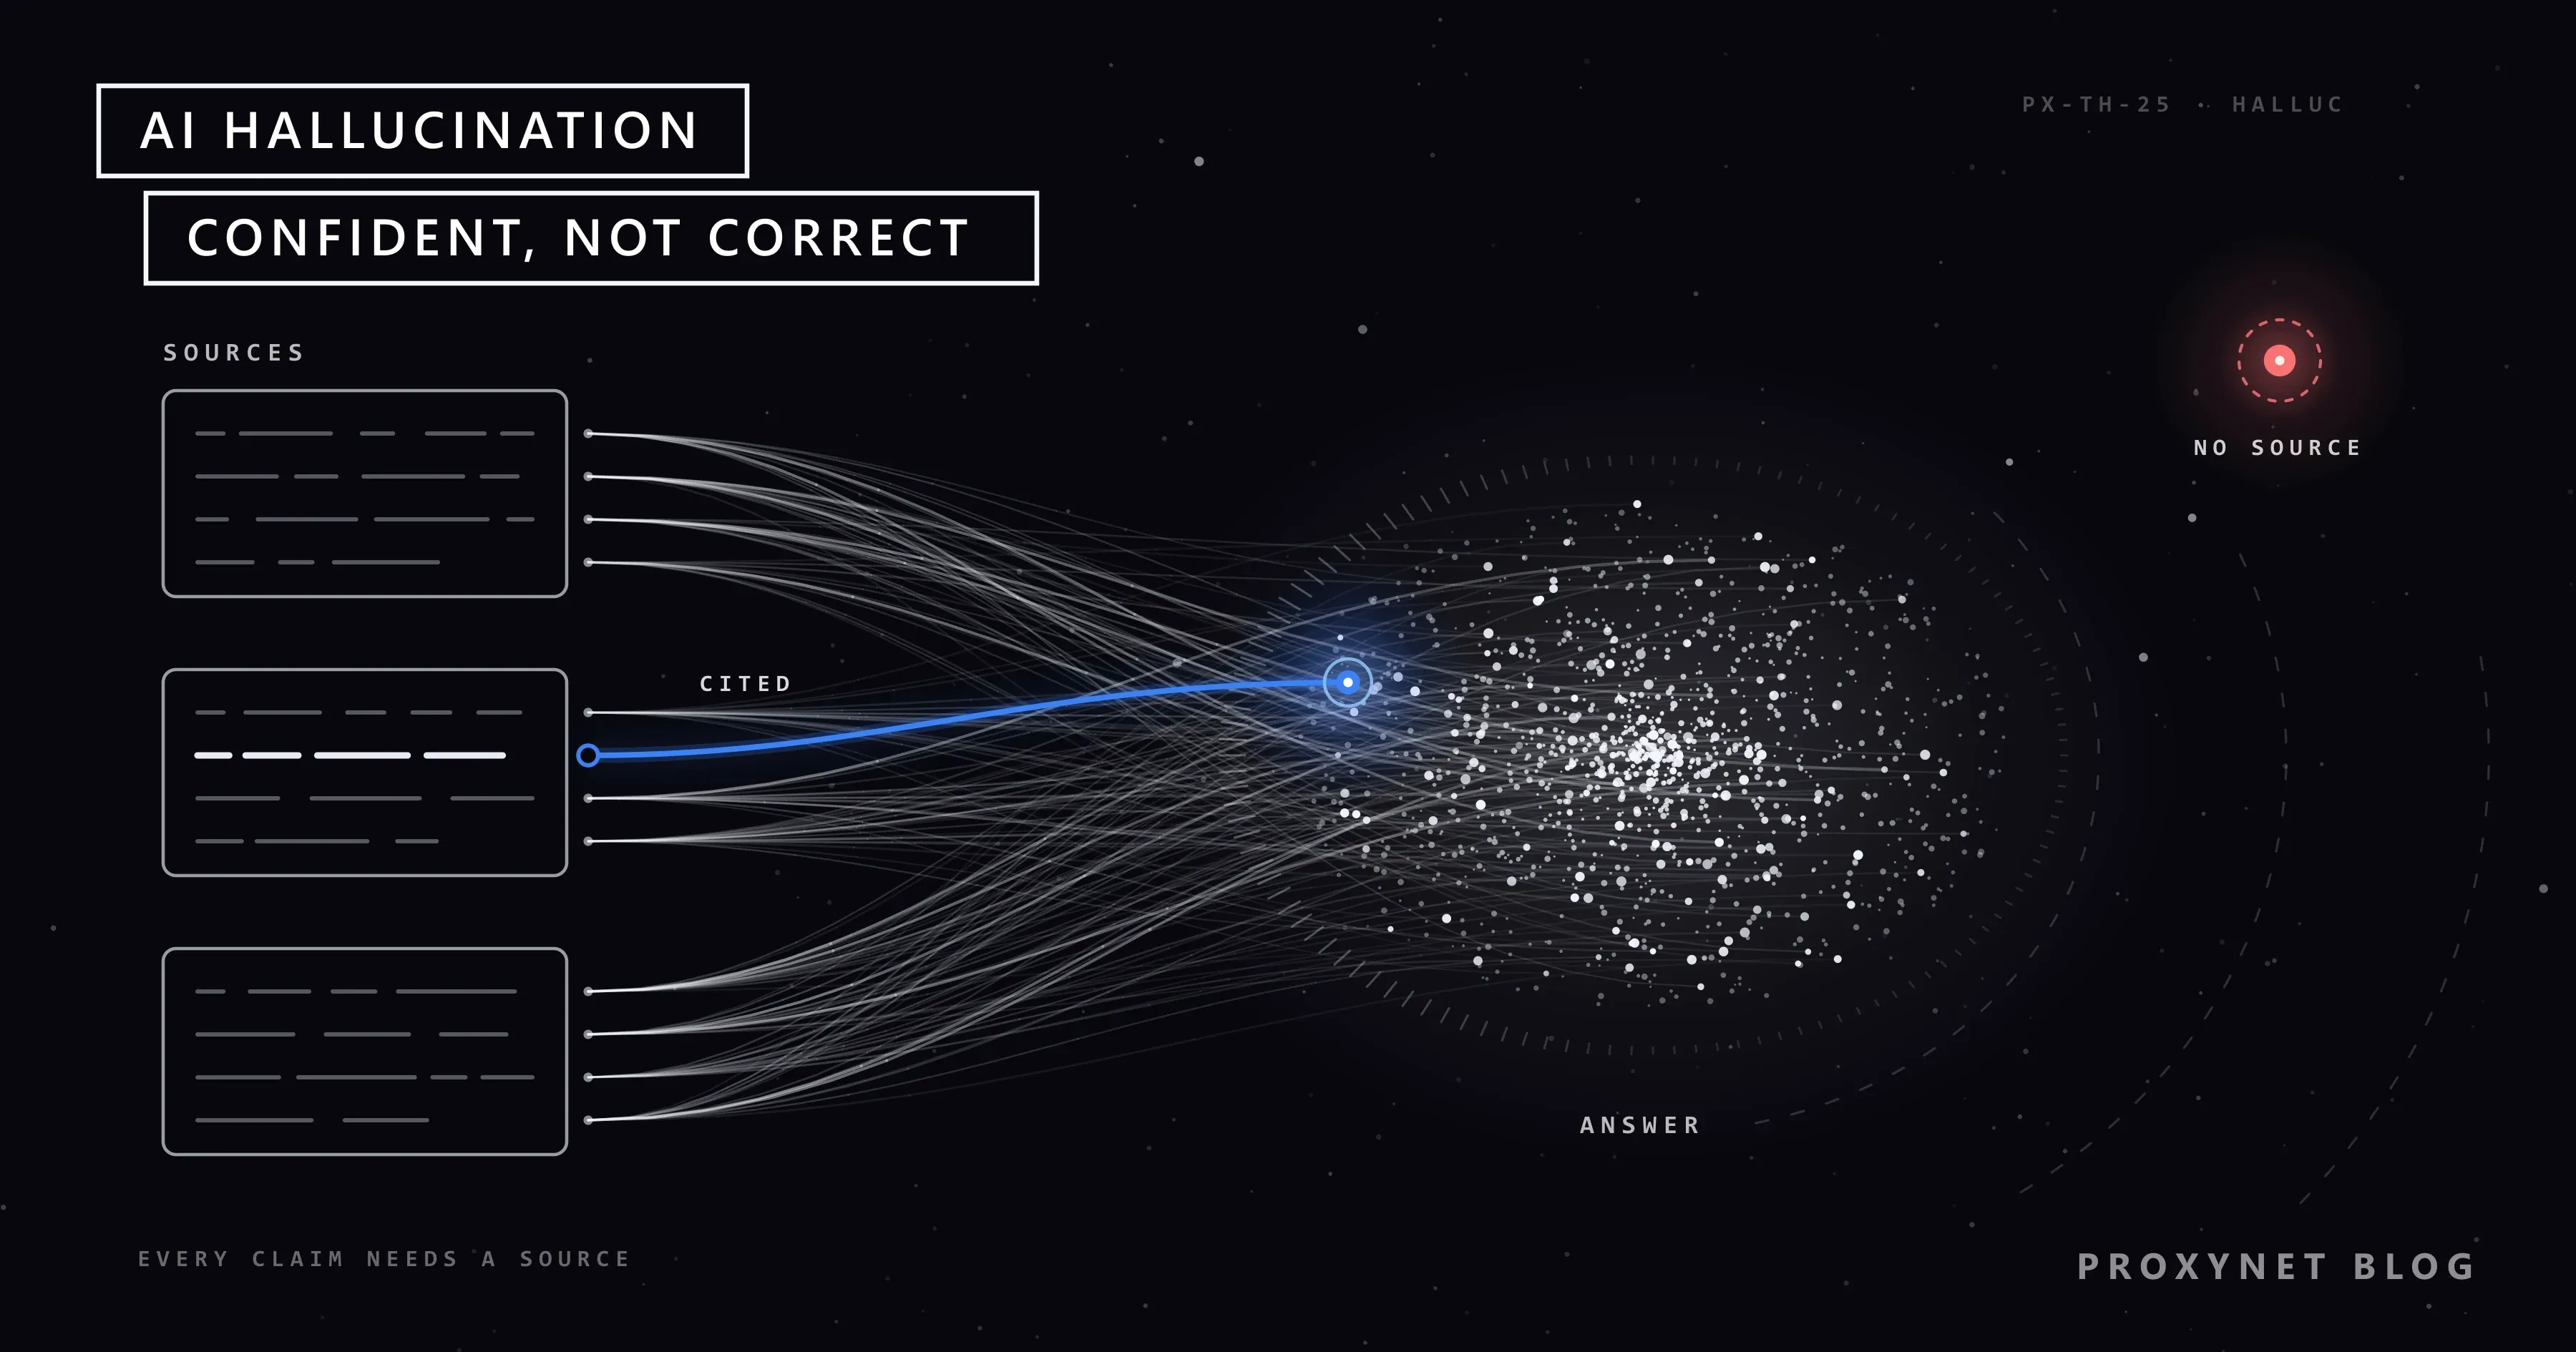
- Die Antwort in Quellen verankern. RAG (Retrieval-Augmented Generation, abrufgestützte Generierung) holt beim Eintreffen einer Frage passende Passagen aus einem Dokumentenindex und lässt das Modell auf dieser Grundlage antworten, mit einer Quellenangabe für jede Passage. Wie man Webseiten für einen solchen Index aufbereitet, erklärt Web Scraping für RAG: Von HTML zu sauberen Markdown-Chunks.
- Das Modell auf den gelieferten Text beschränken. Weisen Sie es an, nur aus den bereitgestellten Dokumenten zu antworten, zu sagen, wenn die Antwort dort nicht steht, und für jede Behauptung den Satz zu zitieren, auf dem sie beruht.
- „Ich weiß es nicht“ zulassen. Schreiben Sie ausdrücklich, dass Ablehnen besser ist als Raten. Die Autoren von OpenAI und Georgia Tech schlagen dasselbe für Benchmarks vor: Eine falsche Antwort sollte mehr kosten als gar keine.
- Nach Quellen fragen und sie dann öffnen. Auch angeforderte Quellenangaben können erfunden sein.
- Bei Faktenfragen den Zufall senken. Eine niedrige Temperatur macht Antworten einheitlicher, fügt aber kein Wissen hinzu; in der Paket-Studie verringerte eine Änderung der Dekodierungseinstellungen die erfundenen Namen nicht.
- Für Fakten und Zahlen Werkzeuge nutzen. Berechnungen, Datumsangaben und aktuelle Informationen sollten aus einem Taschenrechner, aus Code, einer Datenbank oder einer Suche kommen, nicht aus dem Gedächtnis des Modells.
- Den Kontext fokussiert halten. Senden Sie die relevanten Passagen statt eines ganzen Archivs und setzen Sie das Wichtigste an den Anfang oder das Ende des Prompts.
- Ausgaben mit hohem Risiko prüfen lassen. Juristische, medizinische und finanzielle Inhalte sowie alles, was an Kunden geht, brauchen einen Menschen, der jede Behauptung prüft; das NIST rät zu engerer Überwachung überall dort, wo KI-Ausgaben in folgenreiche Entscheidungen einfließen.
- Messen. Legen Sie 30 bis 50 Fragen mit bekannten Antworten aus Ihren eigenen Dokumenten an und zählen Sie nach jeder Änderung die falschen Antworten.
Was bedeutet Grounding und warum zählen die Quellen?
Eine in Quellen verankerte Antwort (grounded) ist eine Antwort, deren Behauptungen sich auf bestimmte Quellpassagen zurückführen lassen, die zum Zeitpunkt der Antwort bereitgestellt wurden; so lässt sich jede Aussage an dem Text prüfen, aus dem sie stammt. Grounding macht ein Modell nicht von selbst wahrheitsgetreu, es verlagert das Risiko in den Abruf (Retrieval). Liefert der Abruf die falsche Passage, eine veraltete Seite oder eine für einen anderen Markt geschriebene Seite, antwortet das Modell trotzdem selbstsicher auf dieser Grundlage.
Die Qualität des Abrufs ist die halbe Arbeit. Die meisten Retriever finden Passagen nach ihrer Bedeutung statt nach exakten Wörtern, wie Was ist semantische Suche? erklärt, und jede Passage sollte ihre URL und ihren Abrufzeitpunkt mitführen, damit Antworten sie zitieren können.
Der Standort ist der Teil, den Teams oft übersehen. Preise, Lagerbestand, Lieferbedingungen und lokale Regeln unterscheiden sich nach Land und Stadt, und viele Websites wählen die angezeigte Version anhand der IP-Adresse des Besuchers. Eine Pipeline, die jede Seite aus einem einzigen Rechenzentrum abruft, sieht nur eine Version und beantwortet die Fragen von Nutzern anderswo mit Angaben zu einem Markt, in dem sie gar nicht sind. Werden öffentliche Seiten so erhoben, wie ein lokaler Besucher sie sieht, etwa über einen Residential-Proxy mit Länder- und Städte-Targeting, passen Quelle und Markt des Nutzers zusammen. Erheben Sie nur öffentliche Seiten, beachten Sie robots.txt und die Nutzungsbedingungen der Website, halten Sie die Anfragerate niedrig und nutzen Sie eine offizielle API, wo es eine gibt.
Teams, die die Erhebung lieber nicht selbst betreiben, können mit unserem Vertriebsteam über die verwaltete Seitenextraktion unserer Web Scraping API sprechen.
Lassen sich KI-Halluzinationen ganz beseitigen?
Nein. Halluzinationen lassen sich seltener und leichter auffindbar machen, aber ein universelles Sprachmodell, das offene Fragen beantwortet, wird sie weiterhin erzeugen. Das NIST behandelt Konfabulation als Folge der Funktionsweise generativer Modelle, und das Paper von OpenAI und Georgia Tech argumentiert, dass auch gut trainierte Basismodelle weiterhin bestimmte Fehler machen werden; ein System vermeidet sie nur, indem es Fragen, deren Antwort es nicht kennt, gar nicht erst beantwortet.
Auch RAG beseitigt das Problem nicht. Die oben zitierte Übersichtsarbeit widmet seinen Grenzen einen eigenen Abschnitt: Der Retriever kann die richtige Passage verfehlen, und das Modell kann den Kontext trotzdem falsch lesen. Das realistische Ziel sind weniger Fehler, die leicht zu erkennen sind und abgefangen werden, bevor sie Schaden anrichten.
Wo begegnen Ihnen KI-Halluzinationen?
Sie begegnen ihnen überall, wo ein Modell Text schreibt, den jemand als Tatsache behandelt: in Chat-Assistenten, in KI-Zusammenfassungen über Suchergebnissen, in Coding-Assistenten, in Kundenservice-Bots und in Werkzeugen, die Verträge, Fachartikel oder Besprechungsprotokolle zusammenfassen.
Das Risiko wächst, wenn ein Modell nicht nur schreibt, sondern auch handelt. Ein KI-Agent, der bucht, kauft, Dateien bearbeitet oder Nachrichten verschickt, kann aus einer erfundenen Tatsache eine Handlung machen.
Häufige Fehler
- Flüssigen Text für richtig halten. Selbstsicherheit und Grammatik sind keine Belege.
- Das Modell sich selbst prüfen lassen. Nutzen Sie eine unabhängige Quelle.
- Einer Quellenangabe trauen, ohne sie zu öffnen. Gefälschte Verweise sehen genauso aus wie echte.
- Annehmen, mit RAG gebe es keine Halluzinationen. Der Abruf verringert sie und bringt eigene Fehlerquellen mit.
- Erwarten, dass eine niedrige Temperatur Fakten korrigiert. Sie verringert die Schwankung, nicht das Unwissen.
- Einen Bot für Kunden ohne Schutzmechanismen starten. Er braucht einen Weg für „weiß ich nicht“, Protokolle und eine Übergabe an einen Menschen.
- Ein Paket installieren, weil ein Assistent es genannt hat. Prüfen Sie zuerst die offizielle Registry.
Entscheidungshilfe
| Bedarf | Vorgehen |
|---|---|
| Eine schnelle allgemeine Frage | Jeden Fakt, den Sie weiterverwenden, in einer verlässlichen Quelle prüfen |
| Antworten zu Ihren eigenen Dokumenten | RAG mit Quellenangaben, Antworten nur aus dem Text |
| Ein Chatbot für Kunden | Aktuelle Richtlinienseiten, Ablehnungsweg, Protokolle, Übergabe an Menschen |
| Juristische, medizinische oder finanzielle Inhalte | Fachliche Prüfung jeder Behauptung und Quelle |
| Code von einem Assistenten | Jedes Paket in seiner Registry prüfen, Tests ausführen |
| Preise, Lagerbestand oder lokale Regeln | Aktuelle Seiten aus dem betreffenden Markt |
| Fortschritt messen | Ein fester Testsatz mit bekannten Antworten |
Häufige Fragen
Warum erfindet KI Dinge?
KI erfindet Dinge, weil ein Sprachmodell die plausibelste Fortsetzung eines Prompts erzeugt, und plausibel ist nicht dasselbe wie wahr. Enthielten seine Trainingsdaten wenig zu einem Thema, erzeugt es trotzdem eine Antwort, die wie die richtige aussieht. Benchmarks, die für „Ich weiß es nicht“ keine Punkte geben, bringen Modellen außerdem bei, dass sich Raten lohnt.
Lassen sich KI-Halluzinationen vollständig beheben?
Nein. Grounding, die Erlaubnis abzulehnen, Werkzeuge und menschliche Prüfung machen Halluzinationen seltener und leichter auffindbar, aber keine heutige Methode entfernt sie aus einem universellen Modell. Planen Sie Fehler ein und legen Sie fest, wo ein Mensch die Ausgabe prüfen muss.
Ist eine KI-Halluzination dasselbe wie eine Lüge?
Nein. Eine Lüge setzt die Absicht voraus zu täuschen, und ein Modell hat keine; es erzeugt wahrscheinlichen Text, ohne zu wissen, ob er stimmt. Die Wirkung auf den Leser kann dieselbe sein. Deshalb bleibt verantwortlich, wer eine KI-Antwort veröffentlicht, wie die Entscheidung zum Chatbot der Fluggesellschaft gezeigt hat.
Wie prüfe ich eine KI-Antwort?
Gleichen Sie die wichtigen Behauptungen mit einer Quelle ab, die Sie selbst öffnen können: der offiziellen Seite, dem Originaldokument, der Paket-Registry oder der Gerichtsakte. Öffnen Sie jeden Link, suchen Sie Zitate im genauen Wortlaut und fragen Sie in einem neuen Chat erneut, um zu sehen, ob die Fakten gleich bleiben. Lassen Sie nie dasselbe Modell allein über seine eigene Antwort urteilen.
Verhindert RAG Halluzinationen?
RAG verringert Halluzinationen, verhindert sie aber nicht. Es gibt dem Modell aktuellen, relevanten Text und lässt Leser die zitierten Passagen prüfen, doch der Retriever kann eine falsche oder veraltete Seite liefern, und das Modell kann das Gelieferte trotzdem falsch lesen. Quellenangaben und Stichproben bleiben nötig.
Warum erfinden KI-Werkzeuge Quellen?
KI-Werkzeuge erfinden Quellen, weil eine Quellenangabe ein Muster ist, das das Modell unzählige Male gesehen hat: Autoren, ein Titel, eine Zeitschrift, ein Jahr und ein Link. Es kann dieses Muster ohne echtes Dokument dahinter erzeugen und die Angabe nicht von sich aus nachschlagen. Werkzeuge, die echte Dokumente abrufen und zitieren, verringern das Problem; jede Quellenangabe zu öffnen lohnt sich trotzdem.
Fazit
Eine KI-Halluzination ist eine selbstsichere, flüssige Ausgabe, die falsch, erfunden oder nicht durch die Eingabe gedeckt ist. Sie folgt aus der Funktionsweise von Sprachmodellen: Sie sagen plausiblen Text vorher, lernen seltene Fakten schlecht, hören an einem Stichtag auf zu lernen und werden oft so trainiert, dass Raten belohnt wird. Die dokumentierten Fälle zeigen, dass für den Fehler bezahlt, wer die Antwort verwendet. Grounding in aktuellen Quellen, die Erlaubnis zu „Ich weiß es nicht“, Werkzeuge für Fakten und menschliche Prüfung machen Fehler seltener und leichter auffindbar. Wo Antworten von Preisen, Lagerbeständen oder Regeln abhängen, die sich je nach Ort unterscheiden, müssen die Quellen aus dem Markt des Nutzers stammen.