Bir destek sohbet botu müşteriye indirimin seyahatten sonra da istenebileceğini söylüyor; oysa şirketin kendi politika sayfası bunun mümkün olmadığını yazıyor. Bir kodlama asistanı hiç yayımlanmamış bir kütüphaneyi kurmayı öneriyor. Bir avukat, hiçbir mahkemenin vermediği kararlardan alıntı yapan bir dilekçe sunuyor. Cevapların hepsi akıcı ve ayrıntılı, hiçbirinde en ufak bir tereddüt yok; hepsi de yanlış. Yapay zekâ alanında bu hatanın bir adı var: halüsinasyon.
Bu yazıda yapay zekâ halüsinasyonunun ne olduğunu, dil modellerinin neden halüsinasyon ürettiğini, başlıca türlerini, belgelenmiş vakaları, bir halüsinasyonu nasıl fark edeceğinizi, grounding (kaynağa dayandırma) ve doğrulamayla nasıl azaltılacağını ve neden tamamen ortadan kaldırılamadığını anlatıyoruz.
Yapay zekâ halüsinasyonu nedir?
Yapay zekâ halüsinasyonu, bir yapay zekâ modelinin gerçekmiş gibi sunduğu ama yanlış, uydurma ya da girdisiyle desteklenmeyen içeriktir. Terim psikolojiden ödünç alınmış bir benzetmedir; yapay zekâ gerçekten halüsinasyon görmez, bir şey görüp duymaz. Model metin üretir ve bu metnin bir kısmı gerçeğe ya da kendisine sorulan belgeye uymaz.
ABD'nin standartlar enstitüsü NIST başka bir sözcüğü tercih eder. Üretken Yapay Zekâ Profili (NIST AI 600-1) bu riske konfabulasyon (confabulation) der ve onu kendinden emin biçimde ifade edilen ama hatalı ya da yanlış içerik üretimi olarak tanımlar; gündelik dilde halüsinasyon ya da uydurma (fabrication) dendiğini de not eder. Tanım, prompt'tan sapan ya da modelin aynı konuşmada daha önce söyledikleriyle çelişen çıktıları da kapsar.
Dar anlamda iki şey halüsinasyon sayılmaz: sizin verdiğiniz belgede zaten bulunan bir hatayı tekrarlamak (bu bir kaynak sorunudur) ve bir öyküde ya da görselde uydurmak (orada uydurmak işin kendisidir). Halüsinasyon, okur bilgi beklediğinde sorun olur.
Yapay zekâ neden halüsinasyon görür?
Yapay zekâ modelleri halüsinasyon üretir, çünkü dil modeli metni denetlemek için değil, olası metni tahmin etmek için eğitilir: öğrendiği örüntülere en çok uyan sonraki kelime parçasını (token) seçer, sonra bir sonrakini. Büyük dil modellerinin (LLM) nasıl çalıştığını anlattığımız yazı bu döngüyü adım adım açıklıyor. Döngünün hiçbir yerinde bir bilgiye bakılmaz; bu yüzden makul görünen yanlış bir cümle ile makul görünen doğru bir cümle aynı süreçten çıkar.
Araştırmacılar ve standart kuruluşları aynı nedenleri sayar:
- Tahmin, makul görüneni ödüllendirir. NIST, konfabulasyonu üretken modellerin tasarımının doğal bir sonucu olarak görür: bu modeller eğitim verilerindeki istatistiksel örüntüleri yaklaşık olarak yeniden üretir ve doğru gibi duran metin, doğru olsun olmasın yüksek puan alır.
- Verideki nadir ya da yanlış bilgiler. Eğitim verisinde defalarca geçen bir bilgi genellikle doğru tekrarlanır; yalnızca bir iki kez geçen bilgi ise çoğu zaman doğru tekrarlanmaz, verideki hatalar da akıcı biçimde yinelenir. OpenAI ve Georgia Tech araştırmacıları Why Language Models Hallucinate (Dil Modelleri Neden Halüsinasyon Görür) makalesinde, bir kişinin doğum günü gibi arkasında hiçbir örüntü olmayan rastgele bilgilerde temel bir modelin bazı hatalarının istatistiksel olarak kaçınılmaz olduğunu savunur.
- Eğitim ve testler tahmini ödüllendirir. Aynı makale, kıyaslama testlerinin (benchmark) çoğunun cevapları yalnızca doğru ya da yanlış diye puanladığını hatırlatır: "bilmiyorum" hiç puan getirmez, tahmin ise bazen bir puan getirir. Bu testlere göre ayarlanan bir model tahmin yürütmeyi öğrenir.
- Eğitim verisinin bir bitiş tarihi vardır. Model, bilgi kesim tarihinden (knowledge cutoff) sonrasını bilmez; daha sonraki bir olayı, fiyatı ya da kuralı eski örüntülerden cevaplayabilir.
- Belirsiz prompt'lar ve yanlış öncüller. Bir ürünün hiç kazanmadığı bir ödülü neden kazandığını sormak, o öncüle dayanan bir cevabı davet eder. Tercih ayarı (preference tuning) da bir modeli kullanıcıya fazla hak vermeye yatkın hâle getirebilir; araştırmacılar buna dalkavukluk (sycophancy) diyor.
- Uzun ya da gürültülü bağlam. "Lost in the Middle" (Liu ve arkadaşları, 2023) çalışmasında modeller, ilgili pasaj uzun bir girdinin başında ya da sonunda olduğunda en iyi, ortasında olduğunda daha kötü cevap verdi.
- Kod çözme (decoding) ayarları. Çoğu araç her seferinde en olası kelimeyi seçmek yerine tahmin edilen olasılıklardan örnekleme yapar; genellikle sıcaklık (temperature) denen rastgelelik ayarı yükseldikçe olasılığı düşük kelimeler ve iddialar daha sık çıkar.
Yapay zekâ halüsinasyonunun türleri nelerdir?
Yapay zekâ halüsinasyonları iki geniş gruba ayrılır: gerçek dünyadaki bilgilerle çelişen cevaplar ve talimatlara ya da modele verilen metne uymayan cevaplar. Huang ve arkadaşlarının 2023 tarihli büyük dil modellerinde halüsinasyon derlemesi bunlara olgusal doğruluk (factuality) ve sadakat (faithfulness) halüsinasyonları der. Metin üretimi üzerine daha eski çalışmalar ise içsel (intrinsic: çıktı kaynakla çelişir) ve dışsal (extrinsic: çıktı, kaynağın doğrulayamayacağı bir şey ekler) terimlerini kullanıyordu.
Uygulamada türler şöyle görünür (örnekler uydurmadır):
| Tür | Nasıl görünür? | Örnek |
|---|---|---|
| Bilgi hatası | Yanlış tarih, rakam ya da ad | "A Markası 2009'da kuruldu"; sitesi 2012 diyor |
| Uydurma kaynak | Var olmayan kaynak, alıntı, link ya da dava | Yazarları gerçekçi görünen bir çalışma ve açılmayan bir link |
| Uydurma paket | Kimsenin yayımlamadığı bir kütüphane | Bilinmeyen bir ad için kurulum komutu |
| Kaynakla çelişki | Belgeyi tersine çeviren özet | "30 gün içinde iade"; politika 14 gün diyor |
| Kaynağa ekleme | Belgede hiç geçmeyen ayrıntılar | Haberde olmayan bir CEO alıntısı |
| Kendi kendisiyle çelişki | Önceki cevapla çatışma | Aynı sohbette iki farklı toplam |
Uydurma kaynaklar ikna edicidir, çünkü bir kaynak gösterimi (yazarlar, başlık, dergi, yıl, DOI) bir örüntüdür ve model bu örüntüyü arkasında hiçbir makale olmadan üretebilir. Kodda da durum aynı: kod üreten modeller üzerine Python ve JavaScript'te yapılan ve 2025 USENIX Security Symposium'a kabul edilen 2024 tarihli bir çalışma, modellerin var olmayan paketler önerdiğini ve uydurdukları adların birçoğunu tekrar tekrar ürettiğini gösterdi. Bir saldırgan böyle bir adla zararlı bir paket yayımlayıp birinin onu kurmasını bekleyebilir.
Yapay zekâ halüsinasyonuna gerçek örnekler nelerdir?
En iyi belgelenmiş vakalar mahkemelerden ve uyuşmazlık kurullarından gelir; kararları neyin söylendiğini ve bunun neye mal olduğunu kayda geçirir.
ABD'de bir mahkemede uydurma içtihat. Mata v. Avianca davasında New York'taki bir federal mahkeme, 22 Haziran 2023'te iki avukatı ve bürolarını, ChatGPT'nin ürettiği sahte alıntı ve atıflar içeren, var olmayan mahkeme kararları sundukları için yaptırıma bağladı. Avukatlardan biri sohbet botuna davalardan birinin gerçek olup olmadığını sorduğunda bot gerçek olduğunu ve hukuk veritabanlarında bulunabileceğini söyledi. Mahkeme, güvenilir bir yapay zekâ aracından yardım almanın kendi başına uygunsuz olmadığını, ama avukatların sundukları belgeleri kontrol etmek zorunda olduğunu yazdı. 5.000 ABD doları para cezasına hükmetti; müvekkile ve sahte kararların yazarı olarak adı geçen her hâkime mektup gönderilmesini emretti.
Bir sohbet botunun yanlış politika cevabı. Moffatt v. Air Canada (2024 BCCRT 149) kararına konu olan olayda bir havayolunun web sitesindeki sohbet botu, bir yolcuya indirimli taziye (bereavement) tarifesinin bilet düzenlendikten sonraki 90 gün içinde istenebileceğini söyledi; havayolunun kendi politika sayfası ise tarifenin seyahat tamamlandıktan sonra uygulanmadığını yazıyordu. Kanada'nın British Columbia eyaletindeki uyuşmazlık çözüm kurulu Civil Resolution Tribunal, 14 Şubat 2024'te havayolunun sohbet botundan sorumlu olmadığı savunmasını reddetti, şirketi web sitesindeki bütün bilgilerden sorumlu tuttu ve 812,02 Kanada doları ödemesine karar verdi. Kararda sohbet botunun hangi teknolojiyle çalıştığı yazmıyor; dersi şu: otomatik bir cevap da şirketin cevabıdır.
Her seferinde emin, her seferinde farklı. OpenAI ve Georgia Tech makalesinde yazarlar, üç popüler sohbet modeline yazarlardan birinin doktora tezinin başlığını sordu. Her model farklı bir başlık ve yıl verdi; hiçbiri doğru değildi.
Yapay zekâ halüsinasyonu nasıl fark edilir?
Bir halüsinasyonu, cevaptaki belirli iddiaları açıp okuyabileceğiniz bir kaynakla karşılaştırarak fark edersiniz; cevabın tonu size hiçbir şey söylemez. Şu işaretler ikinci bir bakışı hak eder:
- Kaynaksız kesin ayrıntılar. Link ya da kaynak gösterilmeden verilen kesin rakamlar, tarihler, alıntılar ya da dava numaraları.
- Açılmayan kaynaklar. Hata veren bir link, hiçbir yere çıkmayan bir DOI, alıntılanan metinde bulamadığınız bir alıntı.
- Az bilinen bir konuda bol ayrıntı. Konu ne kadar nadirse model onun hakkında o kadar az şey öğrenmiştir ve boşluğu o kadar çok doldurur.
- Değişen cevaplar. Soruyu yeni bir sohbette tekrarlayın ya da farklı sözcüklerle sorun. Bilgiler değişiyorsa sürümlerden en az biri yanlıştır.
- Kendi kendini onaylama. Aynı modele "Bu gerçek mi?" diye sormak hiçbir şey kanıtlamaz; Mata davası bunu gösterdi.
- Fazla şey bilen özet. Özetlenen belgede bulamadığınız her ayrıntı.
Yapay zekâ halüsinasyonları nasıl azaltılır?
Halüsinasyonları azaltmanın yolu, modele ihtiyaç duyduğu bilgileri vermek, bilmediğinde cevap vermemesine izin vermek ve iddialarını kullanmadan önce kontrol etmektir. Ekipler birkaç adımı birlikte uygular:
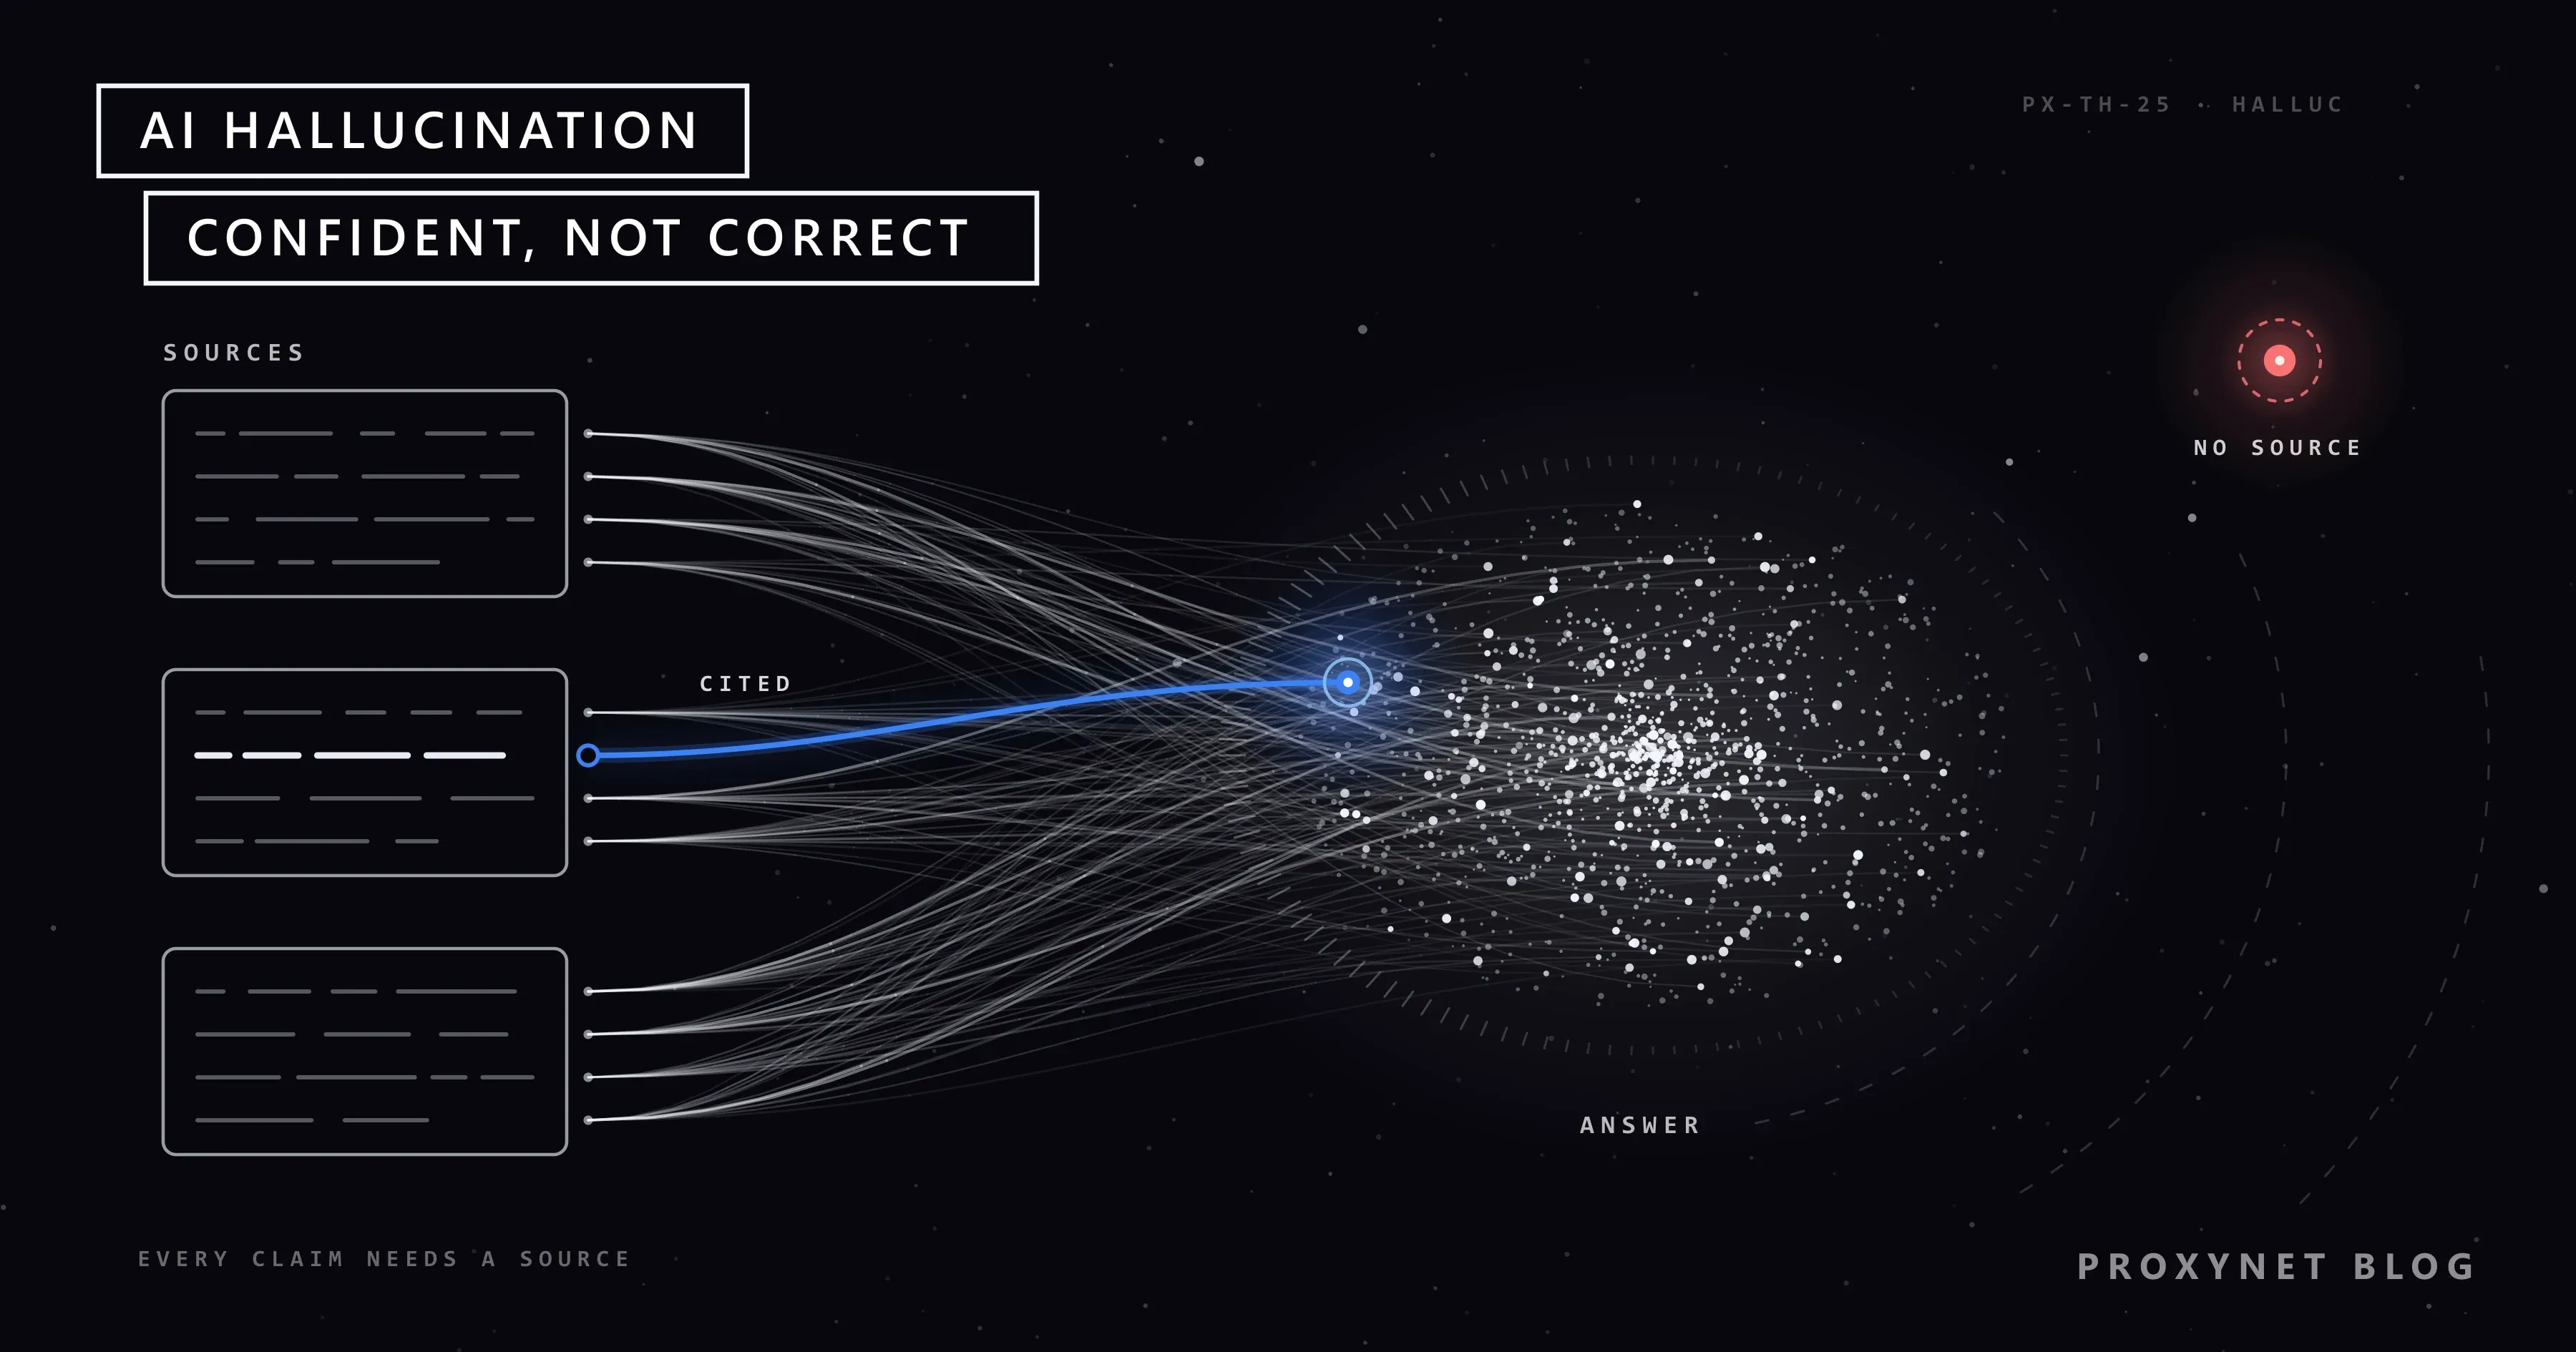
- Cevabı kaynaklara dayandırın. RAG (getirmeyle zenginleştirilmiş üretim), bir soru geldiğinde belge dizininden ilgili pasajları getirir ve modelin cevabı bu pasajlardan, her birine kaynak göstererek yazmasını sağlar. Web sayfalarını böyle bir dizine hazırlamayı RAG Nedir? Web Verisini Temiz Markdown Parçalarına Çevirme yazısında anlattık.
- Modeli verilen metinle sınırlayın. Yalnızca sağlanan belgelerden cevap vermesini, cevap orada yoksa bunu söylemesini ve her iddiasının dayandığı cümleyi alıntılamasını isteyin.
- "Bilmiyorum" demeyi kabul edilebilir kılın. Tahmin yürütmektense cevap vermemenin daha iyi olduğunu açıkça yazın. OpenAI ve Georgia Tech yazarları kıyaslama testleri için de aynısını önerir: yanlış bir cevap, hiç cevap vermemekten daha pahalıya mal olmalı.
- Kaynak isteyin, sonra açın. İstenen kaynaklar da uydurulabilir.
- Bilgi gerektiren işlerde rastgeleliği düşürün. Düşük sıcaklık cevapları daha tutarlı yapar ama modele bilgi eklemez; paket çalışmasında kod çözme ayarlarını değiştirmek uydurma adları azaltmadı.
- Bilgi ve rakamlar için araç kullanın. Hesaplar, tarihler ve güncel bilgiler modelin hafızasından değil; bir hesap makinesinden, koddan, bir veritabanından ya da bir aramadan gelmeli.
- Bağlamı odaklı tutun. Bütün arşivi değil ilgili pasajları gönderin; asıl malzemeyi prompt'un başına ya da sonuna yakın koyun.
- Yüksek riskli çıktıyı inceletin. Hukuki, tıbbi ve finansal içerik ile müşteriye giden her metin, her iddiayı kontrol eden bir insana ihtiyaç duyar; NIST de yapay zekâ çıktısının sonuç doğuran kararlara girdiği her yerde daha yakın izleme önerir.
- Ölçün. Kendi belgelerinizden cevabını bildiğiniz 30 ila 50 soru hazırlayın ve her değişiklikten sonra yanlış cevapları sayın.
Grounding (kaynağa dayandırma) ne demek, kaynaklar neden önemli?
Kaynağa dayanan (grounded) bir cevap, iddiaları cevap anında verilen belirli kaynak pasajlarına kadar izlenebilen cevaptır; böylece her ifade geldiği metinle karşılaştırılabilir. Kaynağa dayandırma, modeli kendiliğinden doğruyu söyleyen bir modele dönüştürmez; riski getirme (retrieval) adımına taşır. Getirme adımı yanlış pasajı, güncelliğini yitirmiş bir sayfayı ya da başka bir pazar için yazılmış bir sayfayı getirirse model ondan kendinden emin bir cevap üretir.
İşin yarısı getirme kalitesidir. Getirme sistemlerinin çoğu pasajları birebir kelimelerle değil anlamla bulur; bunu Semantik Arama Nedir? Anahtar Kelime Aramasından Farkı yazısında anlattık. Her pasaj ayrıca URL'sini ve getirilme zamanını taşımalı ki cevaplar ona kaynak gösterebilsin.
Ekiplerin en sık atladığı kısım konumdur. Fiyatlar, stok, teslimat koşulları ve yerel kurallar ülkeye ve şehre göre değişir; birçok site de hangi sürümü göstereceğine ziyaretçinin IP adresine bakarak karar verir. Bütün sayfaları tek bir veri merkezinden getiren bir veri hattı tek bir sürüm görür ve başka yerlerdeki kullanıcılara, içinde bulunmadıkları bir pazar hakkında cevap verir. Herkese açık sayfaları yerel bir ziyaretçinin gördüğü hâliyle toplamak, örneğin ülke ve şehir hedeflemeli Residential Proxy ile, kaynağı kullanıcının pazarıyla aynı hizada tutar. Yalnızca herkese açık sayfaları toplayın, robots.txt'ye ve sitenin kullanım şartlarına uyun, istek hızını düşük tutun ve varsa resmî API'yi kullanın.
Toplama işini kendiniz yürütmek istemiyorsanız Web Scraping API'miz üzerinden sunduğumuz yönetilen sayfa çıkarma hizmeti için satış ekibimizle görüşebilirsiniz.
Yapay zekâ halüsinasyonları tamamen önlenebilir mi?
Hayır. Halüsinasyonlar seyrekleştirilebilir ve daha kolay yakalanır hâle getirilebilir; ama açık uçlu soruları cevaplayan genel amaçlı bir dil modeli yine de halüsinasyon üretir. NIST konfabulasyonu üretken modellerin çalışma biçiminin bir sonucu olarak ele alır; OpenAI ve Georgia Tech makalesi de iyi eğitilmiş temel modellerin bazı hataları yine yapacağını savunur. Bir sistem bu hatalardan ancak bilmediği soruyu cevaplamayı reddederek kaçınabilir.
RAG da sorunu ortadan kaldırmaz. Yukarıda andığımız derleme, RAG'in sınırlarına ayrı bir bölüm ayırır: getirme adımı doğru pasajı kaçırabilir, model de verilen bağlamı yanlış okuyabilir. Gerçekçi hedef daha az hata, kolay fark edilen hatalar ve zarar vermeden önce yakalanan hatalardır.
Yapay zekâ halüsinasyonlarıyla nerelerde karşılaşırsınız?
Bir modelin yazdığı metnin birileri tarafından bilgi olarak kabul edildiği her yerde karşılaşırsınız: sohbet asistanlarında, arama sonuçlarının üstündeki yapay zekâ özetlerinde, kodlama asistanlarında, müşteri hizmetleri botlarında ve sözleşmeleri, makaleleri ya da toplantı kayıtlarını özetleyen araçlarda.
Model yalnızca yazmakla kalmayıp iş de yaptığında risk büyür. Rezervasyon yapan, satın alan, dosya düzenleyen ya da mesaj gönderen bir yapay zekâ ajanı, uydurulmuş bir bilgiyi bir eyleme dönüştürebilir.
Sık yapılan hatalar
- Akıcı metni doğru saymak. Özgüven ve düzgün dil kanıt değildir.
- Modelden kendini doğrulamasını istemek. Bağımsız bir kaynak kullanın.
- Bir kaynağı açmadan ona güvenmek. Sahte kaynaklar gerçekleriyle tıpatıp aynı görünür.
- RAG varsa halüsinasyon olmaz sanmak. Getirme halüsinasyonları azaltır ama kendi hata noktalarını da ekler.
- Düşük sıcaklığın bilgileri düzelteceğini beklemek. Değişkenliği azaltır, bilgisizliği değil.
- Müşteriye açık bir botu güvencesiz yayına almak. Bot "bilmiyorum" diyebilmeli, kayıt tutmalı ve gerektiğinde konuşmayı bir insana devredebilmeli.
- Bir asistan adını verdi diye paket kurmak. Önce resmî paket deposunu (registry) kontrol edin.
Karar rehberi
| İhtiyaç | Ne yapmalı? |
|---|---|
| Hızlı, genel bir soru | Yeniden kullanacağınız her bilgiyi güvenilir bir kaynakta doğrulayın |
| Kendi belgeleriniz hakkında cevaplar | Kaynak gösteren RAG, yalnızca metinden cevap |
| Müşteriye açık bir sohbet botu | Güncel politika sayfaları, cevap vermeme yolu, kayıt, insana devir |
| Hukuki, tıbbi ya da finansal içerik | Her iddianın ve kaynağın uzman incelemesi |
| Asistanın yazdığı kod | Her paketi kendi deposunda kontrol edin, testleri çalıştırın |
| Fiyatlar, stok ya da yerel kurallar | İlgili pazardan getirilmiş güncel sayfalar |
| İlerlemeyi takip etmek | Cevabı bilinen sabit bir test seti |
Sıkça sorulan sorular
Yapay zekâ neden bilgi uydurur?
Yapay zekâ bilgi uydurur, çünkü dil modeli bir prompt'un en makul devamını üretir ve makul olan her zaman doğru değildir. Eğitim verisinde bir konu hakkında çok az şey olsa bile model doğru cevaba benzeyen bir cevap üretir. "Bilmiyorum" cevabına puan vermeyen kıyaslama testleri de modellere tahmin yürütmenin kazandırdığını öğretir.
Yapay zekâ halüsinasyonları tamamen düzeltilebilir mi?
Hayır. Kaynağa dayandırma, cevap vermeme izni, araçlar ve insan incelemesi halüsinasyonları seyrekleştirir ve yakalanmalarını kolaylaştırır; ama bugünkü yöntemlerin hiçbiri genel amaçlı bir modelden onları tamamen silemez. Hatayı hesaba katın ve çıktıyı nerede bir insanın kontrol edeceğine karar verin.
Yapay zekâ halüsinasyonu yalan söylemekle aynı şey mi?
Hayır. Yalan aldatma niyeti gerektirir, modelin ise niyeti yoktur; doğru olup olmadığını bilmeden olası metin üretir. Okur üzerindeki etkisi aynı olabilir; bu yüzden yapay zekâ cevabını yayımlayan kişi ya da şirket ondan sorumlu kalır, havayolu sohbet botu kararı da bunu gösterdi.
Bir yapay zekâ cevabını nasıl kontrol ederim?
Önemli iddiaları kendiniz açıp okuyabileceğiniz bir kaynakla karşılaştırın: resmî sayfa, özgün belge, paket deposu ya da mahkeme kaydı. Her linki açın, alıntıları kelimesi kelimesine arayın ve bilgilerin değişip değişmediğini görmek için soruyu yeni bir sohbette tekrar sorun. Bir modeli asla kendi cevabının tek yargıcı yapmayın.
RAG halüsinasyonları durdurur mu?
RAG halüsinasyonları azaltır ama durdurmaz. Modele güncel ve ilgili metin verir, okurun da gösterilen pasajları kontrol etmesini sağlar; ama getirme adımı yanlış ya da eskimiş bir sayfa getirebilir, model de kendisine verileni yanlış okuyabilir. Kaynak göstermek ve rastgele seçilen cevapları kontrol etmek yine gereklidir.
Yapay zekâ araçları neden kaynak uydurur?
Yapay zekâ araçları kaynak uydurur, çünkü bir kaynak gösterimi modelin sayısız kez gördüğü bir örüntüdür: yazarlar, başlık, dergi, yıl ve link. Model bu örüntüyü arkasında gerçek bir belge olmadan üretebilir ve kaynağı kendi başına arayıp bulamaz. Gerçek belgeleri getirip onlara kaynak gösteren araçlar sorunu azaltır; yine de her kaynak açıp bakmaya değer.
Özet
Yapay zekâ halüsinasyonu, kendinden emin ve akıcı ama yanlış, uydurma ya da girdiyle desteklenmeyen çıktıdır. Dil modellerinin çalışma biçiminden doğar: makul metni tahmin ederler, nadir bilgileri zayıf öğrenirler, belli bir tarihte öğrenmeyi bırakırlar ve çoğu zaman tahmin yürütmeyi ödüllendiren yöntemlerle eğitilirler. Belgelenmiş vakalar, hatanın bedelini cevabı kullananın ödediğini gösteriyor. Güncel kaynaklara dayandırma, "bilmiyorum" deme izni, bilgiler için araçlar ve insan incelemesi hataları seyrekleştirir ve yakalanmalarını kolaylaştırır. Cevaplar yere göre değişen fiyatlara, stoğa ya da kurallara dayanıyorsa kaynaklar da kullanıcının pazarından gelmelidir.