Ein Pricing-Team möchte jeden Morgen die Preise von 300 Produkten aus 40 Onlineshops abrufen, und zwar so, wie Käufer in fünf Ländern sie sehen. Die Hälfte der Shops baut ihre Seiten mit JavaScript auf, und jeder ordnet sein HTML anders an. Das Team kann die Scraper selbst bauen und betreiben oder jede Produkt-URL an eine Web-Scraping-API schicken und die Felder als JSON zurückbekommen.
Dieser Beitrag erklärt, wie eine Web-Scraping-API funktioniert und welche Arbeit sie Ihnen abnimmt. Er vergleicht sie mit vier anderen Wegen zu Webdaten, behandelt Arten, Preismodelle und die rechtliche Seite und endet mit der Frage, die sich jeder Käufer stellt: Scraping-API oder eigene Proxys?
Was ist eine Web-Scraping-API?
Eine Web-Scraping-API ist ein HTTP-Dienst, der eine Webseite in Ihrem Auftrag abruft und ihren Inhalt in einer Form zurückgibt, die Ihr Programm verarbeiten kann. Sie rufen sie auf wie jede andere API, doch die Daten stammen aus dem Scraping einer Seite, deren Betreiber sie nie als API angeboten hat. Verkauft wird sie auch als Scraper-API oder Web-Scraping-Dienst.
Der Beitrag Was ist Web Scraping und wie funktioniert es? erklärt Web Scraping selbst: ein Programm, das Seiten herunterlädt und Werte aus dem HTML herausliest. Eine Scraping-API erledigt dieselbe Arbeit. Der Unterschied liegt darin, wer die Technik betreibt.
Wie sieht eine Anfrage aus?
Der Endpunkt api.example.com und die Feldnamen unten sind zur Veranschaulichung erfunden; jeder Anbieter benennt seine Optionen anders, der Aufbau ist aber ähnlich.
curl -s https://api.example.com/v1/scrape \
  -H "Authorization: Bearer $API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"url": "https://shop.example.com/p/1234", "country": "de", "render": false, "output": "json"}'
An einen lokalen Nachbau (Mock) derselben erfundenen API geschickt, lieferte die Anfrage diese Antwort:
{
  "url": "https://shop.example.com/p/1234",
  "target_status": 200,
  "country": "de",
  "rendered": false,
  "attempts": 2,
  "data": {
    "name": "Desk lamp",
    "price": "24.90",
    "currency": "EUR",
    "in_stock": true
  }
}
target_status ist der Statuscode des Shops, attempts zeigt, dass der Dienst zwei Versuche brauchte, und data enthält die Felder, die sein Parser herausgelesen hat. Mit "output": "html" erhalten Sie die Seite selbst und parsen sie bei sich.
Wie funktioniert eine Web-Scraping-API?
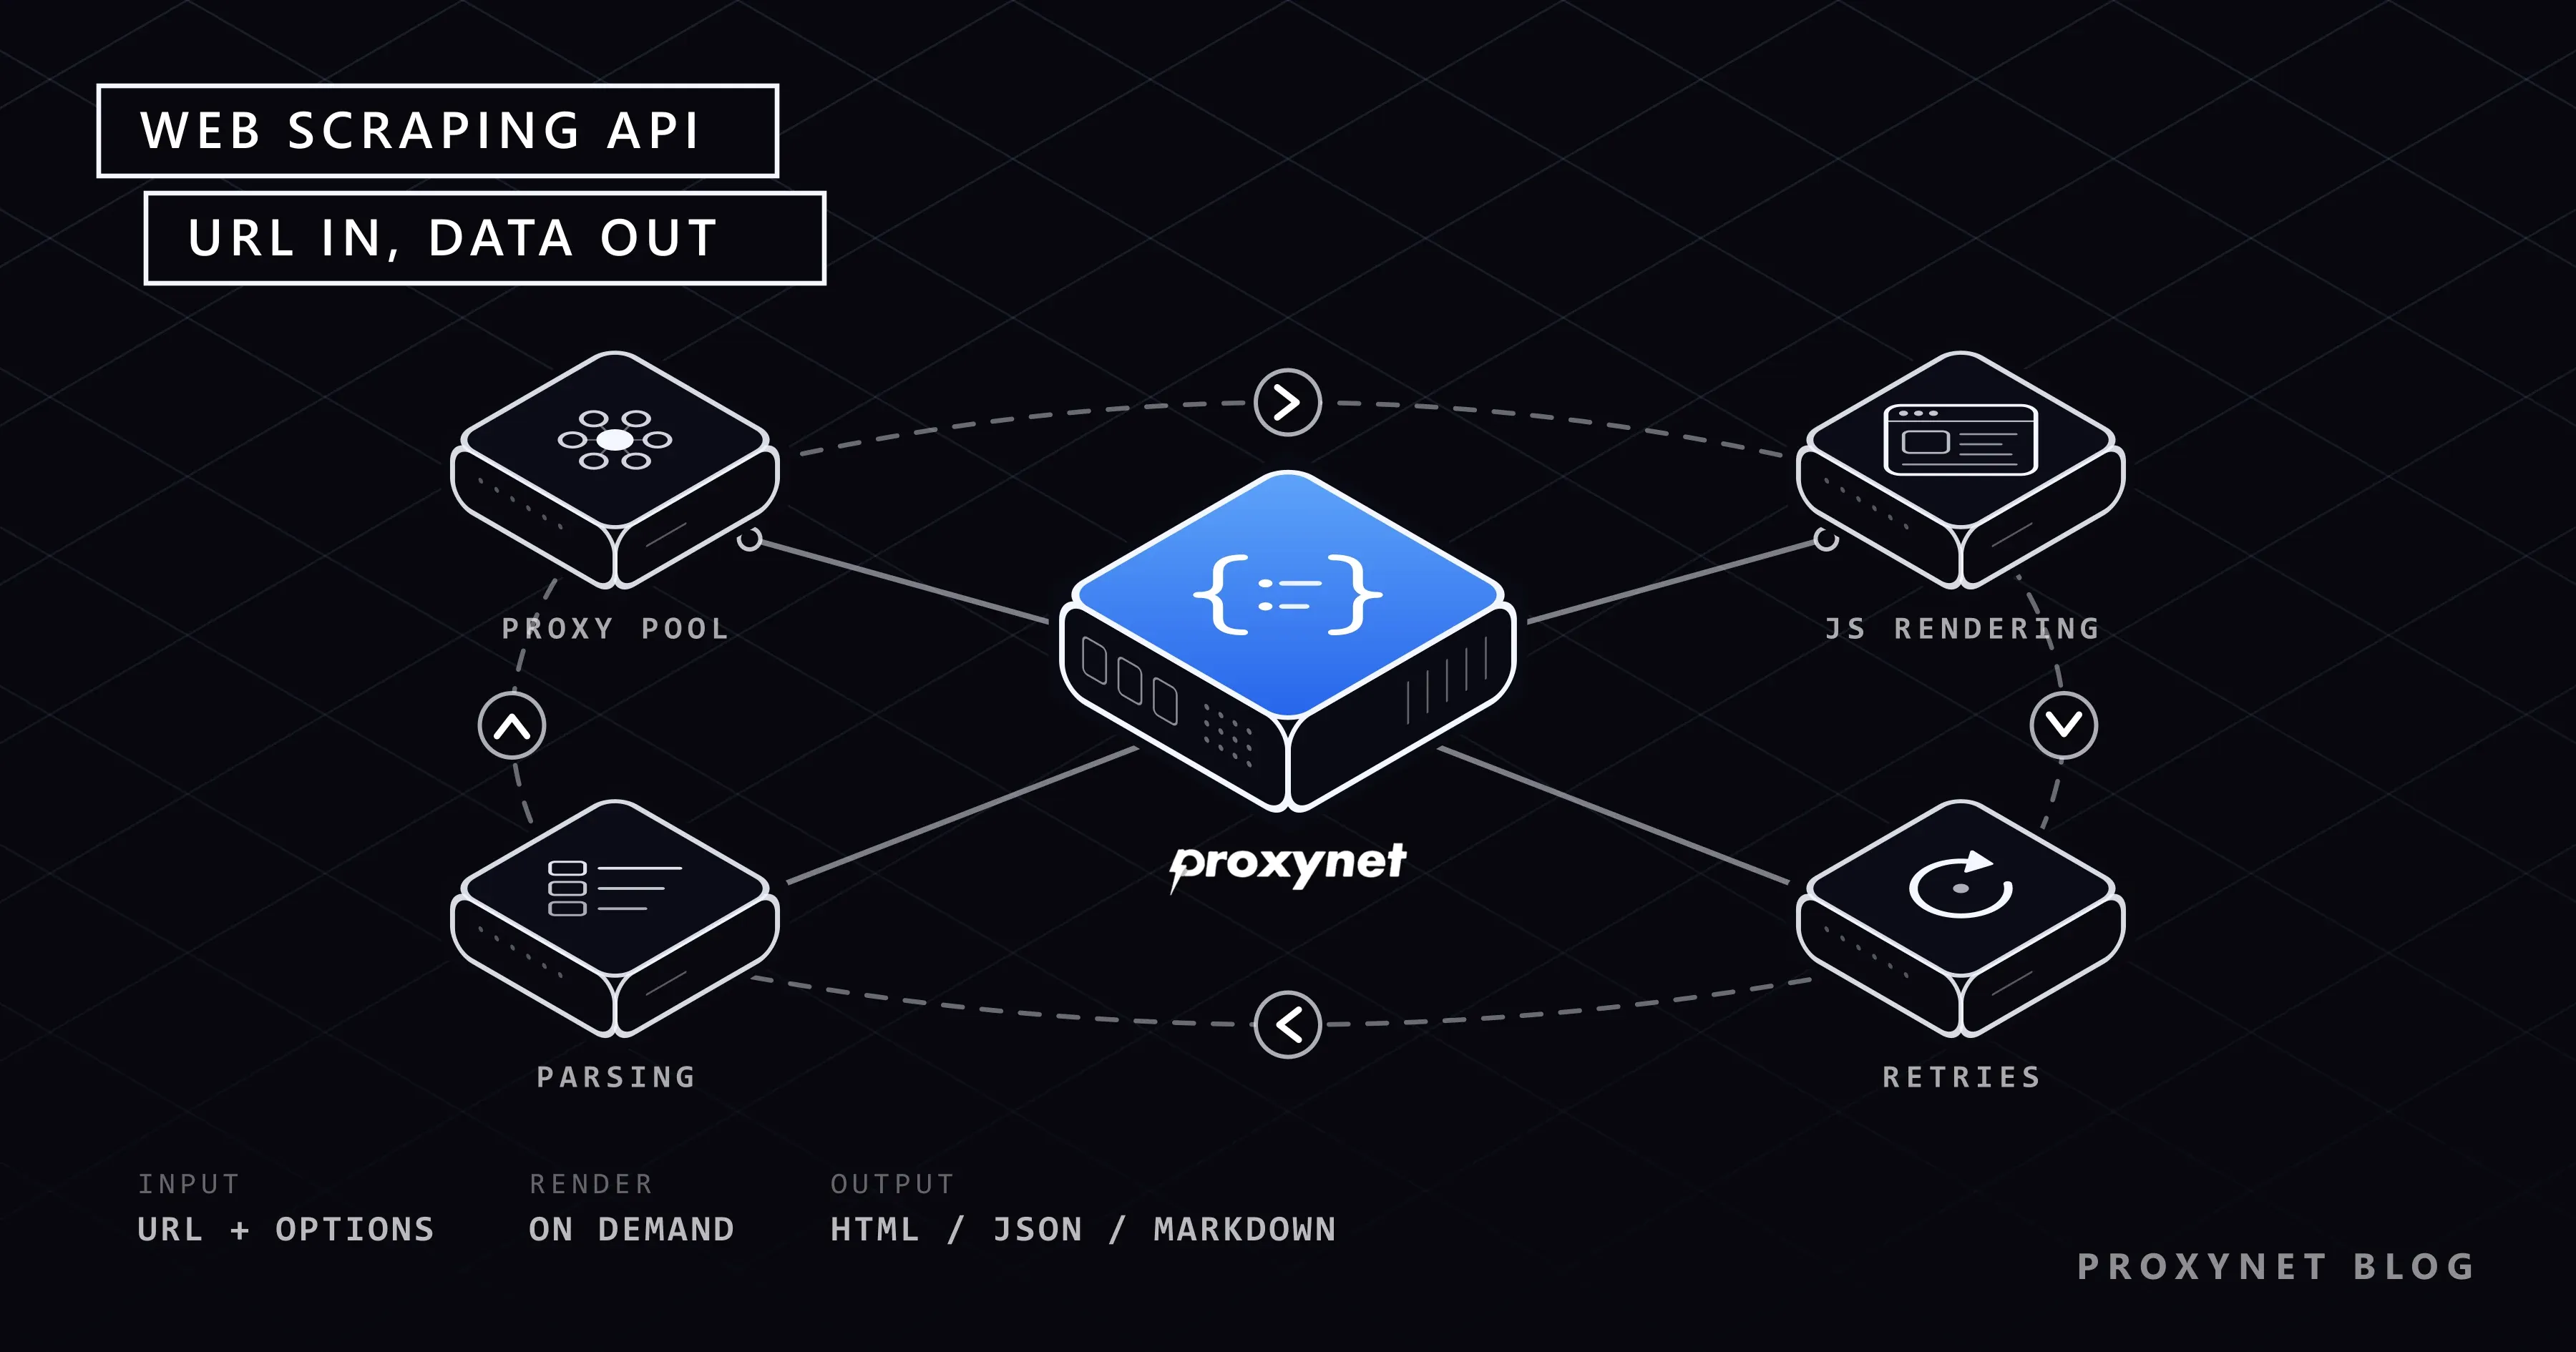
Eine Web-Scraping-API betreibt die Pipeline eines selbst gebauten Scrapers auf ihrer eigenen Infrastruktur:
- Sie senden den Auftrag: die Ziel-URL plus Optionen wie Land, Rendering und Ausgabeformat, manchmal eine Sitzungs-ID, die für mehrere Seiten dieselbe IP behält.
- Der Dienst wählt eine Ausgangs-IP aus seinem Proxy-Pool in dem Land, das Sie angefragt haben.
- Er ruft die Seite ab, mit einer einfachen HTTP-Anfrage oder in einem Headless-Browser, der das JavaScript der Seite ausführt.
- Er prüft die Antwort: den Statuscode, einen leeren Body oder eine Sperrseite an der Stelle, an der der Inhalt stehen sollte.
- Er wiederholt Fehlschläge mit einer anderen IP oder nach einer Pause, innerhalb einer festen Zahl von Versuchen.
- Er wandelt das Ergebnis um in rohes HTML, bereinigtes Markdown oder benannte Felder in JSON.
- Er gibt das Ergebnis zurück, mit Metadaten wie dem Statuscode des Ziels und der Zahl der Versuche, und rechnet die Anfrage ab.
Was nimmt Ihnen eine Web-Scraping-API ab?
Eine Web-Scraping-API übernimmt die fünf Aufgaben, die beim Scraping die meiste Zeit kosten: IP-Adressen, Rendering, Wiederholungen, den Umgang mit Sperren und das Parsing.
Proxy-Rotation und Geo-Targeting. Jede Anfrage verlässt den Dienst über eine IP aus dem Pool des Anbieters, in dem Land (manchmal der Stadt), das Sie wählen, mit einer neuen Adresse pro Anfrage oder einer, die für eine Sitzung bleibt. Die Pools mischen günstige Datacenter-IPs mit Residential- und Mobile-IPs von Heim- und Mobilfunkanschlüssen, die mehr kosten.
JavaScript-Rendering. Viele Seiten kommen als fast leere HTML-Hülle an, die JavaScript erst danach füllt. Der Dienst öffnet die Seite dann in einem Headless-Browser; die Chrome-Dokumentation beschreibt diesen Modus als Betrieb des Browsers „in einer unbeaufsichtigten Umgebung, ohne sichtbare Benutzeroberfläche“ (Chrome-Headless-Modus). Rendering ist die langsamste und teuerste Option, deshalb schalten Sie es pro Anfrage zu.
Wiederholungen. Verbindungen brechen ab, Proxys laufen in einen Timeout, und Server antworten kurzzeitig mit 503; der Dienst wiederholt solche Fehlschläge bis zu einer Grenze. Eine fehlende Seite (404) lohnt keinen neuen Versuch, und ein sauber gebauter Dienst versteht 429 Too Many Requests als Signal, langsamer zu werden.
Erkennung von Sperren und CAPTCHAs. Eine Website, die eine Anfrage ablehnt, schickt oft eine normal aussehende „Access denied“-Seite oder ein CAPTCHA, einen Test, der Menschen von Programmen unterscheiden soll. Ein guter Dienst meldet eine solche Seite als Fehlschlag, statt sie als Daten zurückzugeben. Eine Ablehnung ist die Entscheidung der Website; fragen Sie deshalb, wie ein Anbieter darauf reagiert.
Parsing und strukturierte Ausgabe. Viele APIs liefern benannte Felder, aus fertigen Parsern oder aus Selektoren, die Sie selbst angeben; andere geben den Haupttext als Markdown zurück, das Sprachmodelle leichter lesen als HTML. Sie sparen sich das Schreiben eines Parsers, aber dann entscheidet der Parser eines anderen, was „Preis“ bedeutet.
Web-Scraping-API vs. offizielle API, Proxys, Tools und Datensätze
Alle fünf Wege enden mit Daten in Ihrem System. Sie unterscheiden sich darin, was Sie erhalten und wer die Arbeit trägt.
| Weg | Was Sie erhalten | Wer die schwere Arbeit macht | Am besten geeignet bei |
|---|---|---|---|
| Web-Scraping-API | Seiten oder Felder von jeder URL | Der Anbieter | Vielen Websites, wenig Zeit |
| Offizielle API | Die eigenen Daten der Website, dokumentiert | Die Website | Einer vorhandenen API mit Ihren Feldern |
| Proxy-Dienst | IP-Adressen für Ihre Anfragen | Sie | Hohem Volumen, voller Kontrolle |
| Scraping-Bibliothek | Code, den Sie selbst ausführen | Sie | Eigenen Entwicklern und Servern |
| Kauf eines Datensatzes | Fertige Daten als Dateien | Der Datenanbieter | Daten, die es als Produkt gibt |
Gegenüber einer offiziellen API. Eine offizielle API kommt von der Website, der die Daten gehören; eine Scraping-API ist ein Dritter, der die öffentlichen Seiten dieser Website liest. Web Scraping vs. API vergleicht beide mit einem getesteten Beispiel. Für Käufer ist der entscheidende Unterschied die Vereinbarung: Zu einer offiziellen API gehören Bedingungen, die Sie akzeptieren, und oft Felder, die keine Seite zeigt, etwa interne IDs. Eine Scraping-API hat keine Vereinbarung mit dem Ziel, und ihre Felder können brechen, wenn die Website neu gestaltet wird. Wenn eine offizielle API Ihre Felder liefert, nutzen Sie sie.
Gegenüber einem Proxy-Dienst. Ein Proxy-Dienst verkauft IP-Adressen für Ihre eigenen Anfragen; Scraper, Browser, Wiederholungen und Parser bleiben Ihre Sache. Eine Scraping-API rechnet pro fertiger Seite ab, und die meisten laufen selbst auf Proxy-Pools.
Gegenüber einer Scraping-Bibliothek. Scrapy, Playwright oder Beautiful Soup kosten keine Lizenzgebühr, aber Ihr Team schreibt den Code und betreibt die Server. Ein verbreiteter Mittelweg lässt das Parsing in der Bibliothek und schickt nur die schwierigsten Abrufe an eine API.
Gegenüber einem Datensatz. Ein Datenanbieter verkauft bereits gesammelte und bereinigte Daten, geliefert als Dateien: am schnellsten, wenn es die Daten als Produkt gibt, am schwächsten, wenn Sie bestimmte Felder oder tägliche Aktualisierungen brauchen.
Welche Arten von Web-Scraping-APIs gibt es?
Anbieter verpacken dieselbe Technik für unterschiedliche Ziele, und ein Anbieter verkauft oft mehrere davon:
- Allgemeine APIs rufen jede URL ab und liefern HTML, gerendertes HTML oder Markdown.
- SERP-APIs liefern Suchergebnisseiten als Felder: Position, Titel, URL und Snippet. Die Bedingungen der Suchmaschinen schränken automatisierte Abfragen ein; für die Rankings Ihrer eigenen Website liefert die Google Search Console API Daten aus erster Hand.
- E-Commerce-APIs machen aus Produktseiten von Marktplätzen Felder wie Preis, Verfügbarkeit, Verkäufer und Bewertung.
- Social-Media-APIs liefern öffentliche Profile, Beiträge und Kommentare. Fast alles davon sind personenbezogene Daten, und die Bedingungen der Plattformen sind streng, deshalb ist der rechtliche Spielraum hier am kleinsten.
- KI-fähige Extraktions-APIs liefern den Hauptinhalt einer Seite als sauberes Markdown oder als Text, ohne Menüs und Footer, für Sprachmodelle und KI-Agenten.
Wie werden Web-Scraping-APIs abgerechnet?
Fast jede Scraping-API rechnet pro Anfrage ab; der Unterschied liegt darin, welche Anfragen zählen. Vier Modelle sind verbreitet, oft kombiniert:
- Pro Anfrage. Jeder Aufruf wird berechnet, ob erfolgreich oder nicht.
- Pro erfolgreicher Anfrage. Nur Erfolge werden berechnet, deshalb wird die Definition von Erfolg zur wichtigsten Vertragsbedingung.
- Credits mit Multiplikatoren. Eine einfache Anfrage kostet einen Credit; Rendering, Residential- oder Mobile-IPs und schwierige Ziele kosten mehrere. Ein Preis pro Credit sagt wenig, solange Sie Ihren Multiplikator nicht kennen.
- Monatstarife. Ein festes Kontingent an Anfragen oder Credits, oft mit einer Obergrenze für gleichzeitige Anfragen und einem Preis für Mehrverbrauch.
Was zählt als erfolgreiche Anfrage?
Laut HTTP-Standard bedeutet ein 2xx-Statuscode, dass die Anfrage „erfolgreich empfangen, verstanden und angenommen“ wurde (RFC 9110). Das ist die Sicht des Servers, nicht Ihre: Eine Sperrseite kann mit Status 200 ankommen, und ein 404 Not Found ist eine korrekte Antwort, in der keine Daten stehen.
Fragen Sie deshalb vor dem Kauf, ob ein 404, ein 200 mit leerer Seite oder Sperrseite und ein Timeout nach dem letzten Versuch berechnet werden. Messen Sie dann die Kosten pro 1.000 brauchbare Seiten auf Ihren echten Zielen.
Sollten Sie eine Scraping-API oder eigene Proxys nutzen?
Eine Scraping-API lohnt sich, wenn die Arbeit breit gestreut und Ihre Zeit knapp ist; ein eigener Scraper mit Proxys lohnt sich, wenn die Arbeit eng umrissen, groß und auf Dauer angelegt ist.
Wählen Sie eine Scraping-API, wenn:
- Sie Seiten von vielen verschiedenen Websites brauchen, jede mit eigenem Layout;
- viele Ziele ihre Inhalte mit JavaScript aufbauen;
- das Team klein ist und niemand Browser, Proxys und Parser betreiben will;
- die Zeit bis zum ersten Datensatz wichtiger ist als die Kosten pro Seite.
Wählen Sie einen eigenen Scraper mit Proxys, wenn:
- das Volumen auf einer Handvoll Websites sehr hoch ist, sodass sich ein Preis pro Seite summiert;
- Parser und Crawl-Logik Ihnen gehören oder gehören sollen;
- Sie volle Kontrolle über die Anfragerate, die Sitzungen und darüber brauchen, welche IP was sendet.
Viele Teams nutzen beides: eine API für den Long Tail schwieriger Websites und einen eigenen Scraper für die wenigen, die den Großteil des Volumens ausmachen.
Für den Weg mit eigenen Proxys verkauft Proxynet Proxys im Self-Service. Unser Residential-Proxy bietet rotierende oder Sticky-Sitzungen mit Länder- und Städte-Targeting und wird pro GB abgerechnet. Statische ISP- und Datacenter-Proxys werden pro IP abgerechnet, mit Traffic ohne Kontingent; sie sind standardmäßig auf bestimmte Zielseiten beschränkt, und der Zugang zu allen Websites ist ein kostenpflichtiges Add-on.
Unsere Web-Scraper-API ist vorerst über das Vertriebsteam erhältlich, nicht im Self-Service. Die Seite zum Data Scraping beschreibt den Proxy-Teil; für die API nennen Sie dem Vertrieb Ihre Websites, Länder und das gewünschte Ausgabeformat.
Ist die Nutzung einer Web-Scraping-API legal?
Eine API ändert nichts daran, was Sie sammeln dürfen: Die robots.txt der Zielseite, ihre Nutzungsbedingungen und das Datenschutzrecht gelten so, als würden Sie die Seiten selbst abrufen, denn Sie wählen die URLs und den Zweck.
robots.txt. Diese Datei sagt Crawlern, welche Pfade sie abrufen dürfen. Ihr Standard, RFC 9309, hält fest, dass „diese Regeln keine Form der Zugriffsautorisierung sind“ (RFC 9309). Die Datei sperrt also nichts ab, und ob sie befolgt wird, entscheidet der Crawler. Fragen Sie, ob ein Anbieter sie beachtet oder diese Prüfung Ihnen überlässt.
Nutzungsbedingungen. Die Bedingungen der Zielseite gelten für Sie, nicht nur für den Anbieter. Seiten hinter einem Login, besonders mit dem Konto einer anderen Person, sind etwas anderes als öffentliche Seiten.
Personenbezogene Daten. Namen, Profillinks, E-Mail-Adressen und Bewertungen mit Autorennamen sind nach der DSGVO personenbezogene Daten, auch wenn sie öffentlich sind. Der Leitlinienentwurf des Europäischen Datenschutzausschusses (EDSA), am 7. Juli 2026 zur öffentlichen Konsultation angenommen, hält fest, dass „die Organisation, die das Scraping durchführt, nicht notwendigerweise der Verantwortliche im Sinne der DSGVO ist“ (EDSA-Leitlinien 03/2026). Ein Dienstleister, der nach dokumentierten Weisungen eines Kunden scrapt, kann Auftragsverarbeiter sein; der Kunde, der den Zweck festlegt, ist in der Regel der Verantwortliche.
Die Leitlinien behandeln Scraping für das Training generativer KI, doch die Rollenverteilung folgt den allgemeinen Regeln der DSGVO. Zu den Anzeichen dafür, dass sich eine Website gegen Scraping wendet, zählen sie außerdem robots.txt-Dateien und CAPTCHAs.
Sammeln Sie deshalb nur die Felder, die Sie brauchen, und schließen Sie einen Auftragsverarbeitungsvertrag (AVV), wenn der Anbieter personenbezogene Daten für Sie verarbeitet. Personenbezogene Daten (PII) in Scraping-Datensätzen zeigt, wie Sie solche Daten reduzieren und maskieren.
Anwendungsfälle
- Preis- und Bestandsüberwachung über viele Shops und Länder hinweg.
- Verfolgung von Suchergebnissen für eine Keyword-Liste, im Rahmen der Bedingungen der Suchmaschine.
- Marktforschung: Sortimente, Kataloge und Bewertungstexte ohne Autorendaten.
- Aggregation von Inseraten aus Immobilien-, Reise- oder Kleinanzeigenportalen.
- KI-Pipelines: Dokumentation, für das Retrieval in Markdown umgewandelt.
- Anzeigen- und Inhaltsprüfung: wie eine Seite in einem anderen Land erscheint.
Häufige Fehler
- Für Rendering bezahlen, das Sie nicht brauchen. Testen Sie jedes Ziel zuerst ohne Rendering; viele Seiten enthalten die Daten schon im HTML.
- Preise ohne die Definition von Erfolg vergleichen. Ein niedriger Preis pro Anfrage sagt wenig, wenn Sperrseiten und
404-Antworten berechnet werden. - Zurückgegebenem JSON ohne Schemaprüfung vertrauen. Nach einem Redesign kann ein geparstes Feld unbemerkt zu
nullwerden. Prüfen Sie jede Antwort gegen ein Schema; JSON Schema ist das verbreitete Format dafür. - Eigene Wiederholungen auf die des Anbieters setzen. Drei API-Versuche mal drei eigene ergeben neun Abrufe einer Seite, die fehlschlägt.
- Annehmen, dass die API Einwilligung und Rechtmäßigkeit regelt. Der Anbieter ruft ab; Sie entscheiden, was und wozu.
- Eine Scraping-API nutzen, wo es eine offizielle API gibt. Sie bezahlen dafür, Daten zu scrapen, die der Eigentümer bereits anbietet.
Entscheidungshilfe
| Bedarf | Empfehlung |
|---|---|
| Daten von 50 verschiedenen Websites, kleines Team | Eine Scraping-API |
| Viele Ziele bauen ihre Seiten mit JavaScript | Eine Scraping-API, Rendering nur wo nötig |
| Millionen Seiten pro Monat von drei Websites | Eigener Scraper mit Proxys |
| Volle Kontrolle über Anfragerate, Sitzungen und Parsing | Eigener Scraper mit Proxys |
| Die Website hat eine offizielle API mit Ihren Feldern | Die offizielle API |
| Preise, wie Käufer in fünf Ländern sie sehen | Eine Scraping-API oder Residential-Proxys |
| Die Daten gibt es als Produkt, Aktualität zweitrangig | Kauf eines Datensatzes |
| Öffentliche Profile oder Bewertungen mit Autorennamen | Felder eingrenzen, zuerst die Rechtsgrundlage klären |
Häufige Fragen
Wofür wird eine Web-Scraping-API verwendet?
Eine Web-Scraping-API wird verwendet, um Daten von Websites zu sammeln, ohne eine eigene Scraping-Infrastruktur zu betreiben. Typische Aufgaben sind Preisüberwachung, die Verfolgung von Suchergebnissen, Marktforschung, die Aggregation von Inseraten und das Einspeisen von Webseiten als sauberer Text in KI-Systeme.
Ist eine Web-Scraping-API dasselbe wie ein Proxy?
Nein. Ein Proxy leitet Ihre Anfragen nur über eine andere IP-Adresse weiter, und Ihr Code ruft weiterhin selbst ab, rendert, wiederholt und parst. Eine Web-Scraping-API erledigt all das und liefert die fertige Seite oder die Felder zurück.
Ist eine Scraper-API besser als ein eigener Scraper?
Bei vielen Websites und einem kleinen Team meistens ja: Sie startet schneller und braucht keine Infrastruktur. Bei sehr hohem Volumen auf wenigen Websites kostet ein eigener Scraper mit Proxys pro Seite meist weniger und gibt Ihnen volle Kontrolle.
Kann eine Web-Scraping-API JavaScript-Websites scrapen?
Ja, wenn sie Rendering anbietet: Sie öffnet die Seite in einem Headless-Browser und liefert den fertigen Inhalt zurück. Gerenderte Anfragen sind langsamer und kosten oft mehr; prüfen Sie deshalb zuerst, ob die Daten schon im einfachen HTML stehen.
Was kostet eine Web-Scraping-API?
Das Preismodell entscheidet mehr als der Listenpreis. Dienste rechnen pro Anfrage, pro erfolgreicher Anfrage oder in Credits ab, und Rendering oder Residential-IPs vervielfachen oft die Kosten einer Seite. Vergleichen Sie die Kosten pro 1.000 brauchbare Seiten auf Ihren eigenen Zielen.
Ist die Nutzung einer Web-Scraping-API legal?
Nicht die Nutzung des Dienstes ist die rechtliche Frage, sondern das, was Sie damit sammeln. Die Bedingungen der Zielseite, ihre robots.txt und das Datenschutzrecht gelten für Sie, als würden Sie die Seiten selbst scrapen. Für ein konkretes Projekt fragen Sie am besten einen Anwalt, der Ihre Rechtsordnung kennt.
Fazit
Eine Web-Scraping-API ist Scraping als Dienstleistung: Sie übernimmt IP-Adressen, Rendering, Wiederholungen, die Erkennung von Sperren und das Parsing und liefert HTML, JSON oder Markdown. Für viele Websites und kleine Teams ist sie der schnelle Weg; ein eigener Scraper mit Proxys ist bei großem, gleichmäßigem Volumen auf wenigen Websites günstiger. Prüfen Sie, was als berechneter Erfolg zählt, und validieren Sie, was zurückkommt. Wenn Sie über unsere Web-Scraper-API sprechen möchten, kontaktieren Sie unser Vertriebsteam.