Bir fiyatlandırma ekibi her sabah 40 online mağazadaki 300 ürünün fiyatını, beş ülkedeki müşterilerin gördüğü hâliyle almak istiyor. Mağazaların yarısı sayfalarını JavaScript ile oluşturuyor, her birinin HTML düzeni de farklı. Ekip bu işi yapacak programları (scraper) kendisi yazıp çalıştırabilir ya da her ürünün adresini bir web scraping API'ye gönderip istediği alanları JSON olarak geri alabilir.
Bu yazıda web scraping API'nin nasıl çalıştığını ve işin hangi kısmını üstlendiğini anlatıyoruz. Ardından onu web verisine ulaşmanın dört başka yoluyla karşılaştırıyor, türlerini, fiyatlandırma modellerini ve hukuki tarafı ele alıyoruz. Son bölüm, satın almadan önceki asıl soruyu cevaplıyor: scraping API mi, kendi proxy'leriniz mi?
Web scraping API nedir?
Web scraping API, bir web sayfasını sizin adınıza indirip içeriğini programınızın kullanabileceği biçimde döndüren bir HTTP hizmetidir. Herhangi bir API gibi çağrılır, ama veri, sahibinin API olarak sunmadığı bir sayfadan kazınarak gelir. Piyasada scraper API ya da web scraping hizmeti adıyla da satılır.
Web scraping (veri kazıma), sayfaları indirip HTML'in içinden istenen değerleri ayıklayan programların yaptığı iştir. Nasıl işlediğini Web Scraping (Veri Kazıma) Nedir ve Nasıl Çalışır? yazımızda anlattık. Scraping API de aynı işi yapar; fark, altyapıyı kimin işlettiğindedir.
Bir istek neye benzer?
Aşağıdaki api.example.com endpoint'i ve alanların adları yalnız örnek olsun diye uydurulmuştur. Her sağlayıcı seçeneklerine farklı adlar verir, ama yapı benzerdir.
curl -s https://api.example.com/v1/scrape \
  -H "Authorization: Bearer $API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"url": "https://shop.example.com/p/1234", "country": "de", "render": false, "output": "json"}'
İsteği aynı uydurma API'nin yerel bir taklidine (mock) gönderdiğimizde şu cevap döndü:
{
  "url": "https://shop.example.com/p/1234",
  "target_status": 200,
  "country": "de",
  "rendered": false,
  "attempts": 2,
  "data": {
    "name": "Desk lamp",
    "price": "24.90",
    "currency": "EUR",
    "in_stock": true
  }
}
target_status mağazanın döndürdüğü durum kodudur, attempts hizmetin sayfayı iki denemede alabildiğini gösterir, data ise ayrıştırıcının (parser) sayfadan çıkardığı alanları taşır. "output": "html" gönderirseniz sayfanın kendisini alır, ayrıştırmayı kendi tarafınızda yaparsınız.
Web scraping API nasıl çalışır?
Web scraping API, sizin yazacağınız bir scraper'ın izleyeceği adımları kendi altyapısında yürütür:
- İşi gönderirsiniz: hedef adresle birlikte ülke, render, çıktı biçimi gibi seçenekler; bazen de birkaç sayfa boyunca aynı IP'yi koruyan bir oturum kimliği.
- Hizmet bir çıkış IP'si seçer: istediğiniz ülkeden, kendi proxy havuzundan. Hedef site isteği bu adresten gelmiş görür.
- Sayfayı alır: düz bir HTTP isteğiyle ya da sayfanın JavaScript'ini çalıştıran bir headless tarayıcıda.
- Cevabı denetler: durum koduna, cevabın boş gelip gelmediğine ve içeriğin yerinde bir engel sayfası olup olmadığına bakar.
- Başarısız istekleri yeniden dener: başka bir IP'yle ya da kısa bir beklemenin ardından, belirlenen deneme sayısını aşmadan.
- Sonucu dönüştürür: ham HTML'e, temizlenmiş Markdown'a ya da JSON içinde adlandırılmış alanlara.
- Sonucu size gönderir: hedefin durum kodu ve deneme sayısı gibi üst verilerle birlikte; isteği de ücretlendirir.
Web scraping API sizin için neyi üstlenir?
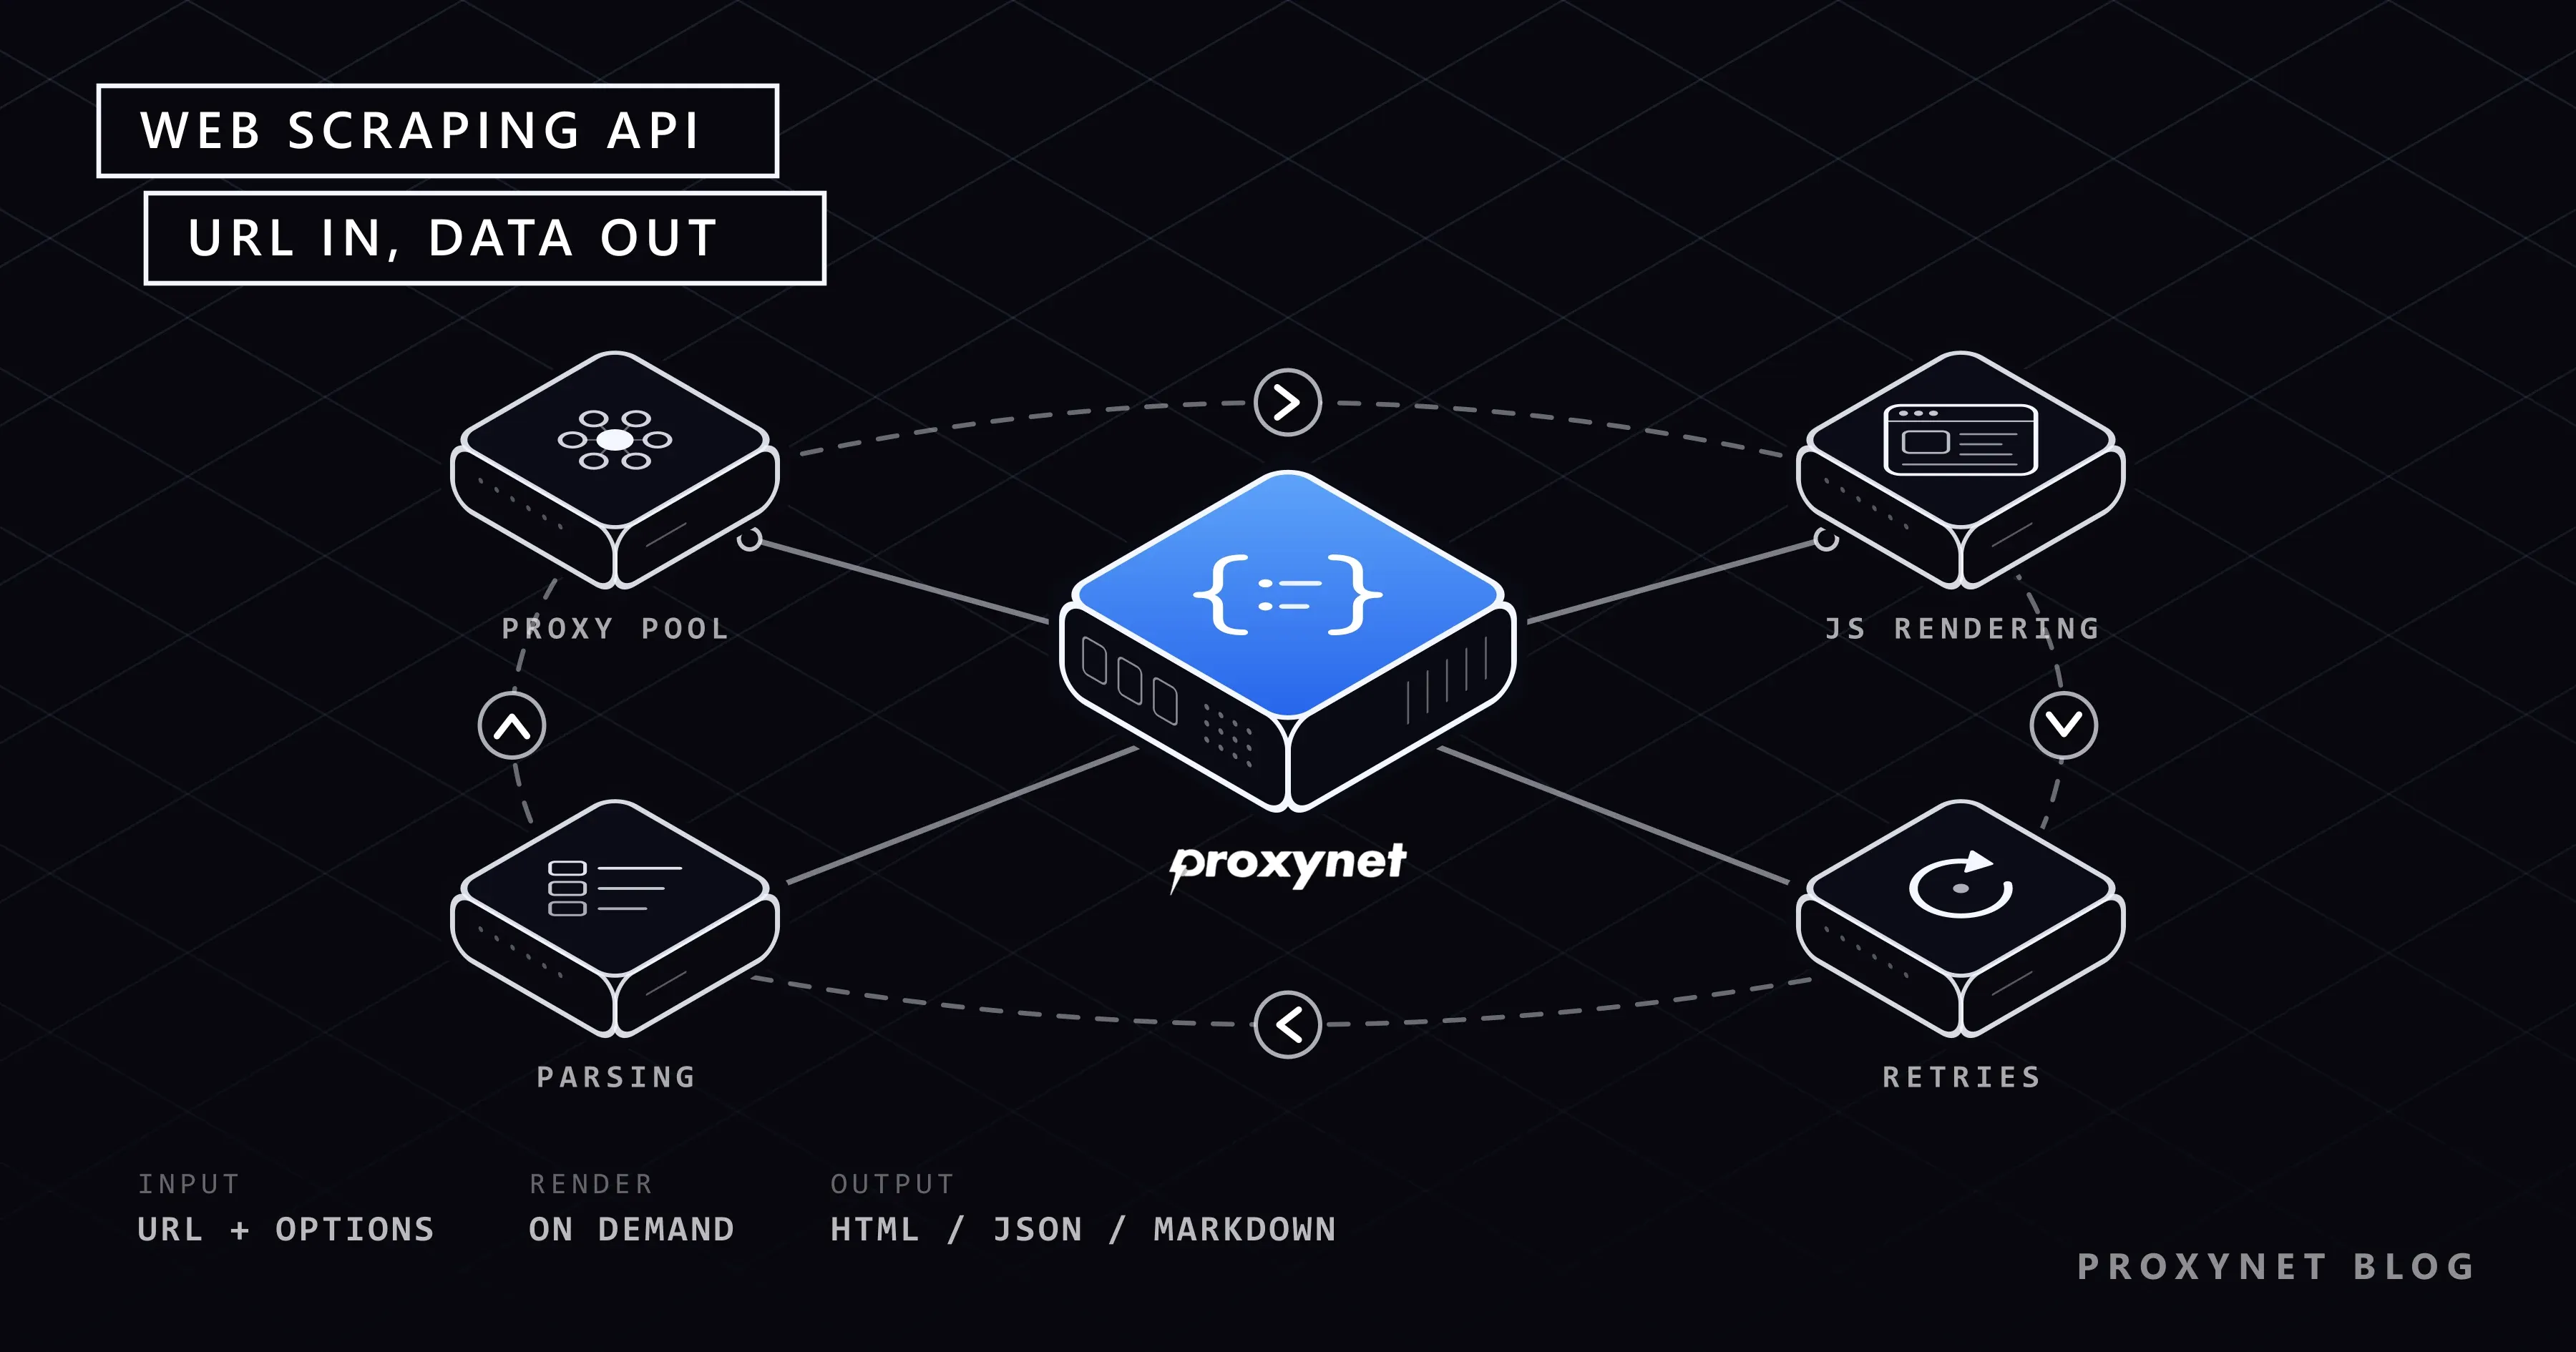
Web scraping API, scraping'de en çok zaman alan beş işi üstlenir: IP adresleri, render, yeniden deneme, engel tespiti ve ayrıştırma.
IP rotasyonu ve coğrafi hedefleme. Her istek sağlayıcının havuzundaki bir IP'den, seçtiğiniz ülkeden (bazen şehirden) çıkar. Adres her istekte değişebilir ya da bir oturum boyunca aynı kalabilir. Havuzlarda ucuz datacenter IP'leriyle, ev ve mobil bağlantılardan gelen daha pahalı residential ve mobil IP'ler bir arada bulunur.
JavaScript render. Birçok sayfa neredeyse boş bir HTML iskeleti olarak gelir, içeriği sonradan JavaScript doldurur. Hizmet bu içeriği görmek için sayfayı headless tarayıcıda, yani penceresi olmayan gerçek bir tarayıcıda açar ve JavaScript'in çalışmasını bekler; buna render denir. Chrome belgeleri headless modu, tarayıcının "başında kimse olmayan bir ortamda, görünür bir arayüz olmadan" çalışması diye tanımlar (Chrome headless modu). Render en yavaş ve en pahalı seçenektir; bu yüzden istek bazında siz açarsınız.
Yeniden deneme. Bağlantılar kopar, proxy'ler zaman aşımına uğrar, sunucular bir anlığına 503 döner; hizmet bu tür hatalarda isteği belirli bir sınıra kadar yeniden dener. Olmayan bir sayfayı (404) yeniden denemenin anlamı yoktur. Kurallara uyan bir hizmet ise 429 Too Many Requests cevabını yavaşlaması gerektiğinin işareti sayar.
Engel ve CAPTCHA tespiti. İsteği reddeden bir site çoğu zaman normal görünen bir "Access denied" sayfası ya da CAPTCHA gösterir; CAPTCHA, insanı programdan ayırt etmek için konan bir testtir. İyi bir hizmet böyle bir sayfayı veri diye döndürmez, isteği başarısız sayar. Ret sitenin kararıdır; sağlayıcıya böyle bir retle karşılaşınca ne yaptığını sorun.
Ayrıştırma ve yapılandırılmış çıktı. Birçok API, hazır ayrıştırıcılarla ya da sizin verdiğiniz seçicilerle (selector) çıkarılmış, adlandırılmış alanlar döndürür. Bazıları sayfanın ana metnini, dil modellerinin HTML'den daha kolay okuduğu Markdown biçiminde verir. Ayrıştırıcı yazmaktan kurtulursunuz, ama "fiyat"ın ne olduğuna artık başkasının ayrıştırıcısı karar verir.
Web scraping API ile resmî API, proxy, kütüphane ve veri seti arasındaki farklar
Beş yolun hepsinin sonunda veri sizin sisteminize ulaşır. Aralarındaki fark, elinize ne geçtiğinde ve işin yükünü kimin çektiğindedir.
| Yol | Ne alırsınız | Zor işi kim yapar | En uygun durum |
|---|---|---|---|
| Web scraping API | Herhangi bir adresten sayfa ya da alan | Sağlayıcı | Çok site, az zaman |
| Resmî API | Sitenin kendi belgelenmiş verisi | Site | Varsa ve alanlarınızı veriyorsa |
| Proxy hizmeti | İstekleriniz için IP adresleri | Siz | Yüksek hacim, tam kontrol |
| Scraping kütüphanesi | Kendi çalıştırdığınız kod | Siz | Geliştiriciniz ve sunucunuz varsa |
| Veri seti satın almak | Dosya olarak hazır veri | Veri satıcısı | Veri zaten ürün olarak varsa |
Resmî API ile farkı. Resmî API'yi verinin sahibi olan site yayımlar; scraping API ise o sitenin herkese açık sayfalarını okuyan üçüncü bir taraftır. İki yolu test edilmiş bir örnekle Web Scraping ve API Farkı yazımızda karşılaştırdık.
Satın alan taraf için asıl fark anlaşmadır. Resmî API, kabul ettiğiniz şartlarla ve çoğu zaman hiçbir sayfada görünmeyen alanlarla, örneğin dahili kimliklerle gelir. Scraping API'nin hedef siteyle bir anlaşması yoktur ve site tasarımını değiştirdiğinde döndürdüğü alanlar bozulabilir. Alanlarınızı veren bir resmî API varsa onu kullanın.
Proxy hizmetiyle farkı. Proxy hizmeti kendi istekleriniz için IP adresi satar; scraper'ı, tarayıcıyı, yeniden denemeleri ve ayrıştırıcıyı siz işletirsiniz. Scraping API ise teslim ettiği her sayfa için ücret alır; çoğu da arka planda kendisi proxy havuzları kullanır.
Scraping kütüphanesiyle farkı. Scrapy, Playwright ya da Beautiful Soup için lisans ücreti ödemezsiniz, ama kodu ekibiniz yazar, sunucuları da siz çalıştırırsınız. Yaygın bir ara yol, ayrıştırmayı kütüphanede tutup yalnız alınması en zor sayfaları API'ye göndermektir.
Veri setiyle farkı. Veri seti satıcısı önceden toplanmış ve temizlenmiş veriyi dosya olarak satar. Veri zaten hazır bir ürün olarak varsa en hızlı yol budur; belirli alanlar ya da günlük güncelleme gerekiyorsa en az işe yarayanı da budur.
Web scraping API türleri nelerdir?
Sağlayıcılar aynı altyapıyı farklı hedefler için ayrı ürünler hâlinde sunar; bir sağlayıcı çoğu zaman birkaç türü birden satar:
- Genel amaçlı API'ler herhangi bir adresi alır; HTML, render edilmiş HTML ya da Markdown döndürür.
- SERP API'leri arama sonuç sayfalarını sıra, başlık, adres ve özet metin gibi alanlara bölerek döndürür. Arama motorlarının şartları otomatik sorguları kısıtlar; kendi sitenizin sıralamaları için Google Search Console API birinci elden veri verir.
- E-ticaret API'leri pazaryeri ürün sayfalarını fiyat, stok durumu, satıcı ve puan gibi alanlara çevirir.
- Sosyal medya API'leri herkese açık profilleri, gönderileri ve yorumları döndürür. Bunların neredeyse tamamı kişisel veridir ve platformların şartları katıdır; hukuken en az hareket alanı burada vardır.
- Yapay zekâya hazır çıkarım API'leri sayfanın ana içeriğini menüler ve alt bilgi olmadan, dil modelleri ve yapay zekâ ajanları için temiz Markdown ya da düz metin olarak verir.
Web scraping API'ler nasıl fiyatlandırılır?
Neredeyse her scraping API istek başına ücret alır; değişen, hangi isteklerin sayıldığıdır. Dört model yaygındır ve çoğu zaman birlikte kullanılır:
- İstek başına. Başarılı olsun olmasın her çağrı ücretlendirilir.
- Başarılı istek başına. Yalnız başarılı istekler ücretlendirilir; bu yüzden başarının tanımı sözleşmenin en önemli maddesi olur.
- Çarpanlı kredi. Basit bir istek bir kredidir; render, residential ya da mobil IP ve zor hedefler ise birkaç kredi tutar. Kendi çarpanınızı bilmeden kredi başına fiyat pek bir şey söylemez.
- Aylık abonelik. Her ay belirli bir istek ya da kredi hakkı tanınır; çoğu zaman eşzamanlı istek sayısı sınırlıdır, kotayı aşan kullanım ayrıca ücretlendirilir.
Başarılı istek ne sayılır?
HTTP standardı, 2xx durum kodunun isteğin "başarıyla alındığını, anlaşıldığını ve kabul edildiğini" gösterdiğini söyler (RFC 9110). Bu, sunucunun bakış açısıdır, sizinki değil: bir engel sayfası 200 koduyla gelebilir, 404 Not Found ise içinde veri olmayan doğru bir cevaptır.
Bu yüzden satın almadan önce 404'ün, boş ya da engel sayfası taşıyan bir 200'ün ve son denemeden sonra zaman aşımına uğrayan isteğin ücretlendirilip ücretlendirilmediğini sorun. Ardından kendi hedeflerinizde kullanılabilir 1.000 sayfanın maliyetini ölçün.
Scraping API mi, kendi proxy'leriniz mi?
İş çok sayıda siteye yayılıyorsa ve zamanınız kısıtlıysa scraping API kazandırır. İş birkaç sitede yoğunlaşıyor, büyük ve uzun soluklu ise kendi scraper'ınız ve proxy'leriniz daha kârlıdır.
Scraping API'yi şu durumlarda seçin:
- her birinin düzeni farklı olan pek çok siteden sayfa gerekiyorsa;
- hedef sitelerin çoğu içeriğini JavaScript ile oluşturuyorsa;
- ekip küçükse ve kimse tarayıcıyla, proxy'yle ve ayrıştırıcıyla uğraşmak istemiyorsa;
- ilk veri setine çabuk ulaşmak sayfa başına maliyetten daha önemliyse.
Kendi scraper'ınızı ve proxy'lerinizi şu durumlarda seçin:
- hacim bir avuç sitede çok yüksekse ve sayfa başına ücret hızla kabarıyorsa;
- ayrıştırıcıyı ve tarama mantığını zaten siz yazıyorsanız ya da kendiniz yazmak istiyorsanız;
- istek hızı, oturumlar ve hangi IP'nin ne gönderdiği üzerinde tam kontrol gerekiyorsa.
Birçok ekip ikisini birlikte kullanır: sayıca çok ama hacmi düşük zor siteleri API'ye bırakır, hacmin çoğunu taşıyan birkaç siteyi kendi scraper'ıyla kazır.
Kendi proxy'lerinizle ilerlemek isterseniz Proxynet proxy'leri self-servis satar. Residential Proxy ürünümüz ülke ve şehir hedeflemeli rotating ya da sticky oturum sunar ve GB başına ücretlendirilir. Statik ISP ve datacenter proxy'ler IP başına ücretlendirilir ve trafikleri sınırsızdır. Varsayılan olarak hedef site kısıtlamasıyla gelirler; tüm sitelere erişim ücretli bir eklentidir.
Web Scraper API'miz şimdilik self-servis değil, satış ekibimiz üzerinden sunuluyor. Veri kazıma sayfamız işin proxy tarafını anlatır; API için de sitelerinizi, ülkelerinizi ve istediğiniz çıktı biçimini bu ekibe iletin.
Web scraping API kullanmak yasal mı?
API kullanmak, neyi toplayabileceğinizi değiştirmez. Adresleri ve amacı siz seçtiğiniz için hedef sitenin robots.txt dosyası, kullanım şartları ve veri koruma hukuku, sayfaları kendiniz indirmişsiniz gibi size uygulanır.
robots.txt. Bu dosya, siteyi otomatik gezen botlara (crawler) sitenin hangi bölümlerini indirebileceklerini söyler. Dosyanın standardı olan RFC 9309, "bu kuralların bir erişim yetkilendirmesi biçimi olmadığını" açıkça yazar (RFC 9309): dosya hiçbir şeyi kilitlemez, kurallara uyup uymamak crawler'a kalmıştır. Sağlayıcıya robots.txt'ye uyup uymadığını ya da bu denetimi size mi bıraktığını sorun.
Kullanım şartları. Hedef sitenin şartları yalnız sağlayıcıyı değil, sizi de bağlar. Giriş yapılarak açılan sayfalar, hele başkasının hesabıyla girilenler, herkese açık sayfalardan ayrı bir konudur.
Kişisel veri. Adlar, profil bağlantıları, e-posta adresleri ve yazarının adı görünen yorumlar, herkese açık olsalar bile GDPR'a (Türkiye'de KVKK'ya) göre kişisel veridir. Avrupa Veri Koruma Kurulu (EDPB), 7 Temmuz 2026'da kabul edip kamuoyu görüşüne açtığı taslak yönergelerde, kazımayı yapan kuruluşun GDPR kapsamında "her zaman veri sorumlusu olmadığını" belirtir (EDPB Yönergeleri 03/2026). Müşterisinin yazılı talimatıyla kazıma yapan bir yüklenici veri işleyen sayılabilir; amacı belirleyen müşteri ise genellikle veri sorumlusudur.
Yönergeler, üretken yapay zekâ modellerini eğitmek için yapılan kazımayı konu alır; bu rol dağılımı ise GDPR'ın genel kurallarından gelir. Aynı metin robots.txt dosyalarını ve CAPTCHA'ları, bir sitenin kazımaya karşı çıktığını gösteren işaretler arasında sayar.
Bu yüzden yalnız ihtiyaç duyduğunuz alanları toplayın; sağlayıcı sizin adınıza kişisel veri işliyorsa onunla bir veri işleme sözleşmesi imzalayın. Kişisel veriyi nasıl azaltıp maskeleyeceğinizi Kazınan Verilerde Kişisel Veri (PII) Nasıl Yönetilir? yazımızda anlattık.
Kullanım alanları
- Fiyat ve stok takibi: çok sayıda mağazada ve ülkede.
- Arama sonucu takibi: bir anahtar kelime listesi için, arama motorunun şartlarına uyarak.
- Pazar araştırması: ürün yelpazesi, kataloglar ve yazar bilgisi çıkarılmış yorum metinleri.
- İlan toplama: emlak, seyahat ya da seri ilan portallarından.
- Yapay zekâ uygulamaları: dokümantasyonun, modelin bilgi arayacağı Markdown metinlerine çevrilmesi.
- Reklam ve içerik kontrolü: bir sayfanın başka bir ülkeden nasıl göründüğü.
Sık yapılan hatalar
- İhtiyacınız olmayan render'a para ödemek. Her hedefi önce render kapalıyken deneyin; birçok sayfa veriyi zaten düz HTML'de taşır.
- Başarı tanımına bakmadan fiyat karşılaştırmak. Engel sayfaları ve
404cevapları ücretlendiriliyorsa düşük istek fiyatı pek bir şey ifade etmez. - Dönen JSON'u şemayla denetlememek. Site yeniden tasarlandıktan sonra ayrıştırılan bir alan sessizce
nullgelmeye başlayabilir. Her cevabı bir şemaya göre doğrulayın; bunun için yaygın olarak JSON Schema kullanılır. - Sağlayıcının yeniden denemelerinin üstüne kendi denemelerinizi eklemek. API'nin üç denemesi sizin üç denemenizle çarpılınca tek bir başarısız sayfa için hedef siteye dokuz istek gider.
- API'nin izin ve yasallık konusunu hallettiğini sanmak. Sağlayıcı sayfayı alır; neyin ve neden toplanacağına siz karar verirsiniz.
- Resmî API varken scraping API kullanmak. Sahibinin zaten sunduğu veriyi kazımak için para ödersiniz.
Karar rehberi
| İhtiyaç | Öneri |
|---|---|
| 50 farklı siteden veri, küçük ekip | Scraping API |
| Hedef sitelerin çoğu sayfalarını JavaScript ile oluşturuyor | Scraping API, render yalnız gereken yerde |
| Üç siteden ayda milyonlarca sayfa | Kendi scraper'ınız ve proxy'leriniz |
| İstek hızı, oturum ve ayrıştırma üzerinde tam kontrol | Kendi scraper'ınız ve proxy'leriniz |
| Sitenin alanlarınızı veren resmî bir API'si var | Resmî API |
| Beş ülkedeki müşterilerin gördüğü fiyatlar | Scraping API ya da residential proxy |
| Veri hazır ürün olarak var, güncellik şart değil | Veri seti satın almak |
| Yazar adı taşıyan herkese açık profil ya da yorumlar | Önce alanları daraltın, hukuki dayanağı netleştirin |
Sıkça sorulan sorular
Web scraping API ne işe yarar?
Web scraping API, kendi scraping altyapınızı kurmadan web sitelerinden veri toplamanızı sağlar. En yaygın kullanım alanları fiyat takibi, arama sonucu takibi, pazar araştırması, ilan toplama ve web sayfalarının yapay zekâ sistemlerine temiz metin olarak aktarılmasıdır.
Web scraping API ile proxy aynı şey mi?
Hayır. Proxy yalnız isteklerinizi başka bir IP adresi üzerinden iletir; sayfayı almak, render etmek, yeniden denemek ve ayrıştırmak yine kodunuzun işidir. Web scraping API bunların hepsini yapar ve size tamamlanmış sayfayı ya da alanları döndürür.
Scraper API mi, kendi scraper'ınızı yazmak mı daha iyi?
Çok sayıda site ve küçük bir ekip söz konusuysa çoğunlukla scraper API daha iyidir: daha hızlı başlarsınız ve altyapı kurmanız gerekmez. Birkaç siteden çok yüksek hacimde veri çekiyorsanız kendi scraper'ınız ve proxy'leriniz sayfa başına genellikle daha ucuza gelir ve tam kontrol sağlar.
Web scraping API, JavaScript ile çalışan siteleri kazıyabilir mi?
Evet, render seçeneği sunuyorsa kazıyabilir: sayfayı headless tarayıcıda açar ve JavaScript'in doldurduğu içeriği döndürür. Render edilen istekler daha yavaştır ve çoğu zaman daha pahalıdır; önce verinin düz HTML'de olup olmadığına bakın.
Web scraping API ne kadar tutar?
Maliyeti, ilan edilen fiyattan çok fiyatlandırma modeli belirler. Hizmetler istek başına, başarılı istek başına ya da kredi üzerinden ücret alır; render ve residential IP'ler çoğu zaman bir sayfanın maliyetini katlar. Kendi hedeflerinizde kullanılabilir 1.000 sayfanın maliyetini karşılaştırın.
Web scraping API kullanmak yasal mı?
Hizmeti kullanmak hukuki bir sorun değildir; önemli olan onunla ne topladığınızdır. Hedef sitenin şartları, robots.txt dosyası ve veri koruma hukuku, sayfaları kendiniz kazımışsınız gibi sizin için geçerlidir. Belirli bir proje için kendi ülkenizdeki bir avukata danışın.
Özet
Web scraping API, hizmet olarak satılan scraping'dir: IP adreslerini, render'ı, yeniden denemeleri, engel tespitini ve ayrıştırmayı üstlenir ve sonucu HTML, JSON ya da Markdown olarak döndürür. Çok sayıda site söz konusuysa ve ekip küçükse hızlı yol budur; birkaç siteden sürekli yüksek hacimde veri çekiyorsanız kendi scraper'ınız ve proxy'leriniz daha ucuza gelir. Neyin başarılı istek diye ücretlendirildiğini kontrol edin ve dönen veriyi doğrulayın. Web Scraper API'miz hakkında konuşmak için satış ekibimizle iletişime geçin.