Bir distribütörün operasyon ekibi her sabah aynı işle başlar: biri tedarikçi portalına girer, dünkü fiyat listesini indirir ve değişiklikleri API'si olmayan bir ERP sistemine elle işler. Koridorun öbür ucundaki analiz ekibi ise aynı ürünlerin fiyatlarını yirmi herkese açık perakende sitesinden, her gün, tek bir tabloda görmek istiyor. İki işe de "otomasyon" deniyor, ama iki ayrı araç gerektiriyorlar: portalı ekran ekran kullanan bir yazılım robotu ile herkese açık sayfaları HTTP yanıtı olarak okuyan bir scraper.
Bu yazıda RPA'nın ve web scraping'in (veri kazıma) ne olduğunu, nasıl çalıştıklarını, nerede ayrıldıklarını, nerede kesiştiklerini, hangisinin ne zaman kazandığını, sorumluluğun kimde olması gerektiğini, proxy'nin nereye oturduğunu ve yapay zekâ ajanlarının neyi değiştirdiğini anlatıyoruz. Sağlayıcı bilgileri 9 Kasım 2026'da okunan UiPath, Automation Anywhere ve Microsoft belgelerinden alındı.
RPA nedir?
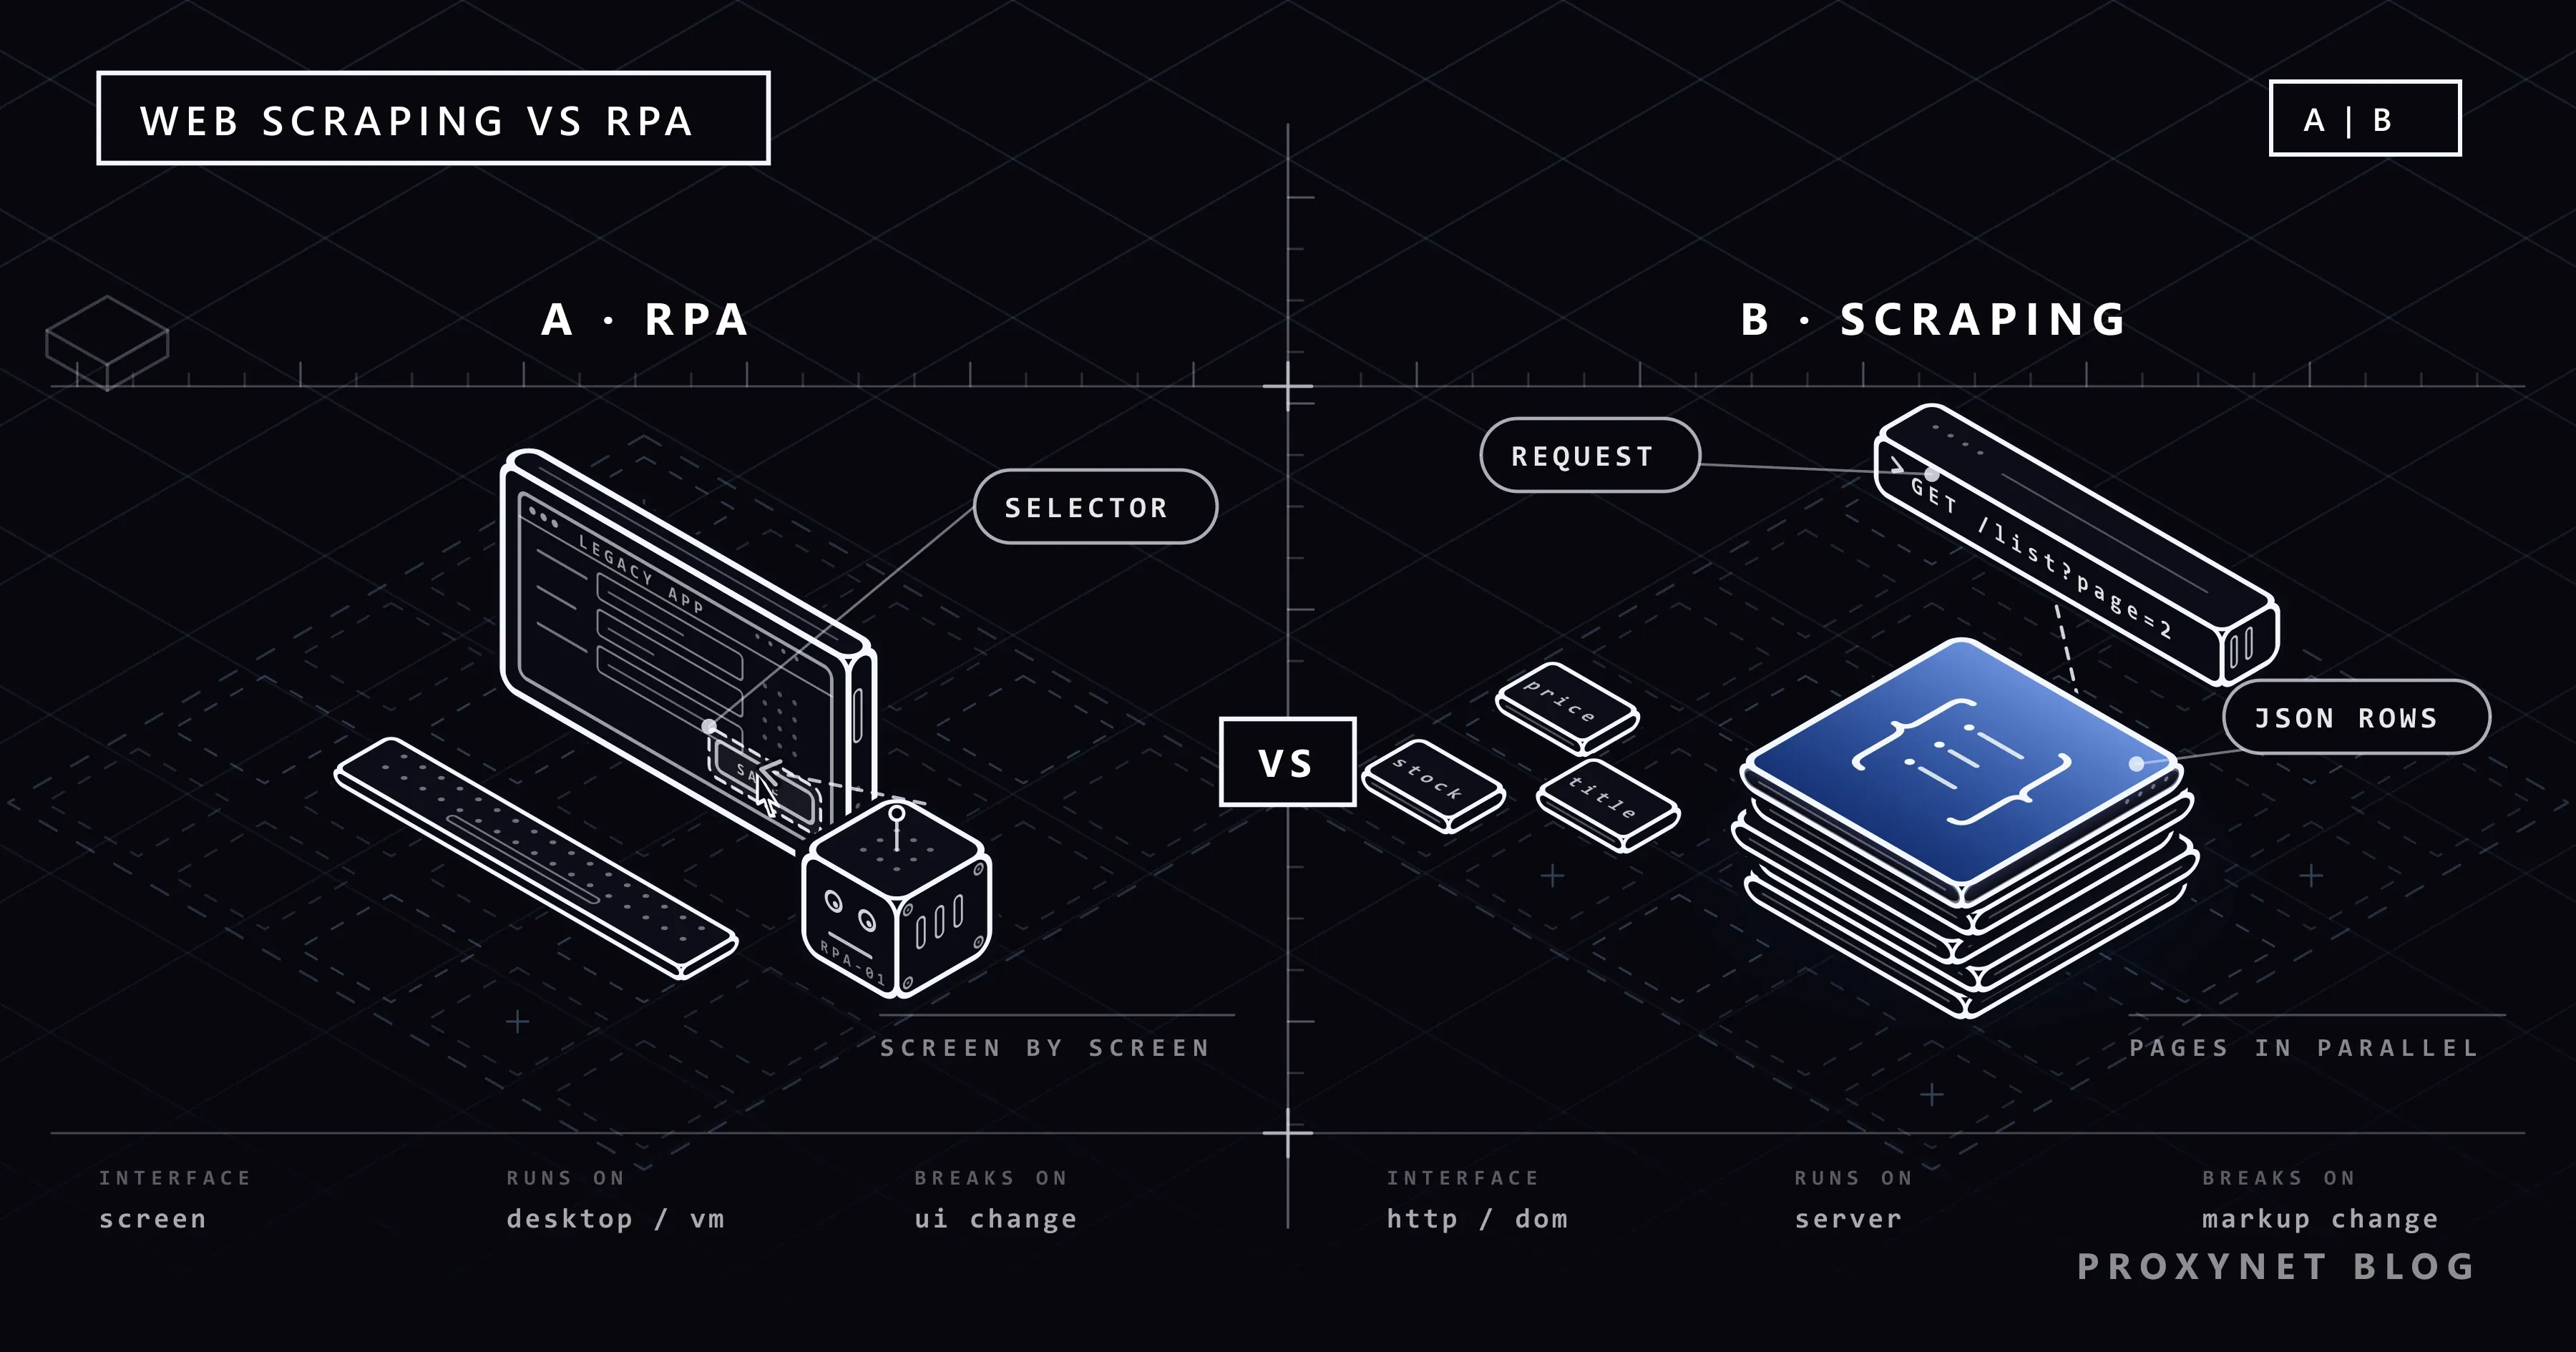
RPA (Robotic Process Automation, robotik süreç otomasyonu), tekrarlı ve kurallı işleri başka yazılımları bir insan gibi kullanarak otomatikleştiren yazılımdır. Buradaki "robot" bir programdır: uygulamayı açar, bir düğmeyi ya da alanı bulur, tıklar, yazar, bir değeri kopyalayıp başka yere yapıştırır. Kullanıcı arayüzü düzeyinde çalışmak, birbiriyle konuşmak üzere tasarlanmamış sistemleri birbirine bağlamasını sağlar.
Terimlerin bir standardı bile var. IEEE 2755-2017, yani IEEE Guide for Terms and Concepts in Intelligent Process Automation, yazılım tabanlı akıllı süreç otomasyonunun terimlerini tutarlı tutmak için 28 Eylül 2017'de yayımlandı ve hâlâ yürürlükte listeleniyor. UiPath'in kendi tanımı da buna yakın: RPA "veri girişi ve sistem entegrasyonu gibi tekrarlı, kurallı görevleri otomatikleştirmek için yazılım robotları kullanır" ve "dijital sistemlerdeki insan eylemlerini taklit eder". Automation Anywhere ise RPA'yı "doğası gereği kurallı" diye tanımlıyor ve kökenini 1990'ların tuş vuruşu makrolarına dayandırıyor.
Robotlar iki türlüdür. Attended (katılımlı) robot, bir insanla aynı makinede çalışır: kullanıcı onu bir düğme ya da kısayol tuşuyla başlatır, girdileri verir ve istisnaları kendisi çözer; Automation Anywhere'in Automation 360 belgesi bunu böyle anlatıyor. Unattended (katılımsız) robot ise kendi başına, çoğunlukla ona ayrılmış bir makinede, bir zamanlama, API çağrısı ya da olayla tetiklenerek çalışır; UiPath bu süreçleri yönetim sunucusu Orchestrator "üzerinden denetlenen" ve ayrı lisanslı süreçler olarak tarif ediyor.
Web scraping nedir?
Web scraping, web sayfalarının bir programla alınması ve içlerinden yapılandırılmış verinin çıkarılmasıdır. Scraper, bir tarayıcının göndereceği HTTP isteğini gönderir; HTML'i ya da sayfanın arka planda yüklediği JSON'u alır, aradığı alanları seçer ve satır olarak kaydeder. Döngüde ekran yoktur: program sayfanın piksellerini değil, kodunu okur. Hattın tamamını Web Scraping (Veri Kazıma) Nedir ve Nasıl Çalışır? yazımızda anlattık.
İkisi nasıl çalışır?
Bir RPA süreci:
- Akışı tasarlayın. Bir geliştirici ya da iş kullanıcısı tıklamaları bir kez kaydeder ya da görsel tasarımcıdaki hazır eylemleri birleştirir, sonra "eşiği aşan faturaları onaya gönder" gibi kuralları ekler.
- Her adımı bir seçiciyle arayüz öğesine bağlayın. UiPath'in belgesi seçiciyi (selector) "bir grafik arayüz öğesinin ve üst öğelerinin niteliklerini" saklayan bir XML parçası olarak tanımlar; Power Automate ise seçiciyi öğenin uygulama hiyerarşisindeki yerinden kurar ve ilki başarısız olunca sıradaki seçiciyi dener.
- Robotu bir masaüstünde ya da sanal makinede çalıştırın. Katılımlı çalıştırma kullanıcının oturumunu kullanır. Katılımsız çalıştırma kendi makinesini ister: Power Automate kayıtlı bir bağlantıyla oturum açar, bir uzak masaüstü oturumu açar, ekranı kilitli tutar ve sonunda oturumu kapatır; Windows 10 ve 11'de etkin bir kullanıcı oturumu varsa, kilitli olsa bile, başlamaz (Microsoft Learn).
- İstisnaları bir insana devredin. Seçici hiçbir şey bulamadığında ya da bir değer denetimden geçemediğinde robot o kaydı bir insan için kuyruğa bırakır.
Bir web scraping işi:
- İstek. robots.txt ve kullanım şartlarına baktıktan sonra bir URL listesi için ölçülü hızda, zaman aşımlı ve dürüst bir User-Agent taşıyan HTTP istekleri.
- Ayrıştırma. HTML bir ağaca dönüşür; alanlar CSS seçicileri ya da XPath ile seçilir ya da sayfanın kendi çağırdığı JSON uç noktasından okunur.
- Normalleştirme. Fiyatlar tek para biriminde sayıya, tarihler tek biçime dönüşür; yinelenen kayıtlar tekleşir.
- Kaydet ve tekrarla. Satırlar bir dosyaya ya da veritabanına yazılır, iş bir zamanlamayla yeniden çalışır.
Web scraping ve RPA karşılaştırma tablosu
| Ölçüt | RPA | Web scraping |
|---|---|---|
| Amaç | Uygulamalar arasında bir iş sürecini otomatikleştirmek | Web sayfalarından veri toplamak |
| Çalıştığı düzey | Kullanıcı arayüzü: pencereler, düğmeler, alanlar | HTTP yanıtları: HTML, JSON |
| Ekran gerekir mi | Evet, bir masaüstü ya da VM oturumu | Hayır |
| Ölçek | Robot başına bir ekran | Tek sunucudan çok sayıda paralel istek |
| Ne zaman bozulur | Pencere, etiket, yerleşim ya da çözünürlük değişince | HTML değişince; site hız sınırı koyunca |
| Maliyet modeli | Robot ya da çalışma zamanı başına lisans, makine, geliştirici | Mühendislik süresi, sunucu, proxy, bakım |
| Tipik sahibi | Operasyon, finans ya da BT otomasyonu | Veri ya da mühendislik ekibi |
| Çıktı | Tamamlanmış bir süreç | Satırlardan oluşan bir veri kümesi |
RPA ile web scraping nerede kesişir?
RPA paketlerinin çoğu içinde küçük bir scraper taşır; veri ekiplerinin çoğu da er geç bir bota ihtiyaç duyar.
Herkese açık bir siteyi okuyan RPA botu. Power Automate'in Web sayfasından veri ayıkla (Extract data from web page) eylemi, başvuru sayfasına göre "web sayfasının belirli bölümlerindeki verileri tek bir değer, liste, satır veya tablo olarak" ayıklar, belirlenen sayıya kadar sayfalamayı izler ve sonucu bir değişkene ya da Excel elektronik tablosuna yazar. Bu, robotun yönettiği bir tarayıcı üzerinden scraping'dir: daha geniş bir sürecin içindeki birkaç sayfa için yeterli, günde on bin sayfa için yanlış araçtır; çünkü her sayfa teker teker çizilir.
Bir RPA sürecini besleyen scraper. Scraper rakip fiyatlarını toplar, analist karar verir, bot da yeni fiyatları içe aktarma işlevi olmayan bir fiyatlama aracına yazar: hacmi scraper taşır, son adımı bot atar.
İkisini de gereksiz kılan resmî API. Tedarikçi portalının bir API'si varsa tıklayıp duran bot saf yüktür; bir site veri akışı yayımlıyorsa onu kazımak da öyle. Bu kararı Web Scraping ve API Farkı yazımızda ele aldık.
Hangisi ne zaman kazanır?
RPA, iş başka hiçbir yoldan ulaşamadığınız sistemlerin içinde yaşıyorsa kazanır:
- API'si olmayan eski uygulamalar: terminal öykünücüleri, Citrix üzerinden yayımlanan uygulamalar, 2004 tarihli bir Windows programı; Microsoft, masaüstü akışlarının otomatikleştirdiği eski uygulamalar arasında terminal öykünücülerini sayar.
- Lisanslı masaüstü yazılımları: kullanıcı programı kullanabilir ama programatik erişim yoktur.
- İnsan onayı gerektiren adımlar: katılımlı robot işi hazırlar, bir insan onaylar.
- Veri kümesi değil, süreç: hedef "burada bir tablo var" değil, "fatura işlendi"dir.
Web scraping, veri herkese açıksa, hacim büyükse ve kaynaklar çoksa kazanır:
- Ölçek: günde binlerce ürün sayfası sıradan bir scraping işi, olanaksız bir RPA işidir.
- İzleme: saatlik denetim, masaüstü oturumu isteyen bir robotu değil, sunucuda çalışan bir programı gerektirir.
- Veri kümeleri: haftalarca toplanan veri; çıktı zaten bir tablodur.
- Çok ülkeli görünüm: scraper her isteği doğru ülkedeki bir çıkıştan gönderebilir; tek bir ofisteki masaüstü robotu bunu yapamaz.
Maliyetleri nedir, neyle bozulurlar?
RPA maliyeti lisansla başlar; robot, kullanıcı ya da çalışma zamanı başına satılır ve katılımsız çalıştırmalar genellikle üst kademededir; Power Automate, katılımsız masaüstü akışları için Process planını şart koşar. Sonra makineler, bir geliştirici ve istisnaları çözen kullanıcılar gelir. Scraping maliyeti ise ayrıştırıcılar için mühendislik süresi, sunucular, hedeflerin gerektirdiği yerde proxy trafiği ve bir seçicinin sessizce boş döndüğünü fark eden izleme düzenidir.
RPA'yı bozan ekrandır: adı değişen bir düğme, yeni bir alan, beklenmedik bir iletişim kutusu ya da katılımsız makinede farklı bir çözünürlük; Microsoft, bunun hedef öğeyi gizleyebileceği ya da robotu yanlış öğeyle etkileştirebileceği konusunda uyarır. UiPath'in seçici kılavuzu da bir niteliğin değeri çalıştırmadan çalıştırmaya değiştiğinde "seçicinin öğeyi doğru tanımlayamayacağını" yazar. Scraping'i bozan ise işaretleme ve kapıdaki bekçidir: bir yeniden tasarım ayrıştırıcınızın dayandığı sınıfların adını değiştirir; aynı adresten çok istek gören site 429 Too Many Requests döner ya da bir bot koruması sayfası gösterir.
Robotun sahibi kim?
RPA botu, sistemlerinizin içinde bir çalışanın ya da bir servis hesabının kimlik bilgileriyle çalışır: Power Automate'in katılımsız çalıştırmaları masaüstü akışı bağlantısında saklanan kimlik bilgileriyle oturum açar; Automation Anywhere'in katılımsız botlarını Control Room zamanlayıcısı, API çağrıları ya da olaylar başlatır. Ona en düşük yetkiyi verin, her çalıştırmayı kayda geçirin ve istisnalar birikince birine haber gitsin.
Scraper ise başkasının sitesine bir ziyaretçi olarak gider; o sitenin kullanım şartlarına, robots.txt dosyasına ve kişisel verilerin korunması mevzuatına tabidir. Fiyat ve stok herkese açık ticari veridir; insanların ad, telefon ve e-posta adresleri ise GDPR ve Türkiye'deki KVKK kapsamında kişisel veridir ve örneklerimiz bunları hiçbir zaman toplamaz. Hızı ölçülü tutun, scraper'ın kim olduğunu dürüstçe belirtin ve istendiğinde durun. Bu yazı kuralları anlatır; belirli bir proje için bir avukata danışın.
Proxy nerede devreye girer?
Proxy, iki aracın da yalnızca web'e bakan tarafında önemlidir. Bir veri merkezinde çalışan robot ya da scraper, herkese açık sitelere o veri merkezinin IP adresinden ulaşır ve o konumun gördüğü fiyatı ve dili görür; sürecin bir pazarın yerel sürümünü görmesi gerekiyorsa ona o pazarda bir çıkış verin.
Bir iş ortağı portalına giriş yapan ya da adresleri whitelist'e alan bir ortak API'sini çağıran robot ya da scraper için ISP Proxy tek bir sabit IP sağlar; IP başına satılan bu ürünlerde erişim varsayılan olarak adını verdiğiniz hedef sitelerle sınırlıdır, tüm sitelere erişim ücretli bir ek pakettir.
Bir sitenin belirli bir ülkedeki ya da şehirdeki müşterilere nasıl göründüğünü okumak içinse o konuma hedeflenmiş Residential Proxy yerel fiyatları gösterir. Proxy, isteğin nereden geldiğini değiştirir; sitenin neye izin verdiğini değil.
RPA ve yapay zekâ ajanları: ne değişiyor?
Yapay zekâ ajanı kendi adımlarını kendi planlar; RPA botu ise kendisine verilen adımları izler. Bir dil modelinin çevresine kurulmuş ajan hedefe bakar, sıradaki aracı seçer, sonucu okur ve uyum sağlar; bu yüzden hiç görmediği bir pencereyle baş edebilir, ama her adımda bir model çağrısına mal olur ve yarın başka bir yol tutabilir. RPA akışı her seferinde aynı şeyi yapar. Ajan döngüsünün nasıl işlediğini ve öngörülebilir işlerin neden hâlâ sabit bir iş akışına ait olduğunu AI Ajanları Nasıl Çalışır? yazımızda anlattık.
Sağlayıcılar ikisini bir araya getiriyor (UiPath, robotlarını genişleten yapay zekâ yetenekleri arasında bilgisayarlı görüyü ve belge anlamayı sayıyor); ayakta kalan kalıp, bir üretim sisteminde serbestçe tıklayan bir ajan değil, tek bir adımında model kullanan sabit bir akıştır.
Sık yapılan hatalar
- On bin sayfayı RPA botuyla kazımak. Her sayfa, meşgul bir makinede çizilen bir tarayıcıya mal olur; hacmi scraper'a taşıyın.
- API'si olan bir iç sistem için scraper yazmak. Bakımı boşuna üstlenirsiniz; şartların izin verdiği yol da API'dir.
- Robotu kişisel bir hesapla çalıştırmak. O kişi ayrıldığında süreç durur ve denetim izi bulanıklaşır.
- Scraper'ı sitenin kurallarından muaf saymak. Kullanım şartları, robots.txt ve hız sınırları bir programa, bir ziyaretçiye uygulandığı gibi uygulanır.
Karar rehberi
| İhtiyaç | Öneri |
|---|---|
| API'si olmayan iki iç sistem arasında veri taşımak | RPA |
| Sağlayıcı bir API ya da veri akışı sunuyor | API'yi kullanın |
| Her gün yüzlerce siteden herkese açık fiyatlar | Web scraping, ülke başına çıkışla |
| Her kaydı bir insan onaylamalı | Katılımlı RPA |
| Sabit bir sürecin tek adımında yapılandırılmamış belgeler | O adımda model kullanan RPA |
| Önceden çizilemeyen adımlar | Sınırları ve onayı olan bir yapay zekâ ajanı |
| Çok sayıda site, ayrıştırıcı bakacak ekip yok | Yönetilen bir scraping API'si |
Sıkça sorulan sorular
RPA nedir, ne işe yarar?
RPA, robotik süreç otomasyonudur: kurallı görevleri, başka programları bir insan gibi kullanıcı arayüzünden kullanarak yerine getiren yazılım robotlarıdır. API'si olmayan sistemler arasında veri taşır, fatura işler ve benzeri tekrarlı arka ofis süreçlerini yürütür.
Web scraping bir RPA türü müdür?
Hayır. Web scraping, web sayfalarını HTTP üzerinden okuyup yanıttan alan çıkarır; RPA ise uygulama ekranlarında işlem yaparak iş süreçlerini otomatikleştirir. İkisi sahipleri ve maliyetleri farklı, ayrı araçlardır.
RPA araçlarıyla web sitesinden veri çekilebilir mi?
Evet, küçük ölçekte. Power Automate'in Web sayfasından veri ayıkla eylemi bir sayfadan tek değer, liste ya da tablo çeker; günde binlerce sayfa için özel bir scraper daha hızlı ve daha ucuzdur, çünkü her sayfa için bir ekran çizmez.
RPA mı API mi?
Sistem ihtiyacınız olan veriyi içeren bir API sunuyorsa her zaman API: o, sağlayıcının sürdürdüğü bir sözleşmedir; robot ise her an değişebilecek bir ekrana bağımlıdır. RPA, eski ya da lisanslı masaüstü yazılımları gibi API'si olmayan sistemler için yedek yoldur.
Yapay zekâ ajanları RPA'nın yerini alır mı?
Öngörülebilir süreçlerde hayır. Ajan kendi adımlarına kendi karar verir; bu, önceden yazılamayan işlerde yardımcı olur ama adım başına maliyet ekler ve sonucu daha az tekrarlanabilir kılar; sabit ve denetlenebilir bir süreç hâlâ tanımlı bir akışa aittir, çoğu zaman tek bir adımda model kullanılır.
Hangisi daha ucuz: RPA mı web scraping mi?
İşe bağlıdır. RPA lisans, makine ve geliştirici maliyeti taşır ve günde onlarca ya da yüzlerce kaydı olan süreçlere uyar; scraping mühendislik, sunucu ve proxy maliyeti taşır ve hacim büyüdükçe sayfa başına ucuzlar.
Özet
RPA, yazılımı ekranından kullanarak bir iş sürecini otomatikleştirir; API'si olmayan sistemlere ulaşır, bedeli o ekrana bağımlı kalmaktır. Web scraping, herkese açık sayfalardan HTTP üzerinden veri toplar; binlerce sayfaya ve pek çok ülkeye ölçeklenir, bedeli ayrıştırıcıların bakımı ve her sitenin kurallarına uymaktır. Önce API var mı diye bakın, sonra iç süreçler için RPA'yı, herkese açık web verisi için scraping'i kullanın. Ayrıştırıcı bakmak yerine çıkarılmış kayıtları hazır almak isterseniz Web Scraping API sayfamız satış ekibimiz üzerinden yönetilen sayfa çıkarımı sunar.