Eine HR-Analystin soll beantworten, ob ihr Unternehmen seine Data Engineers marktgerecht bezahlt. Die Gehaltsstudie, die sie hat, ist ein Jahr alt und steckt die Rolle in eine breite Jobfamilie; die Jobbörsen dagegen enthalten Hunderte ausgeschriebene Gehaltsspannen für genau diesen Titel, veröffentlicht in diesem Monat. Welche Wettbewerber dieselben Fähigkeiten suchen, beantwortet sich am selben Ort: in Stellenanzeigen, verstreut über Karriereseiten, Jobbörsen und Aggregatoren.
Dieser Beitrag erklärt, was Stellenanzeigendaten sind, wer sie aufbaut oder kauft und woher sie kommen, geordnet von amtlichen Statistiken und öffentlichen Karriereseiten-Endpoints bis zu gescrapten Jobbörsen-Seiten; danach geht es um Normalisierung, Qualitätsfallen, den rechtlichen Rahmen, die Rolle von Proxys und sechs kurze Antworten.
Was sind Stellenanzeigendaten?
Stellenanzeigendaten sind der Inhalt von Online-Stellenanzeigen, erfasst als strukturierte Felder. Eine Anzeige wird für Bewerber geschrieben; der Datensatz schreibt sie für eine Abfrage um, sodass aus „Senior Data Engineer, Berlin, hybrid“ eine Zeile wird, die sich zählen, vergleichen und verfolgen lässt.
Die Kernfelder sind bei jeder Quelle dieselben:
- Titel wie geschrieben, plus ein normalisierter Beruf
- Arbeitgeber: Name und ob der Inserent der Arbeitgeber selbst oder eine Agentur ist
- Ort: Stadt, Land und eine Kennzeichnung für Remote oder Hybrid
- Gehalt: Minimum, Maximum, Währung und Zeitraum, soweit angegeben
- Seniorität und Vertragsart
- Fähigkeiten und Anforderungen, aus der Beschreibung extrahiert
- Datumsangaben: zuerst gesehen, zuletzt gesehen, Schluss oder Entfernung
- Quelle: Jobbörse oder Karriereseite und eine stabile URL
Zwei Felder tragen den größten Teil des Werts und sind am schwersten richtig zu erfassen: die Datumsangaben, die aus einem Haufen Anzeigen eine Zeitreihe machen, und der normalisierte Titel, der „Growth Hacker“ und „Digital Marketing Specialist“ als einen Beruf zählt.
Wer nutzt Stellenanzeigendaten, und wofür?
Vier Gruppen bauen sie auf oder kaufen sie, jede mit einer anderen Frage.
Vergütungs- und HR-Teams vergleichen Gehälter. Wo Arbeitgeber Spannen veröffentlichen, zeigen ausgeschriebene Gehälter die aktuellen Marktsätze nach Titel, Stadt und Seniorität und machen sichtbar, welche Fähigkeiten Wettbewerber verlangen.
Arbeitsmarktforscher lesen Anzeigen als Nachfrageindikator. Das Hiring Lab von Indeed, die Forschungsabteilung der Jobbörse, veröffentlicht Analysen auf Basis der eigenen Anzeigen; Lightcast verkauft Arbeitsmarktanalysen, die auf einem sehr großen Anzeigenarchiv beruhen.
Strategie- und Vertriebsteams behandeln Einstellungen als Signal für die Roadmap. Ein Wettbewerber, der zwanzig Stellen mit einer neuen Cloud-Plattform, einem neuen Markt oder einer neuen Sprache ausschreibt, kündigt einen Plan ohne Pressemitteilung an, und ein Vertriebsteam liest dasselbe Signal, um Unternehmen zu finden, die in einer Funktion einstellen, an die es verkauft.
Recruiter, Aggregatoren und Investoren. Aggregatoren sammeln Anzeigen, um sie zu listen, Personalvermittler beobachten, wo Stellen frei werden, und Investmentanalysten zählen Einstellungsvolumen als eine der webbasierten Arten alternativer Daten.
Woher kommen Stellenanzeigendaten?
Quellen ordnen sich nach Zuverlässigkeit und Zulässigkeit, also umgekehrt zu der Reihenfolge, in der die meisten Teams anfangen.
1. Amtliche Statistiken zu offenen Stellen. Nationale Statistikämter messen die Arbeitskräftenachfrage direkt. In den USA liefert die JOLTS-Erhebung des Bureau of Labor Statistics monatliche Schätzungen zu offenen Stellen, Einstellungen und Abgängen; ihre Veröffentlichung vom 3. November 2026 bezifferte die offenen Stellen für September auf 7,5 Millionen. Die Statistik der offenen Stellen von Eurostat weist jedes Quartal den Anteil unbesetzter Stellen aus (2,1 % im Euroraum im zweiten Quartal 2026). In Türkiye veröffentlicht TurkStat monatliche Arbeitskräftestatistiken, und das monatliche Bulletin von ISKUR, der öffentlichen Arbeitsagentur, zählt die offenen Stellen, die Arbeitgeber dort melden, nach Beruf und Branche. Diese Reihen sind kostenlos und zitierfähig, aber aggregiert: keine Titel, Fähigkeiten oder Arbeitgeber.
2. Karriereseiten der Arbeitgeber über ihr ATS. Viele Unternehmen betreiben ihre Karriereseite auf einem Bewerbermanagementsystem (Applicant Tracking System, ATS), das ihre Anzeigen als öffentliches JSON ausgibt. Greenhouse dokumentiert eine Job Board API, deren GET-Endpoints keine Authentifizierung brauchen: https://boards-api.greenhouse.io/v1/boards/{board_token}/jobs?content=true liefert jede offene Stelle mit Titel, Ort, updated_at, Beschreibung, Abteilungen und Büros, und pay_transparency=true ergänzt angegebene Gehaltsspannen.
Die Postings API von Lever funktioniert genauso: https://api.lever.co/v0/postings/{site}?mode=json listet veröffentlichte Anzeigen mit categories (Ort, Team, Beschäftigungsart), workplaceType, descriptionPlain und einem optionalen salaryRange. Für namentlich bekannte Arbeitgeber sind diese Endpoints die sauberste Quelle, die es gibt.
3. Aggregator-APIs. Die API von Adzuna zum Beispiel bietet Jobsuche, Kategorien und Gehaltshistogramme pro Land hinter einer app_id und einem app_key, die Sie per Registrierung erhalten. Aggregatordaten decken viele Arbeitgeber auf einmal ab, übernehmen aber die Abdeckung, die Deduplizierung und die Lizenzbedingungen des Aggregators. LinkedIn ist die Ausnahme, nach der am häufigsten gefragt wird: Seine Nutzervereinbarung (Abschnitt 8.2, „Don'ts“, also Verbote) untersagt das Scrapen oder Kopieren des Dienstes, auch mit Crawlern und Browser-Plugins; seine Anzeigen werden daher über die eigene Jobsuche gelesen, nicht gesammelt.
4. Öffentliche Jobbörsen-Seiten. Alles andere ist eine Webseite ohne Feed. Sie zu erfassen ist Web Scraping, begrenzt durch die Nutzungsbedingungen der Website und ihre robots.txt; wo beide es erlauben, sind die Daten aktuell und detailliert, aber unstrukturiert, sodass die Normalisierungsarbeit unten bei Ihnen liegt.
Wie werden Stellenanzeigendaten erfasst und normalisiert?
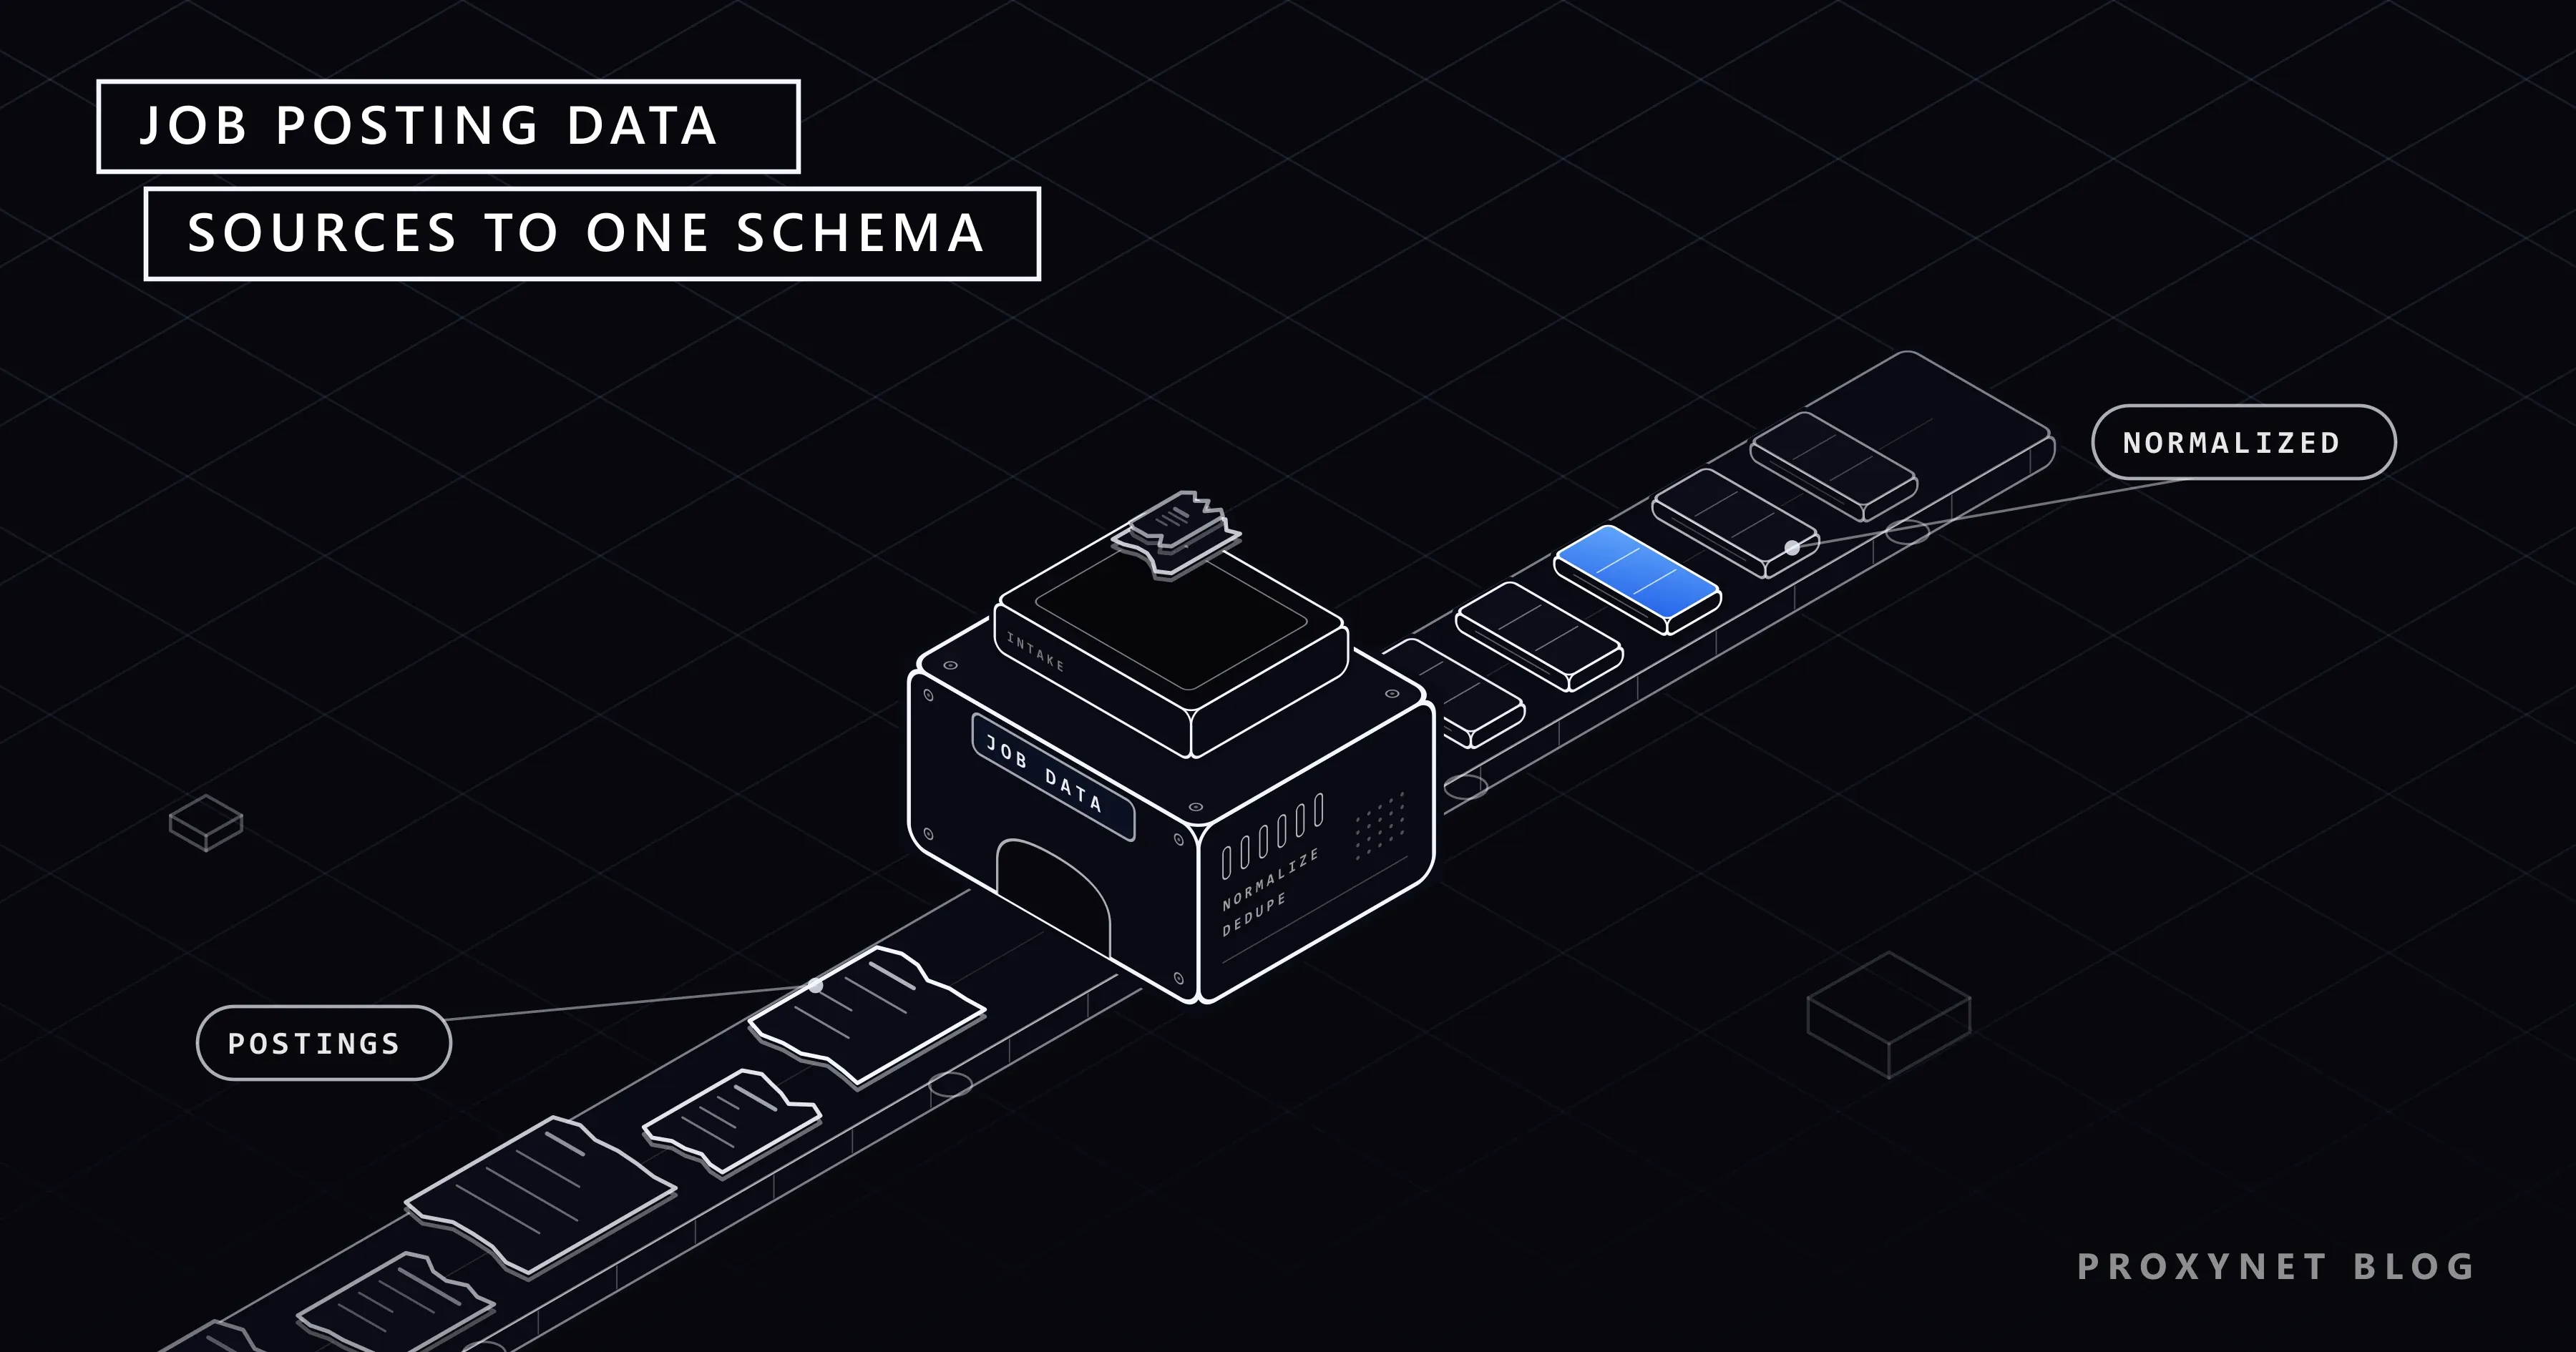
Eine funktionierende Pipeline hat acht Schritte; die Erfassung ist der kleinste.
- Zuerst das Schema festlegen. Legen Sie Felder und Typen fest, bevor Sie eine Quelle anfassen; ergänzen Sie jeden Datensatz um
source,source_url,first_seenundlast_seen. - Quellen und Zugangsweg auflisten. Amtliche Reihe, ATS-Endpoint, lizenzierte API oder öffentliche Seite; die geltenden Bedingungen und die Abfragefrequenz.
- Den Rhythmus festlegen. Anzeigen bleiben wochenlang online, manche werden erneuert, einige verschwinden innerhalb von Tagen; ein täglicher Durchlauf erfasst die Datumsangaben, für Volumentrends reicht ein wöchentlicher.
- Titel auf eine Berufsklassifikation normalisieren. Ordnen Sie Freitexttitel ESCO zu, der Klassifikation der Europäischen Kommission mit 3.039 Berufen und 13.939 Fähigkeiten in 28 Sprachen, kostenlos und mit API; O*NET, der Datenbank des US-Arbeitsministeriums mit mehr als 900 Berufen; oder der ISCO-08 der ILO mit ihren zehn Hauptgruppen. Ein Wörterbuch bekannter Titel erledigt den ersten Durchgang, ein Textklassifikator den Rest.
- Gehalt parsen. Extrahieren Sie Minimum, Maximum, Währung und Zeitraum, rechnen Sie Stunden- und Monatsangaben in eine Jahresspanne um und speichern Sie „nicht angegeben“ als Wert, denn seine Häufigkeit ist selbst ein Signal.
- Deduplizieren. Dieselbe Stelle erscheint auf der Karriereseite, zwei Jobbörsen und einem Aggregator, oft unter verschiedenen Titeln; gleichen Sie über Arbeitgeber, normalisierten Titel, Ort und einen Fingerabdruck der Beschreibung ab und behalten Sie einen Datensatz mit allen Quell-URLs.
- Signale ableiten. Neue Anzeigen pro Woche nach Arbeitgeber und Beruf, mediane Tage online (ein Ersatz für die Besetzungsdauer), Anteil mit Gehaltsangabe, Häufigkeit von Fähigkeiten.
- Jeden Lauf prüfen. Zeilenzahl pro Quelle, Anteil der Datensätze ohne Gehalt oder Ort, zehn zufällige Datensätze gegen die Live-Seite geprüft.
Ein normalisierter Datensatz für einen fiktiven Arbeitgeber sieht so aus:
{
  "posting_id": "example-ltd-2026-11-0417",
  "title_raw": "Sr. Data Engineer (Hybrid)",
  "occupation": "Data engineer",
  "employer": "Example Ltd",
  "poster_type": "employer",
  "location": { "city": "Berlin", "country": "DE", "workplace": "hybrid" },
  "salary": { "min": 85000, "max": 100000, "currency": "EUR", "period": "year", "disclosed": true },
  "seniority": "senior",
  "contract": "full-time",
  "skills": ["Spark", "Airflow", "SQL", "Python"],
  "first_seen": "2026-11-02",
  "last_seen": "2026-11-09",
  "closed_at": null,
  "sources": ["https://example.com/careers/417", "https://jobs.example.net/view/88213"]
}
Quellen für Stellenanzeigendaten im Vergleich
| Quelle | Abdeckung | Aktualität | Einschränkung |
|---|---|---|---|
| Amtliche Statistiken (JOLTS, Eurostat, ISKUR) | Gesamte Wirtschaft, aggregiert | Monatlich oder vierteljährlich | Keine Titel, Fähigkeiten oder Arbeitgeber |
| Öffentliche ATS-Endpoints (Greenhouse, Lever) | Namentlich bekannte Arbeitgeber, jede offene Stelle | Live | Ein Board pro Unternehmen; die Liste bauen Sie |
| Aggregator-APIs | Viele Arbeitgeber pro Land | Stunden bis Tage | Lizenzbedingungen, Deduplizierung des Anbieters |
| Öffentliche Jobbörsen-Seiten | Alles Veröffentlichte | So oft Sie abfragen | Nutzungsbedingungen, robots.txt, Parsing-Aufwand |
Was geht bei Stellenanzeigendaten schief?
Anzeigen sind Werbung, keine offenen Stellen; Analysen scheitern in der Lücke zwischen beidem.
Ghost Postings und Dauerinserate. Ein Kurzdossier des US Congressional Research Service von 2025 definiert „Ghost“-Stellenanzeigen als Anzeigen für Stellen, die nicht existieren oder die der Arbeitgeber nicht sofort besetzen will, stellt fest, dass keine amtliche Statistik sie misst, und warnt, dass die Umfragen mit Prozentzahlen überwiegend von Firmen stammen, die Recruiting-Tools verkaufen. In den Daten erscheinen sie als Anzeigen, die monatelang offen sind, in festem Rhythmus wieder auftauchen oder überall gleichzeitig geschaltet werden.
Erneuerungen und Agentur-Duplikate. Jobbörsen setzen das Datum zurück, wenn ein Arbeitgeber eine Anzeige erneuert, sodass „vor 2 Tagen veröffentlicht“ eine drei Monate alte Stelle sein kann; Agenturen schalten dieselbe Kundenstelle unter eigenem Namen, manchmal mehrere auf einmal. Führen Sie Ihr eigenes first_seen, kennzeichnen Sie Agentur-Inserenten und zählen Sie eine Stelle einmal.
Fehlendes Gehalt. Viele Anzeigen nennen kein Gehalt, und die, die es tun, sind keine Zufallsstichprobe. Weisen Sie neben jeder Gehaltsstatistik die Angabequote aus.
Titelinflation und -drift. Dieselbe Arbeit wird je nach Markt und Jahr als Engineer, Developer, Architect oder Consultant ausgeschrieben; ohne Klassifikation sieht ein Unternehmen, das seine Entwickler umbenannt hat, aus wie eines, das keine mehr einstellt.
Ist das Erfassen von Stellenanzeigendaten legal?
Drei Ebenen gelten: personenbezogene Daten, Nutzungsbedingungen und das Recht des Landes, in dem Sie tätig sind. Nichts davon ist eine Rechtsberatung.
Personenbezogene Daten. Eine Anzeige handelt von einer Stelle, enthält aber oft Name, E-Mail-Adresse oder Telefonnummer eines Recruiters. Das sind personenbezogene Daten, und sowohl die DSGVO (Artikel 6) als auch das KVKK in Türkiye erlauben die Verarbeitung nur auf einer Rechtsgrundlage; ein Arbeitsmarktdatensatz braucht sie nicht, also erfassen Sie sie nie und entfernen Sie sie beim Einlesen aus den Beschreibungen. Personenbezogene Daten in Scraping-Datensätzen zeigt, wie Sie maskieren, was durchrutscht.
Nutzungsbedingungen. Viele Jobbörsen verbieten automatisierten Zugriff in ihren Bedingungen, LinkedIn ausdrücklich. Die Entscheidung hiQ Labs gegen LinkedIn (US-Berufungsgericht für den Ninth Circuit, 2022) kam zu dem Schluss, dass der Begriff „ohne Autorisierung“ im Computer Fraud and Abuse Act nicht auf öffentliche Websites anwendbar ist; sie betraf ein US-Strafgesetz, nicht die Bedingungen einer Website, die eine eigene Frage bleiben.
Lokales Recht. Datenbankrechte, Wettbewerbsrecht und Vorschriften für Stellenanzeigen unterscheiden sich je nach Land. Lassen Sie vor dem Start eines Jobdaten-Produkts die Quellen und die jeweils geltenden Bedingungen von einem Anwalt prüfen.
Wo passt ein Proxy in die Erfassung von Jobdaten?
Ein Proxy bestimmt, von welcher Netzwerkadresse eine Anfrage ausgeht; bei Jobdaten ist das in zwei Situationen wichtig.
Erstens lokalisieren Jobbörsen: Viele zeigen standardmäßig das Land des Besuchers, und manche ändern Währung, Sprache oder Gehaltsanzeige je nach Standort. Um festzuhalten, was ein Bewerber in jedem Markt sieht, muss die Anfrage aus diesem Markt kommen; mit Residential-Proxy-Adressen wählen Sie Land und Stadt pro Anfrage, sodass sich eine Reihe für Deutschland nicht mit einer für Türkiye vermischt.
Zweitens verteilt sich das Volumen dünn: Tausend Karriereseiten bedeuten tausend kleine, rücksichtsvolle Jobs statt eines schweren. Statische JSON-Endpoints wie die ATS-Feeds oben passen zu Datacenter-Proxy-Adressen, deren Traffic ohne Kontingent läuft; Websites, die je nach Besucherland variieren, gehören auf Residential-Adressen. Ein Proxy ändert nichts daran, welche Quellen Sie lesen dürfen, wie oft eine Website Abfragen zulässt oder was ihre Bedingungen sagen.
Wenn Sie lieber normalisierte Zeilen erhalten als die Pipeline zu betreiben, übernimmt ein verwalteter Extraktionsdienst das Parsing und die Deduplizierung für Sie.
Häufige Fehler bei Stellenanzeigendaten
- Anzeigen als Einstellungen oder offene Stellen zählen; kalibrieren Sie Volumen an amtlichen Reihen.
- Mit Scraping anfangen, obwohl ATS-Endpoints und lizenzierte APIs dieselben Arbeitgeber abdecken.
- Dem Datum der Jobbörse vertrauen statt dem eigenen
first_seenundlast_seen. - Die Deduplizierung auslassen, sodass eine Stelle dreimal zählt.
- Nur Rohtitel behalten, sodass Trends in Umbenennungen verschwinden.
- Kontaktdaten von Recruitern erfassen, weil sie auf der Seite standen.
Entscheidungshilfe
| Bedarf | Weg |
|---|---|
| Arbeitskräftenachfrage für ein Land oder eine Branche | Amtliche Statistiken (JOLTS, Eurostat, ISKUR) |
| Einstellungspläne von fünfzig namentlich bekannten Wettbewerbern | Deren ATS-Endpoints, täglich abgefragt |
| Gehaltsspannen nach Titel und Stadt | Lizenzierte Aggregator-API plus ATS-Gehaltsfelder |
| Eine Jobbörse, wie Bewerber sie in jedem Land sehen | Residential-Proxys pro Land, im Rahmen ihrer Bedingungen |
| Tausende kleine Karriereseiten ohne Feed | Datacenter-Proxys mit maßvoller Rate oder ein verwalteter Feed |
| Zeilen heute, kein Pipeline-Team | Verwaltete Extraktion mit normalisiertem Schema |
Häufige Fragen
Ist Job-Scraping legal?
Öffentliche Stellenanzeigen zu erfassen ist in den meisten Ländern nicht an sich rechtswidrig; rechtswidrig wird ein Projekt, wenn es personenbezogene Daten ohne Rechtsgrundlage verarbeitet, die Nutzungsbedingungen einer Website verletzt oder lokale Regeln wie Datenbankrechte ignoriert. Amtliche Statistiken und öffentliche ATS-Endpoints tragen keines dieser Risiken.
Wo bekomme ich Stellenanzeigendaten kostenlos?
Aus amtlichen Statistiken (BLS JOLTS, Eurostats Statistik der offenen Stellen, das monatliche Bulletin von ISKUR) für Aggregate und aus den öffentlichen ATS-Endpoints der Arbeitgeber wie der Job Board API von Greenhouse und der Postings API von Lever für einzelne Anzeigen; keiner braucht einen API-Schlüssel. Kostenlose Datensätze auf Data-Science-Plattformen sind Momentaufnahmen, gut zum Üben, aber nicht für eine Zeitreihe.
Wie erkennt man Ghost Jobs?
Am Verhalten über die Zeit statt am Text: eine Anzeige, die monatelang offen ist, dieselbe Anzeige, die in festem Rhythmus neu angelegt wird, eine Stelle, die an jedem Standort gleichzeitig ausgeschrieben ist, und Arbeitgeber, deren Anzeigenzahl sich nie bewegt, während sich die Mitarbeiterzahl ändert. Keines ist allein ein Beweis; kombinieren Sie sie zu einem Score und weisen Sie ihn neben den Zahlen aus.
Wie oft ändern sich Stellenanzeigen?
Täglich, wenn Sie einzelne Anzeigen zählen: Jeden Tag erscheinen neue, andere werden geschlossen oder erneuert. Für Volumen nach Beruf oder Arbeitgeber reicht eine wöchentliche Erfassung; für genaue First-seen- und Last-seen-Daten, die das Signal zur Besetzungsdauer liefern, ist eine tägliche Abfrage nötig.
Darf ich LinkedIn-Jobs scrapen?
Nein. Die Nutzervereinbarung von LinkedIn untersagt das Scrapen oder Kopieren des Dienstes, auch mit Crawlern und Browser-Erweiterungen; ein so aufgebauter Datensatz verletzt die Bedingungen ab der ersten Anfrage. Um zu sehen, wie sich Anzeigen je nach Land unterscheiden, nutzen Sie die eigenen Suchfilter; LinkedIn-Jobs in einem anderen Land suchen zeigt, wie.
Stellenanzeigen-Datensatz oder Live-Scraping: Was ist besser?
Ein gekaufter Datensatz liefert Ihnen vom ersten Tag an Historie und die Deduplizierung eines Anbieters; die eigene Erfassung liefert die Felder, Quellen und den Rhythmus, die Sie wählen, ab heute. Teams, die Backfill brauchen, kaufen; Teams, die ein bestimmtes Schema oder Land brauchen, bauen selbst.
Fazit
Stellenanzeigendaten machen aus Werbung einen strukturierten, datierten Datensatz zur Arbeitskräftenachfrage: wer einstellt, für welchen Beruf, wo, zu welchem Gehalt und seit wann. Die zuverlässigsten Quellen sind zugleich die legitimsten: amtliche Statistiken zu offenen Stellen für das Gesamtbild und die öffentlichen ATS-Endpoints der Arbeitgeber für das Detail. Wenn die Erfassung jeden Markt so sehen muss wie ein lokaler Bewerber, beschreibt die Seite Proxys für Marktforschung von Proxynet die Residential- und Datacenter-Ausgänge, und die Web Scraping API, erhältlich über das Vertriebsteam, ist der verwaltete Weg für Teams, die die Zeilen statt der Pipeline wollen.