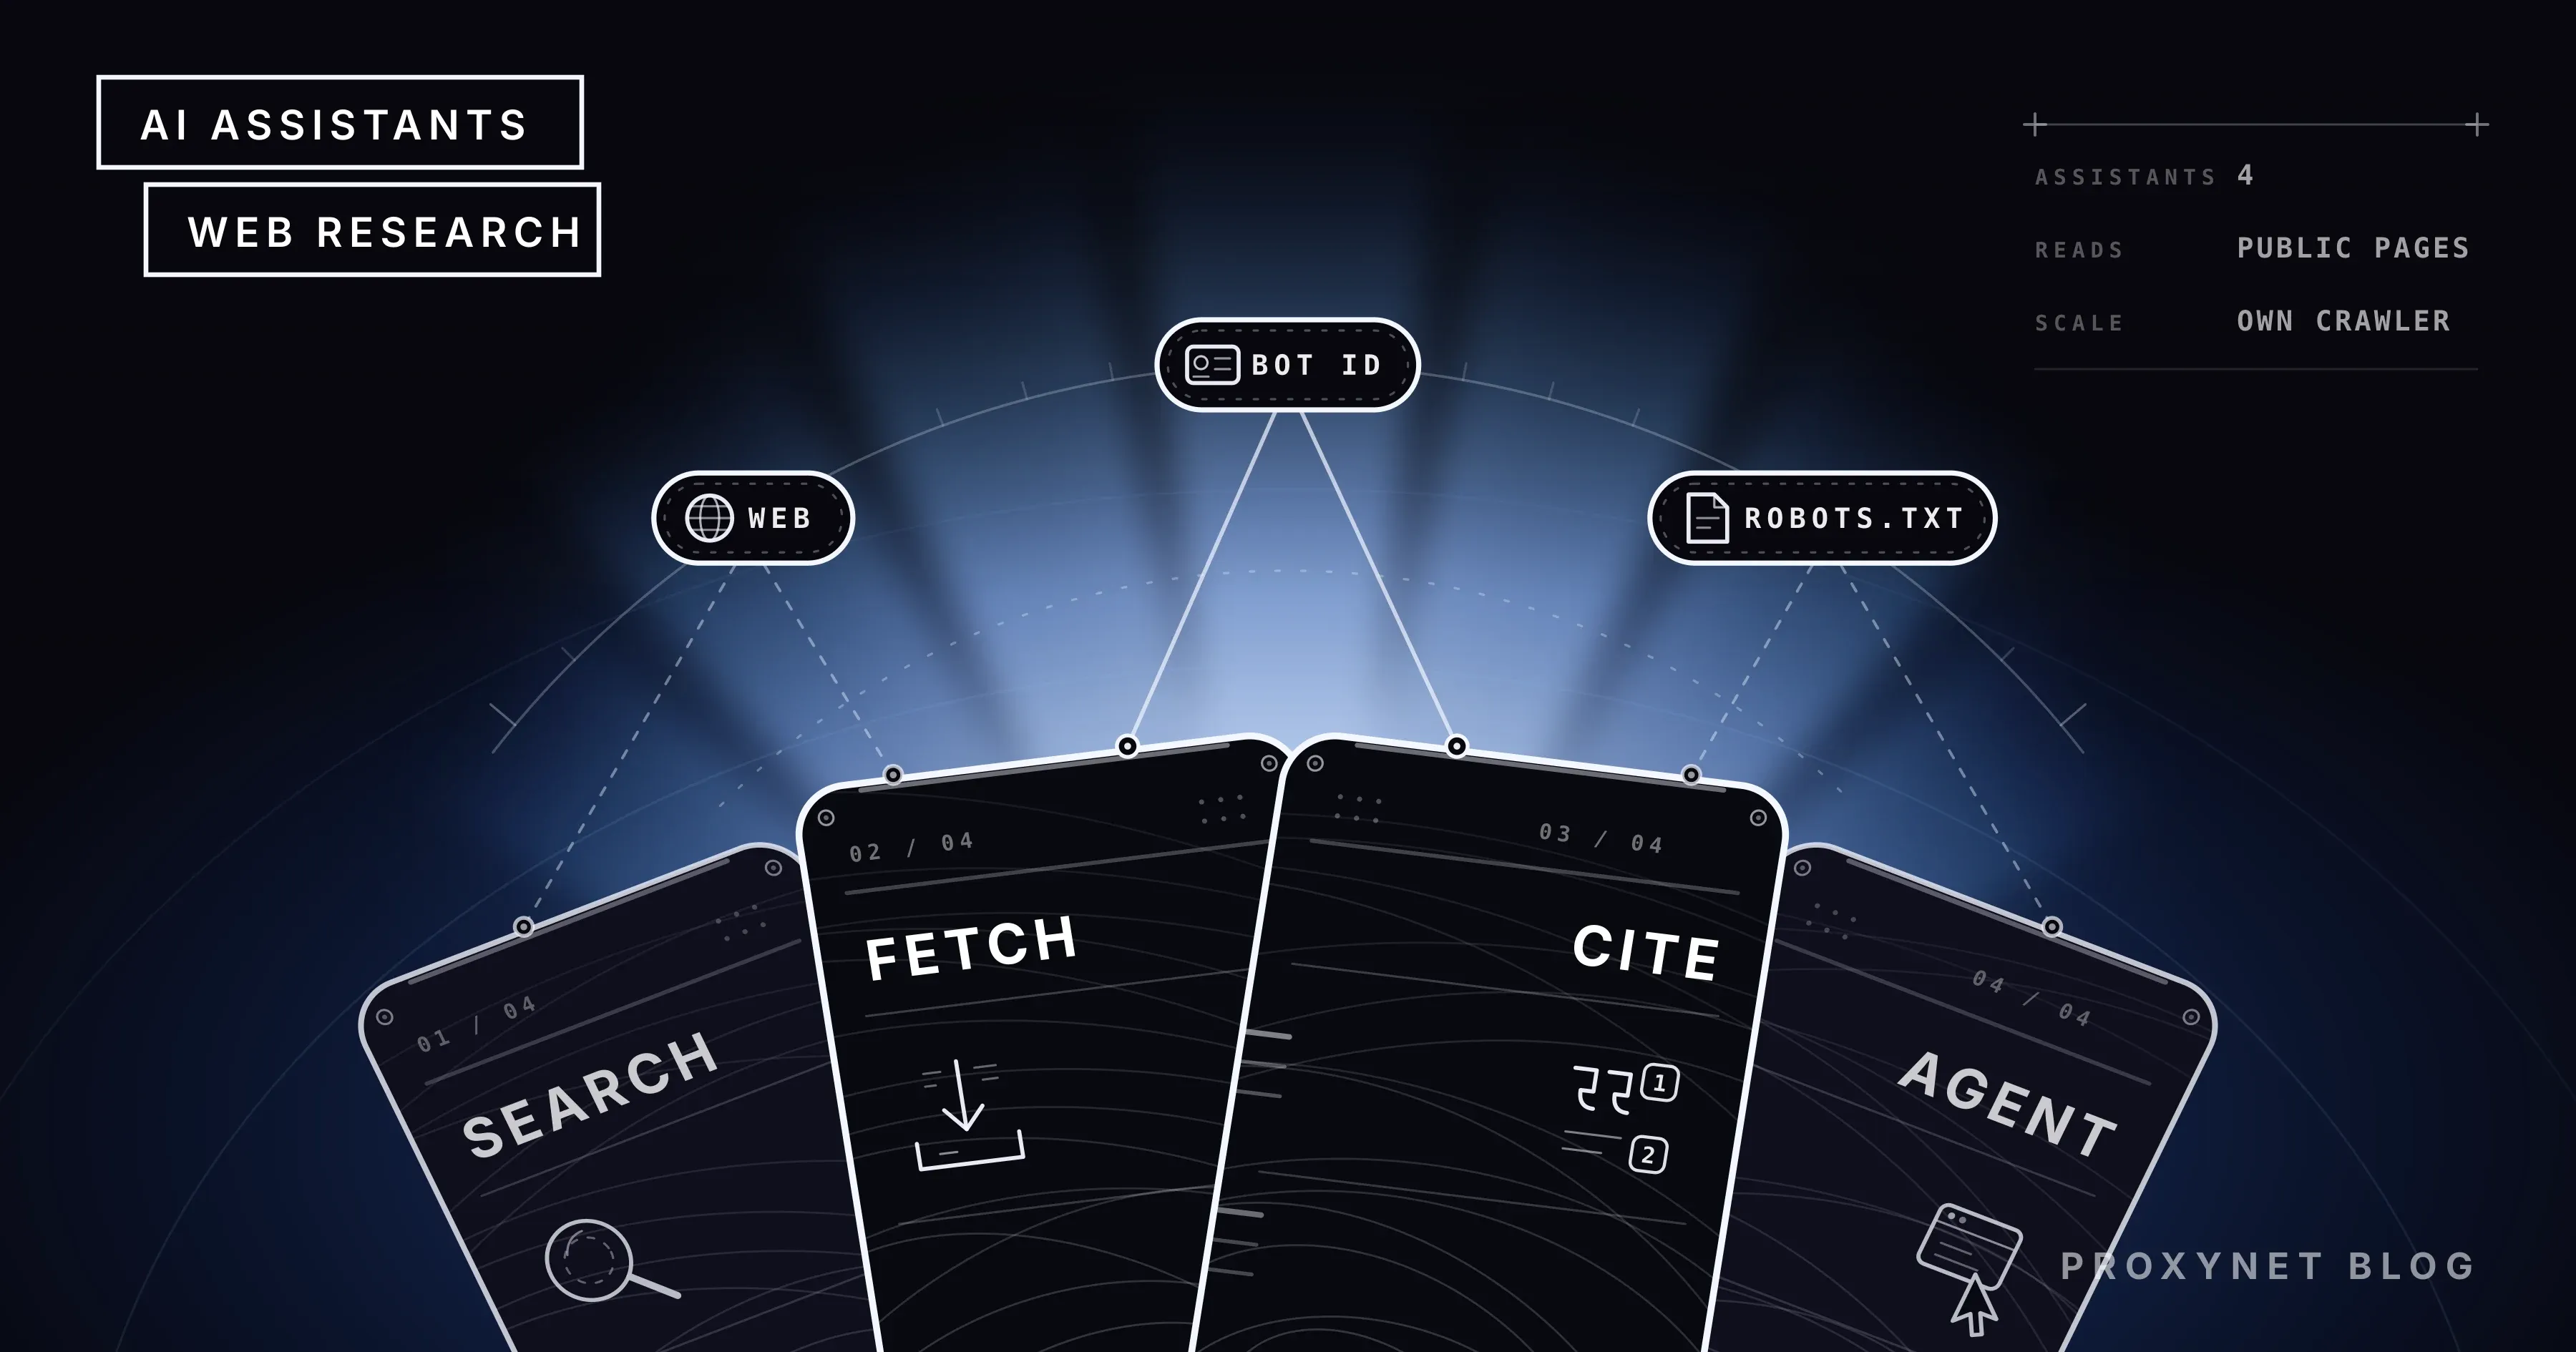
Uma equipe de pesquisa de mercado faz a mesma pergunta a quatro assistentes: "Quanto custa hoje este produto nesta loja na Türkiye?" Um devolve um preço com fontes numeradas, outro lê a página mas não diz de quando ela é, outro dá uma faixa baseada em resultados do Google e o último diz que não consegue acessar a página. Os quatro são vendidos como "conectados à web"; o que os separa não é a inteligência do modelo, e sim a relação que cada produto tem com a web.
Este artigo compara ChatGPT, Claude, Gemini e Perplexity a partir desse único ângulo: como funciona a busca ao vivo, como as fontes são mostradas, se uma URL que você fornece pode ser lida e onde eles param, o que fazem os modos de "deep research" e de agente, e como são as ferramentas web do lado da API. Depois passamos ao dono do site: identidades de bot, comportamento com o robots.txt e a disputa de agosto de 2025 entre Cloudflare e Perplexity. A última seção é para equipes de dados: por que esses assistentes não são ferramentas de scraping e onde um proxy entra. Conferimos os dados de cada fornecedor nas páginas deles em 7 de outubro de 2026; não citamos nomes de versões de modelos.
Como os quatro assistentes chegam à web?
Os quatro têm busca ao vivo; a diferença está em quando ela roda e sobre qual infraestrutura. O modelo em si não está conectado à web: em cada produto há uma camada de busca na frente dele que transforma a pergunta em consultas, traz os resultados e os entrega ao modelo. Tudo o que há de atual na resposta vem dessa camada.
O ChatGPT, segundo a página de ajuda da OpenAI, busca na web quando necessário, às vezes trabalha com outros provedores de busca para isso e reescreve sua pergunta em consultas direcionadas. A busca está disponível em todos os planos; as fontes chegam como citações clicáveis no texto, e uma visão "Fontes" lista os links relacionados.
O Claude ganhou busca na web em março de 2025 e a oferece em todo o mundo, em todos os planos, desde maio de 2025. Você ativa "Web search" no menu "+" de uma conversa, e o Claude busca quando a pergunta depende de informação atual: acontecimentos recentes, preços, dados sobre organizações e produtos que podem ter mudado ou um pedido explícito para consultar algo. Ele não busca para conhecimento consolidado, matemática ou escrita criativa.
O Gemini apoia as respostas na Pesquisa Google. Segundo a página de ajuda do Google, quando há fontes disponíveis aparece um botão "Fontes" abaixo ou dentro da resposta, que abre os links em um painel lateral; se não há botão, nenhum link foi fornecido para aquela resposta. Nem toda resposta se apoia em uma busca.
O Perplexity parte de outro lugar. O produto é um mecanismo de respostas: toda pergunta vai primeiro para a busca, e o modelo depois escreve uma resposta com fontes numeradas a partir das páginas que encontrou. Não existe a opção de "desligar a web"; a web é a condição prévia da resposta.
Como os formatos de citação diferem?
Os quatro citam fontes, mas a relação entre fonte e resposta é diferente. O Perplexity coloca um número ao lado de cada frase e trata a lista de fontes como parte da resposta. O Claude cita no nível da frase: qual trecho veio de qual URL, com um excerto de 150 caracteres, viaja dentro da resposta. O ChatGPT coloca as citações como links dentro do texto e acrescenta uma lista de fontes. O Gemini reúne as fontes em um painel separado e trata como normal uma resposta sem fontes.
| Assistente | Quando busca | Como as fontes aparecem | Efeito da localização |
|---|---|---|---|
| ChatGPT | Quando a pergunta precisa de dados atuais | Links no texto + lista de Fontes | A localização aproximada derivada do IP é passada ao parceiro de busca |
| Claude | Quando ativada e a pergunta precisa | Citação no nível da frase com URL e excerto | Não documentado no app; um parâmetro na API |
| Gemini | Quando a Pesquisa Google melhoraria a resposta | Botão Fontes, painel lateral | Não documentado |
| Perplexity | Em toda pergunta | Fontes numeradas como parte da resposta | Um parâmetro na API |
A coluna de localização importa. A página de ajuda da OpenAI diz que o ChatGPT passa aos parceiros de busca uma localização aproximada derivada do seu endereço IP, sem o IP em si. Uma pergunta de preço feita de Istambul pode não retornar os mesmos resultados de uma feita de Berlim. Não encontramos nenhuma página que documente isso nos outros três produtos, então não afirmamos nada sobre eles.
O que acontece quando você cola uma URL?
Ler uma página (fetch) é uma capacidade separada da busca: a busca retorna resumos de um índice, o fetch vai a um endereço específico e traz a própria página. Os quatro produtos usam uma identidade de bot separada para isso quando agem em nome de um usuário; o mecanismo é o mesmo em todos:
- O endereço precisa aparecer na conversa. A ferramenta da API do Claude transforma isso em regra: só podem ser lidas as URLs que apareceram em uma mensagem do usuário, em resultados de busca ou em resultados de ferramentas; um endereço que o próprio modelo escreveu, não. A razão dada é o risco de vazamento de dados.
- Domínio e robots.txt são verificados. A ferramenta do Claude retorna
url_not_allowedpara um caminho fechado pelo robots.txt, um endereço de rede privada ou uma URL que carrega credenciais. A ferramenta URL context do Gemini exclui endereços de rede local e serviços de túnel. - A página é recuperada. Texto, HTML e PDF são lidos. A documentação do Claude afirma que páginas renderizadas com JavaScript não são suportadas; a do Gemini diz que conteúdo atrás de login ou paywall não é lido.
- O conteúdo é cortado. O Claude tem um limite
max_content_tokens; o Gemini permite 34 MB por URL e 20 URLs por requisição. O modelo lê a parte que cabe, não a página inteira. - A resposta é escrita e citada. No fetch do Claude as citações são opcionais; o Gemini retorna junto com a resposta quais URLs foram lidas com sucesso.
Depois há o cache. A documentação do Claude diz que o conteúdo lido fica em cache e pode não refletir a versão mais recente da URL; use_cache pode ser desligado para conteúdo fresco. O Gemini olha primeiro no cache do próprio índice e só busca ao vivo se a página não estiver lá. Para dados que mudam de hora em hora, como um preço, isso decide a idade da resposta.
| Assistente | Como lê uma URL | Limites documentados | Postura do bot acionado pelo usuário quanto ao robots.txt |
|---|---|---|---|
| ChatGPT | Visita de página pelo ChatGPT-User | Sem rastreamento automático | "Podem não se aplicar" |
| Claude | Claude-User; ferramenta web fetch na API | Sem JavaScript; a URL precisa aparecer na conversa; cache | Obedece |
| Gemini | Fetchers acionados pelo usuário do Google; URL context na API | 20 URLs, 34 MB; sem login nem paywall | Em geral ignora |
| Perplexity | Perplexity-User | A página é usada na hora para responder à pergunta | Em geral ignora |
O que fazem os modos de deep research e de agente?
Os quatro produtos têm um modo de pesquisa longa, e todos rodam o mesmo ciclo: planejar, buscar, ler, buscar de novo o que falta, escrever o relatório. O Gemini abriu esse modo como "Deep Research" em dezembro de 2024; a OpenAI lançou o "deep research" em fevereiro de 2025, o Perplexity o seu "Deep Research" no mesmo mês e a Anthropic o recurso "Research" em abril de 2025. A diferença está em quantas páginas são lidas, mas também em como as fontes viajam: Perplexity e Claude prendem a citação à frase, ChatGPT e Gemini as reúnem abaixo do relatório. Descrevemos a forma desse ciclo em como funcionam os agentes de IA.
Os modos de agente vão um passo além: o assistente navega, preenche formulários e clica. O Perplexity lançou o próprio navegador, o Comet, para isso; o Google lista uma identidade de bot separada (Google-Agent) para agentes que navegam em nome de um usuário; o modo agente da OpenAI vive dentro do ChatGPT. Para o dono de um site, essa visita se parece com uma humana, mas a requisição ainda vem de um programa e carrega a identidade dele no cabeçalho user agent.
Como são as ferramentas web do lado da API?
Nas quatro APIs, a busca na web é uma ferramenta de servidor: a infraestrutura do fornecedor executa a busca e entrega os resultados ao modelo. O desenvolvedor controla três coisas: o número de buscas, um filtro de domínios e a localização.
| Assistente | Ferramenta de API | Parâmetro de localização | Filtro de domínios |
|---|---|---|---|
| OpenAI | web_search da Responses API; anotações url_citation | user_location: cidade, país, região, fuso horário | Sim |
| Anthropic | Ferramentas web_search e web_fetch; citações obrigatórias na busca | user_location: cidade, região, código do país, fuso horário | allowed_domains ou blocked_domains |
Grounding com google_search; url_context | Não documentado | Não documentado | |
| Perplexity | Modelos Sonar; search_results e citações por padrão | web_search_options.user_location: latitude e longitude mais país, cidade, região | search_domain_filter, até 20 domínios |
A mesma requisição com e sem country: "TR" pode retornar páginas diferentes. A documentação do Claude pede pelo menos um campo e recebe o país como código ISO de duas letras:
{
  "type": "web_search_20250305",
  "name": "web_search",
  "max_uses": 5,
  "user_location": {
    "type": "approximate",
    "city": "Istanbul",
    "country": "TR",
    "timezone": "Europe/Istanbul"
  }
}
Na ferramenta de grounding do Google, o groundingMetadata que volta com a resposta carrega as consultas de busca, os trechos de fonte e um searchEntryPoint, e o Google pede que essas "Search Suggestions" sejam mostradas ao usuário. A busca do Perplexity não pode ser desligada, mas search_recency_filter limita a idade das fontes.
Quais identidades de bot importam para donos de sites?
Cada fornecedor usa três identidades para três tarefas: rastrear para treinamento, rastrear para um índice de busca e abrir uma página em nome de um usuário. Cada uma é gerenciada separadamente no robots.txt; bloquear o bot de treinamento não bloqueia o bot de busca. Nosso guia de robots.txt explica como o arquivo é escrito; aqui listamos só os nomes e as posturas.
| Fornecedor | Treinamento | Busca | Acionado pelo usuário |
|---|---|---|---|
| OpenAI | GPTBot | OAI-SearchBot | ChatGPT-User |
| Anthropic | ClaudeBot | Claude-SearchBot | Claude-User |
| Google-Extended (só token) | Googlebot | Fetchers acionados pelo usuário, Google-Agent | |
| Perplexity | Nenhum (não rastreia para treinamento) | PerplexityBot | Perplexity-User |
A OpenAI define as três identidades na sua documentação de bots. O GPTBot rastreia para treinamento; o OAI-SearchBot encontra e vincula sites na busca do ChatGPT e não é usado para treinamento; o ChatGPT-User visita uma página quando um usuário faz uma pergunta e não rastreia automaticamente. Como um usuário inicia essas visitas, o documento diz que as regras do robots.txt "podem não se aplicar" ao ChatGPT-User. Um site que bloqueia o OAI-SearchBot não aparece nas respostas de busca do ChatGPT; uma mudança leva cerca de 24 horas para ser captada. As faixas de IP são publicadas em arquivos JSON separados.
A Anthropic define os três bots na sua página de ajuda e diz que os três respeitam o robots.txt; é o único fornecedor que diz "obedece" para o bot acionado pelo usuário. A página também diz que os bots suportam a diretiva Crawl-delay e publica as faixas de IP em uma única lista JSON.
No Google, o Gemini não rastreia com um crawler próprio. O Googlebot constrói o índice; o Google-Extended é um token de robots.txt sem string de user agent própria, e governa se o conteúdo rastreado pode ser usado para treinar modelos Gemini e para o grounding com a Pesquisa Google nos Gemini Apps e na Vertex AI. A documentação afirma duas coisas com clareza: o Google-Extended não afeta a posição de um site na Pesquisa, e os fetchers acionados pelo usuário em geral ignoram as regras do robots.txt porque um usuário pediu a leitura. Bloquear o Google-Extended não toca no Googlebot nem nas visitas feitas em nome de um usuário.
O Perplexity escreve na sua documentação de crawlers que o PerplexityBot rastreia para exibir sites nos resultados de busca, não é usado para treinamento e respeita o robots.txt. A frase para o Perplexity-User é outra: "Como um usuário pediu a leitura, este fetcher em geral ignora as regras do robots.txt." As faixas de IP dos dois bots são publicadas em arquivos JSON separados.
A conclusão prática: o robots.txt governa o rastreamento automatizado, e três dos quatro fornecedores tratam uma visita única feita em nome de um usuário como algo fora desse arquivo. O jeito de limitar essas visitas é uma regra do lado do servidor baseada no user agent e nas listas de IP publicadas. Uma configuração comum bloqueia os bots de treinamento e deixa os de busca abertos:
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Google-Extended
Disallow: /

User-agent: OAI-SearchBot
Allow: /

User-agent: Claude-SearchBot
Allow: /

User-agent: PerplexityBot
Allow: /
O que aconteceu entre Cloudflare e Perplexity?
Em 4 de agosto de 2025, a Cloudflare publicou um artigo alegando que o Perplexity usava crawlers não declarados. No relato dela, sites que haviam bloqueado o PerplexityBot informaram que seu conteúdo continuava aparecendo nas respostas do Perplexity, e domínios de teste novos que a Cloudflare havia fechado a todos os bots ainda eram lidos pelo Perplexity. O artigo dizia que, uma vez bloqueado o user agent declarado, as requisições chegavam com um user agent genérico parecido com o do Chrome e de redes variáveis (ASNs), e que às vezes o robots.txt nem era baixado; no mesmo dia a Cloudflare removeu o Perplexity da sua lista de bots verificados.
O Perplexity respondeu no dia seguinte com um artigo intitulado "Agents or Bots? Making Sense of AI on the Open Web": o tráfego em questão não era rastreamento automatizado, e sim requisições de "agentes dirigidos pelo usuário" que abriam uma página para a pergunta imediata de um usuário, nada foi indexado e a Cloudflare havia confundido parte do tráfego com um serviço de navegador em nuvem de terceiros. Os dois relatos não batem, e este artigo não é o árbitro. O resultado duradouro é que a questão da identidade caminhou para uma resposta técnica: no mesmo mês, a Cloudflare abriu um programa de "signed agents" em que os agentes assinam as requisições com Web Bot Auth, um rascunho do IETF. Um bot que copia uma string de user agent não consegue produzir essa assinatura.
Esses assistentes são ferramentas de coleta de dados?
Não. Os limites acima são decisões de design: o número de buscas por requisição, o cache, ler só as URLs que aparecem na conversa, não executar JavaScript e recusar caminhos fechados pelo robots.txt dimensionam essas ferramentas para a pergunta imediata de um usuário. Cem páginas exigem cem perguntas, e você não controla qual versão de uma página foi lida. Nosso artigo sobre acesso seguro à web para LLMs descreve a que um modelo deve prestar atenção quando lê páginas ao vivo.
Para uma coleta regular e em grande escala há três caminhos: uma fonte que permita isso explicitamente, a API oficial da fonte ou o seu próprio crawler. No terceiro caminho, ler o robots.txt, respeitar os limites de taxa do site e se identificar com um user agent honesto são tarefa sua. Rodar o crawler por um Proxies de datacenter separa seus endereços de saída dos seus servidores de aplicação e facilita a identificação com uma lista fixa de IPs; não aumenta o número de requisições por minuto que um site permite.
O lugar real de um proxy é a geografia. Uma loja pode mostrar preços, moedas e campanhas diferentes conforme o país do visitante. Os assistentes leem uma página de onde a própria infraestrutura deles estiver; publicam as faixas de IP, mas não prometem nada sobre o país. No seu próprio crawler esse controle é seu: um Proxies residenciais com saída na Türkiye retorna a página como um comprador daquele país a vê e permite registrar junto com os dados "de qual país foi vista". Que a resposta de um assistente, no caso do ChatGPT, possa variar conforme o lugar de onde a pergunta foi feita é outro assunto.
Erros comuns
- Registrar o preço de um assistente sem data. A resposta pode vir de um cache ou de uma página indexada dias antes; guarde juntos a URL da fonte e o horário da resposta.
- Tomar uma resposta sem fontes por uma com fontes. No Gemini, sem o botão "Fontes" a resposta não se apoiou em uma busca; no Claude, com a busca na web desligada, a resposta vem dos dados de treinamento.
- Tentar dar centenas de URLs a um assistente. As ferramentas limitam URLs e tokens por requisição; quando o trabalho cresce, passe para a API oficial ou para o seu próprio crawler.
- Relatar uma página renderizada com JavaScript como "o assistente não conseguiu ler". A página volta como uma casca vazia; o problema está em como a página é construída.
- Bloquear só o bot de treinamento e dar o trabalho por encerrado. Bots de busca e bots acionados pelo usuário são identidades separadas, e a maioria destes últimos nem lê o robots.txt.
- Confiar na string de user agent. Qualquer um pode escrevê-la; a verificação precisa de uma lista de IPs ou de uma requisição assinada.
Guia de decisão
| Necessidade | Recomendação |
|---|---|
| Uma resposta rápida com fonte em cada frase | Perplexity |
| Ler um documento longo ou uma URL que você fornece, com citações no nível da frase | Claude |
| Respostas atuais apoiadas na Pesquisa Google, dentro do ecossistema do Google | Gemini |
| Pesquisa do dia a dia com verificação clicando nas fontes | ChatGPT |
| Adicionar busca na web com fontes à sua própria aplicação | Ferramentas da OpenAI ou da Anthropic; Perplexity Sonar |
| Como dono de site, bloquear o rastreamento para treinamento e continuar visível na busca | GPTBot, ClaudeBot e Google-Extended bloqueados; bots de busca permitidos |
| Coleta de dados regular e em grande escala | Uma fonte que permita, uma API oficial ou o seu próprio crawler |
Perguntas frequentes
O ChatGPT está conectado à internet?
Sim. O ChatGPT busca na web quando necessário, em todos os planos, e anexa fontes clicáveis à resposta. Às vezes trabalha com outros provedores de busca e reescreve sua pergunta em consultas direcionadas.
O Claude consegue buscar na web?
Sim. A busca na web está no Claude desde março de 2025 e disponível em todos os planos e em todos os países desde maio de 2025. Você a ativa no menu "+" de uma conversa; o Claude busca quando uma pergunta precisa de informação atual e prende cada citação à sua fonte.
Qual é a diferença entre Perplexity e ChatGPT?
O Perplexity começa toda resposta com uma busca e torna as fontes numeradas parte da resposta; o ChatGPT busca só quando necessário e dá as fontes como links no texto. O Perplexity serve para uma resposta rápida e com fontes; o ChatGPT, para uma conversa longa e um conjunto de ferramentas mais amplo.
Assistentes de IA conseguem ler páginas atrás de paywall?
Não. A documentação de URL context do Gemini afirma que conteúdo atrás de login ou paywall não é lido, e as outras ferramentas também pedem a página sem sessão. O assistente vê a versão da página que o site mostra a todo mundo.
Bloquear o Google-Extended afeta o ranqueamento na Pesquisa Google?
Não. A documentação do Google diz que o Google-Extended não tem string de user agent própria e não afeta a posição de um site na Pesquisa Google. O token só governa se o conteúdo rastreado é usado para treinamento e grounding do Gemini.
Posso bloquear bots de IA por completo com o robots.txt?
Em parte. Bots de treinamento e de busca respeitam o robots.txt; a maioria dos bots que abrem uma página em nome de um usuário não respeita, com o Claude-User da Anthropic como exceção. Para limitar as visitas acionadas pelo usuário, você precisa de regras do lado do servidor baseadas no user agent e nas listas de IP publicadas.
Em resumo
Os quatro assistentes chegam à web: o Perplexity faz da busca a condição prévia de toda resposta, ChatGPT e Claude buscam quando necessário, e o Gemini se apoia na Pesquisa Google e trata como normal uma resposta sem fontes. Para ler URLs eles compartilham limites documentados: sem JavaScript, sem login, sem caminhos fechados pelo robots.txt e com um cache. Para o dono de um site, a divisão real está nos bots acionados pelo usuário; todo fornecedor exceto a Anthropic trata essas visitas como algo fora do robots.txt, então o controle passa para user agents e listas de IP. Para equipes de dados, essas ferramentas são assistentes de pesquisa, não coletores; a coleta regular precisa de uma fonte que permita, de uma API oficial ou do seu próprio crawler, e para ver uma página do país certo você pode conferir nossa infraestrutura de extração de dados.