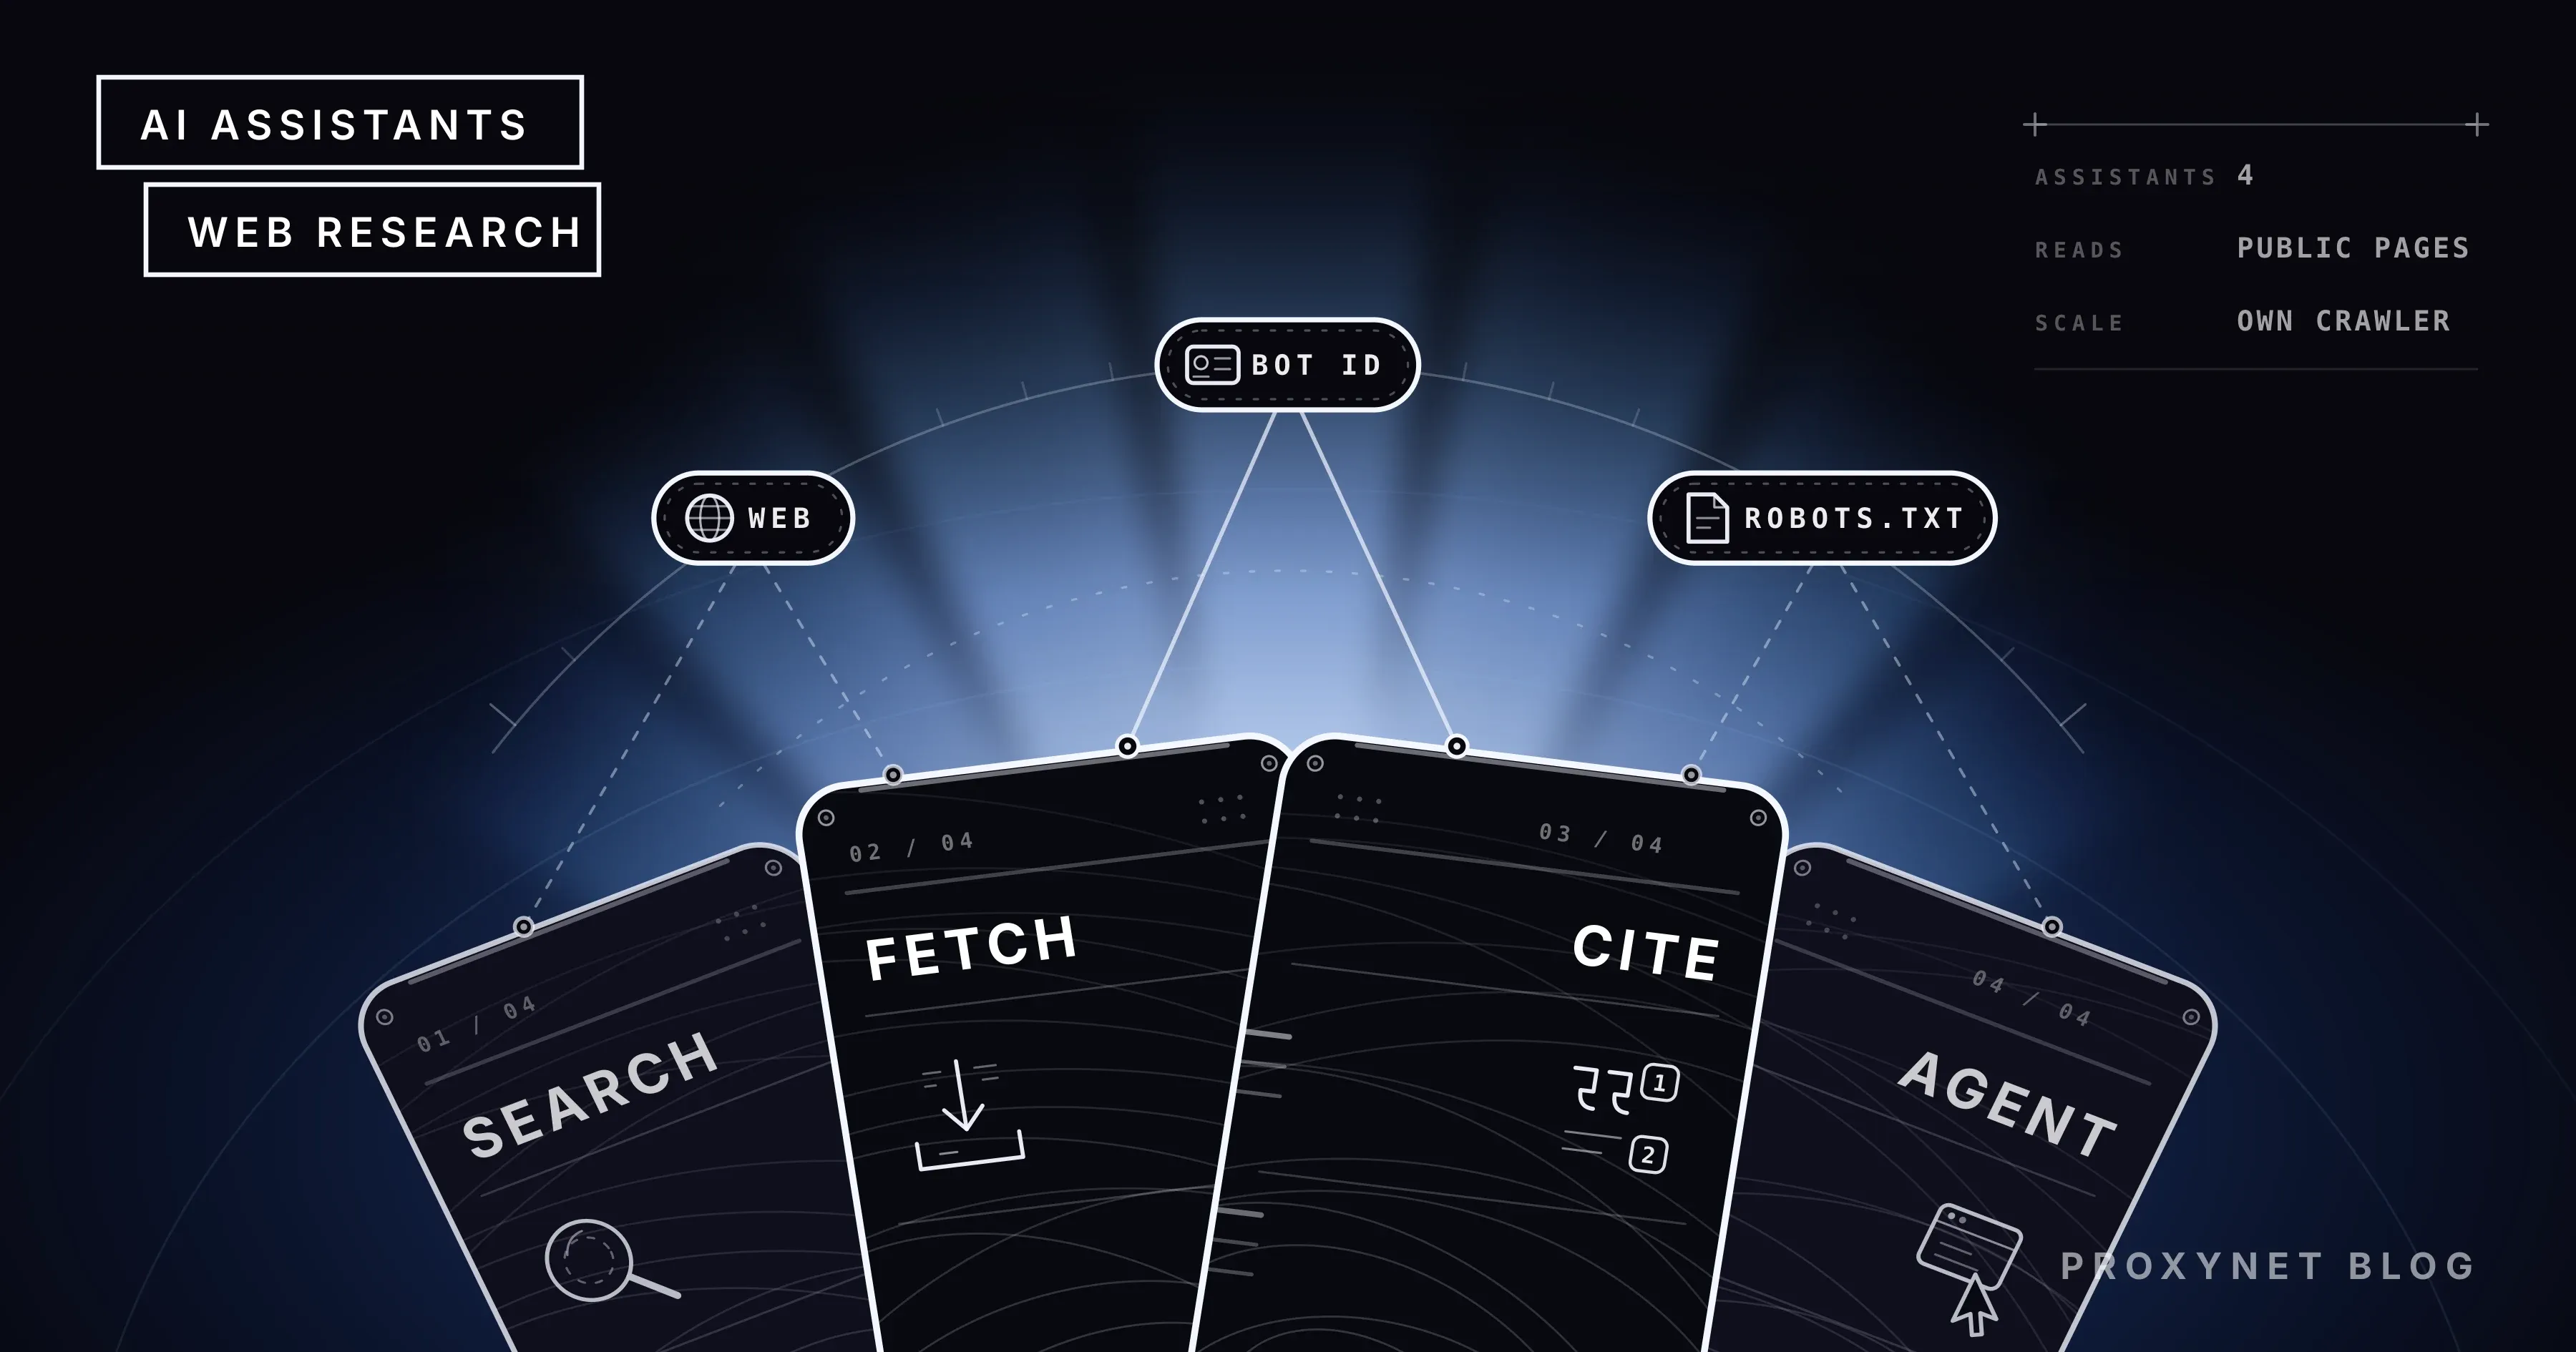
Bir pazar araştırma ekibi aynı soruyu dört asistana soruyor: "Bu ürün Türkiye'deki şu mağazada bugün kaç lira?" Biri numaralı kaynaklarla bir fiyat veriyor, biri sayfayı okuyor ama tarihini söylemiyor, biri Google sonuçlarına dayanan bir aralık yazıyor, biri de sayfaya erişemediğini söylüyor. Dördü de "web'e bağlı" diye tanıtılıyor; farkı yaratan modelin zekâsı değil, her birinin web ile kurduğu ilişki.
Bu yazıda ChatGPT, Claude, Gemini ve Perplexity'yi tek bir açıdan karşılaştırıyoruz: canlı web araması nasıl çalışıyor, kaynaklar nasıl gösteriliyor, bir URL verince sayfa okunabiliyor mu ve nerede duruluyor, "deep research" ve ajan modları ne yapıyor, API tarafında web araçları neye benziyor. Sonra site sahibi tarafına geçiyoruz: bot kimlikleri, robots.txt tutumları ve Cloudflare ile Perplexity arasındaki Ağustos 2025 tartışması. Son bölüm veri ekipleri için: bu asistanlar neden scraping aracı değildir ve proxy'nin yeri neresidir. Üreticilere ait bilgileri 7 Ekim 2026'da kendi sayfalarından kontrol ettik; sürüm adı yazmadık.
Dört asistan web'e nasıl ulaşıyor?
Dördünde de canlı arama var; fark aramanın ne zaman ve hangi altyapıyla yapıldığında. Modelin kendisi web'e bağlı değildir: her üründe modelin önünde bir arama katmanı durur, soruyu sorgulara çevirir, sonuçları getirir ve modele okutur. Cevaptaki güncellik o katmandan gelir.
ChatGPT, OpenAI'ın yardım sayfasına göre gerektiğinde web'de arar, bunun için zaman zaman başka arama sağlayıcılarıyla çalışır ve sorunuzu hedefli sorgulara yeniden yazar. Arama bütün planlarda açık; kaynaklar tıklanabilir alıntılar olarak gelir, "Kaynaklar" bölümü de ilgili bağlantıları listeler.
Claude, Mart 2025'te web aramasına kavuştu; Mayıs 2025'ten beri bütün planlarda ve ülkelerde açık. Sohbette "+" menüsünden "Web search" seçeneğini açarsınız, Claude da soru güncel bilgi gerektirdiğinde arar: güncel olaylar, fiyatlar, değişebilecek kurum ve ürün bilgileri ya da açıkça "ara" denmesi. Yerleşik bilgi, matematik ve yaratıcı yazı için aramaz.
Gemini, cevabını Google Arama'yla destekler. Google'ın yardım sayfasına göre kaynak varsa cevabın altında ya da içinde bir "Kaynaklar" düğmesi görünür ve bağlantılar yan panelde açılır; düğme yoksa o cevap için bağlantı verilmemiştir. Her cevap aramaya dayanmaz.
Perplexity farklı bir yerden başlar. Ürün bir cevap motorudur: her soru önce aramaya gider, model sonra bulunan sayfalardan numaralı kaynaklarla cevap yazar. "Web'i kapatmak" diye bir seçenek yoktur; web, cevabın ön koşuludur.
Kaynak gösterme biçimleri nasıl farklı?
Dört asistan da kaynak gösterir, ama kaynağın cevapla ilişkisi farklıdır. Perplexity her cümlenin yanına numara koyar ve kaynak listesini cevabın parçası sayar. Claude alıntıyı cümle düzeyinde verir: hangi metin parçasının hangi URL'den geldiği ve alıntılanan 150 karakterlik kesit cevabın içinde taşınır. ChatGPT alıntıları metnin içine bağlantı olarak yerleştirir ve ayrıca bir kaynak listesi sunar. Gemini kaynakları ayrı bir panelde toplar ve kaynaksız cevap vermeyi de normal sayar.
| Asistan | Aramayı ne zaman yapar | Kaynak gösterimi | Konum etkisi |
|---|---|---|---|
| ChatGPT | Soru güncel bilgi istediğinde | Metin içi bağlantı + Kaynaklar listesi | IP'den türetilen genel konum arama ortağına iletilir |
| Claude | Açıksa ve soru gerektiriyorsa | Cümle düzeyinde alıntı, URL ve kesit | Uygulamada belgelenmemiş; API'de parametre |
| Gemini | Google Arama cevabı iyileştirecekse | Kaynaklar düğmesi, yan panel | Belgelenmemiş |
| Perplexity | Her soruda | Numaralı kaynaklar, cevabın parçası | API'de parametre |
Konum sütunu önemli: ChatGPT'nin yardım sayfası, IP adresinizden türetilen genel konumun arama ortaklarına iletildiğini, IP'nin kendisinin iletilmediğini yazar. İstanbul'dan sorulan bir fiyat sorusu Berlin'den sorulanla aynı sonuçları getirmeyebilir. Diğer üç üründe bunu doğrulayan bir sayfa bulamadık, o yüzden onlar için bir şey iddia etmiyoruz.
Bir URL verince ne olur?
Sayfa okuma (fetch), aramadan ayrı bir yetenektir: arama indeksten özet getirir, fetch belirli bir adrese gidip sayfanın kendisini alır. Dört üründe de bunu kullanıcı adına yapan ayrı bir bot kimliği vardır; mekanizma aynıdır:
- Adres sohbette geçmiş olmalı. Claude'un API aracı bunu kural yapar: yalnızca kullanıcı mesajında, arama ya da araç sonuçlarında geçen URL'ler getirilir; modelin kendi yazdığı adres getirilmez. Gerekçe veri sızdırma riskidir.
- Alan adı ve robots.txt denetlenir. Claude'un aracı, robots.txt'nin kapattığı, özel ağdaki ya da içinde şifre taşıyan bir adres için
url_not_alloweddöner. Gemini'nin URL context aracı yerel ağ adreslerini ve tünel servislerini dışarıda bırakır. - Sayfa alınır. Metin, HTML ve PDF okunur. Claude'un belgesi JavaScript ile oluşturulan sayfaların desteklenmediğini açıkça yazar; Gemini'nin belgesi giriş ya da ödeme duvarı arkasındaki içeriğin okunmadığını söyler.
- İçerik kırpılır. Claude'da
max_content_tokenssınırı vardır, Gemini'de URL başına 34 MB ve istek başına 20 URL. Sayfanın tamamı değil, modele sığan kısmı okunur. - Cevap yazılır ve alıntı eklenir. Claude'da fetch alıntıları isteğe bağlıdır; Gemini'de hangi URL'lerin başarıyla okunduğu cevapla birlikte döner.
Bir de önbellek var. Claude'un belgesi getirilen içeriğin önbelleğe alındığını ve adresteki en son sürümü yansıtmayabileceğini yazar; taze içerik için use_cache kapatılır. Gemini önce kendi indeks önbelleğine bakar, sayfa yoksa canlı getirir. Fiyat gibi saatlik değişen veride bu, cevabın yaşını belirler.
| Asistan | URL okuma yolu | Belgelenmiş sınırlar | Kullanıcı tetikli botun robots.txt tutumu |
|---|---|---|---|
| ChatGPT | ChatGPT-User ile sayfa ziyareti | Otomatik tarama yapmaz | "Uygulanmayabilir" |
| Claude | Claude-User; API'de web fetch aracı | JavaScript yok; yalnız sohbette geçen URL; önbellek | Uyar |
| Gemini | Google'ın kullanıcı tetikli getiricileri; API'de URL context | 20 URL, 34 MB; giriş ve ödeme duvarı yok | Genellikle yok sayar |
| Perplexity | Perplexity-User | Sayfa, soruyu cevaplamak için anında kullanılır | Genellikle yok sayar |
Deep research ve ajan modları ne yapıyor?
Dört üründe de uzun araştırma modu var ve hepsi aynı döngüyü çalıştırır: plan yap, ara, oku, eksik olanı yeniden ara, raporu yaz. Gemini bu modu Aralık 2024'te "Deep Research" adıyla açtı; OpenAI Şubat 2025'te "deep research"ü, Perplexity aynı ay "Deep Research"ü, Anthropic Nisan 2025'te "Research" özelliğini duyurdu. Fark, okunan sayfa sayısı kadar kaynakların taşınma biçimidir: Perplexity ve Claude alıntıyı cümleye bağlar, ChatGPT ve Gemini raporun altında toplar. Döngünün yapısını yapay zekâ ajanları nasıl çalışır yazımızda anlattık.
Ajan modları bir adım ileri gider: asistan bir tarayıcıda gezer, form doldurur, tıklar. Perplexity bunun için Comet adlı tarayıcısını çıkardı; Google, kullanıcı adına gezen ajanları için ayrı bir bot kimliği (Google-Agent) listeliyor; OpenAI'ın ajan modu ChatGPT'nin içinde. Site sahibi için bu ziyaret bir insanınkine benzer, ama istek yine bir programdan gelir ve kimliğini user agent başlığında taşır.
API tarafında web araçları neye benziyor?
Dört API'de de web araması bir "sunucu aracı"dır: aramayı üreticinin altyapısı yapar, sonuçları modele verir. Geliştirici üç şeyi kontrol eder: arama sayısı, alan adı filtresi ve konum.
| Asistan | API aracı | Konum parametresi | Alan adı filtresi |
|---|---|---|---|
| OpenAI | Responses API web_search; url_citation ek açıklamaları | user_location: şehir, ülke, bölge, saat dilimi | Var |
| Anthropic | web_search ve web_fetch araçları; alıntı zorunlu (arama) | user_location: şehir, bölge, ülke kodu, saat dilimi | allowed_domains ya da blocked_domains |
google_search ile grounding; url_context | Belgelenmemiş | Belgelenmemiş | |
| Perplexity | Sonar modelleri; search_results ve alıntılar varsayılan | web_search_options.user_location: enlem-boylam + ülke, şehir, bölge | search_domain_filter, en fazla 20 alan adı |
Aynı istek country: "TR" ile ve onsuz farklı sayfalar getirebilir. Claude'un belgesi en az bir alan ister ve ülkeyi iki harfli ISO koduyla alır:
{
  "type": "web_search_20250305",
  "name": "web_search",
  "max_uses": 5,
  "user_location": {
    "type": "approximate",
    "city": "Istanbul",
    "country": "TR",
    "timezone": "Europe/Istanbul"
  }
}
Google'ın grounding aracında cevapla dönen groundingMetadata arama sorgularını, kaynak parçalarını ve bir searchEntryPoint taşır; Google bu "Arama Önerileri"nin kullanıcıya gösterilmesini ister. Perplexity'de arama kapatılamaz, ama search_recency_filter kaynakların yaşını sınırlar.
Site sahipleri için bot kimlikleri hangileri?
Her üretici üç iş için üç kimlik kullanır: eğitim için tarama, arama indeksi için tarama ve kullanıcı adına sayfa açma. robots.txt'de her biri ayrı yönetilir; eğitim botunu kapatmak arama botunu kapatmaz. Dosyanın yazımını robots.txt rehberimizde anlattık; burada yalnız adlar ve tutumlar var.
| Üretici | Eğitim | Arama | Kullanıcı tetikli |
|---|---|---|---|
| OpenAI | GPTBot | OAI-SearchBot | ChatGPT-User |
| Anthropic | ClaudeBot | Claude-SearchBot | Claude-User |
| Google-Extended (yalnız belirteç) | Googlebot | Kullanıcı tetikli getiriciler, Google-Agent | |
| Perplexity | Yok (eğitim için taramıyor) | PerplexityBot | Perplexity-User |
OpenAI üç kimliği bot dokümanında ayrı tanımlar. GPTBot eğitim için tarar; OAI-SearchBot ChatGPT aramasında siteleri bulup bağlantı verir, eğitim için kullanılmaz; ChatGPT-User, kullanıcı soru sorduğunda sayfayı ziyaret eder ve otomatik tarama yapmaz. Belge, kullanıcı tarafından başlatıldığı için ChatGPT-User'a robots.txt kurallarının "uygulanmayabileceğini" söyler. OAI-SearchBot'u kapatan site ChatGPT arama cevaplarında görünmez; değişiklik yaklaşık 24 saatte işlenir. IP aralıkları ayrı JSON dosyalarında yayımlanır.
Anthropic üç botu da yardım sayfasında tanımlar ve üçünün de robots.txt'yi dinlediğini yazar; kullanıcı tetikli bot için "uyar" diyen tek üretici. Belge Crawl-delay yönergesini desteklediğini söyler ve IP aralıklarını tek JSON listesinde yayımlar.
Google'da Gemini ayrı bir crawler ile taramaz. Googlebot indeksi kurar; Google-Extended kendi user agent dizesi olmayan bir robots.txt belirtecidir ve taranan içeriğin Gemini eğitiminde ve Gemini Apps ile Vertex AI'daki Google Arama grounding'inde kullanılıp kullanılmayacağını yönetir. Belge iki şeyi açıkça söyler: Google-Extended sitenin aramadaki yerini etkilemez; kullanıcı tetikli getiriciler, istek kullanıcıdan geldiği için robots.txt kurallarını genellikle yok sayar. Google-Extended'ı kapatmak Googlebot'u ve kullanıcı adına yapılan ziyaretleri etkilemez.
Perplexity crawler dokümanında PerplexityBot'un siteleri arama sonuçlarında göstermek için taradığını, eğitim için kullanılmadığını ve robots.txt'ye uyduğunu yazar. Perplexity-User için cümle farklıdır: "Bir kullanıcı getirmeyi istediği için bu getirici robots.txt kurallarını genellikle yok sayar." İki botun IP aralıkları ayrı JSON dosyalarında yayımlanır.
Pratik sonuç: robots.txt otomatik taramayı yönetir; kullanıcı adına yapılan tekil ziyareti dört üreticiden üçü bu dosyanın dışında sayar. O ziyaretleri sınırlamanın yolu, user agent ve yayımlanmış IP listeleriyle sunucu tarafında kural yazmaktır. Yaygın bir yapı eğitim botlarını kapatıp arama botlarını açık bırakır:
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Google-Extended
Disallow: /

User-agent: OAI-SearchBot
Allow: /

User-agent: Claude-SearchBot
Allow: /

User-agent: PerplexityBot
Allow: /
Cloudflare ile Perplexity arasında ne oldu?
Cloudflare, 4 Ağustos 2025'te yayımladığı bir yazıda Perplexity'nin beyan edilmemiş crawler'lar kullandığını öne sürdü. Anlatımına göre PerplexityBot'u engelleyen siteler içeriklerinin Perplexity cevaplarında çıkmaya devam ettiğini bildirmiş; Cloudflare'in bütün botlara kapattığı yeni test alan adları da Perplexity tarafından getirilebilmiş. Yazı, beyanlı user agent engellenince isteklerin Chrome gibi görünen genel bir user agent ile ve değişen ağlardan (ASN) geldiğini, robots.txt'nin bazen hiç çekilmediğini yazdı; Cloudflare aynı gün Perplexity'yi doğrulanmış bot listesinden çıkardı.
Perplexity ertesi gün "Agents or Bots? Making Sense of AI on the Open Web" başlıklı yazıyla cevap verdi: söz konusu trafik otomatik tarama değil, bir kullanıcının o anki sorusu için sayfa açan "kullanıcı güdümlü ajan" istekleriydi, içerik indekslenmiyordu ve Cloudflare bir kısım trafiği üçüncü taraf bir bulut tarayıcı servisiyle karıştırmıştı. İki anlatım birbirini tutmuyor; bu yazı hakem değil. Kalıcı sonuç, kimlik sorusunun teknik bir cevaba yürümesi oldu: Cloudflare aynı ay, ajanların isteklerini IETF taslağı Web Bot Auth ile imzalayabildiği "signed agents" programını açtı. İmzayı, user agent dizesini kopyalayan bir bot üretemez.
Bu asistanlar veri toplama aracı mıdır?
Hayır. Yukarıdaki sınırlar tasarım kararıdır: istek başına arama sayısı, önbellek, yalnızca sohbette geçen URL'nin okunması, JavaScript'in çalıştırılmaması ve robots.txt'nin kapattığı yolun reddedilmesi, bu araçları bir kullanıcının o anki sorusuna göre ölçeklendirir. Yüz sayfa için yüz soru gerekir ve sayfanın hangi sürümünü okuduğunuzu kontrol edemezsiniz. Bir modelin canlı sayfa okurken nelere dikkat etmesi gerektiğini LLM'e güvenli web erişimi yazımızda anlattık.
Düzenli ve büyük ölçekli toplama için üç yol vardır: açıkça izin veren kaynak, kaynağın resmî API'si ve kendi crawler'ınız. Üçüncü yolda robots.txt'yi okumak, sitenin hız sınırına uymak ve kendinizi dürüst bir user agent ile tanıtmak sizin işinizdir. Crawler'ı bir Datacenter Proxy üzerinden çalıştırmak çıkış adreslerinizi uygulama sunucularından ayırır ve sabit bir IP listesiyle tanıtmanızı kolaylaştırır; sitenin dakikada izin verdiği istek sayısını artırmaz.
Proxy'nin asıl yeri coğrafyadır. Bir mağaza ziyaretçinin ülkesine göre farklı fiyat, para birimi ve kampanya gösterebilir. Asistanlar sayfayı kendi altyapılarının bulunduğu yerden çeker; IP aralıklarını yayımlarlar ama ülke taahhüdü vermezler. Kendi crawler'ınızda bu kontrol sizdedir: Türkiye çıkışlı bir Residential Proxy sayfayı o ülkedeki alıcının gördüğü hâliyle getirir ve veriye "hangi ülkeden görüldü" bilgisini eklemenizi sağlar. Asistanın cevabının, ChatGPT örneğinde, sorunun sorulduğu konuma göre değişmesi ise ayrı bir şeydir.
Sık yapılan hatalar
- Asistanın verdiği fiyatı tarihsiz kaydetmek. Cevap önbellekten ya da günler önce indekslenmiş bir sayfadan gelebilir; kaynağın URL'sini ve cevabın saatini birlikte saklayın.
- Kaynaksız cevabı kaynaklı sanmak. Gemini'de "Kaynaklar" düğmesi yoksa cevap aramaya dayanmıyor; Claude'da web araması kapalıysa cevap eğitim verisinden gelir.
- Bir asistana yüzlerce URL okutmaya çalışmak. Araçlar istek başına URL ve token sınırı koyar; iş büyüyünce resmî API ya da kendi crawler'ınıza geçin.
- JavaScript ile dolan sayfayı "asistan okuyamadı" diye raporlamak. Sayfa boş kabuk olarak döner; sorun sayfanın oluşturulma biçimindedir.
- Yalnız eğitim botunu kapatıp işin bittiğini düşünmek. Arama ve kullanıcı tetikli botlar ayrı kimliklerdir; ikincilerin çoğu robots.txt'yi zaten okumaz.
- User agent dizesine güvenmek. Dizeyi herkes yazabilir; doğrulama için IP listesi ya da imzalı istek gerekir.
Karar rehberi
| İhtiyaç | Öneri |
|---|---|
| Her cümlesi kaynaklı, hızlı bir cevap | Perplexity |
| Uzun bir belgeyi ya da verdiğiniz URL'yi cümle düzeyinde alıntıyla okutmak | Claude |
| Google Arama sonuçlarına dayanan güncel cevap, Google ekosistemi içinde | Gemini |
| Günlük araştırma, kaynaklara tıklayarak doğrulama | ChatGPT |
| Uygulamanıza kaynaklı web araması eklemek | OpenAI ya da Anthropic'in araçları; Perplexity Sonar |
| Site sahibi olarak eğitim taramasını kapatmak, aramada görünmek | GPTBot, ClaudeBot, Google-Extended kapalı; arama botları açık |
| Düzenli ve büyük ölçekli veri toplama | İzinli kaynak, resmî API ya da kendi crawler'ınız |
Sıkça sorulan sorular
ChatGPT internete bağlı mı?
Evet. ChatGPT gerektiğinde web'de arar, bunu bütün planlarda yapar ve cevaba tıklanabilir kaynaklar ekler. Arama için zaman zaman başka arama sağlayıcılarıyla çalışır ve sorunuzu hedefli sorgulara yeniden yazar.
Claude web'de arama yapabiliyor mu?
Evet. Web araması Mart 2025'ten beri Claude'da var ve Mayıs 2025'ten beri bütün planlarda ve ülkelerde açık. Sohbette "+" menüsünden açılır; Claude güncel bilgi gerektiren sorularda arar ve her alıntıyı kaynağına bağlar.
Perplexity ile ChatGPT arasındaki fark nedir?
Perplexity her cevaba aramayla başlar ve kaynakları numaralı biçimde cevabın parçası yapar; ChatGPT ise aramayı yalnız gerektiğinde yapar ve kaynakları metin içi bağlantı olarak verir. Hızlı ve kaynaklı bir cevap için Perplexity, uzun bir sohbet ve araçların çeşitliliği için ChatGPT daha uygun.
Yapay zekâ asistanları ödeme duvarı arkasındaki sayfayı okuyabilir mi?
Hayır. Gemini'nin URL context belgesi giriş ya da ödeme duvarı arkasındaki içeriğin okunmadığını açıkça yazar; diğer araçlar da sayfayı oturum açmadan ister. Asistan, sitenin herkese gösterdiği sürümü görür.
Google-Extended'ı engellemek Google aramadaki sıralamayı etkiler mi?
Hayır. Google'ın belgesi Google-Extended'ın ayrı bir user agent dizesi olmadığını ve sitenin Google Arama'daki yerini etkilemediğini yazar. Belirteç yalnızca taranan içeriğin Gemini eğitimi ve grounding'inde kullanılmasını yönetir.
Yapay zekâ botlarını robots.txt ile tamamen engelleyebilir miyim?
Kısmen. Eğitim ve arama botları robots.txt'yi dinler; kullanıcı adına sayfa açan botların çoğu ise dinlemez, Anthropic'in Claude-User'ı bu konuda istisna. Kullanıcı tetikli ziyaretleri sınırlamak için user agent ve yayımlanmış IP listeleriyle sunucu tarafında kural yazmanız gerekir.
Özet
Dört asistan da web'e ulaşır: Perplexity aramayı cevabın ön koşulu yapar, ChatGPT ve Claude gerektiğinde arar, Gemini Google Arama'ya yaslanır ve kaynaksız cevabı da normal sayar. URL okumada hepsinin belgelenmiş sınırları var: JavaScript yok, giriş yok, robots.txt'nin kapattığı yol yok, önbellek var. Site sahibi için asıl ayrım kullanıcı tetikli botlardadır; Anthropic dışındaki üreticiler bu ziyaretleri robots.txt'nin dışında sayar, kontrol user agent ve IP listesine kayar. Veri ekibi için bu araçlar araştırma asistanıdır, toplama aracı değil; düzenli toplama için izinli kaynak, resmî API ya da kendi crawler'ınız gerekir ve sayfayı doğru ülkeden görmek için veri kazıma altyapımıza bakabilirsiniz.