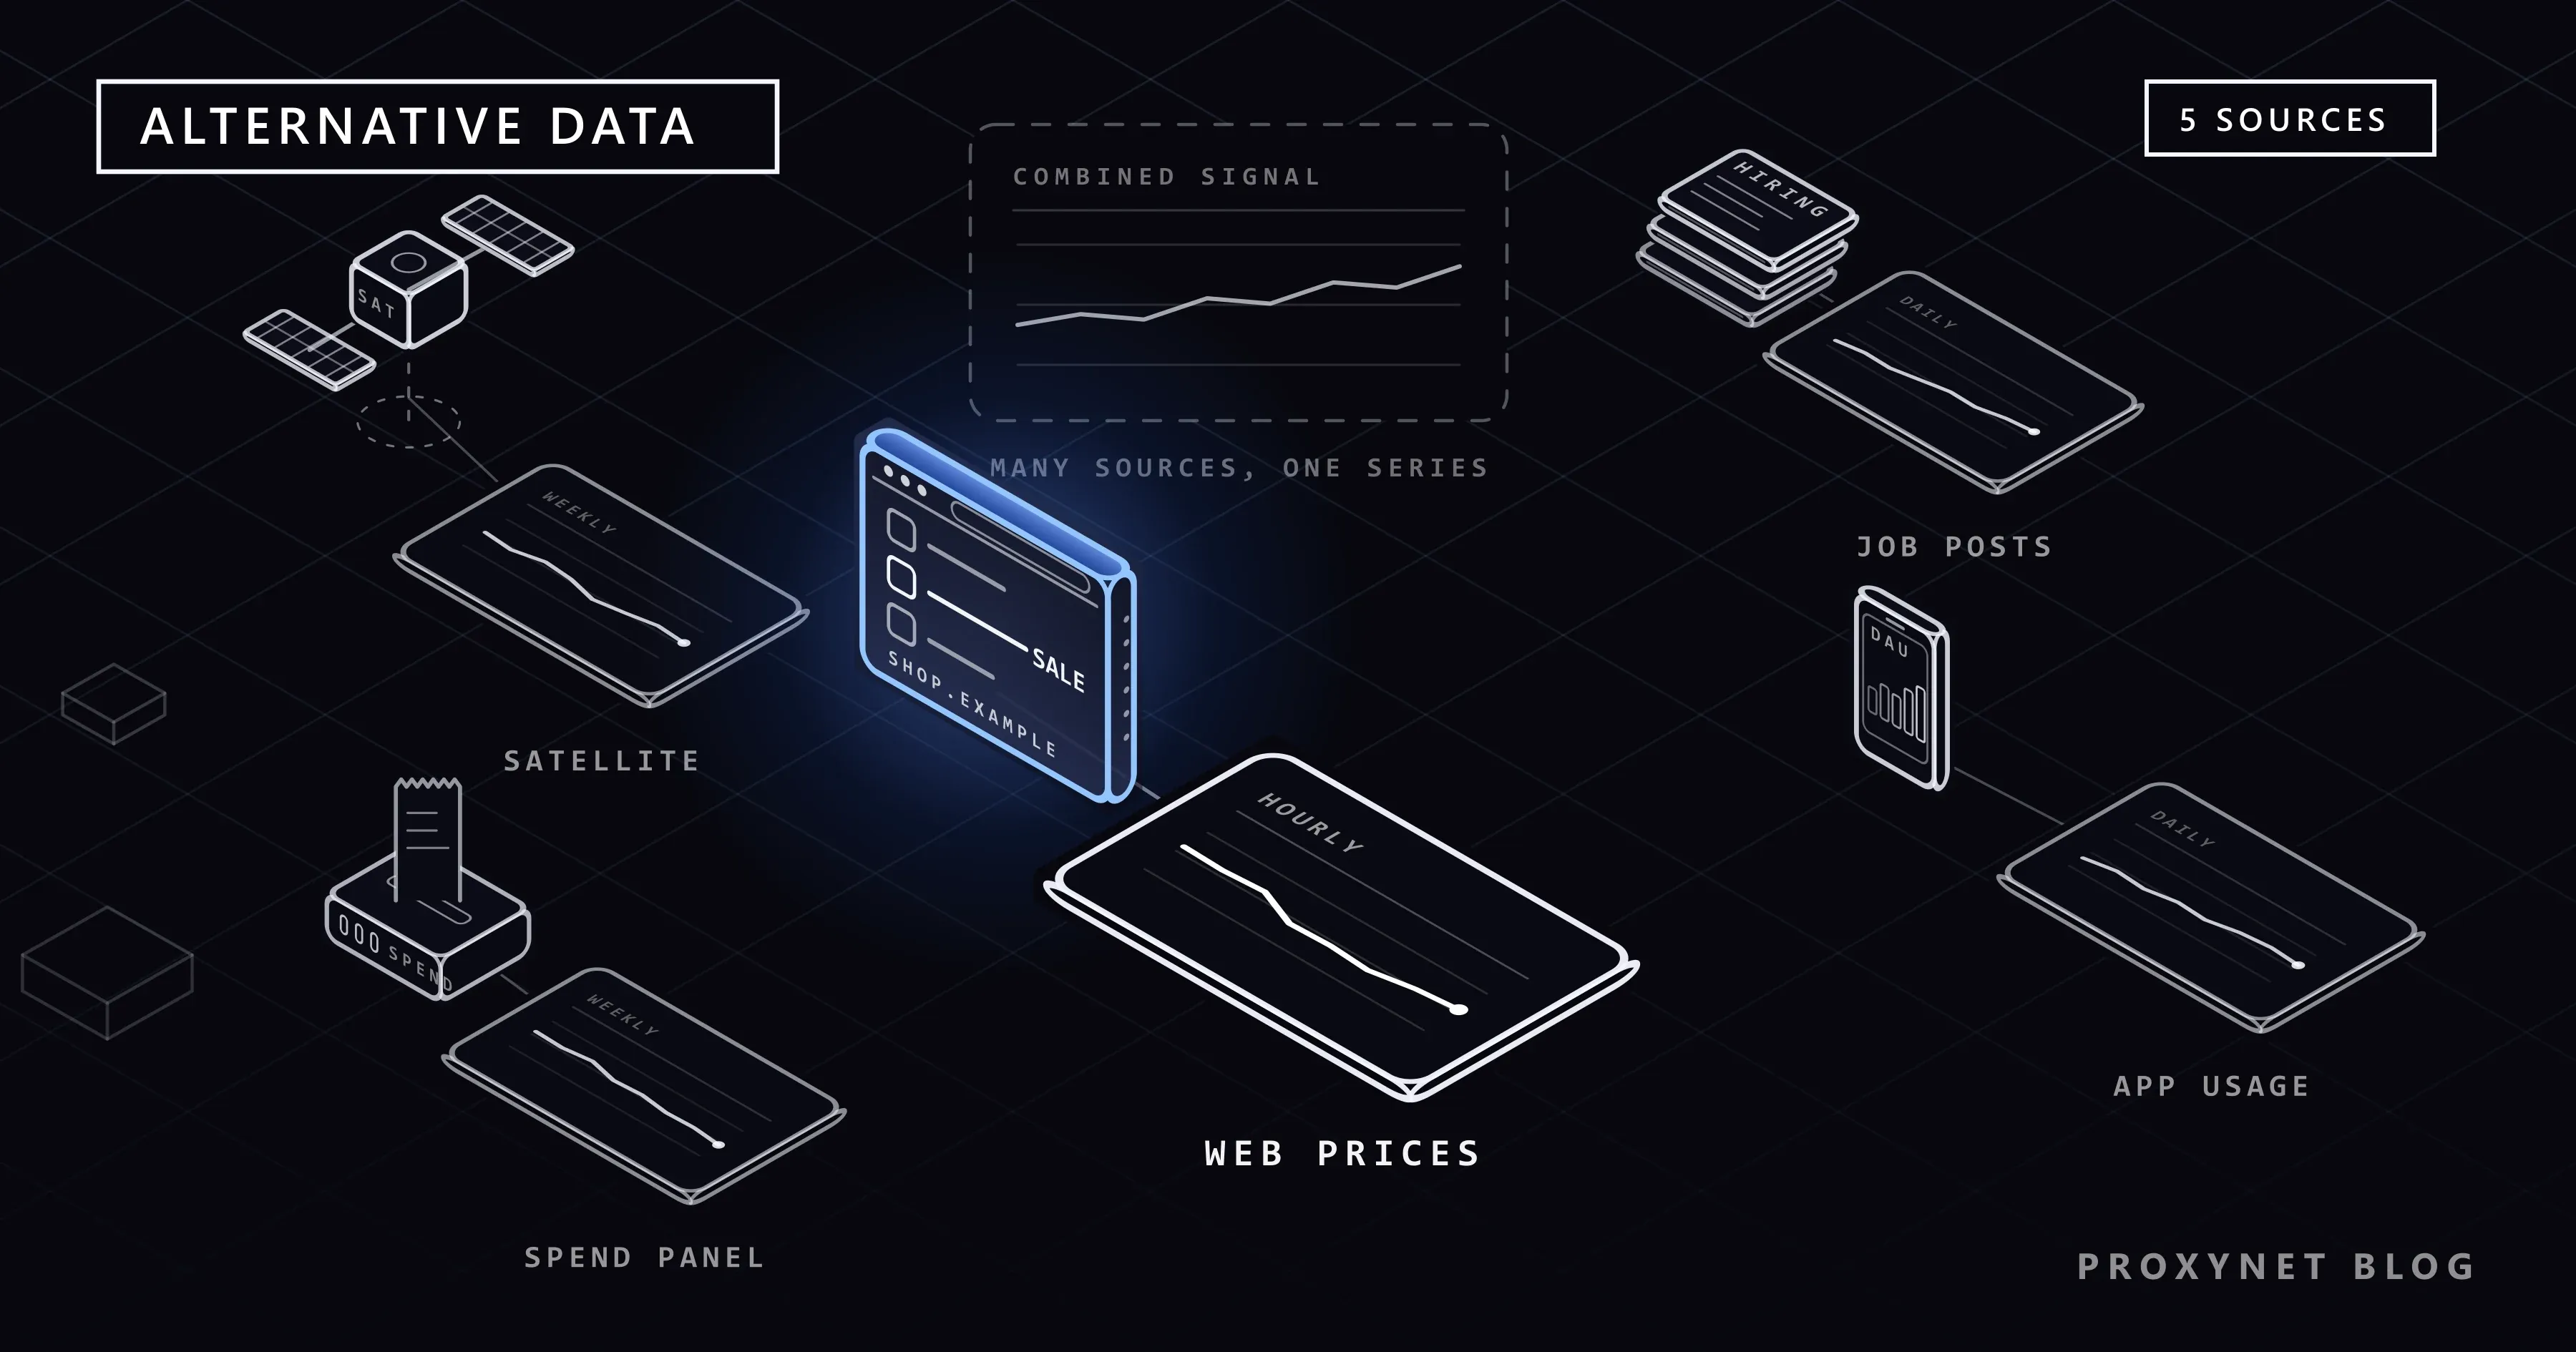
Um varejista vai divulgar suas vendas trimestrais daqui a seis semanas. Antes disso, um analista já consegue contar quantos produtos ficaram sem estoque no site, quantos gerentes de loja a empresa está contratando e se as avaliações da nova linha estão piorando. Nenhum desses números vem dos relatórios da própria empresa, mas juntos eles dizem algo sobre o trimestre. É a esse tipo de informação que o mercado financeiro chama de dados alternativos.
Este artigo explica o que são dados alternativos e de onde eles vêm: dados da web, painéis de transações com cartão, imagens de satélite, uso de aplicativos e sentimento. Em seguida, acompanha um conjunto de dados da coleta até a decisão, trata de compliance e qualidade, mostra onde entra o web scraping e compara construir com comprar. Nada aqui é recomendação de investimento; o assunto são os dados, não quais operações fazer.
O que são dados alternativos?
Dados alternativos são qualquer conjunto de dados que ajuda a explicar uma empresa, um setor ou a economia, mas fica fora do conjunto tradicional de fontes. Esse conjunto tradicional é formado por demonstrações financeiras auditadas, documentos regulatórios, teleconferências de resultados, comunicados à imprensa, estatísticas oficiais e preços de mercado; tudo o que traz um sinal útil além disso é "alternativo".
A Comissão de Valores Mobiliários dos Estados Unidos (SEC) dá uma definição prática em um alerta de risco de 2022 sobre compliance de MNPI, publicado por sua área de fiscalização. Entre os exemplos estão imagens de satélite e de drone de lavouras e estacionamentos, transações agregadas com cartão de crédito, dados de redes sociais e de busca, geolocalização de celulares e dados de e-mail vindos de aplicativos de consumo. A mesma nota acrescenta que dados alternativos "não contêm necessariamente MNPI", um ponto que volta mais adiante neste artigo.
O termo vem do mundo dos investimentos, em que os fundos hedge foram os primeiros grandes compradores; hoje credores, varejistas, consultorias e economistas usam os mesmos conjuntos de dados.
Quais são os principais tipos de dados alternativos?
As categorias se sobrepõem, mas a maioria dos conjuntos de dados se encaixa em um destes grupos:
- Dados da web. Preços e estoque em lojas online, catálogos de produtos, vagas de emprego, páginas de equipe das empresas, localizadores de lojas, rankings de lojas de aplicativos, anúncios de imóveis e avaliações. São públicos, atualizados e mais baratos de coletar que os outros tipos.
- Dados de transações. Compras agregadas e anonimizadas de emissores de cartão, processadores de pagamento ou aplicativos de notas fiscais. Mostram os gastos por loja ou marca, geralmente por meio de um painel de consumidores, e não do mercado inteiro.
- Dados geoespaciais. Imagens de satélite e aéreas (estacionamentos, tanques de petróleo, lavouras, navegação) e contagens de fluxo de pessoas (foot traffic) derivadas de sinais de localização de celulares.
- Uso de aplicativos e sites. Estimativas de downloads e usuários ativos de apps, estimativas de tráfego de sites e tendências de volume de busca.
- Dados de sentimento e texto. Posts em redes sociais, notícias, avaliações de produtos, tópicos de fóruns e transcrições de teleconferências de resultados transformados em pontuações ou temas. O CFA Institute observa, em seu artigo sobre o uso de NLP em dados alternativos, que boa parte desse material é texto não estruturado e precisa ser processado antes de ser usado.
Como os dados alternativos viram um sinal útil?
O caminho da fonte até a decisão costuma ter seis etapas:
- Defina a pergunta. "As vendas do varejista X estão crescendo mais rápido que no ano passado?" é uma pergunta; "coletar tudo sobre o varejista X" não é.
- Encontre e avalie a fonte. Verifique quem é o dono dos dados, como foram coletados, sob quais termos e se você pode usá-los para essa finalidade. Para dados de scraping, isso significa ler os termos do site e o robots.txt; para um fornecedor, significa um questionário de due diligence.
- Colete. Faça scraping de páginas públicas, chame uma API oficial, receba arquivos de um fornecedor ou importe o feed de um parceiro. A coleta roda de forma programada, porque um único retrato não mostra nada sobre mudança.
- Limpe e cruze. Remova duplicatas, corrija tipos e moedas, associe nomes de produtos e endereços de lojas à empresa e ao ticker corretos.
- Construa o indicador e teste. Transforme as linhas em uma série, por exemplo uma contagem semanal de itens com desconto, e compare com números divulgados no passado. Uma série que nunca acompanhou os números divulgados é ruído.
- Monitore. As fontes mudam: um site redesenha suas páginas, o painel de um fornecedor perde membros, um app muda sua página na loja.
As etapas 3 e 4 são, na prática, um processo de ETL: extrair, transformar, carregar. O que é ETL? percorre um pipeline desse tipo com dados obtidos por scraping.
Tipos de dados alternativos comparados
| Tipo | O que mede | Coleta típica | Atualização | Principal risco |
|---|---|---|---|---|
| Preços e estoque na web | Preços, descontos, disponibilidade | Scraping de páginas públicas de produto | De horas a dias | Mudanças na página quebram o scraper |
| Vagas de emprego | Planos de contratação por cargo e local | Scraping de páginas de carreira e sites de vagas | Dias | Anúncios duplicados e desatualizados |
| Avaliações e posts sociais | Sentimento, problemas de produto | Scraping, APIs oficiais | Horas | Bots, sarcasmo, amostras pequenas |
| Painéis de transações com cartão | Gastos do consumidor por loja | Licenciados de fornecedores | De dias a semanas | Viés do painel, dados pessoais |
| Imagens de satélite | Atividade física (carros, tanques, lavouras) | Imagens licenciadas mais análise de imagem | Dias | Nuvens, custo, interpretação |
| Fluxo de pessoas (foot traffic) | Visitas a lojas e locais | Painéis de localização de celulares via fornecedores | Dias | Consentimento e privacidade |
| Estimativas de uso de apps | Downloads, usuários ativos | Modelos de fornecedores, dados de lojas de apps | Dias | Modelos opacos, qualidade da fonte |
Dados da web são o tipo que uma equipe consegue coletar por conta própria; dados de cartão, localização e apps quase sempre vêm de um fornecedor, o que define tanto o custo quanto o trabalho de compliance.
Usar dados alternativos é legal?
Em geral, usar dados alternativos é legal; o que importa é como o conjunto de dados foi obtido e se ele traz informações que não deveriam ser usadas para negociar.
Informação privilegiada (MNPI). MNPI é a sigla em inglês de material nonpublic information: informação relevante que ainda não é pública e que pode afetar o preço de um ativo. Nos Estados Unidos, consultores de investimento precisam manter políticas escritas para evitar o uso indevido dessa informação (seção 204A do Investment Advisers Act). No alerta de risco de 2022 citado acima, os fiscais da SEC relataram que alguns consultores usavam dados alternativos sem políticas que tratassem do risco de receber MNPI por meio deles. A equipe apontou due diligence improvisada dos fornecedores de dados, falta de avaliação dos termos e das obrigações legais da coleta (mesmo depois de surgirem sinais de alerta), due diligence que não era aplicada a todas as fontes e ausência de um processo para refazê-la quando as práticas de coleta mudavam.
Mentir sobre a origem dos dados. Em setembro de 2021, a SEC acusou a App Annie e seu cofundador de fraude no mercado de valores mobiliários. Segundo a SEC, a empresa dizia aos desenvolvedores de apps que os dados deles seriam agregados e anonimizados antes de entrar em seu modelo estatístico, mas usava dados não agregados para ajustar as estimativas que vendia a empresas de trading. A empresa concordou em pagar uma multa de dez milhões de dólares, e a SEC chamou o caso de sua primeira ação contra um fornecedor de dados alternativos.
Scraping e dados pessoais. Para dados da web, as perguntas são as de qualquer projeto de scraping: as páginas são públicas? Os termos do site permitem acesso automatizado? O robots.txt pede que você não entre? Os dados incluem informações pessoais protegidas por leis como a LGPD, o GDPR ou a KVKK? Web scraping é legal? mostra o panorama geral, e Como tratar dados pessoais (PII) em dados de scraping explica como reduzir e proteger os campos pessoais.
Por que é difícil avaliar a qualidade dos dados alternativos?
Os relatórios financeiros vêm com auditoria e normas; dados alternativos não, então quem compra precisa verificar:
- Cobertura. Um painel de cartão cobre as pessoas que usam os cartões de um emissor ou um aplicativo de notas específico, não a população inteira. Um scraper cobre as páginas que consegue alcançar, não o catálogo inteiro.
- Histórico. Um sinal precisa de anos de histórico para ser testado contra os resultados divulgados.
- Sobrevivência e mudanças. Lojas fecham, sites mudam seus códigos de produto, fornecedores revisam dados antigos.
- Mapeamento. Marcas, subsidiárias e nomes de lojas precisam ser ligados à empresa certa.
- Desgaste. Quando muitas empresas compram o mesmo conjunto de dados, a vantagem que ele oferece diminui. O artigo do CFA Institute citado acima faz a mesma observação.
Onde entra o web scraping?
Web scraping, a coleta automatizada de páginas públicas da web, é a forma como a maioria das equipes constrói seus próprios dados alternativos. Ele funciona bem para respostas que estão publicadas na internet, mas espalhadas por milhares de páginas:
- Preços e promoções. Preços diários em vários varejistas mostram a profundidade dos descontos e a inflação de uma categoria, a mesma técnica tratada em Como monitorar preços da concorrência no e-commerce.
- Contratações. Vagas por cargo e cidade; Como procurar vagas no LinkedIn em outro país mostra como os anúncios mudam conforme o local.
- Avaliações. Número de avaliações e notas ao longo do tempo, pontuadas com métodos como os de Análise de sentimento em Python: VADER vs Hugging Face.
- Mudanças em páginas. Atualizações em localizadores de lojas, páginas de termos ou de preços, acompanhadas como em Como monitorar alterações em um site e receber alertas.
Dois pontos importam aqui. Primeiro, muitos sites mostram preços, estoque e anúncios diferentes conforme o país, então o scraper precisa pedir as páginas a partir do local certo, ou a série mistura regiões. Os endereços de Proxies residenciais permitem escolher o país e a cidade de destino em cada requisição. Segundo, um scraper que roda todos os dias durante anos precisa ser educado: respeite o robots.txt, mantenha as taxas de requisição baixas, use uma API oficial quando houver e distribua as requisições no tempo com as configurações de Proxies rotativos, em vez de atingir um site em rajadas. Proxies não mudam quais dados você pode coletar; eles só definem de qual endereço de rede a requisição sai.
Construir ou comprar dados alternativos?
| Fator | Construir (coletar por conta própria) | Comprar (licenciar de um fornecedor) |
|---|---|---|
| Controle do método | Total; você conhece cada etapa | Limitado ao que o fornecedor divulga |
| Tempo até os primeiros dados | Semanas para um scraper funcionando | Dias após o contrato |
| Histórico | Começa no dia em que você começa | Muitas vezes anos de dados retroativos |
| Trabalho contínuo | Manutenção quando os sites mudam | Due diligence do fornecedor, renovações |
| Trabalho de compliance | Sua própria revisão de fontes e termos | Revisão das fontes e termos do fornecedor |
| Tipos de dados adequados | Dados públicos da web | Dados de cartão, localização, apps e satélite |
A maioria das equipes acaba usando os dois: dados de fornecedores para os tipos que não consegue coletar e scrapers próprios para os dados da web de que precisa em um formato ou país específico.
Onde os dados alternativos são usados?
- Análise de investimentos. Analistas usam dados da web, de cartão e de apps para estimar vendas antes da divulgação dos resultados; a página de proxies para finanças trata da coleta de dados para empresas financeiras.
- Pesquisa de mercado. Consultorias e marcas dimensionam categorias e acompanham o portfólio da concorrência; veja os proxies para pesquisa de mercado.
- Precificação no varejo. Varejistas comparam seus preços com os da concorrência todos os dias, como descrito na página de monitoramento de preços.
- Pesquisa econômica. Preços online e vagas de emprego dão leituras da inflação e da demanda por trabalho antes das estatísticas mensais.
- Produtos de dados. Empresas que constroem conjuntos de dados para terceiros dependem de coleta em grande escala, o caso de uso por trás dos proxies para coleta de dados.
Erros comuns com dados alternativos
- Começar pelo conjunto de dados, não pela pergunta. Um grande conjunto de dados sem hipótese produz gráficos, não respostas.
- Pular a avaliação da fonte. Não saber como um fornecedor coletou seus dados é exatamente a lacuna que o alerta da SEC descreve.
- Misturar locais. Fazer scraping de um site global a partir de um único país e supor que os preços valem para todos os lugares.
- Confiar em um backtest curto. Um sinal testado em um único ano pode ter funcionado por acaso.
- Guardar dados pessoais de que você não precisa. Nomes, e-mails e IDs de usuário raramente acrescentam sinal e sempre acrescentam risco; descarte-os já na coleta.
- Deixar scrapers falharem em silêncio. Uma mudança de layout que retorna páginas vazias parece "as vendas caíram a zero" se você não monitorar a contagem de linhas.
- Tratar o sinal como permanente. Fontes mudam e vantagens se desgastam; revise cada conjunto de dados periodicamente.
Guia de decisão
| Necessidade | Recomendação |
|---|---|
| Preços ou estoque diários de lojas públicas | Construa um scraper; faça requisições a partir do país de destino |
| Gastos do consumidor por marca | Licencie um painel de transações e revise a origem dos dados |
| Atividade física em locais | Licencie dados de satélite ou de fluxo de pessoas |
| Tendências de contratação por empresa | Faça scraping de páginas de carreira e sites de vagas dentro dos termos deles |
| Sentimento da marca ao longo do tempo | Colete avaliações ou posts via APIs e pontue com NLP |
| Vários anos de histórico agora | Compre; um scraper não recupera o passado |
| Um sinal que ninguém mais tem | Construa e documente o método para compliance |
Perguntas frequentes
Qual é a diferença entre dados alternativos e dados tradicionais?
Dados tradicionais são o que empresas e governos publicam formalmente: demonstrações financeiras, documentos regulatórios, teleconferências de resultados e estatísticas oficiais. Dados alternativos são todo o resto que explica o mesmo negócio, como preços na web ou painéis de cartão. A linha é definida pela fonte, não pelo formato.
Web scraping é uma fonte de dados alternativos?
Sim. Dados da web obtidos por scraping (preços, anúncios de produtos, vagas de emprego, avaliações) são um dos tipos mais comuns e o que as equipes mais coletam por conta própria. A coleta deve se limitar a páginas públicas, seguir os termos do site e o robots.txt e manter as taxas de requisição baixas.
Quem usa dados alternativos?
Fundos hedge e gestoras de ativos vieram primeiro. Hoje, gestoras de private equity, credores, varejistas, consultorias e economistas também usam.
Dados alternativos podem conter informação privilegiada?
Podem. A SEC observa que dados alternativos não contêm necessariamente informação privilegiada, mas um conjunto de dados coletado em violação de um acordo de confidencialidade ou dos termos de um site pode trazer informações que não deveriam ser usadas para negociar. Por isso os reguladores esperam que as empresas verifiquem como cada fonte foi coletada antes de usá-la.
Dados alternativos são a mesma coisa que big data?
Não. Big data descreve volume e métodos de processamento; dados alternativos descrevem de onde a informação vem. Alguns conjuntos de dados alternativos são enormes, como anos de preços diários, e outros são pequenos, como uma contagem semanal de inaugurações de lojas.
Como começar com dados alternativos?
Escolha uma pergunta específica, encontre uma fonte que possa respondê-la e colete histórico suficiente para testar a resposta contra resultados conhecidos. Para dados da web, um scraper pequeno com armazenamento organizado e monitoramento é suficiente para começar; acrescente fornecedores só quando precisar de dados que você não consegue coletar.
Em resumo
Dados alternativos são informações de fora do conjunto tradicional de relatórios, demonstrações e estatísticas oficiais: preços na web, vagas de emprego, avaliações, painéis de cartão, imagens de satélite e uso de aplicativos. Eles são úteis quando respondem a uma pergunta específica antes das fontes tradicionais, depois de limpos e testados contra o histórico. O que separa um conjunto de dados utilizável de um arriscado é a avaliação da fonte: quem coletou os dados, como e sob quais termos. Para os dados da web que você coleta por conta própria, o que mais importa são páginas públicas, taxas moderadas e requisições a partir do país certo; a rede de proxies da Proxynet oferece os endereços residenciais e rotativos para essa coleta.