یک تیم پشتیبانی دستیاری میخواهد که از روی مستندات عمومی محصولاتی که پشتیبانی میکند پاسخ بدهد. نسخه اول صفحهها را با Requests دانلود میکند و HTML را به مدل میدهد. پاسخها از بنر کوکی نقلقول میکنند، منو بیش از خود مقاله در پرامپت جا میگیرد، صفحههایی که متنشان را با JavaScript بارگذاری میکنند خالی برمیگردند و صفحهای که هفته گذشته تغییر کرده هنوز از روی نسخه قدیمی پاسخ داده میشود. مدل هیچ مشکلی ندارد. داده هرگز آماده نشده است.
این نوشته همان آمادهسازی را شرح میدهد: RAG چیست، چرا صفحههای وب دشوارترین منبع برای آمادهسازیاند، چرا Markdown هم از HTML و هم از متن ساده بهتر است، خط لوله از دریافت تا بهروزرسانی چگونه کار میکند، یک نمونه اندازهگیریشده روی یک صفحه واقعی با اسکریپت Python در 58 خط، و APIهای اسکرپینگ و پروکسیها کجای این خط لوله قرار میگیرند. اسکریپت در 9 نوامبر 2026 با trafilatura 2.3.1، tiktoken 0.14.0 و Python 3.13 اجرا شد.
RAG چیست و چه کاربردی دارد؟
RAG، کوتاهشده retrieval-augmented generation (تولید تقویتشده با بازیابی)، روشی برای پاسخ دادن با مدل زبانی است که در آن واقعیتها بهجای آنکه فقط از آموزش مدل بیایند، از سندهایی میآیند که در لحظه پرسش بازیابی میشوند. یک بازیاب (retriever) نمایهای از گزیدههای متن را جستوجو میکند، بهترین نتیجهها وارد پرامپت میشوند و مدل پاسخش را از روی آنها مینویسد. نمایه میتواند هر چیزی را که به متن تبدیل شده نگه دارد: فایلهای PDF، تیکتها، سطرهای پایگاه داده و صفحههای وب.
این نام از مقالهای در سال 2020 از پاتریک لوئیس، ایتن پرز، الکساندرا پیکتوس و همکارانشان با عنوان Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks میآید. مقاله یک مدل دنبالهبهدنباله از پیش آموزشدیده را، که دانشش در پارامترهایش نشسته، با یک نمایه برداری متراکم از ویکیپدیا جفت میکند که یک بازیاب عصبی آن را میخواند؛ نویسندگان این دومی را حافظه ناپارامتری مینامند. دو مشکلی که مقاله نام میبرد دقیقاً همانهاییاند که محتوای وب پیش میآورد: بهروز کردن آنچه مدل میداند و نشان دادن اینکه پاسخ از کجا آمده است. تنظیم دقیق (fine-tuning) دانش را در وزنهای مدل جا میدهد، پس هر تغییر صفحه یعنی یک دور آموزش دیگر و هیچ منبعی برای ارجاع؛ در RAG صفحه تغییریافته دوباره دریافت و دوباره نمایه میشود و هر پاسخ میتواند URL و بخش خود را همراه داشته باشد.
چرا صفحههای وب دشوارترین منبع RAG هستند؟
صفحههای وب دشوارند چون محتوایی که میخواهید بخش کوچکی از چیزی است که سرور میفرستد. یک صفحه مستندات درخت ناوبری، سربرگ، پابرگ، اعلان کوکی، دکمههای اشتراکگذاری و «مقالههای مرتبط» را با خود دارد، همه به شکل متنی که یک خط لوله سادهانگارانه آن را کنار مقاله نمایه میکند. وقتی کاربر درباره محدودیت نرخ میپرسد، بازیاب بنر کوکی را برمیگرداند، چون واژه «محدودیت» در آن هست.
سه مشکل دیگر مخصوص وب است. بسیاری از صفحهها متنشان را با JavaScript بارگذاری میکنند، پس در HTML دانلودشده فقط یک عنوان و یک div خالی هست. یک مقاله اغلب در چند URL زندگی میکند، با پارامترهای ردیابی، نمای چاپ، http و https یا اسلش پایانی، پس همان گزیده سه بار در نمایه مینشیند و نتیجههای بالا را با رونوشتهای خودش پر میکند. و صفحهها بیصدا تغییر میکنند: فایل PDF که در مارس نمایه کردید هنوز همان PDF است، اما صفحه قیمت نه. صفحهبندیای را که یک سند را روی چند صفحه پخش میکند و خطاهای کدگذاریای را که — را به — تبدیل میکنند هم اضافه کنید؛ این وضعیت عادی یک سایت عمومی است.
چرا Markdown و نه HTML یا متن ساده؟
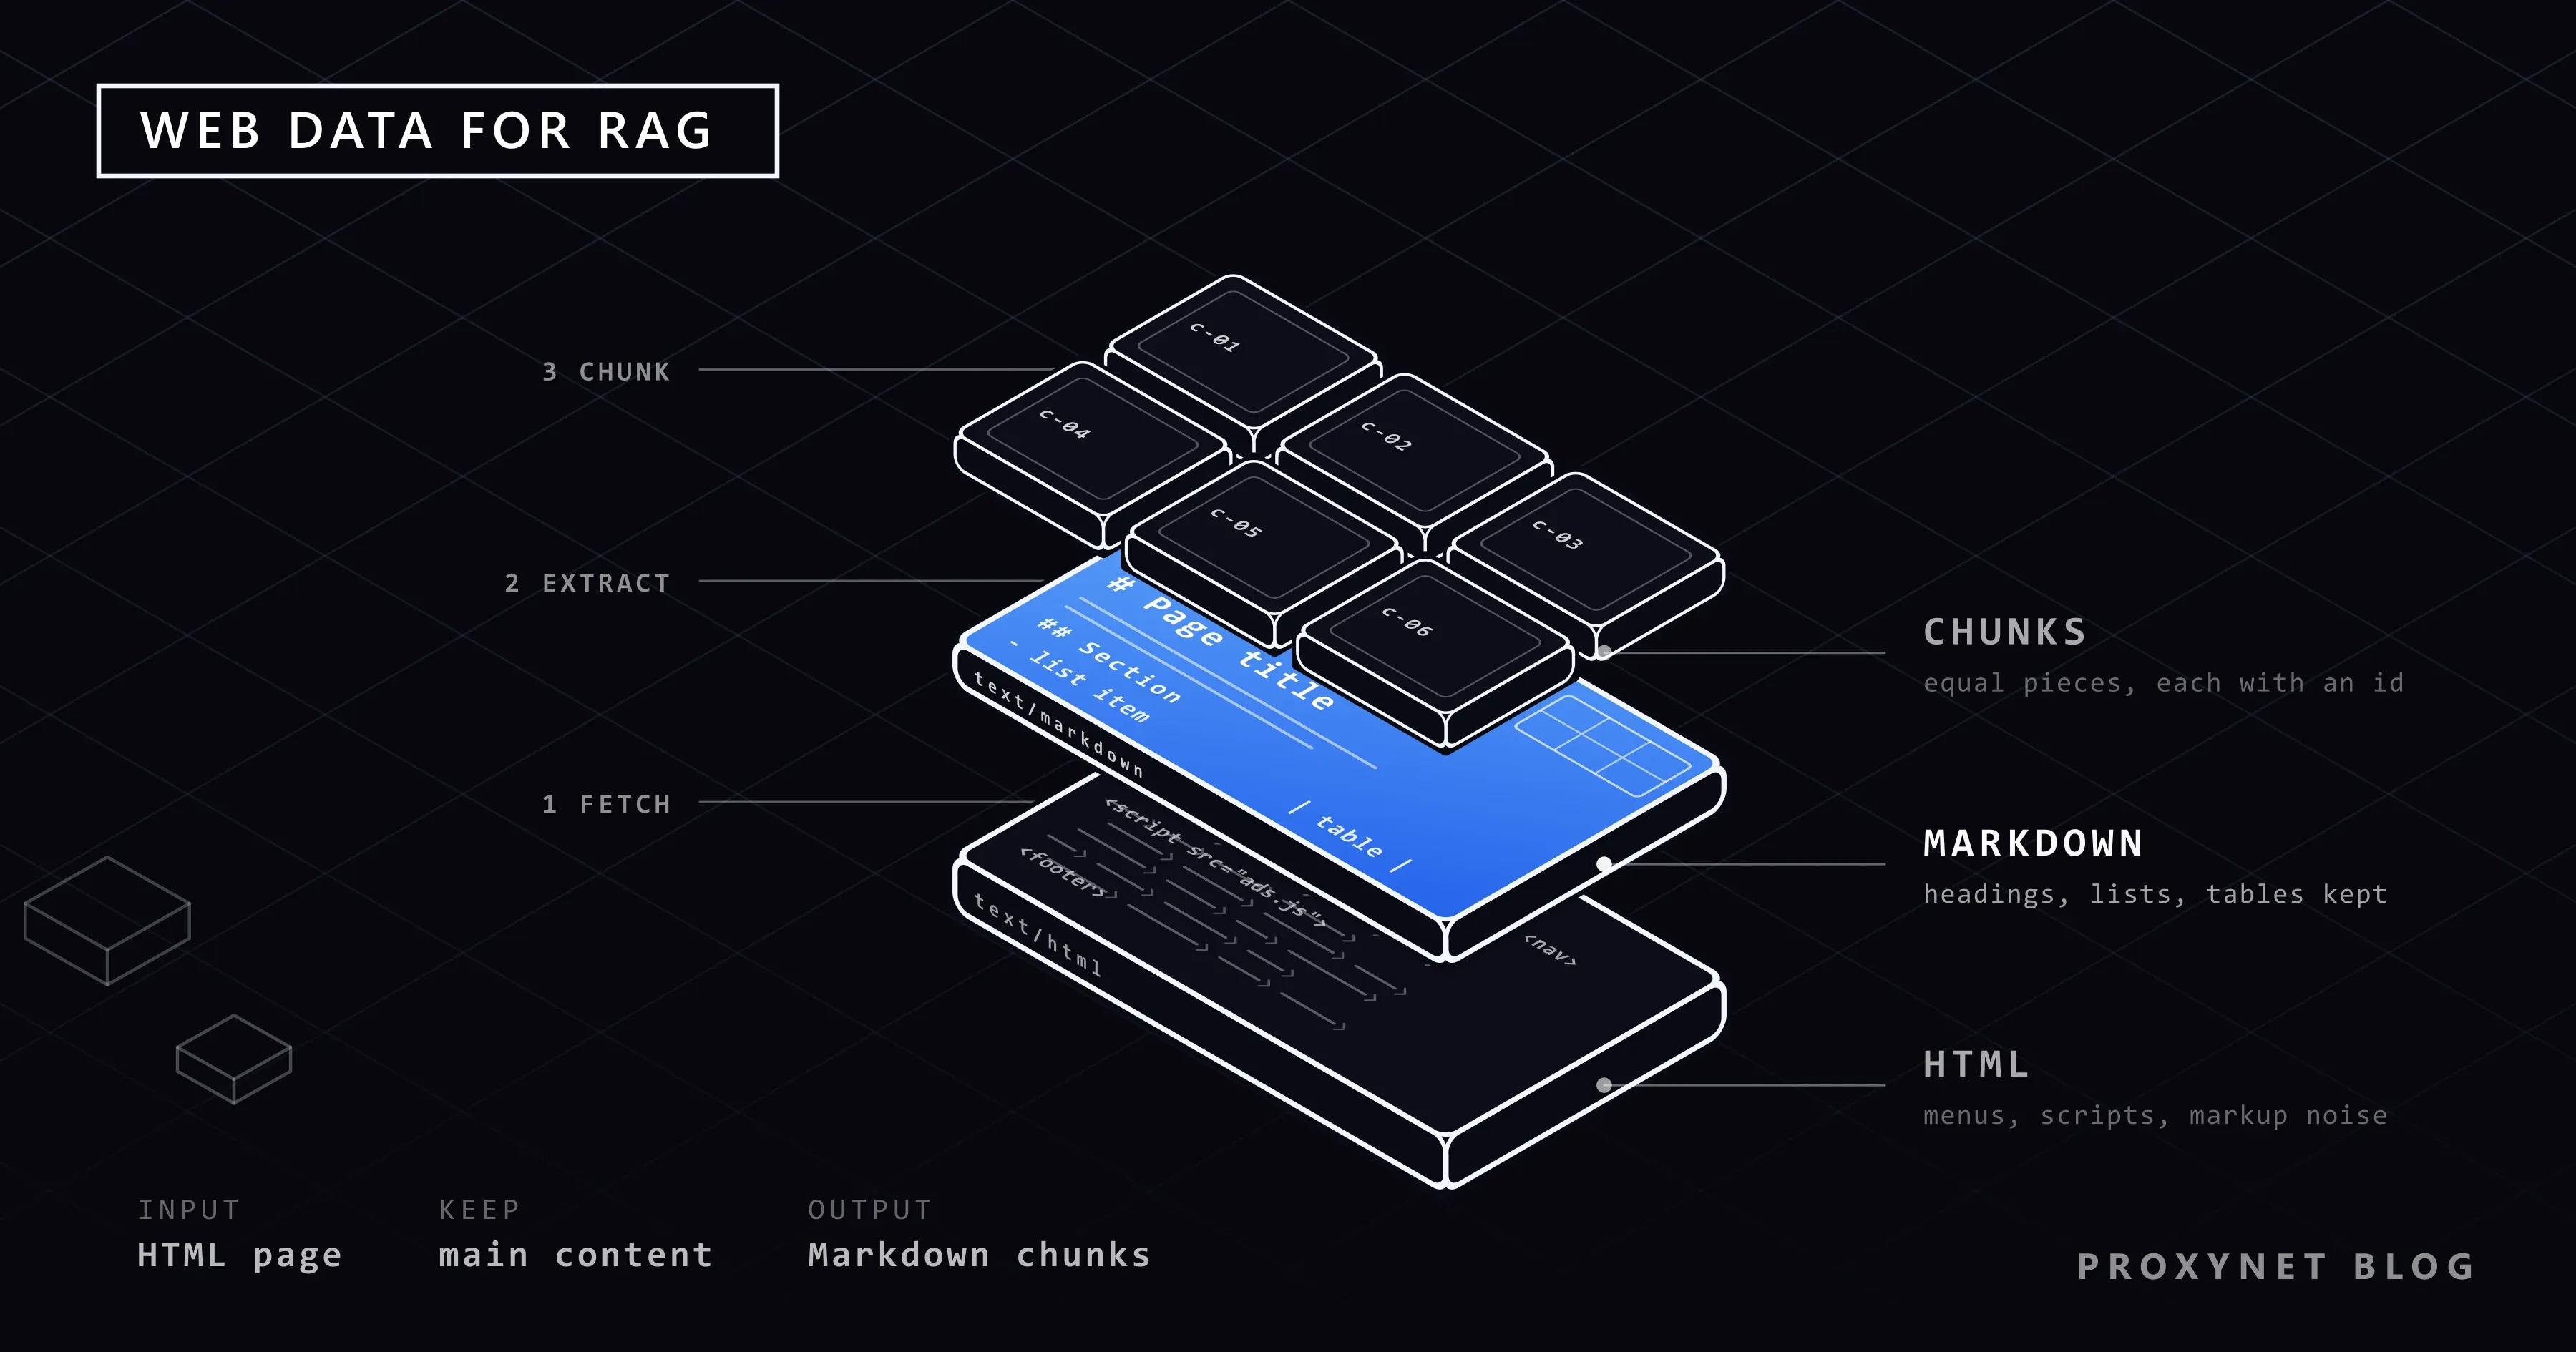
Markdown قالب میانی درست است، چون ساختاری را که بازیاب و مدل لازم دارند، مانند عنوانها، فهرستها، جدولها، بلوکهای کد و پیوندها، نگه میدارد و در عین حال نشانهگذاری، اسکریپتها و استایلهای بیمعنا را دور میریزد. HTML بیشتر توکنهایش را خرج تگها و ویژگیها میکند. متن ساده در جهت مخالف زیادهروی میکند: جدول به رشتهای از واژهها تبدیل میشود، عنوان مثل هر سطر دیگری میشود و دیگر جای قابل اعتمادی برای بریدن تکه وجود ندارد. پیشنهاد llms.txt، که از سایتها میخواهد نسخه Markdown صفحههایشان را منتشر کنند، آن را صریح میگوید: "At the moment the most widely and easily understood format for language models is Markdown." (در حال حاضر رایجترین و قابلفهمترین قالب برای مدلهای زبانی Markdown است).
ما این تفاوت را روی یک صفحه واقعی اندازه گرفتیم: راهنمای HOWTO مستندات Python درباره دریافت منابع اینترنتی با urllib، با توکنایزر o200k_base از tiktoken. این عددها همین صفحه را توصیف میکنند، نه کل وب را.
| قالب | چه چیزی باقی میماند | توکن در صفحه آزمایشی | تکهها کجا بریده میشوند |
|---|---|---|---|
| HTML خام | همه چیز، از جمله منوها، اسکریپتها و نشانهگذاری | 21,044 | در تگها، که درباره معنا هیچ نمیگویند |
| متن ساده | فقط واژهها؛ عنوانها و جدولها صاف میشوند | 4,133 | در بهترین حالت، در سطرهای خالی |
| Markdown | عنوانها، فهرستها، جدولها، کد و پیوندها | 4,405 | در سطرهای عنوان |
Markdown در این صفحه 272 توکن، حدود 7 درصد، بیش از متن ساده هزینه داشت و در عوض هر عنوان بخش هنوز یک عنوان است. در برابر HTML خام 4.8 برابر کوچکتر است. یک هشدار: Markdown برای هسته خود مشخصاتی دارد، CommonMark (نسخه 0.31.2، ژانویه 2024)، اما جدولهای با خط عمودی (pipe table) و بلوکهای کد محصور (fenced code block) افزونههاییاند که گیتهاب رواج داده است، پس مطمئن شوید مبدل شما آنها را مینویسد، نه اینکه دور بریزد.
خط لوله وب به RAG چگونه کار میکند؟
خط لوله ده گام دارد و ترتیب مهم است، چون هر گام به گام پیش از خود تکیه میکند.
- فقط چیزی را دریافت کنید که اجازه دارید. پیش از نخستین درخواست robots.txt سایت را بخوانید و مسیرهای غیرمجاز را کنار بگذارید؛ قاعدهها در راهنمای robots.txt ما توضیح داده شدهاند. شرایط استفاده را بخوانید، یک
User-Agentبفرستید که نام ربات شما و یک نشانی تماس را دارد و در هر دامنه آهنگ درخواست مؤدبانهای نگه دارید. اگر سایت نسخه Markdown صفحههایش را منتشر میکند، بهجای تجزیه HTML از همانها استفاده کنید. - محتوای اصلی را استخراج کنید. trafilatura یک بسته Python و ابزار خط فرمان با مجوز Apache 2.0 است که HTML خام را به متن، Markdown، XML یا JSON تبدیل میکند و عنوان، نویسنده و تاریخ را هم بیرون میکشد. Mozilla Readability کتابخانه JavaScript پشت Reader View (نمای خواندن) فایرفاکس است؛
new Readability(document).parse()عنوان، محتوای پاکسازیشده و سطر نام نویسنده را برمیگرداند. هر دو بر اساس ساختار و چگالی متن کار میکنند، بدون تجزیهگر مخصوص هر سایت. - به Markdown تبدیل کنید. trafilatura با
output_format="markdown"مستقیماً Markdown مینویسد. اگر از قبل HTML پاکسازیشده دارید، markdownify در Python یا Turndown در JavaScript آن را تبدیل میکنند؛ عنوانهای#به سبک ATX را انتخاب کنید، چون تکهکننده روی همانها میبرد. صفحههایی که محتوایشان را با JavaScript میسازند به مرورگر نیاز دارند: Crawl4AI آنها را در Chromium رندر میکند و یک Markdown «fit» بدون منو برمیگرداند، همانطور که در راهنمای Crawl4AI ما نشان دادهایم. - پاکسازی کنید. آنچه را استخراجکننده جا گذاشته حذف کنید: نشانههای لنگر پس از عنوانها، پیوندهای «ویرایش این صفحه»، مسیر ناوبری (breadcrumb)، فاصلههای تکراری. کدگذاری را در منبع درست کنید، نه در متن. بلوکهای کد و جدولها را دقیقاً همانطور که هستند بگذارید.
- در محل عنوانها و درون یک بودجه توکن تکهتکه کنید. جایی که یک سطر عنوان شروع میشود ببرید، مسیر عنوان را بهصورت فراداده نگه دارید (
Fetching URLs > Data) و بخشهای بزرگتر از بودجه را در مرز پاراگرافها بشکنید. توکنها را با توکنایزر مدلی بشمارید که با آن embedding میسازید؛ tiktoken توکنایزر سریع BPE برای مدلهای OpenAI است وo200k_baseهمان کدگذاریای است که README آن به کار میبرد. نویسه جای توکن را نمیگیرد: 500 نویسه در نثر انگلیسی حدود 100 توکن است و در کد بسیار بیشتر. - موارد تکراری را حذف کنید. از متن نرمالشده تکه هش بگیرید؛ دو تکه با هش یکسان، از هر URL که آمده باشند، یک گزیدهاند. موارد تقریباً تکراری، مانند همان صفحه با یک سطر «آخرین بهروزرسانی» متفاوت، به آزمون شباهت روی دنبالههای واژه (shingle) یا روی embeddingها نیاز دارند.
- اطلاعات منشأ را بچسبانید. هر تکه URL، زمان دریافت، عنوان صفحه، مسیر بخش، هش محتوا و تعداد توکن خود را همراه دارد. بدون اینها نه میتوانید ارجاع بدهید، نه بهروز کنید و نه حذف کنید.
- embedding بسازید و نمایه کنید. هر تکه در یک نمایه برداری به یک بردار تبدیل میشود؛ بسیاری از تیمها یک نمایه کلیدواژهای هم کنار آن میگذارند و دو فهرست نتیجه را ادغام میکنند. اینکه کدام مدل و پایگاه داده را انتخاب میکنید گامهای بالا را تغییر نمیدهد.
- بهروز کنید. هدرهای
ETagوLast-Modifiedرا ذخیره کنید و دفعه بعدIf-None-MatchیاIf-Modified-Sinceبفرستید؛ پاسخ304 Not Modifiedتقریباً هیچ هزینهای ندارد و صفحه آزمایشی ما هر دو هدر را فرستاد. از تاریخهایlastmodنقشه سایت برای تصمیم درباره اینکه اول به کجا سر بزنید استفاده کنید، تکهها را بر اساس URL و بخش جایگزین کنید و تکههای صفحههایی را که حالا 404 یا 410 برمیگردانند حذف کنید. - بازیابی را ارزیابی کنید. 30 یا 50 پرسش واقعی را همراه با گزیدهای که به هر کدام پاسخ میدهد بنویسید و اندازه بگیرید چند بار تکه درست در نتیجههای بالا هست. اندازه تکه، همپوشانی و بودجه را بر اساس همین عدد تنظیم کنید، نه بر اساس حس.
نمونه آزموده: یک صفحه از HTML تا تکههای Markdown
اسکریپت هفت گام اول را روی یک صفحه اجرا میکند و آنچه را یافته چاپ میکند. صفحهای از مستندات Python را انتخاب کردیم که robots.txt آن /dev، /release و نسخههای قدیمی مانند /3.10/ را ممنوع و /3/ را مجاز میکند، بررسیشده در 9 نوامبر 2026؛ اسکریپت پیش از دریافت، آن را با urllib.robotparser دوباره بررسی میکند.
python -m venv .venv
.venv/bin/pip install trafilatura tiktoken requests   # Windows: .venv\Scripts\pip
دو نکته دو سطر کد را توضیح میدهند. docs.python.org هدر Content-Type: text/html را بدون charset میفرستد، پس resp.text در Requests صفحه را بهصورت ISO-8859-1 رمزگشایی میکرد و هر عنوان به یک Â اضافی ختم میشد؛ صفحه در <meta charset> خود UTF-8 را اعلام میکند، پس اسکریپت بایتها را خودش رمزگشایی میکند. و مولد مستندات پس از هر عنوان یک نشانه پاراگراف (¶) بهعنوان پیوند لنگر میگذارد که trafilatura آن را بهصورت متن نگه میدارد، پس گام پاکسازی آن را حذف میکند. نکته سومی برای تکهبندی مهم است: صفحه 17 بلوک کد محصور دارد که کامنتهای Python درونشان با # شروع میشوند، پس تکهکنندهای که روی هر سطر # ببرد، وسط کد را میبرد و کامنتها را عنوان میپندارد. اسکریپت هر بلوک محصور را یکپارچه نگه میدارد.
"""Fetch one public page, keep its main content as Markdown, chunk it by heading and count tokens."""
import hashlib, json, re, sys
from datetime import datetime, timezone
from urllib.parse import urlsplit
from urllib.robotparser import RobotFileParser
import requests
import tiktoken
import trafilatura

URL = sys.argv[1] if len(sys.argv) > 1 else "https://docs.python.org/3/howto/urllib2.html"
UA = "rag-prep-demo/1.0 (+https://example.com/bot)"
BUDGET = 512                                  # max tokens per chunk; longer sections are split by paragraph
enc = tiktoken.get_encoding("o200k_base")     # the tokenizer of OpenAI's current models
tokens = lambda s: len(enc.encode(s))

# 1. robots.txt first: stop if the path is disallowed for our user agent
robots = RobotFileParser(urlsplit(URL)._replace(path="/robots.txt", query="", fragment="").geturl())
robots.read()
if not robots.can_fetch(UA, URL):
    sys.exit(f"robots.txt disallows {URL}")

# 2. one fetch, three views of the same page: raw HTML, main content as Markdown, plain text
resp = requests.get(URL, headers={"User-Agent": UA}, timeout=30)
resp.raise_for_status()
html = resp.content.decode("utf-8")           # the page declares UTF-8; resp.text would guess ISO-8859-1
fetched_at = datetime.now(timezone.utc).isoformat(timespec="seconds")
md = trafilatura.extract(html, url=URL, output_format="markdown", include_tables=True, include_formatting=True)
md = md.replace("¶", "")                 # clean: Sphinx leaves a pilcrow anchor after every heading
txt = trafilatura.extract(html, url=URL, output_format="txt", include_tables=True)
title = trafilatura.extract_metadata(html, default_url=URL).title

# 3. split into blocks (paragraphs, heading lines, whole code fences), then cut at headings and at the budget
blocks = []
for seg in re.split(r"(```[\s\S]*?```)", md.strip()):           # a fenced code block is one block, never cut
    blocks += [seg] if seg.startswith("```") else [p.strip() for p in re.split(r"\n\s*\n|\n(?=#{1,6} )", seg) if p.strip()]
chunks, path, piece = [], [], ""
for block in blocks + ["# end"]:                                 # the sentinel heading flushes the last chunk
    head = re.match(r"(#{1,6}) (.+)", block)
    if head or (piece and tokens(piece + "\n\n" + block) > BUDGET):
        if piece:
            chunks.append((list(path), piece))                   # a heading with no text under it adds no chunk
        piece = "" if head else block
    else:
        piece = f"{piece}\n\n{block}".strip()
    if head:
        path = path[:len(head.group(1)) - 1] + [head.group(2).strip()]

# 4. provenance: every chunk carries where it came from, when, and a hash for de-duplication
records = [{"url": URL, "fetched_at": fetched_at, "title": title, "section": " > ".join(p[1:]) or "(top)",
            "content_hash": hashlib.sha256(text.encode()).hexdigest()[:16], "tokens": tokens(text), "text": text}
           for p, text in chunks]

print(f"page: {title}\nfetched: {fetched_at}")
print(f"tokens (o200k_base): html={tokens(html)}  markdown={tokens(md)}  text={tokens(txt)}")
sizes = sorted(r["tokens"] for r in records)
print(f"chunks: {len(records)}  min={sizes[0]}  median={sizes[len(sizes) // 2]}  max={sizes[-1]}  budget={BUDGET}")
print("\n".join(f"  {r['tokens']:>4} tok  {r['content_hash']}  {r['section'][:60]}" for r in records[:6]))
print(json.dumps({k: v for k, v in records[1].items() if k != "text"}, indent=2))
این خروجی را چاپ کرد:
page: HOWTO Fetch Internet Resources Using The urllib Package
fetched: 2026-11-09T12:32:13+00:00
tokens (o200k_base): html=21044  markdown=4405  text=4133
chunks: 19  min=10  median=183  max=495  budget=512
   276 tok  e21a9bc9bc9dc71b  Introduction
   460 tok  30fc2c8722d53c1a  Fetching URLs
   434 tok  51aca2bdee7780e4  Fetching URLs > Data
   144 tok  f8e6254387670d87  Fetching URLs > Data
   329 tok  3b49bcc1ef1326f3  Fetching URLs > Headers
    79 tok  3928e9cb23c19eee  Handling Exceptions
{
  "url": "https://docs.python.org/3/howto/urllib2.html",
  "fetched_at": "2026-11-09T12:32:13+00:00",
  "title": "HOWTO Fetch Internet Resources Using The urllib Package",
  "section": "Fetching URLs",
  "content_hash": "30fc2c8722d53c1a",
  "tokens": 460
}
صفحه به 19 تکه با میانه 183 توکن تبدیل شد و هیچکدام از بودجه 512 توکنی فراتر نرفت. "Fetching URLs > Data" دو بار دیده میشود، چون آن بخش از بودجه بلندتر بود و در مرز یک پاراگراف به 434 و 144 توکن بریده شد؛ دو قطعه یک مسیر بخش مشترک دارند اما هشهایشان متفاوت است، و گام حذف موارد تکراری دقیقاً همین را لازم دارد. کوچکترین تکه 10 توکن دارد، بخش یکجملهای «Footnotes» صفحه؛ یک خط لوله عملیاتی آن را با همسایهاش ادغام میکرد. نوار کناری، پیوندهای قبلی و بعدی و پابرگ صفحه اصلی اصلاً در Markdown دیده نمیشوند، و این یعنی استخراجکننده کارش را کرده است. رکورد JSON همان اطلاعات منشأ است که همراه تکه به نمایه میرود؛ بسیاری از تیمها پیش از ساختن embedding مسیر بخش را هم به ابتدای متن میافزایند.
APIهای اسکرپینگ کجا به کار میآیند؟
API اسکرپینگ وقتی به کار میآید که رندر، استخراج و رعایت ادب باید مشکل کس دیگری باشد. بسیاری از آنها مستقیماً Markdown برمیگردانند، صفحههای JavaScript را در مرورگر رندر میکنند و نرخ درخواست را برای هر دامنه مدیریت میکنند، پس خط لوله شما از گام تکهبندی شروع میشود. چهار بررسی میگوید یک سرویس به درد یک پیکره RAG میخورد یا نه: ده صفحهای را که میشناسید دریافت کنید و در Markdown دنبال منوها و جدولهایی بگردید که کامل رسیدهاند؛ مطمئن شوید عنوان، URL متعارف (canonical) و در صورت وجود تاریخ آخرین تغییر همراه محتوا میآیند، چون اینها به اطلاعات منشأ تبدیل میشوند؛ همان صفحه تغییرنکرده را دو بار بگیرید و خروجی را مقایسه کنید، وگرنه هشهایتان هر صفحه را تغییریافته علامت میزنند؛ و بپرسید سرویس با robots.txt و محدودیتهای نرخ چه میکند، چون درخواستها از طرف شما انجام میشوند.
پروکسی کجا به کار میآید؟
پروکسی اینجا در دو وضعیت به کار میآید و هیچکدام درباره دریافت سریعتر از یک سایت نیست. اولی گستردگی است: یک پیکره RAG اغلب صدها دامنه را در بر میگیرد و خزندهای که آهنگ هر دامنه را رعایت میکند باز هم میتواند دامنههای زیادی را همزمان پیش ببرد. پخش کردن این دریافتها روی بیش از یک نشانی خروجی، برای نمونه از طریق پروکسی چرخشی، باعث میشود هر دامنه همچنان یک کلاینت آهسته و مؤدب ببیند، در حالی که کل کار بهجای چند روز در چند ساعت تمام میشود.
دومی موقعیت مکانی است. صفحههای مستندات، راهنما و قیمت اغلب بسته به کشور یا زبان بازدیدکننده فرق میکنند و نمایهای که از نسخه اشتباه ساخته شده به کاربران با محتوایی پاسخ میدهد که هرگز نمیبینند. دریافت از کشوری که کاربران شما در آن هستند، با پروکسی مسکونی و هدفگیری کشور، همان صفحهای را نمایه میکند که آنها واقعاً میخوانند. robots.txt، شرایط استفاده و نرخ درخواست از هر نشانیای که درخواست خارج شود یکسان میمانند.
اشتباهات رایج
- تکهبندی بر اساس تعداد نویسه بدون توجه به عنوانها. پنجرهای 1,000 نویسهای که روی دو بخش میافتد به هیچکدام از دو پرسش پاسخ نمیدهد. اول در عنوانها ببرید، بعد در پاراگرافها.
- نمایه کردن محتوای قالبی (boilerplate). اعلانهای کوکی، منوها و پابرگها به تکههایی تبدیل میشوند که با همه چیز کمی و با هیچ چیز خوب جور درمیآیند.
- نداشتن اطلاعات منشأ. بدون URL، زمان دریافت و بخش نمیتوانید منبعی را ارجاع بدهید، صفحه تغییریافتهای را بهروز کنید یا صفحهای را که برداشته شده حذف کنید.
- هرگز بهروز نکردن. پیکرهای که یک بار ساخته شود یک تصویر لحظهای است؛ درخواستهای شرطی با
ETagوLast-Modifiedبهروزرسانی هفتگی را ارزان میکنند. - ساختن embedding از یک صفحه چند بار. پارامترهای ردیابی، نماهای چاپ و اسلشهای پایانی رونوشتهایی میسازند که نتیجههای بالا را شلوغ میکنند؛ از محتوا هش بگیرید، نه از URL.
- شمردن نویسه بهجای توکن، یا شمردن با توکنایزری غیر از آنچه مدل embedding به کار میبرد.
- بریدن درون بلوکهای کد و جدولها. کامنت
#درون کد عنوان نیست و نصف جدول به هیچ چیز پاسخ نمیدهد. - نمایه کردن صفحه خالی. اگر محتوا با JavaScript ساخته میشود، HTML دانلودشده مقالهای ندارد؛ پیش از نمایه کردن تعداد توکن متن استخراجشده را بررسی کنید.
- دریافت چیزی که robots.txt یا شرایط استفاده کنار گذاشتهاند، یا سریعتر از آنچه یک انسان میخواند. وضعیت حقوقی (پرسش آخر در پرسشهای متداول) با حجم بهتر نمیشود.
راهنمای انتخاب
| نیاز | پیشنهاد |
|---|---|
| چند صد صفحه مستندات | trafilatura به Markdown، تکههای عنوانمحور 200 تا 500 توکنی، بهروزرسانی هفتگی |
| صفحههایی که با JavaScript رندر میشوند | یک استخراجکننده مبتنی بر مرورگر مانند Crawl4AI، یا یک API اسکرپینگ که Markdown برمیگرداند |
| سایت نسخه Markdown یا llms.txt ارائه میدهد | همتاهای .md را دریافت کنید و از استخراج بگذرید |
| پاسخها باید منبع خود را ارجاع بدهند | اطلاعات منشأ روی هر تکه: URL، زمان دریافت، عنوان، مسیر بخش، هش |
| یک گزیده مدام در نتیجهها تکرار میشود | هش محتوا، نرمالسازی URL، آزمون موارد تقریباً تکراری |
| صدها دامنه، هر کدام با آهنگ مؤدبانه | دامنههای موازی روی چند خروجی با پروکسی چرخشی |
| مستندات یا قیمتهای مخصوص هر کشور | پروکسی مسکونی با هدفگیری کشور |
| تیمی برای اداره خط لوله ندارید | یک API اسکرپینگ مدیریتشده که Markdown را همراه فراداده تحویل میدهد |
پرسشهای متداول
RAG مخفف چیست و چه فرقی با تنظیم دقیق دارد؟
RAG مخفف retrieval-augmented generation است: مدل از روی گزیدههایی پاسخ میدهد که در لحظه پرسش بازیابی شدهاند. تنظیم دقیق وزنهای مدل را با داده آموزشی تغییر میدهد، پس اطلاعات تازه به یک دور آموزش تازه نیاز دارد و مدل نمیتواند بگوید پاسخ از کدام سند آمده است. RAG با نمایه کردن دوباره یک صفحه بهروز میشود و میتواند URL و بخشی را که به کار برده ارجاع بدهد.
چرا Markdown برای LLMها بهتر از HTML است؟
Markdown ساختار مهم را، مانند عنوانها، فهرستها، جدولها و کد، در چند نویسه نگه میدارد، در حالی که HTML بیشتر توکنهایش را خرج تگها، ویژگیها و اسکریپتها میکند. در صفحه آزمایشی ما Markdown 4,405 توکن بود در برابر 21,044 توکن HTML، و تکهها همچنان میتوانستند در عنوانها بریده شوند.
اندازه ایدهآل تکه برای RAG چقدر است؟
عدد واحدی وجود ندارد؛ بازهای که برای مستندات جواب میدهد 200 تا 500 توکن با برش در عنوانهاست و مقدار درست همان است که در آزمون بازیابی خودتان بهترین امتیاز را میگیرد. تکههای کوچکتر دقیقتر جور درمیآیند اما زمینه را از دست میدهند؛ تکههای بزرگتر زمینه را دارند اما تطابق را رقیق میکنند.
صفحهها را برای RAG هر چند وقت یک بار دوباره بخزیم؟
به همان اندازه که صفحهها تغییر میکنند، و درخواستهای شرطی این را ارزان به شما میگویند: مقدار ذخیرهشده ETag یا Last-Modified را بفرستید و پاسخ 304 Not Modified یعنی هیچ چیز تغییر نکرده است. برای مستندات معمولاً هفتگی کافی است، صفحههای قیمت و وضعیت روزانه، و تاریخهای lastmod نقشه سایت میگویند اول به کجا نگاه کنید.
آیا llms.txt جای اسکرپینگ را میگیرد؟
نه. llms.txt فهرستی گزینششده از صفحههای مهم یک سایت برای ابزارهای هوش مصنوعی است و همان پیشنهاد از سایتها میخواهد نسخه Markdown صفحهها را هم ارائه کنند؛ هر جا هر دو وجود دارند، Markdown را دریافت کنید و از استخراج بگذرید. بیشتر سایتها هیچکدام را منتشر نمیکنند و این فایل هیچ کنترلی بر دسترسی ندارد، همانطور که راهنمای llms.txt ما توضیح میدهد، پس همچنان robots.txt و شرایط استفاده تعیین میکنند چه چیزی را میتوانید دریافت کنید.
آیا استفاده از صفحههای وب اسکرپشده در RAG قانونی است؟
این به سایت و حوزه قضایی بستگی دارد، و آنچه میآید توصیف است، نه مشاوره حقوقی. معمولاً چهار چیز بررسی میشود: robots.txt، که RFC 9309 آن را درخواستی از خزندهها توصیف میکند و نه مجوز دسترسی؛ شرایط استفاده سایت، که اغلب دسترسی خودکار را ممنوع میکنند؛ حق نشر (کپیرایت)، که به بازتولید متن مربوط است و به این بستگی دارد که یک پاسخ چه مقدار از صفحه را تکرار میکند و آیا منبع را ذکر میکند یا نه؛ و داده شخصی درون صفحهها، که GDPR و KVKK ترکیه آن را تنظیم میکنند و یک پیکره RAG اصلاً نباید آن را جمعآوری کند. اطلاعات منشأ روی هر تکه به شما امکان میدهد یک منبع را به درخواست حذف کنید. پیش از ساختن پیکره از سایتهای شخص ثالث با یک وکیل مشورت کنید.
خلاصه
RAG از روی گزیدههای بازیابیشده پاسخ میدهد، پس کیفیت پاسخها را کیفیت گزیدهها تعیین میکند. برای منابع وب این یعنی فقط چیزی را دریافت کنید که اجازه دارید، محتوای اصلی را استخراج کنید، بهجای HTML یا متن ساده به Markdown تبدیل کنید، در محل عنوانها و درون یک بودجه توکن تکهتکه کنید، اطلاعات منشأ بچسبانید، موارد تکراری را حذف کنید و با درخواستهای شرطی بهروز نگه دارید. در صفحه آزمایشی ما این خط لوله 21,044 توکن HTML را از راه یک Markdown 4,405 توکنی به 19 تکه تمیز تبدیل کرد، با اسکریپتی آنقدر کوتاه که در یک نشست خوانده شود. اگر ترجیح میدهید بهجای ساختن خط لوله، Markdown آماده تحویل بگیرید، Web Scraping API ما، سرویس استخراج صفحه مدیریتشده که از طریق تیم فروش در دسترس است، در صفحه استخراج داده توضیح داده شده است.