

































Blog de Proxynet – Página 8
Publicado
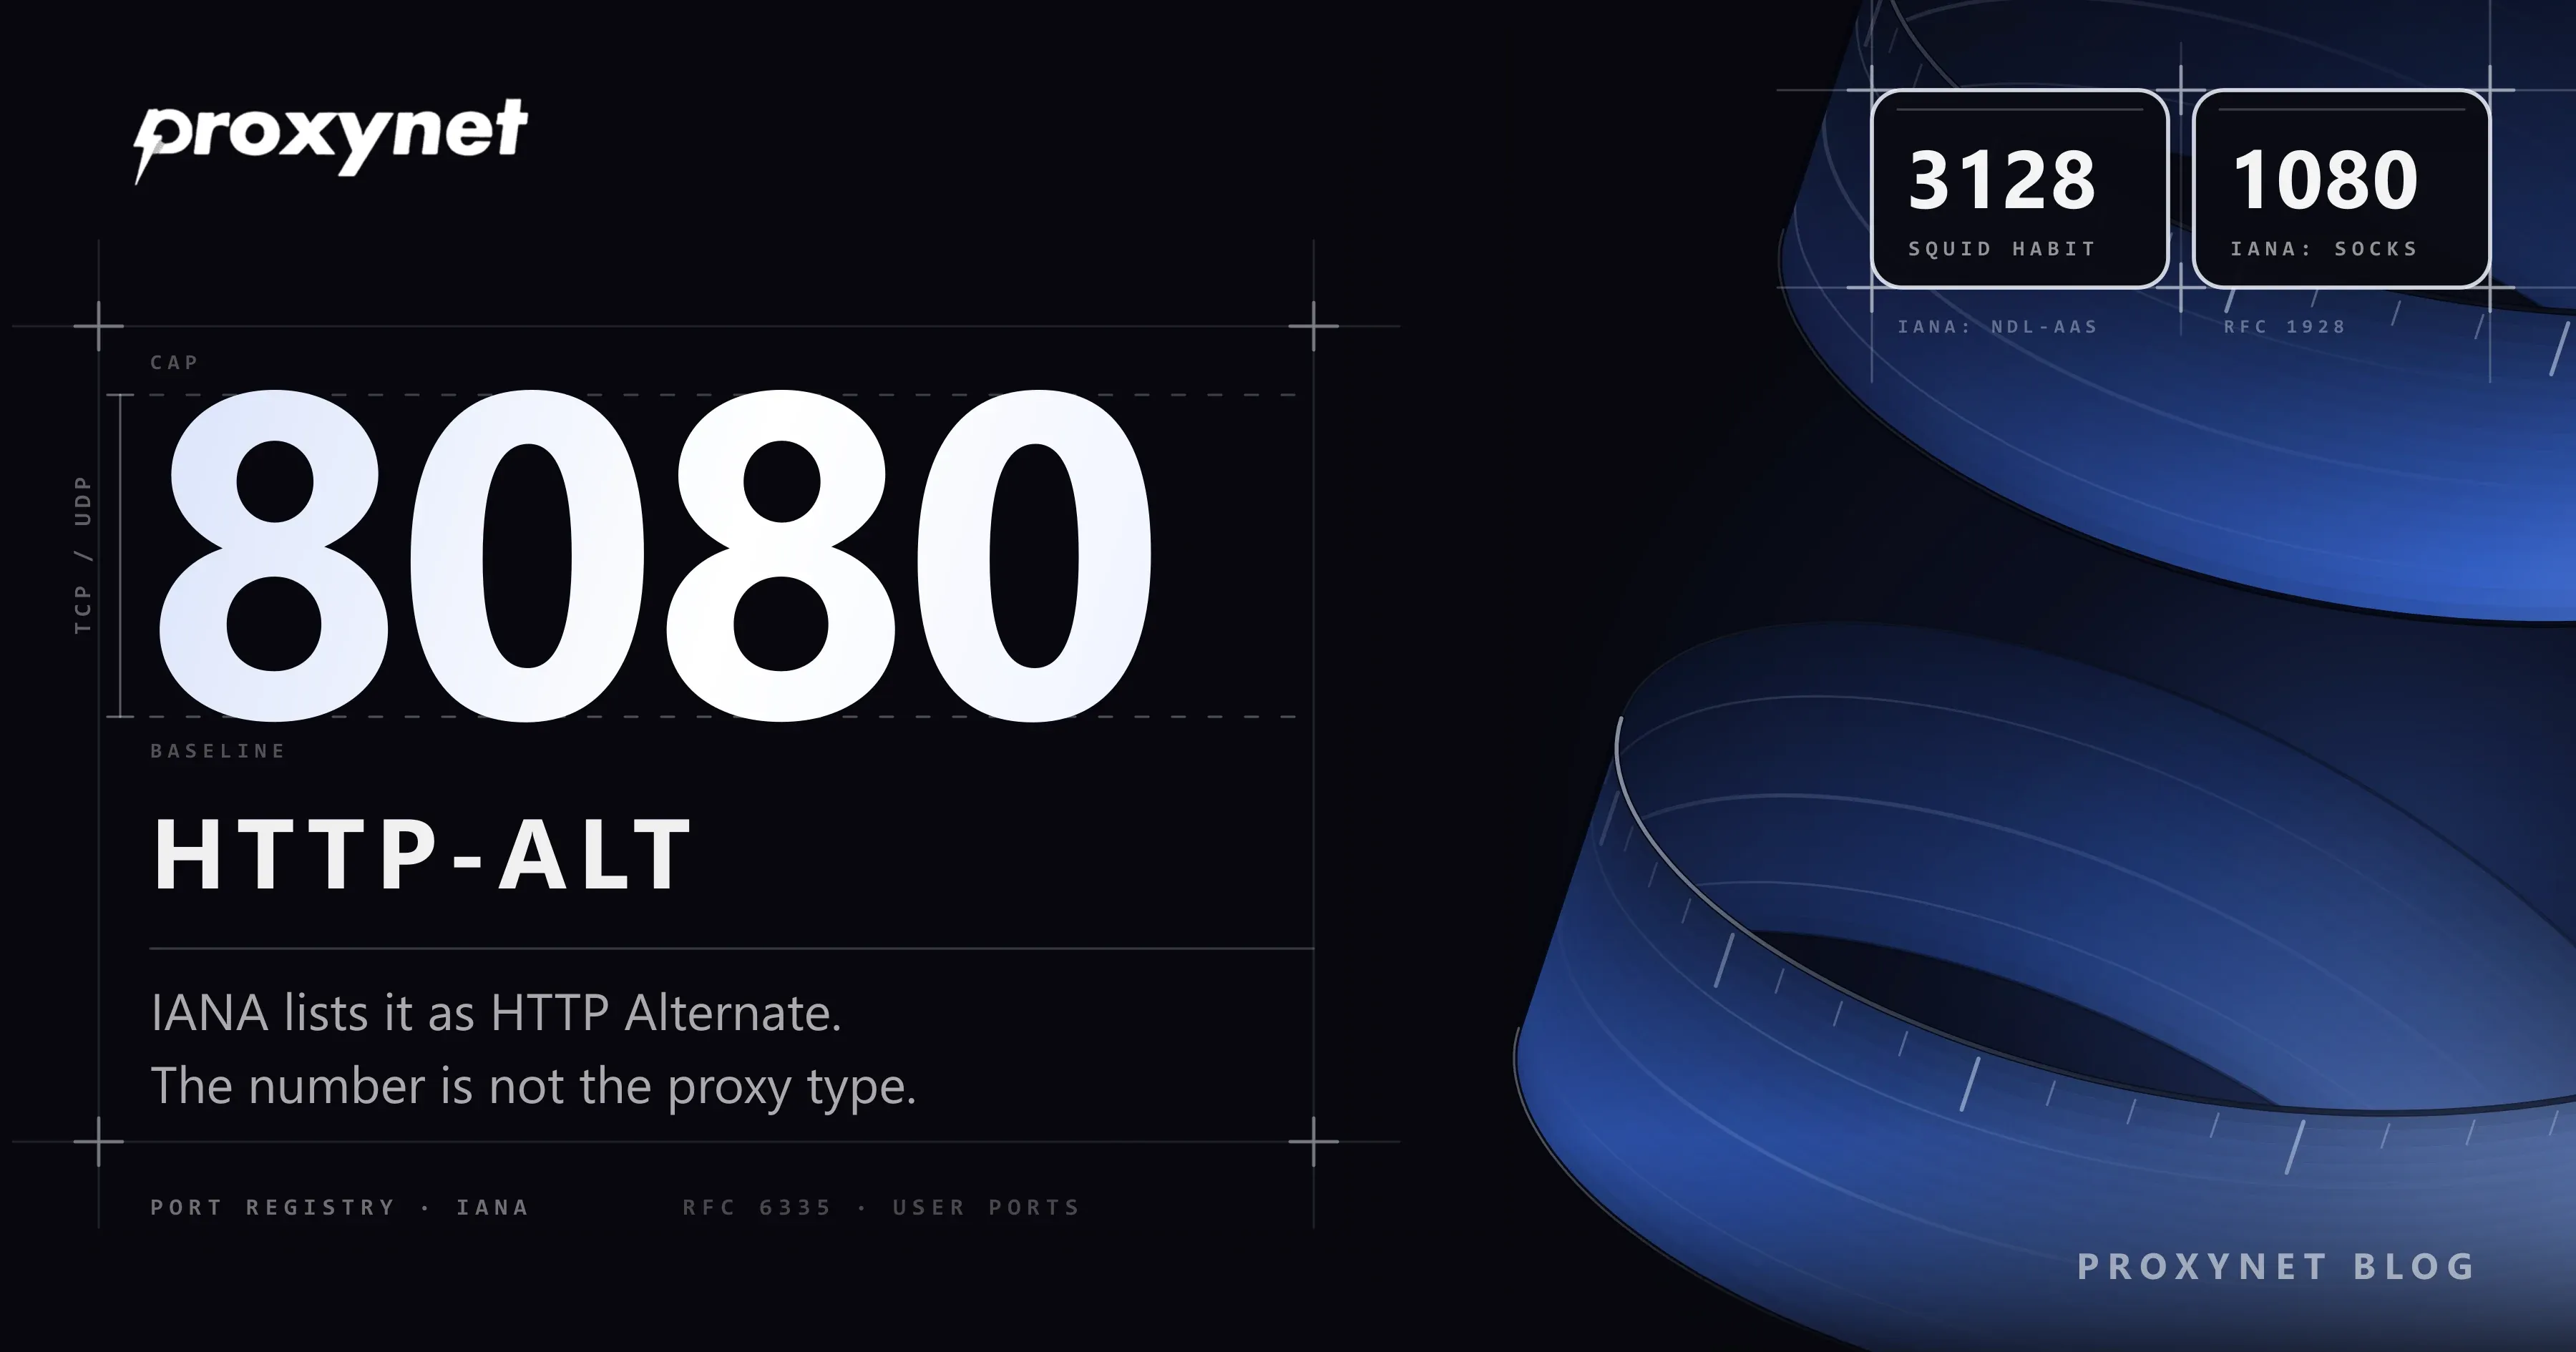
¿Qué es el puerto 8080? Puertos de proxy y qué significan
El 8080 es el puerto HTTP alternativo de IANA, usado por proxies y servidores de desarrollo. Qué significan 3128, 1080 y 443 y cómo liberar el puerto ocupado.
Autor: Enver Kaya
Publicado
Codificación en Python: tildes, ñ y UnicodeDecodeError
Errores de codificación en Python: por qué se rompen las tildes y la ñ, y cómo arreglar UnicodeDecodeError en archivos, Windows y páginas web.
Autor: Acar Diveroli
Publicado
Proxy Squid en Ubuntu 24.04: instalación, login y squid.conf
Squid, un forward proxy de código abierto, reenvía peticiones desde su propia IP. Instálalo en Ubuntu 24.04, protégelo con ACL y contraseña y ajusta la caché.
Autor:Acar Diveroli
Publicado
This Site Can't Be Reached: qué significa y por qué aparece
This Site Can't Be Reached («No se puede acceder a este sitio») indica que Chrome no pudo conectar. Te explicamos cada código y si el fallo es tuyo o de la web.
Autor:Enver Kaya
Publicado
Web scraping y web crawling: ¿en qué se diferencian?
El web crawling descubre qué páginas existen siguiendo enlaces; el web scraping extrae de ellas campos como precio o título. Los comparamos con código Scrapy.
Autor:Acar Diveroli
Publicado
Cómo detectar cambios en una página web y recibir alertas
Para detectar cambios en una web, una herramienta carga la página a intervalos, la compara con la última copia y te avisa. Evita falsas alertas y usa proxies.
Autor:Enver Kaya
Publicado
Cloudflare y scraping: por qué te bloquean y qué funciona
Cloudflare bloquea un scraper cuando puntúa sus solicitudes como bot. Aprende a leer el bloqueo y elige una vía legítima que aun así te dé los datos.
Autor:Acar Diveroli
Publicado
Context engineering vs. prompt engineering: diferencias
La ingeniería de prompts da forma a la instrucción; la de contexto decide todo lo demás que ve el modelo. Vemos en qué difieren y cuándo importa cada una.
Autor:Acar Diveroli
Publicado
¿Qué es el agentic web scraping y cómo funciona?
En el agentic web scraping el agente recorre la página, decide el siguiente paso y extrae los datos según un esquema. Explicamos bucle, costo y límites.
Autor:Acar Diveroli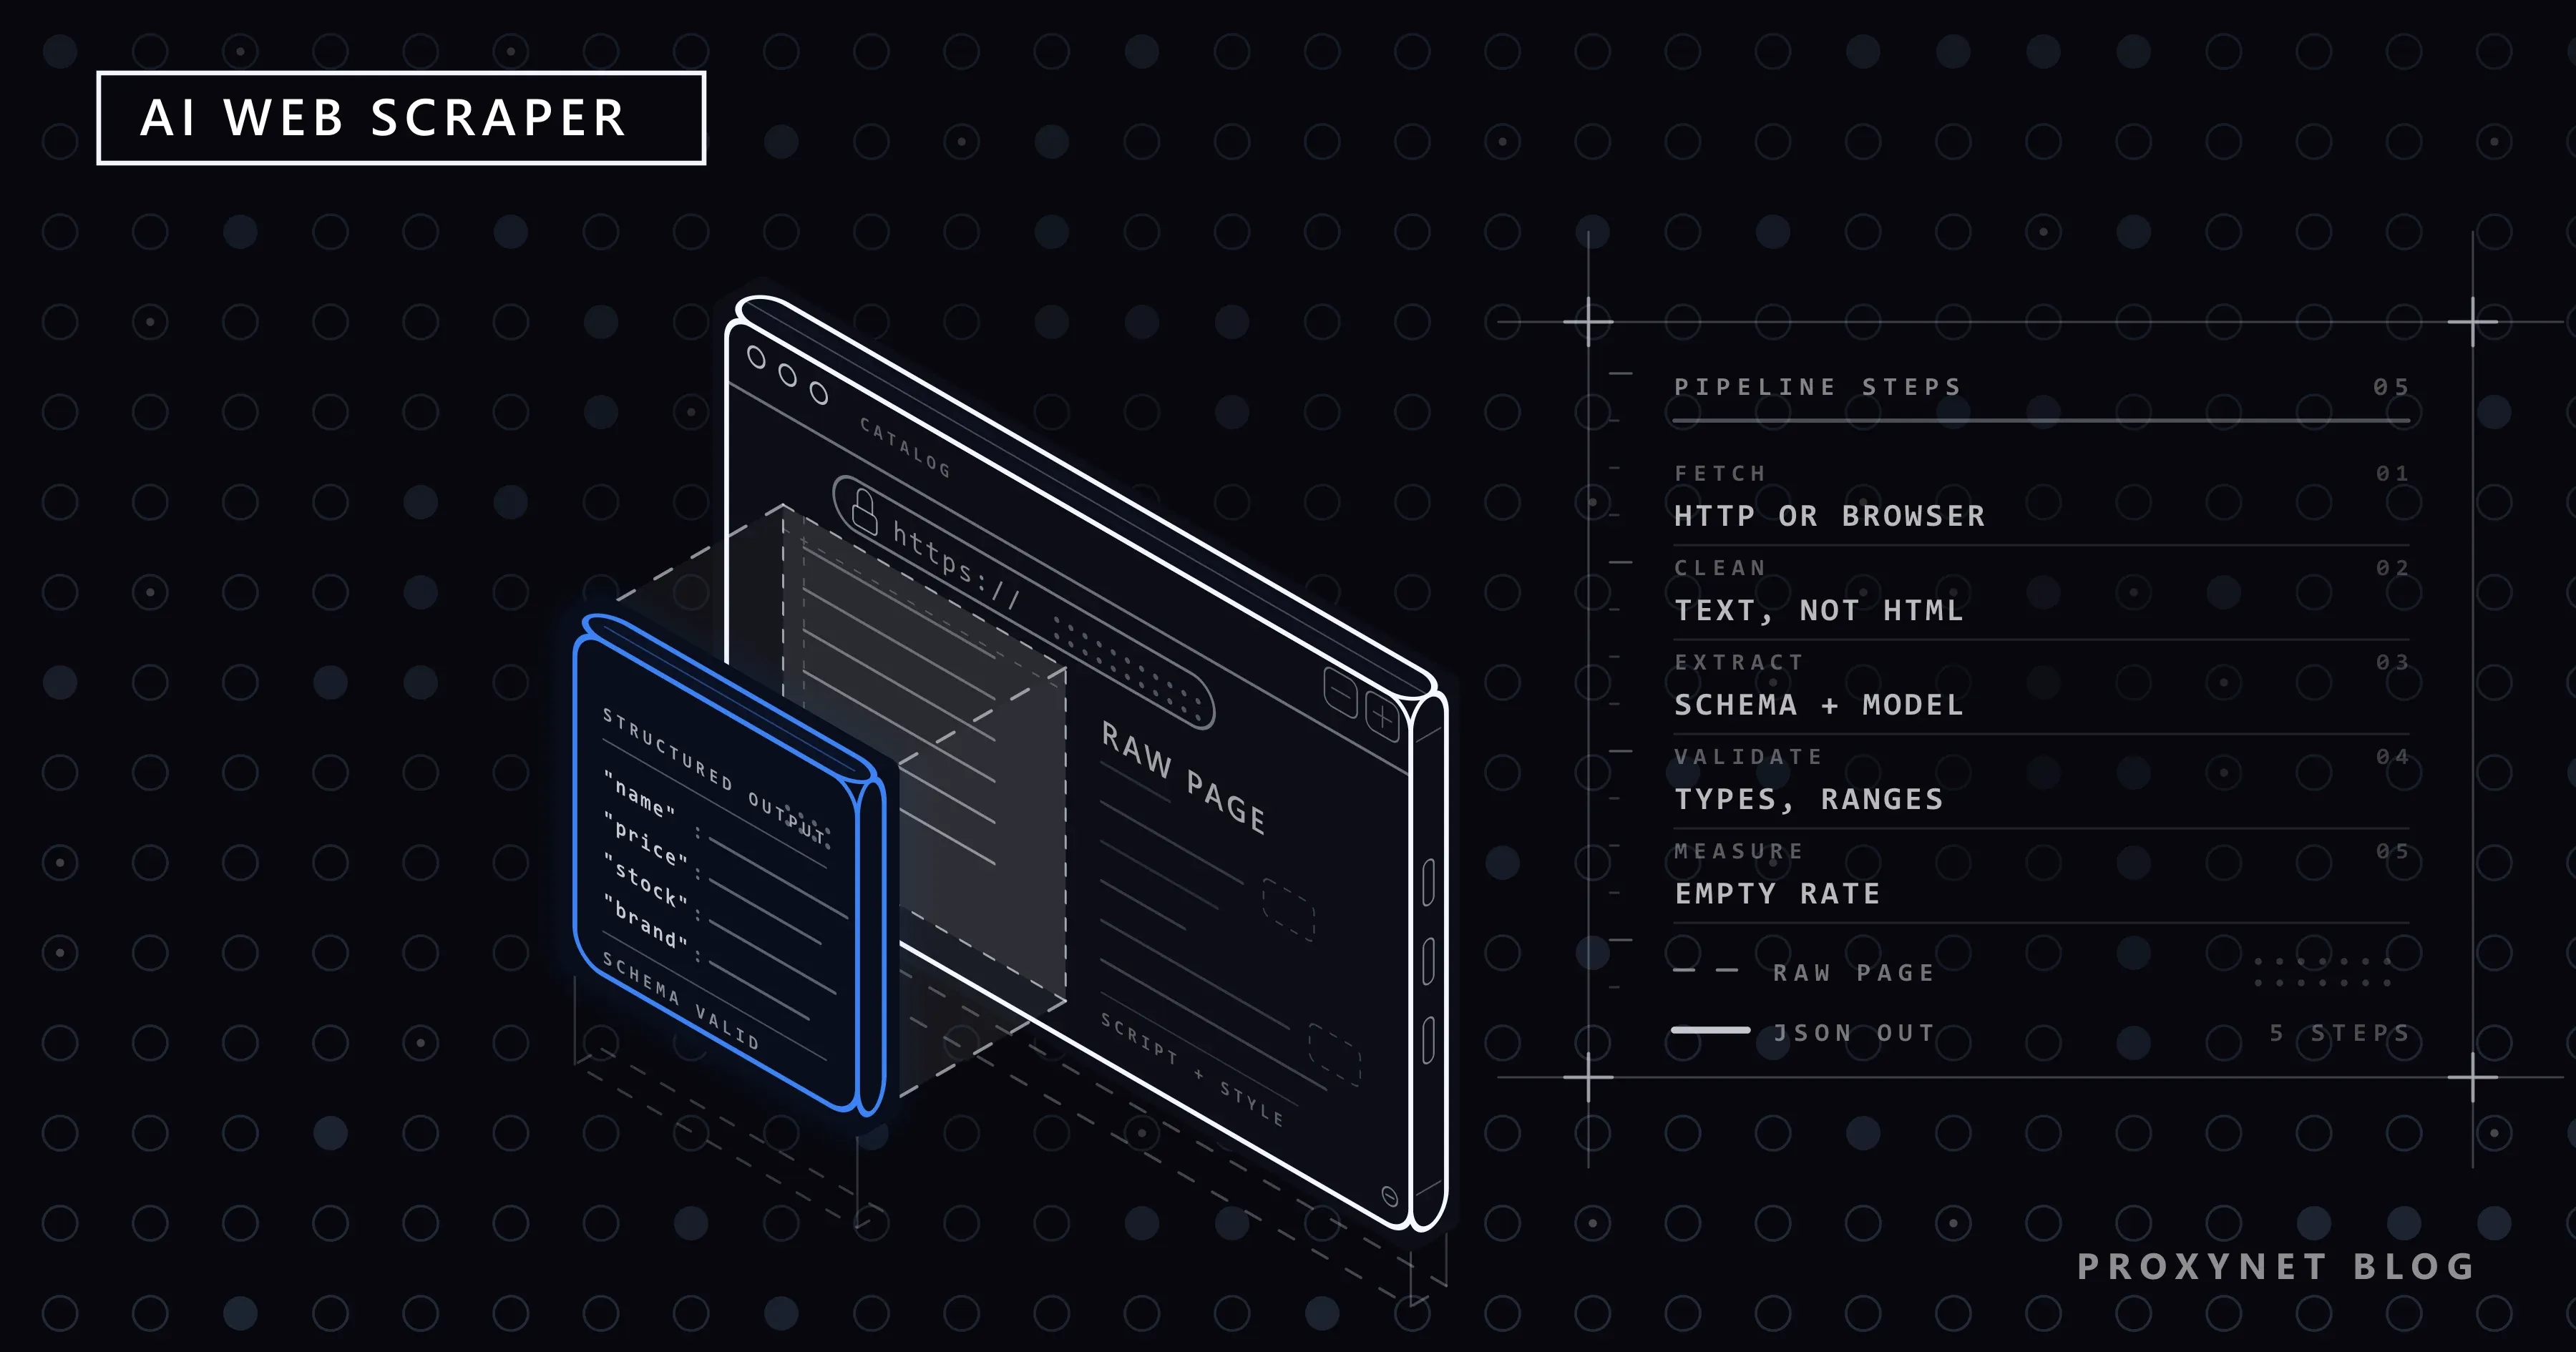
Publicado
¿Qué es un AI web scraper y cómo funciona?
Un AI web scraper deja la extracción de campos en manos de la IA en lugar de selectores fijos. Explicamos los pasos, los tipos de herramientas y los límites.
Autor:Acar Diveroli
Publicado
Cómo configurar un proxy en un teléfono Android
En Android, el proxy se define en las opciones avanzadas de cada red Wi-Fi. Te mostramos las rutas de menú en Samsung y Xiaomi y los campos de host y puerto.
Autor:Enver Kaya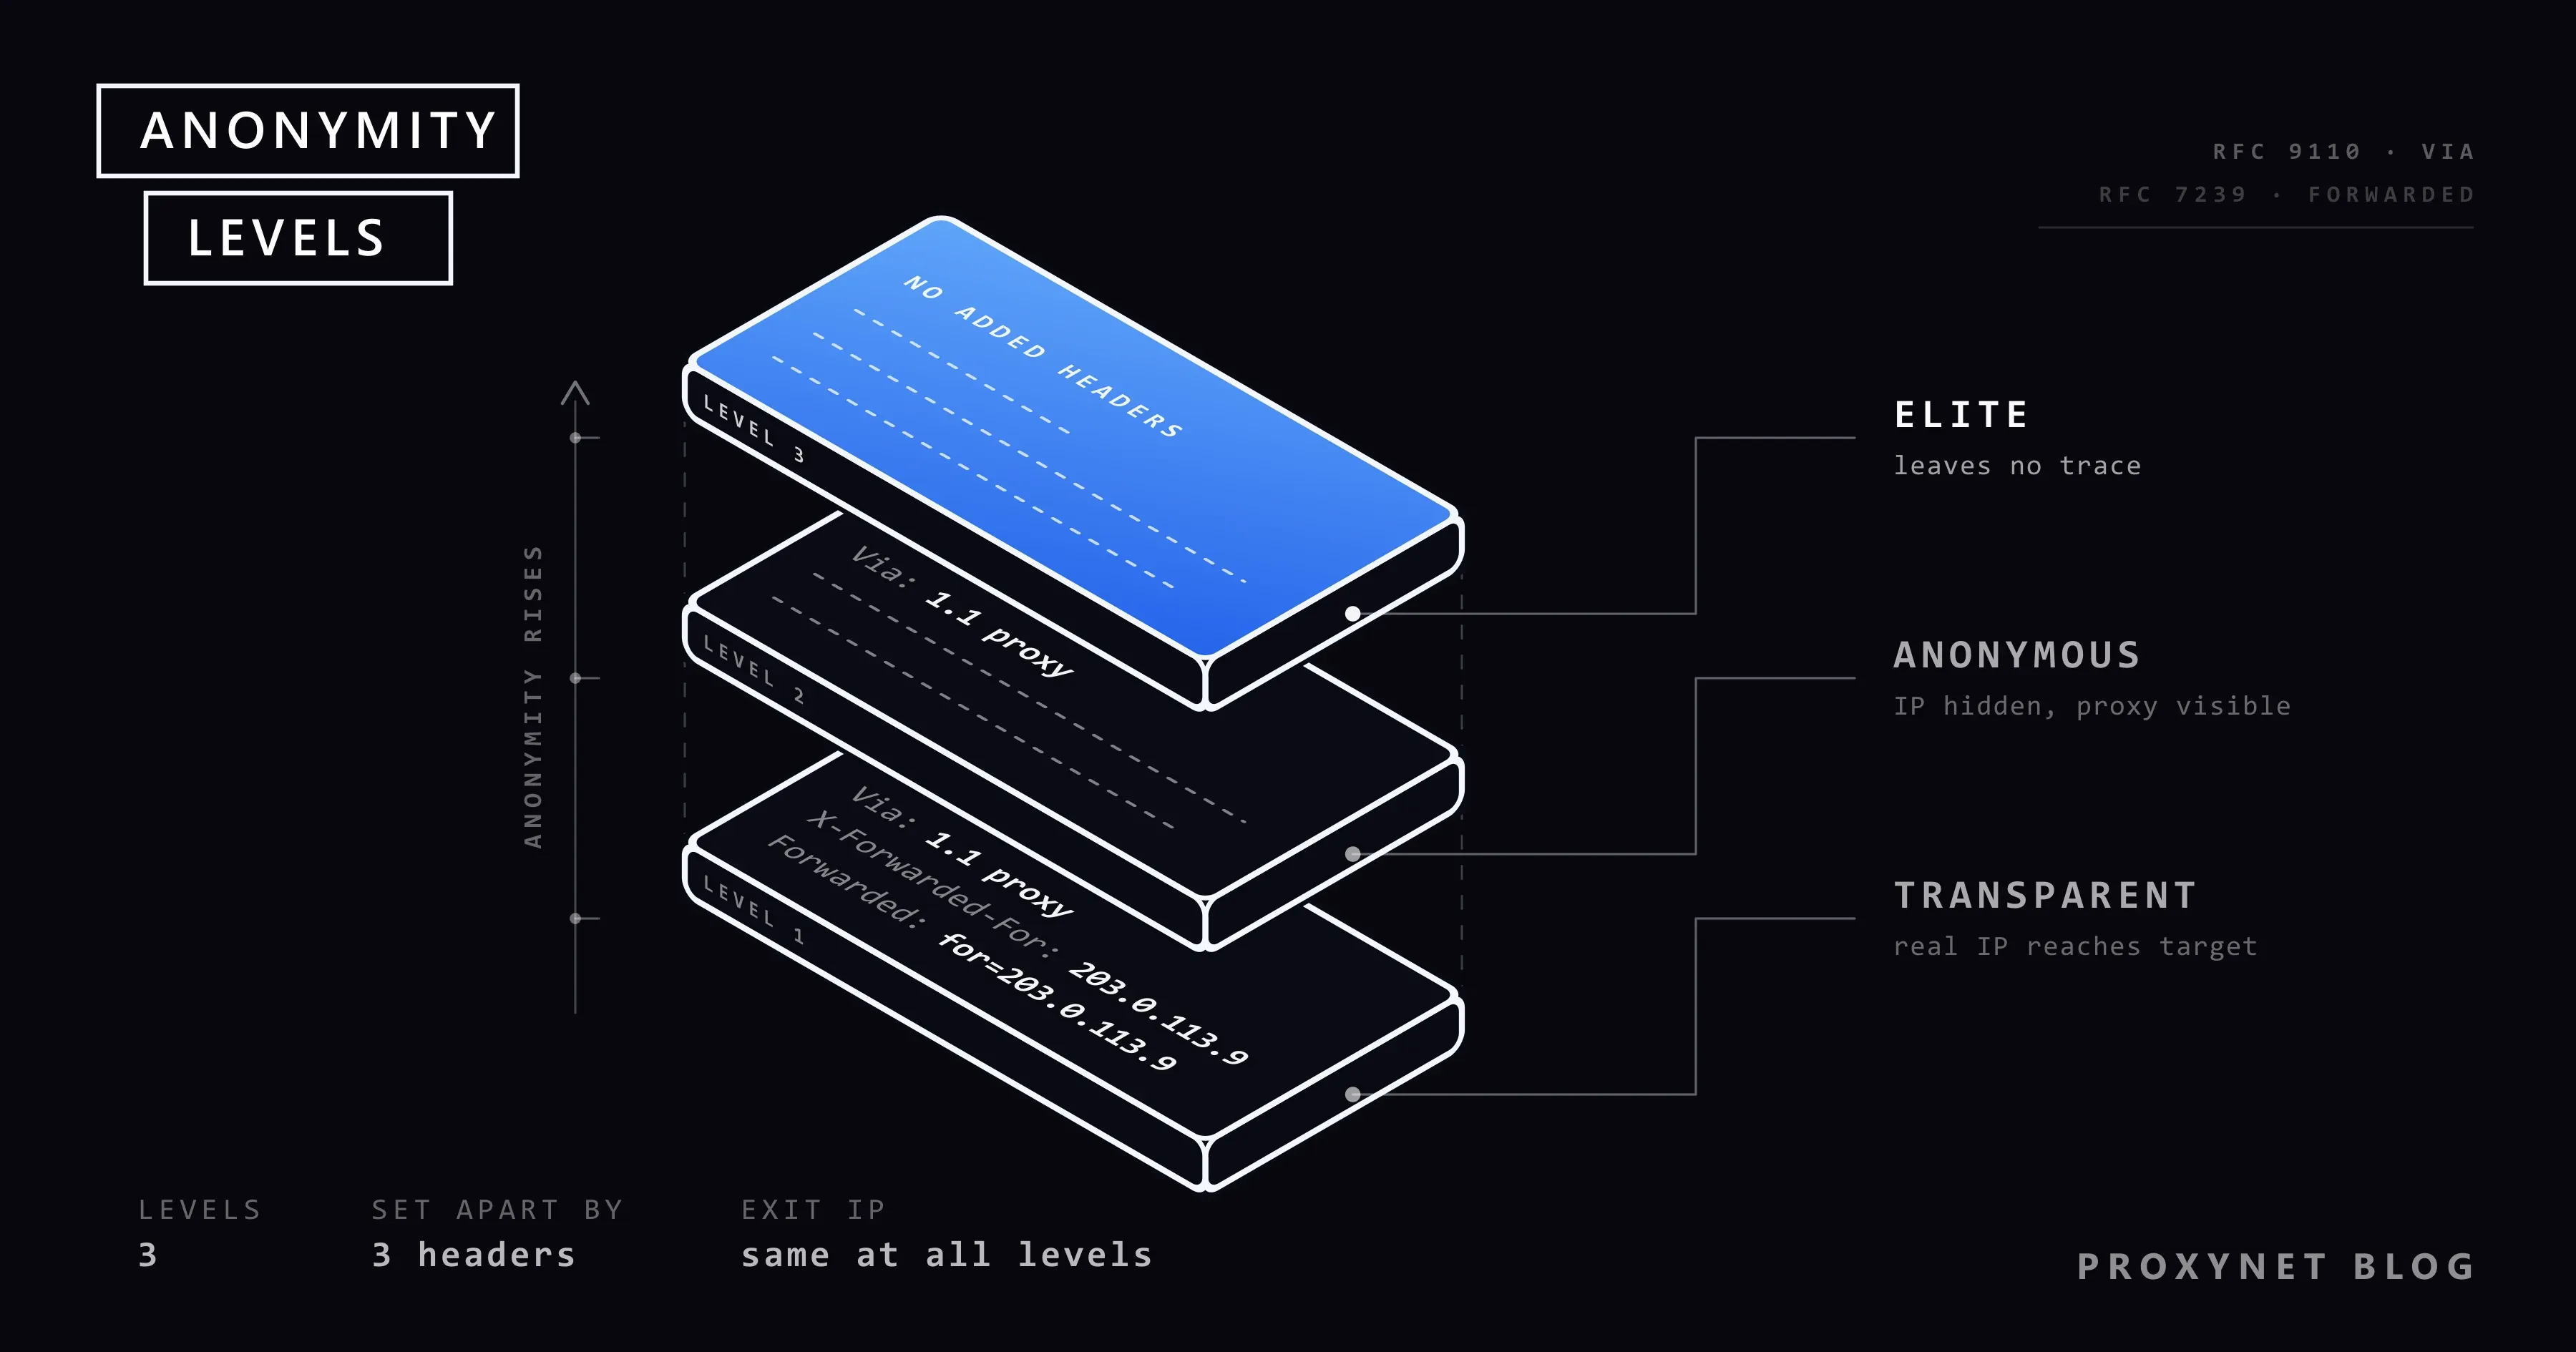
Publicado
Proxy transparente, anónimo y élite: ¿qué los diferencia?
Un proxy transparente envía tu IP real al sitio, uno anónimo la oculta pero se delata y uno élite no deja rastro. Tres cabeceras HTTP marcan la diferencia.
Autor:Acar Diveroli
¿Qué es el puerto 8080? Puertos de proxy y qué significan
Autor: Enver KayaProxy 101Publicado
Codificación en Python: tildes, ñ y UnicodeDecodeError
Autor: Acar DiveroliWeb scrapingPublicado
Proxy Squid en Ubuntu 24.04: instalación, login y squid.conf
Autor: Acar DiveroliTutorialesPublicado
This Site Can't Be Reached: qué significa y por qué aparece
Autor: Enver KayaTutorialesPublicado
Web scraping y web crawling: ¿en qué se diferencian?
Autor: Acar DiveroliComparativasPublicado
Cómo detectar cambios en una página web y recibir alertas
Autor: Enver KayaCasos de usoPublicado
Cloudflare y scraping: por qué te bloquean y qué funciona
Autor: Acar DiveroliWeb scrapingPublicado
Context engineering vs. prompt engineering: diferencias
Autor: Acar DiveroliIAPublicado
¿Qué es el agentic web scraping y cómo funciona?
Autor: Acar DiveroliIAPublicado
¿Qué es un AI web scraper y cómo funciona?
Autor: Acar DiveroliWeb scrapingPublicado
Cómo configurar un proxy en un teléfono Android
Autor: Enver KayaTutorialesPublicado
Proxy transparente, anónimo y élite: ¿qué los diferencia?
Autor: Acar DiveroliProxy 101Publicado
Ningún artículo coincide
Publicado
Publicado