

































Blog de Proxynet – Página 3

Publicado
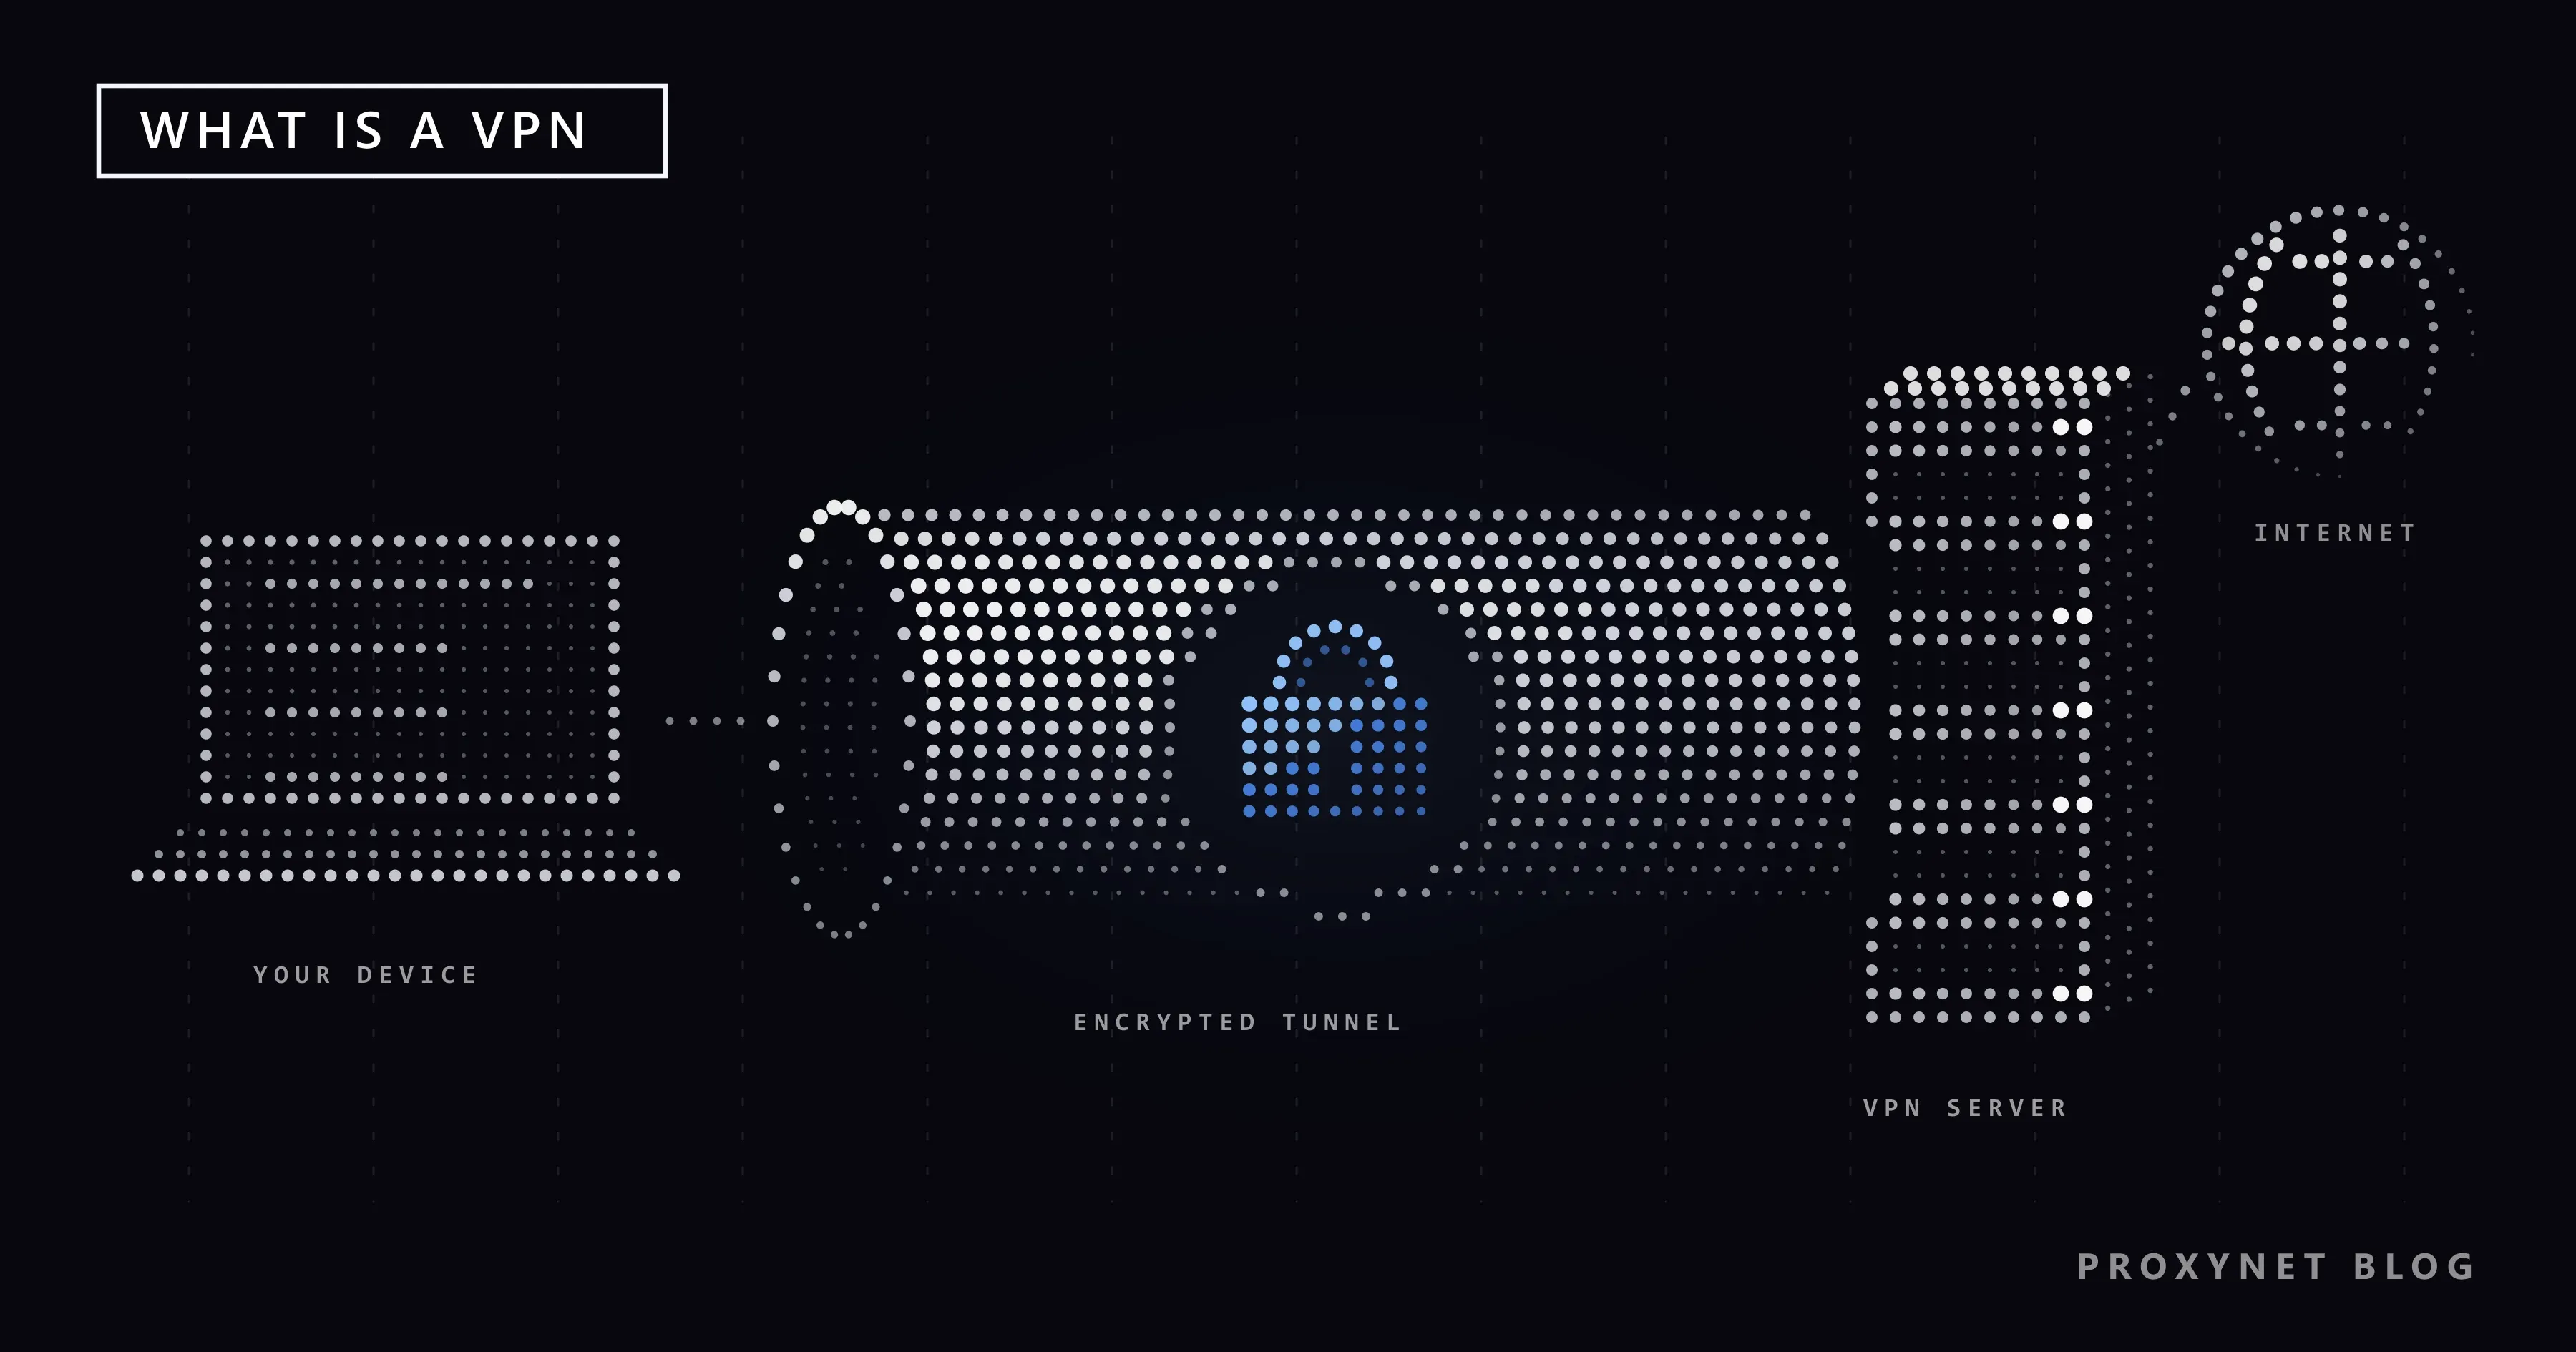
¿Qué es una VPN y cómo funciona?
Una VPN lleva el tráfico de tu dispositivo por un túnel cifrado hasta un servidor, y las webs ven la IP de este. Cómo funciona, qué oculta y qué protocolo usar.
Autor: Acar Diveroli
Publicado
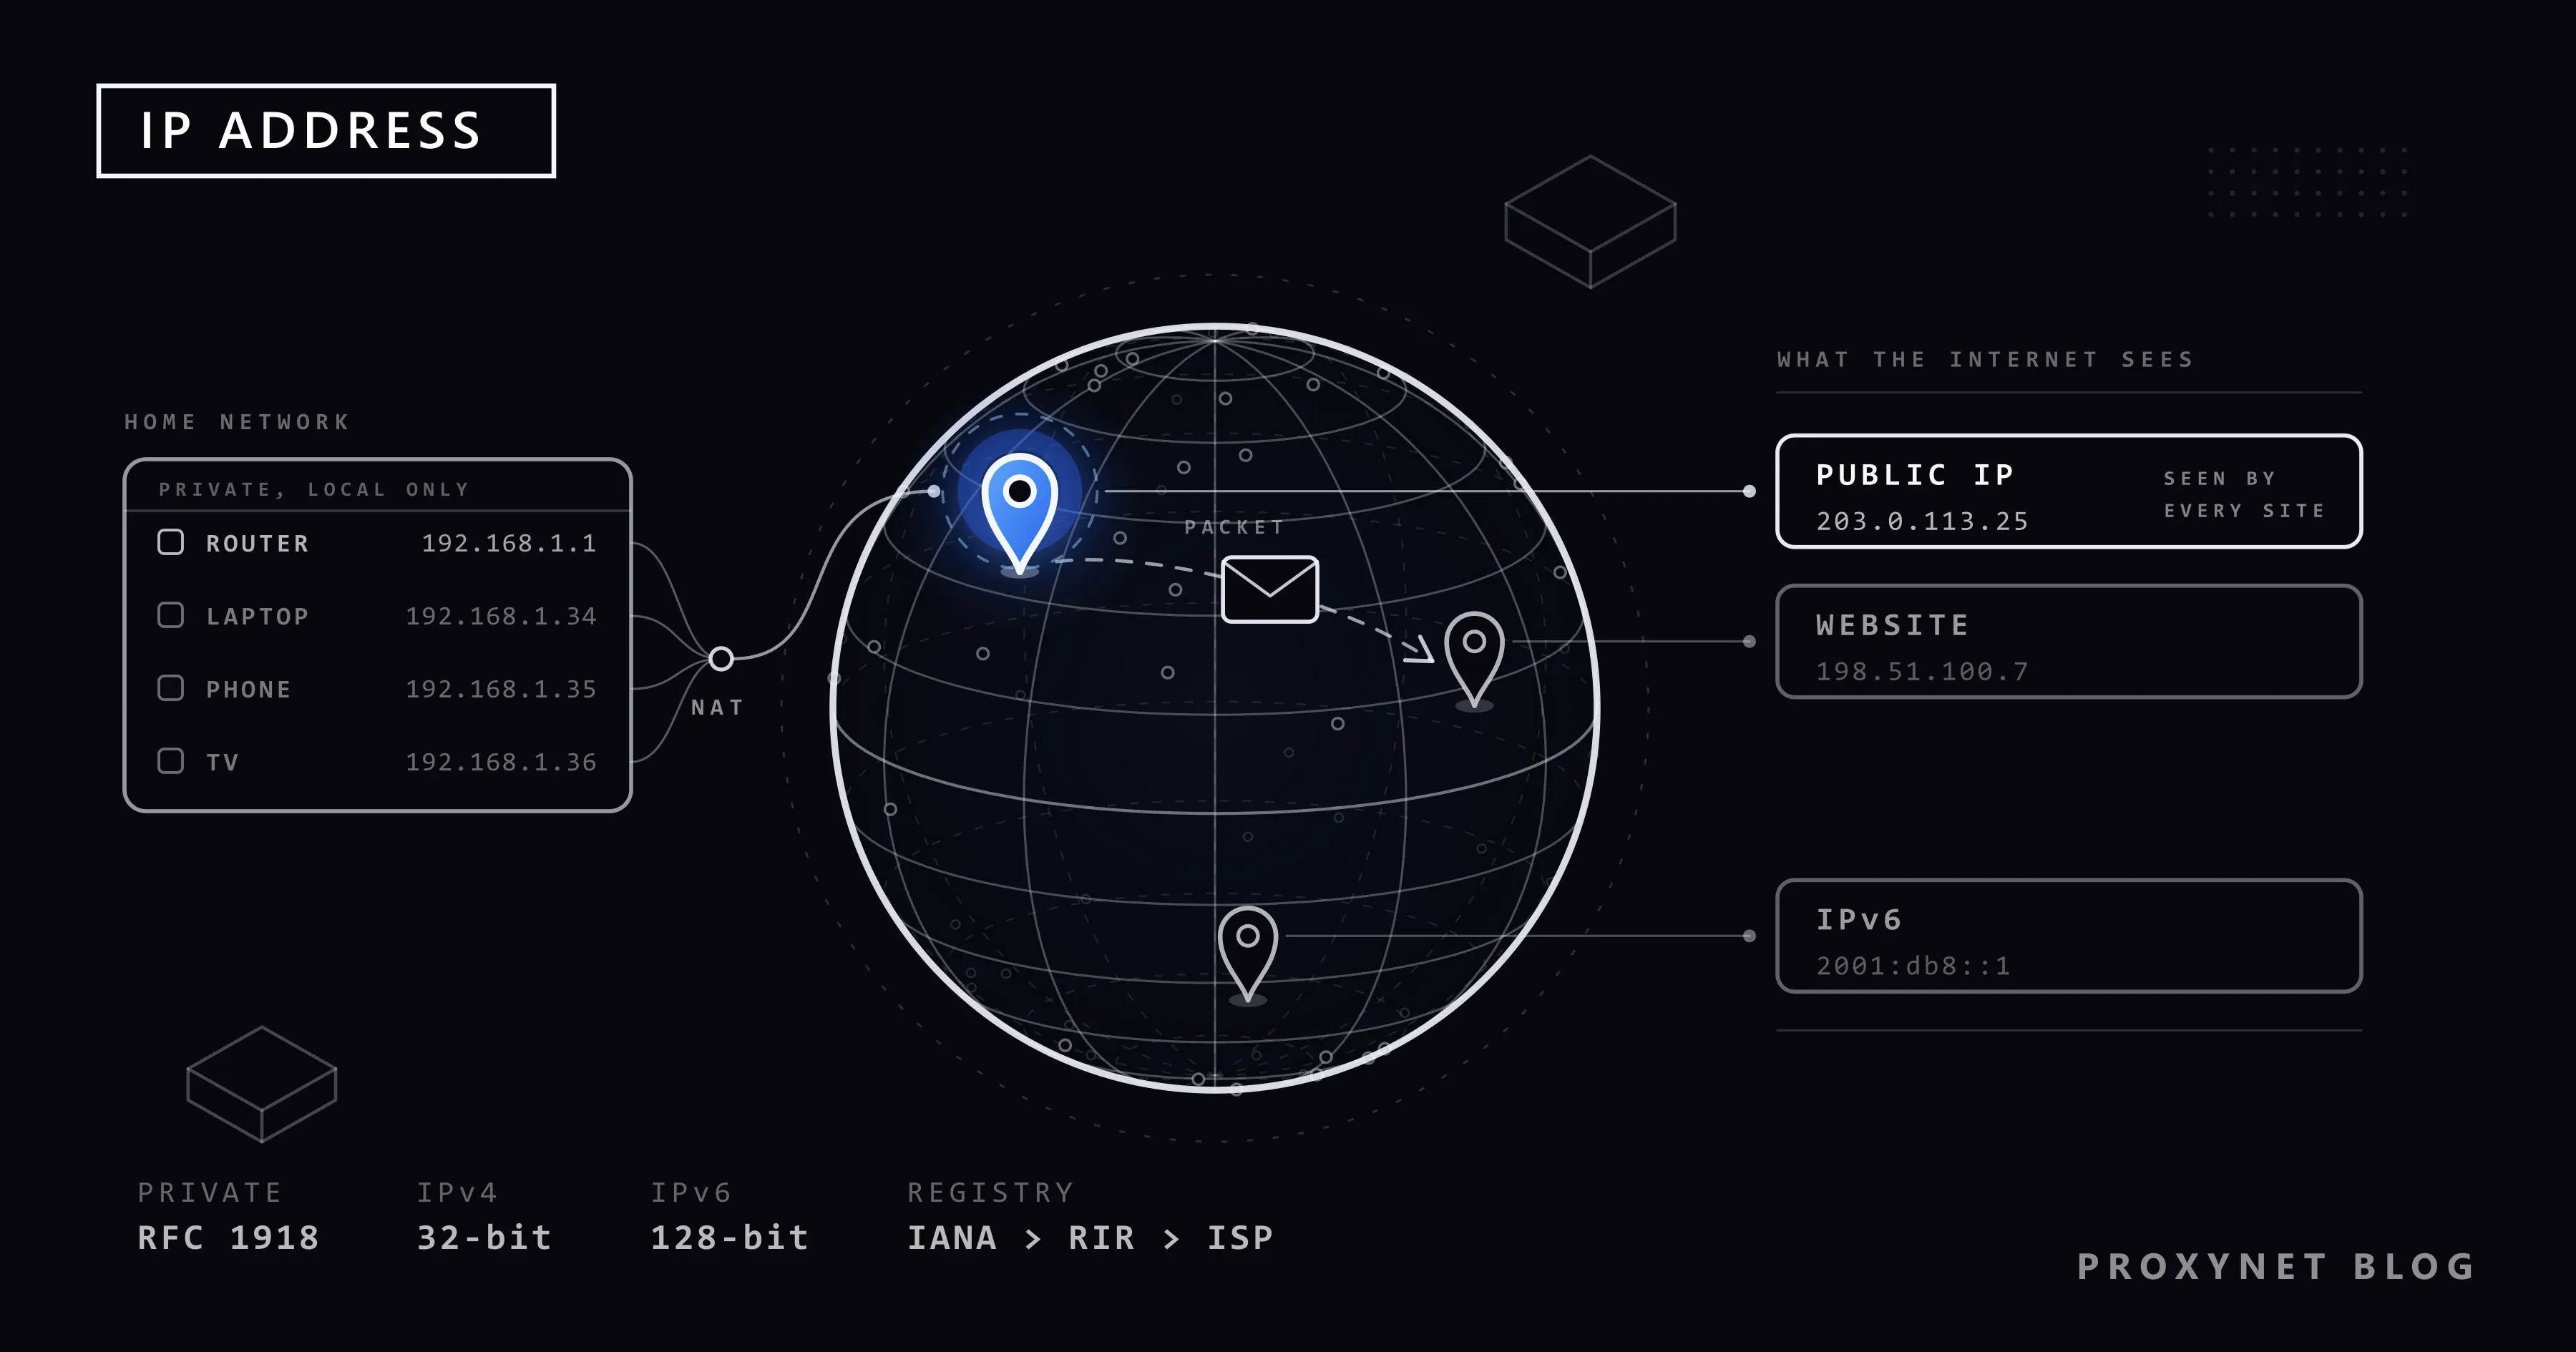
¿Qué es una dirección IP? IP pública, privada, IPv4 e IPv6
Una dirección IP es el número que permite a los datos encontrar tu dispositivo en la red. Para qué sirve, IP pública y privada, IPv4 e IPv6 y cómo ver la tuya.
Autor:Acar Diveroli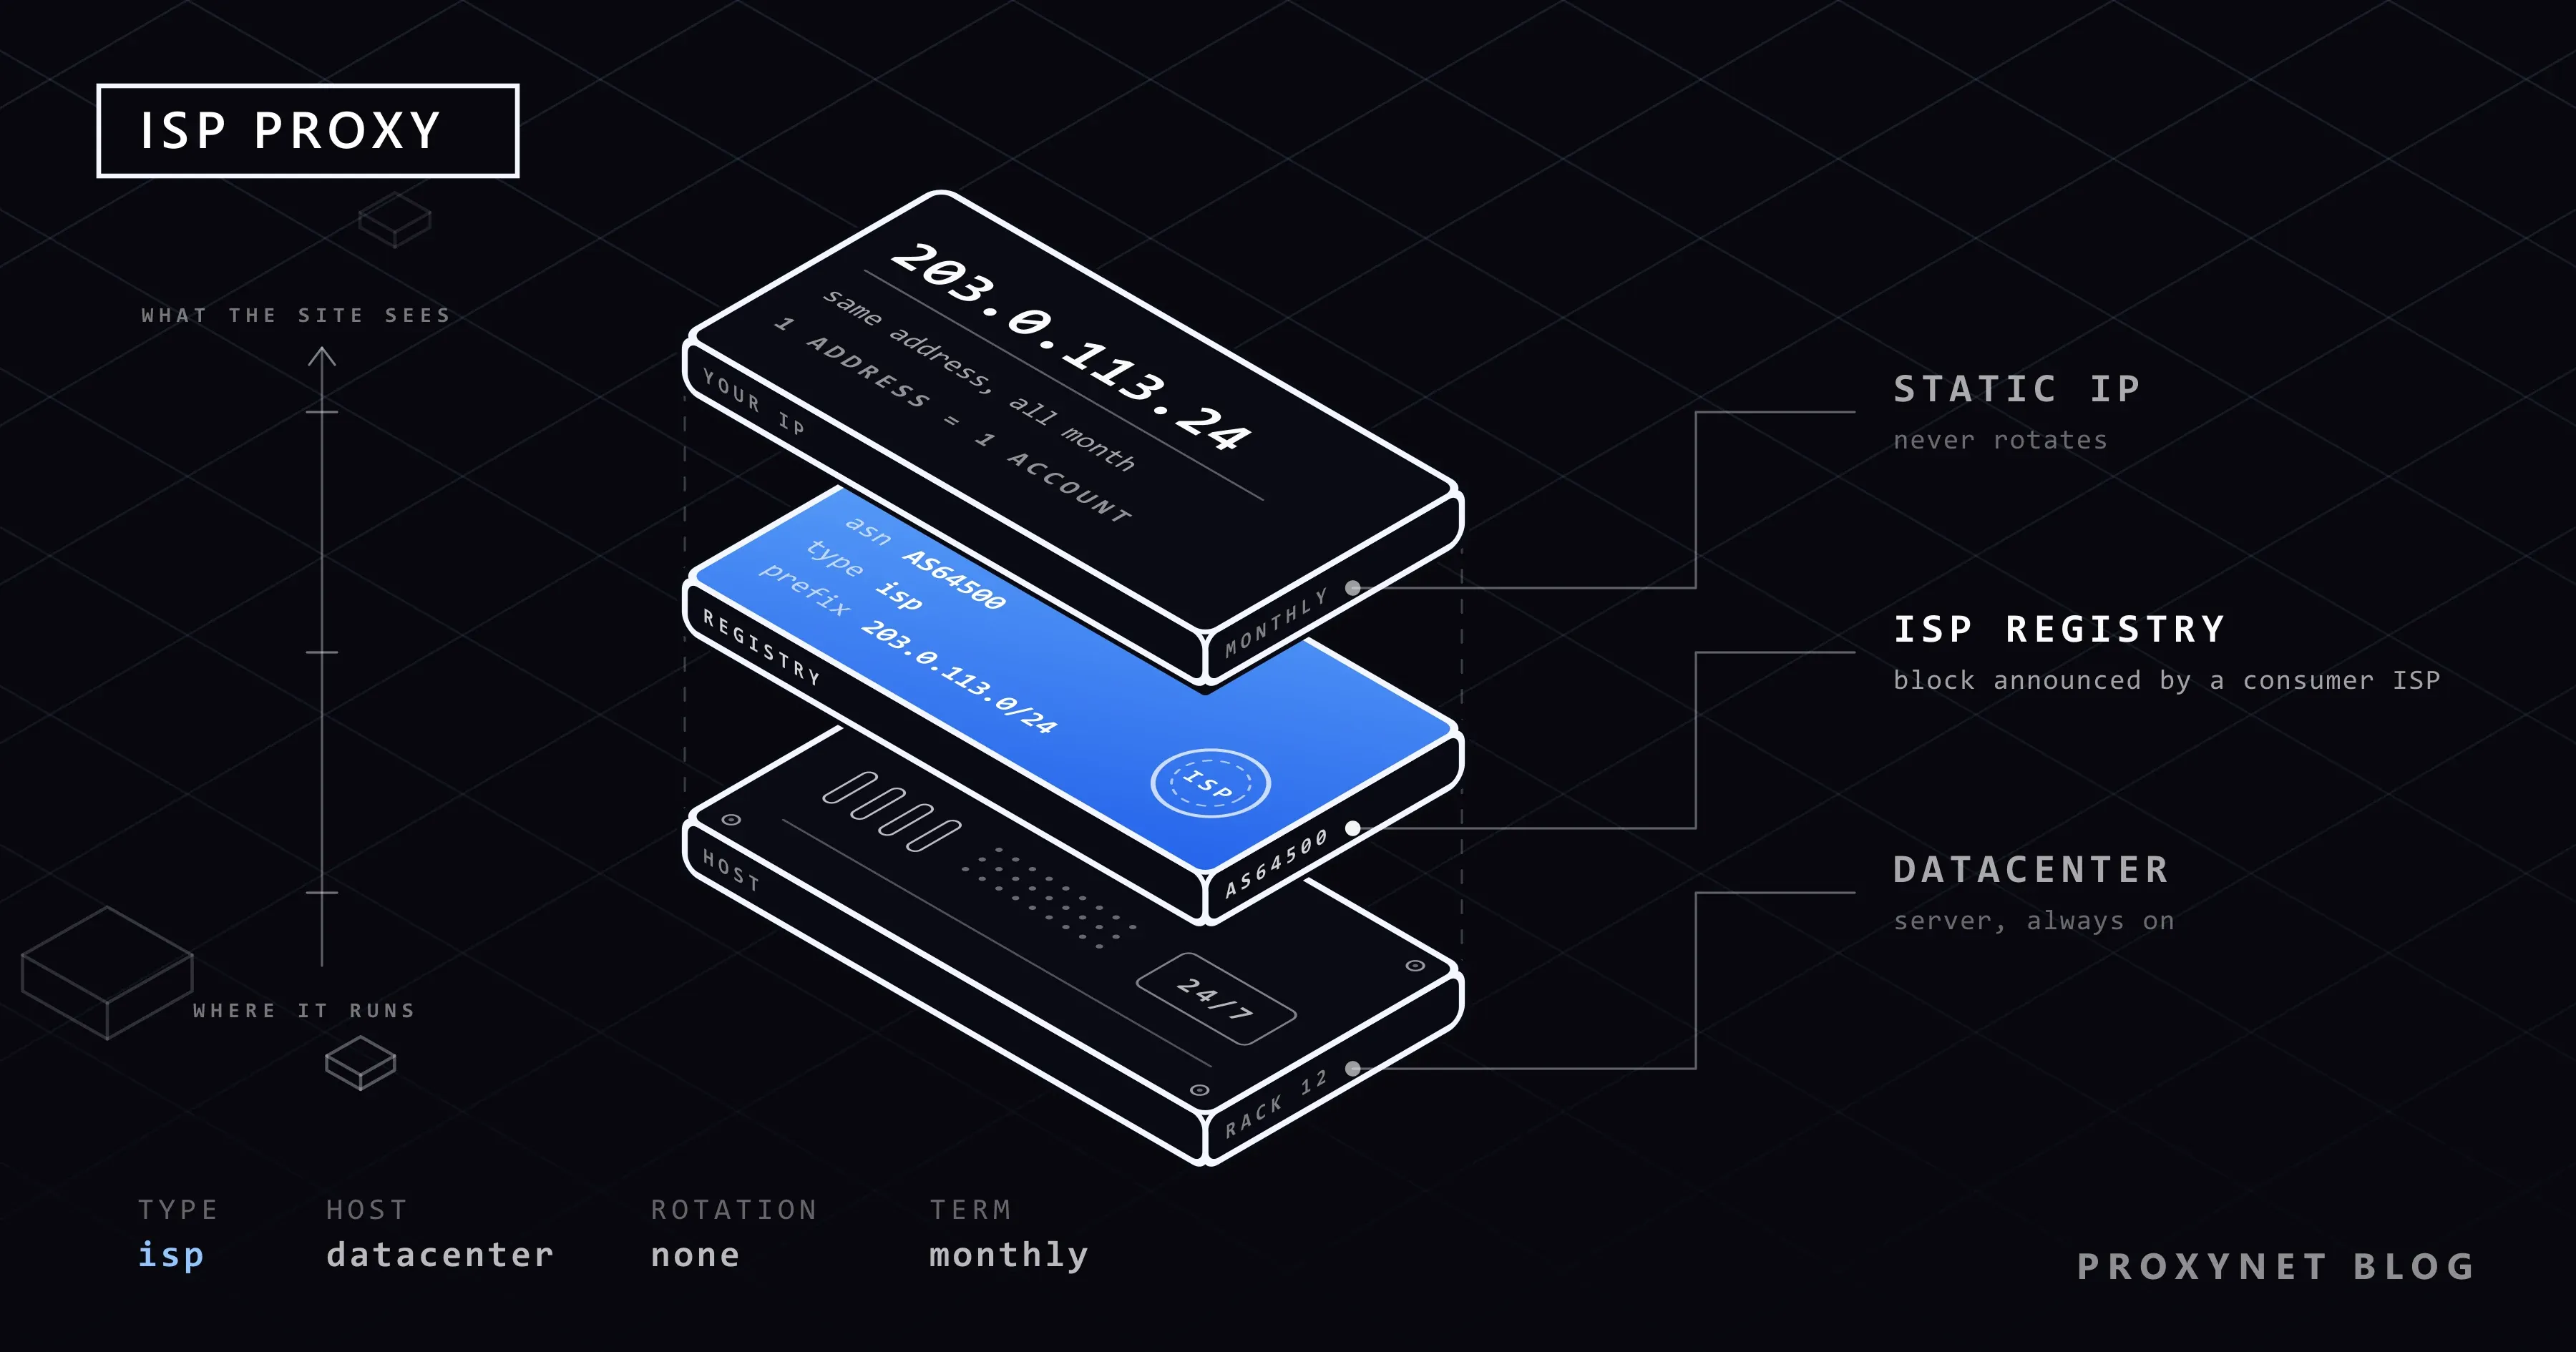
Publicado
Qué es un proxy ISP y cuándo lo necesitas
Un proxy ISP es una IP estática registrada a nombre de un ISP pero alojada en un centro de datos. Cómo funciona, en qué se diferencia y cuándo comprarlo.
Autor:Acar Diveroli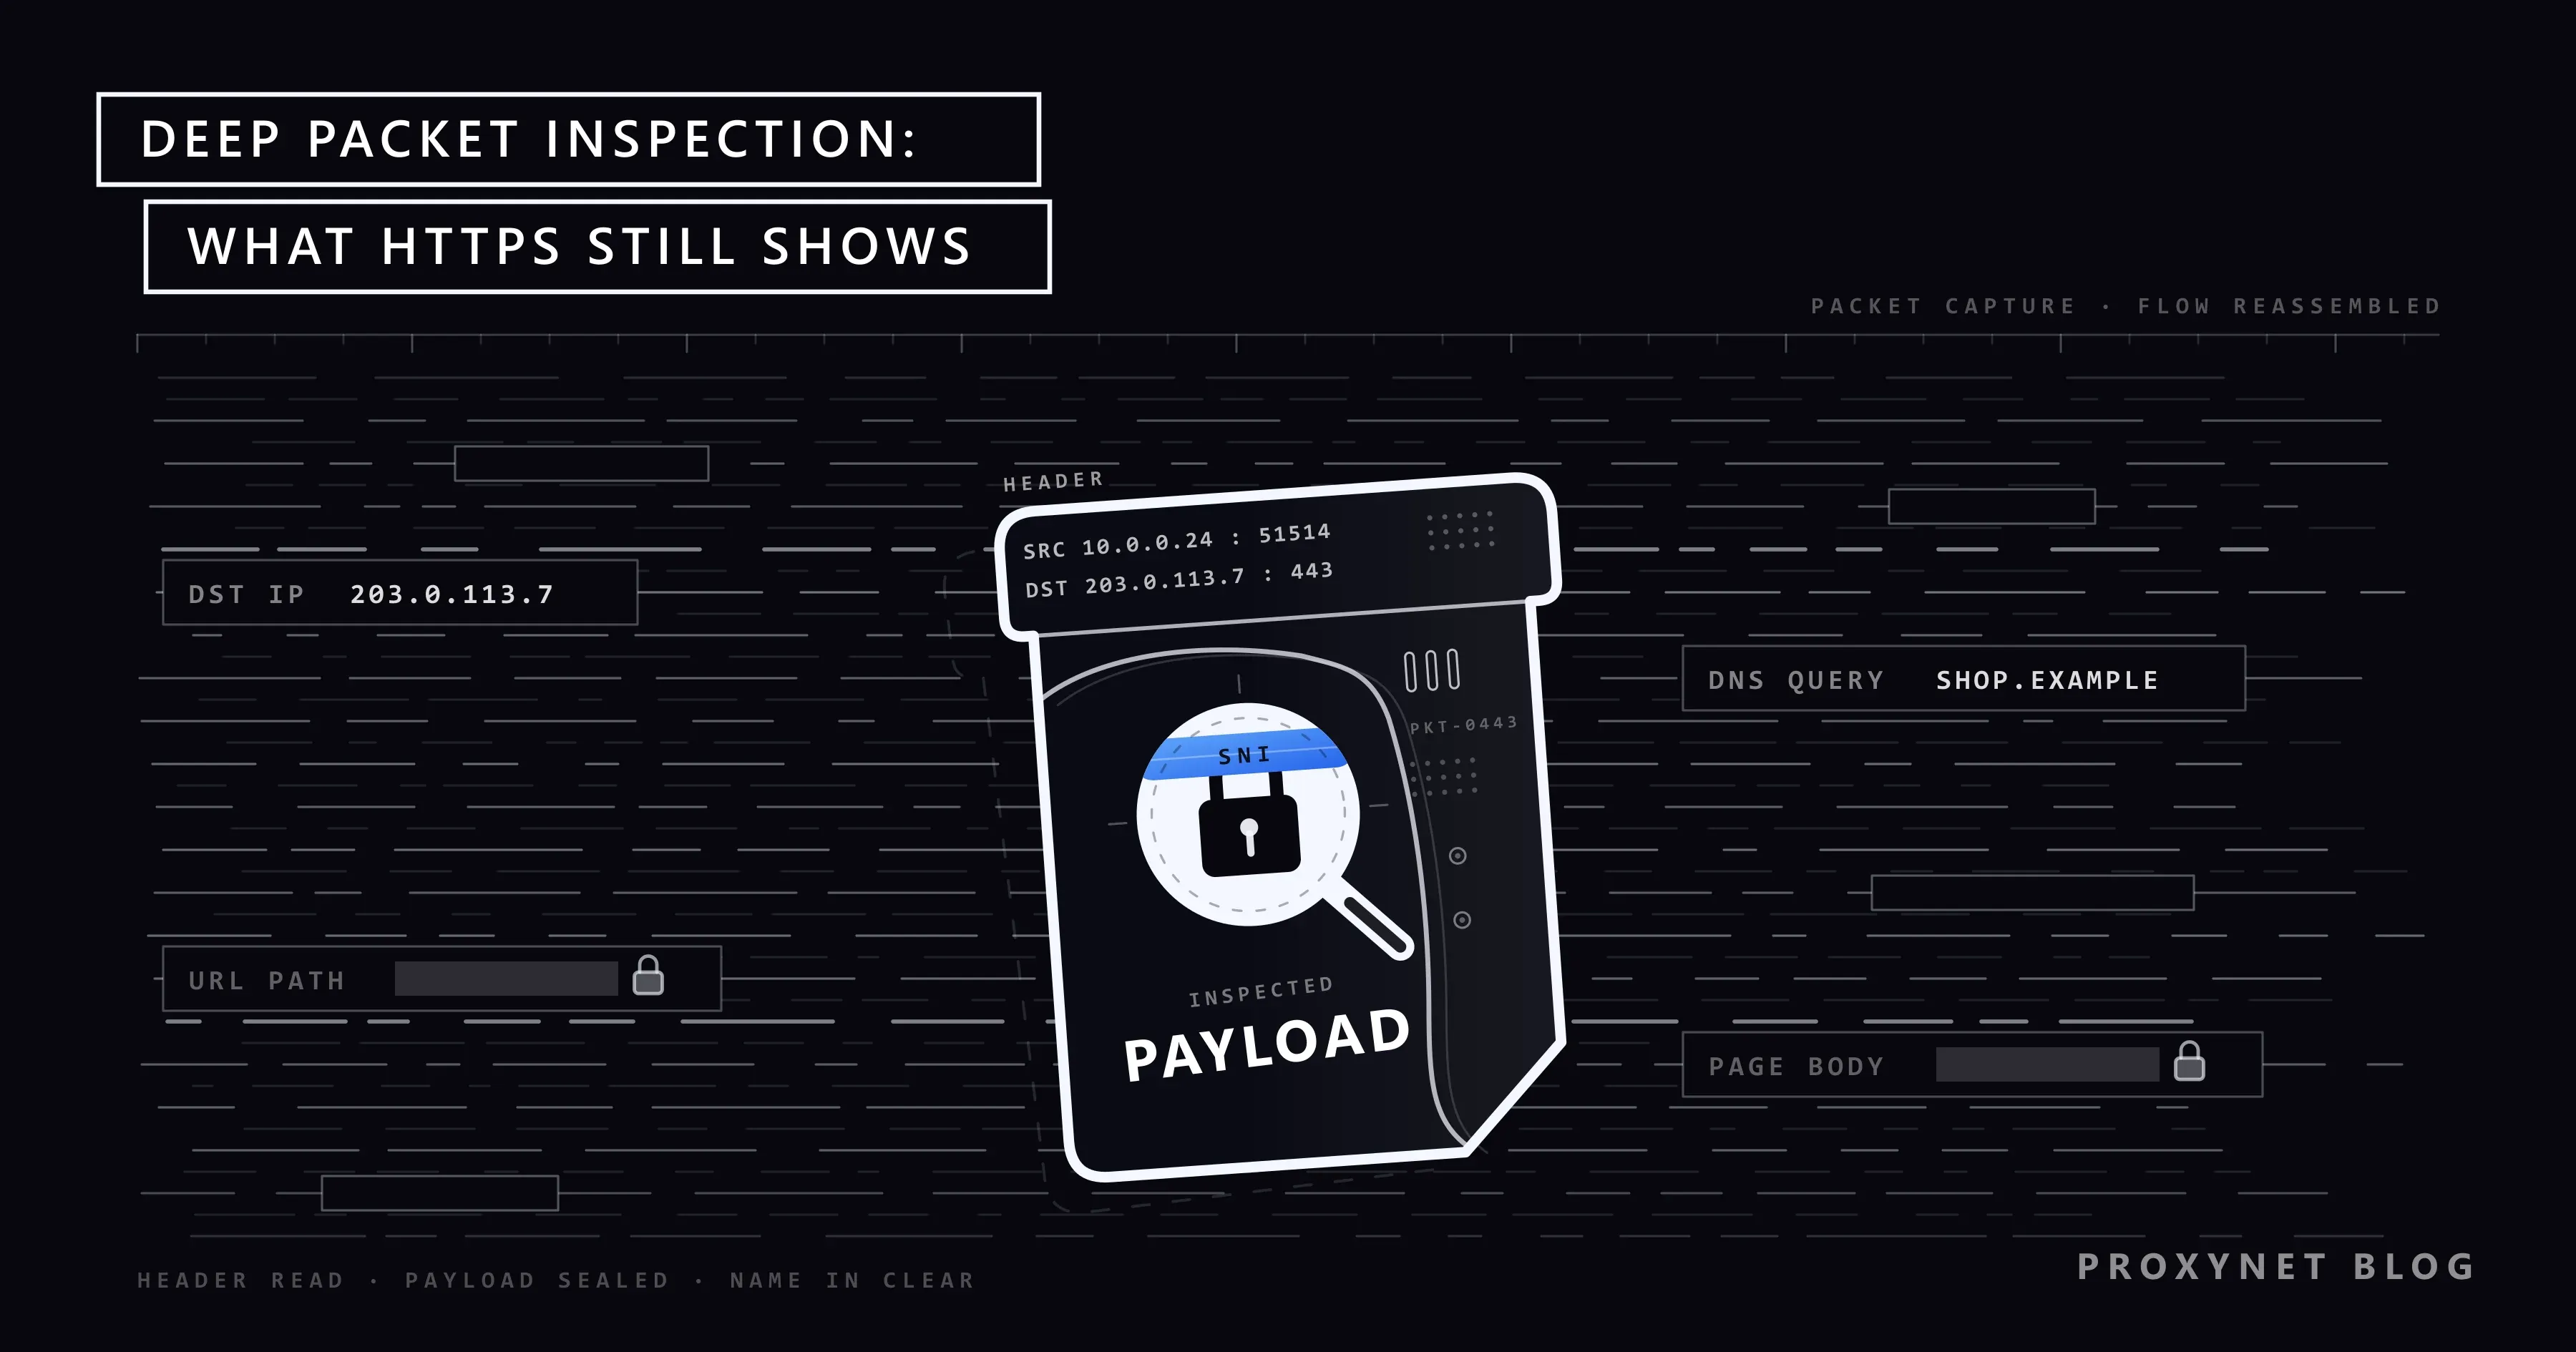
Publicado
¿Qué es la inspección profunda de paquetes (DPI)?
La inspección profunda de paquetes (DPI) lee también los datos que lleva cada paquete para identificar apps y amenazas. Cómo funciona y qué ve en HTTPS.
Autor:Acar Diveroli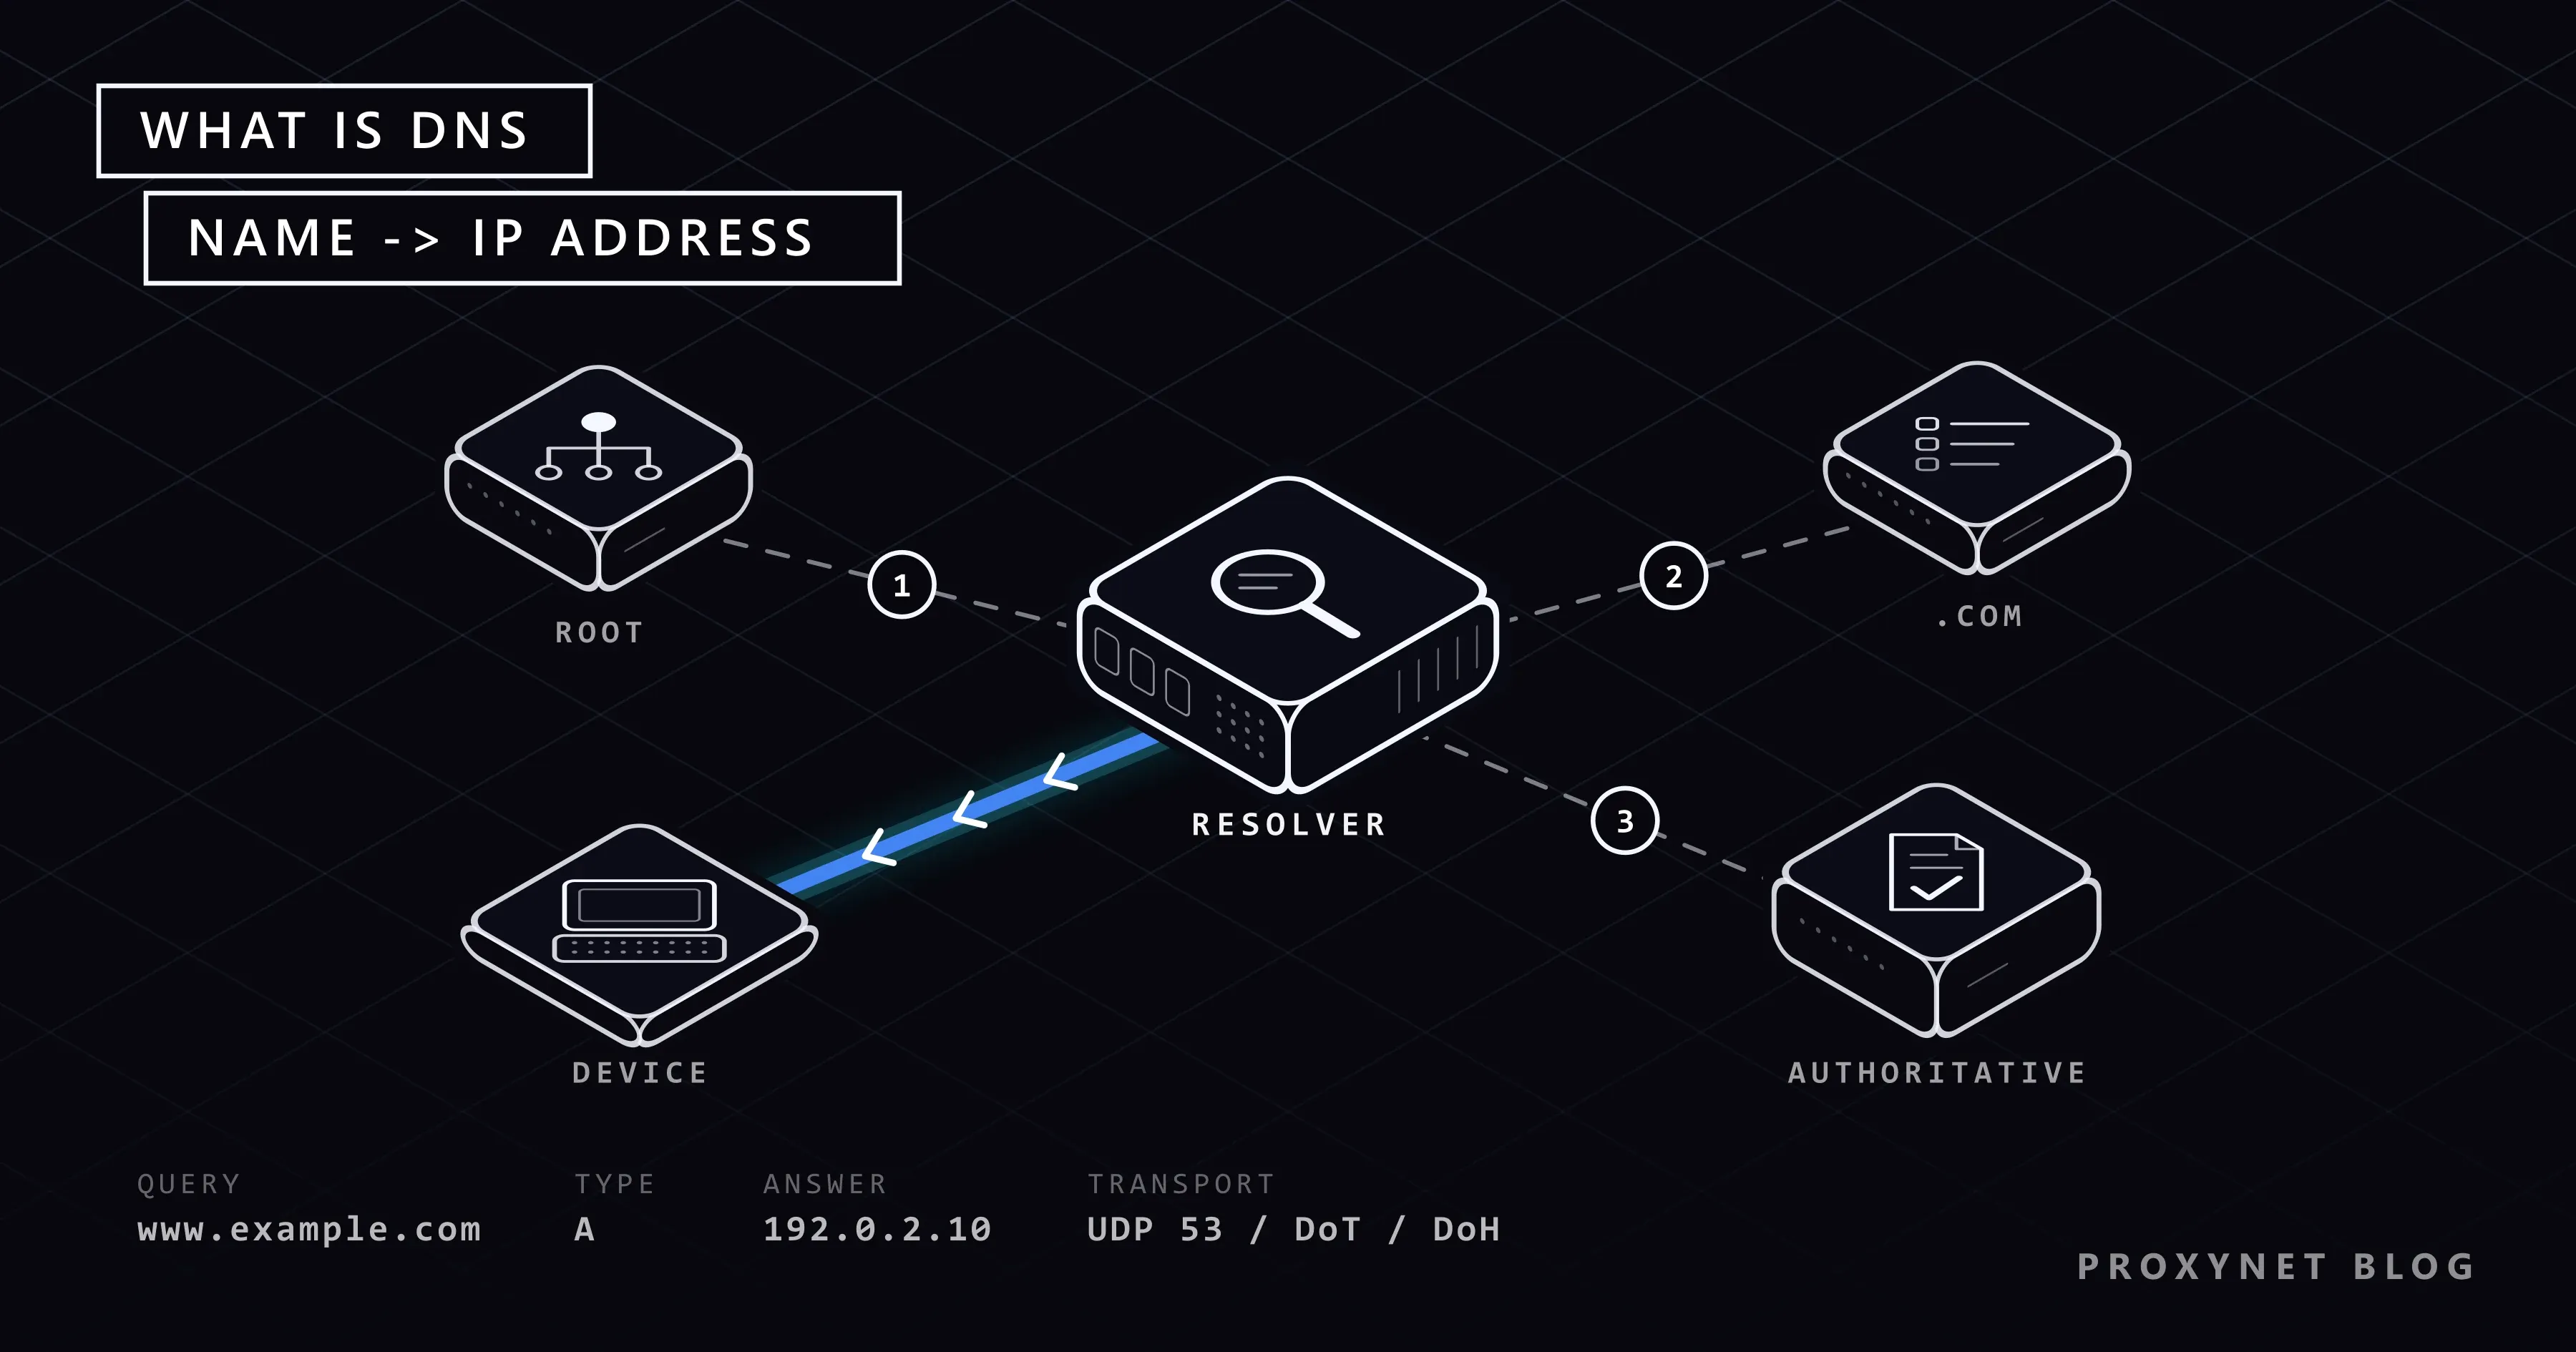
Publicado
¿Qué es el DNS y cómo cambiar tu servidor DNS?
El DNS traduce nombres de sitios a direcciones IP. Cómo funciona una consulta, qué servidor DNS elegir y cómo cambiarlo en Windows, Mac, Android y iPhone.
Autor:Acar Diveroli
Publicado
¿Qué es el web scraping y cómo funciona?
El web scraping es la recogida automática de datos de páginas web: un programa descarga el HTML, extrae campos y los guarda. Cómo funciona y para qué sirve.
Autor:Acar Diveroli
Publicado
Proxy de WhatsApp: cómo activarlo y desactivarlo
El proxy de WhatsApp está en Ajustes > Almacenamiento y datos > Proxy. Cómo activarlo y desactivarlo, y por qué un proxy HTTP o SOCKS5 no funciona ahí.
Autor:Acar Diveroli
Publicado
Web scraping con Cheerio en Node.js: tutorial paso a paso
Cheerio analiza HTML en Node.js con selectores al estilo jQuery. Crea un scraper probado con fetch, paginación, límite de concurrencia, reintentos y proxy.
Autor:Acar Diveroli
Publicado
Cómo limpiar datos de scraping con pandas en Python
Limpia datos de scraping con pandas: primero el texto, luego tipos, duplicados, valores faltantes y atípicos, y valida antes de guardar. Con script probado.
Autor:Acar Diveroli
Publicado
Cómo extraer datos de un PDF: tablas, texto y OCR
Comprueba primero si el PDF tiene capa de texto. Si la tiene, Excel o pdfplumber leen las tablas; las páginas escaneadas necesitan OCR. Con código probado.
Autor:Acar Diveroli
Publicado
Cómo tratar datos personales (PII) en datos de scraping
Los datos de scraping suelen traer datos personales: nombres, perfiles, emails y teléfonos. Cómo detectarlos, reducirlos, enmascararlos y protegerlos.
Autor:Acar Diveroli
Publicado
Cómo guardar datos de scraping en CSV, JSON y SQLite
Guarda los datos extraídos en CSV para hojas de cálculo, JSON Lines para registros que crecen y SQLite para ejecuciones sin duplicados. Código Python probado.
Autor:Acar Diveroli
¿Qué es una VPN y cómo funciona?
Autor: Acar DiveroliProxy 101Publicado
¿Qué es una dirección IP? IP pública, privada, IPv4 e IPv6
Autor: Acar DiveroliProxy 101Publicado
Qué es un proxy ISP y cuándo lo necesitas
Autor: Acar DiveroliProxy 101Publicado
¿Qué es la inspección profunda de paquetes (DPI)?
Autor: Acar DiveroliProxy 101Publicado
¿Qué es el DNS y cómo cambiar tu servidor DNS?
Autor: Acar DiveroliProxy 101Publicado
¿Qué es el web scraping y cómo funciona?
Autor: Acar DiveroliWeb scrapingPublicado
Proxy de WhatsApp: cómo activarlo y desactivarlo
Autor: Acar DiveroliTutorialesPublicado
Web scraping con Cheerio en Node.js: tutorial paso a paso
Autor: Acar DiveroliTutorialesPublicado
Cómo limpiar datos de scraping con pandas en Python
Autor: Acar DiveroliTutorialesPublicado
Cómo extraer datos de un PDF: tablas, texto y OCR
Autor: Acar DiveroliTutorialesPublicado
Cómo tratar datos personales (PII) en datos de scraping
Autor: Acar DiveroliWeb scrapingPublicado
Cómo guardar datos de scraping en CSV, JSON y SQLite
Autor: Acar DiveroliTutorialesPublicado
Ningún artículo coincide
Publicado
Publicado