Ihr Skript liest jede Nacht 2.000 Produktseiten. Die ersten 300 kommen sauber zurück, dann werden die Antworten zu 429 Too Many Requests, und ein paar Minuten später bekommt jede Anfrage einen 403. Am Code hat sich nichts geändert; die Seite hat die Anfragen von Ihrer Adresse gezählt und entschieden, dass sich kein Besucher so verhält. Ein rotierender Proxy ist die übliche Antwort darauf, aber schlecht eingebunden schafft er neue Probleme: Die IP wechselt nicht, wenn Sie es erwarten, ein Login bricht auf halbem Weg ab, oder zwanzig Worker machen aus einem rücksichtsvollen Scraper eine Flut.
Dieses Tutorial baut den Aufbau in Python von Anfang bis Ende: warum eine einzelne IP ins Ratenlimit läuft, wie ein rotierendes Gateway Ausgänge zuweist, das proxies-Dictionary in requests, die Wiederverwendung von Sessions und warum sie die Rotation still abschaltet, Wiederholungen, die Retry-After respektieren, ein Thread-Pool und eine Variante mit httpx und asyncio, die Wahl zwischen pro Anfrage und Sticky, die Prüfung der Ausgangs-IP und die Grenzen, die Sie einhalten. Jeder Codeausschnitt lief am 29. September 2026 mit Python 3.13.9, requests 2.34.2, httpx 0.28.1 und tenacity 9.1.4. Die Konzepte stehen in Was ist IP-Rotation und Web Scraping ohne Sperren; dieser Beitrag ist der Code.
Warum bekommt eine einzelne IP 429 oder 403?
Seiten zählen Anfragen pro Client, und die einfachste Client-Kennung ist die Quell-IP. Ein Ratenbegrenzer führt pro Adresse einen Zähler in einem Zeitfenster und antwortet mit 429 Too Many Requests, sobald der Zähler die Schwelle überschreitet. RFC 6585, Abschnitt 4 definiert den Code für diesen Fall und erlaubt der Antwort einen Retry-After-Header, der sagt, wie lange Sie warten sollen. Die Zählalgorithmen stehen in 429 Too Many Requests erklärt.
Ein 403 nach wiederholten 429 ist eine andere Ebene: Der Begrenzer hat Sie zum Bremsen aufgefordert, Sie haben nicht gebremst, und eine Regel hat Ihre Adresse auf eine Sperrliste gesetzt, die Ihr Skript überdauert. Rotierende Ausgänge verteilen Anfragen auf viele Adressen, damit keine einzelne die Schwelle überschreitet, aber sie ersetzen das Bremsen nicht: Schicken Sie 600 Anfragen pro Minute von zehn Adressen an eine Seite, die 60 erlaubt, bekommen Sie zehn gesperrte Adressen statt einer.
Wie funktioniert ein rotierendes Proxy-Gateway?
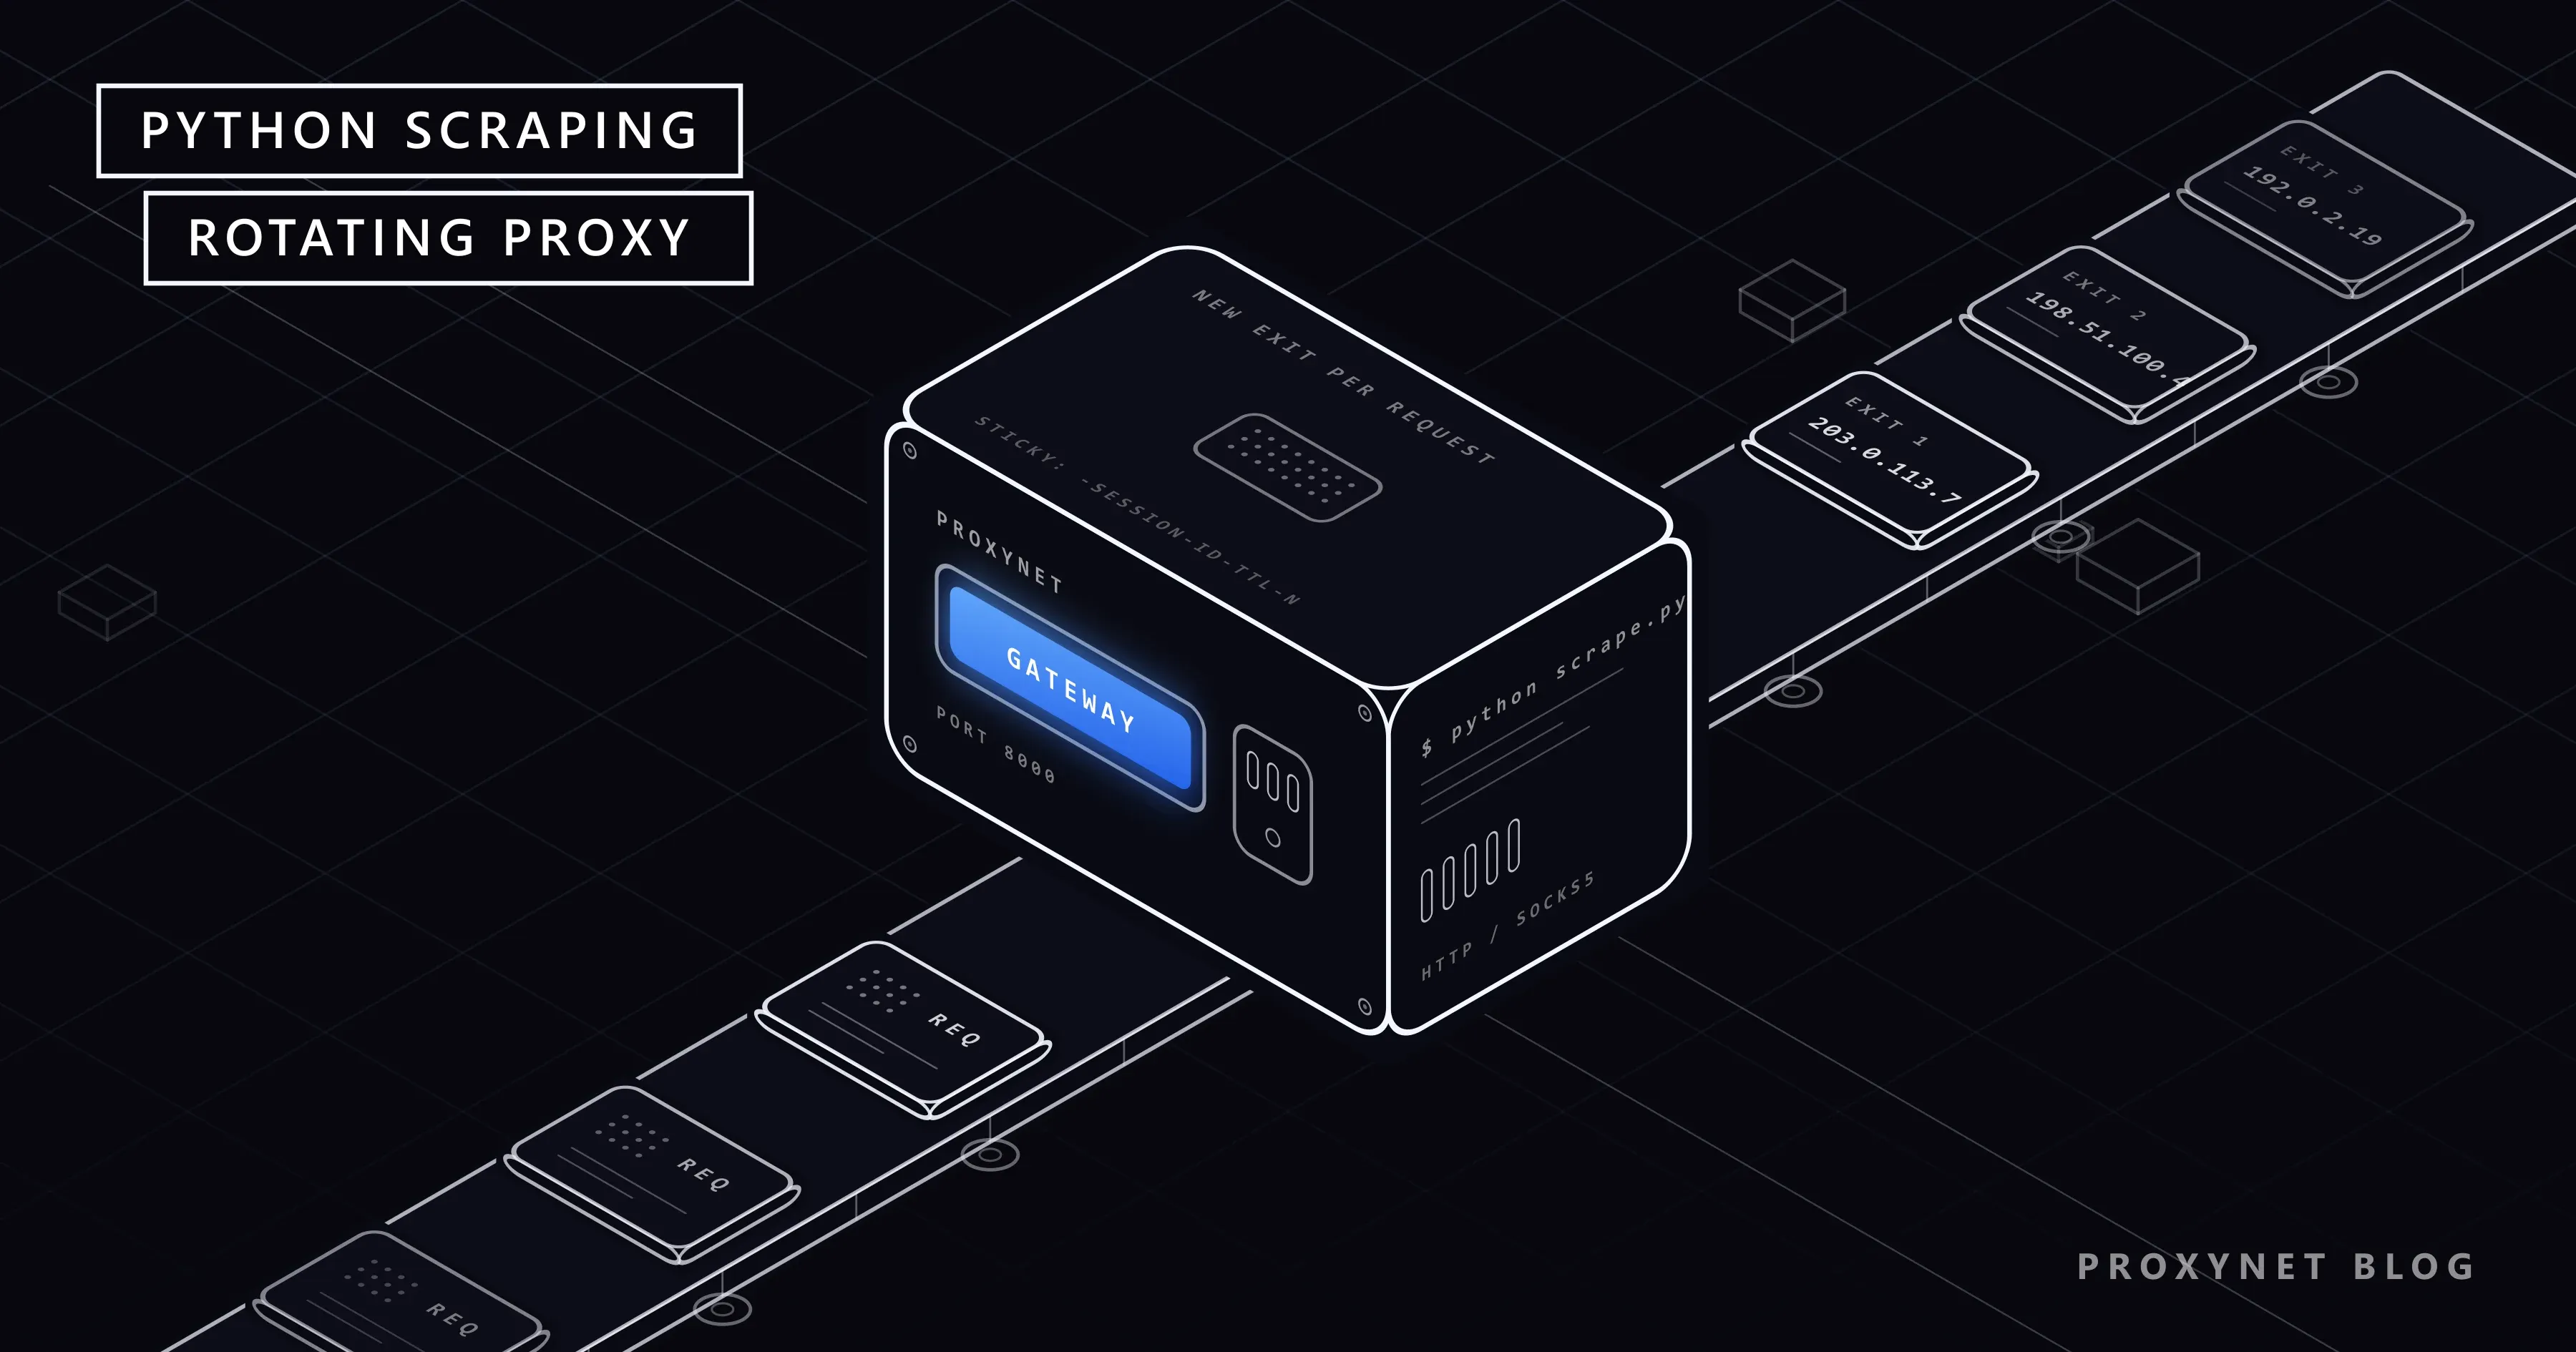
Im Gateway-Modell (Backconnect) kennt Ihr Code eine einzige Adresse, in den Beispielen pr.proxynet.io:8000, und der Anbieter verwaltet den Pool dahinter. Eine HTTPS-Anfrage nimmt diesen Weg:
- Ihr Client öffnet eine TCP-Verbindung zum Gateway und schickt
CONNECT target:443mit einemProxy-Authorization: Basic ...-Header, der aususer:passgebildet wird. - Das Gateway liest den Benutzernamen. Alles nach Ihrem Kontoteil ist ein Parameter:
-country-trfiltert den Pool auf ein Land,-session-<id>-ttl-<seconds>fordert eine Sticky-Sitzung an. - Das Gateway wählt einen Ausgang aus dem gefilterten Pool: im Modus pro Anfrage einen frischen für jeden neuen Tunnel, im Sticky-Modus den bereits an Ihre Sitzungs-ID gebundenen.
- Der Tunnel steht, TLS läuft zwischen Ihrem Client und dem Ziel, und das Ziel sieht die IP des Ausgangs.
- Wenn der Tunnel schließt, ist die Bindung weg. Die nächste Verbindung bekommt einen neuen Ausgang, sofern keine Sitzungs-ID einen festhält.
Schritt 3 ist die ganze Geschichte dieses Tutorials. Die Einheit der Rotation ist der Tunnel, nicht die HTTP-Anfrage: Solange ein CONNECT-Tunnel offen bleibt, verlässt jede Anfrage darüber das Gateway über denselben Ausgang. Deshalb ändert Keep-Alive, das jeder moderne Client standardmäßig einschaltet, was „pro Anfrage" in der Praxis bedeutet. Die Produktseite ist Rotierender Proxy; die Ausgänge hier stammen aus einem Residential-Proxy-Pool, das Ziel sieht also eine gewöhnliche Privatanschluss-Adresse. Das Panel erzeugt den echten Benutzernamen (proxynet-xxxxxxxx-country-tr-session-…-ttl-1800); unten ist er zu user gekürzt.
Rotation pro Anfrage vs. Sticky-Sitzung vs. statische IP
| Rotation pro Anfrage | Sticky-Sitzung | Statische IP | |
|---|---|---|---|
| Was die IP wechselt | Jede neue Verbindung | Eine geänderte Sitzungs-ID oder das Ende der TTL (1 bis 60 Minuten) | Nichts; die Adresse gehört Ihnen |
| Benutzername | user | user-session-<id>-ttl-<seconds> | Eigenes Produkt, festes host:port |
| Cookies und Logins | Brechen; die Seite sieht ein Cookie aus vielen Städten | Bleiben für die Dauer der TTL erhalten | Bleiben unbegrenzt erhalten |
| Kosten pro Anfrage | Jedes Mal neuer TCP- und TLS-Handshake | Einmal Handshake, dann Keep-Alive | Einmal Handshake, dann Keep-Alive |
| Parallele Worker | Jede Verbindung bekommt einen eigenen Ausgang | Eine ID pro Worker, ein Ausgang pro ID | So viele Ausgänge, wie Sie Adressen mieten |
| Typische Aufgabe | Unabhängige Produkt- oder Listenseiten | Login, Warenkorb, mehrseitige Paginierung | API-Allowlists, langlebige Konten |
Sticky ist eine Bitte, den Ausgang zu halten, keine Garantie; ein Privatanschluss-Gerät kann offline gehen, und das Gateway verschiebt die Sitzung vorzeitig. Das Produktverhalten steht auf der Seite Sticky-Proxy.
requests einrichten: das proxies-Dictionary
Die requests-Dokumentation zu Proxys empfiehlt, proxies bei jeder Anfrage explizit zu übergeben, weil Werte in session.proxies von den Umgebungsvariablen HTTP_PROXY und HTTPS_PROXY überschrieben werden können. Die Schlüssel sind das Schema der Ziel-URL, und beide zeigen auf dieselbe http://-Gateway-Adresse, da HTTPS-Verkehr getunnelt wird:
import os
import requests

# Diesen String erzeugt das Panel; in einer Umgebungsvariable halten, nicht in git.
GATEWAY = os.environ.get("PROXY_URL", "http://user:pass@pr.proxynet.io:8000")
PROXIES = {"http": GATEWAY, "https": GATEWAY}
HEADERS = {"User-Agent": "price-monitor/1.0 (+mailto:you@example.com)"}

resp = requests.get("https://httpbin.org/ip", proxies=PROXIES, headers=HEADERS, timeout=(5, 30))
print(resp.status_code, resp.json())
Das timeout-Tupel setzt 5 Sekunden für den Verbindungsaufbau und 30 Sekunden fürs Lesen; ohne es hängt ein stehen gebliebener Ausgang einen Worker für immer auf. Der User-Agent nennt Ihr Skript und gibt dem Seitenbetreiber eine Kontaktmöglichkeit, was Was ist ein User Agent dem Vortäuschen eines Browsers vorzieht. Die Zugangsdaten liegen in einer Umgebungsvariable, weil dieselbe Dokumentation vor versionierten Dateien warnt. Für SOCKS5 installieren Sie requests[socks] und verwenden socks5h://user:pass@pr.proxynet.io:1080; das h lässt den Proxy DNS auflösen, und der SOCKS5-Port rotiert genauso.
Session-Wiederverwendung: warum die IP nicht gewechselt hat
Eine requests.Session verwendet die TCP-Verbindung wieder, was hinter einem Proxy heißt: Sie verwendet den Tunnel und damit den Ausgang wieder. Wir haben das mit einem lokalen Testproxy gemessen, der jedes CONNECT protokolliert:
Drei GETs an denselben Host | Geöffnete Tunnel | Zugewiesene Ausgänge (einer pro Tunnel) |
|---|---|---|
Dreimal requests.get(...), ohne Session | 3 | 3 |
Eine Session, dreimal s.get(...) | 1 | 1 |
Eine Session, headers={"Connection": "close"} | 3 | 3 |
Ein httpx.AsyncClient, dreimal nacheinander await client.get(...) | 1 | 1 |
Daraus folgt die Regel: Für Rotation pro Anfrage rufen Sie requests.get ohne Session auf oder senden Connection: close; für Sticky-Arbeit verwenden Sie Session und Sitzungs-ID zusammen, weil eine abgebrochene Verbindung sonst den Ausgang neu zuweisen würde.
Wiederholungen mit Backoff, die Retry-After respektieren
Hinter einem rotierenden Gateway scheitern zwei Dinge: das Netzwerk (ein Ausgang fällt weg, der Tunnel wird abgelehnt, ein Lesevorgang läuft in den Timeout) und das Ziel (ein 429 oder ein 5xx). Beides verdient eine Wiederholung, aber nicht dieselbe Wartezeit. Ein 429 kann in Retry-After die eigene Zahl der Seite tragen, und diese Zahl gewinnt. Alles andere bekommt exponentiellen Backoff mit Jitter, damit vier Worker, die gemeinsam gescheitert sind, nicht gemeinsam wiederholen:
import logging
import random
import time

import requests

MAX_ATTEMPTS = 4         # erster Versuch + 3 Wiederholungen
RETRY_STATUS = {429, 500, 502, 503, 504}
TIMEOUT = (5, 30)        # Verbindungsaufbau, Lesen - Sekunden
log = logging.getLogger("scraper")


def backoff(attempt: int) -> float:
    """1, 2, 4, 8 s ... plus Jitter, damit Worker nicht im Gleichschritt wiederholen."""
    return min(2 ** (attempt - 1), 30) + random.uniform(0, 1)


def fetch(url: str) -> requests.Response:
    """GET auf eine URL mit Wiederholungen. Wirft nach dem letzten gescheiterten Versuch."""
    for attempt in range(1, MAX_ATTEMPTS + 1):
        try:
            resp = requests.get(url, proxies=PROXIES, headers=HEADERS, timeout=TIMEOUT)
        except (requests.ConnectionError, requests.Timeout) as exc:
            # Schließt ProxyError ein: das Gateway hat den Tunnel abgelehnt oder getrennt.
            log.warning("attempt %d/%d %s: %s", attempt, MAX_ATTEMPTS, url, exc.__class__.__name__)
            if attempt == MAX_ATTEMPTS:
                raise
            time.sleep(backoff(attempt))
            continue

        if resp.status_code not in RETRY_STATUS:
            return resp  # 200, 404, 301 ... der Aufrufer entscheidet

        # Die Seite bittet uns zu bremsen. Ihre Zahl gewinnt gegen unseren Plan.
        retry_after = resp.headers.get("Retry-After")
        wait = float(retry_after) if retry_after and retry_after.isdigit() else backoff(attempt)
        log.warning("attempt %d/%d %s: HTTP %d, sleeping %.1fs", attempt, MAX_ATTEMPTS, url, resp.status_code, wait)
        if attempt == MAX_ATTEMPTS:
            resp.raise_for_status()
        time.sleep(wait)
    raise RuntimeError("unreachable")
requests.ProxyError ist eine Unterklasse von ConnectionError; ein Gateway, das den CONNECT mit einem Fehler beantwortet, wird also über einen neuen Tunnel wiederholt, was im Modus pro Anfrage einen neuen Ausgang bedeutet. Ein 404 wird unverändert zurückgegeben: Die Seite ist weg, und eine andere Adresse bringt sie nicht zurück.
Dieselbe Regel als tenacity-Decorator ist kürzer, um den Preis, dass Retry-After zu einer Exception wird und damit der Zeitplan von tenacity statt des Headers gilt:
from tenacity import retry, retry_if_exception_type, stop_after_attempt, wait_exponential_jitter


class RetryableStatus(Exception):
    """Wird bei 429 und 5xx geworfen, damit tenacity sie wie einen Netzwerkfehler wiederholt."""


@retry(
    stop=stop_after_attempt(4),
    wait=wait_exponential_jitter(initial=1, max=20),
    retry=retry_if_exception_type((requests.ConnectionError, requests.Timeout, RetryableStatus)),
    reraise=True,
)
def fetch_with_tenacity(url: str) -> requests.Response:
    resp = requests.get(url, proxies=PROXIES, headers=HEADERS, timeout=TIMEOUT)
    if resp.status_code in RETRY_STATUS:
        raise RetryableStatus(f"HTTP {resp.status_code} for {url}")
    return resp
Gegen https://httpbin.org/status/503 wiederholte er nach 1,5 s, 2,8 s und 4,8 s und warf dann RetryableStatus.
Ein vollständiger Scraper: Thread-Pool, Wiederholungen und Logging
ThreadPoolExecutor führt vier fetch-Aufrufe gleichzeitig aus, as_completed liefert die Ergebnisse, sobald sie fertig sind, und eine gescheiterte Seite wird protokolliert, ohne den Lauf zu stoppen. Speichern Sie es als scrape.py:
"""scrape.py - eine Liste von Seiten über ein rotierendes Proxy-Gateway abrufen."""
import logging
import os
import random
import sys
import time
from concurrent.futures import ThreadPoolExecutor, as_completed

import requests

GATEWAY = os.environ.get("PROXY_URL", "http://user:pass@pr.proxynet.io:8000")
PROXIES = {"http": GATEWAY, "https": GATEWAY}
HEADERS = {"User-Agent": "price-monitor/1.0 (+mailto:you@example.com)"}

MAX_WORKERS = 4          # gleichzeitig laufende Anfragen
MAX_ATTEMPTS = 4
RETRY_STATUS = {429, 500, 502, 503, 504}
TIMEOUT = (5, 30)

log = logging.getLogger("scraper")


def backoff(attempt: int) -> float:
    return min(2 ** (attempt - 1), 30) + random.uniform(0, 1)


def fetch(url: str) -> requests.Response:
    # die Retry-Schleife aus dem vorigen Abschnitt, unverändert
    ...


def scrape(url: str) -> dict:
    started = time.monotonic()
    resp = fetch(url)
    return {
        "url": url,
        "status": resp.status_code,
        "bytes": len(resp.content),
        "seconds": round(time.monotonic() - started, 2),
    }


def main(urls: list[str]) -> None:
    logging.basicConfig(level=logging.INFO, format="%(asctime)s %(levelname)s %(message)s")
    results, failed = [], []
    with ThreadPoolExecutor(max_workers=MAX_WORKERS) as pool:
        futures = {pool.submit(scrape, url): url for url in urls}
        for future in as_completed(futures):
            url = futures[future]
            try:
                row = future.result()
                results.append(row)
                log.info("ok   %s -> %d in %.1fs", url, row["status"], row["seconds"])
            except Exception as exc:  # eine defekte Seite darf den Lauf nicht stoppen
                failed.append((url, repr(exc)))
                log.error("fail %s -> %s", url, exc)
    log.info("done: %d ok, %d failed", len(results), len(failed))
    for row in results:
        print(row)


if __name__ == "__main__":
    targets = sys.argv[1:] or [f"https://httpbin.org/ip?n={i}" for i in range(8)]
    main(targets)
Wir haben es über einen lokalen Testproxy laufen lassen, der jeden dritten Tunnel mit 429 ablehnt, um den Retry-Pfad zu üben. Acht URLs, vier Worker, acht Tunnel, drei eingebaute Fehler, null verlorene Seiten:
03:32:27 WARNING attempt 1/4 https://httpbin.org/ip?n=2: ProxyError
03:32:28 INFO ok   https://httpbin.org/ip?n=3 -> 200 in 1.1s
03:32:28 INFO ok   https://httpbin.org/ip?n=1 -> 200 in 1.1s
03:32:28 INFO ok   https://httpbin.org/ip?n=0 -> 200 in 1.1s
03:32:28 WARNING attempt 1/4 https://httpbin.org/ip?n=5: ProxyError
03:32:29 INFO ok   https://httpbin.org/ip?n=4 -> 200 in 0.9s
03:32:29 WARNING attempt 1/4 https://httpbin.org/ip?n=7: ProxyError
03:32:29 INFO ok   https://httpbin.org/ip?n=6 -> 200 in 0.9s
03:32:30 INFO ok   https://httpbin.org/ip?n=2 -> 200 in 2.6s
03:32:31 INFO ok   https://httpbin.org/ip?n=5 -> 200 in 2.4s
03:32:31 INFO ok   https://httpbin.org/ip?n=7 -> 200 in 2.0s
03:32:31 INFO done: 8 ok, 0 failed
Das Log gehört zum Entwurf: URL, Versuchsnummer, Status oder Exception-Klasse und die Wartezeit auf jeder Zeile reichen, um „die Seite drosselt uns" von „das Gateway trennt Tunnel" zu unterscheiden, ohne irgendetwas neu laufen zu lassen. Vier Worker sind bewusst wenig; Parallelität vervielfacht Ihre Anfragerate, und die Rate ist das, was das Ziel misst. Schreiben Sie die results-Zeilen so heraus, wie Gescrapte Daten in CSV, JSON und SQLite speichern es zeigt; der Parsing-Schritt zwischen resp.text und einer Zeile steht in Daten von einer Website extrahieren.
Dieselbe Aufgabe mit httpx und asyncio
httpx nimmt den Proxy am Client entgegen, wie die httpx-Dokumentation zu Proxys beschreibt. Eine Semaphore ersetzt den Thread-Pool als Parallelitätsgrenze; die Retry-Schleife behält ihre Form, nur aus den Sleeps wird await:
import asyncio
import random

import httpx

MAX_IN_FLIGHT = 4


async def fetch(client: httpx.AsyncClient, url: str) -> httpx.Response:
    for attempt in range(1, MAX_ATTEMPTS + 1):
        try:
            resp = await client.get(url)
        except (httpx.TransportError, httpx.ProxyError) as exc:
            log.warning("attempt %d/%d %s: %s", attempt, MAX_ATTEMPTS, url, exc.__class__.__name__)
            if attempt == MAX_ATTEMPTS:
                raise
            await asyncio.sleep(2 ** (attempt - 1) + random.uniform(0, 1))
            continue
        if resp.status_code not in RETRY_STATUS:
            return resp
        retry_after = resp.headers.get("Retry-After")
        wait = float(retry_after) if retry_after and retry_after.isdigit() else 2 ** (attempt - 1) + random.uniform(0, 1)
        log.warning("attempt %d/%d %s: HTTP %d, sleeping %.1fs", attempt, MAX_ATTEMPTS, url, resp.status_code, wait)
        if attempt == MAX_ATTEMPTS:
            resp.raise_for_status()
        await asyncio.sleep(wait)
    raise RuntimeError("unreachable")


async def main(urls: list[str]) -> None:
    gate = asyncio.Semaphore(MAX_IN_FLIGHT)
    async with httpx.AsyncClient(proxy=GATEWAY, headers=HEADERS, timeout=httpx.Timeout(30, connect=5)) as client:

        async def one(url: str):
            async with gate:
                resp = await fetch(client, url)
                return {"url": url, "status": resp.status_code}

        rows = await asyncio.gather(*(one(u) for u in urls), return_exceptions=True)
    for url, row in zip(urls, rows):
        print("FAIL" if isinstance(row, Exception) else "ok  ", url, row)


asyncio.run(main([f"https://httpbin.org/ip?n={i}" for i in range(8)]))
Ein Client heißt ein Verbindungspool, und gepoolte Verbindungen verwenden Tunnel wieder: Mit vier laufenden Anfragen und acht URLs öffnete unser Lauf vier Tunnel, Seitenpaare teilten sich also einen Ausgang. Muss jede Seite über eine eigene Adresse hinausgehen, senden Sie headers={"Connection": "close"}; muss sich eine Gruppe von Seiten eine teilen, ist das eine Sticky-Sitzung und kein Zufall des Poolings. Welche Bibliothek zu welcher Aufgabe passt, steht in HTTPX vs. Requests vs. AIOHTTP.
Pro Anfrage oder Sticky wählen und die Ausgangs-IP prüfen
Entscheiden Sie pro Aufgabe. Produktseiten, Suchlisten und öffentliche Profile sind unabhängig: Rotation pro Anfrage, kein Session-Objekt. Ein Login mit zwanzig paginierten Seiten danach ist ein Gespräch: eine Session für die Cookies, eine Sitzungs-ID für den Ausgang, ein Worker. Ein Cookie-Jar, der bleibt, während die IP wechselt, ist der häufigste Weg, mitten im Lauf ausgeloggt zu werden; die Login-Seite ist in Sessions und Cookies in Python gebaut.
Bevor Sie einem der beiden Modi trauen, fragen Sie einen Echo-Dienst, welche Adresse er sieht: Drei Aufrufe ohne Session sollten drei verschiedene Adressen liefern, drei mit derselben Sitzungs-ID dieselbe:
import uuid
import requests

HOST = "pr.proxynet.io:8000"
USER, PASSWORD = "user", "pass"
ECHO = "https://httpbin.org/ip"


def proxies_for(username: str) -> dict:
    url = f"http://{username}:{PASSWORD}@{HOST}"
    return {"http": url, "https": url}


print("per request:")
for _ in range(3):  # keine Session, also öffnet jeder Aufruf einen neuen Tunnel
    print("  ", requests.get(ECHO, proxies=proxies_for(USER), timeout=20).json()["origin"])

sid = uuid.uuid4().hex[:8]
sticky = proxies_for(f"{USER}-session-{sid}-ttl-600")  # derselbe Ausgang für bis zu 600 s
print(f"sticky {sid}:")
with requests.Session() as s:
    for _ in range(3):
        print("  ", s.get(ECHO, proxies=sticky, timeout=20).json()["origin"])
Lassen Sie das zu Beginn einer Aufgabe laufen und protokollieren Sie das Ergebnis. Druckt „per request" dreimal dieselbe Adresse, sehen Sie zuerst auf die Verbindungswiederverwendung; druckt „sticky" drei verschiedene, kommt die Sitzungs-ID nicht am Gateway an, meist weil ein URL-Encoding-Schritt den Benutzernamen verstümmelt hat.
Ratenlimits, robots.txt und die Grenzen, die Sie einhalten
Ein rotierender Proxy ändert, welche Adresse die Seite sieht, nicht, was die Seite erlaubt:
- Zuerst robots.txt lesen.
urllib.robotparserbeantwortetcan_fetch(user_agent, url)in drei Zeilen; ein verbotener Pfad bleibt aus der URL-Liste. Was die Datei ausdrücken kann, steht in Was ist robots.txt. Retry-Afterwörtlich nehmen. Die Retry-Schleife wartet die Zahl der Seite ab, auch wenn die Rotation Sie über einen anderen Ausgang weitermachen ließe.- Die Rate begrenzen, nicht nur die Worker. Vier Worker ohne Verzögerung schicken auf einer schnellen Seite immer noch 40 Anfragen pro Sekunde; fügen Sie pro Worker ein kleines
time.sleephinzu, wenn die Seite ein Limit veröffentlicht. - Die offizielle API bevorzugen, wenn es eine gibt; sie ist für beide Seiten günstiger als HTML durch einen Proxy zu parsen.
- Keine CAPTCHA-Lösedienste und keine Plugins zur Umgehung von Erkennung. Ein CAPTCHA heißt, die Seite will einen Menschen; die Antwort ist eine niedrigere Rate, die API oder eine Anfrage um Zugang.
Wo dieser Aufbau eingesetzt wird
- Preisüberwachung. Tausende unabhängige Produktseiten pro Tag, Rotation pro Anfrage, vier bis acht Worker; die Pool-Dimensionierung steht auf der Seite Data Scraping.
- Eigene Dashboards hinter Login. Eine Sticky-Sitzung pro Konto, ein Worker, Cookies zwischen den Läufen gespeichert wie in Sessions und Cookies in Python.
- Ablösung einer handgepflegten Proxy-Liste. Im Code durch eine Liste zu rotieren, wie in Proxys in Python rotieren, ist der ältere Ansatz; das Gateway nimmt Ihnen die Liste und die Buchführung über tote Adressen ab.
Häufige Fehler
- Eine
Sessionwiederverwenden und pro Seite eine neue IP erwarten. Ein Tunnel, ein Ausgang. Lassen Sie die Session weg oder senden SieConnection: close. - Eine Sticky-ID ohne
Session. Der Ausgang ist fixiert, aber jeder Aufruf zahlt einen neuen Handshake, und die Cookies gehen verloren. Verwenden Sie beides zusammen. - Einen
404wiederholen. Die Seite ist weg; ein anderer Ausgang findet sie nicht. Wiederholen Sie nur429,5xxund Netzwerkfehler. - Kein Timeout. Ein stehen gebliebener Ausgang blockiert einen Worker, bis der Prozess beendet wird. Übergeben Sie immer
timeout=(5, 30). - Zugangsdaten im Skript. Sie landen in der git-Historie. Lesen Sie sie aus der Umgebung.
Entscheidungshilfe
| Bedarf | Empfehlung |
|---|---|
| Viele unabhängige Seiten, kein Login | Rotation pro Anfrage, requests.get ohne Session, zum Start 4 Worker |
| Login, dann viele Seiten | Sticky-Sitzung (-session-<id>-ttl-<seconds>) plus eine requests.Session, ein Worker pro Konto |
| Tausende kleine Anfragen, I/O-gebunden | httpx AsyncClient mit einer Semaphore; Connection: close, wenn jede einen eigenen Ausgang braucht |
| Die Seite veröffentlicht ein Ratenlimit | Erst Worker und Verzögerungen unter dieses Limit setzen, dann Rotation |
| Länderspezifische Preise | -country-xx im Benutzernamen, Rotation pro Anfrage innerhalb dieses Landes |
| Die Adresse darf sich nie ändern (API-Allowlist) | Kein rotierendes Produkt; nehmen Sie eine statische IP |
Häufige Fragen
Warum wechselt die IP nicht bei jeder Anfrage?
Weil Ihr Client die Verbindung wiederverwendet. Die Session von requests und der Client von httpx halten die TCP-Verbindung und damit den Proxy-Tunnel zwischen Anfragen offen; der Ausgang wird beim Öffnen des Tunnels gewählt. Verwenden Sie einfache requests.get-Aufrufe oder einen Connection: close-Header für einen neuen Ausgang pro Anfrage.
Wie verwende ich eine Sticky-Sitzung in Python?
Hängen Sie -session-<id>-ttl-<seconds> an den Benutzernamen in der Proxy-URL, behalten Sie dieselbe ID für das ganze Gespräch und führen Sie die Aufrufe über eine einzige requests.Session, damit Cookies und Tunnel wiederverwendet werden. Die TTL kann zwischen 1 und 60 Minuten liegen; wählen Sie einen Wert, der länger ist als die Aufgabe.
Sollte ich requests oder httpx für Scraping mit Proxys nehmen?
Für ein paar hundert Seiten pro Nacht reicht requests mit einem Thread-Pool, und es lässt sich leichter debuggen. Für Zehntausende kleine Anfragen verbraucht der Async-Client von httpx mit einer Semaphore weniger Ressourcen. Beide nehmen dieselbe Gateway-URL und dieselbe Retry-Logik.
Wie viele parallele Worker sind sicher?
Beginnen Sie mit vier und beobachten Sie die Antworten. Entscheidend sind die Anfragen pro Minute, wie das Ziel sie sieht, die Antwort hängt also vom Limit der Seite ab, nicht von der Pool-Größe. Tauchen bei vier 429 auf, senken Sie die Zahl oder fügen Sie eine Verzögerung hinzu.
Umgeht ein rotierender Proxy einen 429?
Er verteilt Anfragen auf mehr Adressen, damit jede unter der Schwelle bleibt; die Schwelle entfernt er nicht. Hat die Seite ein Limit gesetzt, respektieren Sie Retry-After, senken Sie die Rate oder nutzen Sie die API. Schneller an einem 429 vorbeizurotieren ist der Weg, auf dem Adressen auf Sperrlisten landen.
Wie prüfe ich, dass der Proxy funktioniert?
Rufen Sie einen IP-Echo-Endpunkt wie https://httpbin.org/ip über den Proxy auf und vergleichen Sie die Antwort mit Ihrer eigenen Adresse: dreimal ohne Session, um die Rotation zu sehen, dreimal mit Sitzungs-ID, um das Sticky-Verhalten zu sehen.
Fazit
Ein rotierender Proxy in Python ist eine Gateway-URL in einem proxies-Dictionary, eine Retry-Schleife, die Retry-After respektiert, eine Grenze von wenigen Workern und eine klare Regel dafür, wann eine Seite sich einen Ausgang mit der vorigen teilen darf. Halten Sie Session-Objekt und Sitzungs-ID für Arbeit hinter Login zusammen, halten Sie beides von unabhängigen Seiten fern, und prüfen Sie die Ausgangs-IP vor dem ersten echten Lauf. Der Pool hinter dem Gateway steht auf der Seite Proxy.