یک تیم قیمتگذاری هر روز صبح قیمت 300 محصول را از 40 فروشگاه اینترنتی لازم دارد، آن هم همانطور که خریداران در پنج کشور آنها را میبینند. نیمی از این فروشگاهها صفحههایشان را با JavaScript میسازند و چیدمان HTML هر کدام با بقیه فرق دارد. تیم میتواند اسکرپرها را خودش بسازد و اداره کند، یا آدرس هر محصول را به یک API وب اسکرپینگ بفرستد و فیلدها را بهصورت JSON تحویل بگیرد.
در این نوشته توضیح میدهیم API وب اسکرپینگ چگونه کار میکند و چه کارهایی را از دوش شما برمیدارد، آن را با چهار راه دیگر رسیدن به داده وب مقایسه میکنیم، به انواع، قیمتگذاری و جنبه حقوقی آن میپردازیم و در پایان به پرسش خریدار میرسیم: API اسکرپینگ یا پروکسیهای خودتان؟
API وب اسکرپینگ چیست؟
API وب اسکرپینگ یک سرویس HTTP است که صفحهای از وب را از طرف شما دریافت میکند و محتوایش را در قالبی برمیگرداند که برنامه شما بتواند از آن استفاده کند. آن را مثل هر API دیگری فرا میخوانید، اما داده از اسکرپ کردن صفحهای میآید که صاحبش هرگز آن را به شکل API ارائه نکرده است. این سرویس با نامهای scraper API یا سرویس وب اسکرپینگ (web scraping service) هم فروخته میشود.
خود وب اسکرپینگ، یعنی برنامهای که صفحهها را دانلود میکند و مقدارها را از HTML بیرون میکشد، در وب اسکرپینگ چیست و چگونه کار میکند؟ توضیح داده شده است. API اسکرپینگ همان کار را انجام میدهد. تفاوت در این است که زیرساخت آن را چه کسی اداره میکند.
یک درخواست چه شکلی دارد؟
نقطه اتصال (endpoint) api.example.com و نام فیلدهای زیر فقط برای توضیح ساخته شدهاند. هر ارائهدهنده گزینههایش را به شکل دیگری نامگذاری میکند، اما شکل کلی درخواست شبیه است.
curl -s https://api.example.com/v1/scrape \
  -H "Authorization: Bearer $API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"url": "https://shop.example.com/p/1234", "country": "de", "render": false, "output": "json"}'
این درخواست را به یک نسخه شبیهسازیشده محلی (mock) از همین API ساختگی فرستادیم و این پاسخ برگشت:
{
  "url": "https://shop.example.com/p/1234",
  "target_status": 200,
  "country": "de",
  "rendered": false,
  "attempts": 2,
  "data": {
    "name": "Desk lamp",
    "price": "24.90",
    "currency": "EUR",
    "in_stock": true
  }
}
target_status کد وضعیت فروشگاه است، attempts میگوید سرویس به دو تلاش نیاز داشت و data فیلدهایی را در خود دارد که تجزیهگر سرویس بیرون کشیده است. با "output": "html" خود صفحه را میگیرید و تجزیه را در سمت خودتان انجام میدهید.
API وب اسکرپینگ چگونه کار میکند؟
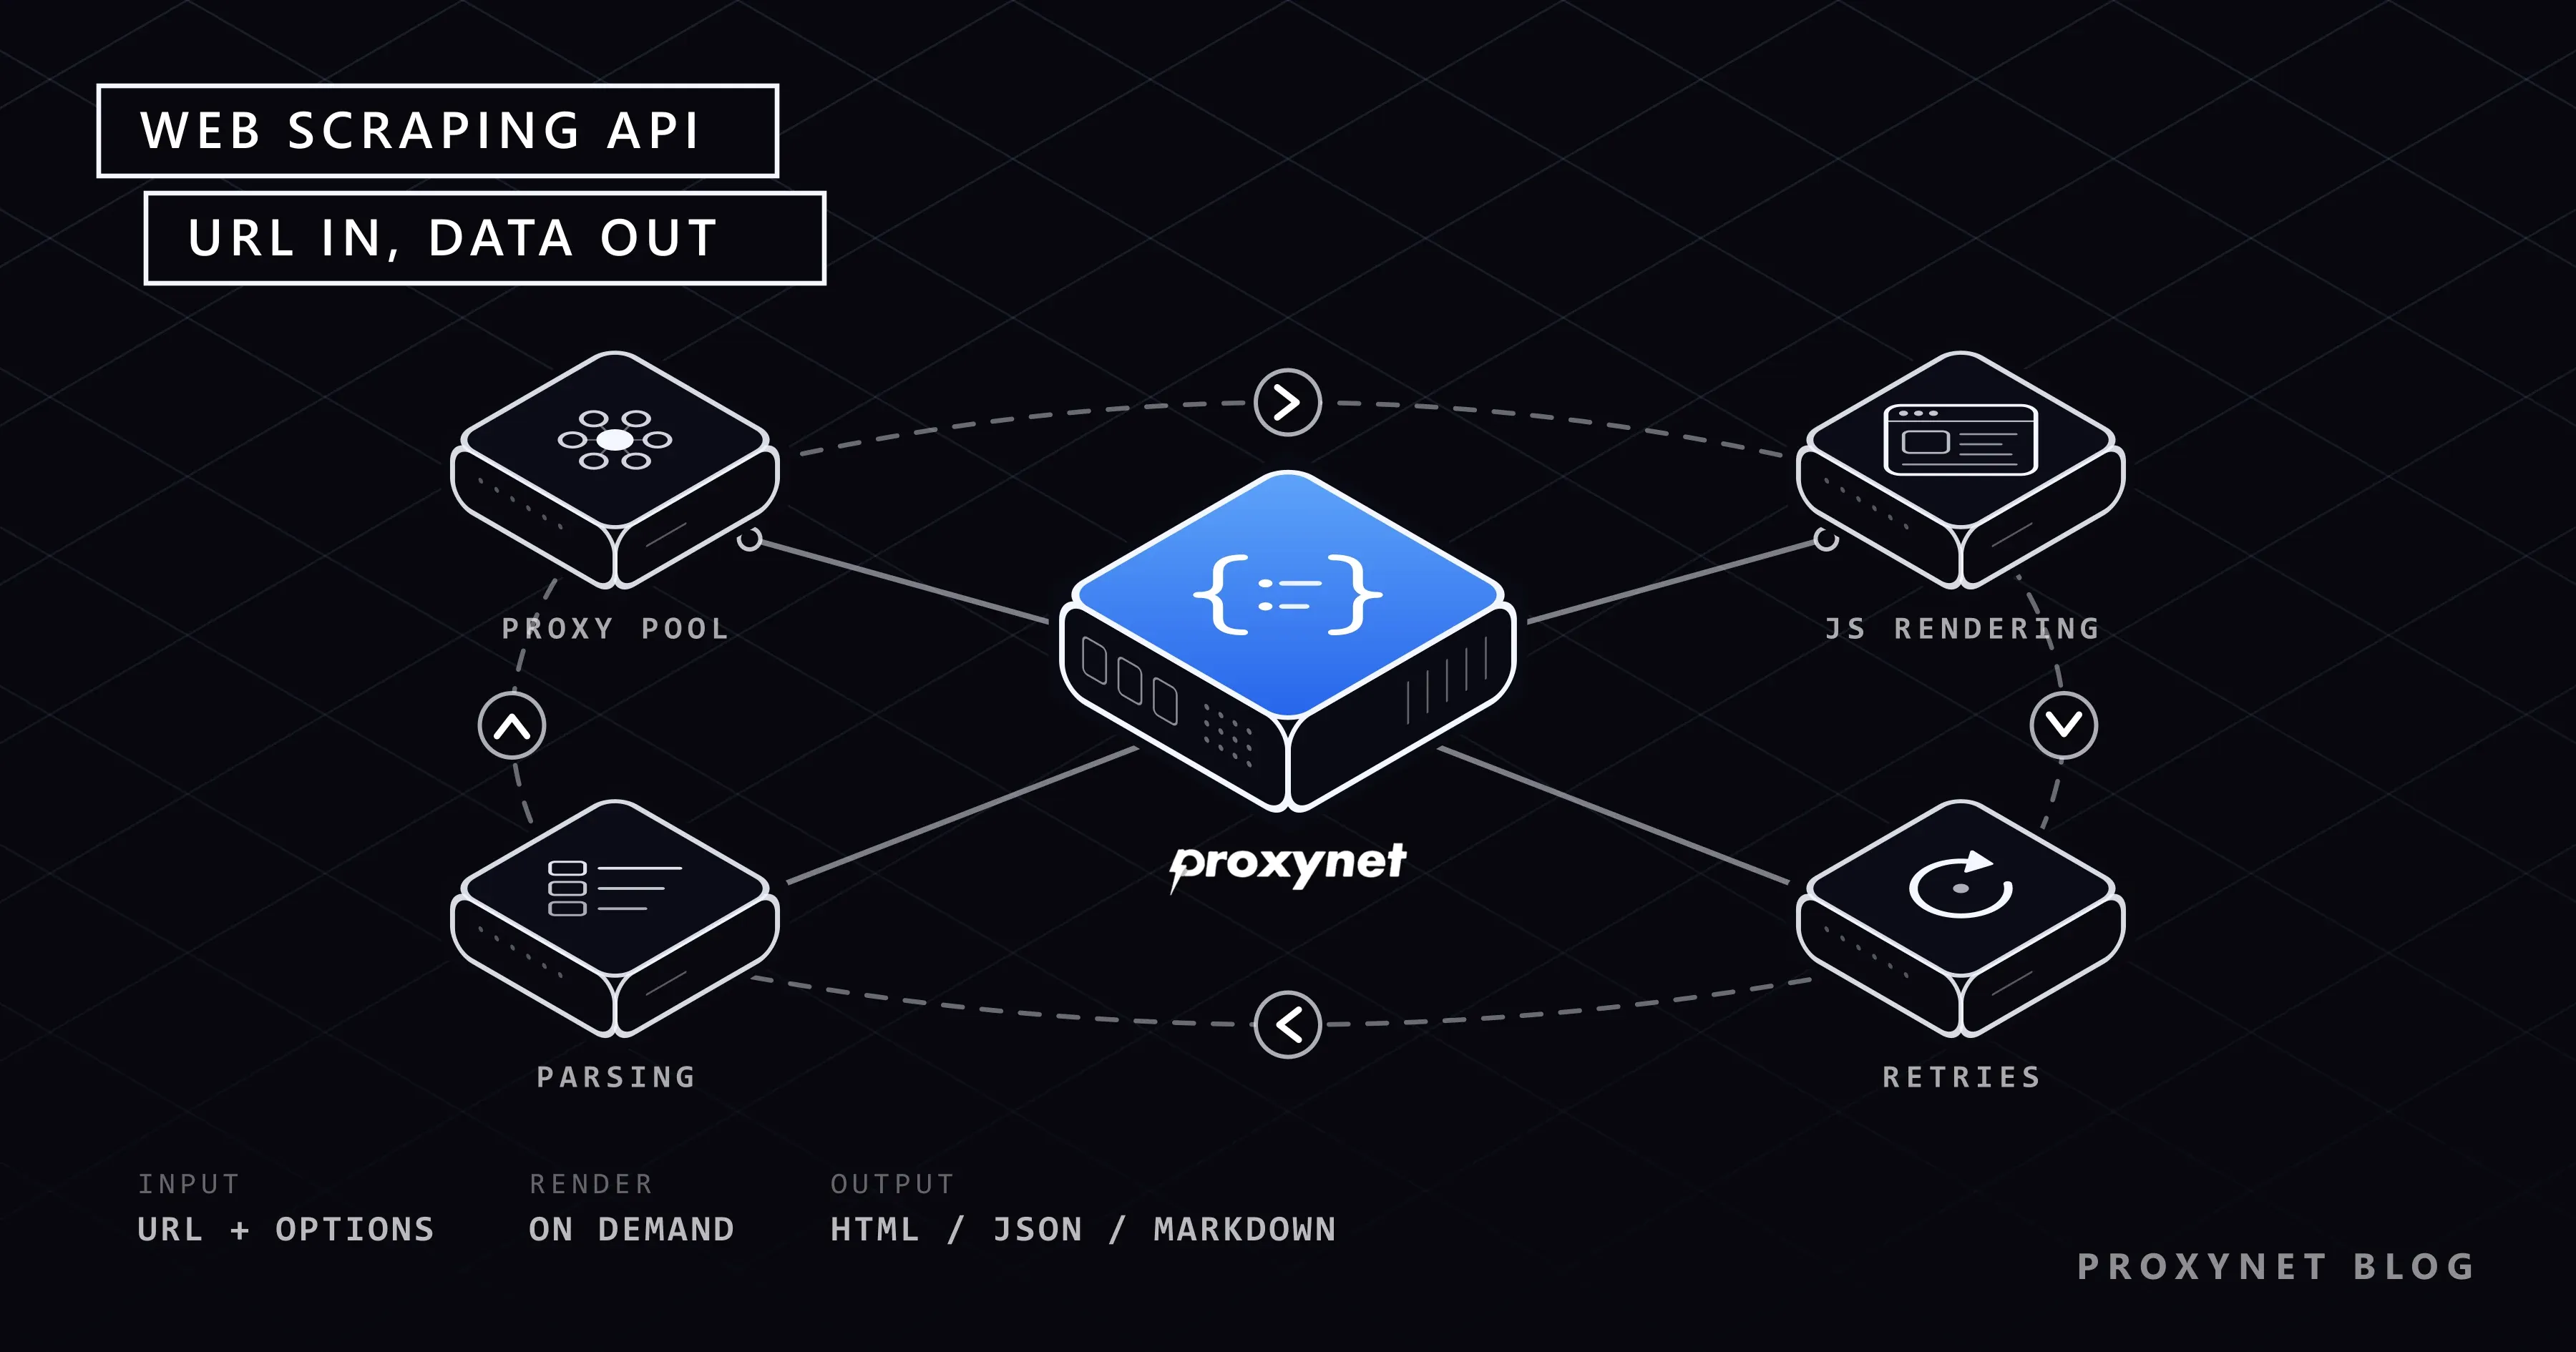
API وب اسکرپینگ همان زنجیره کار یک اسکرپر خودساخته را روی زیرساخت خودش اجرا میکند:
- کار را میفرستید: آدرس صفحه هدف همراه با گزینههایی مانند کشور، رندر و قالب خروجی، و گاهی یک شناسه نشست (session ID) که یک IP را برای چند صفحه نگه میدارد.
- سرویس یک IP خروجی انتخاب میکند، از استخر پروکسی خودش و در کشوری که خواستهاید.
- صفحه را دریافت میکند، با یک درخواست HTTP ساده یا در یک مرورگر headless که JavaScript صفحه را اجرا میکند.
- پاسخ را بررسی میکند: کد وضعیت، بدنه خالی، یا صفحه مسدودی به جای محتوای مورد انتظار.
- درخواستهای ناموفق را دوباره امتحان میکند، با IP دیگری یا پس از مکثی کوتاه، تا سقف مشخصی از تلاشها.
- نتیجه را تبدیل میکند به HTML خام، Markdown پاکسازیشده یا فیلدهای نامدار در JSON.
- نتیجه را برمیگرداند، همراه با فراداده (metadata) مانند کد وضعیت سایت هدف و تعداد تلاشها، و هزینه درخواست را حساب میکند.
API وب اسکرپینگ چه کارهایی را برای شما انجام میدهد؟
API وب اسکرپینگ پنج کاری را بر عهده میگیرد که در اسکرپینگ بیشترین وقت را میگیرند: آدرسهای IP، رندر، تلاش دوباره، مدیریت مسدودیها و تجزیه.
چرخش پروکسی و هدفگیری جغرافیایی. هر درخواست از راه یک IP از استخر ارائهدهنده بیرون میرود، در کشوری (و گاهی شهری) که انتخاب میکنید، با آدرسی تازه برای هر درخواست یا آدرسی ثابت برای یک نشست. این استخرها IPهای ارزان دیتاسنتر را با IPهای مسکونی (رزیدنتال) و موبایل ترکیب میکنند که از اتصالهای خانگی و موبایلی میآیند و گرانترند.
رندر JavaScript. بسیاری از صفحهها به شکل پوستهای تقریباً خالی از HTML میرسند که JavaScript بعداً آن را پر میکند. در این حالت سرویس صفحه را در یک مرورگر headless باز میکند؛ مستندات Chrome این حالت را اجرای مرورگر «در محیطی بدون نظارت و بدون هیچ رابط کاربری قابل مشاهده» توصیف میکند (حالت headless در Chrome). رندر کندترین و گرانترین گزینه است، به همین دلیل آن را برای هر درخواست جداگانه روشن میکنید.
تلاش دوباره. اتصالها قطع میشوند، مهلت پاسخ پروکسیها تمام میشود و سرورها برای لحظهای 503 برمیگردانند؛ سرویس چنین خطاهایی را تا یک سقف مشخص دوباره امتحان میکند. صفحهای که وجود ندارد (404) ارزش تلاش دوباره ندارد و سرویس خوشرفتار پاسخ 429 Too Many Requests را نشانهای برای کم کردن سرعت میداند.
تشخیص مسدودی و کپچا. سایتی که درخواستی را رد میکند اغلب یک صفحه «Access denied» با ظاهری عادی یا یک کپچا (CAPTCHA) میفرستد، یعنی آزمونی برای تشخیص انسان از برنامه. سرویس خوب چنین صفحهای را بهعنوان خطا گزارش میکند، نه بهعنوان داده. رد کردن درخواست تصمیم خود سایت است؛ پس بپرسید ارائهدهنده در برابر آن چه میکند.
تجزیه و خروجی ساختاریافته. بسیاری از APIها فیلدهای نامدار برمیگردانند، چه از تجزیهگرهای آماده و چه از انتخابگرهایی که خودتان میدهید؛ برخی دیگر متن اصلی را بهصورت Markdown برمیگردانند که مدلهای زبانی آن را راحتتر از HTML میخوانند. از نوشتن تجزیهگر معاف میشوید، اما حالا تجزیهگر شخص دیگری تعیین میکند «قیمت» یعنی چه.
مقایسه API وب اسکرپینگ با API رسمی، پروکسی، ابزارها و مجموعهدادهها
هر پنج راه به دادهای در سیستم شما ختم میشوند. تفاوتشان در این است که چه چیزی تحویل میگیرید و بار کار را چه کسی به دوش میکشد.
| راه | چه چیزی دریافت میکنید | کار سخت با کیست | مناسب وقتی |
|---|---|---|---|
| API وب اسکرپینگ | صفحه یا فیلد از هر URL | ارائهدهنده | سایتهای زیاد، وقت کم |
| API رسمی | داده مستند خود سایت | خود سایت | وجود دارد و فیلدهای شما را دارد |
| سرویس پروکسی | آدرس IP برای درخواستهای شما | شما | حجم بالا، کنترل کامل |
| کتابخانه اسکرپینگ | کدی که خودتان اجرا میکنید | شما | توسعهدهنده و سرور دارید |
| خرید مجموعهداده | داده آماده به شکل فایل | فروشنده داده | داده به شکل محصول وجود دارد |
در برابر API رسمی. API رسمی را سایتی منتشر میکند که صاحب داده است؛ API اسکرپینگ شخص ثالثی است که صفحههای عمومی همان سایت را میخواند. تفاوت وب اسکرپینگ و API این دو را با یک نمونه آزمودهشده مقایسه میکند. برای خریدار، تفاوت اصلی در توافق است: API رسمی شرایطی دارد که آن را میپذیرید و اغلب فیلدهایی که هیچ صفحهای نشان نمیدهد، مانند شناسههای داخلی. API اسکرپینگ هیچ توافقی با سایت هدف ندارد و فیلدهایش ممکن است با بازطراحی سایت از کار بیفتند. اگر API رسمی فیلدهای شما را دارد، از همان استفاده کنید.
در برابر سرویس پروکسی. سرویس پروکسی آدرس IP برای درخواستهای خودتان میفروشد و اسکرپر، مرورگر، تلاش دوباره و تجزیهگر همچنان با شماست. API اسکرپینگ بهازای هر صفحه تکمیلشده هزینه میگیرد و بیشتر این سرویسها خودشان روی استخرهای پروکسی کار میکنند.
در برابر کتابخانه اسکرپینگ. Scrapy، Playwright یا Beautiful Soup هزینه مجوز ندارند، اما تیم شما کد را مینویسد و سرورها را اداره میکند. یک راه میانه رایج این است که تجزیه در کتابخانه بماند و فقط سختترین دریافتها به API سپرده شوند.
در برابر مجموعهداده. فروشنده مجموعهداده، دادهای را که از قبل جمعآوری و پاکسازی شده به شکل فایل میفروشد. وقتی داده به شکل محصول وجود دارد این سریعترین راه است و وقتی به فیلدهای مشخص یا بهروزرسانی روزانه نیاز دارید ضعیفترین.
APIهای وب اسکرپینگ چه انواعی دارند؟
ارائهدهندگان همان سازوکار را برای هدفهای مختلف بستهبندی میکنند و یک ارائهدهنده اغلب چند نوع را با هم میفروشد:
- APIهای همهمنظوره هر URLی را دریافت میکنند و HTML، HTML رندرشده یا Markdown برمیگردانند.
- APIهای SERP صفحه نتایج جستوجو را به شکل فیلد برمیگردانند: جایگاه، عنوان، URL و خلاصه متن (snippet). شرایط استفاده موتورهای جستوجو پرسوجوی خودکار را محدود میکند؛ برای رتبههای سایت خودتان، API رسمی Search Console گوگل داده دستاول میدهد.
- APIهای تجارت الکترونیک صفحههای محصول بازارگاهها را به فیلدهایی مانند قیمت، موجودی، فروشنده و امتیاز تبدیل میکنند.
- APIهای شبکههای اجتماعی پروفایلها، پستها و نظرهای عمومی را برمیگردانند. تقریباً همه اینها داده شخصی است و شرایط استفاده پلتفرمها سختگیرانه است، پس محدوده قانونی در اینجا از همه تنگتر است.
- APIهای استخراج آماده برای هوش مصنوعی محتوای اصلی صفحه را بدون منو و پانویس، بهصورت Markdown یا متن تمیز، برای مدلهای زبانی و عاملهای هوش مصنوعی برمیگردانند.
قیمتگذاری APIهای وب اسکرپینگ چگونه است؟
تقریباً همه APIهای اسکرپینگ بر اساس درخواست هزینه میگیرند؛ تفاوت در این است که کدام درخواستها شمرده میشوند. چهار مدل رایج است که اغلب با هم ترکیب میشوند:
- بهازای هر درخواست. هر فراخوانی هزینه دارد، چه موفق باشد چه نه.
- بهازای هر درخواست موفق. فقط درخواستهای موفق هزینه دارند، پس تعریف «موفق» به شرط اصلی قرارداد تبدیل میشود.
- اعتبار (credit) با ضریب. یک درخواست ساده یک اعتبار مصرف میکند؛ رندر، IPهای مسکونی یا موبایل و هدفهای سخت چند اعتبار. قیمت هر اعتبار تا وقتی ضریب کار خودتان را ندانید معنای چندانی ندارد.
- پلنهای ماهانه. سهمیه ثابتی از درخواست یا اعتبار، اغلب با سقفی برای درخواستهای همزمان و نرخی برای مصرف مازاد.
چه درخواستی موفق به حساب میآید؟
استاندارد HTTP میگوید کد وضعیت 2xx یعنی درخواست «با موفقیت دریافت، درک و پذیرفته شده است» (RFC 9110). این دیدگاه سرور است، نه دیدگاه شما: صفحه مسدودی ممکن است با وضعیت 200 برسد و 404 Not Found پاسخی درست است که هیچ دادهای در آن نیست.
پس پیش از خرید بپرسید آیا 404، پاسخ 200 با صفحه خالی یا صفحه مسدودی، و پایان مهلت (timeout) پس از آخرین تلاش هزینه دارند یا نه. سپس هزینه هر 1,000 صفحه قابل استفاده را روی هدفهای واقعی خودتان اندازه بگیرید.
از API اسکرپینگ استفاده کنید یا پروکسیهای خودتان؟
API اسکرپینگ وقتی بهصرفه است که کار گسترده باشد و وقت شما کم؛ اسکرپر خودتان با پروکسی وقتی بهصرفه است که کار محدود به چند سایت، حجیم و طولانیمدت باشد.
در این حالتها API اسکرپینگ را انتخاب کنید:
- به صفحههایی از سایتهای زیاد و متفاوت نیاز دارید که هر کدام چیدمان خودش را دارد؛
- بسیاری از سایتهای هدف محتوایشان را با JavaScript میسازند؛
- تیم کوچک است و کسی نمیخواهد مرورگر، پروکسی و تجزیهگر را اداره کند؛
- زمان رسیدن به نخستین مجموعهداده از هزینه هر صفحه مهمتر است.
در این حالتها اسکرپر و پروکسیهای خودتان را انتخاب کنید:
- حجم کار روی چند سایت محدود بسیار بالاست و قیمت بهازای هر صفحه روی هم انباشته میشود؛
- تجزیهگر و منطق خزش مال خودتان است، یا میخواهید باشد؛
- به کنترل کامل بر نرخ درخواست، نشستها و اینکه کدام IP چه چیزی را میفرستد نیاز دارید.
بسیاری از تیمها هر دو را به کار میبرند: API برای دنباله بلند سایتهای دشوار و اسکرپر خودشان برای معدود سایتهایی که بیشتر حجم کار را دارند.
برای راه پروکسیهای خودتان، Proxynet پروکسی را بهصورت سلفسرویس میفروشد. پروکسی مسکونی ما نشست چرخشی یا ثابت با هدفگیری کشور و شهر ارائه میدهد و هزینه آن بهازای هر گیگابایت محاسبه میشود. پروکسیهای ISP ثابت و دیتاسنتر بهازای هر IP فروخته میشوند و ترافیکشان بدون سهمیه است؛ این IPها بهطور پیشفرض با محدودیت سایت هدف تحویل میشوند و دسترسی به همه وبسایتها یک افزونه پولی است.
Web Scraper API ما فعلاً از طریق تیم فروش در دسترس است، نه بهصورت سلفسرویس. صفحه استخراج داده بخش پروکسی را پوشش میدهد؛ برای API، سایتها، کشورها و قالب خروجی مورد نظرتان را به تیم فروش بگویید.
آیا استفاده از API وب اسکرپینگ قانونی است؟
API چیزی را که مجاز به جمعآوری آن هستید تغییر نمیدهد: فایل robots.txt سایت هدف، شرایط استفاده آن و قانون حفاظت از داده طوری شامل حال شما میشوند که انگار صفحهها را خودتان دریافت کردهاید، چون آدرسها و هدف را شما انتخاب میکنید.
robots.txt. این فایل به خزندهها میگوید کدام مسیرها را میتوانند دریافت کنند. استاندارد آن، RFC 9309، میگوید «این قاعدهها نوعی مجوز دسترسی نیستند» (RFC 9309): این فایل چیزی را قفل نمیکند، پس پیروی از آن بر عهده خزنده است. بپرسید ارائهدهنده به آن پایبند است یا این بررسی را به شما واگذار میکند.
شرایط استفاده. شرایط استفاده سایت هدف شامل حال شما هم میشود، نه فقط ارائهدهنده. صفحههای پشت ورود به حساب، بهویژه با حساب شخص دیگر، با صفحههای عمومی فرق اساسی دارند.
داده شخصی. نامها، پیوندهای پروفایل، نشانیهای ایمیل و نظرهایی که نام نویسنده را دارند طبق GDPR داده شخصیاند، حتی وقتی عمومی باشند. پیشنویس رهنمودهای هیئت اروپایی حفاظت از دادهها (EDPB)، که در 7 ژوئیه 2026 برای نظرخواهی عمومی تصویب شد، میگوید «سازمانی که اسکرپینگ را انجام میدهد لزوماً کنترلکننده طبق GDPR نیست» (رهنمودهای EDPB 03/2026). پیمانکاری که بر اساس دستورهای مستند یک مشتری اسکرپ میکند ممکن است پردازشگر باشد؛ مشتری، که هدف را تعیین میکند، معمولاً کنترلکننده است.
این رهنمودها به اسکرپینگ برای آموزش هوش مصنوعی مولد میپردازند، اما تقسیم نقشها از قاعدههای عمومی GDPR پیروی میکند. در آنها فایلهای robots.txt و کپچاها هم در شمار نشانههایی آمدهاند که نشان میدهند سایت با اسکرپینگ مخالف است.
پس فقط فیلدهایی را جمع کنید که لازم دارید و اگر ارائهدهنده از طرف شما داده شخصی را پردازش میکند، یک قرارداد پردازش داده امضا کنید. مدیریت دادههای شخصی (PII) در مجموعهدادههای اسکرپشده نشان میدهد چنین دادهای را چگونه کم کنید و بپوشانید.
کاربردها
- پایش قیمت و موجودی در فروشگاهها و کشورهای مختلف.
- ردیابی نتایج جستوجو برای فهرستی از کلیدواژهها، در چارچوب شرایط موتور جستوجو.
- تحقیقات بازار: سبد محصولات، کاتالوگها و متن نظرها بدون داده نویسنده.
- گردآوری آگهیها از پورتالهای املاک، سفر یا نیازمندیها.
- زنجیرههای هوش مصنوعی: تبدیل مستندات به Markdown برای بازیابی (retrieval).
- بررسی تبلیغ و محتوا: اینکه یک صفحه در کشوری دیگر چگونه دیده میشود.
اشتباههای رایج
- پرداخت هزینه رندری که لازم ندارید. هر هدف را اول بدون رندر بیازمایید؛ داده بسیاری از صفحهها در خود HTML هست.
- مقایسه قیمتها بدون تعریف موفقیت. قیمت پایین بهازای هر درخواست وقتی صفحههای مسدودی و پاسخهای
404هم هزینه دارند معنای چندانی ندارد. - اعتماد به JSON برگشتی بدون بررسی طرحواره (schema). پس از یک بازطراحی، یک فیلد تجزیهشده ممکن است بیصدا به
nullتبدیل شود. هر پاسخ را با یک طرحواره اعتبارسنجی کنید؛ JSON Schema قالب رایج این کار است. - تلاش دوباره روی تلاشهای دوباره ارائهدهنده. 3 تلاش API ضرب در 3 تلاش خودتان یعنی 9 بار دریافت یک صفحه ناموفق.
- فرض اینکه API رضایت و قانونی بودن را مدیریت میکند. ارائهدهنده صفحه را دریافت میکند؛ اینکه چه چیزی و برای چه، تصمیم شماست.
- استفاده از API اسکرپینگ وقتی API رسمی وجود دارد. برای اسکرپ کردن دادهای پول میدهید که صاحبش از قبل ارائه میکند.
راهنمای انتخاب
| نیاز | پیشنهاد |
|---|---|
| داده از 50 سایت مختلف، تیم کوچک | یک API اسکرپینگ |
| بسیاری از هدفها صفحه را با JavaScript میسازند | یک API اسکرپینگ، با رندر فقط در جای لازم |
| میلیونها صفحه در ماه از سه سایت | اسکرپر خودتان با پروکسی |
| کنترل کامل بر نرخ، نشستها و تجزیه | اسکرپر خودتان با پروکسی |
| سایت API رسمی با فیلدهای مورد نیاز شما دارد | API رسمی |
| قیمتها همانطور که خریداران در پنج کشور میبینند | یک API اسکرپینگ یا پروکسی مسکونی |
| داده به شکل محصول وجود دارد و تازه بودن اختیاری است | خرید مجموعهداده |
| پروفایلهای عمومی یا نظرهایی با نام نویسنده | فیلدها را محدود کنید و اول مبنای قانونی را روشن کنید |
پرسشهای متداول
API وب اسکرپینگ برای چه استفاده میشود؟
API وب اسکرپینگ برای جمعآوری داده از وبسایتها بدون اداره زیرساخت اسکرپینگ خودتان به کار میرود. کارهای رایج آن پایش قیمت، ردیابی نتایج جستوجو، تحقیقات بازار، گردآوری آگهیها و رساندن صفحههای وب به سیستمهای هوش مصنوعی به شکل متن تمیز است.
آیا API وب اسکرپینگ همان پروکسی است؟
نه. پروکسی فقط درخواستهای شما را از راه یک آدرس IP دیگر منتقل میکند و دریافت، رندر، تلاش دوباره و تجزیه همچنان با کد شماست. API وب اسکرپینگ همه این کارها را انجام میدهد و صفحه یا فیلدهای نهایی را برمیگرداند.
آیا scraper API از ساختن اسکرپر خودتان بهتر است؟
برای سایتهای زیاد و یک تیم کوچک، معمولاً بله: زودتر راه میافتد و به زیرساختی نیاز ندارد. برای حجم بسیار بالا از چند سایت، اسکرپر خودتان با پروکسی معمولاً هزینه کمتری بهازای هر صفحه دارد و کنترل کامل را به شما میدهد.
آیا API وب اسکرپینگ میتواند سایتهای JavaScript را اسکرپ کند؟
بله، اگر رندر ارائه کند: صفحه را در یک مرورگر headless باز میکند و محتوای نهایی را برمیگرداند. درخواستهای رندرشده کندترند و اغلب گرانتر، پس اول بررسی کنید که آیا داده از قبل در HTML ساده هست یا نه.
هزینه API وب اسکرپینگ چقدر است؟
مدل قیمتگذاری بیش از قیمت اعلامشده تعیینکننده است. سرویسها بهازای هر درخواست، بهازای هر درخواست موفق یا با اعتبار هزینه میگیرند و رندر یا IPهای مسکونی اغلب هزینه یک صفحه را چند برابر میکنند. هزینه هر 1,000 صفحه قابل استفاده را روی هدفهای خودتان مقایسه کنید.
آیا استفاده از API وب اسکرپینگ قانونی است؟
مسئله قانونی خود استفاده از سرویس نیست، بلکه چیزی است که با آن جمع میکنید. شرایط استفاده سایت هدف، فایل robots.txt آن و قانون حفاظت از داده طوری شامل حال شما میشوند که انگار صفحهها را خودتان اسکرپ کردهاید. برای یک پروژه مشخص، از یک وکیل در حوزه قضایی خودتان بپرسید.
خلاصه
API وب اسکرپینگ همان اسکرپینگ است که به شکل سرویس فروخته میشود: آدرسهای IP، رندر، تلاش دوباره، تشخیص مسدودی و تجزیه را بر عهده میگیرد و HTML، JSON یا Markdown برمیگرداند. برای سایتهای زیاد و تیمهای کوچک راه سریع است؛ برای حجم بزرگ و پیوسته از چند سایت، اسکرپر خودتان با پروکسی ارزانتر است. بررسی کنید چه چیزی بهعنوان موفقیت هزینهدار شمرده میشود و آنچه را برمیگردد اعتبارسنجی کنید. برای گفتوگو درباره Web Scraper API ما، با تیم فروش ما تماس بگیرید.