Eine Marketingmanagerin fügt fünfzig Kundenbewertungen in ein Chatfenster ein und fragt nach den drei häufigsten Beschwerden. Ein Entwickler bittet um einen regulären Ausdruck, der Bestellnummern erkennt. Eine Studentin fragt, warum der Himmel blau ist. Alle drei erhalten innerhalb von Sekunden eine flüssige Antwort von derselben Art Software: einem großen Sprachmodell (Large Language Model, LLM), das seine Antwort aus kleinen Textstücken zusammensetzt, eines nach dem anderen.
Dieser Beitrag erklärt, was ein LLM ist und was „groß“ dabei bedeutet, wie es aus einem Prompt eine Antwort macht, wie und mit welchen Daten es trainiert wird, worin es sich von einem Chatbot, einem KI-Agenten und einer Suchmaschine unterscheidet, wo es versagt und wie sich Open-Weight-Modelle von geschlossenen Modellen unterscheiden.
Was ist ein großes Sprachmodell?
Ein großes Sprachmodell ist ein neuronales Netz, das mit einer sehr großen Textsammlung darauf trainiert wird, das jeweils nächste Textstück vorherzusagen, und es nutzt diese eine Fähigkeit, um zu schreiben, zusammenzufassen, zu übersetzen, Fragen zu beantworten und Code zu erzeugen. Ein Sprachmodell im Allgemeinen ist jedes Modell, das Wortfolgen Wahrscheinlichkeiten zuordnet; die Wortvorschläge einer Smartphone-Tastatur beruhen auf einer ähnlichen Idee in winzigem Maßstab.
„Groß“ hat zwei Bedeutungen. Die erste ist die Zahl der Parameter. Ein Parameter ist eine einzelne Zahl im Modell, ein Gewicht, das beim Training immer wieder angepasst wird, bis die Vorhersagen des Modells besser werden; alles, was das Modell gelernt hat, steckt in diesen Zahlen. Die zweite ist die Menge an Trainingstext. GPT-3, 2020 von Forschenden bei OpenAI beschrieben, hatte 175 Milliarden Parameter, nach Angabe der Autoren zehnmal so viele wie jedes frühere nicht spärliche (non-sparse) Sprachmodell, und wurde mit 300 Milliarden Tokens trainiert.
Ein LLM enthält keine Faktendatenbank, in der es nachschlägt. Was es „weiß“, existiert nur als Muster, die über seine Parameter verteilt sind. Deshalb kann es ein Konzept gut erklären und trotzdem ein Datum, einen Preis oder ein Zitat falsch wiedergeben.
Wie funktioniert ein LLM?
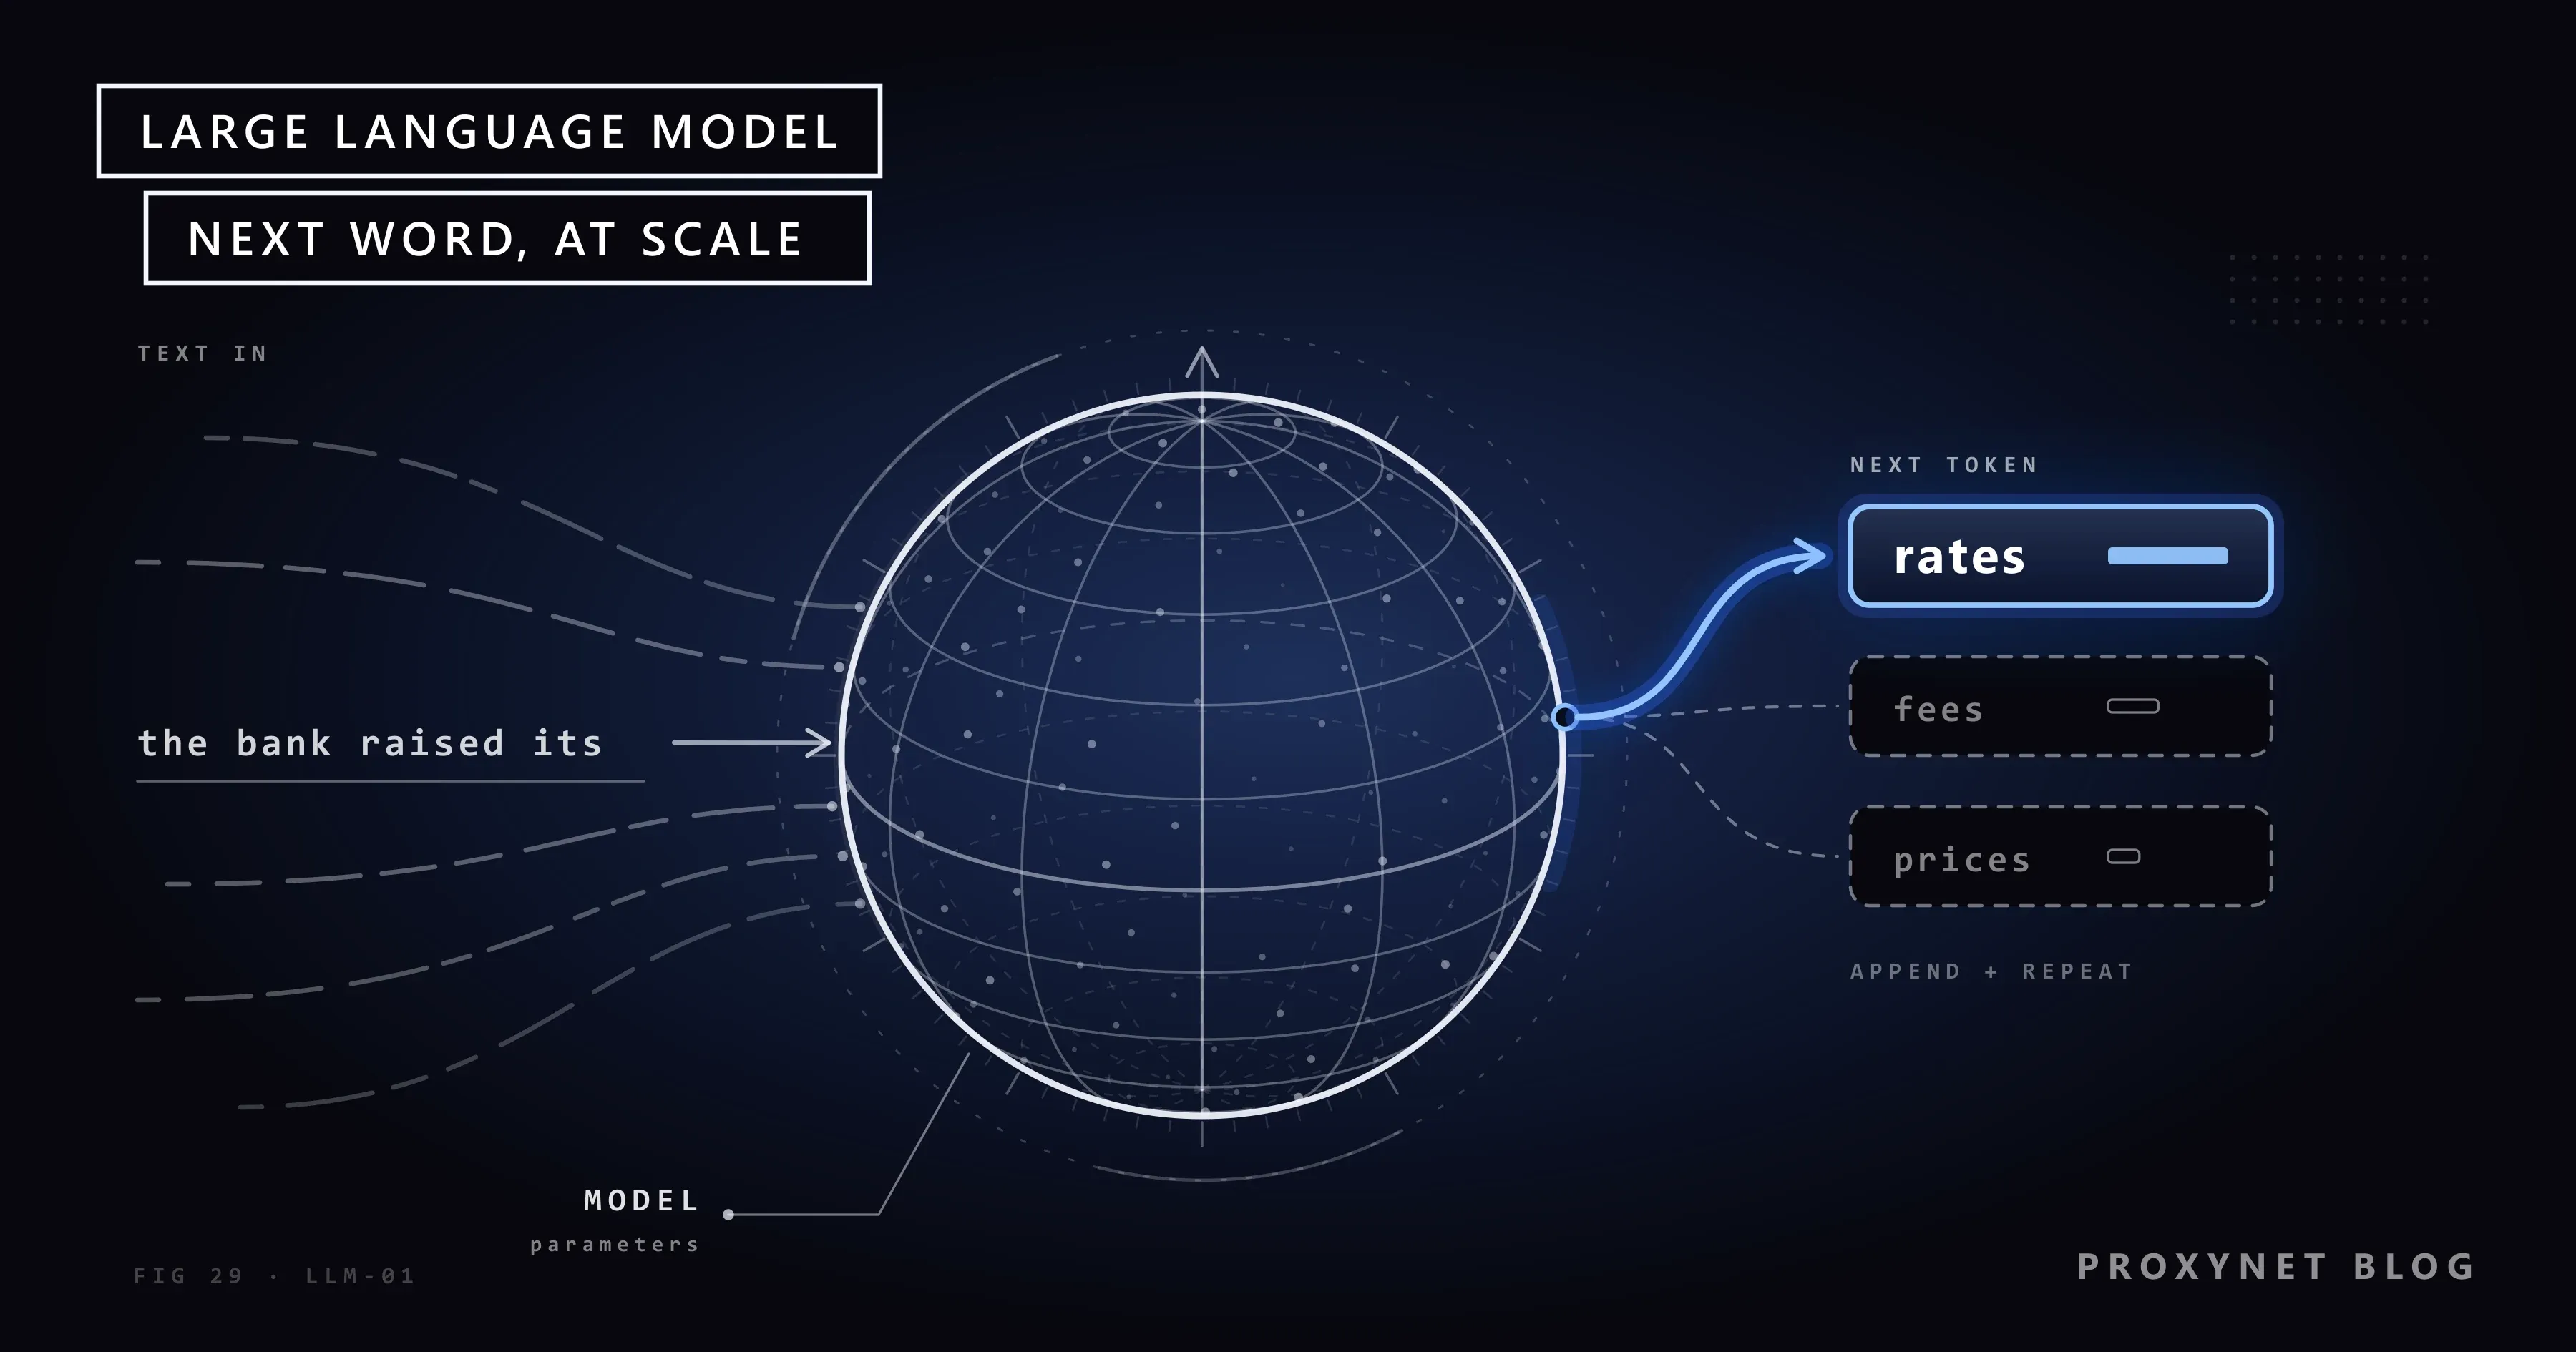
Ein LLM erzeugt Text Token für Token: Es wandelt Ihre Wörter in Zahlen um, schickt sie durch viele Schichten, die ermitteln, wie die Wörter zueinander stehen, bewertet jedes mögliche nächste Token, wählt eines aus, hängt es an den Text an und wiederholt den Vorgang. Der Reihe nach:
- Text in Tokens zerlegen. Ein Token ist ein Wort oder ein Wortteil; ein häufiges Wort ist oft ein einziges Token, ein seltenes wird in mehrere Stücke geschnitten. Was sind Tokens in der KI? zeigt, wie die Zerlegung funktioniert und warum sie Kosten und Grenzen bestimmt.
- Jedes Token in Zahlen umwandeln. Jedes Token wird einer langen Zahlenliste zugeordnet, einem Vektor, der es in einem Raum platziert, in dem ähnlich verwendete Wörter nah beieinanderliegen.
- Die Vektoren durch Transformer-Schichten schicken. Die meisten heutigen LLMs beruhen auf dem Transformer, der Architektur, die 2017 im Paper Attention Is All You Need vorgestellt wurde. Ihr Kern ist Attention (Aufmerksamkeit): Jedes Token betrachtet die anderen Tokens im Text und gewichtet, welche für seine Bedeutung zählen. In „Die Bank erhöhte ihre Zinsen“ verrät „Zinsen“ dem Modell, dass mit „Bank“ ein Kreditinstitut gemeint ist und keine Sitzbank.
- Jedes mögliche nächste Token bewerten. Die letzte Schicht gibt für jedes Token im Vokabular des Modells eine Wahrscheinlichkeit aus, also für jeden Eintrag der festen Liste von Tokens, die es kennt.
- Eines auswählen. Das Modell nimmt das wahrscheinlichste Token oder zieht eines zufällig aus den wahrscheinlichen. Eine Einstellung namens Temperatur (Temperature) legt fest, wie viel Zufall erlaubt ist; deshalb kann dieselbe Frage zwei unterschiedlich formulierte Antworten bekommen.
- Anhängen und wiederholen. Das gewählte Token wird an den Text angehängt, und die ganze Schleife läuft erneut, bis das Modell ein Stopp-Token erzeugt oder seine Längengrenze erreicht.
Diese Schleife erklärt die Stärken des Modells und seine Schwachstellen. Es schreibt flüssige, gut gegliederte Texte, weil es genau darauf trainiert wurde, flüssigen Text fortzusetzen. Es hält nicht inne, um zu prüfen, ob ein Satz stimmt, denn kein Schritt der Schleife stellt diese Frage.
Wie wird ein LLM trainiert?
Ein LLM wird in Stufen trainiert: Das Vortraining auf einem riesigen Textkorpus bringt ihm Sprache und Allgemeinwissen bei, danach lernt es durch Instruction Tuning und Präferenz-Tuning, Anfragen zu befolgen und die Art von Antworten zu geben, die Menschen erwarten.
Das Vortraining (Pretraining) ist selbstüberwacht (self-supervised): Der Text liefert die Lösungen selbst. Das Modell liest eine Passage, rät das nächste Token, vergleicht seinen Tipp mit dem tatsächlichen und passt seine Parameter leicht an, damit das richtige Token wahrscheinlicher wird. Über Hunderte Milliarden Tokens wiederholt, beansprucht diese Stufe den größten Teil der Rechenarbeit. Das Ergebnis ist ein Basismodell (Base Model): Es setzt Text gut fort, schreibt auf eine Frage aber womöglich einfach weitere Fragen.
Instruction Tuning trainiert das Basismodell weiter mit Beispielen, in denen Prompts mit guten Antworten gepaart sind, oft von Menschen geschrieben. Man spricht auch von überwachtem Fine-Tuning (Supervised Fine-Tuning), und es macht aus einem Textfortsetzer einen Assistenten, der antwortet.
Präferenz-Tuning arbeitet mit Rangfolgen statt mit geschriebenen Antworten. Menschen vergleichen mehrere Antworten auf denselben Prompt und markieren die besseren, ein separates Belohnungsmodell (Reward Model) lernt aus diesen Rangfolgen, und bestärkendes Lernen schiebt das LLM in Richtung gut bewerteter Antworten. Das nennt sich bestärkendes Lernen aus menschlichem Feedback (RLHF). Im InstructGPT-Paper von 2022 zogen menschliche Bewerter die Antworten eines so abgestimmten Modells mit 1,3 Milliarden Parametern denen des 175 Milliarden Parameter großen GPT-3 vor; Größe allein macht ein Modell also nicht nützlich.
Unternehmen können eine kleinere Version der zweiten Stufe mit eigenen Beispielen wiederholen, um einem Modell ein Format, einen Tonfall oder eine eng umrissene Aufgabe beizubringen. Wie das funktioniert und wann es einen gut geschriebenen Prompt übertrifft, erklärt Was ist Fine-Tuning?
Woher stammen die Trainingsdaten?
Der Großteil des Vortrainingstexts stammt von öffentlichen Webseiten, ergänzt um Bücher, Code, Enzyklopädien und andere kuratierte oder lizenzierte Quellen, nach Qualität gefiltert und von Duplikaten bereinigt. Das GPT-3-Paper gehört zu den klarsten öffentlichen Beschreibungen eines Trainingsmixes: 60 % der im Training gesehenen Beispiele stammten aus einer gefilterten Kopie von Common Crawl, der Rest aus einem Webtext-Datensatz, zwei Büchersammlungen und der englischsprachigen Wikipedia.
Common Crawl ist ein Archiv von Webseiten, das sich selbst als freies, offenes Repository von Web-Crawl-Daten beschreibt, das jeder nutzen kann. Die GPT-3-Autoren haben es nicht roh verwendet: Sie behielten die Seiten, die hochwertigen Referenztexten am ähnlichsten waren, und entfernten Beinahe-Duplikate, weil ungefilterte Crawl-Daten die Qualität senkten.
Auch nach dem Vortraining spielen Webdaten eine Rolle. Teams stimmen Modelle mit Beispielen aus ihrem Fachgebiet ab und bauen Testsätze, die prüfen, ob ein Assistent Preise, Produkte oder Regeln in verschiedenen Märkten richtig wiedergibt. Viele Produkte nutzen außerdem RAG (Retrieval-Augmented Generation, abrufgestützte Generierung): Die Anwendung holt zum Zeitpunkt der Frage passende Seiten und gibt sie dem Modell zusammen mit der Frage.
Diese Seiten unterscheiden sich oft von Land zu Land, sodass eine Prüfung aus einem einzigen Büro nur eine Version sieht. Ein Residential-Proxy leitet jede Anfrage über einen privaten Internetanschluss in dem Land und der Stadt Ihrer Wahl, sodass Sie die öffentliche Seite so erfassen, wie ein lokaler Besucher sie sieht.
Für Teams, die öffentliche Seiten aus vielen Ländern in großem Umfang brauchen, beschreibt unsere Seite zu Data-Scraping-Lösungen die Proxy-Pools für Erhebungsaufträge, und unser Vertriebsteam spricht mit Ihnen über die verwaltete Seitenextraktion. Welchen Weg Sie auch wählen: Erheben Sie nur öffentliche Seiten, beachten Sie robots.txt und die Nutzungsbedingungen der Website, halten Sie die Anfragerate niedrig, nutzen Sie eine offizielle API, wo es eine gibt, und lassen Sie personenbezogene Daten weg, die Sie nicht brauchen.
Was unterscheidet ein LLM von einem Chatbot, einem KI-Agenten und einer Suchmaschine?
Ein LLM ist das Modell selbst; ein Chatbot ist eine Anwendung, die um ein Modell herum gebaut ist; ein KI-Agent ist ein System, das ein Modell Werkzeuge nutzen und Schritt für Schritt auf ein Ziel hinarbeiten lässt; eine Suchmaschine findet und ordnet Seiten, die es bereits gibt.
| Begriff | Was es ist | Was es tut | Beispiel |
|---|---|---|---|
| LLM | Ein trainiertes Modell | Sagt das nächste Token vorher | gpt-oss-20b |
| Chatbot | Eine App auf Basis eines Modells | Führt ein Gespräch | ChatGPT, ein Helpdesk-Bot |
| KI-Agent | Modell plus Werkzeuge und Schleife | Plant und handelt in Schritten | Ein Agent für Reisebuchungen |
| Suchmaschine | Ein Index von Webseiten | Findet und ordnet Seiten | Google Suche |
Im Alltag verschwimmen die Grenzen: Chatbots fragen vor der Antwort eine Suchmaschine ab, Suchmaschinen zeigen von KI geschriebene Zusammenfassungen, und Agenten laufen auf denselben Modellen. Die Unterscheidung hilft trotzdem, wenn etwas schiefgeht, denn ein falscher Fakt kommt meist vom Modell, eine fehlende Quelle vom Abrufschritt und eine falsche Aktion von den Werkzeugen des Agenten.
Wo liegen die Grenzen von LLMs?
Ein LLM erzeugt wahrscheinlichen Text, keinen geprüften Text, und die meisten seiner Grenzen folgen daraus:
- Halluzination. Das Modell kann falsche Fakten behaupten, Quellen erfinden oder ein Dokument falsch zitieren, und das mit voller Überzeugung; Was sind KI-Halluzinationen? erklärt, warum das passiert und wie Sie es verringern.
- Wissensstichtag. Seine Trainingsdaten enden an einem bestimmten Datum, daher weiß es ohne Suchwerkzeug nichts über spätere Ereignisse, Preise oder Gesetze.
- Kontextfenster. Das Modell kann nur eine begrenzte Zahl von Tokens gleichzeitig berücksichtigen, Ihren Prompt, eingefügte Dokumente und seine eigene Antwort eingerechnet; was darüber hinausgeht, muss gekürzt oder zusammengefasst werden.
- Kosten pro Token. API-Anbieter rechnen nach Tokens ab, meist mit getrennten Preisen für Eingabe und Ausgabe, deshalb kosten lange Dokumente und lange Antworten mehr.
- Verzerrung (Bias). Muster in den Trainingsdaten, darunter Stereotype und das Übergewicht einiger Sprachen, gehen in die Antworten über.
- Datenschutz. Text, den Sie in ein KI-Werkzeug einfügen, geht an dessen Anbieter; Kunden- oder Mitarbeiterdaten in einem Prompt gelten nach der Datenschutz-Grundverordnung (DSGVO) in der EU und nach dem Gesetz Nr. 6698 über den Schutz personenbezogener Daten (KVKK) in Türkiye als personenbezogene Daten. Prüfen Sie deshalb zuerst die Bedingungen des Anbieters.
Was unterscheidet Open-Weight-Modelle von geschlossenen Modellen?
Bei einem Open-Weight-Modell sind die Parameter veröffentlicht, sodass jeder es herunterladen, auf eigener Hardware betreiben und im Rahmen der Lizenz per Fine-Tuning anpassen kann; ein geschlossenes Modell ist nur über die App oder API des Anbieters verfügbar. Die gpt-oss-Modelle von OpenAI, unter der Lizenz Apache 2.0 veröffentlicht, sind ein Beispiel für die erste Art, und Mistral veröffentlicht sowohl Open-Weight- als auch kommerzielle Modelle.
Open-Weight ist nicht dasselbe wie Open Source. Die Gewichte können frei nutzbar sein, während Trainingsdaten und Trainingscode privat bleiben, und die Lizenzen reichen von großzügig bis restriktiv. In der Praxis wägen Sie Kontrolle gegen Bequemlichkeit ab: Ein Modell auf Ihren eigenen Servern hält die Daten im Haus und lässt sich frei verändern, ein geschlossenes Modell braucht keine Hardware und wird vom Anbieter aktualisiert.
Zwei weitere Begriffe tauchen oft neben LLM auf. Ein Mixture-of-Experts-Modell (MoE) teilt einige Schichten in viele kleinere Teilnetze auf und schickt jedes Token nur an wenige davon, sodass ein sehr großes Modell pro Token weniger Arbeit leistet. Ein multimodales Modell nimmt mehr als Text entgegen oder erzeugt mehr als Text, etwa Bilder und Audio, und zwar im selben Modell.
Wofür werden LLMs eingesetzt?
LLMs werden überall eingesetzt, wo Arbeit mit Text beginnt oder endet. Im Büro entwerfen sie E-Mails, Berichte und Produktbeschreibungen und fassen lange Dokumente, Besprechungsnotizen und Support-Tickets zusammen. Kundenservice-Teams beantworten damit Routinefragen und leiten den Rest an einen Menschen weiter, Übersetzer nutzen sie für erste Entwürfe, und Marketingteams sortieren damit offene Umfrageantworten nach Themen.
Entwickler lassen sich damit Code schreiben und erklären und Anfragen in Alltagssprache in Datenbankabfragen übersetzen. Analysten ziehen damit Namen, Datumsangaben und Beträge aus unstrukturiertem Text. Suchprodukte schreiben damit Antworten auf Grundlage abgerufener Seiten, und Agenten nutzen sie als den Teil, der über den nächsten Schritt entscheidet.
Häufige Fehler
- Die Antwort für einen Fakt halten. Flüssigkeit ist kein Beleg; prüfen Sie Namen, Zahlen, Datumsangaben und Zitate an einer Primärquelle.
- Ohne Suchwerkzeug nach aktuellen Ereignissen fragen. Ein Modell ohne Abruf antwortet aus seinen Trainingsdaten und sagt womöglich nicht, dass diese veraltet sind.
- Vertrauliche oder personenbezogene Daten einfügen, ohne die Bedingungen zu prüfen. Lesen Sie die Datenrichtlinie des Anbieters und entfernen Sie, was die Aufgabe nicht braucht.
- Ein Modell nur nach der Parameterzahl auswählen. Tuning, Trainingsdaten und die Aufgabe selbst zählen ebenso viel wie die Größe.
- Jedes Mal dieselbe Antwort erwarten. Durch das Sampling variieren die Ausgaben; legen Sie das Format stattdessen mit klaren Anweisungen und Beispielen fest.
- Exakte Berechnungen oder Zählungen als Fließtext verlangen. Geben Sie dem Modell einen Rechner oder ein Code-Werkzeug, oder prüfen Sie die Rechnung selbst.
Entscheidungshilfe
| Bedarf | Lösung |
|---|---|
| Text entwerfen, umschreiben oder zusammenfassen | Ein Chat-Assistent, danach das Ergebnis überarbeiten |
| Antworten zu aktuellen Ereignissen oder Preisen | Ein Modell mit Websuche, das Quellen zeigt |
| Antworten aus Ihren eigenen Dokumenten | Abruf über diese Dokumente (RAG) |
| Eine eng umrissene Aufgabe in festem Format | Zuerst bessere Prompts, Fine-Tuning erst, wenn sie nicht reichen |
| Daten, die auf Ihren Servern bleiben müssen | Ein Open-Weight-Modell, das Sie selbst hosten |
| Breite Aufgaben ohne eigene Hardware | Ein geschlossenes Modell per App oder API |
| Rechtliche, medizinische oder finanzielle Fakten | Primärquellen; das LLM nur für Entwürfe |
Häufige Fragen
Ist ChatGPT ein LLM?
Nicht genau: ChatGPT ist ein Chatbot, also eine Anwendung, und die Motoren dahinter sind die großen Sprachmodelle der GPT-Reihe von OpenAI. Die App ergänzt, was dem Modell allein fehlt, etwa die Chat-Oberfläche, den Gesprächsverlauf, Sicherheitsebenen und Werkzeuge.
Was ist der Unterschied zwischen einem LLM und generativer KI?
Generative KI ist die breite Kategorie von KI, die neue Inhalte erzeugt, ob Text, Bilder, Audio, Video oder Code, und ein LLM ist der Teil dieser Kategorie, der mit Sprache arbeitet. Bildgeneratoren sind generative KI, aber keine LLMs. Viele neuere LLMs lesen auch Bilder oder Audio, was die Grenze verwischt.
Wofür steht LLM?
In der KI steht LLM für Large Language Model, auf Deutsch großes Sprachmodell. Dieselben Buchstaben, als LL.M. geschrieben, stehen außerdem für Master of Laws, einen weiterführenden juristischen Masterabschluss, der nichts mit KI zu tun hat.
Wie wird ein LLM trainiert?
In drei groben Stufen. Das Vortraining bringt ihm bei, in einer sehr großen Textmenge das nächste Token vorherzusagen, Instruction Tuning trainiert es mit Beispielen guter Antworten, und Präferenz-Tuning nutzt die Rangfolgen, in die Menschen Antworten bringen, oft per RLHF, damit seine Antworten hilfreicher werden.
Kann ein LLM im Internet surfen?
Nicht von sich aus: Das Modell kennt nur seine Trainingsdaten und das, was im Prompt steht. Eine Anwendung oder API kann ihm ein Websuche-Werkzeug geben. Die Dokumentation von Anthropic beschreibt zum Beispiel ein Werkzeug, das Entwickler einer Anfrage hinzufügen, damit das Modell mit aktuellen Informationen jenseits seines Wissensstichtags antworten kann, mit Quellenangaben zu den genutzten Seiten. Das Modell liest dann Ergebnisse, die eine Software für es abgerufen hat; das Durchklicken von Seiten, wie es ein Mensch tut, ergänzen erst KI-Agenten und KI-Browser.
Versteht ein LLM, was es sagt?
Darauf gibt es keine abschließende Antwort. Ein LLM lernt die statistischen Muster von Text, und die Forschenden Emily Bender und Alexander Koller argumentierten in einem ACL-Paper von 2020, dass ein System, das nur mit der Form von Sprache trainiert wird, keinen Weg hat, ihre Bedeutung zu lernen. Andere halten dagegen, dass eine so gute Textvorhersage eine gewisse innere Repräsentation von Bedeutung erfordert. So oder so ist die praktische Folge dieselbe: Das Modell hat keine eingebaute Prüfung, ob das, was es sagt, auch stimmt.
Fazit
Ein großes Sprachmodell ist ein neuronales Netz, das mit einer sehr großen Textmenge darauf trainiert wird, das nächste Token vorherzusagen, und es baut jede Antwort auf, indem es diese Vorhersage wiederholt. Vortrainiert wird es vor allem mit öffentlichen Webseiten, Büchern und Code, danach wird es mit Beispielen und menschlichen Rangfolgen so abgestimmt, dass es Anweisungen befolgt. Das macht es stark beim Entwerfen, Zusammenfassen, Übersetzen und Programmieren und unzuverlässig als Faktenquelle: Es kann halluzinieren, es lernt nach seinem Wissensstichtag nichts mehr dazu, und es sieht nur, was in sein Kontextfenster passt. Nutzen Sie es für schnelle erste Entwürfe, stützen Sie es auf aktuelle Quellen, wenn Fakten zählen, und lassen Sie bei allem, was stimmen muss, einen Menschen gegenprüfen.