Bir çevrim içi mağaza bir parti teslimatı geciktiriyor ve pazartesi sabahına kadar destek kutusunda 3.000 yeni e-posta birikiyor. Hiç kimse hepsini okumuyor. Önce bir yazılım ayıklıyor: şunlar para iadesi istiyor, şunlar ezik kutudan söz ediyor, şunlar kıdemli bir temsilciye gidecek kadar öfkeli. Yazılım metni bir insan gibi "okumuyor", ama serbest yazılmış metni ekibin üzerinde işlem yapabileceği etiketlere dönüştürüyor. Buna doğal dil işleme (NLP, natural language processing) denir.
Bu yazıda NLP'nin ne olduğunu, elle yazılan kurallardan transformer modellerine nasıl geliştiğini, bir sistemin metni nasıl anlama dönüştürdüğünü, başlıca görevlerini, NLU, NLG ve büyük dil modellerinden farkını, dilin bilgisayar için neden zor olduğunu ve şirketlerin onu nerede kullandığını anlatıyoruz.
Doğal dil işleme nedir?
Doğal dil işleme, bilgisayarlara insan dilini çözümlemeyi, anlamayı ve üretmeyi öğreten alandır. "Doğal" sözcüğü, insanların konuştuğu ve yazdığı Türkçe, İngilizce ya da İspanyolca gibi dilleri, bilgisayarlar için tasarlanmış Python ya da SQL gibi biçimsel dillerden ayırır. Biçimsel dillerin kuralları katıdır ve belirsizlik içermez.
NLP, bilgisayar bilimi, yapay zekâ ve dilbilimin kesiştiği yerde durur. Dilbilim dilin nasıl kurulduğunu anlatır: kelimeler, dil bilgisi, anlam ve bağlam. Bilgisayar bilimi ve makine öğrenmesi ise bir programın bu örüntüleri, her kural tek tek söylenmeden örneklerden öğrenmesini sağlayan yöntemleri getirir.
Çoğu insan NLP'yi adını anmadan günde birçok kez kullanır. Sıradaki kelimeyi öneren telefon klavyesi, yabancı dildeki bir paylaşımın altındaki çeviri düğmesi ve "mayısta Roma'ya ucuz uçuş" sorusunu anlayan arama kutusu bunun üzerinde çalışır.
NLP nasıl gelişti?
NLP dört büyük aşamadan geçti: elle yazılan kurallar, metinden öğrenilen istatistik, sinir ağları ve 2017'den beri çok büyük metin miktarlarıyla önceden eğitilen transformer modelleri.
Kurallar (1950'lerden 1980'lere). Ocak 1954'te IBM ve Georgetown Üniversitesi, Rusça cümleleri İngilizceye çeviren bir sistemi kamuya açık biçimde tanıttı. W. John Hutchins'in Georgetown-IBM deneyi üzerine yazdığı tarihçeye göre sistem yalnızca 250 kelime ve altı dil bilgisi kuralıyla çalışıyordu; buna karşın yüksek kaliteli makine çevirisinin birkaç yıl içinde mümkün olacağı beklentisini doğurdu. 1966'da Joseph Weizenbaum, MIT'de geliştirdiği ELIZA'yı tanıttı. Program cümleleri anahtar kelimelerin tetiklediği ayrıştırma kurallarıyla çözümlüyor, cevabını da bunlara bağlı yeniden kurma kurallarıyla yazıyordu. Bu sistemler ancak kuralları kadar iyiydi ve her yeni söyleyiş biçimi için yeni bir kural gerekiyordu.
İstatistik (1980'lerin sonundan 2000'lere). Araştırmacılar kural yazmak yerine programların büyük metin koleksiyonlarındaki örüntüleri saymasına izin verdi. IBM'in T.J. Watson Araştırma Merkezi'nden bir ekip 1993'te beş istatistiksel çeviri modeli yayımladı. Modeller, Kanada Parlamentosu tutanaklarından alınan Fransızca ve İngilizce cümle çiftlerinden öğreniliyordu. Yazarlar algoritmalarının dilbilimsel içeriğinin çok az olduğunu belirtiyordu: bilgi dil bilgisi kitaplarından değil, veriden geliyordu.
Sinir ağları (2010'lar). 2013'te Google'dan Tomas Mikolov ve arkadaşları word2vec'i tanıttı. Bu yöntem her kelimeyi çok büyük metin koleksiyonlarından öğrenilen bir sayı listesine hızla çeviriyor, benzer biçimde kullanılan kelimeleri birbirine yakın konumlandırıyordu. Sonraki yıllarda kelime vektörleri üzerine kurulan sinir ağları çeviri, etiketleme ve sınıflandırmada standart yaklaşım hâline geldi.
Transformer'lar (2017 ve sonrası). Attention Is All You Need makalesinde tanıtılan ve ilk olarak çeviri üzerinde denenen transformer mimarisi, eski sinir ağlarının metni adım adım okuma yöntemini bırakır ve her kelimenin aynı anda diğer bütün kelimelere bakmasını sağlar.
2018'de Google araştırmacıları BERT modelini yayımladı: etiketsiz metinle önceden eğitilen, ardından tek bir ek çıktı katmanıyla ince ayar yapılan bu transformer, on bir NLP görevinde en iyi sonuçları yeniledi. Bugünkü büyük dil modelleri de aynı mimariden doğdu.
NLP nasıl çalışır?
Bir NLP sistemi ham metni adım adım bir modelin işleyebileceği sayılara çevirir, ardından bir modelle etiket, yapı ya da yeni metin üretir. Klasik işlem hattı şöyledir:
- Temizleme ve bölme. Metin biçimlendirme kodlarından arındırılır, cümlelere ve kelimelere bölünür. Kulağa basit gelse de değildir: bir nokta cümleyi bitirebilir, bir kısaltmayı kapatabilir ya da bir sayının içinde durabilir.
- Token'lara ayırma. Metin, modelin okuduğu birimler olan token'lara kesilir. Eski sistemler bütün kelimeleri kullanırdı; bugünkü modeller kelime parçalarını kullanır, böylece nadir ya da yeni bir kelime de temsil edilebilir. Bu bölmenin nasıl yapıldığını Token Nedir? yazısında anlattık.
- Normalleştirme. Bir kelimenin farklı biçimleri tek biçime indirilir: "geldi", "geliyor" ve "gelecek", sözlükte arayacağınız biçime, yani lemmaya ("gelmek") indirgenir.
- Etiketleme. Sözcük türü etiketleme (part-of-speech tagging) her kelimeyi isim, fiil, sıfat gibi türlere ayırır. "Yüz" kelimesinin "yüz kişi"de sayı, "yüzünü yıka"da isim, "denizde yüz"de fiil olduğunu bu adım ayırt eder.
- Çözümleme. Bağlılık çözümlemesi (dependency parsing) kelimelerin birbiriyle ilişkisini, yani kimin kime ne yaptığını çıkarır. "Kurye paketi komşuya bıraktı" cümlesinde "bıraktı" fiilini öznesi "kurye"ye ve nesnesi "paket"e bağlar.
- Vektörle temsil. Her kelime, cümle ya da belge bir embedding'e (vektör temsili) dönüşür: onu benzer anlamların birbirine yakın durduğu bir uzaya yerleştiren uzun bir sayı listesi.
- Görev modelini çalıştırma. Bir sınıflandırıcı, dizi etiketleyici ya da metin üretici bu vektörlerden sonucu üretir: bir kategori, etiketlenmiş adlar, bir çeviri ya da bir özet.
Bugünkü transformer modelleri bu adımların çoğunu etiketlemeyi, yapıyı ve anlamı kendi içinde öğrenen tek bir ağda birleştirir. İşlem hattını bilmek yine de işe yarar, çünkü bir NLP sistemi hata yaptığında neden çoğu zaman erken adımlardan birindedir.
Test makinemizde Node.js'in yerleşik cümle bölücüsünü (ICU kütüphanesini kullanan Intl.Segmenter) İngilizce "Dr. Smith ordered 2.5 kg at 9 a.m. It arrived late." cümlesi üzerinde çalıştırdık. Bölücü "2.5" ve "a.m." ifadelerini doğru ele aldı, ama "Dr." kısaltmasını ayrı bir cümle sayarak iki yerine üç cümle döndürdü. Bu tür küçük hatalar işlem hattı boyunca ilerler ve sonraki adımlarda yanlış etiketlere dönüşür.
NLP'nin başlıca görevleri nelerdir?
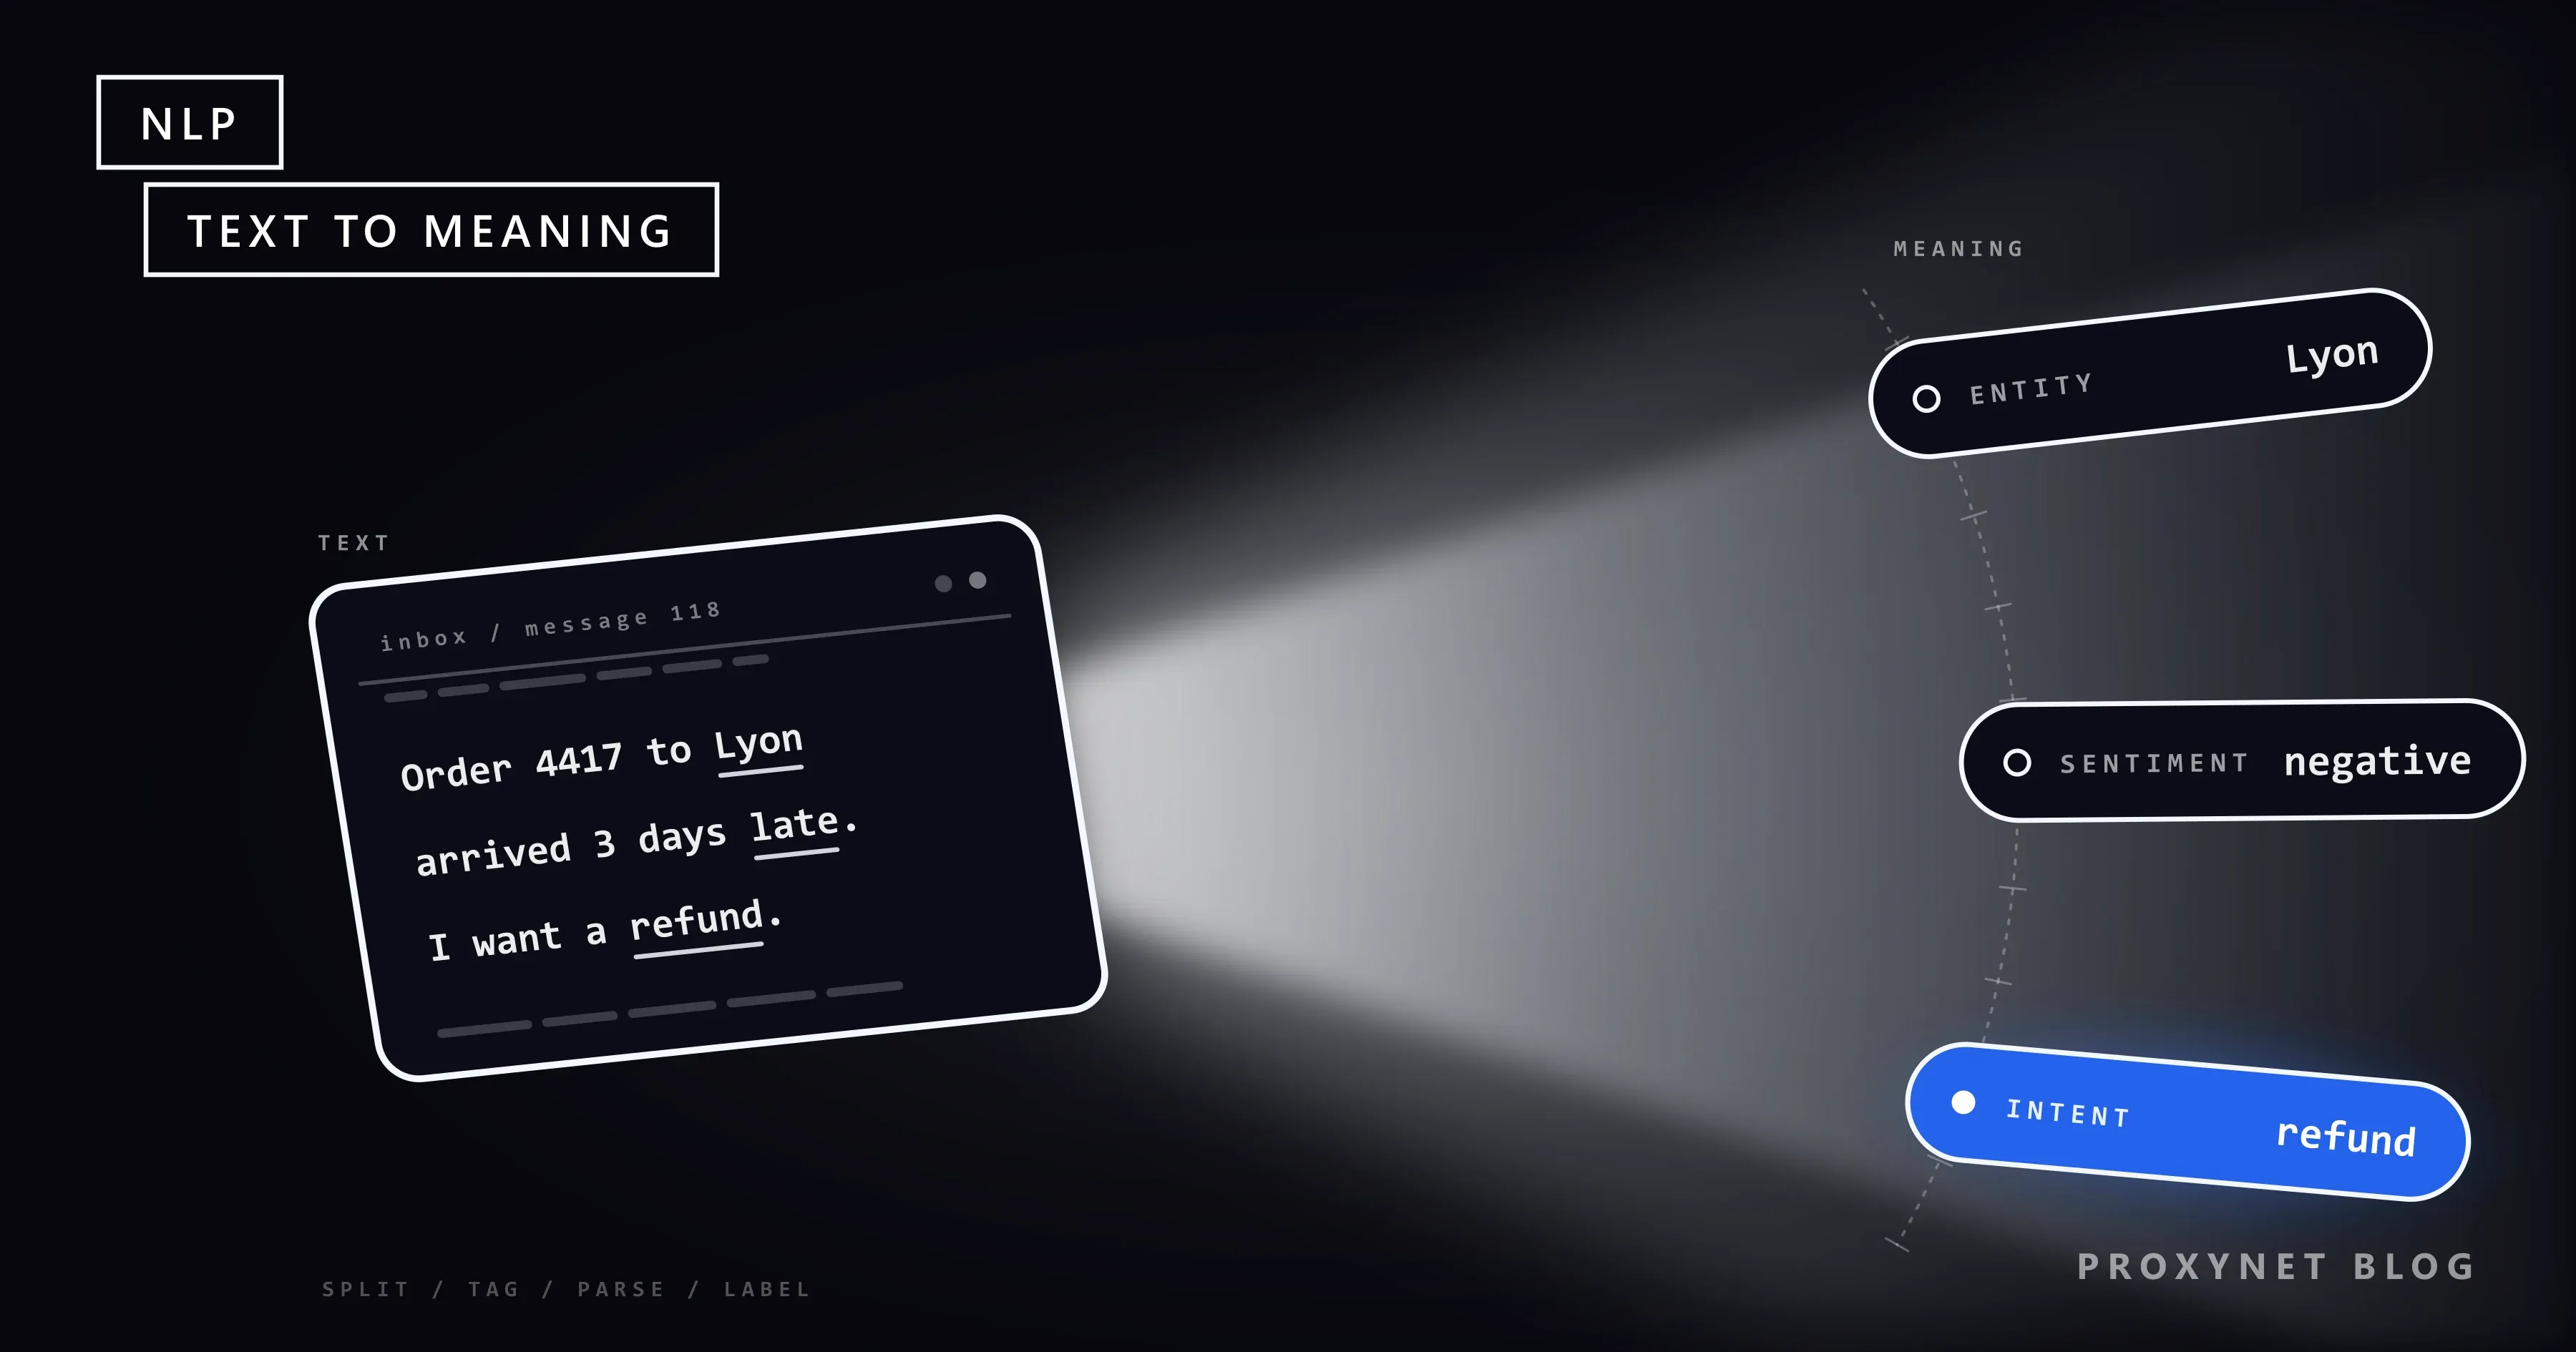
NLP işlerinin çoğu, her biri metne farklı bir soru soran birkaç göreve ayrılır. Tek bir müşteri mesajını ele alalım: "4417 numaralı siparişim Lyon'a üç gün geç geldi, kutu da ezilmişti; paramı geri istiyorum."
- Metin sınıflandırma mesajın tamamını bir kategoriye koyar: teslimat şikâyeti. Spam filtreleme ve konuya göre ayırma da aynı görevdir.
- Duygu analizi tonun olumlu, nötr ya da olumsuz olduğuna karar verir: burada açıkça olumsuz. Python ile Duygu Analizi yazısı ürün yorumlarını puanlamanın iki yolunu karşılaştırıyor.
- Adlandırılmış varlık tanıma (NER, named entity recognition) metindeki adları bulup etiketler: "Lyon" konum, "4417" sipariş numarası, "üç gün" süre.
- Niyet tespiti yazanın ne istediğini çıkarır: para iadesi. Sohbet botları ve sesli asistanlar buna dayanır.
- Bilgi çıkarma serbest metinden sipariş numarası, sorun türü ve istenen işlem gibi alanları doldurarak veritabanına hazır bir kayıt oluşturur.
- Makine çevirisi mesajı yurt dışındaki bir destek ekibi için başka bir dile aktarır.
- Özetleme uzun metni kısaltır: ya önemli cümleleri seçerek (çıkarımsal) ya da yeni ve daha kısa bir metin yazarak (soyutlayıcı).
- Soru cevaplama bir belgeden ya da bilgi tabanından bir sorunun cevabını bulur veya yazar.
Konuşma, işin iki ucuna iki görev daha ekler: konuşma tanıma, NLP başlamadan önce sesi metne çevirir; metinden sese dönüştürme ise çıktıyı yeniden sese çevirir.
NLP, NLU, NLG ve LLM arasındaki fark nedir?
NLP alanın bütünüdür; doğal dil anlama (NLU) anlamı çıkaran kısım, doğal dil üretme (NLG) metin yazan kısımdır; büyük dil modeli (LLM) ise ikisini de yapabilen bir model türüdür.
| Terim | Neyi kapsar | Örnek çıktı |
|---|---|---|
| NLP | Bilgisayar ve dil alanının bütünü | Bu yazıdaki her görev |
| NLU | Okuma: anlam, niyet, varlıklar | "Niyet: iade, sipariş 4417" |
| NLG | Yazma: veriden ya da prompt'tan metin | "İadeniz yapıldı." |
| LLM | İkisini de yapan bir model türü | Baştan sona yazılmış bir cevap |
NLU ve NLG aynı işin iki yönüdür: bir destek botu mesajı okumak için NLU'yu, cevabı yazmak için NLG'yi kullanır.
LLM ile NLP aynı şey mi?
Hayır: LLM, NLP alanının içindeki bir araçtır, alanın yerini almaz. Büyük dil modeli, sıradaki token'ı tahmin etmek için çok büyük miktarda metinle eğitilmiş bir sinir ağıdır; görevi bir prompt'la tarif ettiğinizde bu tek beceriyle sınıflandırma, çeviri, özetleme ve soru cevaplama yapabilir. Bu modellerin nasıl kurulduğunu ve eğitildiğini LLM Nedir? yazısında anlattık.
Eskiden ayrı bir model gerektiren pek çok görev bugün bir LLM'e sade bir dille sorularak yapılabiliyor. Göreve özel küçük modellerin yine de yeri var: kendi etiketlediğiniz e-postalarla eğitilmiş küçük bir sınıflandırıcı mesaj başına daha ucuzdur, aynı girdiye her seferinde aynı etiketi verir ve kendi sunucularınızda çalışabilir. Bu, yüksek hacimde ya da kişisel veriyle çalışırken önem kazanır.
İnsan dili bilgisayar için neden zordur?
İnsan dili zordur, çünkü aynı kelimeler farklı anlamlara gelebilir ve anlam çoğu zaman metinde hiç yazılmayan bağlama, tona ve bilgiye bağlıdır.
- Çok anlamlılık. "Yaşlı adam ve kadın" sözünde yaşlı olan yalnız adam da olabilir, ikisi de; "Ali'yi görünce gözleri doldu" cümlesinde gözleri dolan Ali de olabilir, onu gören kişi de. İnsan bunu fark etmeden bağlamdan çözer; model bunu öğrenmek zorundadır.
- İroni ve ton. "Harika, yine geç kalan bir teslimat" olumlu bir kelimeyle şikâyet eder. Olumlu ve olumsuz kelimeleri sayan basit duygu modelleri burada yanılır.
- Alan dili. "Pozitif" bir yorumda iyi haber, bir tıbbi test sonucunda kötü haberdir. Haber metinleriyle eğitilmiş bir model sözleşmelerde, tıbbi notlarda ya da sosyal medya argosunda tökezler.
- Kaynağı az diller. Modeller kendilerine sunulan metinden öğrenir, bu yüzden dijital metni İngilizceden az olan dillerde çoğu zaman daha zayıftır. Kelimeyi eklerle uzatan diller buna bir katman daha ekler: Türkçe "evlerinizden" kelimesi, İngilizcenin üç kelimeyle söylediğini (
from your houses) bir kök ve üç ekle anlatır. - Önyargı. Modeller insanların yazdığı metinden, içindeki kalıp yargılarla birlikte öğrenir ve bunları etiketlerinde ya da cevaplarında tekrarlayabilir.
- Yazım ve dil karışımı. Yazım hataları, emojiler ve cümle ortasında dil değiştiren mesajlar gündelik girdidir ve modelleri hâlâ zorlar.
Türkçe doğal dil işleme neden ayrı bir iştir?
Türkçe, kök kelimeye yapım ve çekim eklerinin art arda eklenmesiyle kelime kuran sondan eklemeli bir dildir; Kemal Oflazer'in Türkçe biçimbilimi üzerine 1993 tarihli çalışması da onu böyle tanımlar. "Kitaplarımızdan" kelimesi kitap + lar + ımız + dan parçalarından oluşur ve İngilizcede üç kelimeyle (from our books) söylenir; aynı kökün yüzlerce biçimi olabildiğinden sistemin kelimeyi köküne ve eklerine ayırması, yani biçimbilimsel çözümleme yapması gerekir. Test makinemizde Node.js'in kelime bölücüsü "Kitaplarımızdan birini evlerinizden getirdiniz mi?" cümlesini beş kelimeye ayırdı ve "Kitaplarımızdan"ı tek parça bıraktı: kelimeyi buldu, eklerini görmedi. Ekler belirsizlik de yaratır: Oflazer'in örneğindeki "çalışmanın" hem "senin çalışmanın" hem de yalnızca "bu çalışmanın" anlamına gelebilir ve doğru çözümleme ancak bağlamdan seçilir.
NLP nerede kullanılır?
NLP, bir kurumun okuyabileceğinden fazla metni olduğu her yerde kullanılır. Müşteri hizmetleri ekipleri talepleri yönlendirir ve acil mesajları işaretler. E-ticaret ekipleri yorumlarda tekrar eden şikâyetleri bulur ve site içi aramanın birebir anahtar kelime yerine soruları anlamasını sağlar.
Hukuk ekipleri sözleşmelerde belirli maddeleri arar, hastaneler doktorların serbest yazdığı notları yapılandırılmış kayıtlara çevirir, finans ekipleri bir şirketin adının geçtiği haberleri izler, işe alım ekipleri de iş ilanlarını karşılaştırılabilir alanlara ayırır. İş dünyasının dışında canlı altyazılar, çeviri uygulamaları ve sesli asistanlar da NLP ile çalışır.
NLP projelerinde proxy'ler nereye oturur?
Proxy'ler, bir NLP projesi herkese açık web metnine belirli bir ülkede göründüğü hâliyle ihtiyaç duyduğunda önem kazanır. Yorumlar, haberler, iş ilanları ve ürün açıklamaları pazara ve dile göre değişir; bir site de ziyaretçinin nereden bağlandığına göre çoğu zaman farklı bir yerel sürüm gösterir.
Residential Proxy her isteği seçtiğiniz ülke ve şehirdeki bir ev internet bağlantısı üzerinden gönderir; böylece Almanca yorumlarda duygu analizi yapan ya da Brezilya'daki iş ilanlarının diline bakan bir ekip, yerel bir ziyaretçinin gördüğü herkese açık sayfaları toplar.
Pazar araştırması sayfamız, ekiplerin hedef pazardaki alıcıların gördüğü fiyatları, kampanyaları ve ürün yelpazesini görmek için proxy'leri nasıl kullandığını anlatıyor.
Daha büyük toplama işleri için veri kazıma çözümleri sayfamız bu işlere uygun proxy havuzlarını anlatır; yönetilen sayfa çıkarma (managed page extraction) hizmetini de satış ekibimizle görüşebilirsiniz. Hangi yolu seçerseniz seçin yalnızca herkese açık sayfaları toplayın, robots.txt'ye ve her sitenin kullanım koşullarına uyun, istek hızını düşük tutun, varsa resmî API'yi kullanın ve analizin ihtiyaç duymadığı kişisel verileri dışarıda bırakın.
Sık yapılan hatalar
- Sorudan önce modelle başlamak. Bir yöntem seçmeden önce metinden hangi etiketi ya da cevabı istediğinize karar verin.
- Kendi verinizde ölçmeyi atlamak. Herkese açık karşılaştırma testlerinde (benchmark) yüksek puan alan bir model, kendi müşterilerinizin ifadelerini yine de yanlış etiketleyebilir; kendi örneklerinizden birkaç yüz tanesini etiketleyip modeli onlarla deneyin.
- İngilizce sonuçların başka dillere taşınacağını varsaymak. İşlediğiniz her dilde kaliteyi ayrı ayrı ölçün.
- İşlem hattının ilk adımlarını önemsememek. Bozuk karakter kodlaması, HTML artıkları ve hatalı cümle bölme, "model hatası" sanılan birçok sorunun asıl nedenidir.
- Her görev için LLM kullanmak. Sabit ve yüksek hacimli bir sınıflandırma işinde eğitilmiş küçük bir model çoğu zaman daha ucuz ve daha tutarlıdır.
- Kişisel veriyi kullanım koşullarını okumadan üçüncü taraf araçlara vermek. Metindeki adlar, e-posta adresleri ve sipariş bilgileri, 6698 sayılı Kişisel Verilerin Korunması Kanunu (KVKK) ve GDPR gibi düzenlemelere göre kişisel veridir; görevin gerektirmediğini çıkarın.
Karar rehberi
| İhtiyaç | Öneri |
|---|---|
| Çok sayıda metni sabit etiketlere ayırmak | Eğitilmiş bir metin sınıflandırıcı |
| Ad, yer, tarih ve sipariş numarası bulmak | Adlandırılmış varlık tanıma |
| Yorumların ya da paylaşımların tonunu ölçmek | Kendi verinizde denenmiş duygu analizi |
| Cevap, özet ya da çeviri taslağı | Çıktıyı bir insanın kontrol ettiği bir LLM |
| Kendi belgelerinizden cevap | Belgelerde arama ve bir LLM |
| Sunucularınızdan çıkmaması gereken metin | Kendiniz barındırdığınız açık bir model |
| Birkaç ülkeden yerel web metni | Yerel proxy'lerle toplanan herkese açık sayfalar |
Sıkça sorulan sorular
Doğal dil işlemeye örnek nedir?
En yaygın örneklerden biri spam filtresidir: gelen her e-postayı okur ve ifadelerden yola çıkarak istenmeyen e-posta olup olmadığına karar verir. Makine çevirisi, konuşmayı komuta çeviren sesli asistanlar, telefon klavyesindeki otomatik tamamlama ve müşteri sorularını cevaplayan sohbet botları da NLP örnekleridir.
ChatGPT bir NLP örneği mi?
Evet: ChatGPT, bir NLP model türü olan büyük dil modelleri üzerine kurulmuş bir NLP uygulamasıdır. Prompt'unuzu okumak için dil anlamayı, cevabı yazmak için dil üretmeyi kullanır; bunlar yukarıda anlatılan NLP'nin iki yarısıdır.
NLP ile makine öğrenmesi arasındaki fark nedir?
Makine öğrenmesi veriden örüntü öğrenmenin genel bir yöntemidir; NLP ise bu yöntemi, başka yöntemlerle birlikte, insan diline uygulayan bir alandır. Makine öğrenmesi dille ilgisi olmayan görüntü tanıma, dolandırıcılık tespiti ve öneri sistemlerinde de kullanılır; ilk NLP sistemleri ise hiç makine öğrenmesi kullanmadan elle yazılan kurallarla çalışıyordu.
Psikolojide NLP ne demek?
Psikolojide ve koçlukta NLP, "nöro-linguistik programlama" anlamına gelir ve bilgisayarlarla hiçbir ilgisi olmayan bir iletişim ve kişisel gelişim yöntemidir. Yapay zekâda, veri biliminde ve yazılımda NLP her zaman doğal dil işleme demektir.
NLP için hangi programlama dili kullanılır?
Genellikle Python tercih edilir, çünkü NLTK, spaCy ve Hugging Face Transformers gibi yaygın NLP kütüphaneleri onun için yazılmıştır. Birçok ekip ayrıca uygulamasının zaten kullandığı dilden bir API aracılığıyla bir LLM'e bağlanır.
NLP İngilizce dışındaki dillerde çalışır mı?
Evet, ama kalite dile göre değişir. Modeller genellikle İngilizcede ve dijital metni bol olan dillerde en güçlüdür; eğitim verisi az olan ya da Türkçe gibi kelime yapısı karmaşık dillerde daha zayıf kalabilir. Bu yüzden her modeli ihtiyaç duyduğunuz her dilde gerçek metinle deneyin.
Özet
Doğal dil işleme, bilgisayarların insan dilini okumasını, anlamasını ve yazmasını sağlayan alandır. 1950'lerin elle yazılan kurallarından 1990 civarında istatistiğe, ardından sinir ağlarına ve 2017'den beri transformer'lara ve onların üzerine kurulan büyük dil modellerine geçti. Bir sistem metni cümlelere ve token'lara böler, bunları sayılarla temsil eder ve sınıflandırma, varlık tanıma ya da çeviri gibi bir görev için bir model çalıştırır. Çok anlamlılık, ironi ve diller arasındaki veri eşitsizliği yüzünden dil, bilgisayarlar için zor olmaya devam ediyor. Bu yüzden her NLP sistemini kendi metninizle deneyin ve aracı göreve göre seçin: yüksek hacimli etiketler için küçük bir model, taslak yazmak ve açık uçlu sorular için bir LLM.