


































O prompt de uma equipe de suporte já chegou a três páginas: regras de tom, o formato JSON das tags dos tickets, trinta respostas de exemplo. Cada requisição paga por esses tokens, e mesmo assim o assistente sai do formato de vez em quando. Um engenheiro sugere fazer o ajuste fino do modelo com as respostas anteriores da equipe; outro diz que o assistente precisa, na verdade, de RAG. Os dois podem ter razão, para partes diferentes do problema.
Neste artigo, você vai ver o que é o ajuste fino (fine-tuning), seus principais métodos (SFT, RLHF, DPO e LoRA), como ele se compara ao prompting e ao RAG, de quais dados precisa, quais são os riscos e onde você pode fazer o ajuste fino de um modelo hoje.
O que é fine-tuning (ajuste fino)?
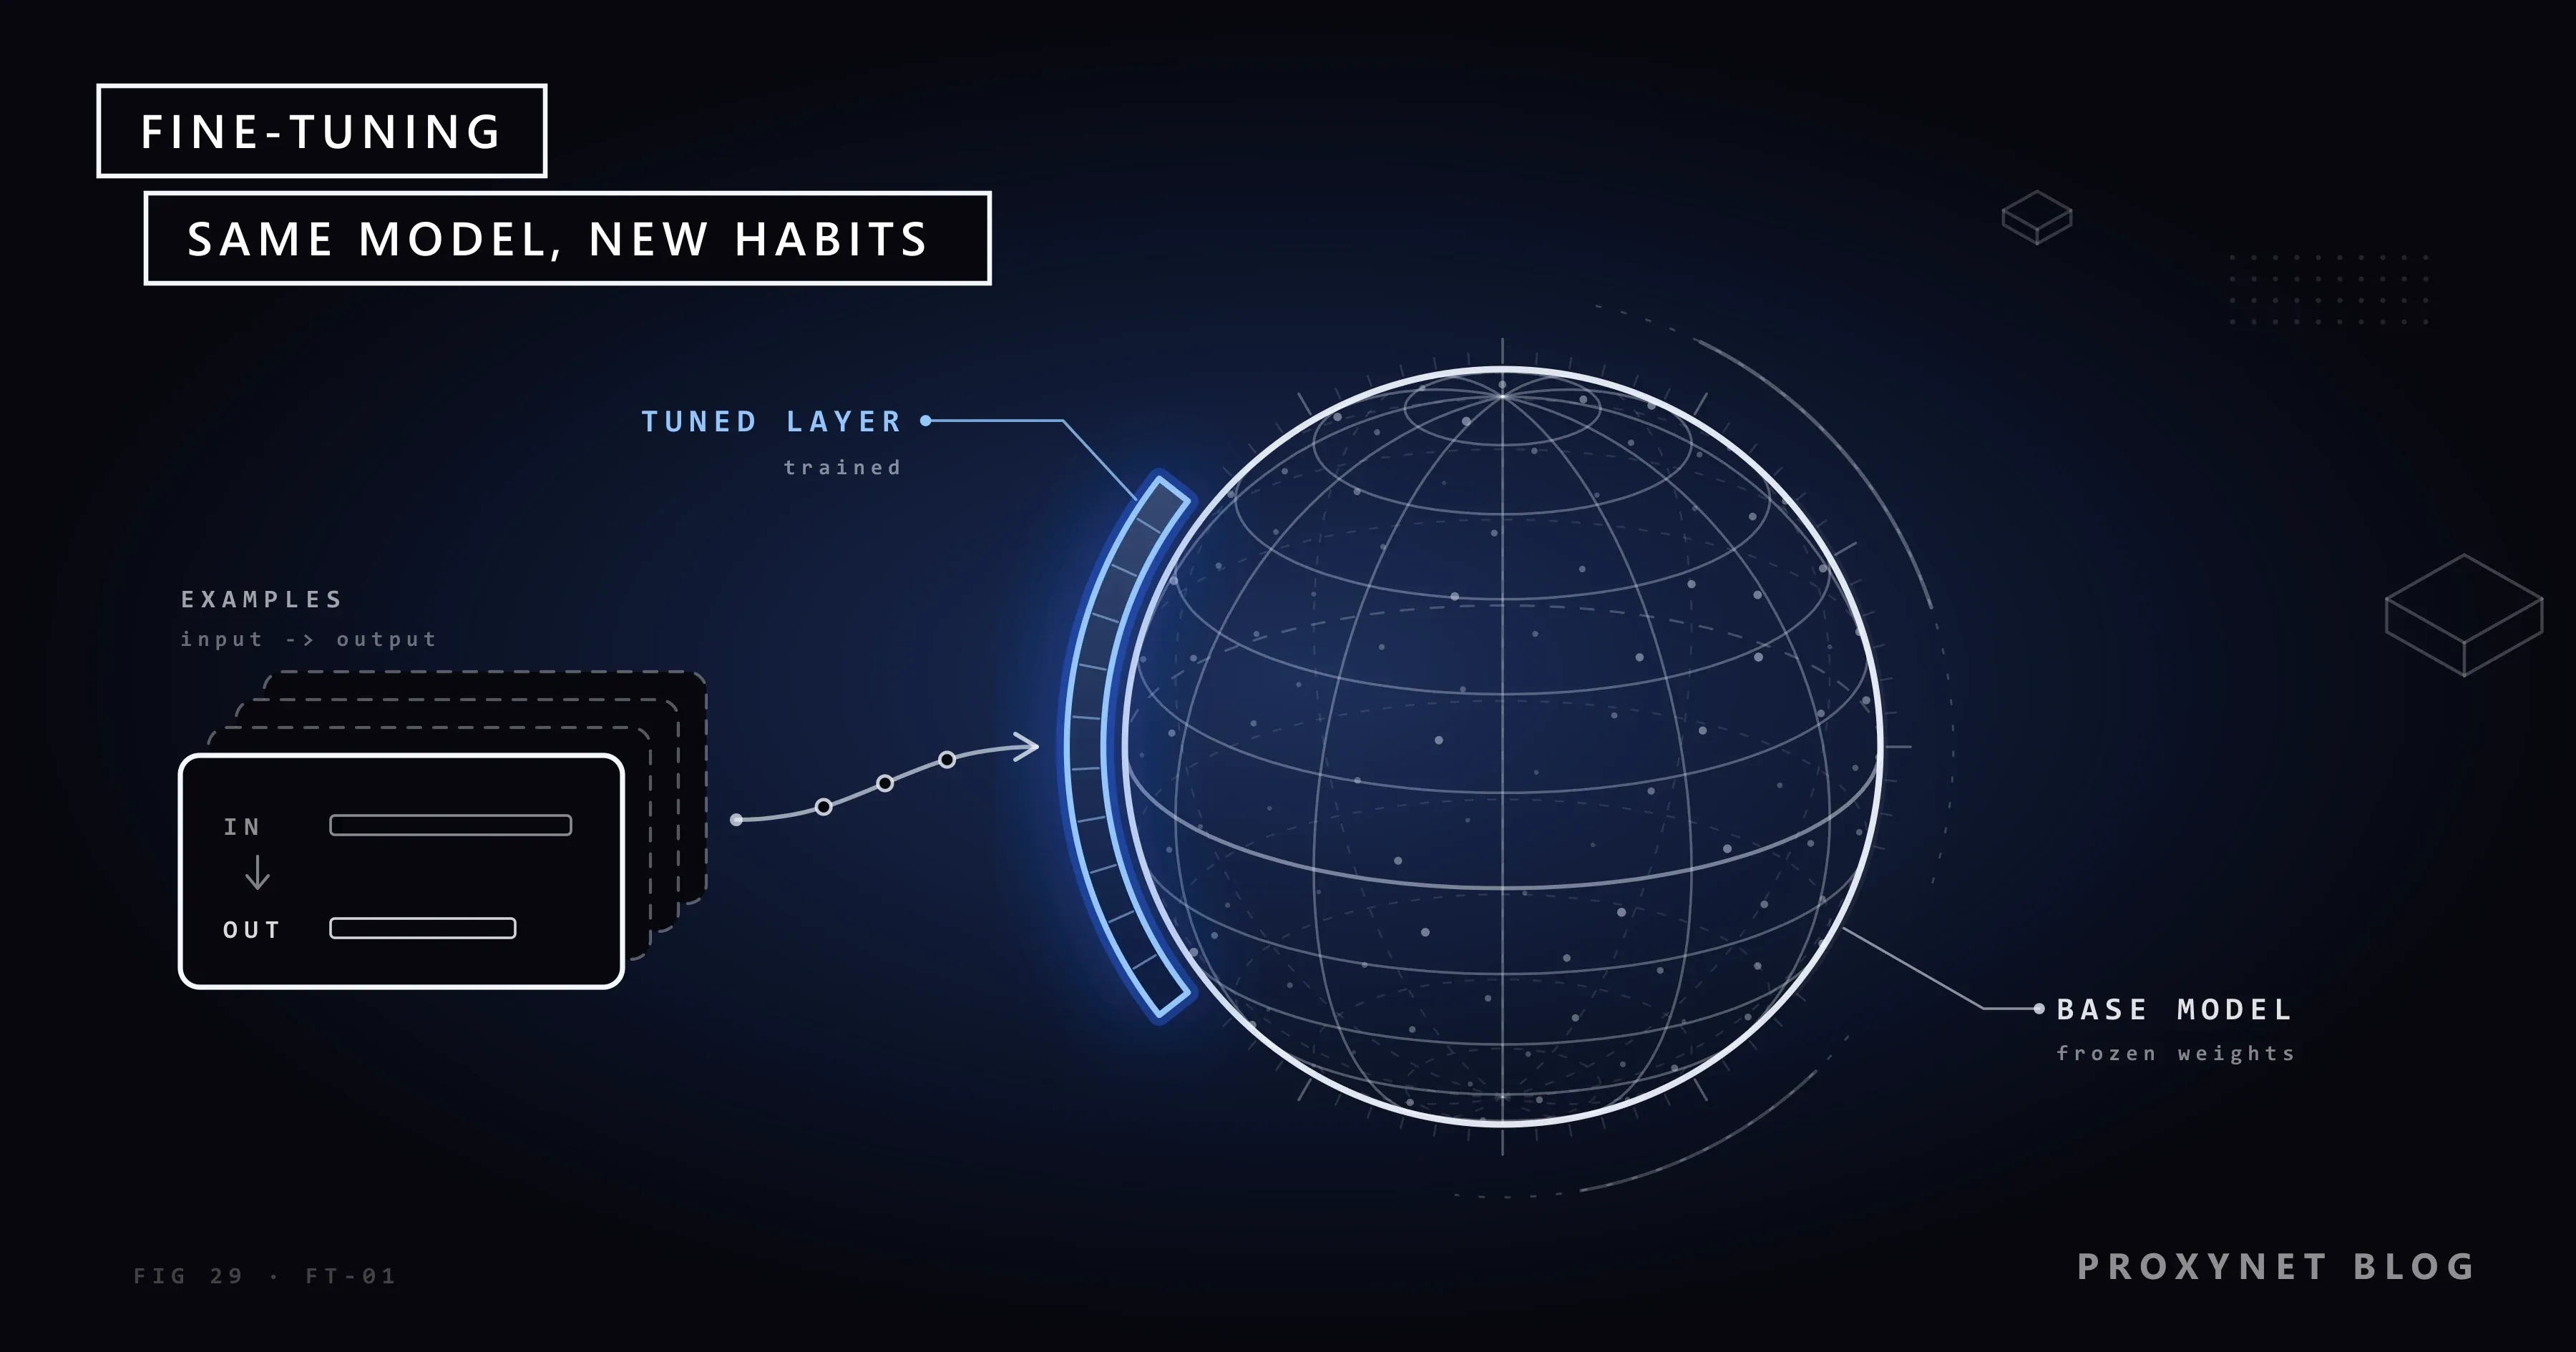
Ajuste fino é continuar treinando um modelo já treinado com um conjunto menor de exemplos de uma tarefa específica, para que o comportamento dele se desloque em direção a essa tarefa. Os parâmetros do modelo, os bilhões de números (pesos) que ele ajusta enquanto aprende, começam de onde o treinamento anterior os deixou, então o ajuste fino precisa de uma pequena fração dos dados e do poder computacional originais.
O modelo de partida se chama modelo base ou modelo pré-treinado. Em tarefas de texto, ele costuma ser um modelo de linguagem grande (LLM), um modelo treinado com enormes quantidades de texto para prever o próximo trecho de texto; nosso guia sobre como os LLMs funcionam explica essa primeira etapa. O ajuste fino é uma forma de aprendizado por transferência (transfer learning): o que um modelo aprendeu em uma tarefa é reaproveitado em outra.
A receita virou padrão por volta de 2018, quando os autores do BERT mostraram que um único modelo pré-treinado podia ser ajustado para muitas tarefas com apenas uma camada de saída adicional. Fora da IA, "ajuste fino" também é o nome de um argumento da cosmologia (o ajuste fino do universo); este artigo trata apenas de modelos.
Em que o ajuste fino difere do pré-treinamento?
O pré-treinamento constrói do zero o conhecimento geral de um modelo com um corpus de texto enorme, enquanto o ajuste fino adapta o comportamento desse modelo já treinado com um conjunto de dados muito menor e selecionado com cuidado. No pré-treinamento, o modelo lê livros, código e páginas web e aprende a prever o próximo token, uma palavra ou um pedaço de palavra. É a etapa cara, conduzida pelas organizações que criam modelos base.
As duas etapas ensinam coisas diferentes. O estudo LIMA fez o ajuste fino de um modelo LLaMA de 65 bilhões de parâmetros com apenas 1.000 prompts e respostas escolhidos com cuidado, e os autores concluíram que quase todo o conhecimento dos modelos de linguagem grandes é aprendido no pré-treinamento; o ajuste fino molda sobretudo a forma como esse conhecimento aparece nas respostas. Entre os dois fica o pré-treinamento continuado (continued pretraining): mais texto sem rótulos de um domínio, com o mesmo objetivo de prever o próximo token.
Como funciona o ajuste fino, passo a passo?
O ajuste fino funciona como um ciclo: você define a tarefa e um teste, prepara os exemplos, treina, compara o resultado com o teste e repete.
- Defina a tarefa e o teste. Reúna entradas reais com as saídas que você espera antes de qualquer treinamento; sem elas, não dá para saber se o ajuste ajudou.
- Meça uma linha de base com prompts. Rode o teste no modelo base com um prompt claro e alguns exemplos. Se ele passar, pare aqui.
- Escolha um modelo base. Um modelo hospedado com serviço de ajuste ou um modelo de pesos abertos (open-weight) que você mesmo executa.
- Colete e rotule exemplos. Cada exemplo combina uma entrada com a saída desejada e costuma ser salvo como JSONL, um objeto JSON por linha, sem duplicatas nem dados pessoais.
- Divida os dados. Treinamento, validação e um conjunto de teste reservado que o modelo nunca vê.
- Treine. Escolha ajuste fino completo ou eficiente em parâmetros, algumas passagens pelos dados (épocas) e uma taxa de aprendizado. Se a perda de validação sobe enquanto a perda de treinamento cai, o modelo está decorando.
- Avalie. Compare a pontuação do teste com a linha de base e verifique também as habilidades gerais e a segurança.
- Implante e monitore. Inclua as falhas reais na próxima rodada.
O que são SFT, RLHF e DPO?
O SFT, ajuste fino supervisionado, treina um modelo com pares de uma entrada e a saída ideal; RLHF e DPO são ajuste por preferências (preference tuning), que aprende com o julgamento das pessoas sobre qual resposta é melhor. A maioria dos projetos usa SFT, e o ajuste por preferências costuma vir depois.
Ajuste fino supervisionado (SFT). Os pares podem ser uma pergunta de cliente e a melhor resposta, ou uma fatura e os campos extraídos dela. "Supervisionado" significa que cada exemplo traz a resposta certa, escrita ou conferida por uma pessoa. O ajuste por instruções (instruction tuning) é SFT com uma mistura ampla de tarefas; ele transforma um modelo base que só continua textos em um assistente que atende a pedidos.
RLHF, aprendizado por reforço com feedback humano, foi apresentado no artigo do InstructGPT de Ouyang e colegas (2022). Anotadores escreveram demonstrações para o SFT do GPT-3 e depois ordenaram várias saídas por prompt; um modelo de recompensa aprendeu essas classificações, e o aprendizado por reforço ajustou o modelo com base nele. Os avaliadores preferiram o InstructGPT de 1,3 bilhão de parâmetros ao GPT-3 de 175 bilhões.
DPO, otimização direta de preferências (direct preference optimization; Rafailov e colegas, 2023), chega ao mesmo objetivo sem modelo de recompensa nem aprendizado por reforço e treina diretamente com pares de uma resposta preferida e uma rejeitada.
O que é LoRA e o que é ajuste fino eficiente em parâmetros?
O ajuste fino eficiente em parâmetros (PEFT) congela quase todos os pesos de um modelo e treina um número pequeno de pesos novos; o LoRA, sigla de low-rank adaptation (adaptação de baixo posto), é o método mais conhecido. Já o ajuste fino completo atualiza todos os pesos e gera uma cópia completa do modelo para cada tarefa.
O LoRA, descrito por Hu e colegas no artigo do LoRA (2021), mantém congelados os pesos pré-treinados e treina apenas pares de pequenas matrizes adicionadas a cada camada do transformer, o projeto de rede sobre o qual os LLMs são construídos. "Baixo posto" significa que a mudança em cada grande tabela de pesos é escrita como duas tabelas estreitas cujo produto se aproxima dela.
Em comparação com o ajuste fino completo do GPT-3 de 175 bilhões de parâmetros, os autores relatam 10.000 vezes menos parâmetros treináveis e três vezes menos memória de GPU, com qualidade equivalente ou melhor nos modelos testados e sem respostas mais lentas depois que as matrizes são incorporadas aos pesos. O QLoRA (Dettmers e colegas, 2023) armazena o modelo base congelado em precisão de 4 bits, o que bastou para fazer o ajuste fino de um modelo de 65 bilhões de parâmetros em uma única GPU de 48 GB.
Assim, um modelo base pode atender a várias tarefas, cada uma com seu próprio adaptador pequeno. O LoRA não tem nada a ver com o LoRa, a tecnologia de rádio de longo alcance.
Fine-tuning vs. RAG vs. engenharia de prompt: qual é a diferença?
A engenharia de prompt (prompt engineering) muda as instruções que você envia, o RAG muda as informações que o modelo vê no momento da pergunta e o ajuste fino muda o próprio modelo. Eles resolvem problemas diferentes e muitas vezes são combinados.
| Pergunta | Engenharia de prompt | RAG | Ajuste fino |
|---|---|---|---|
| O que muda? | As instruções | O contexto de cada pergunta | Os pesos do modelo |
| Dados necessários | Alguns exemplos | Um índice de documentos | Pares de entrada e saída selecionados |
| Esforço para começar | Baixo | Médio | Alto |
| Fatos recentes | Só se colados no prompt | Sim, reindexando a fonte | Não, exige novo treinamento |
| Mostra as fontes | Não | Sim | Não |
| Ideal para | Protótipos, tarefas simples | Conhecimento que muda | Formato, tom, tarefas restritas |
No RAG, a geração aumentada por recuperação, um retriever (componente de busca) encontra em um índice de documentos os trechos mais relevantes para uma pergunta, esses trechos entram no prompt e o modelo responde com base neles. Quando os documentos são páginas web, a maior parte do trabalho é prepará-los, o que explicamos em web scraping para RAG.
Para conhecimento, os dois já foram comparados diretamente: Ovadia e colegas (2023) descobriram que o RAG superou de forma consistente o ajuste fino não supervisionado, tanto para fatos que o modelo tinha visto no treinamento quanto para fatos totalmente novos. Eles também se combinam bem, já que um modelo ajustado pode responder no formato da casa a partir dos trechos que o RAG recupera.
Em que o ajuste fino é bom, e em que não é?
O ajuste fino é bom para ensinar a um modelo como responder e fraco para ensinar o que é verdade agora. Seus pontos fortes:
- Um formato de saída consistente. Os mesmos campos JSON toda vez, ou uma estrutura de resposta fixa.
- Tom e estilo da casa. O jeito como a sua equipe de suporte ou a sua marca escreve.
- Classificação e extração restritas. Suas categorias de tickets, sua taxonomia de produtos, os campos de um tipo de documento.
- Prompts mais curtos, modelos menores. As instruções passam para os pesos, e um modelo pequeno ajustado pode assumir uma tarefa de um modelo grande.
Os pontos fracos são fatos que mudam, como preços e políticas, mostrar de onde veio uma resposta e tarefas vagas: se os seus revisores discordam sobre os rótulos, o modelo aprende a discordância.
Até fatos novos e estáveis são um problema. Em um estudo controlado, Gekhman e colegas verificaram que exemplos com fatos que o modelo ainda não conhecia eram aprendidos muito mais devagar e, depois de aprendidos, aumentavam a tendência dele a alucinar, ou seja, a afirmar coisas falsas com confiança. Os modelos adquirem conhecimento factual principalmente no pré-treinamento; o ajuste fino os ensina a usá-lo.
De quais dados você precisa para o ajuste fino?
Você precisa de exemplos parecidos com as entradas reais que o modelo vai receber, cada um combinado com uma saída que você entregaria sem receio; consistência importa mais do que volume. Não existe um número universal, então comece com um conjunto que você consiga conferir à mão, meça e acrescente exemplos onde o modelo falhar.
Os exemplos costumam vir de quatro lugares:
- Seus próprios registros. Respostas anteriores, documentos revisados, produtos categorizados, usados só onde você tem o direito.
- Rotulagem humana. Pessoas escrevem ou conferem a saída correta para cada entrada; o artigo sobre rotulagem de dados explica como esses projetos funcionam e como se mede a concordância entre anotadores.
- Exemplos sintéticos. Um modelo maior os escreve sob demanda. Eles copiam os erros e o viés do gerador, por isso pessoas devem revisá-los e o conjunto de teste deve continuar real.
- Texto público da web. Descrições de produtos, documentação e outros textos do domínio nos idiomas que o modelo vai atender.
Verifique a licença do modelo base e os termos de cada fonte de dados antes de treinar. Se os exemplos tiverem dados pessoais, o treinamento é um tratamento de dados pelo GDPR na UE e pela KVKK (a lei de proteção de dados da Türkiye), e um modelo ajustado pode repetir o que memorizou. O Comitê Europeu para a Proteção de Dados (CEPD) afirma no Parecer 28/2024 que a questão de saber se um modelo treinado com dados pessoais é anônimo deve ser avaliada caso a caso. A proteção mais simples é deixar de fora nomes, dados de contato e números de documentos.
Onde entram os dados públicos da web?
Os exemplos de um domínio costumam começar como páginas web públicas, como descrições de produtos para um modelo de categorização ou vagas de emprego para um modelo que marca habilidades, em cada idioma que o modelo vai atender. Muitos sites mudam o idioma, a moeda e o sortimento conforme o país do visitante, então coletar a partir de um único local gera um conjunto de dados parcial. Com os Proxies residenciais, as requisições passam por conexões residenciais no país e na cidade que você escolher, e você coleta a versão que os visitantes locais veem. Colete apenas páginas públicas, siga o robots.txt e os termos de cada site, mantenha um ritmo baixo de requisições, use uma API oficial quando houver e verifique se o texto pode ser usado para treinamento.
Equipes que preferem não cuidar da coleta podem falar com o nosso time de vendas sobre a extração gerenciada de páginas da nossa Web Scraping API.
Quais são os riscos do ajuste fino?
O principal risco é acabar com um modelo que decora em vez de generalizar, perde habilidades que tinha ou parece melhor nos seus testes do que no uso real; um conjunto de teste separado, executado de novo depois de cada rodada, pega a maioria desses problemas.
- Sobreajuste (overfitting). O modelo decora os exemplos de treinamento e se sai pior com entradas novas.
- Esquecimento catastrófico (catastrophic forgetting). Treinar em uma tarefa nova pode apagar habilidades anteriores, um problema conhecido das redes neurais que Kirkpatrick e colegas abordaram em 2017.
- Comportamento de segurança mais fraco. Qi e colegas (2023) descobriram que o ajuste fino, mesmo com conjuntos de dados inofensivos e de uso comum, pode enfraquecer o treinamento de segurança de um modelo.
- Lacunas na avaliação. Se os exemplos de teste se parecem com o conjunto de treinamento ou vazam dele, as pontuações favorecem o modelo.
- Dependência do modelo base. Um modelo ajustado só dura enquanto o modelo base dele for oferecido.
Onde você pode fazer o ajuste fino de um modelo?
Você pode fazer o ajuste fino pelo serviço hospedado de um fornecedor ou treinando um modelo de pesos abertos em hardware próprio ou alugado, e as ofertas dos fornecedores mudam com o tempo.
Em um serviço hospedado, você envia os dados de treinamento, o fornecedor treina e serve o modelo ajustado, e os pesos ficam com o fornecedor. A documentação de ajuste do Google Cloud lista ajuste fino supervisionado, por preferências e com aprendizado por reforço para alguns modelos Gemini.
As ofertas também acabam. A OpenAI anunciou em maio de 2026 que está encerrando aos poucos o ajuste fino self-service: segundo a sua página de descontinuações, clientes ativos não poderão mais criar novos jobs a partir de 6 de janeiro de 2027, e os modelos ajustados existentes continuam respondendo até que seus modelos base sejam retirados.
Com modelos de pesos abertos, você baixa pesos publicados sob uma licença, faz o ajuste com LoRA ou QLoRA, por exemplo pela biblioteca de código aberto PEFT, e fica com o resultado, mas também assume o hardware e a disponibilização do modelo.
Onde o ajuste fino é usado?
O ajuste fino é usado onde quer que uma tarefa se repita milhares de vezes no mesmo formato. Assistentes de suporte aprendem o estilo da casa, modelos de roteamento aprendem as categorias de tickets de uma empresa e fluxos de processamento de documentos extraem os mesmos campos de faturas para um layout JSON fixo. Lojas online marcam produtos com a própria taxonomia, e desenvolvedores ajustam modelos pequenos para executar uma única tarefa em um celular ou notebook.
Erros comuns
- Começar pelo ajuste fino. Um prompt claro com exemplos, ou RAG, muitas vezes resolve o problema com menos esforço.
- Ensinar fatos que mudam. Preços, políticas e notícias pertencem à recuperação.
- Não ter um conjunto de teste reservado. Sem ele, toda rodada de treinamento parece progresso.
- Volume acima de consistência. Milhares de exemplos contraditórios e não conferidos ensinam as contradições.
- Dados pessoais no conjunto de treinamento. Um modelo ajustado pode repeti-los.
- Testar só a tarefa-alvo. Verifique também as habilidades gerais e o comportamento de segurança.
- Jogar os dados fora. Modelos base são retirados, e você vai precisar ajustar de novo.
Guia de decisão
| Necessidade | Use |
|---|---|
| Um primeiro protótipo | Engenharia de prompt |
| Respostas a partir dos seus documentos atuais | RAG |
| Preços, estoque, notícias ou políticas | RAG ou uma consulta em tempo real, não ajuste fino |
| O mesmo formato de saída toda vez | SFT, muitas vezes com LoRA, depois de uma linha de base com prompts |
| O tom da sua marca nas respostas | SFT com respostas anteriores revisadas |
| Respostas que as pessoas preferem | Ajuste por preferências (DPO ou RLHF) |
| Uma tarefa restrita com custo menor | Um modelo menor ajustado, testado contra um grande |
| Memória de GPU limitada | LoRA ou QLoRA, não ajuste fino completo |
Perguntas frequentes
Devo usar fine-tuning ou RAG?
Use RAG quando faltar conhecimento ao modelo e ajuste fino quando faltar um comportamento. O RAG serve para fatos que mudam e documentos que você precisa citar; o ajuste fino serve para formatos, tom e tarefas restritas e repetidas. Muitos sistemas usam os dois.
O que é ajuste fino com LoRA?
O ajuste fino com LoRA congela o modelo original e treina pequenas matrizes adicionadas em cada camada, que capturam a mudança de que a tarefa precisa. Ele treina muito menos parâmetros e exige muito menos memória de GPU do que o ajuste fino completo, e o resultado é um adaptador pequeno que pode ser trocado por tarefa ou incorporado ao modelo.
De quantos dados preciso para fazer o ajuste fino de um LLM?
Não há um número fixo; os exemplos precisam ser corretos, consistentes e próximos das entradas reais. O estudo LIMA moldou um assistente geral com 1.000 exemplos selecionados. Para uma tarefa restrita, comece com um conjunto que você consiga conferir à mão e acrescente exemplos onde o teste reservado ainda falhar.
Posso fazer o ajuste fino do ChatGPT ou de outros modelos hospedados?
Só pela plataforma de desenvolvedores de um fornecedor e só nos modelos que o fornecedor abre para ajuste, não nos apps de chat. O Google Cloud oferece ajuste para alguns modelos Gemini, enquanto a OpenAI deixa de aceitar novos jobs de ajuste fino self-service de clientes ativos em 6 de janeiro de 2027. Se você precisa ficar com os pesos ajustados, a alternativa são os modelos de pesos abertos.
Qual é a diferença entre ajuste fino e pré-treinamento?
O pré-treinamento ensina a um modelo a língua e o conhecimento geral do zero, com um corpus muito grande; o ajuste fino adapta um modelo já pré-treinado com um conjunto de dados pequeno e focado. O pré-treinamento exige os recursos de quem desenvolve modelos, enquanto o ajuste fino está ao alcance de uma equipe comum.
O ajuste fino ensina fatos novos ao modelo?
Só mal, e com um custo. Os modelos aprendem fatos novos pelo ajuste fino muito mais devagar do que os conhecidos e alucinam mais depois de aprendê-los. Coloque os fatos em documentos que o modelo recupera e use o ajuste fino para a forma como ele responde.
Em resumo
O ajuste fino continua o treinamento de um modelo existente com um conjunto pequeno de exemplos para que ele aprenda um comportamento: um formato, um tom, uma tarefa restrita. O SFT ensina com respostas ideais, o ajuste por preferências com as escolhas das pessoas, e o LoRA faz tudo caber em um hardware modesto. Ele não acrescenta fatos novos de forma confiável; esse é o papel do RAG. Comece com um prompt, adicione recuperação para o conhecimento, faça ajuste fino para o comportamento e monte o conjunto de dados com fontes que você pode usar, nos idiomas e países que o seu modelo vai atender.


