


































Bir destek ekibinin prompt'u üç sayfayı bulmuş: üslup kuralları, talep etiketleri için JSON biçimi, otuz örnek cevap. Her istek bu token'ların bedelini ödüyor, asistan yine de arada bir biçimin dışına çıkıyor. Ekipteki bir mühendis, modele ekibin geçmiş cevaplarıyla fine-tuning (ince ayar) yapmayı öneriyor; bir diğeri asistanın asıl ihtiyacının RAG olduğunu söylüyor. Sorunun farklı parçaları için ikisi de haklı olabilir.
Bu yazıda ince ayarın ne olduğunu, başlıca yöntemlerini (SFT, RLHF, DPO ve LoRA), prompt ve RAG ile karşılaştırmasını, gerektirdiği veriyi, risklerini ve bugün bir modele nerede ince ayar yapabileceğinizi anlatıyoruz.
Fine-tuning (ince ayar) nedir?
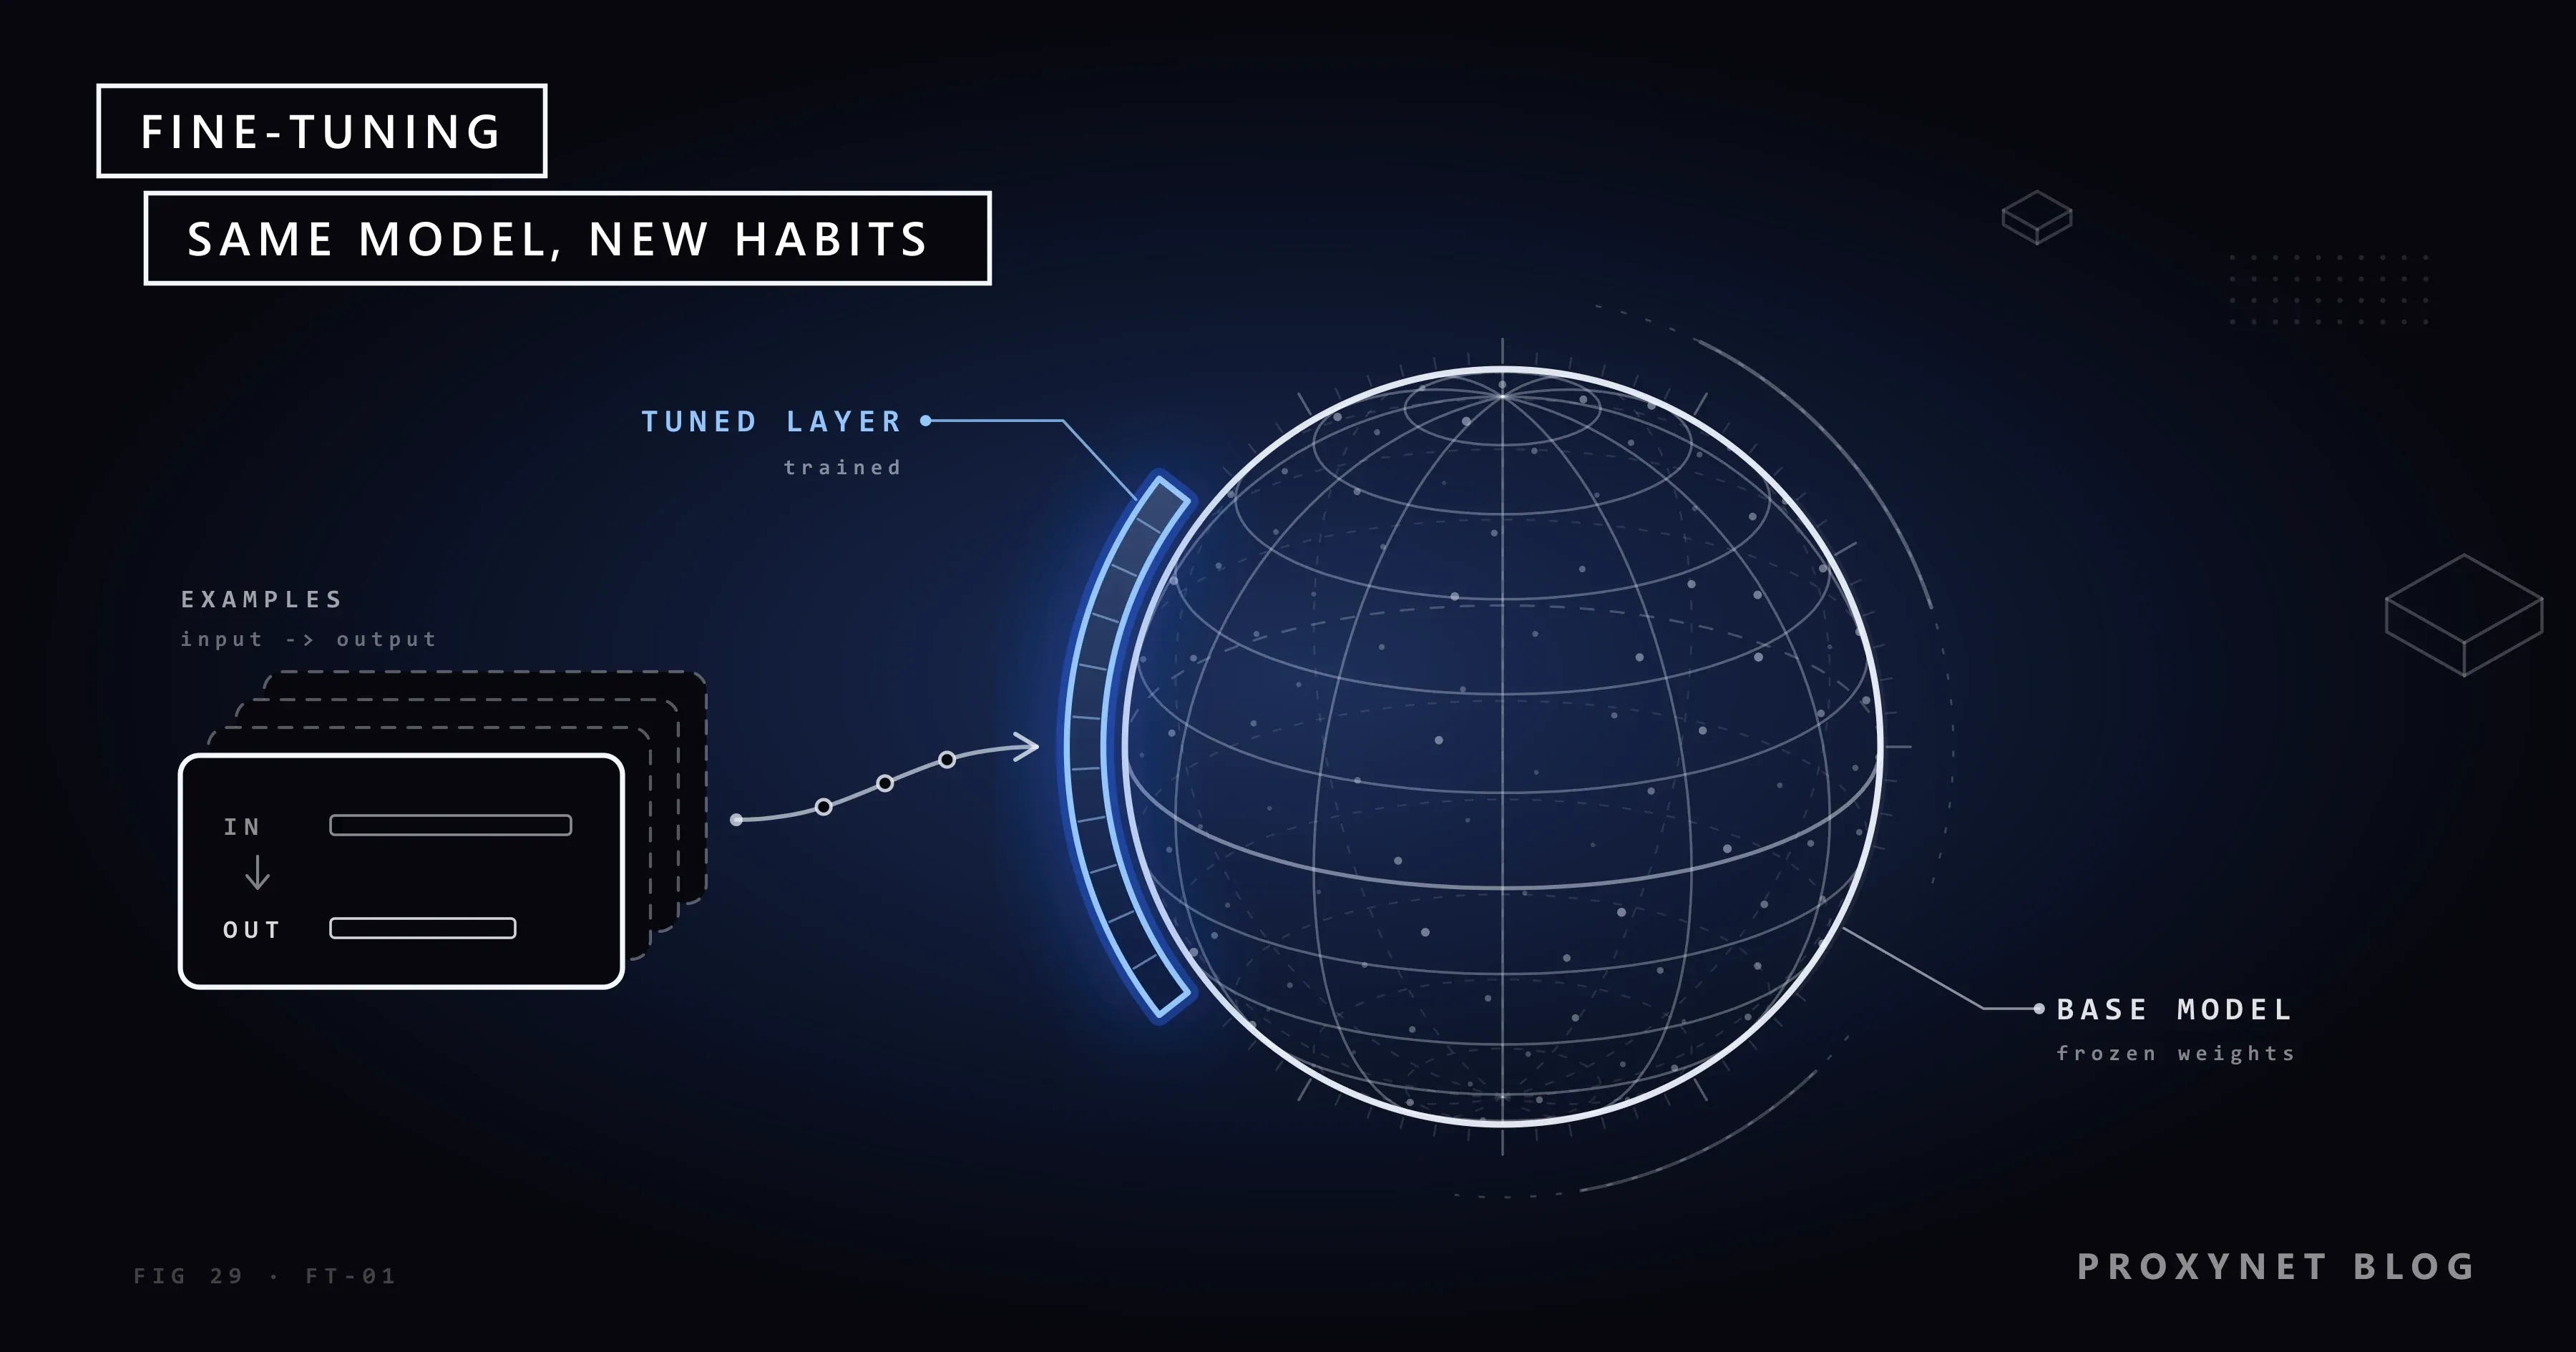
İnce ayar, eğitilmiş bir modeli göreve özgü, daha küçük bir örnek setiyle eğitmeye devam ederek davranışını o göreve doğru kaydırmaktır. Modelin parametreleri, yani öğrenirken ayarladığı milyarlarca sayı (ağırlık), önceki eğitimin bıraktığı yerden başlar; bu yüzden ince ayar, ilk eğitimin verisinin ve işlem gücünün küçük bir kısmıyla yapılır.
Başlangıçtaki modele temel model (base model) ya da önceden eğitilmiş model denir. Metin görevlerinde bu genellikle bir büyük dil modelidir (LLM): çok büyük miktarda metinle, sıradaki metin parçasını tahmin etmek üzere eğitilmiş bir model. Bu ilk aşamayı LLM'lerin nasıl çalıştığını anlattığımız yazıda bulabilirsiniz. İnce ayar bir transfer öğrenme (transfer learning) biçimidir: modelin bir görevde öğrendikleri başka bir görevde yeniden kullanılır.
Bu yöntem 2018 civarında standart hâline geldi: BERT'in yazarları, önceden eğitilmiş tek bir modelin üstüne yalnızca bir çıktı katmanı eklenerek pek çok göreve uyarlanabileceğini gösterdi. Yapay zekâ dışında "fine-tuning" kozmolojideki bir argümanın da adıdır; bu yazı yalnızca modellerle ilgili.
İnce ayarın ön eğitimden farkı nedir?
Ön eğitim (pretraining) modelin genel bilgisini çok büyük bir metin derlemi üzerinde sıfırdan kurar; ince ayar ise eğitilmiş bu modelin davranışını çok daha küçük, özenle seçilmiş bir veri setiyle ayarlar. Ön eğitimde model kitapları, kodu ve web sayfalarını okur ve sıradaki token'ı, yani bir kelimeyi ya da kelime parçasını tahmin etmeyi öğrenir. Bu, temel modelleri geliştiren kuruluşların yürüttüğü pahalı aşamadır.
İki aşama farklı şeyler öğretir. LIMA çalışmasında 65 milyar parametreli bir LLaMA modeli, özenle seçilmiş yalnızca 1.000 prompt ve cevapla ince ayardan geçirildi; yazarlar büyük dil modellerindeki bilginin neredeyse tamamının ön eğitimde öğrenildiği sonucuna vardı. İnce ayar ise daha çok bu bilginin cevaplara nasıl yansıdığını biçimlendirir. İkisinin arasında sürdürülen ön eğitim (continued pretraining) durur: tek bir alandan gelen etiketsiz metinle, aynı sıradaki token hedefiyle eğitime devam edilir.
İnce ayar adım adım nasıl yapılır?
İnce ayar bir döngü olarak ilerler: görevi ve testi tanımlarsınız, örnekleri hazırlarsınız, eğitirsiniz, sonucu testle karşılaştırır ve baştan alırsınız.
- Görevi ve testi tanımlayın. Eğitimden önce gerçek girdileri ve beklediğiniz çıktıları toplayın; bunlar olmadan ince ayarın işe yarayıp yaramadığını anlayamazsınız.
- Prompt'la bir başlangıç ölçümü alın. Testi temel modelde açık bir prompt ve birkaç örnekle çalıştırın. Model testi geçiyorsa burada durun.
- Temel modeli seçin. İnce ayar hizmeti sunan, sağlayıcının barındırdığı bir model ya da kendiniz çalıştıracağınız açık ağırlıklı (open-weight) bir model.
- Örnekleri toplayıp etiketleyin. Her örnek bir girdiyi istenen çıktıyla eşleştirir; örnekler genellikle her satırda bir JSON nesnesi bulunan JSONL dosyasında, tekrarlardan ve kişisel verilerden arındırılmış olarak tutulur.
- Veriyi bölün. Eğitim seti, doğrulama seti ve modelin hiç görmeyeceği, ayrı tutulmuş bir test seti.
- Eğitin. Tam ya da parametre açısından verimli ince ayarı, veri üzerinden birkaç tam geçişi (epoch) ve bir öğrenme oranını seçin. Eğitim kaybı düşerken doğrulama kaybı yükseliyorsa model ezberliyordur.
- Değerlendirin. Test puanını başlangıç ölçümüyle karşılaştırın; genel becerileri ve güvenlik davranışını da kontrol edin.
- Yayına alın ve izleyin. Gerçek kullanımda çıkan hataları bir sonraki tura ekleyin.
SFT, RLHF ve DPO nedir?
SFT, yani denetimli ince ayar (supervised fine-tuning), modeli girdi ile ideal çıktı çiftleri üzerinde eğitir; RLHF ve DPO ise tercih ayarıdır (preference tuning): hangi cevabın daha iyi olduğuna dair insan yargılarından öğrenir. Projelerin çoğu SFT kullanır; tercih ayarı genellikle ondan sonra gelir.
Denetimli ince ayar (SFT). Çiftler bir müşteri sorusu ile en iyi cevap ya da bir fatura ile ondan çıkarılan alanlar olabilir. "Denetimli" sözcüğü, her örneğin bir insanın yazdığı ya da kontrol ettiği doğru cevabı taşıdığını anlatır. Talimat ayarı (instruction tuning), pek çok görevden gelen geniş bir karışımla yapılan SFT'dir; yalnızca metni sürdüren bir temel modeli istekleri yerine getiren bir asistana dönüştürür.
RLHF, insan geri bildirimiyle pekiştirmeli öğrenme (reinforcement learning from human feedback), Ouyang ve arkadaşlarının InstructGPT makalesinde (2022) adım adım anlatıldı. Etiketleyiciler GPT-3'ün SFT'si için örnek cevaplar yazdı, ardından aynı prompt'a verilen birkaç çıktıyı sıraladı; bir ödül modeli bu sıralamaları öğrendi, son olarak da model pekiştirmeli öğrenmeyle bu ödül modelinden yüksek puan alacak biçimde ayarlandı. Değerlendiriciler 1,3 milyar parametreli InstructGPT'nin cevaplarını 175 milyar parametreli GPT-3'ün cevaplarına tercih etti.
DPO, doğrudan tercih optimizasyonu (direct preference optimization; Rafailov ve arkadaşları, 2023), aynı hedefe ödül modeli ve pekiştirmeli öğrenme olmadan ulaşır: tercih edilen ve reddedilen cevap çiftleri üzerinde doğrudan eğitim yapar.
LoRA nedir, parametre açısından verimli ince ayar ne demek?
Parametre açısından verimli ince ayar (parameter-efficient fine-tuning, PEFT), modelin ağırlıklarının neredeyse tamamını dondurur ve az sayıda yeni ağırlık eğitir; bu yöntemlerin en bilineni LoRA'dır (low-rank adaptation, düşük ranklı uyarlama). Tam ince ayar ise her ağırlığı günceller ve her görev için modelin tam bir kopyasını üretir.
Hu ve arkadaşlarının LoRA makalesinde (2021) anlattığı yöntem, önceden eğitilmiş ağırlıkları dondurur ve yalnızca transformer'ın, yani LLM'lerin üzerine kurulduğu ağ tasarımının her katmanına eklenen küçük matris çiftlerini eğitir. "Düşük ranklı" ifadesi, her büyük ağırlık tablosundaki değişikliğin, çarpımı bu değişikliğe yaklaşan iki ince tabloyla yazılması demektir.
Yazarlar, 175 milyar parametreli GPT-3'ün tam ince ayarına kıyasla eğitilen parametre sayısının 10.000 kat, GPU bellek ihtiyacının 3 kat azaldığını bildiriyor; denedikleri modellerde kalite tam ince ayarla aynı ya da daha iyiydi ve matrisler ağırlıklara katıldığında cevaplar yavaşlamadı. QLoRA (Dettmers ve arkadaşları, 2023) dondurulmuş temel modeli 4 bit hassasiyetle saklar; bu, 65 milyar parametreli bir modele tek bir 48 GB GPU'da ince ayar yapmaya yetti.
Böylece tek bir temel model, her biri kendi küçük adaptörüne sahip birkaç göreve hizmet edebilir. Yapay zekâdaki LoRA'nın, uzun menzilli radyo haberleşme teknolojisi LoRa ile bir ilgisi yoktur.
Fine-tuning, RAG ve prompt engineering arasındaki fark nedir?
Prompt engineering (prompt mühendisliği) modele gönderdiğiniz talimatı, RAG modelin soru anında gördüğü bilgiyi, ince ayar ise modelin kendisini değiştirir. Üçü farklı sorunları çözer ve çoğu zaman birlikte kullanılır.
| Soru | Prompt engineering | RAG | İnce ayar |
|---|---|---|---|
| Ne değişir? | Talimat | Her sorudaki bağlam | Modelin ağırlıkları |
| Gereken veri | Birkaç örnek | Bir belge dizini | Seçilmiş girdi-çıktı çiftleri |
| Başlama zahmeti | Düşük | Orta | Yüksek |
| Güncel bilgi | Yalnızca prompt'a eklenirse | Evet, kaynak yeniden dizine eklenir | Hayır, yeniden eğitim gerekir |
| Kaynağını gösterir mi? | Hayır | Evet | Hayır |
| En uygun olduğu iş | Prototip, basit görev | Değişen bilgi | Biçim, üslup, dar görev |
RAG'de (getirmeyle zenginleştirilmiş üretim) bir getirme bileşeni (retriever) belge dizininde soruyla en ilgili pasajları bulur, bu pasajlar prompt'a eklenir ve model cevabı onlara dayanarak yazar. Belgeler web sayfalarıysa işin büyük kısmı onları hazırlamaktır; bunu web verisini RAG için temiz Markdown parçalarına çevirme yazısında anlattık.
Bilgi eklemek konusunda ikisi doğrudan karşılaştırıldı: Ovadia ve arkadaşları (2023), RAG'in hem modelin eğitimde karşılaştığı bilgilerde hem de tamamen yeni bilgilerde denetimsiz ince ayardan sürekli olarak daha iyi sonuç verdiğini buldu. İkisi birlikte de iyi çalışır: ince ayardan geçmiş bir model, RAG'in getirdiği pasajlardan şirketin istediği biçimde cevap yazabilir.
İnce ayar neyde iyidir, neyde değildir?
İnce ayar, modele nasıl cevap vereceğini öğretmekte iyi, şu an neyin doğru olduğunu öğretmekte zayıftır. Güçlü yanları:
- Tutarlı çıktı biçimi. Her seferinde aynı JSON alanları ya da sabit bir cevap yapısı.
- Üslup ve kurum dili. Destek ekibinizin ya da markanızın yazış biçimi.
- Dar sınıflandırma ve çıkarma görevleri. Kendi talep kategorileriniz, ürün sınıflandırmanız, tek bir belge türünün alanları.
- Daha kısa prompt, daha küçük model. Talimatlar ağırlıklara taşınır; ince ayardan geçmiş küçük bir model, tek bir görevi büyük bir modelden devralabilir.
Zayıf yanları ise fiyatlar ve politikalar gibi değişen bilgiler, cevabın nereden geldiğini gösterememek ve belirsiz görevlerdir: değerlendiricileriniz etiketlerde anlaşamıyorsa model de bu anlaşmazlığı öğrenir.
Değişmeyen yeni bilgiler bile sorun çıkarır. Gekhman ve arkadaşlarının kontrollü çalışmasında, modelin daha önce bilmediği bilgileri taşıyan örnekler çok daha yavaş öğrenildi; öğrenildikten sonra da modelin halüsinasyon eğilimini, yani yanlış şeyleri kendinden emin biçimde söyleme eğilimini artırdı. Modeller bilgiyi çoğunlukla ön eğitimde edinir; ince ayar onlara bu bilgiyi kullanmayı öğretir.
İnce ayar için hangi veri gerekir?
Modelin karşılaşacağı gerçek girdilere benzeyen ve her biri gönül rahatlığıyla yayına alabileceğiniz bir çıktıyla eşleşmiş örneklere ihtiyacınız var; tutarlılık miktardan önemlidir. Herkese uyan bir sayı yoktur: elle kontrol edebileceğiniz bir setle başlayın, ölçün ve modelin hata yaptığı yerlere örnek ekleyin.
Örnekler genellikle dört kaynaktan gelir:
- Kendi kayıtlarınız. Geçmiş cevaplar, incelenmiş belgeler, kategorilere ayrılmış ürünler; yalnızca kullanma hakkınız olan yerlerde.
- İnsan eliyle etiketleme. Her girdi için doğru çıktıyı insanlar yazar ya da kontrol eder; bu projelerin nasıl yürüdüğünü ve etiketleyiciler arası uyumun nasıl ölçüldüğünü veri etiketleme yazısında anlattık.
- Sentetik örnekler. Daha büyük bir model istendiği anda örnek yazar. Bu örnekler onları üreten modelin hatalarını ve önyargısını kopyalar; bu yüzden insanlar onları gözden geçirmeli, test seti de gerçek kalmalıdır.
- Herkese açık web metni. Modelin hizmet edeceği dillerde ürün açıklamaları, dokümantasyon ve alana özgü diğer metinler.
Eğitimden önce temel modelin lisansını ve her veri kaynağının kullanım şartlarını kontrol edin. Örnekler kişisel veri içeriyorsa eğitim, AB'de GDPR, Türkiye'de 6698 sayılı Kişisel Verilerin Korunması Kanunu (KVKK) kapsamında bir kişisel veri işleme faaliyetidir ve ince ayardan geçmiş model ezberlediğini tekrar edebilir. Avrupa Veri Koruma Kurulu (EDPB), 28/2024 sayılı görüşünde kişisel verilerle eğitilmiş bir modelin anonim sayılıp sayılmayacağının her vaka için ayrı ayrı değerlendirilmesi gerektiğini belirtiyor. En basit koruma, adları, iletişim bilgilerini ve kimlik numaralarını eğitim setine hiç koymamaktır.
Herkese açık web verisi nerede devreye girer?
Alana özgü örnekler çoğu zaman herkese açık web sayfası olarak başlar: bir kategori modeli için ürün açıklamaları ya da beceri etiketleyen bir model için iş ilanları gibi, modelin hizmet edeceği her dilde. Pek çok site dili, para birimini ve ürün yelpazesini ziyaretçinin ülkesine göre değiştirir; tek bir konumdan toplanan veri seti bu yüzden tek taraflı kalır. Residential Proxy kullandığınızda istekler seçtiğiniz ülke ve şehirdeki ev bağlantıları üzerinden gider; böylece yerel ziyaretçilerin gördüğü sürümü toplarsınız. Yalnızca herkese açık sayfaları toplayın, robots.txt'ye ve her sitenin kullanım şartlarına uyun, istek hızını düşük tutun, varsa resmî API'yi kullanın ve metnin eğitimde kullanılıp kullanılamayacağını kontrol edin.
Toplama işini kendiniz yürütmek istemiyorsanız Web Scraping API'miz üzerinden sunduğumuz yönetilen sayfa çıkarma hizmeti için satış ekibimizle görüşebilirsiniz.
İnce ayarın riskleri nelerdir?
İnce ayarın başlıca riski, genellemek yerine ezberleyen, eskiden sahip olduğu becerileri kaybeden ya da testlerde gerçek kullanımda olduğundan iyi görünen bir model elde etmektir; her turdan sonra yeniden çalıştırılan ayrı bir test seti bu sorunların çoğunu yakalar.
- Aşırı öğrenme (overfitting). Model eğitim örneklerini ezberler ve yeni girdilerde daha kötü sonuç verir.
- Yıkıcı unutma (catastrophic forgetting). Yeni bir görevle yapılan eğitim önceki becerileri silebilir; Kirkpatrick ve arkadaşlarının 2017'de ele aldığı, sinir ağlarında bilinen bir sorundur.
- Zayıflayan güvenlik davranışı. Qi ve arkadaşları (2023), zararsız ve yaygın kullanılan veri setleriyle yapılan ince ayarın bile modelin güvenlik eğitimini zayıflatabildiğini buldu.
- Değerlendirme açıkları. Test örnekleri eğitim setine benziyor ya da ondan sızıyorsa puanlar modeli olduğundan iyi gösterir.
- Temel modele bağımlılık. İnce ayardan geçmiş bir model, ancak temel modeli sunulduğu sürece kullanılabilir.
Bir modele nerede ince ayar yapabilirsiniz?
İnce ayarı bir model sağlayıcısının barındırdığı hizmetle ya da açık ağırlıklı bir modeli kendi veya kiraladığınız donanımda eğiterek yapabilirsiniz; sağlayıcıların sundukları da zamanla değişir.
Barındırılan bir hizmette eğitim verisini yüklersiniz; modeli sağlayıcı eğitir ve sunar, ağırlıklar da sağlayıcıda kalır. Google Cloud'un ince ayar dokümantasyonu, bazı Gemini modelleri için denetimli ince ayarı, tercih ayarını ve pekiştirmeli öğrenmeyle ince ayarı listeliyor.
Bu hizmetler kapanabilir de. OpenAI, Mayıs 2026'da self-servis ince ayar platformunu kademeli olarak kapatmaya başladığını duyurdu: kullanımdan kaldırma sayfasına göre aktif müşteriler 6 Ocak 2027'den itibaren yeni ince ayar işi oluşturamayacak. Mevcut ince ayarlı modeller ise temel modelleri kullanımdan kalkana kadar cevap vermeyi sürdürecek.
Açık ağırlıklı modellerde bir lisansla yayımlanmış ağırlıkları indirir, örneğin açık kaynak PEFT kütüphanesiyle LoRA ya da QLoRA uygular ve sonucu elinizde tutarsınız; ama donanımı ve modeli sunmayı da kendiniz üstlenirsiniz.
İnce ayar nerelerde kullanılır?
İnce ayar, tek bir görevin aynı biçimde binlerce kez tekrarlandığı her yerde kullanılır. Destek asistanları kurum dilini, yönlendirme modelleri şirketin kendi talep kategorilerini öğrenir; belge işleme hatları faturalardan aynı alanları sabit bir JSON düzenine aktarır. Online mağazalar ürünlerini kendi sınıflandırmalarıyla etiketler; yazılımcılar da tek bir işi telefonda ya da dizüstü bilgisayarda yürütecek küçük modellere ince ayar yapar.
Sık yapılan hatalar
- İşe ince ayarla başlamak. Örnekli, açık bir prompt ya da RAG, sorunu çoğu zaman daha az zahmetle çözer.
- Değişen bilgileri öğretmeye çalışmak. Fiyatlar, politikalar ve haberler getirme (retrieval) katmanına aittir.
- Ayrı tutulmuş test seti olmaması. Test seti yoksa her eğitim turu ilerleme gibi görünür.
- Tutarlılık yerine miktar. Kontrol edilmemiş, birbiriyle çelişen binlerce örnek modele çelişkileri öğretir.
- Eğitim setinde kişisel veri. İnce ayardan geçmiş model bunu tekrar edebilir.
- Yalnızca hedef görevi test etmek. Genel becerileri ve güvenlik davranışını da kontrol edin.
- Veriyi atmak. Temel modeller kullanımdan kalkar; yeniden ince ayar yapmanız gerekecek.
Karar rehberi
| İhtiyaç | Kullanın |
|---|---|
| İlk prototip | Prompt engineering |
| Güncel belgelerinize dayanan cevaplar | RAG |
| Fiyat, stok, haber ya da politika | RAG ya da canlı sorgu, ince ayar değil |
| Her seferinde aynı çıktı biçimi | Prompt'la başlangıç ölçümünden sonra SFT, çoğu zaman LoRA ile |
| Cevaplarda kurum dili | İncelenmiş geçmiş cevaplarla SFT |
| İnsanların tercih ettiği cevaplar | Tercih ayarı (DPO ya da RLHF) |
| Tek bir dar görev, daha düşük maliyet | Büyük bir modelle karşılaştırılmış, ince ayarlı küçük bir model |
| Sınırlı GPU belleği | Tam ince ayar yerine LoRA ya da QLoRA |
Sıkça sorulan sorular
Fine-tuning mi, RAG mi kullanmalıyım?
Modelde eksik olan bilgiyse RAG'i, davranışsa ince ayarı kullanın. RAG değişen bilgilere ve kaynak göstermeniz gereken belgelere, ince ayar biçime, üsluba ve tekrar eden dar görevlere uygundur. Pek çok sistem ikisini birlikte kullanır.
LoRA fine-tuning nedir?
LoRA ile ince ayar, özgün modeli dondurur ve her katmana eklenen, görevin gerektirdiği değişikliği taşıyan küçük matrisleri eğitir. Tam ince ayara göre çok daha az parametre eğitir ve çok daha az GPU belleği ister; sonuç, göreve göre değiştirilebilen ya da modele katılabilen küçük bir adaptördür.
Bir LLM'e ince ayar yapmak için ne kadar veri gerekir?
Sabit bir sayı yoktur; örneklerin doğru, tutarlı ve gerçek girdilere yakın olması gerekir. LIMA çalışması genel amaçlı bir asistanı özenle seçilmiş 1.000 örnekle biçimlendirdi. Dar bir görevde elle kontrol edebileceğiniz bir setle başlayın ve ayrı tutulmuş testte modelin hâlâ hata yaptığı yerlere örnek ekleyin.
ChatGPT'ye ya da başka barındırılan modellere ince ayar yapabilir miyim?
Yalnızca sağlayıcının geliştirici platformu üzerinden ve yalnızca sağlayıcının ince ayara açtığı modellerde yapabilirsiniz; sohbet uygulamalarının içinde bu yapılmaz. Google Cloud bazı Gemini modelleri için ince ayar sunuyor; OpenAI ise aktif müşterilerin yeni self-servis ince ayar işi oluşturmasını 6 Ocak 2027'de durduruyor. İnce ayarlı ağırlıkları elinizde tutmanız gerekiyorsa seçenek açık ağırlıklı modellerdir.
İnce ayar ile ön eğitim arasındaki fark nedir?
Ön eğitim modele dili ve genel bilgiyi çok büyük bir derlem üzerinde sıfırdan öğretir; ince ayar ise önceden eğitilmiş bir modeli küçük, odaklı bir veri setiyle ayarlar. Ön eğitim bir model geliştiricisinin kaynaklarını gerektirir; ince ayar ise sıradan bir ekibin de yapabileceği bir iştir.
İnce ayar modele yeni bilgi öğretir mi?
Ancak zayıf biçimde ve bir bedel karşılığında. Modeller ince ayarla yeni bilgileri, zaten bildiklerine göre çok daha yavaş öğrenir ve öğrendikten sonra daha fazla halüsinasyon üretir. Bilgileri modelin getirdiği belgelere koyun, ince ayarı cevap verme biçimi için kullanın.
Özet
Fine-tuning (ince ayar), var olan bir modeli küçük bir örnek setiyle eğitmeye devam ederek ona bir davranış öğretir: bir biçim, bir üslup, dar bir görev. SFT ideal cevaplardan, tercih ayarı insanların seçimlerinden öğretir; LoRA ise bu işi mütevazı bir donanıma sığdırır. İnce ayar güncel bilgiyi güvenilir biçimde eklemez; bu, RAG'in işidir. Prompt'la başlayın, bilgi için getirmeyi (retrieval) ekleyin, davranış için ince ayar yapın; veri setini de kullanma hakkınız olan kaynaklardan, modelinizin hizmet edeceği dillerde ve ülkelerde kurun.


