


































Der Prompt eines Support-Teams ist auf drei Seiten angewachsen: Tonregeln, das JSON-Format für Ticket-Tags, dreißig Beispielantworten. Jede Anfrage bezahlt diese Tokens mit, und trotzdem fällt der Assistent ab und zu aus dem Format. Ein Ingenieur schlägt vor, das Modell per Fine-Tuning mit den bisherigen Antworten des Teams anzupassen; ein anderer meint, der Assistent brauche stattdessen RAG. Beide können recht haben, für verschiedene Teile des Problems.
Dieser Beitrag erklärt, was Fine-Tuning ist, welche Hauptmethoden es gibt (SFT, RLHF, DPO und LoRA), wie es sich von Prompting und RAG unterscheidet, welche Daten es braucht, welche Risiken es hat und wo Sie heute ein Modell feinabstimmen können.
Was ist Fine-Tuning?
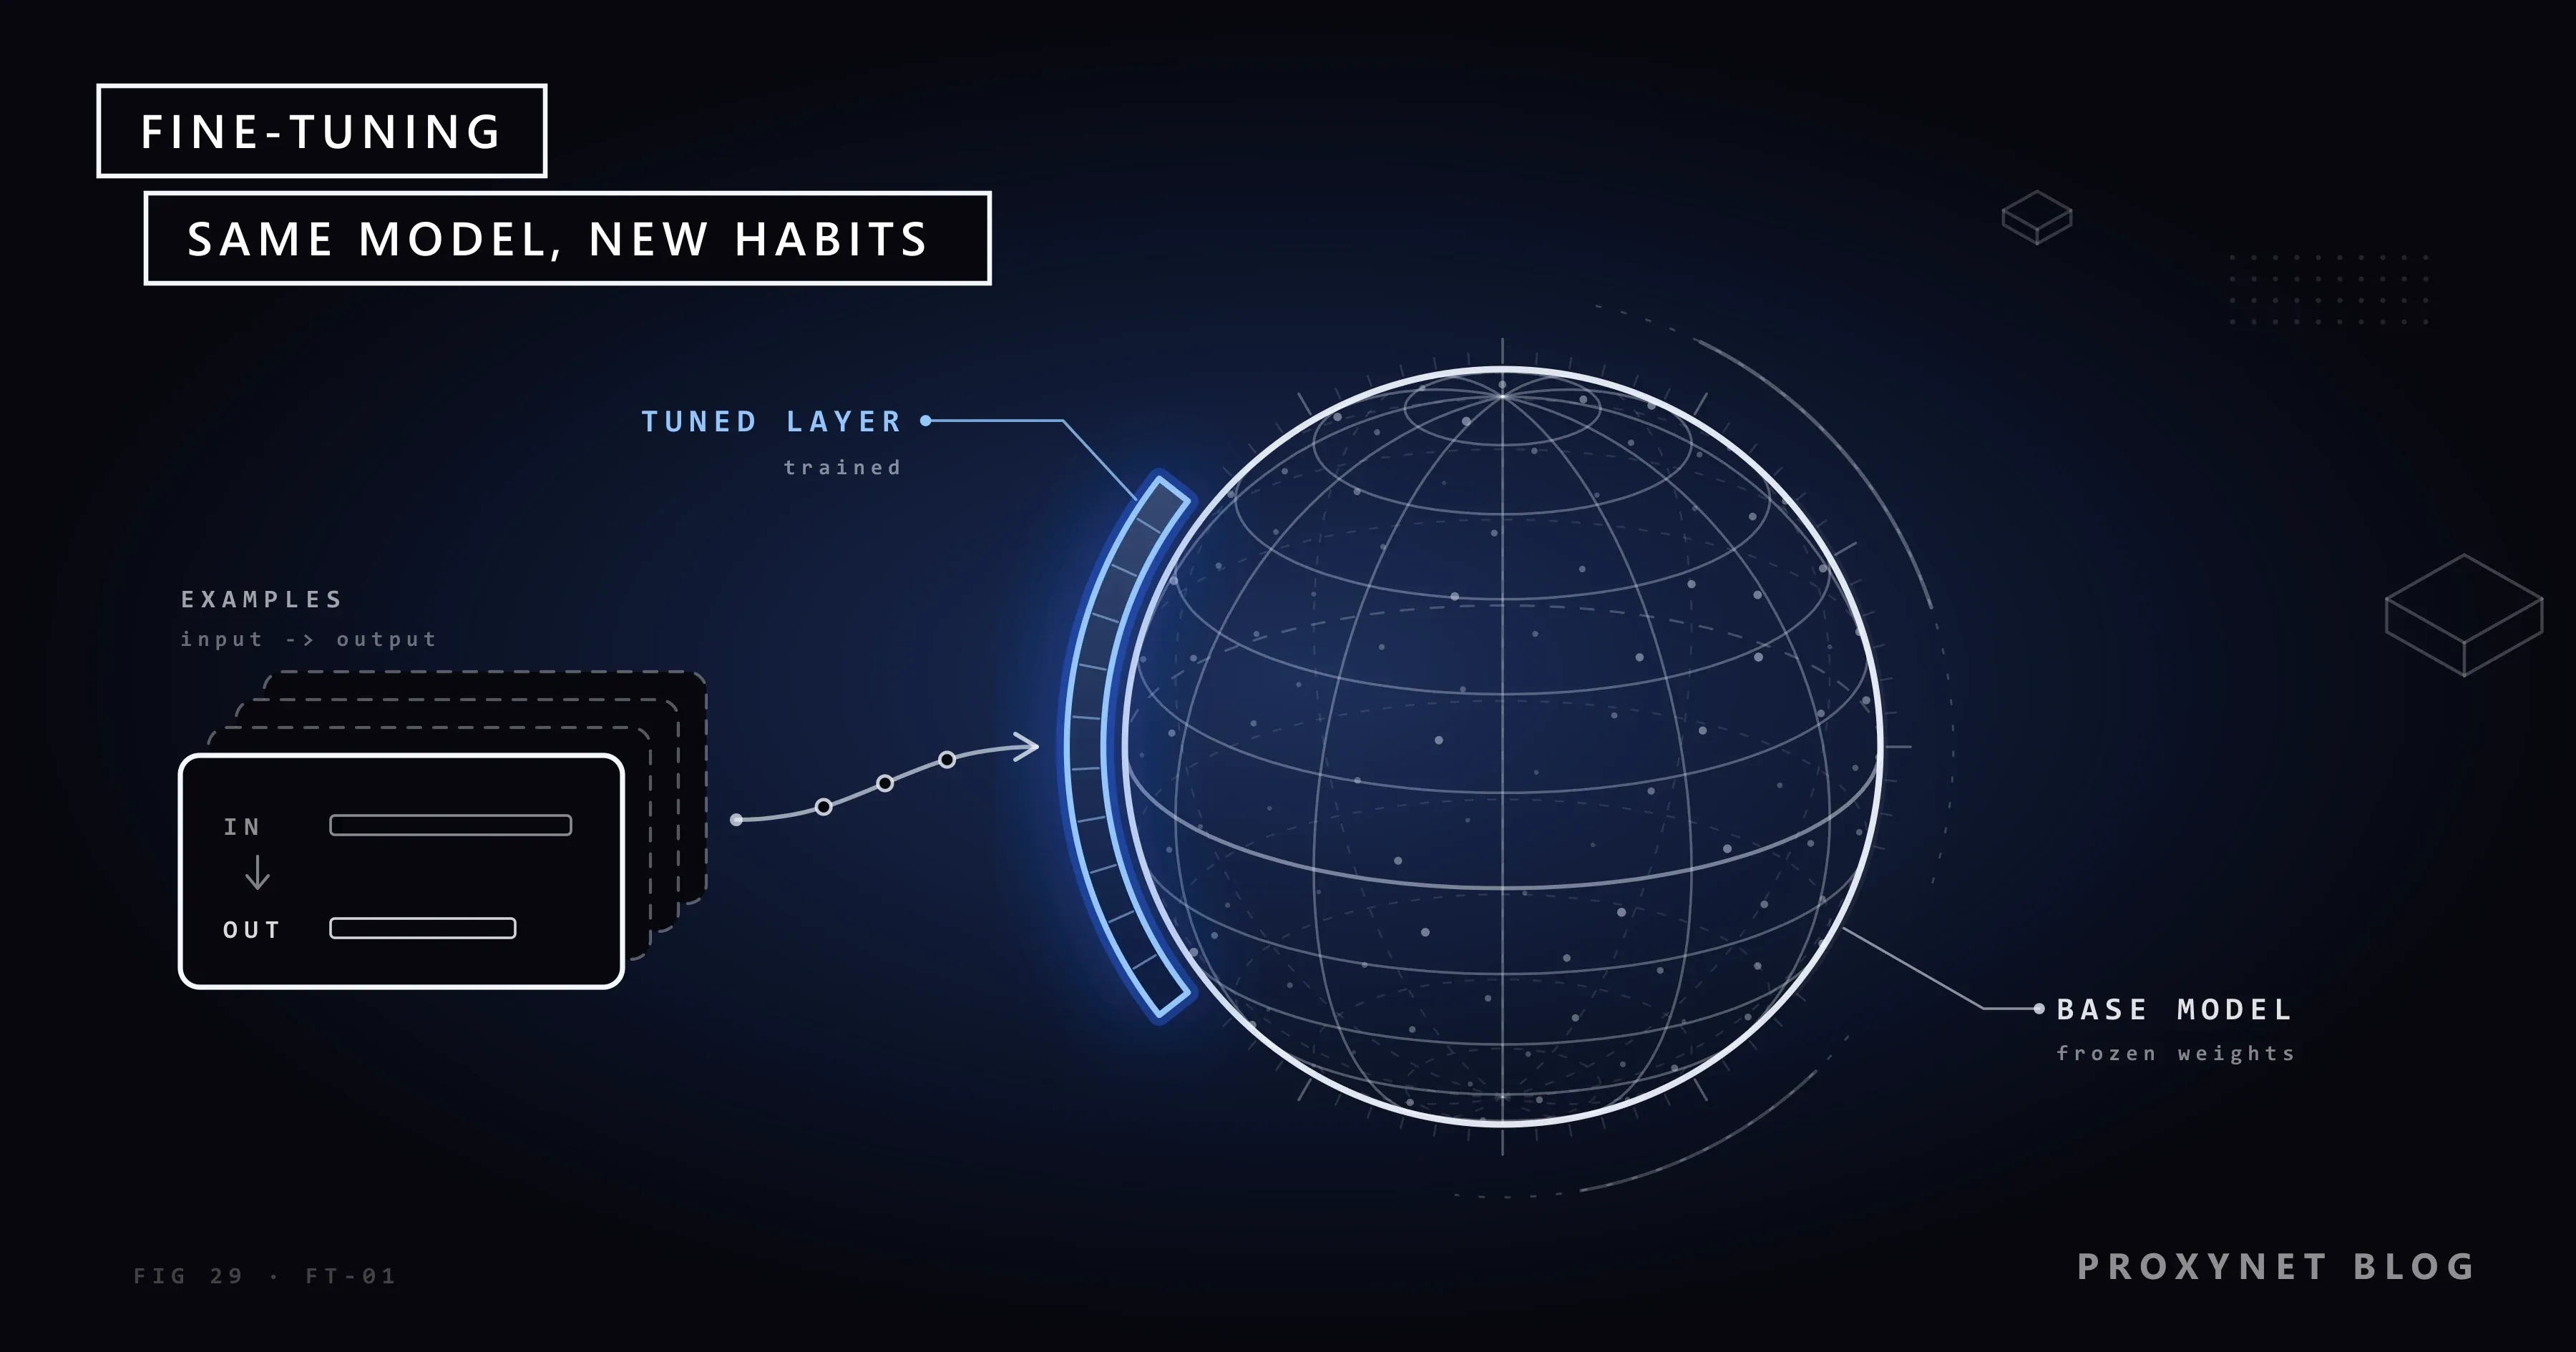
Fine-Tuning heißt, ein bereits trainiertes Modell mit einem kleineren, aufgabenspezifischen Satz von Beispielen weiterzutrainieren, sodass sich sein Verhalten in Richtung dieser Aufgabe verschiebt. Die Parameter des Modells, also die Milliarden Zahlen (Gewichte), die es beim Lernen anpasst, starten dort, wo das frühere Training sie hinterlassen hat. Deshalb braucht Fine-Tuning nur einen kleinen Bruchteil der ursprünglichen Daten und Rechenleistung.
Das Ausgangsmodell heißt Basismodell oder vortrainiertes Modell. Bei Textaufgaben ist es meist ein großes Sprachmodell (LLM), ein Modell, das mit riesigen Textmengen darauf trainiert wurde, das nächste Textstück vorherzusagen; unser Leitfaden dazu, wie LLMs funktionieren, beschreibt diese erste Stufe. Fine-Tuning ist eine Form des Transferlernens (Transfer Learning): Was ein Modell bei einer Aufgabe gelernt hat, wird für eine andere wiederverwendet.
Zum Standard wurde das Vorgehen um 2018, als die Autoren von BERT zeigten, dass sich ein einziges vortrainiertes Modell mit nur einer zusätzlichen Ausgabeschicht für viele Aufgaben feinabstimmen lässt. Außerhalb der KI bezeichnet „Fine-Tuning“ auch ein Argument der Kosmologie (die Feinabstimmung der Naturkonstanten); dieser Beitrag handelt nur von Modellen.
Wie unterscheidet sich Fine-Tuning vom Vortraining?
Das Vortraining baut das allgemeine Wissen eines Modells von Grund auf mit einem riesigen Textkorpus auf, während Fine-Tuning das Verhalten des fertig trainierten Modells mit einem viel kleineren, sorgfältig zusammengestellten Datensatz anpasst. Im Vortraining (Pretraining) liest das Modell Bücher, Code und Webseiten und lernt, das nächste Token vorherzusagen, also ein Wort oder einen Wortteil. Es ist die teure Stufe, und sie wird von den Organisationen durchgeführt, die Basismodelle bauen.
Die beiden Stufen vermitteln Unterschiedliches. In der LIMA-Studie wurde ein LLaMA-Modell mit 65 Milliarden Parametern mit nur 1.000 sorgfältig ausgewählten Prompts und Antworten feinabgestimmt, und die Autoren folgerten, dass fast das gesamte Wissen großer Sprachmodelle im Vortraining gelernt wird; Fine-Tuning prägt vor allem, wie es in den Antworten zum Vorschein kommt. Dazwischen liegt das fortgesetzte Vortraining (Continued Pretraining): mehr nicht annotierter Text aus einem Fachgebiet, mit demselben Ziel, das nächste Token vorherzusagen.
Wie läuft Fine-Tuning Schritt für Schritt ab?
Fine-Tuning läuft als Schleife: Aufgabe und Test festlegen, Beispiele vorbereiten, trainieren, das Ergebnis mit dem Test vergleichen und wiederholen.
- Aufgabe und Test festlegen. Sammeln Sie vor jedem Training echte Eingaben mit den Ausgaben, die Sie erwarten; ohne sie können Sie nicht beurteilen, ob das Fine-Tuning geholfen hat.
- Eine Prompting-Baseline messen. Lassen Sie den Test mit einem klaren Prompt und einigen Beispielen gegen das Basismodell laufen. Besteht es den Test, hören Sie hier auf.
- Ein Basismodell wählen. Ein gehostetes Modell mit Tuning-Dienst oder ein Open-Weight-Modell, das Sie selbst betreiben.
- Beispiele sammeln und annotieren. Jedes Beispiel verbindet eine Eingabe mit der gewünschten Ausgabe, meist gespeichert als JSONL, ein JSON-Objekt pro Zeile, ohne Duplikate und ohne personenbezogene Daten.
- Die Daten aufteilen. Ein Trainings-, ein Validierungs- und ein zurückgehaltener Testdatensatz, den das Modell nie sieht.
- Trainieren. Wählen Sie vollständiges oder parametereffizientes Fine-Tuning, einige Durchläufe über die Daten (Epochen) und eine Lernrate. Steigt der Validierungsverlust, während der Trainingsverlust sinkt, lernt das Modell auswendig.
- Bewerten. Vergleichen Sie das Testergebnis mit der Baseline und prüfen Sie auch allgemeine Fähigkeiten und Sicherheit.
- Bereitstellen und überwachen. Nehmen Sie echte Fehlschläge in die nächste Runde auf.
Was sind SFT, RLHF und DPO?
SFT, überwachtes Fine-Tuning (Supervised Fine-Tuning), trainiert ein Modell mit Paaren aus einer Eingabe und der idealen Ausgabe; RLHF und DPO sind Präferenz-Tuning, das aus menschlichen Urteilen darüber lernt, welche Antwort besser ist. Die meisten Projekte nutzen SFT, und Präferenz-Tuning folgt in der Regel danach.
Überwachtes Fine-Tuning (SFT). Die Paare können eine Kundenfrage und die beste Antwort sein oder eine Rechnung und die daraus extrahierten Felder. „Überwacht“ bedeutet, dass jedes Beispiel die richtige Antwort enthält, von einem Menschen geschrieben oder geprüft. Instruction Tuning ist SFT mit einer breiten Mischung von Aufgaben; es macht aus einem Basismodell, das nur Text fortsetzt, einen Assistenten, der Anfragen befolgt.
RLHF, bestärkendes Lernen aus menschlichem Feedback, wurde im InstructGPT-Paper von Ouyang und Kollegen (2022) beschrieben. Annotatoren schrieben Musterantworten für das SFT von GPT-3 und brachten dann mehrere Ausgaben pro Prompt in eine Rangfolge; ein Belohnungsmodell (Reward Model) lernte diese Rangfolgen, und bestärkendes Lernen stimmte das Modell darauf ab. Die Bewerter zogen das InstructGPT mit 1,3 Milliarden Parametern dem GPT-3 mit 175 Milliarden Parametern vor.
DPO, Direct Preference Optimization (direkte Präferenzoptimierung; Rafailov und Kollegen, 2023), erreicht dasselbe Ziel ohne Belohnungsmodell und ohne bestärkendes Lernen und trainiert direkt auf Paaren aus einer bevorzugten und einer abgelehnten Antwort.
Was ist LoRA, und was ist parametereffizientes Fine-Tuning?
Parametereffizientes Fine-Tuning (PEFT) friert fast alle Gewichte eines Modells ein und trainiert eine kleine Zahl neuer Gewichte; LoRA, kurz für Low-Rank Adaptation, ist das bekannteste Verfahren dafür. Vollständiges Fine-Tuning dagegen aktualisiert jedes Gewicht und erzeugt für jede Aufgabe eine vollständige Kopie des Modells.
LoRA, beschrieben von Hu und Kollegen im LoRA-Paper (2021), lässt die vortrainierten Gewichte eingefroren und trainiert nur Paare kleiner Matrizen, die jeder Schicht des Transformers hinzugefügt werden, also der Netzarchitektur, auf der LLMs aufbauen. „Low-Rank“ (niedriger Rang) bedeutet, dass die Änderung an jeder großen Gewichtstabelle als zwei schmale Tabellen geschrieben wird, deren Produkt sie annähert.
Gegenüber dem vollständigen Fine-Tuning des GPT-3 mit 175 Milliarden Parametern berichten die Autoren von 10.000-mal weniger trainierbaren Parametern und dreimal weniger GPU-Speicher, bei gleicher oder besserer Qualität auf den getesteten Modellen und ohne langsamere Antworten, sobald die Matrizen in die Gewichte eingerechnet sind. QLoRA (Dettmers und Kollegen, 2023) speichert das eingefrorene Basismodell mit 4-Bit-Genauigkeit; das reichte, um ein Modell mit 65 Milliarden Parametern auf einer einzigen GPU mit 48 GB feinabzustimmen.
Ein Basismodell kann so mehrere Aufgaben bedienen, jede mit ihrem eigenen kleinen Adapter. Mit LoRa, der Funktechnik für große Reichweiten, hat LoRA nichts zu tun.
Fine-Tuning vs. RAG vs. Prompt Engineering: Was ist der Unterschied?
Prompt Engineering ändert die Anweisungen, die Sie senden, RAG ändert die Informationen, die das Modell zum Zeitpunkt der Frage sieht, und Fine-Tuning ändert das Modell selbst. Sie lösen verschiedene Probleme und werden oft kombiniert.
| Frage | Prompt Engineering | RAG | Fine-Tuning |
|---|---|---|---|
| Was ändert sich? | Die Anweisungen | Der Kontext pro Frage | Die Gewichte des Modells |
| Benötigte Daten | Einige Beispiele | Ein Dokumentenindex | Kuratierte Eingabe-Ausgabe-Paare |
| Aufwand für den Start | Gering | Mittel | Hoch |
| Neue Fakten | Nur, wenn eingefügt | Ja, Quelle neu indexieren | Nein, erfordert neues Training |
| Zeigt Quellen | Nein | Ja | Nein |
| Geeignet für | Prototypen, einfache Aufgaben | Wissen, das sich ändert | Format, Ton, eng umrissene Aufgaben |
Bei RAG, der abrufgestützten Generierung, findet ein Retriever in einem Index von Dokumenten die Passagen, die für eine Frage am relevantesten sind; die Passagen kommen in den Prompt, und das Modell antwortet auf ihrer Grundlage. Sind die Dokumente Webseiten, besteht die meiste Arbeit darin, sie aufzubereiten. Das behandeln wir in Web Scraping für RAG.
Für Wissen wurden beide direkt verglichen: Ovadia und Kollegen (2023) fanden, dass RAG unüberwachtes Fine-Tuning durchweg übertraf, sowohl bei Fakten, die das Modell im Training gesehen hatte, als auch bei völlig neuen. Beide lassen sich auch gut kombinieren, denn ein feinabgestimmtes Modell kann im hauseigenen Format aus Passagen antworten, die RAG abruft.
Wofür eignet sich Fine-Tuning, und wofür nicht?
Fine-Tuning eignet sich gut, um einem Modell beizubringen, wie es antworten soll, und schlecht, um ihm beizubringen, was gerade wahr ist. Seine Stärken:
- Ein einheitliches Ausgabeformat. Jedes Mal dieselben JSON-Felder oder eine feste Antwortstruktur.
- Ton und Hausstil. Die Art, wie Ihr Support-Team oder Ihre Marke schreibt.
- Eng umrissene Klassifikation und Extraktion. Ihre Ticketkategorien, Ihre Produkttaxonomie, die Felder eines Dokumenttyps.
- Kürzere Prompts, kleinere Modelle. Anweisungen wandern in die Gewichte, und ein kleines feinabgestimmtes Modell kann eine Aufgabe von einem großen übernehmen.
Schwach ist es bei Fakten, die sich ändern, etwa Preisen und Richtlinien, beim Nachweis, woher eine Antwort stammt, und bei vagen Aufgaben: Sind sich Ihre Prüfer bei den Labels uneinig, lernt das Modell die Uneinigkeit.
Selbst stabile neue Fakten sind ein Problem. In einer kontrollierten Studie stellten Gekhman und Kollegen fest, dass Beispiele mit Fakten, die das Modell noch nicht kannte, viel langsamer gelernt wurden und, einmal gelernt, seine Neigung zu halluzinieren verstärkten, also Falsches mit Überzeugung zu behaupten. Modelle erwerben Faktenwissen größtenteils im Vortraining; Fine-Tuning bringt ihnen bei, es zu nutzen.
Welche Daten brauchen Sie für Fine-Tuning?
Sie brauchen Beispiele, die den echten Eingaben ähneln, die das Modell erhalten wird, jeweils gepaart mit einer Ausgabe, die Sie guten Gewissens ausliefern würden; Konsistenz zählt mehr als Menge. Eine allgemeingültige Zahl gibt es nicht. Beginnen Sie deshalb mit einem Satz, den Sie von Hand prüfen können, messen Sie und ergänzen Sie Beispiele dort, wo das Modell scheitert.
Beispiele stammen meist aus vier Quellen:
- Eigene Datenbestände. Frühere Antworten, geprüfte Dokumente, kategorisierte Produkte, nur dort genutzt, wo Sie das Recht dazu haben.
- Menschliches Labeling. Menschen schreiben oder prüfen für jede Eingabe die richtige Ausgabe; der Beitrag Was ist Daten-Labeling? erklärt, wie solche Projekte ablaufen und wie die Übereinstimmung zwischen Annotatoren gemessen wird.
- Synthetische Beispiele. Ein größeres Modell schreibt sie auf Abruf. Sie übernehmen die Fehler und Verzerrungen des Generators; deshalb sollten Menschen sie prüfen, und der Testdatensatz sollte echt bleiben.
- Öffentlicher Webtext. Produktbeschreibungen, Dokumentationen und anderer Fachtext in den Sprachen, die das Modell bedienen soll.
Prüfen Sie vor dem Training die Lizenz des Basismodells und die Nutzungsbedingungen jeder Datenquelle. Enthalten die Beispiele personenbezogene Daten, ist das Training eine Verarbeitung im Sinne der Datenschutz-Grundverordnung (DSGVO) in der EU und des Gesetzes Nr. 6698 über den Schutz personenbezogener Daten (KVKK) in Türkiye, und ein feinabgestimmtes Modell kann wiedergeben, was es auswendig gelernt hat. Der Europäische Datenschutzausschuss (EDSA) hält in seiner Stellungnahme 28/2024 fest, dass im Einzelfall geprüft werden muss, ob ein mit personenbezogenen Daten trainiertes Modell anonym ist. Der einfachste Schutz besteht darin, Namen, Kontaktdaten und Ausweisnummern gar nicht erst aufzunehmen.
Wo kommen öffentliche Webdaten ins Spiel?
Fachbeispiele beginnen oft als öffentliche Webseiten, etwa Produktbeschreibungen für ein Kategorisierungsmodell oder Stellenanzeigen für ein Modell, das Kompetenzen verschlagwortet, und zwar in jeder Sprache, die das Modell bedienen soll. Viele Websites ändern Sprache, Währung und Sortiment je nach Land des Besuchers; wer nur von einem Standort aus sammelt, erhält deshalb einen einseitigen Datensatz. Ein Residential-Proxy leitet Anfragen über private Internetanschlüsse in dem Land und der Stadt Ihrer Wahl, sodass Sie die Version erheben, die lokale Besucher sehen. Erheben Sie nur öffentliche Seiten, beachten Sie robots.txt und die Nutzungsbedingungen jeder Website, halten Sie die Anfragerate niedrig, nutzen Sie eine offizielle API, wo es eine gibt, und prüfen Sie, ob der Text für Training verwendet werden darf.
Teams, die die Erhebung lieber nicht selbst betreiben, können mit unserem Vertriebsteam über die verwaltete Seitenextraktion unserer Web Scraping API sprechen.
Welche Risiken hat Fine-Tuning?
Das Hauptrisiko ist ein Modell, das auswendig lernt statt zu verallgemeinern, Fähigkeiten verliert, die es hatte, oder in Ihren Tests besser aussieht als im echten Einsatz; ein separater Testdatensatz, der nach jeder Runde erneut läuft, fängt die meisten dieser Probleme ab.
- Überanpassung (Overfitting). Das Modell lernt die Trainingsbeispiele auswendig und schneidet bei neuen Eingaben schlechter ab.
- Katastrophales Vergessen (Catastrophic Forgetting). Training auf einer neuen Aufgabe kann frühere Fähigkeiten löschen, ein bekanntes Problem neuronaler Netze, das Kirkpatrick und Kollegen 2017 angegangen sind.
- Schwächeres Sicherheitsverhalten. Qi und Kollegen (2023) stellten fest, dass schon Fine-Tuning mit harmlosen, gängigen Datensätzen das Sicherheitstraining eines Modells schwächen kann.
- Lücken in der Bewertung. Ähneln Testbeispiele dem Trainingsdatensatz oder sickern sie aus ihm durch, schmeicheln die Ergebnisse dem Modell.
- Abhängigkeit vom Basismodell. Ein feinabgestimmtes Modell bleibt nur so lange nutzbar, wie sein Basismodell angeboten wird.
Wo können Sie ein Modell feinabstimmen?
Sie können über den gehosteten Tuning-Dienst eines Anbieters feinabstimmen oder ein Open-Weight-Modell auf eigener oder gemieteter Hardware trainieren; die Angebote der Anbieter ändern sich mit der Zeit.
Bei einem gehosteten Dienst laden Sie Trainingsdaten hoch, der Anbieter trainiert und betreibt das feinabgestimmte Modell, und die Gewichte bleiben beim Anbieter. Die Tuning-Dokumentation von Google Cloud nennt für einige Gemini-Modelle überwachtes Fine-Tuning, Präferenz-Tuning und Fine-Tuning mit bestärkendem Lernen.
Angebote werden auch eingestellt. OpenAI hat im Mai 2026 angekündigt, sein Self-Service-Fine-Tuning auslaufen zu lassen: Laut seiner Seite zu Abkündigungen können aktive Kunden ab dem 6. Januar 2027 keine neuen Jobs mehr anlegen, und bestehende feinabgestimmte Modelle antworten weiter, bis ihre Basismodelle eingestellt werden.
Bei Open-Weight-Modellen laden Sie Gewichte herunter, die unter einer Lizenz veröffentlicht sind, stimmen sie mit LoRA oder QLoRA fein, zum Beispiel mit der Open-Source-Bibliothek PEFT, und behalten das Ergebnis; dafür betreiben Sie aber auch Hardware und Bereitstellung selbst.
Wo wird Fine-Tuning eingesetzt?
Fine-Tuning wird überall dort eingesetzt, wo sich eine Aufgabe tausendfach in derselben Form wiederholt. Support-Assistenten lernen den Hausstil, Routing-Modelle lernen die Ticketkategorien eines Unternehmens, und Pipelines zur Dokumentverarbeitung übertragen dieselben Felder aus Rechnungen in ein festes JSON-Layout. Onlineshops verschlagworten Produkte mit ihrer eigenen Taxonomie, und Entwickler stimmen kleine Modelle so ab, dass sie eine einzelne Aufgabe auf einem Smartphone oder Laptop erledigen.
Häufige Fehler
- Mit Fine-Tuning anfangen. Ein klarer Prompt mit Beispielen oder RAG löst das Problem oft mit weniger Aufwand.
- Fakten beibringen, die sich ändern. Preise, Richtlinien und Nachrichten gehören in den Abruf (Retrieval).
- Kein zurückgehaltener Testdatensatz. Ohne ihn sieht jeder Trainingslauf wie ein Fortschritt aus.
- Menge vor Konsistenz. Tausende ungeprüfte, widersprüchliche Beispiele bringen dem Modell die Widersprüche bei.
- Personenbezogene Daten im Trainingsdatensatz. Ein feinabgestimmtes Modell kann sie wiedergeben.
- Nur die Zielaufgabe testen. Prüfen Sie auch allgemeine Fähigkeiten und das Sicherheitsverhalten.
- Die Daten wegwerfen. Basismodelle werden eingestellt, und Sie werden erneut feinabstimmen müssen.
Entscheidungshilfe
| Bedarf | Lösung |
|---|---|
| Ein erster Prototyp | Prompt Engineering |
| Antworten aus Ihren aktuellen Dokumenten | RAG |
| Preise, Bestand, Nachrichten oder Richtlinien | RAG oder eine Live-Abfrage, kein Fine-Tuning |
| Jedes Mal dasselbe Ausgabeformat | SFT, oft mit LoRA, nach einer Prompt-Baseline |
| Ihr Hausstil in Antworten | SFT mit geprüften früheren Antworten |
| Antworten, die Menschen bevorzugen | Präferenz-Tuning (DPO oder RLHF) |
| Eine eng umrissene Aufgabe zu geringeren Kosten | Ein feinabgestimmtes kleineres Modell, gegen ein großes getestet |
| Begrenzter GPU-Speicher | LoRA oder QLoRA statt vollständigem Fine-Tuning |
Häufige Fragen
Sollte ich Fine-Tuning oder RAG nutzen?
Nutzen Sie RAG, wenn dem Modell Wissen fehlt, und Fine-Tuning, wenn ihm ein Verhalten fehlt. RAG passt zu Fakten, die sich ändern, und zu Dokumenten, die Sie belegen müssen; Fine-Tuning passt zu Formaten, Ton und eng umrissenen, wiederkehrenden Aufgaben. Viele Systeme nutzen beides.
Was ist LoRA-Fine-Tuning?
LoRA-Fine-Tuning friert das ursprüngliche Modell ein und trainiert kleine zusätzliche Matrizen in jeder Schicht, die die Änderung erfassen, die die Aufgabe braucht. Es trainiert weit weniger Parameter und braucht viel weniger GPU-Speicher als vollständiges Fine-Tuning; das Ergebnis ist ein kleiner Adapter, der sich pro Aufgabe austauschen oder in das Modell einrechnen lässt.
Wie viele Daten brauche ich für das Fine-Tuning eines LLM?
Eine feste Zahl gibt es nicht; die Beispiele müssen korrekt, konsistent und nah an echten Eingaben sein. Die LIMA-Studie formte einen allgemeinen Assistenten mit 1.000 kuratierten Beispielen. Beginnen Sie bei einer eng umrissenen Aufgabe mit einem Satz, den Sie von Hand prüfen können, und ergänzen Sie Beispiele dort, wo der zurückgehaltene Test noch scheitert.
Kann ich ChatGPT oder andere gehostete Modelle feinabstimmen?
Nur über die Entwicklerplattform eines Anbieters und nur für die Modelle, die der Anbieter für das Tuning freigibt, nicht in den Chat-Apps. Google Cloud bietet Tuning für einige Gemini-Modelle an, während OpenAI neue Self-Service-Fine-Tuning-Jobs für aktive Kunden am 6. Januar 2027 beendet. Wenn Sie die feinabgestimmten Gewichte behalten müssen, sind Open-Weight-Modelle die Alternative.
Was ist der Unterschied zwischen Fine-Tuning und Vortraining?
Das Vortraining bringt einem Modell Sprache und Allgemeinwissen von Grund auf mit einem sehr großen Korpus bei; Fine-Tuning passt ein bereits vortrainiertes Modell mit einem kleinen, fokussierten Datensatz an. Vortraining erfordert die Ressourcen eines Modellherstellers, Fine-Tuning liegt dagegen in Reichweite eines gewöhnlichen Teams.
Bringt Fine-Tuning dem Modell neue Fakten bei?
Nur schlecht, und mit Nebenwirkungen. Modelle lernen neue Fakten beim Fine-Tuning viel langsamer als bekannte und halluzinieren mehr, sobald sie sie gelernt haben. Legen Sie Fakten in Dokumenten ab, die das Modell abruft, und nutzen Sie Fine-Tuning für die Art, wie es antwortet.
Fazit
Fine-Tuning trainiert ein vorhandenes Modell mit einem kleinen Satz von Beispielen weiter, damit es ein Verhalten lernt: ein Format, einen Ton, eine eng umrissene Aufgabe. SFT lernt aus idealen Antworten, Präferenz-Tuning aus den Entscheidungen von Menschen, und LoRA macht das Ganze auf bescheidener Hardware möglich. Neue Fakten fügt es nicht zuverlässig hinzu; das ist die Aufgabe von RAG. Beginnen Sie mit einem Prompt, ergänzen Sie den Abruf für Wissen, nutzen Sie Fine-Tuning für Verhalten und bauen Sie den Datensatz aus Quellen auf, die Sie nutzen dürfen, in den Sprachen und Ländern, die Ihr Modell bedienen soll.


