Sie brauchen einen echten Browser aus Node.js heraus: Die Seite, die Sie lesen wollen, baut ihren Inhalt mit JavaScript auf, oder ein HTML-Bericht soll zum PDF werden. Zwei Namen fallen zuerst, Puppeteer und Playwright. Beide sind kostenlos, und ihre APIs sehen sich ähnlich (page.goto(), page.click(), page.pdf()), die Syntax gibt also nicht den Ausschlag. Die Wahl hängt davon ab, welche Browser und Sprachen Sie brauchen, wie der Proxy gesetzt wird und was Sie von Testwerkzeugen und Werkzeugen für KI-Agenten erwarten.
Dieser Beitrag vergleicht die beiden bei Browsern und Protokoll, Sprachen, Warten, Proxy-Konfiguration, Testwerkzeugen und MCP-Servern. Dieselbe Aufgabe haben wir in beiden ausgeführt, mit Puppeteer 25.12.0 (Chrome for Testing 154) und Playwright 1.63.0 (Chromium 153) unter Node.js 24 und Windows 11, über einen lokalen Proxy, der Benutzername und Passwort verlangt. Welches Werkzeug Websites weniger bemerken, ist hier kein Thema: Beide steuern einen echten Browser, und die Regeln der Website einzuhalten ist in beiden Ihre Aufgabe.
Was sind Puppeteer und Playwright?
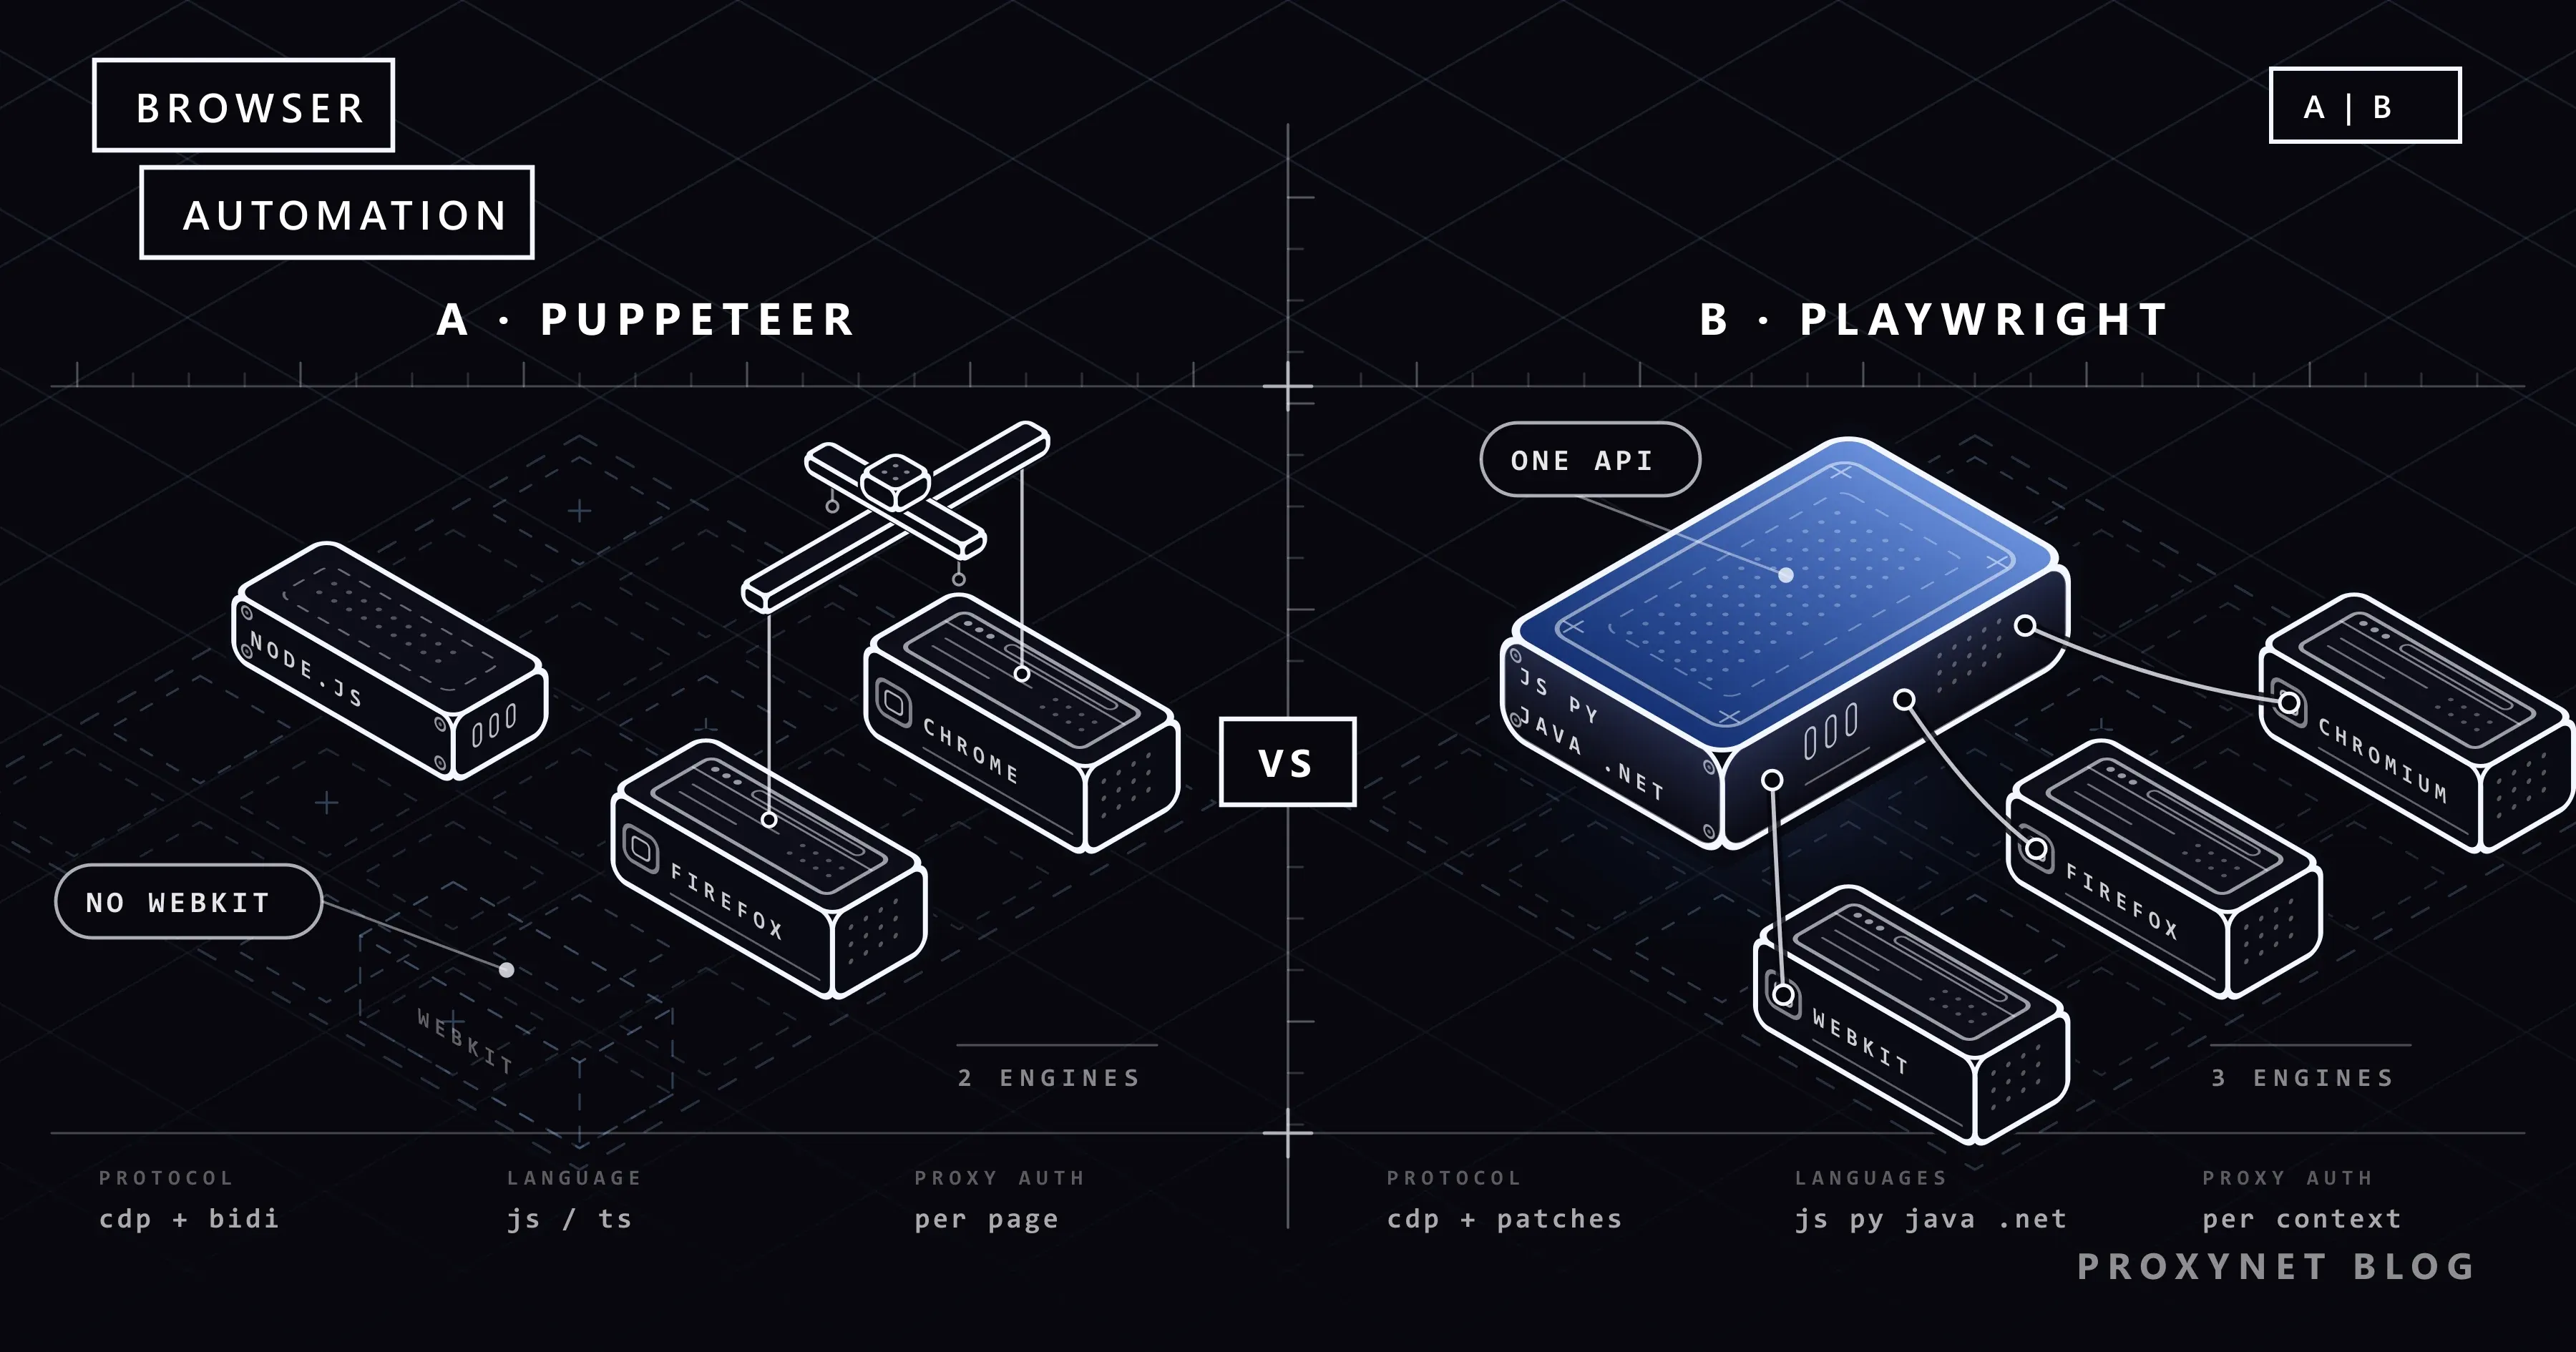
Puppeteer ist eine JavaScript-Bibliothek mit einer High-Level-API zur Steuerung von Chrome oder Firefox. Sie läuft unter Node.js und hat in keiner anderen Sprache eine offizielle Bibliothek; Python-Portierungen gibt es, doch das sind Projekte Dritter. npm i puppeteer lädt außerdem einen passenden Build von Chrome for Testing und das kleinere Programm chrome-headless-shell nach ~/.cache/puppeteer herunter, während puppeteer-core dieselbe Bibliothek ohne diesen Download ist.
Playwright ist die quelloffene Automatisierungsbibliothek von Microsoft. Sie steuert Chromium, Firefox und WebKit, die Engine hinter Safari, über eine einzige API, mit offiziellen Bibliotheken für JavaScript und TypeScript, Python, Java und .NET. Daneben steht Playwright Test, ein Test-Runner mit Assertions und parallelen Läufen. Die Browser sind ein eigener Schritt: npx playwright install chromium lädt den Build herunter, der an Ihre Playwright-Version gebunden ist.
Beide sind für Seiten gedacht, deren Inhalt erst erscheint, wenn JavaScript gelaufen ist. Steht die Information schon im Quelltext der Seite oder an einem JSON-Endpunkt, braucht ein einfacher HTTP-Client weit weniger Speicher.
Wie sprechen sie mit dem Browser?
Das Protokoll unter jedem Werkzeug erklärt den größten Teil seines Verhaltens. Ein Puppeteer-Skript läuft so ab:
puppeteer.launch()startet Chrome for Testing aus dem Cache oder Firefox, wenn Siebrowser: "firefox"übergeben.- Puppeteer verbindet sich über das Chrome DevTools Protocol (CDP), das eigene Debugging-Protokoll von Chrome, oder über WebDriver BiDi, den W3C-Standard für bidirektionale Browser-Automatisierung.
- Jeder Aufruf wie
page.goto()wird zu einer Folge von Protokollnachrichten. - Ereignisse kommen zurück, ohne dass Sie danach fragen: Anfragen, Antworten, Konsolenmeldungen, Dialoge.
Die WebDriver-BiDi-Seite von Puppeteer erklärt die Aufteilung: BiDi ist der Standard für Firefox, während Chrome bei CDP bleibt, weil noch nicht jede CDP-Funktion in BiDi existiert. Seit Version 23 arbeitet Puppeteer mit der stabilen Firefox-Version statt mit einem Spezial-Build.
Auch Playwright spricht CDP mit Chromium. Für Firefox und WebKit liefert es gepatchte Builds mit, und seine Dokumentation hält fest, dass es mit dem markengebundenen Firefox oder Safari nicht funktioniert, weil es auf diese Patches angewiesen ist; Google Chrome und Microsoft Edge stehen über die Option channel bereit. In Python, Java und .NET läuft jeder Aufruf über einen Node.js-Treiber, der im Paket enthalten ist, sodass sich die Browserseite in jeder Sprache gleich verhält. Wollen Sie das Firefox automatisieren, das Ihre Nutzer installieren, liegt Puppeteer näher; WebKit gibt es nur bei Playwright.
Puppeteer vs. Playwright: Vergleichstabelle
| Puppeteer | Playwright | |
|---|---|---|
| Browser | Chrome, stabiles Firefox | Chromium, gepatchtes Firefox, WebKit; Chrome und Edge über channel |
| Protokoll | CDP für Chrome, WebDriver BiDi für Firefox | CDP für Chromium; Firefox und WebKit über gepatchte Builds |
| Offizielle Sprachen | JavaScript und TypeScript | JavaScript und TypeScript, Python, Java, .NET |
| Warten | Locators warten vor Aktionen | Locators warten vor Aktionen; Test-Assertions wiederholen ihre Prüfung |
| Test-Runner | Keiner eingebaut | Playwright Test |
| Aufzeichnen | Export aus dem Recorder der Chrome DevTools | playwright codegen |
| Rückblick auf einen Lauf | Performance-Trace für DevTools | Trace Viewer |
| Proxy pro Browser | Startargument --proxy-server | proxy in launch() |
| Proxy pro Context | proxyServer in createBrowserContext() | proxy in newContext() |
| Proxy-Benutzername und -Passwort | page.authenticate() auf einer Seite, pro Context zwischengespeichert | Felder username und password |
| MCP-Server | Chrome DevTools MCP (auf Puppeteer gebaut) | Playwright MCP |
Wie sieht dieselbe Aufgabe in beiden Werkzeugen aus?
Unsere Testseite shop.test ist eine kleine lokale Seite, die anderthalb Sekunden nach dem Laden sechs Produktkarten mit JavaScript ausgibt und dann einen Link „Next“ zeigt. Die Aufgabe: die Seite über einen Proxy öffnen, der Benutzername und Passwort verlangt, die Produktnamen lesen, auf „Next“ klicken und die neue Adresse bestätigen. Setzen Sie in Ihrem eigenen Code Ihr Ziel an die Stelle von shop.test.
Mit Puppeteer:
import puppeteer from "puppeteer";

const URL = "http://shop.test/"; // unsere lokale Testseite; hier Ihr Ziel eintragen

const browser = await puppeteer.launch({
  args: ["--proxy-server=http://pr.proxynet.io:8000"],
});
try {
  const page = await browser.newPage();
  await page.authenticate({ username: "user", password: "pass" });
  const response = await page.goto(URL);
  console.log("status:", response.status());
  await page.waitForSelector("div.product"); // die Liste wird von JavaScript gezeichnet
  const names = await page.$$eval("div.product h2", (els) => els.map((el) => el.textContent));
  console.log(names.length, "products, first:", names[0]);
  await Promise.all([
    page.waitForNavigation(),
    page.locator("a.next").click(), // der Locator wartet, bis der Link klickbar ist
  ]);
  console.log(page.url());
} finally {
  await browser.close();
}
Mit Playwright:
import { chromium } from "playwright";

const URL = "http://shop.test/"; // unsere lokale Testseite; hier Ihr Ziel eintragen

const browser = await chromium.launch({
  proxy: { server: "http://pr.proxynet.io:8000", username: "user", password: "pass" },
});
try {
  const page = await browser.newPage();
  const response = await page.goto(URL);
  console.log("status:", response.status());
  const products = page.locator("div.product h2");
  await products.first().waitFor(); // count() und allTextContents() warten nicht
  const names = await products.allTextContents();
  console.log(names.length, "products, first:", names[0]);
  await page.getByRole("link", { name: "Next" }).click(); // wartet von selbst
  await page.waitForURL("**/page/2/");
  console.log(page.url());
} finally {
  await browser.close();
}
Beide Skripte gaben über unseren lokalen Test-Proxy dieselben drei Zeilen aus:
status: 200
6 products, first: Desk lamp
http://shop.test/page/2/
Puppeteer nimmt die Proxy-Adresse als Chrome-Argument und die Zugangsdaten in einem separaten Aufruf; Playwright nimmt alle drei Angaben in einem Objekt. Puppeteer koppelt den Klick an page.waitForNavigation(), damit die URL nicht zu früh gelesen wird, während Playwright den Link über seinen zugänglichen Namen findet und auf das URL-Muster wartet.
Das Proxy-Log zeigte noch einen Unterschied. Der Standard-Headless-Modus von Puppeteer startet den vollständigen Build von Chrome for Testing, der zusätzlich Anfragen an Google-Dienste (update.googleapis.com, accounts.google.com und andere) über den Proxy schickte. Mit headless: "shell", dem schlankeren Programm chrome-headless-shell, verschwanden sie; die Headless Shell, die Playwright standardmäßig nutzt, schickte nur die Anfragen der Seite selbst. Wenn Sie den Verkehr pro Gigabyte bezahlen, wie bei Residential-Proxy, lohnt sich ein Blick auf diesen Hintergrundverkehr in Ihrem Panel.
Wie funktioniert das automatische Warten in beiden?
Die meisten Fehler auf dynamischen Seiten entstehen aus dem Timing: Der Code sucht ein Element, das JavaScript noch nicht gezeichnet hat. Bei Aktionen gehen beide Werkzeuge ähnlich damit um.
In Puppeteer ist der empfohlene Weg der Locator. Vor einem Klick stellt ein Locator sicher, dass das Element im Viewport liegt, sichtbar und aktiviert ist und über zwei Animationsframes hinweg einen stabilen Begrenzungsrahmen hat; gelingt das nicht innerhalb des Timeouts der Seite, wirft er einen TimeoutError. Älterer Code auf Basis von page.$() und page.click(selector) wartet nicht, bis das Element erscheint, deshalb ruft dieser Stil zuerst page.waitForSelector() auf.
Playwright prüft, ob das Element sichtbar und stabil ist, Ereignisse empfangen kann und aktiviert ist. Es ergänzt zwei Dinge: Locators, die ein Element über Rolle, Beschriftung oder Text finden und eine umbenannte CSS-Klasse überstehen, und in Playwright Test Assertions wie expect(locator).toHaveText(), die ihre Prüfung wiederholen, bis die Bedingung erfüllt ist.
Keines der beiden wartet, wenn Sie eine Liste lesen: page.$$eval() und allTextContents() liefern, was in diesem Moment auf der Seite steht. Deshalb warten beide Skripte auf das erste Produkt.
Worin unterscheiden sich die Proxy-Einstellungen?
Bei Scraping-Aufgaben gehen die Wege der beiden Werkzeuge hier am deutlichsten auseinander.
In Puppeteer bindet das Argument --proxy-server den gesamten Browser. Für einen eigenen Proxy pro Sitzung beschreibt die Referenz zu BrowserContextOptions die Felder proxyServer und proxyBypassList und überlässt Benutzername und Passwort Page.authenticate:
const context = await browser.createBrowserContext({
  proxyServer: "http://pr.proxynet.io:8000",
});
const page = await context.newPage();
await page.authenticate({ username: "user", password: "pass" }); // Chrome speichert die Zugangsdaten pro Context
Die Referenz ergänzt, dass page.authenticate() im Hintergrund das Abfangen von Anfragen (Request Interception) einschaltet, was die Leistung beeinträchtigen kann. Der Aufruf erfolgt auf einer Seite, doch Chrome speichert die Zugangsdaten für den ganzen Browser-Context zwischen: In unseren Tests scheiterte ein Context, in dem keine Seite den Aufruf gemacht hatte, mit net::ERR_INVALID_AUTH_CREDENTIALS, während spätere Seiten in einem bereits angemeldeten Context durchkamen. Sitzungen und die Prüfung der Ausgangs-IP behandelt unsere Anleitung zur Proxy-Einrichtung in Puppeteer.
In Playwright kommt das Objekt proxy in launch() für den ganzen Browser oder in newContext() für einen einzelnen Context, mit Benutzername und Passwort als Feldern:
const context = await browser.newContext({
  proxy: { server: "http://pr.proxynet.io:8000", username: "user", password: "pass" },
});
Der Netzwerk-Leitfaden von Playwright zeigt beide Formen und akzeptiert HTTP(S)- und SOCKSv5-Server. Da jeder Context seine eigenen Zugangsdaten trägt, gibt es keinen Aufruf pro Seite, den man vergessen könnte.
Ein Verhalten sollten Sie kennen: Als wir die Zugangsdaten wegließen, warf Playwright keinen Fehler, und page.goto() lieferte eine Antwort mit dem Status 407. Prüfen Sie response.status(), statt ein stilles goto als Beweis zu nehmen, dass die Seite geladen wurde. Die vollständige Einrichtung steht in Was ist Playwright und wie nutzt man es mit Proxy?.
Drei Chromium-Regeln gelten für beide Werkzeuge. Das Proxy-Dokument von Chromium sagt, dass Chrome für SOCKS5 keine Authentifizierungsmethode unterstützt; SOCKS5 mit Passwort funktioniert in Chromium also mit keinem der beiden Werkzeuge. Nutzen Sie eine IP-Whitelist, die bei uns bis zu 10 Adressen aufnimmt. Chrome lehnt außerdem Zugangsdaten ab, die in die Proxy-Adresse geschrieben werden: In unserem Puppeteer-Test führte user:pass@ in --proxy-server dazu, dass Chrome 154 mit net::ERR_NO_SUPPORTED_PROXIES scheiterte; eine Abkürzung ist das also nicht. Und Chrome umgeht den Proxy bei Loopback-Adressen, also Adressen des eigenen Rechners: In unserem Test öffnete Puppeteer 127.0.0.1 direkt, während Playwright die Anfrage über den Proxy schickte, und mit --proxy-bypass-list=<-loopback> nutzte auch Puppeteer den Proxy.
Wenn jeder Context über eine andere IP hinausgehen soll, brauchen Sie keine Adressliste in Ihrem Code. Mit Rotierender Proxy wechselt ein einziges Gateway die Ausgangs-IP für Sie, und eine Sticky-Sitzung hält eine IP 1 bis 60 Minuten lang.
Welcher MCP-Server: Playwright MCP oder Chrome DevTools MCP?
Dieser Vergleich kommt heute oft auf, wenn jemand einem KI-Coding-Assistenten wie Claude Code oder Cursor einen Browser geben will. MCP (Model Context Protocol) ist der Standardweg, über den solche Assistenten externe Werkzeuge aufrufen, und zu jeder der beiden Bibliotheken gibt es einen darauf gebauten Server.
Playwright MCP ist der Server von Microsoft. Er übergibt dem Modell die Seite als Text des Accessibility Tree statt als Screenshots, startet mit npx @playwright/mcp@latest und nimmt die Flags --proxy-server und --proxy-bypass an. Sein README merkt an, dass für Coding-Agenten ein Weg über die Kommandozeile weniger Tokens verbraucht, weil er keine großen Tool-Schemas in den Kontext des Modells lädt. Einrichtung und Proxy-Zugangsdaten stehen in Was ist Playwright MCP?.
Chrome DevTools MCP lässt einen Coding-Agenten ein laufendes Chrome steuern und untersuchen; für Aktionen nutzt es Puppeteer, für Performance-Traces die DevTools, und gestartet wird es mit npx -y chrome-devtools-mcp@latest. In Version 1.10.1 wird --proxyServer als --proxy-server an Chrome weitergegeben, ohne Feld für Zugangsdaten, sodass eine IP-Whitelist der praktische Weg ist. Standardmäßig startet es das installierte stabile Chrome und sendet Nutzungsstatistiken an Google, sofern Sie nicht --no-usage-statistics ergänzen.
Für einen Agenten, der sich durch Seiten klickt und Formulare ausfüllt, nehmen Sie Playwright MCP; für einen, der Konsolenfehler, Netzwerkanfragen und Performance-Traces Ihrer eigenen Website liest, Chrome DevTools MCP. In beiden Fällen begrenzen Sie, wohin der Agent darf (--allowed-origins oder --allowedUrlPattern), halten Passwörter aus dem Prompt heraus und genehmigen Aktionen, die etwas verändern.
Test-Runner, Codegenerierung und Traces
Hier ist der Vorsprung von Playwright am größten. Playwright Test bringt Runner, Assertions, parallele Läufe, Wiederholungen und einen HTML-Bericht mit; Python nutzt das pytest-Plugin, Java und .NET ihre üblichen Test-Frameworks. npx playwright codegen <url> schreibt Code, während Sie klicken. Der Trace Viewer (npx playwright show-trace trace.zip) spielt einen aufgezeichneten Lauf mit DOM-Snapshots, Netzwerkanfragen und Konsolenmeldungen auf einer Zeitachse ab, sodass Sie sehen, warum ein nächtlicher Job leer zurückkam.
Puppeteer überlässt das Testen Ihnen: Kombinieren Sie es mit Jest, Mocha oder dem Test-Runner von Node.js. Zum Aufzeichnen exportiert das Panel Recorder (Rekorder) in den Chrome DevTools eine Sitzung als Puppeteer-Skript, als Puppeteer-Skript für Firefox oder als Skript mit Lighthouse-Analyse. page.tracing.start() schreibt einen Chrome-Performance-Trace für DevTools; er beantwortet, warum eine Seite langsam ist, ist aber keine Schritt-für-Schritt-Wiedergabe Ihres Skripts.
Tempo: Warum wir keine Zahlen nennen
Veröffentlichte Angaben der Art „X Prozent schneller“ wurden auf der Maschine und der Seite von jemand anderem gemessen. In Chromium sprechen beide Werkzeuge CDP, und bei einem Crawl über einen Proxy geht die meiste Zeit an das Netz und die Zielseite. Einrichtungsentscheidungen wie vollständiges Chrome gegenüber der Headless Shell wiegen schwerer als die Bibliothek. Brauchen Sie eine Zahl, messen Sie sie an Ihrem eigenen Ziel mit demselben Proxy und derselben Nebenläufigkeit.
Einsatzbereiche
- PDFs und Screenshots aus einem Node.js-Dienst: Beide haben
page.pdf(), und beide erzeugten in unserem Test ein PDF aus Chromium; Puppeteer ist die leichtere Abhängigkeit. - End-to-End-Tests über Engines hinweg: Playwright Test führt denselben Test in Chromium, Firefox und WebKit aus.
- Datenerhebung in Python, Java oder .NET: Playwright, da es Puppeteer nur für JavaScript gibt.
- Die stabile Firefox-Version automatisieren: Puppeteer über WebDriver BiDi.
Welches Werkzeug Sie auch wählen: Halten Sie sich an robots.txt und die Nutzungsbedingungen der Website, nutzen Sie die offizielle API, wenn es eine gibt, und halten Sie Ihr Anfragetempo auf einem Niveau, das die Website tragen kann.
Häufige Fehler
- Einen Puppeteer-Context ohne
page.authenticate()öffnen. Chrome speichert die Zugangsdaten pro Context; ein Context, in dem keine Seite den Aufruf gemacht hat, scheitert mitnet::ERR_INVALID_AUTH_CREDENTIALS. - Erwarten, dass Playwright einen Fehler wirft, wenn der Proxy Zugangsdaten verlangt. In unserem Test kam eine Antwort mit 407 zurück; prüfen Sie
response.status(). user:pass@in die Proxy-Adresse schreiben. Chrome übernimmt keine Zugangsdaten aus der Adresse; übergeben Sie sie in Puppeteer mitpage.authenticate()und in Playwright über die Felderusernameundpassword.- SOCKS5 mit Passwort in Chromium nutzen. Chrome hat keine SOCKS5-Authentifizierung; nutzen Sie eine IP-Whitelist.
- Einen Proxy in Puppeteer gegen
localhosttesten. Chrome umgeht den Proxy bei Loopback-Adressen, solange Sie nicht<-loopback>ergänzen. - Erwarten, dass das Firefox von Playwright das installierte Firefox ist. Es ist ein gepatchter Build, und WebKit ist nicht Safari.
Entscheidungshilfe
| Bedarf | Empfehlung |
|---|---|
| Ein Node.js-Skript, das nur Chrome braucht | Beide; Puppeteer genügt |
| Python, Java oder .NET | Playwright |
| Tests in der WebKit-Engine | Playwright |
| Die stabile Firefox-Version automatisieren | Puppeteer |
| Proxy-Zugangsdaten einmal pro Context setzen | Playwright |
| Getrennte IPs pro Sitzung in einem Browser | Beide, ein Context pro Sitzung |
| Eine Testsuite mit Assertions und Berichten | Playwright Test |
| Ein Agent, der Formulare ausfüllt | Playwright MCP |
| Ein Agent, der die Performance in Chrome untersucht | Chrome DevTools MCP |
Häufige Fragen
Ist Playwright besser als Puppeteer?
Nicht in jeder Hinsicht. Playwright deckt mehr Engines, Sprachen und Testwerkzeuge ab; Puppeteer ist kleiner und arbeitet mit der stabilen Firefox-Version. Wenn ein funktionierendes Puppeteer-Skript tut, was Sie brauchen, gibt es keinen Grund, es neu zu schreiben.
Kann ich Puppeteer mit Python nutzen?
Nicht offiziell. Die einzige offizielle Bibliothek von Puppeteer ist die für JavaScript und TypeScript unter Node.js; Python-Portierungen gibt es, doch es sind Projekte Dritter außerhalb des Puppeteer-Repositorys. Für eine Python-Pipeline hat Playwright eine offizielle Bibliothek mit denselben Funktionen zur Browser-Automatisierung wie seine Node.js-Version.
Funktioniert Puppeteer mit Firefox?
Ja. Seit Version 23 arbeitet es über WebDriver BiDi mit der stabilen Firefox-Version; Sie starten es mit browser: "firefox". Firefox wird mit dem Paket nicht heruntergeladen, solange Sie es nicht in der Download-Konfiguration aktivieren, und einige Funktionen, die es nur in CDP gibt, stehen über BiDi nicht zur Verfügung.
Ist der Umstieg von Puppeteer auf Playwright schwer?
Ein kleines Skript zieht schnell um, weil viele Aufrufe gleich heißen: goto, click, evaluate, pdf. Die Arbeit liegt an drei Stellen: Die Proxy-Zugangsdaten wandern in das Objekt proxy, Paare mit waitForNavigation() weichen waitForURL() und Locators, und Browser-Contexts werden zur Einheit der Isolation.
Welches sollte ich mit Claude Code oder einem anderen KI-Agenten nutzen?
Das hängt von der Aufgabe ab. Playwright MCP ist dafür gebaut, Seiten über den Accessibility Tree zu steuern; Chrome DevTools MCP, auf Puppeteer gebaut, ist stärker darin, Konsolenmeldungen, Netzwerkanfragen und Performance-Traces zu untersuchen. Sie können beide installieren und jeder Aufgabe nur den Server geben, den sie braucht.
Kann eines der Werkzeuge einen SOCKS5-Proxy mit Benutzername und Passwort nutzen?
In Chromium nicht, weil Chrome keine SOCKS5-Authentifizierung unterstützt. Nutzen Sie SOCKS5 mit einer IP-Whitelist oder einen HTTP-Proxy mit Benutzername und Passwort. Der Endpoint-Generator in unserem Panel zeigt den SOCKS5-Port für jedes Produkt.
Fazit
Puppeteer und Playwright steuern dasselbe Chromium auf ganz ähnliche Weise; der Unterschied liegt in dem, was darum herum steht. Puppeteer ist eine Node.js-Bibliothek für Chrome und das stabile Firefox; die Proxy-Zugangsdaten gehen über page.authenticate() und werden pro Browser-Context zwischengespeichert. Playwright ergänzt WebKit, drei weitere offizielle Sprachen, einen Test-Runner mit Traces und eine Option proxy, die die Zugangsdaten pro Context trägt. Für eine reine Chrome-Aufgabe in Node.js genügt Puppeteer; für mehrere Sprachen, Engines oder eine Testsuite passt Playwright besser. Die Proxy-Typen, die mit beiden funktionieren, finden Sie in unseren Proxy-Diensten.