از یک تحلیلگر منابع انسانی میپرسند آیا شرکت به مهندسان دادهاش حقوقی همتراز بازار میدهد یا نه. نظرسنجی حقوقی که در اختیار دارد یک سال قدیمی است و این سمت را در یک خانواده شغلی کلی جا داده است؛ سایتهای کاریابی اما صدها بازه حقوق اعلامشده برای دقیقاً همین عنوان دارند که همین ماه منتشر شدهاند. اینکه کدام رقبا برای همین مهارتها نیرو میگیرند هم در همانجا پاسخ داده میشود: در آگهیهای شغلی پراکنده در صفحههای فرصتهای شغلی، سایتهای کاریابی و تجمیعکنندهها.
این نوشته توضیح میدهد دادههای آگهی شغلی چیست، چه کسانی آن را میسازند یا میخرند و از کجا میآید؛ منابع را از آمار رسمی و نقاط اتصال عمومی صفحههای فرصتهای شغلی تا صفحههای اسکرپشده سایتهای کاریابی رتبهبندی میکند و سپس به نرمالسازی، دامهای کیفیت، چارچوب حقوقی، جایگاه پروکسیها و شش پاسخ کوتاه میپردازد.
دادههای آگهی شغلی چیست؟
دادههای آگهی شغلی محتوای آگهیهای استخدام آنلاین است که بهصورت فیلدهای ساختاریافته ثبت شده باشد. یک آگهی برای داوطلب نوشته میشود؛ مجموعهداده آن را برای پرسوجو بازنویسی میکند، بهطوری که «مهندس ارشد داده، برلین، ترکیبی» به ردیفی تبدیل شود که بتوان آن را شمرد، مقایسه کرد و دنبال کرد.
فیلدهای اصلی، منبع هرچه باشد، یکساناند:
- عنوان همانطور که نوشته شده، بهعلاوه شغل نرمالشده
- کارفرما: نام، و اینکه آگهیدهنده خود کارفرماست یا یک آژانس
- مکان: شهر، کشور و نشانگر دورکاری یا ترکیبی
- حقوق: کمینه، بیشینه، واحد پول و دوره، هر جا اعلام شده باشد
- سطح ارشدیت و نوع قرارداد
- مهارتها و الزاماتی که از متن شرح شغل استخراج میشوند
- تاریخها: نخستین مشاهده، آخرین مشاهده، بسته شدن یا حذف
- منبع: سایت کاریابی یا صفحه فرصتهای شغلی، و یک URL پایدار
دو فیلد بیشترین ارزش را دارند و درست درآوردنشان از همه دشوارتر است: تاریخها، که انبوهی از آگهیها را به یک سری زمانی تبدیل میکنند، و عنوان نرمالشده، که «Growth Hacker» و «Digital Marketing Specialist» را یک شغل به شمار میآورد.
چه کسانی از دادههای آگهی شغلی استفاده میکنند و برای چه؟
چهار گروه آن را میسازند یا میخرند و هر یک پرسش متفاوتی دارد.
تیمهای جبران خدمات و منابع انسانی حقوق را با بازار مقایسه میکنند. هر جا کارفرمایان بازه حقوق را منتشر کنند، حقوقهای اعلامشده تصویری بهروز از نرخهای بازار به تفکیک عنوان، شهر و سطح ارشدیت میدهند و نشان میدهند رقبا چه مهارتهایی میخواهند.
پژوهشگران بازار کار آگهیها را بهعنوان شاخص تقاضا میخوانند. Hiring Lab، بازوی پژوهشی سایت کاریابی Indeed، تحلیلهایی بر پایه آگهیهای خود Indeed منتشر میکند؛ Lightcast اطلاعات بازار کار را بر پایه آرشیو بسیار بزرگی از آگهیها میفروشد.
تیمهای استراتژی و فروش استخدام را نشانهای از نقشه راه میدانند. رقیبی که بیست موقعیت باز میکند و در آنها از یک پلتفرم ابری، بازار یا زبان تازه نام میبرد، برنامهاش را بدون بیانیه مطبوعاتی اعلام کرده است، و تیم فروش همین نشانه را میخواند تا شرکتهایی را پیدا کند که در حوزهای که به آن میفروشد نیرو میگیرند.
استخدامکنندگان، تجمیعکنندهها و سرمایهگذاران. تجمیعکنندهها آگهیها را گردآوری میکنند تا فهرستشان کنند، شرکتهای کاریابی میبینند فرصتهای شغلی کجا باز میشوند، و تحلیلگران سرمایهگذاری حجم استخدام را یکی از انواع وبمحور دادههای جایگزین میشمارند.
دادههای آگهی شغلی از کجا میآید؟
منابع بر اساس اعتبار و مجاز بودن رتبهبندی میشوند، درست برعکس ترتیبی که بیشتر تیمها با آن شروع میکنند.
1. آمار رسمی فرصتهای شغلی خالی. مراکز ملی آمار تقاضای نیروی کار را مستقیماً اندازه میگیرند. در ایالات متحده، نظرسنجی JOLTS اداره آمار کار برآوردهای ماهانهای از فرصتهای شغلی خالی، استخدامها و جداییها تولید میکند؛ انتشار 3 نوامبر 2026 آن، شمار فرصتهای خالی سپتامبر را 7.5 میلیون اعلام کرد. آمار فرصتهای شغلی خالی یورواستات (Eurostat) هر سه ماه سهم پستهای خالی را گزارش میکند (2.1% در منطقه یورو در سهماهه دوم 2026). در Türkiye، مرکز آمار این کشور (TurkStat) آمار ماهانه نیروی کار را منتشر میکند و بولتن ماهانه ISKUR، سازمان دولتی کاریابی، فرصتهای شغلی خالی را که کارفرمایان نزد آن ثبت میکنند به تفکیک شغل و بخش میشمارد. این منابع رایگان و قابل استنادند، اما تجمیعیاند: نه عنوانی دارند، نه مهارتی و نه کارفرمایی.
2. صفحههای فرصتهای شغلی کارفرمایان از طریق ATS آنها. بسیاری از شرکتها صفحه فرصتهای شغلی خود را روی یک سامانه پیگیری متقاضیان (ATS) میزبانی میکنند که آگهیهایشان را بهصورت JSON عمومی منتشر میکند. Greenhouse یک Job Board API را مستند کرده است که نقاط اتصال GET آن به احراز هویت نیاز ندارند: https://boards-api.greenhouse.io/v1/boards/{board_token}/jobs?content=true همه موقعیتهای شغلی باز را با عنوان، مکان، updated_at، شرح، دپارتمانها و دفترها برمیگرداند و pay_transparency=true بازههای حقوق اعلامشده را به آن میافزاید.
Postings API شرکت Lever هم به همین شکل کار میکند: https://api.lever.co/v0/postings/{site}?mode=json آگهیهای منتشرشده را همراه با categories (مکان، تیم، نوع همکاری)، workplaceType، descriptionPlain و در صورت وجود salaryRange فهرست میکند. برای کارفرمایان مشخص، این نقاط اتصال تمیزترین منبع موجودند.
3. APIهای تجمیعکنندهها. برای نمونه، API سایت Adzuna جستوجوی شغل، دستهبندیها و هیستوگرام حقوق را برای هر کشور، پشت یک app_id و app_key که برای دریافتشان ثبتنام میکنید، در اختیار میگذارد. داده تجمیعکنندهها کارفرمایان زیادی را یکجا پوشش میدهد اما پوشش، حذف موارد تکراری و شرایط مجوز خود تجمیعکننده را به ارث میبرد. LinkedIn استثنایی است که بیش از همه درباره آن میپرسند: توافقنامه کاربری آن (بند 8.2، «Don'ts») اسکرپ یا کپی کردن سرویس را، از جمله با خزندهها و افزونههای مرورگر، ممنوع میکند؛ پس آگهیهای آن از طریق جستوجوی شغل خودش خوانده میشوند، نه گردآوری.
4. صفحههای عمومی سایتهای کاریابی. هر چیز دیگری یک صفحه وب بدون فید است. گردآوری آنها وب اسکرپینگ است و شرایط استفاده سایت و فایل robots.txt آن تعیین میکنند مجاز است یا نه؛ هر جا هر دو اجازه دهند، داده بهروز و پرجزئیات اما بدون ساختار است، پس کار نرمالسازی که در ادامه میآید بر عهده خود شماست.
دادههای آگهی شغلی چگونه گردآوری و نرمالسازی میشود؟
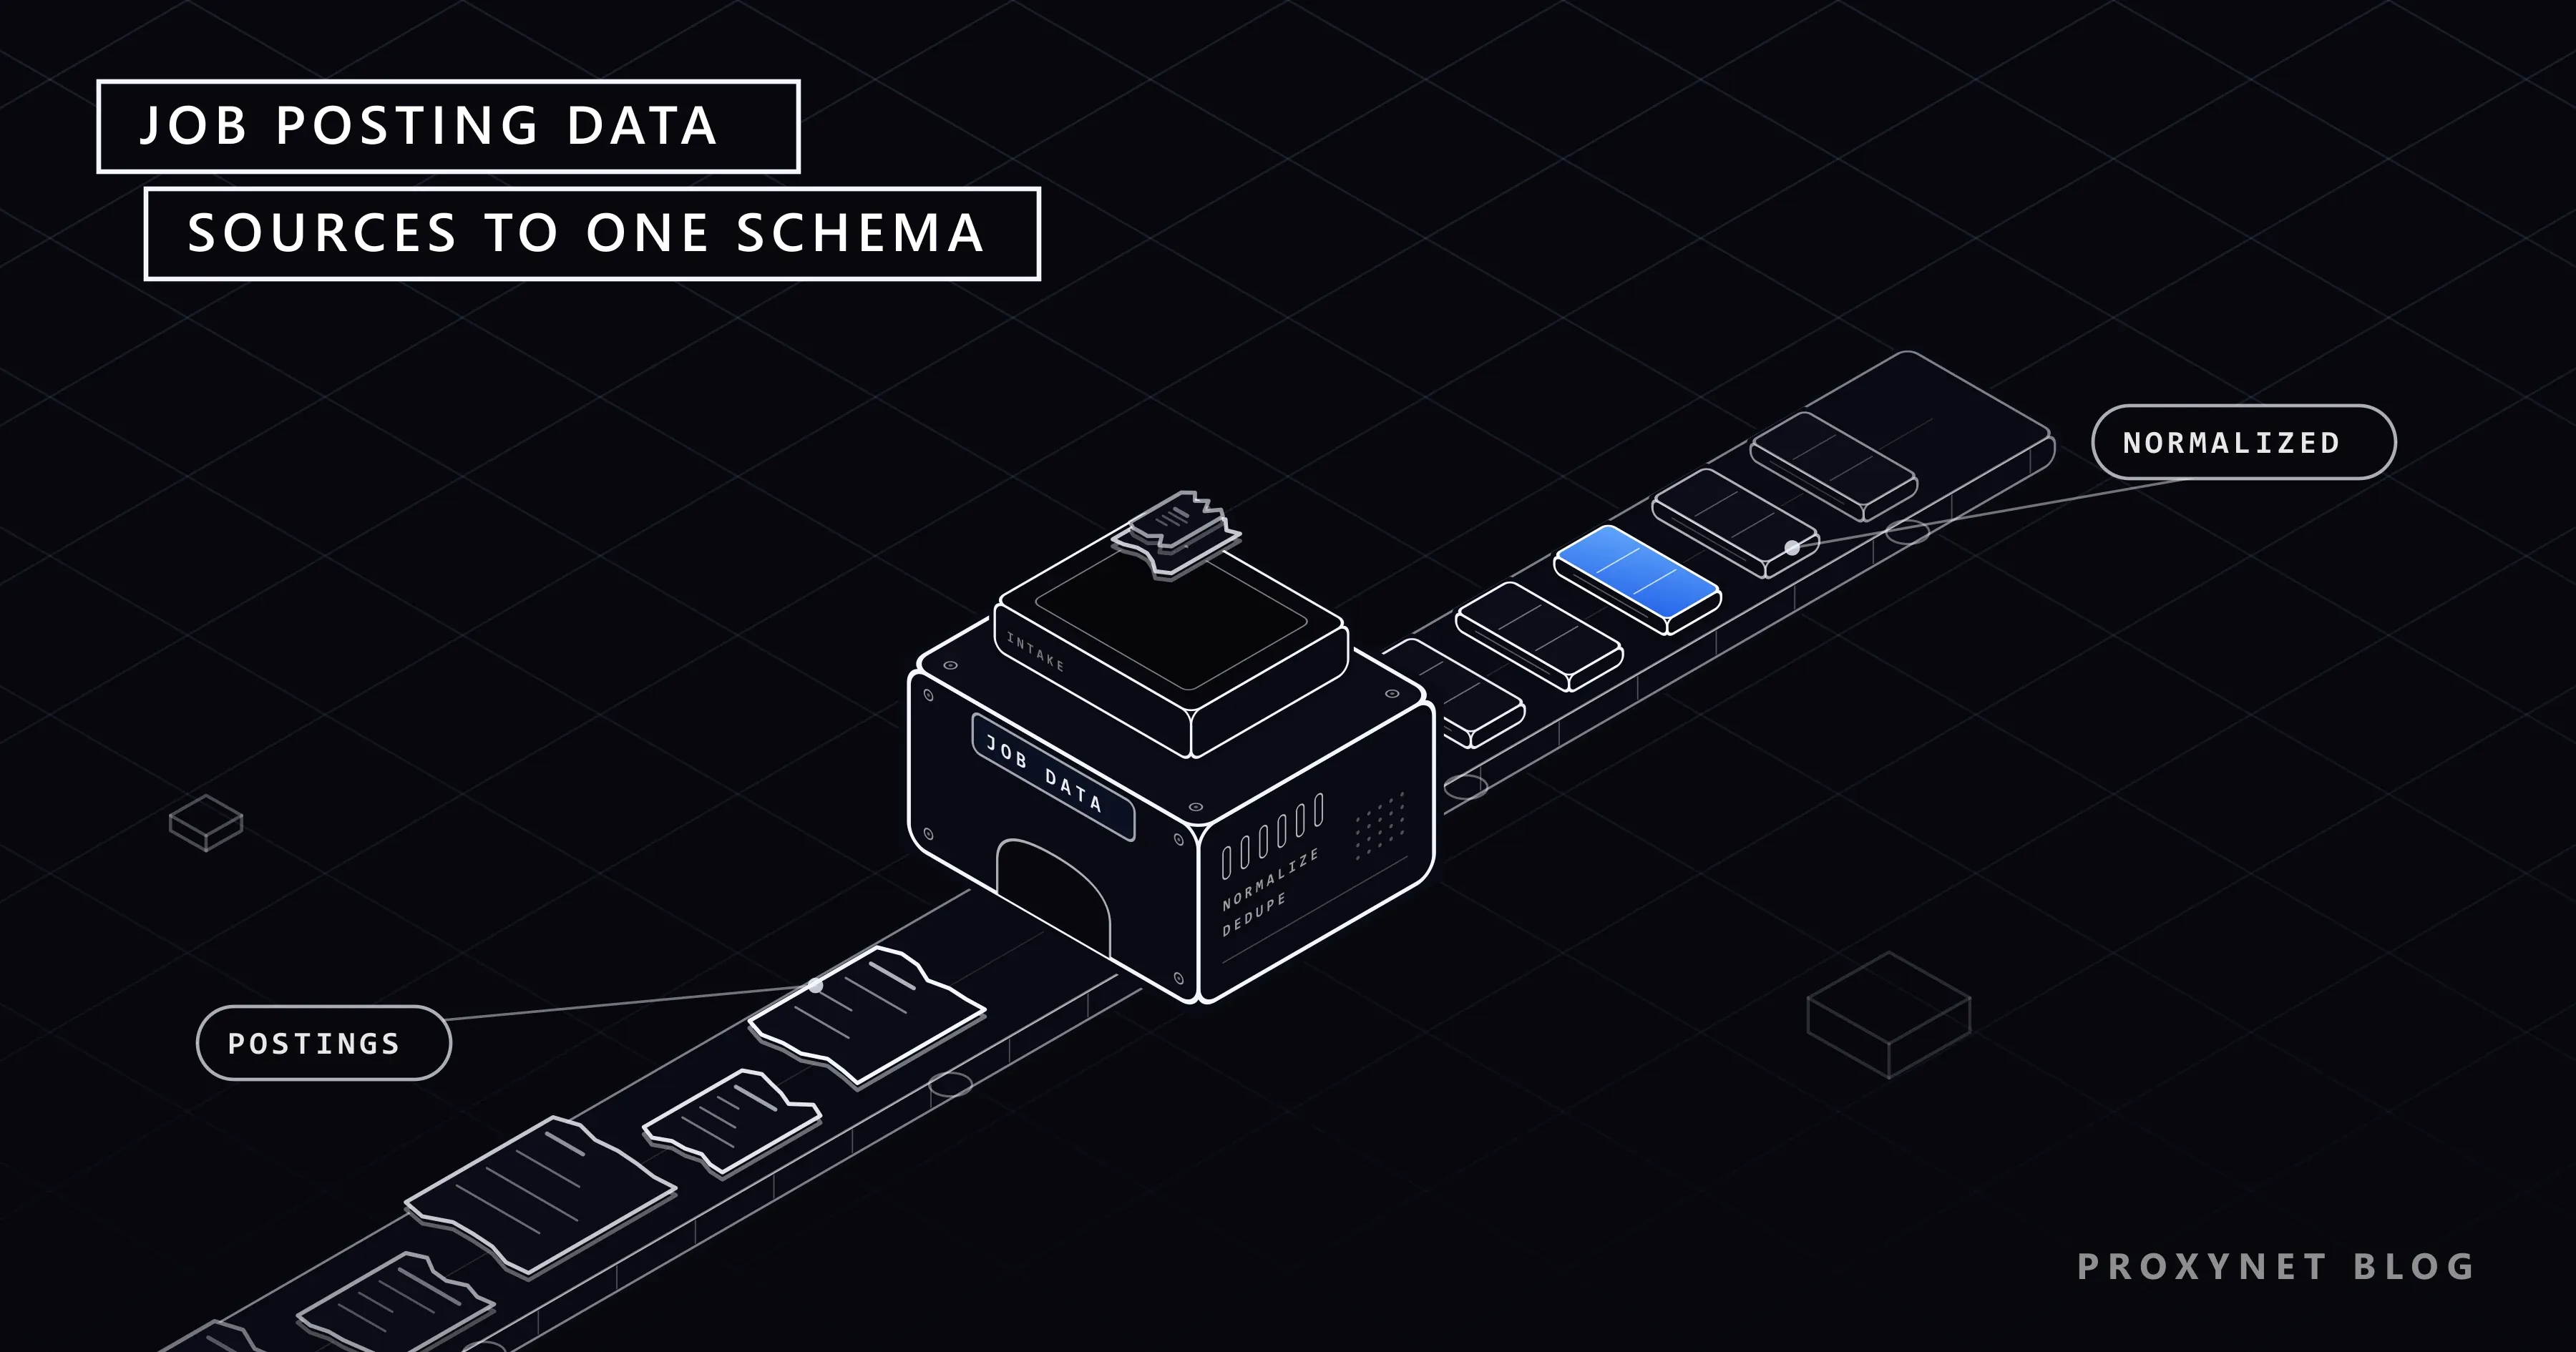
یک پایپلاین کارآمد هشت گام دارد؛ گردآوری کوچکترین آنهاست.
- اول اسکیما را تعریف کنید. فیلدها و نوع دادهها را پیش از دست زدن به هر منبعی ثابت کنید؛
source،source_url،first_seenوlast_seenرا به هر رکورد بیفزایید. - منابع و مسیر دسترسی به هر یک را فهرست کنید. سری رسمی، نقطه اتصال ATS، API دارای مجوز یا صفحه عمومی؛ شرایطی که بر آن حاکم است و دوره سرکشی.
- دوره گردآوری را تعیین کنید. آگهیها هفتهها آنلاین میمانند، برخی تمدید میشوند و تعدادی ظرف چند روز ناپدید میشوند؛ گذر روزانه تاریخها را ثبت میکند و گذر هفتگی برای روند حجم کافی است.
- عنوانها را به یک طبقهبندی مشاغل نرمال کنید. عنوانهای متن آزاد را به ESCO، طبقهبندی کمیسیون اروپا با 3,039 شغل و 13,939 مهارت در 28 زبان، رایگان و دارای API؛ به O*NET، پایگاه داده وزارت کار ایالات متحده با بیش از 900 شغل؛ یا به ISCO-08 سازمان بینالمللی کار (ILO) با ده گروه اصلی آن نگاشت کنید. یک واژهنامه از عنوانهای شناختهشده گذر نخست را انجام میدهد و یک طبقهبند متنی بقیه را.
- حقوق را تجزیه کنید. کمینه، بیشینه، واحد پول و دوره را استخراج کنید، ارقام ساعتی و ماهانه را به بازه سالانه تبدیل کنید و «اعلامنشده» را بهعنوان یک مقدار ذخیره کنید، چون فراوانی آن خودش یک سیگنال است.
- موارد تکراری را حذف کنید. یک فرصت شغلی در صفحه فرصتهای شغلی، دو سایت کاریابی و یک تجمیعکننده ظاهر میشود، اغلب با عنوانهای متفاوت؛ بر اساس کارفرما، عنوان نرمالشده، مکان و اثر انگشت متن شرح شغل تطبیق دهید و یک رکورد با همه URLهای منبع نگه دارید.
- سیگنالها را استخراج کنید. آگهیهای تازه در هر هفته به تفکیک کارفرما و شغل، میانه روزهای آنلاین بودن (جایگزینی برای زمان پر شدن موقعیت)، سهم اعلام حقوق، فراوانی مهارتها.
- هر اجرا را کنترل کیفیت کنید. تعداد ردیفها به تفکیک منبع، سهم رکوردهای بدون حقوق یا مکان، و ده رکورد تصادفی که با صفحه زنده مقایسه میشوند.
یک رکورد نرمالشده برای یک کارفرمای فرضی چنین شکلی دارد:
{
  "posting_id": "example-ltd-2026-11-0417",
  "title_raw": "Sr. Data Engineer (Hybrid)",
  "occupation": "Data engineer",
  "employer": "Example Ltd",
  "poster_type": "employer",
  "location": { "city": "Berlin", "country": "DE", "workplace": "hybrid" },
  "salary": { "min": 85000, "max": 100000, "currency": "EUR", "period": "year", "disclosed": true },
  "seniority": "senior",
  "contract": "full-time",
  "skills": ["Spark", "Airflow", "SQL", "Python"],
  "first_seen": "2026-11-02",
  "last_seen": "2026-11-09",
  "closed_at": null,
  "sources": ["https://example.com/careers/417", "https://jobs.example.net/view/88213"]
}
مقایسه منابع دادههای آگهی شغلی
| منبع | پوشش | تازگی | محدودیت |
|---|---|---|---|
| آمار رسمی (JOLTS، یورواستات، ISKUR) | کل اقتصاد، تجمیعی | ماهانه یا فصلی | بدون عنوان، مهارت یا کارفرما |
| نقاط اتصال عمومی ATS (Greenhouse، Lever) | کارفرمایان مشخص، همه موقعیتهای باز | زنده | هر شرکت یک صفحه جدا؛ فهرست را خودتان میسازید |
| APIهای تجمیعکنندهها | کارفرمایان زیاد در هر کشور | چند ساعت تا چند روز | شرایط مجوز، حذف موارد تکراری به روش فروشنده |
| صفحههای عمومی سایتهای کاریابی | هر چه منتشر شده | به تناوب سرکشی شما | شرایط استفاده، robots.txt، کار تجزیه |
در دادههای آگهی شغلی چه مشکلاتی پیش میآید؟
آگهیها تبلیغاند، نه فرصت شغلی خالی؛ تحلیل در شکاف میان این دو شکست میخورد.
آگهیهای شبح و همیشگی. یادداشت آموزشی سال 2025 سرویس پژوهشی کنگره ایالات متحده آگهیهای شغلی «شبح» را آگهیهایی تعریف میکند برای موقعیتهایی که وجود ندارند یا کارفرما قصد ندارد آنها را فوراً پر کند، یادآوری میکند که هیچ آمار رسمیای آنها را اندازه نمیگیرد و هشدار میدهد که نظرسنجیهایی که درصد اعلام میکنند بیشتر از شرکتهای فروشنده ابزارهای استخدام میآیند. در دادهها، اینها آگهیهاییاند که ماهها باز میمانند، در چرخهای ثابت دوباره ظاهر میشوند یا همزمان همهجا تبلیغ میشوند.
تمدیدها و تکرارهای آژانسها. سایتهای کاریابی وقتی کارفرما آگهی را تمدید میکند تاریخ را از نو تنظیم میکنند، پس «2 روز پیش منتشر شده» میتواند فرصتی سهماهه باشد؛ آژانسها همان موقعیت مشتری را با نام خودشان آگهی میکنند، گاهی چند آژانس همزمان. first_seen خودتان را نگه دارید، آگهیدهندگان آژانسی را علامت بزنید و هر فرصت شغلی را یک بار بشمارید.
نبود حقوق. بسیاری از آگهیها حقوقی اعلام نمیکنند و آنهایی که اعلام میکنند نمونهای تصادفی نیستند. نرخ اعلام را کنار هر آمار حقوقی گزارش کنید.
تورم و جابهجایی عنوانها. یک کار بسته به بازار و سال با عنوان مهندس، توسعهدهنده، معمار یا مشاور آگهی میشود؛ بدون طبقهبندی، شرکتی که نام توسعهدهندگانش را عوض کرده شبیه شرکتی به نظر میرسد که استخدامشان را متوقف کرده است.
آیا گردآوری دادههای آگهی شغلی قانونی است؟
سه لایه در کار است: دادههای شخصی، شرایط استفاده و قانون کشوری که در آن فعالیت میکنید. هیچیک از اینها مشاوره حقوقی نیست.
دادههای شخصی. آگهی درباره یک شغل است، اما اغلب نام، نشانی ایمیل یا شماره تلفن یک استخدامکننده را هم دارد. اینها داده شخصیاند و هم GDPR (ماده 6) و هم KVKK در Türkiye پردازش را فقط با یک مبنای قانونی مجاز میدانند؛ یک مجموعهداده بازار کار به آنها نیازی ندارد، پس هرگز آنها را گردآوری نکنید و هنگام دریافت از متن شرح شغل حذفشان کنید. نوشته دادههای شخصی در مجموعهدادههای اسکرپشده توضیح میدهد آنچه را از دست در میرود چگونه بپوشانید.
شرایط استفاده. بسیاری از سایتهای کاریابی دسترسی خودکار را در شرایط خود ممنوع میکنند و LinkedIn این را بهصراحت میگوید. رأی پرونده hiQ Labs v. LinkedIn (دادگاه تجدیدنظر حوزه نهم ایالات متحده، 2022) نتیجه گرفت که مفهوم «بدون مجوز» در قانون کلاهبرداری و سوءاستفاده رایانهای (CFAA) بر وبسایتهای عمومی اعمال نمیشود؛ این رأی به یک قانون کیفری ایالات متحده مربوط بود، نه به شرایط یک سایت، که پرسشی جداگانه باقی میماند.
قانون محلی. حقوق پایگاه داده، قواعد رقابت ناعادلانه و قوانین آگهی استخدام از کشوری به کشور دیگر فرق میکند. پیش از عرضه یک محصول داده شغلی، از یک وکیل بخواهید منابع و شرایط حاکم بر هر یک را بررسی کند.
پروکسی کجای گردآوری دادههای شغلی قرار میگیرد؟
پروکسی تعیین میکند درخواست از کدام نشانی شبکه خارج شود؛ در دادههای شغلی دو موقعیت این را مهم میکند.
نخست، سایتهای کاریابی بومیسازی میکنند: بسیاری بهطور پیشفرض کشور بازدیدکننده را نشان میدهند و برخی واحد پول، زبان یا نمایش حقوق را بسته به مکان تغییر میدهند. برای ثبت آنچه داوطلب هر بازار میبیند، درخواست باید از همان بازار بیاید؛ نشانیهای پروکسی مسکونی به شما امکان میدهند کشور و شهر را برای هر درخواست انتخاب کنید تا سری داده آلمان با سری Türkiye مخلوط نشود.
دوم، حجم کار پراکنده است: هزار صفحه فرصت شغلی یعنی هزار کار کوچک و مؤدبانه، نه یک کار سنگین. نقاط اتصال JSON ایستا مانند فیدهای ATS بالا برای نشانیهای پروکسی دیتاسنتر مناسباند که ترافیکشان بدون سهمیه است؛ سایتهایی که بسته به کشور بازدیدکننده تغییر میکنند به نشانیهای مسکونی تعلق دارند. پروکسی تغییری نمیدهد در اینکه کدام منابع را مجازید بخوانید، سایت چند بار اجازه سرکشی میدهد یا شرایطش چه میگوید.
اگر ترجیح میدهید بهجای اجرای پایپلاین، ردیفهای نرمالشده تحویل بگیرید، یک سرویس استخراج مدیریتشده تجزیه و حذف موارد تکراری را برای شما انجام میدهد.
اشتباهات رایج در کار با دادههای آگهی شغلی
- شمردن آگهیها بهجای استخدامها یا فرصتهای خالی؛ حجمها را با سریهای رسمی کالیبره کنید.
- شروع از اسکرپینگ وقتی نقاط اتصال ATS و APIهای دارای مجوز همان کارفرمایان را پوشش میدهند.
- اعتماد به تاریخ انتشار سایت کاریابی بهجای
first_seenوlast_seenخودتان. - رد شدن از حذف موارد تکراری، بهطوری که یک فرصت شغلی سه بار شمرده میشود.
- نگه داشتن فقط عنوانهای خام، بهطوری که روندها در تغییر نامها گم میشوند.
- گردآوری اطلاعات تماس استخدامکنندگان فقط چون در صفحه بودهاند.
راهنمای انتخاب
| نیاز | مسیر |
|---|---|
| تقاضای نیروی کار برای یک کشور یا بخش | آمار رسمی (JOLTS، یورواستات، ISKUR) |
| برنامه استخدام پنجاه رقیب مشخص | نقاط اتصال ATS آنها، با سرکشی روزانه |
| بازه حقوق به تفکیک عنوان و شهر | API تجمیعکننده دارای مجوز بهعلاوه فیلدهای حقوق ATS |
| یک سایت کاریابی آنطور که داوطلبان هر کشور میبینند | پروکسی مسکونی به تفکیک کشور، در چارچوب شرایط سایت |
| هزاران صفحه فرصت شغلی کوچک بدون فید | پروکسی دیتاسنتر با نرخ مؤدبانه، یا یک فید مدیریتشده |
| ردیفها همین امروز، بدون تیم پایپلاین | استخراج مدیریتشده با اسکیمای نرمالشده |
پرسشهای متداول
آیا اسکرپ کردن آگهیهای شغلی قانونی است؟
گردآوری آگهیهای شغلی عمومی در بیشتر کشورها بهخودیخود غیرقانونی نیست، اما یک پروژه وقتی غیرقانونی میشود که داده شخصی را بدون مبنای قانونی پردازش کند، شرایط استفاده یک سایت را نقض کند یا قواعد محلی مانند حقوق پایگاه داده را نادیده بگیرد. آمار رسمی و نقاط اتصال عمومی ATS هیچیک از این ریسکها را ندارند.
دادههای آگهی شغلی را از کجا میتوان رایگان گرفت؟
برای ارقام تجمیعی از آمار رسمی (JOLTS اداره آمار کار ایالات متحده، آمار فرصتهای شغلی خالی یورواستات، بولتن ماهانه ISKUR) و برای تکتک آگهیها از نقاط اتصال عمومی ATS کارفرمایان مانند Job Board API شرکت Greenhouse و Postings API شرکت Lever؛ هیچکدام به کلید API نیاز ندارند. مجموعهدادههای رایگان در پلتفرمهای علم داده تصویرهای لحظهایاند، برای تمرین خوباند اما برای سری زمانی نه.
آگهیهای شغلی شبح را چگونه تشخیص میدهید؟
از روی رفتار در طول زمان، نه از روی متن: آگهیای که ماهها باز است، همان آگهی که در چرخهای ثابت دوباره ساخته میشود، یک موقعیت که همزمان در همه مکانها تبلیغ میشود و کارفرمایانی که شمار آگهیهایشان هرگز تغییر نمیکند در حالی که تعداد کارکنانشان تغییر میکند. هیچیک بهتنهایی اثبات نیست؛ آنها را در یک امتیاز ترکیب کنید و کنار شمارشها گزارش دهید.
آگهیهای شغلی هر چند وقت یک بار تغییر میکنند؟
اگر تکتک آگهیها را بشمارید، روزانه: هر روز آگهیهای تازه ظاهر میشوند و آگهیهای دیگر بسته یا تمدید میشوند. گردآوری هفتگی برای حجمها به تفکیک شغل یا کارفرما کافی است؛ سرکشی روزانه برای تاریخهای دقیق نخستین و آخرین مشاهده لازم است، که سیگنال زمان پر شدن موقعیت را میسازند.
آیا میتوانم آگهیهای شغلی LinkedIn را اسکرپ کنم؟
خیر. توافقنامه کاربری LinkedIn اسکرپ یا کپی کردن سرویس را، از جمله با خزندهها و افزونههای مرورگر، ممنوع میکند، پس مجموعهدادهای که به این روش ساخته شود از نخستین درخواست شرایط را نقض کرده است. برای دیدن اینکه آگهیها در هر کشور چه تفاوتی دارند از فیلترهای جستوجوی خود آن استفاده کنید؛ نوشته جستوجوی آگهیهای شغلی LinkedIn در کشوری دیگر روش آن را نشان میدهد.
مجموعهداده آگهی شغلی یا اسکرپینگ زنده: کدام بهتر است؟
مجموعهداده خریداریشده از روز نخست سابقه و حذف موارد تکراری به روش فروشنده را به شما میدهد؛ گردآوری زنده فیلدها، منابع و دورهای را میدهد که خودتان انتخاب میکنید و از همین امروز شروع میشود. تیمهایی که به داده گذشته نیاز دارند میخرند؛ تیمهایی که اسکیما یا کشور مشخصی میخواهند میسازند.
خلاصه
دادههای آگهی شغلی تبلیغها را به رکوردی ساختاریافته و تاریخدار از تقاضای نیروی کار تبدیل میکند: چه کسی نیرو میگیرد، برای کدام شغل، کجا، با چه حقوقی و از چه زمانی. مطمئنترین منابع آن مشروعترین آنها هم هستند: آمار رسمی فرصتهای شغلی خالی برای تصویر کلی و نقاط اتصال عمومی ATS کارفرمایان برای جزئیات. وقتی گردآوری باید هر بازار را همانطور ببیند که یک داوطلب محلی میبیند، صفحه پروکسی تحقیقات بازار Proxynet خروجیهای مسکونی و دیتاسنتر را پوشش میدهد و Web Scraping API، که از طریق تیم فروش در دسترس است، مسیر مدیریتشده برای تیمهایی است که ردیفها را میخواهند نه پایپلاین را.