Ein Einzelhändler veröffentlicht seine Quartalsumsätze in sechs Wochen. Schon vorher kann ein Analyst zählen, wie viele Produkte in seinem Onlineshop ausverkauft sind, wie viele Filialleitungen er sucht und ob die Bewertungen seiner neuen Produktlinie schlechter werden. Keine dieser Zahlen stammt aus den Berichten des Unternehmens selbst, zusammen sagen sie aber etwas über das Quartal aus. Genau diese Art von Information nennt die Finanzwelt alternative Daten.
Dieser Beitrag erklärt, was alternative Daten sind und woher sie kommen: Webdaten, Kartentransaktionspanels, Satellitenbilder, App-Nutzung und Sentiment. Anschließend verfolgt er einen Datensatz von der Erhebung bis zur Entscheidung, behandelt Compliance und Qualität, zeigt, wo Web Scraping hineinpasst, und vergleicht Selbermachen mit Einkaufen. Nichts hier ist eine Anlageberatung; es geht um Daten, nicht darum, welche Geschäfte Sie abschließen sollten.
Was sind alternative Daten?
Alternative Daten sind alle Datensätze, die helfen, ein Unternehmen, eine Branche oder die Wirtschaft zu erklären, aber außerhalb der traditionellen Eingangsdaten liegen. Zu diesen gehören geprüfte Jahresabschlüsse, regulatorische Pflichtveröffentlichungen, Telefonkonferenzen zu Quartalszahlen, Pressemitteilungen, amtliche Statistiken und Marktpreise. Alles andere, das ein brauchbares Signal trägt, gilt als „alternativ“.
Die US-Börsenaufsicht SEC liefert eine brauchbare Definition in einem Prüfungshinweis zur MNPI-Compliance aus dem Jahr 2022. Zu ihren Beispielen gehören Satelliten- und Drohnenbilder von Feldern und Parkplätzen, aggregierte Kreditkartentransaktionen, Social-Media- und Suchdaten, Standortdaten von Smartphones und E-Mail-Daten aus Verbraucher-Apps. In derselben Fußnote heißt es, alternative Daten enthielten „nicht notwendigerweise MNPI“ – ein Punkt, auf den dieser Beitrag später zurückkommt.
Der Begriff stammt aus der Geldanlage, wo Hedgefonds die ersten großen Käufer waren. Heute nutzen Kreditgeber, Händler, Beratungen und Ökonomen dieselben Datensätze.
Welche Arten alternativer Daten gibt es?
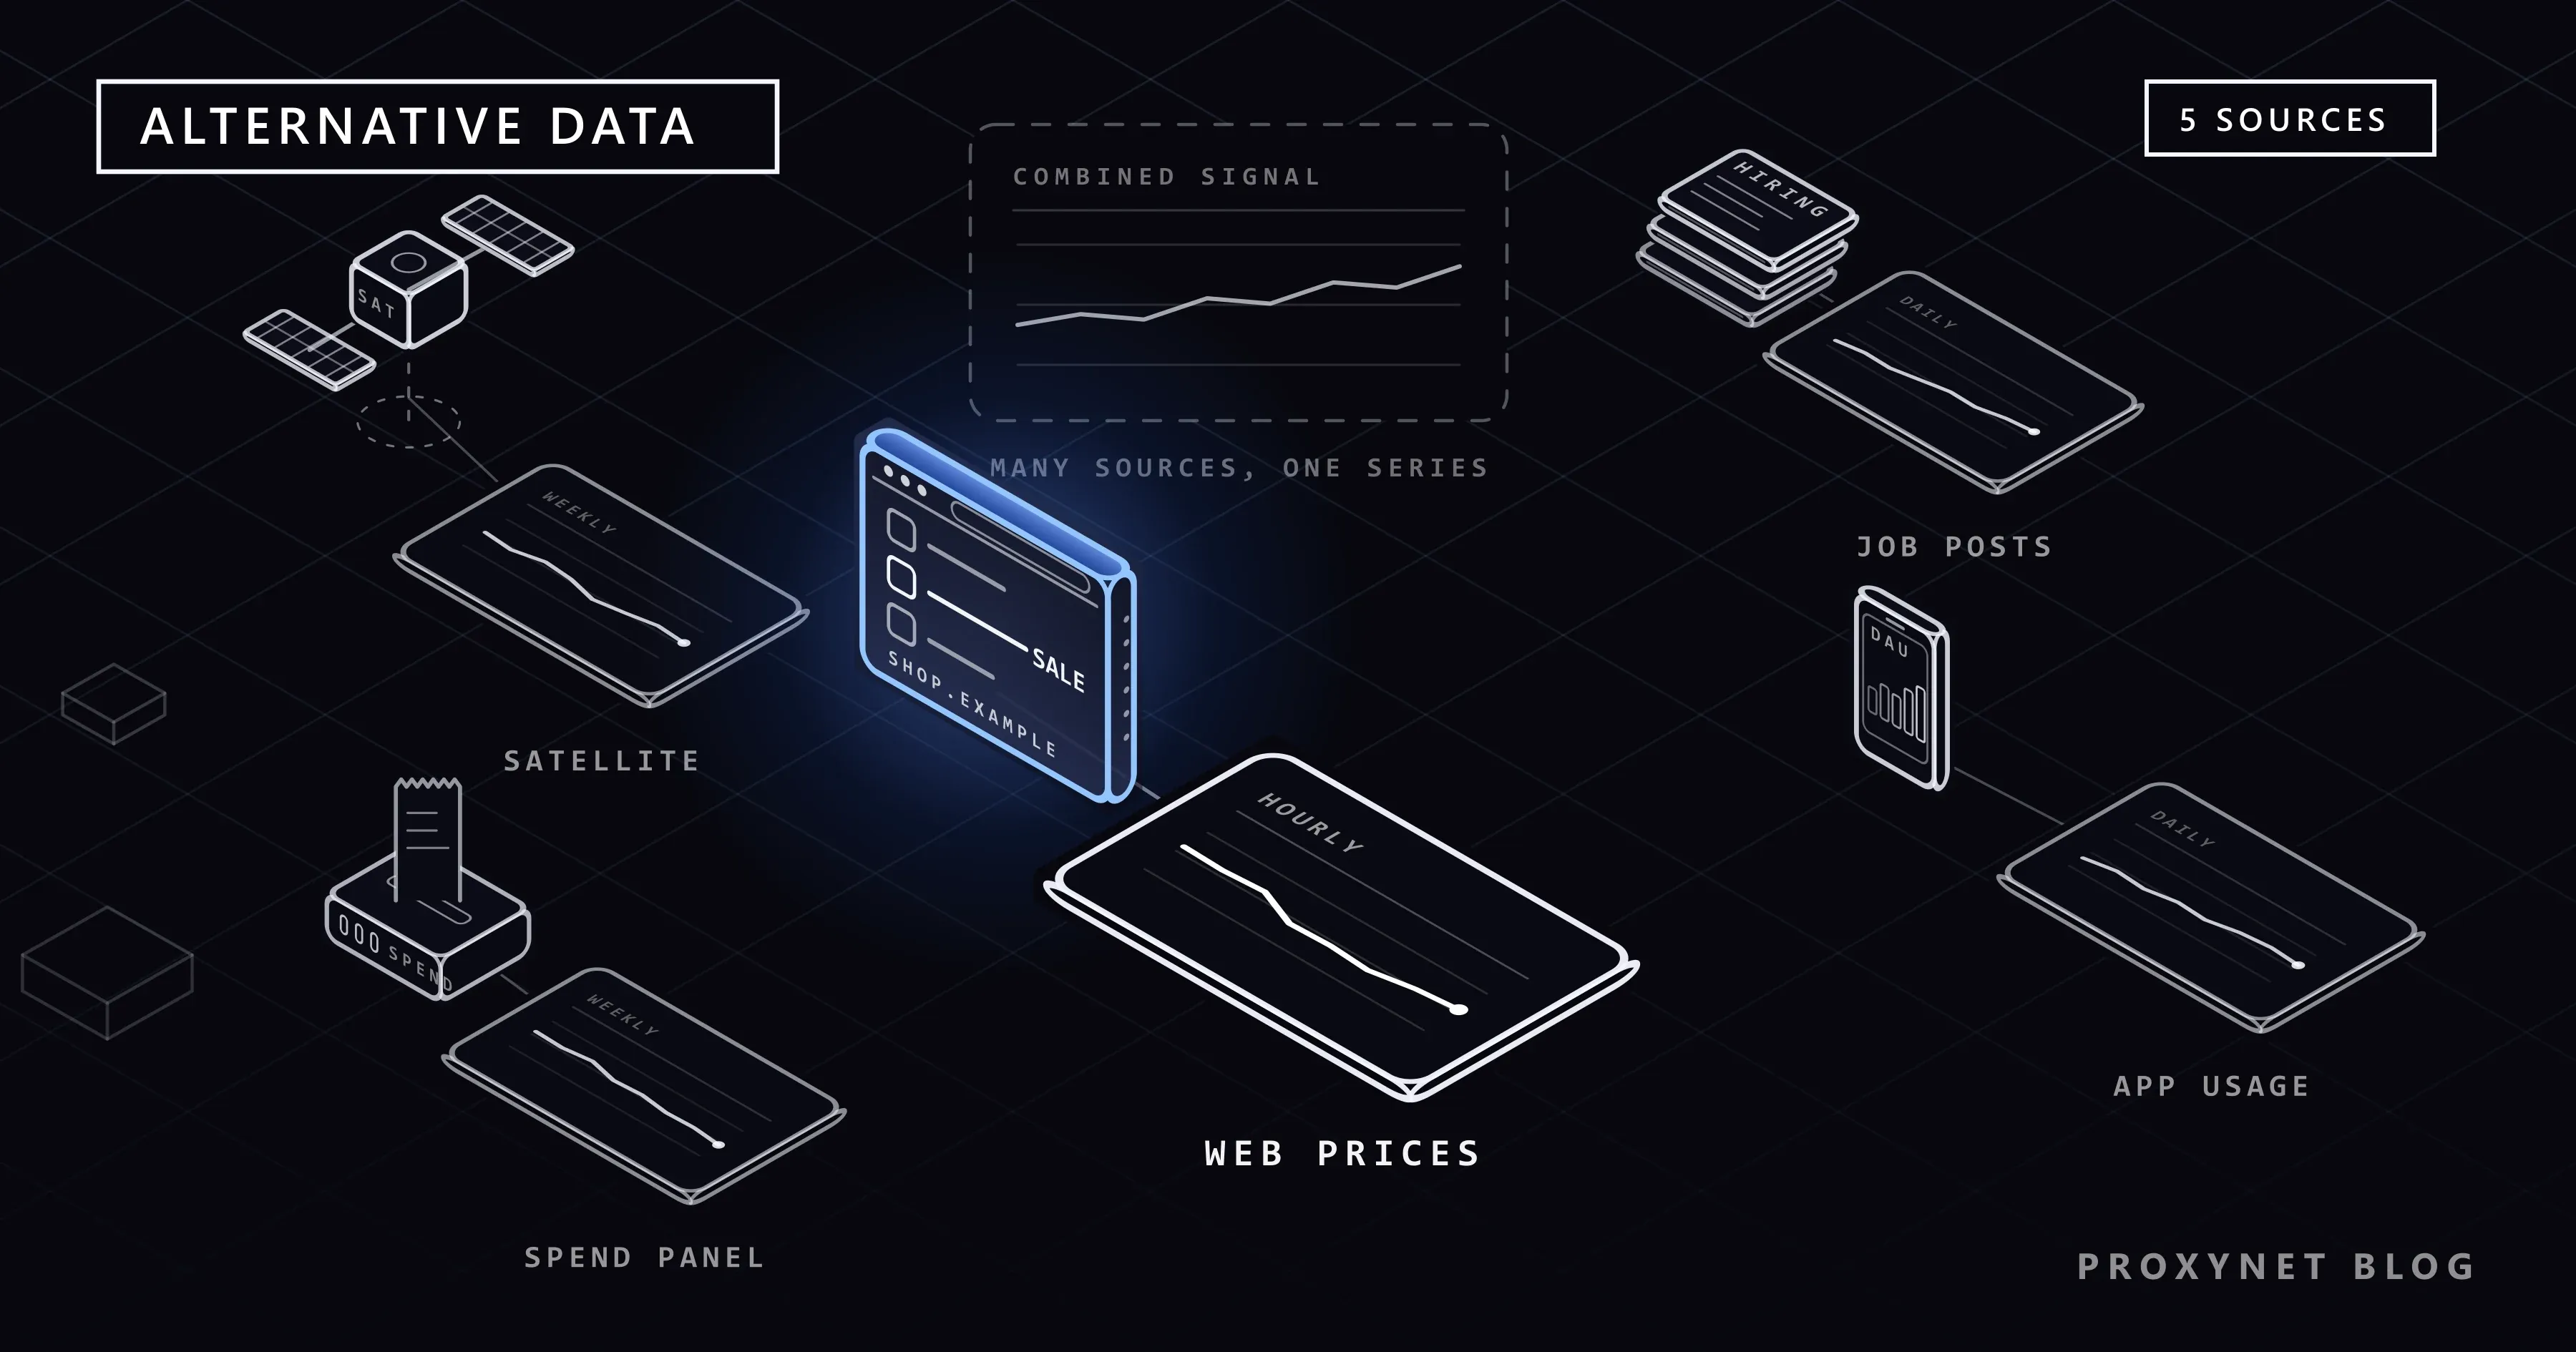
Die Kategorien überschneiden sich, doch die meisten Datensätze passen in eine dieser Gruppen:
- Webdaten. Preise und Lagerbestände in Onlineshops, Produktkataloge, Stellenanzeigen, Seiten mit Mitarbeiterzahlen, Filialfinder, App-Store-Rankings, Immobilienanzeigen und Bewertungen. Sie sind öffentlich, aktuell und günstiger zu erheben als andere Arten.
- Transaktionsdaten. Aggregierte und anonymisierte Einkäufe von Kartenausgebern, Zahlungsdienstleistern oder Beleg-Apps. Sie zeigen Ausgaben nach Händler oder Marke, meist über ein Panel von Verbrauchern statt über den gesamten Markt.
- Geodaten. Satelliten- und Luftbilder (Parkplätze, Öltanks, Felder, Schifffahrt) sowie Besucherfrequenz (Foot Traffic), abgeleitet aus Standortsignalen von Smartphones.
- App- und Webnutzung. Schätzungen zu Downloads und aktiven Nutzern mobiler Apps, zum Website-Traffic und zu Trends beim Suchvolumen.
- Sentiment- und Textdaten. Social-Media-Beiträge, Nachrichten, Produktbewertungen, Forenthreads und Transkripte von Telefonkonferenzen zu Quartalszahlen, umgewandelt in Scores oder Themen. Das CFA Institute weist in seinem Artikel über NLP für alternative Daten darauf hin, dass ein Großteil dieses Materials unstrukturierter Text ist und vor der Nutzung aufbereitet werden muss.
Wie werden alternative Daten zu einem verwertbaren Signal?
Der Weg von der Quelle zur Entscheidung umfasst meist sechs Schritte:
- Die Frage festlegen. „Wachsen die Umsätze von Händler X schneller als im Vorjahr?“ ist eine Frage; „alles über Händler X sammeln“ ist keine.
- Die Quelle finden und prüfen. Klären Sie, wem die Daten gehören, wie und unter welchen Bedingungen sie erhoben wurden und ob Sie sie für diesen Zweck nutzen dürfen. Bei gescrapten Daten heißt das: Nutzungsbedingungen der Website und robots.txt; bei einem Anbieter: ein Due-Diligence-Fragebogen.
- Erheben. Öffentliche Seiten scrapen, eine offizielle API aufrufen, Dateien von einem Anbieter empfangen oder einen Partner-Feed einlesen. Die Erhebung läuft nach Zeitplan, denn eine einzelne Momentaufnahme zeigt keine Veränderung.
- Bereinigen und verknüpfen. Duplikate entfernen, Datentypen und Währungen korrigieren, Produktnamen und Filialadressen dem richtigen Unternehmen und Tickersymbol zuordnen.
- Den Indikator bilden und testen. Zeilen in eine Zeitreihe überführen, etwa eine wöchentliche Zahl rabattierter Artikel, und sie mit früher gemeldeten Zahlen vergleichen. Eine Reihe, die den gemeldeten Zahlen nie gefolgt ist, ist Rauschen.
- Überwachen. Quellen ändern sich: Eine Website wird neu gestaltet, das Panel eines Anbieters verliert Teilnehmer, eine App ändert ihren Store-Eintrag.
Die Schritte 3 und 4 sind im Grunde ein ETL-Job: Extract, Transform, Load. Was ist ETL? geht eine solche Pipeline mit gescrapten Daten durch.
Arten alternativer Daten im Vergleich
| Art | Was sie misst | Typische Erhebung | Aktualität | Hauptrisiko |
|---|---|---|---|---|
| Webpreise und Bestand | Preise, Rabatte, Verfügbarkeit | Scraping öffentlicher Produktseiten | Stunden bis Tage | Seitenänderungen legen den Scraper lahm |
| Stellenanzeigen | Einstellungspläne nach Rolle und Ort | Scraping von Karriereseiten und Jobbörsen | Tage | Doppelte und veraltete Anzeigen |
| Bewertungen und Social-Media-Beiträge | Sentiment, Produktprobleme | Scraping, offizielle APIs | Stunden | Bots, Ironie, kleine Stichproben |
| Kartentransaktionspanels | Verbraucherausgaben nach Händler | Lizenz von Anbietern | Tage bis Wochen | Panel-Verzerrung, personenbezogene Daten |
| Satellitenbilder | Physische Aktivität (Autos, Tanks, Ernten) | Lizenzierte Bilder plus Bildanalyse | Tage | Wolken, Kosten, Interpretation |
| Foot Traffic | Besuche in Geschäften und Einrichtungen | Standortpanels von Smartphones über Anbieter | Tage | Einwilligung und Datenschutz |
| Schätzungen zur App-Nutzung | Downloads, aktive Nutzer | Anbietermodelle, App-Store-Daten | Tage | Intransparente Modelle, Quellenqualität |
Webdaten sind die Art, die ein Team selbst erheben kann. Karten-, Standort- und App-Daten kommen fast immer von einem Anbieter, was sowohl die Kosten als auch den Compliance-Aufwand prägt.
Ist die Nutzung alternativer Daten legal?
Die Nutzung alternativer Daten ist grundsätzlich legal. Entscheidend ist, wie ein Datensatz beschafft wurde und ob er Informationen enthält, auf deren Grundlage nicht gehandelt werden darf.
Wesentliche nicht öffentliche Informationen (MNPI). In den USA müssen Anlageberater schriftliche Richtlinien unterhalten, um den Missbrauch wesentlicher nicht öffentlicher Informationen zu verhindern (Section 204A des Investment Advisers Act). Im oben zitierten Hinweis von 2022 berichteten die Prüfer der SEC, dass manche Berater alternative Daten ohne Richtlinien nutzten, die das Risiko adressieren, darüber MNPI zu erhalten. Die Behörde nannte eine nur anlassbezogene Prüfung der Datenanbieter, keine Bewertung der Bedingungen und rechtlichen Pflichten rund um die Erhebung (selbst nachdem Warnsignale aufgetreten waren), eine Prüfung, die nicht auf jede Quelle angewandt wurde, und kein Verfahren, um sie bei geänderten Erhebungspraktiken zu wiederholen.
Falsche Angaben zur Herkunft der Daten. Im September 2021 erhob die SEC Anklage gegen App Annie und seinen Mitgründer wegen Wertpapierbetrugs. Nach Angaben der SEC hatte das Unternehmen App-Entwicklern zugesichert, ihre Daten vor der Verwendung in seinem statistischen Modell zu aggregieren und zu anonymisieren, nutzte aber nicht aggregierte Daten, um die Schätzungen anzupassen, die es an Handelsfirmen verkaufte. Das Unternehmen willigte in eine Geldstrafe von zehn Millionen US-Dollar ein, und die SEC bezeichnete das Verfahren als ihre erste Durchsetzungsmaßnahme gegen einen Anbieter alternativer Daten.
Scraping und personenbezogene Daten. Bei Webdaten stellen sich dieselben Fragen wie bei jedem Scraping-Projekt: Sind die Seiten öffentlich, erlauben die Nutzungsbedingungen automatisierten Zugriff, bittet die robots.txt darum, fernzubleiben, und enthalten die Daten personenbezogene Informationen, die unter Gesetze wie die DSGVO oder das KVKK fallen? Ist Web Scraping legal? gibt den allgemeinen Überblick, und Personenbezogene Daten (PII) in Scraping-Datensätzen zeigt, wie Sie personenbezogene Felder reduzieren und schützen.
Warum ist die Qualität alternativer Daten schwer zu beurteilen?
Pflichtveröffentlichungen werden geprüft und folgen Standards; alternative Daten nicht, also muss der Käufer sie selbst kontrollieren:
- Abdeckung. Ein Kartenpanel erfasst die Menschen, die die Karten eines Ausgebers oder eine bestimmte Beleg-App nutzen, nicht die gesamte Bevölkerung. Ein Scraper erfasst die Seiten, die er erreicht, nicht den ganzen Katalog.
- Historie. Ein Signal braucht Jahre an Historie, um gegen gemeldete Ergebnisse getestet zu werden.
- Survivorship und Änderungen. Filialen schließen, Websites ändern ihre Produktcodes, Anbieter revidieren alte Daten.
- Zuordnung. Marken, Tochtergesellschaften und Filialnamen müssen dem richtigen Unternehmen zugeordnet werden.
- Verfall. Wenn viele Firmen denselben Datensatz kaufen, schrumpft der Vorsprung, den er bietet. Der oben genannte Artikel des CFA Institute betont denselben Punkt.
Wo passt Web Scraping hinein?
Web Scraping, also das automatisierte Erfassen öffentlicher Webseiten, ist der Weg, über den die meisten Teams eigene alternative Daten aufbauen. Es eignet sich für Antworten, die online veröffentlicht, aber über Tausende Seiten verteilt sind:
- Preise und Aktionen. Tägliche Preise über mehrere Händler zeigen Rabatttiefe und Inflation in einer Kategorie – dieselbe Technik wie in Wettbewerberpreise im E-Commerce überwachen.
- Personalsuche. Stellenanzeigen nach Rolle und Stadt; LinkedIn-Jobs in einem anderen Land suchen zeigt, wie sich Anzeigen je nach Standort unterscheiden.
- Bewertungen. Anzahl und Noten von Bewertungen im Zeitverlauf, bewertet mit Methoden wie in Sentiment-Analyse in Python: VADER vs. Hugging Face.
- Seitenänderungen. Aktualisierungen von Filialfindern, AGB- oder Preisseiten, verfolgt wie in Website auf Änderungen überwachen.
Zwei Punkte sind hier wichtig. Erstens zeigen viele Websites je nach Land andere Preise, Bestände und Angebote; ein Scraper muss Seiten daher vom richtigen Standort anfordern, sonst vermischt die Zeitreihe Regionen. Mit Residential-Proxy-Adressen wählen Sie für jede Anfrage Zielland und Stadt. Zweitens muss ein Scraper, der jahrelang täglich läuft, rücksichtsvoll sein: robots.txt beachten, die Anfragerate niedrig halten, eine offizielle API nutzen, wenn es eine gibt, und Anfragen mit Rotierender Proxy-Einstellungen über die Zeit verteilen, statt eine Website in Schüben zu belasten. Proxys ändern nichts daran, welche Daten Sie erheben dürfen; sie bestimmen nur, von welcher Netzwerkadresse die Anfrage kommt.
Alternative Daten selbst erheben oder einkaufen?
| Faktor | Selbst erheben | Von einem Anbieter lizenzieren |
|---|---|---|
| Kontrolle über die Methode | Vollständig; Sie kennen jeden Schritt | Begrenzt auf das, was der Anbieter offenlegt |
| Zeit bis zu den ersten Daten | Wochen für einen funktionierenden Scraper | Tage nach Vertragsabschluss |
| Historie | Beginnt am Tag Ihres Starts | Oft Jahre an rückwirkenden Daten |
| Laufender Aufwand | Wartung, wenn sich Websites ändern | Due Diligence beim Anbieter, Verlängerungen |
| Compliance-Aufwand | Eigene Prüfung von Quellen und Bedingungen | Prüfung der Quellen und Bedingungen des Anbieters |
| Geeignete Datenarten | Öffentliche Webdaten | Karten-, Standort-, App-, Satellitendaten |
Die meisten Teams nutzen am Ende beides: Anbieterdaten für Arten, die sie nicht selbst erheben können, und eigene Scraper für Webdaten, die sie in einer bestimmten Form oder aus einem bestimmten Land brauchen.
Wo werden alternative Daten eingesetzt?
- Investment-Research. Analysten nutzen Web-, Karten- und App-Daten, um Umsätze vor der Veröffentlichung der Ergebnisse zu schätzen; die Finanz-Proxy-Seite behandelt die Datenerhebung für Finanzunternehmen.
- Marktforschung. Beratungen und Marken ermitteln die Größe von Kategorien und verfolgen die Sortimente der Konkurrenz; siehe Proxys für Marktforschung.
- Preisgestaltung im Handel. Händler vergleichen ihre Preise täglich mit denen der Konkurrenz, wie auf der Seite zur Preisüberwachung beschrieben.
- Wirtschaftsforschung. Onlinepreise und Stellenanzeigen liefern frühere Werte zu Inflation und Arbeitskräftenachfrage als monatliche Statistiken.
- Datenprodukte. Unternehmen, die Datensätze für andere aufbauen, sind auf Erhebung in großem Umfang angewiesen – der Anwendungsfall hinter Proxys für Data Scraping.
Häufige Fehler bei alternativen Daten
- Beim Datensatz statt bei der Frage anfangen. Ein großer Datensatz ohne Hypothese liefert Diagramme, keine Antworten.
- Die Prüfung der Quelle überspringen. Nicht zu wissen, wie ein Anbieter seine Daten erhoben hat, ist genau die Lücke, die der SEC-Hinweis beschreibt.
- Standorte vermischen. Eine globale Website aus einem Land scrapen und annehmen, die Preise gälten überall.
- Einem kurzen Backtest vertrauen. Ein Signal, das nur an einem Jahr getestet wurde, kann zufällig gepasst haben.
- Personenbezogene Daten behalten, die Sie nicht brauchen. Namen, E-Mail-Adressen und Nutzer-IDs bringen selten Signal, aber immer Risiko; verwerfen Sie sie schon bei der Erhebung.
- Scraper stillschweigend scheitern lassen. Eine Layoutänderung, die leere Seiten liefert, sieht aus wie „Umsatz auf null gefallen“, wenn Sie die Zeilenzahlen nicht überwachen.
- Das Signal für dauerhaft halten. Quellen ändern sich und Vorsprünge verblassen; prüfen Sie jeden Datensatz in festen Abständen.
Entscheidungshilfe
| Bedarf | Empfehlung |
|---|---|
| Tägliche Preise oder Bestände aus öffentlichen Shops | Scraper bauen; Anfragen aus dem Zielland senden |
| Verbraucherausgaben nach Marke | Transaktionspanel lizenzieren und dessen Herkunft prüfen |
| Physische Aktivität an Standorten | Satelliten- oder Foot-Traffic-Daten lizenzieren |
| Einstellungstrends nach Unternehmen | Karriereseiten und Jobbörsen im Rahmen ihrer Bedingungen scrapen |
| Markensentiment im Zeitverlauf | Bewertungen oder Beiträge über APIs sammeln, mit NLP bewerten |
| Sofort mehrere Jahre Historie | Einkaufen; ein Scraper kann die Vergangenheit nicht nachträglich erfassen |
| Ein Signal, das sonst niemand hat | Selbst erheben und die Methode für die Compliance dokumentieren |
Häufige Fragen
Was ist der Unterschied zwischen alternativen und traditionellen Daten?
Traditionelle Daten sind das, was Unternehmen und Behörden offiziell veröffentlichen: Abschlüsse, Pflichtmeldungen, Telefonkonferenzen zu Quartalszahlen und amtliche Statistiken. Alternative Daten sind alles andere, was dasselbe Geschäft erklärt, etwa Webpreise oder Kartenpanels. Die Grenze verläuft entlang der Quelle, nicht des Formats.
Ist Web Scraping eine Quelle alternativer Daten?
Ja. Gescrapte Webdaten (Preise, Produktlisten, Stellenanzeigen, Bewertungen) gehören zu den häufigsten Arten und sind die, die Teams am häufigsten selbst erheben. Sie sollten nur öffentliche Seiten umfassen, die Nutzungsbedingungen und robots.txt beachten und mit niedriger Anfragerate erhoben werden.
Wer nutzt alternative Daten?
Hedgefonds und Vermögensverwalter waren die Ersten. Heute nutzen sie auch Private-Equity-Gesellschaften, Kreditgeber, Händler, Beratungen und Ökonomen.
Können alternative Daten Insiderinformationen enthalten?
Ja. Die SEC stellt fest, dass alternative Daten nicht notwendigerweise wesentliche nicht öffentliche Informationen enthalten; ein Datensatz, der unter Verletzung einer Vertraulichkeitsvereinbarung oder der Nutzungsbedingungen einer Website erhoben wurde, könnte aber Informationen tragen, auf deren Grundlage nicht gehandelt werden darf. Deshalb erwarten Aufsichtsbehörden, dass Firmen vor der Nutzung prüfen, wie jede Quelle erhoben wurde.
Sind alternative Daten dasselbe wie Big Data?
Nein. Big Data beschreibt Volumen und Verarbeitungsmethoden; alternative Daten beschreiben, woher Informationen stammen. Manche alternativen Datensätze sind riesig, etwa jahrelange tägliche Preise, andere sind klein, etwa eine wöchentliche Zahl von Filialeröffnungen.
Wie steige ich in alternative Daten ein?
Wählen Sie eine eng gefasste Frage, finden Sie eine Quelle, die sie beantworten könnte, und sammeln Sie genug Historie, um die Antwort gegen bekannte Ergebnisse zu testen. Für Webdaten reicht zum Start ein kleiner Scraper mit sauberer Speicherung und Überwachung; nehmen Sie Anbieter erst hinzu, wenn Sie Daten brauchen, die Sie nicht selbst erheben können.
Fazit
Alternative Daten sind Informationen außerhalb der traditionellen Quellen aus Pflichtveröffentlichungen, Abschlüssen und amtlichen Statistiken: Webpreise, Stellenanzeigen, Bewertungen, Kartenpanels, Satellitenbilder und App-Nutzung. Sie sind nützlich, wenn sie eine konkrete Frage früher beantworten als traditionelle Quellen – nach Bereinigung und Test gegen die Historie. Was einen brauchbaren Datensatz von einem riskanten unterscheidet, ist die Prüfung der Quelle: wer die Daten erhoben hat, wie und unter welchen Bedingungen. Bei Webdaten, die Sie selbst erheben, zählen vor allem öffentliche Seiten, maßvolle Anfrageraten und Anfragen aus dem richtigen Land; das Proxy-Netzwerk von Proxynet stellt dafür Residential- und Rotating-Adressen bereit.