


































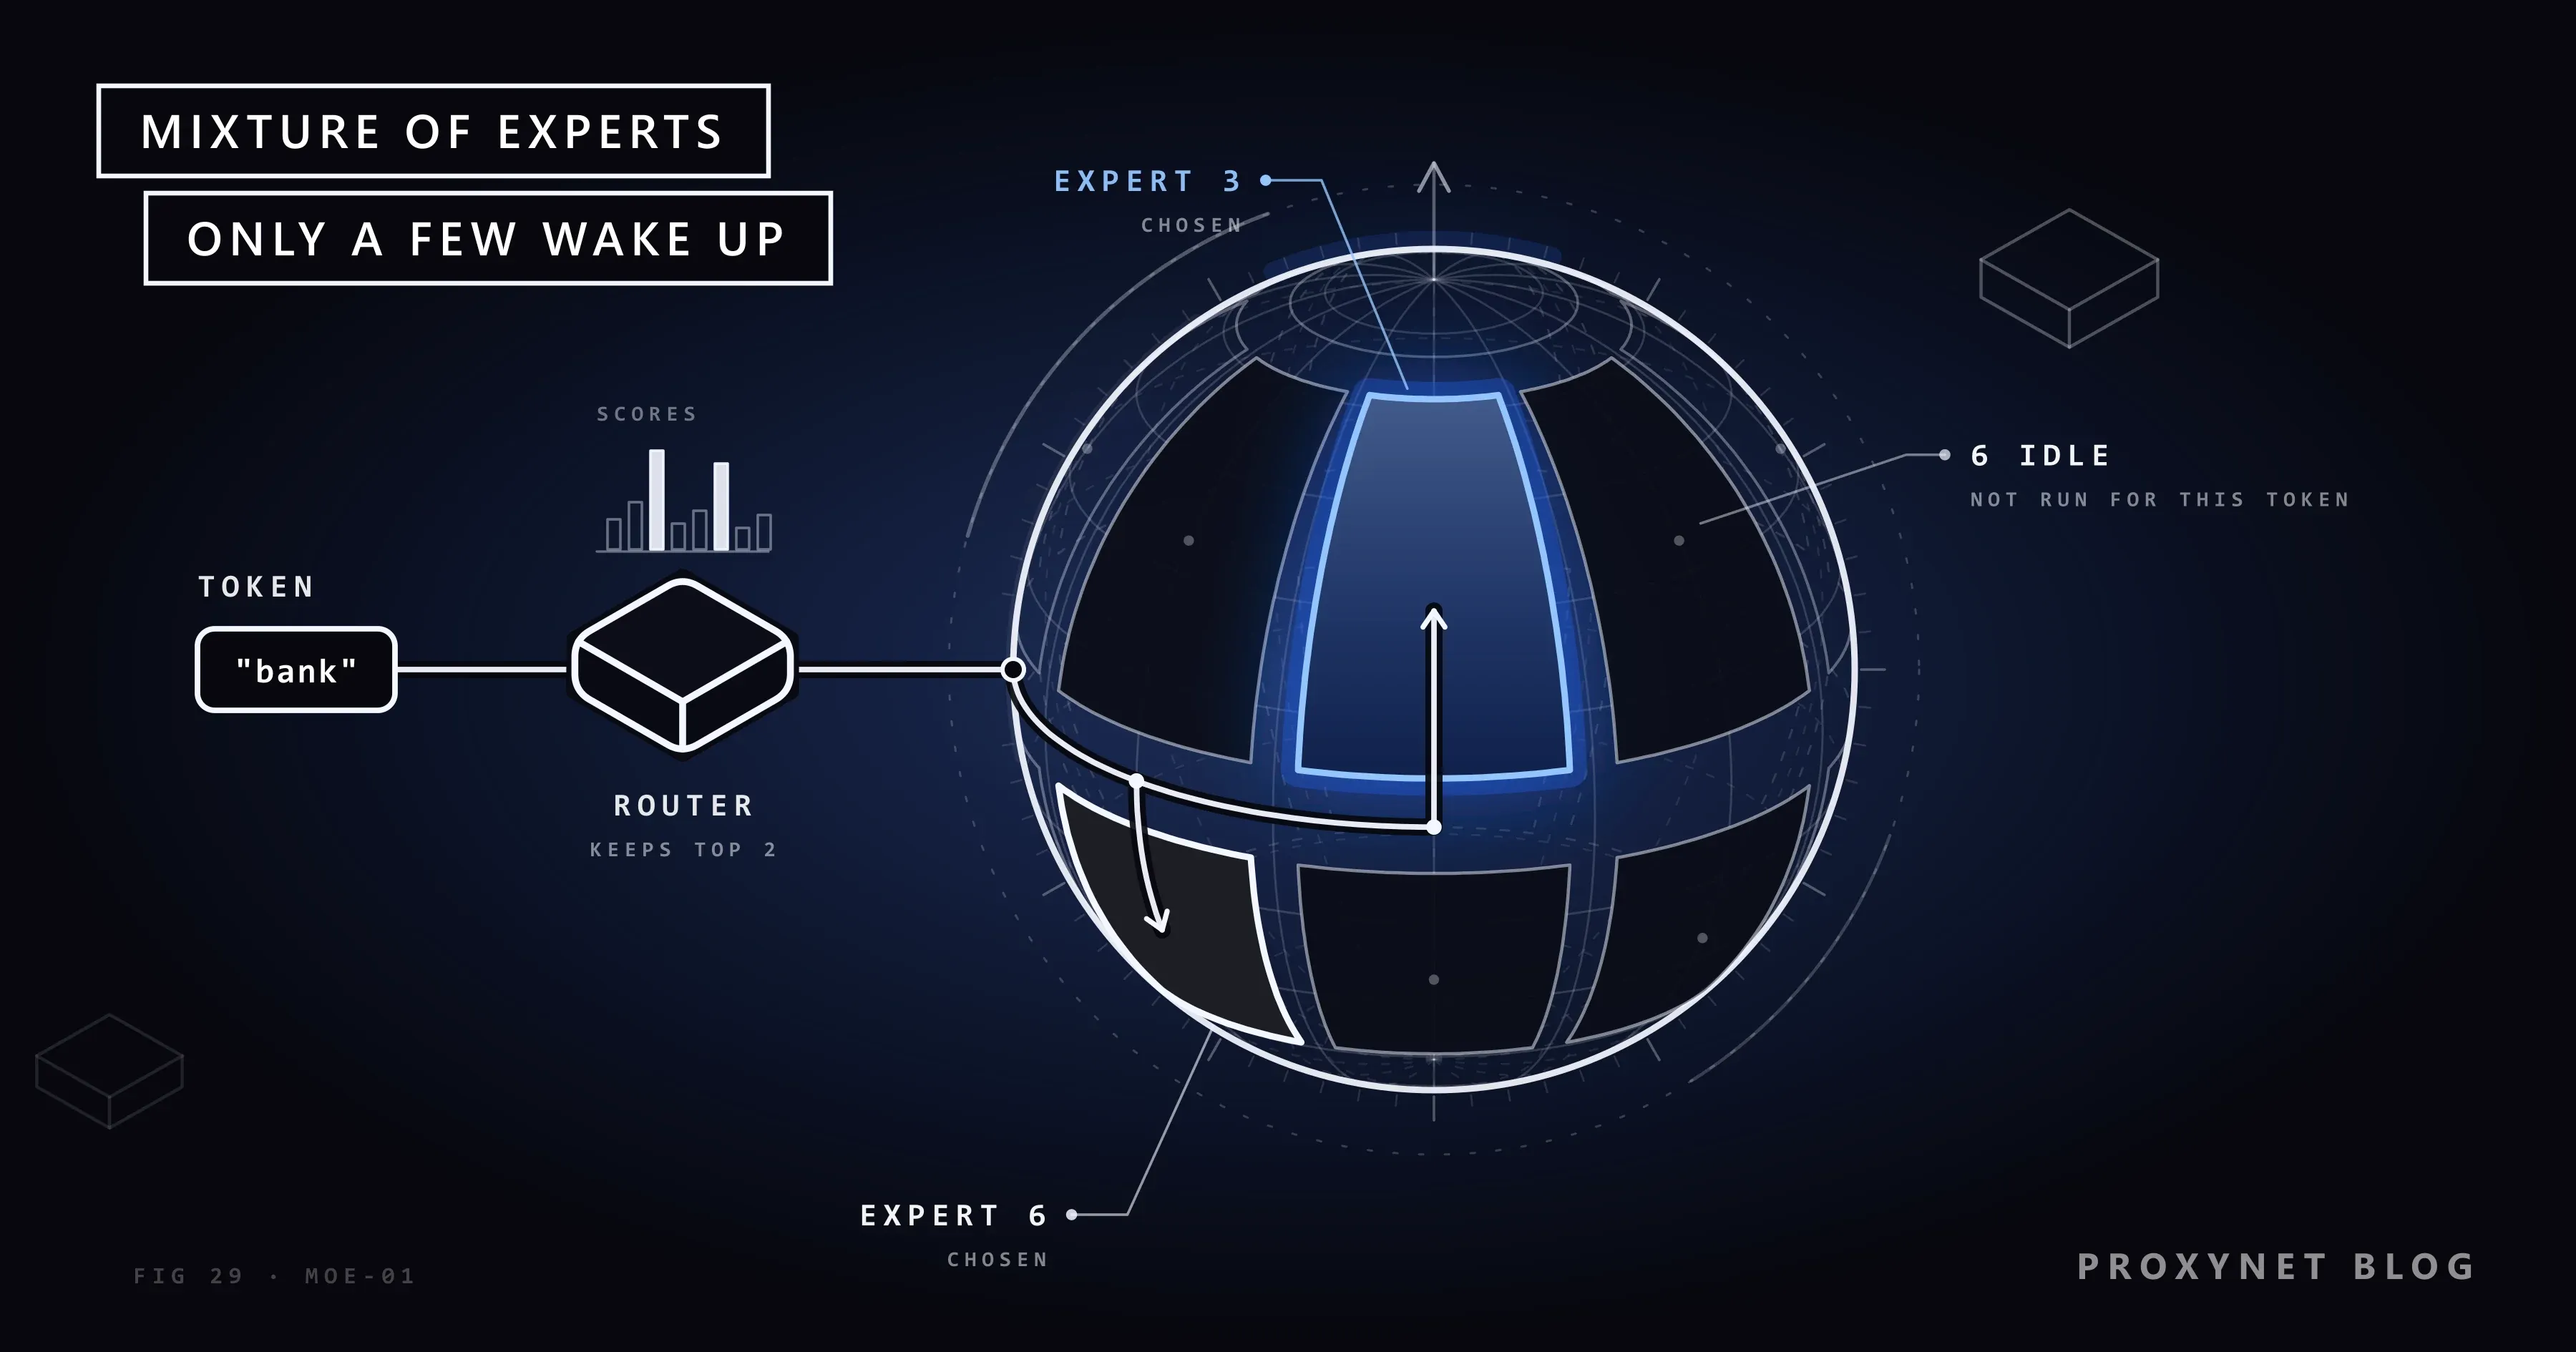
O relatório técnico de um modelo aberto informa que ele tem 47 bilhões de parâmetros e, na mesma frase, diz que ele usa só 13 bilhões deles para cada token. Os dois números estão certos, e a diferença entre eles é toda a ideia da mistura de especialistas (mixture of experts): o modelo tem muito mais parâmetros do que usa para qualquer token que lê ou escreve. Se você pretende rodar um modelo assim por conta própria, o primeiro número decide quanta memória você precisa e o segundo, a maior parte do processamento.
Este post explica o que é um modelo de mistura de especialistas (MoE), como o roteador (router) escolhe os especialistas, o que significam parâmetros totais e ativos, como a MoE se compara a um modelo denso, quanto ela custa e se os especialistas realmente se especializam.
O que é mistura de especialistas?
Mistura de especialistas é uma forma de montar uma camada de rede neural com várias redes menores, os especialistas, e um roteador (também chamado de gate, ou porta) que decide quais deles processam cada entrada. Uma camada densa aplica todos os seus pesos a cada entrada; uma camada MoE executa só os especialistas que o roteador escolhe, então a maioria dos pesos fica parada a cada momento. É por isso que os modelos MoE também são chamados de modelos esparsos: para cada token, só uma parte pequena da rede está ativa.
O design faz mais diferença nos modelos de linguagem grandes (LLMs), redes neurais treinadas com enormes volumes de texto para prever o próximo trecho de texto; nosso guia sobre LLMs explica como eles são construídos. Cada camada do transformer de um modelo assim tem um bloco de atenção (attention), que permite a cada token levar os outros tokens em conta, e um bloco feed-forward (de alimentação direta), que depois processa cada token sozinho. Um modelo MoE mantém o bloco de atenção e troca o bloco feed-forward único por muitas versões especialistas dele, cada uma com seus próprios pesos.
A palavra "especialista" é um nome, não um cargo: ninguém atribui um assunto a um especialista, e qualquer divisão de trabalho que apareça é aprendida no treinamento.
De onde veio a ideia?
A ideia tem mais de trinta anos. Em 1991, Robert Jacobs, Michael Jordan, Steven Nowlan e Geoffrey Hinton publicaram "Adaptive Mixtures of Local Experts" na revista Neural Computation: redes separadas, cada uma aprendendo um subconjunto dos casos de treinamento, e uma rede de controle (gating network) que decidia em qual delas confiar.
A forma usada nos modelos de linguagem atuais começa com um artigo de 2017 de Noam Shazeer e colegas, Outrageously Large Neural Networks. Ele colocou uma camada MoE de ativação esparsa (sparsely-gated), com até milhares de especialistas, entre as camadas de um modelo de linguagem, chegou a até 137 bilhões de parâmetros e relatou uma capacidade de modelo mais de 1.000 vezes maior com só pequenas perdas de eficiência computacional.
Em 2021, o artigo do Switch Transformer enviou cada token a um único especialista e treinou modelos de até 1,6 trilhão de parâmetros. Os autores relataram um pré-treinamento até 7 vezes mais rápido que o de um modelo denso T5-Base com os mesmos recursos computacionais e apontaram o que vinha travando essa abordagem: complexidade, custos de comunicação e instabilidade de treinamento. Depois vieram os modelos de linguagem MoE de pesos abertos (open-weight), entre eles o Mixtral 8x7B, da Mistral AI, e o DeepSeek-V3.
Como funciona uma camada de mistura de especialistas?
Uma camada MoE dá uma pontuação a cada especialista para cada token, executa só os melhores e mistura os resultados. Antes disso, o texto já foi dividido em tokens, os pequenos pedaços que um modelo lê, como palavras ou partes de palavras (nosso guia sobre tokens em IA mostra como), e cada token percorre o modelo como um vetor, ou seja, uma longa lista de números.
- O token chega como um vetor vindo do bloco de atenção da mesma camada, que já incorporou informações dos tokens ao redor.
- O roteador pontua cada especialista. O roteador é uma pequena camada aprendida que dá a cada especialista uma pontuação para este token. Executá-lo é barato, por maiores que sejam os especialistas.
- Só os k melhores especialistas (top-k) são mantidos. O número k é definido no projeto do modelo: 1 no Switch Transformer, 2 no Mixtral, 8 de 256 especialistas roteados no DeepSeek-V3. Todos os outros especialistas recebem peso zero.
- As pontuações mantidas viram pesos. Uma função softmax as transforma em frações que somam 1.
- Os especialistas escolhidos processam o token. Cada especialista é uma rede feed-forward comum, com seus próprios pesos.
- As saídas são misturadas. A saída da camada é a soma ponderada das saídas dos especialistas escolhidos e segue para a próxima camada.
- A próxima camada escolhe de novo. Cada camada MoE tem seu próprio roteador e seus próprios especialistas, então um token pode usar os especialistas 2 e 5 em uma camada e os especialistas 1 e 7 na seguinte.
Um exemplo inventado mostra a conta. Em uma camada com 8 especialistas, o roteador dá a um token uma pontuação de 2,1 para o especialista 3, de 1,3 para o especialista 6 e pontuações menores para os outros seis. Com roteamento top-2, só os especialistas 3 e 6 rodam; uma softmax sobre as duas pontuações mantidas dá pesos de cerca de 0,69 e 0,31, ou seja, a saída da camada é 69% o resultado do especialista 3 e 31% o do especialista 6. Seis especialistas não trabalharam para este token.
Os designs variam: o DeepSeek-V3, por exemplo, acrescenta aos especialistas roteados um especialista compartilhado pelo qual todo token passa.
Parâmetros totais e ativos: qual é a diferença?
Parâmetros totais são todos os pesos que o modelo tem; parâmetros ativos são os pesos realmente usados para processar um token. Um parâmetro é um único número aprendido dentro da rede. Um modelo denso usa todos os seus parâmetros para cada token, então nele as duas contagens são iguais; em um modelo MoE, elas se separam.
O artigo do Mixtral dá um exemplo claro. Cada camada tem 8 especialistas e o roteador escolhe 2 para cada token, então cada token tem acesso a 47 bilhões de parâmetros, mas usa só 13 bilhões. O nome "8x7B" sugere 56 bilhões, mas só os blocos feed-forward existem oito vezes; a atenção e as outras partes de cada camada são compartilhadas e contadas uma vez.
O DeepSeek-V3 amplia a diferença: 671 bilhões de parâmetros totais, dos quais 37 bilhões são ativados para cada token, mais ou menos um peso em cada dezoito.
Os dois números respondem a perguntas diferentes:
- Os parâmetros totais definem a memória. Todo especialista precisa estar carregado, porque o próximo token pode precisar de qualquer um deles. Os autores do Mixtral escrevem que o custo de memória para servir o modelo é proporcional à contagem total, esparsa, de parâmetros.
- Os parâmetros ativos definem a maior parte do processamento por token, e com isso boa parte do custo de cada token gerado.
- Nenhum dos dois números sozinho indica a qualidade. Um modelo com 13 bilhões de parâmetros ativos não é o mesmo que um modelo denso de 13 bilhões de parâmetros, porque recorre a um estoque muito maior de pesos armazenados.
Modelo denso vs. modelo MoE: qual é a diferença?
Um modelo denso executa todos os parâmetros para cada token, enquanto um modelo MoE do mesmo tamanho total executa só uma fração deles, o que economiza processamento, mas não memória. A tabela compara os dois com o mesmo número total de parâmetros.
| Modelo denso | Modelo MoE | |
|---|---|---|
| Parâmetros usados por token | Todos | Só os especialistas escolhidos e as partes compartilhadas |
| Processamento por token | Cresce com o tamanho total | Cresce com o tamanho ativo |
| Memória para servir | Tamanho total | Tamanho total: todos os especialistas carregados |
| Treinamento | Bem conhecido | Exige balanceamento de carga, menos estável |
| Distribuição em muitos chips | Divisão por camadas ou tensores | Especialistas em chips diferentes, mais tráfego |
| Ajuste fino (fine-tuning) com poucos dados | Previsível | Pode sofrer sobreajuste mais cedo |
O quadro muda se você fixar o processamento. Comparado a um modelo denso com o mesmo número de parâmetros ativos, um modelo MoE faz mais ou menos a mesma conta por token, mas precisa de várias vezes mais memória e, em troca, tem muito mais pesos para guardar o que aprendeu.
Quanto custa a mistura de especialistas?
A mistura de especialistas troca processamento por memória e traz três problemas que um modelo denso não tem: carga desigual entre os especialistas, treinamento menos estável e mais comunicação entre chips.
Memória. Todo especialista precisa estar carregado em algum acelerador (como uma GPU), embora a maioria fique parada para um token qualquer. O relatório técnico do DeepSeek-V3 descreve uma unidade mínima de implantação de 40 nós com 320 GPUs para a etapa que gera texto, com cada GPU guardando um especialista. Por isso, rodar um modelo MoE em uma única máquina significa fazer todos os especialistas caberem na memória, não só os ativos.
Balanceamento de carga. Se o roteador escolhe sempre os mesmos poucos especialistas, eles recebem mais treinamento, melhoram e são escolhidos com frequência ainda maior; o artigo de Shazeer diz que esse desequilíbrio se autorreforça. A solução habitual é uma perda auxiliar (auxiliary loss), um termo extra no objetivo de treinamento que penaliza cargas desiguais. O Switch Transformer também dá a cada especialista uma capacidade fixa por lote (batch): um token que chega quando o seu especialista está cheio pula esse especialista e vai direto para a próxima camada, o que se chama descarte de tokens (token dropping). O DeepSeek-V3 usa, em vez disso, um viés (bias) por especialista, ajustado durante o treinamento, porque, segundo os autores, uma perda auxiliar grande demais prejudica o desempenho do modelo.
Instabilidade de treinamento. Os roteadores são sensíveis a pequenos erros numéricos. Os autores do Switch Transformer viram que a instabilidade os impedia de treinar em bfloat16, um formato numérico de baixa precisão, e resolveram isso calculando o roteador com precisão de 32 bits e começando com pesos iniciais menores. O relatório do Llama 3, da Meta, faz a escolha oposta pelo mesmo motivo: o maior modelo, com 405 bilhões de parâmetros, é um transformer denso padrão, escolhido no lugar de uma mistura de especialistas para maximizar a estabilidade do treinamento.
Comunicação. Modelos MoE grandes espalham seus especialistas por muitos chips, então cada camada MoE precisa enviar cada token aos chips que guardam os especialistas escolhidos e recolher os resultados. O DeepSeek-V3 limita esse tráfego enviando cada token a especialistas em no máximo 4 nós.
Os especialistas se especializam em assuntos?
Não do jeito que o nome sugere: estudos de modelos MoE treinados encontram especialistas que cuidam de tipos de token, como pontuação ou partes da sintaxe de código, e não de assuntos como medicina ou direito.
A equipe do Mixtral verificou quais especialistas eram escolhidos para textos de fontes diferentes, entre elas artigos do arXiv, resumos de biologia do PubMed, artigos de filosofia e código do GitHub, e não encontrou nenhum padrão claro por assunto. O roteamento parecia mais ligado à sintaxe: a palavra self em Python e os tokens de indentação no código muitas vezes iam para os mesmos especialistas, e tokens consecutivos frequentemente compartilhavam especialistas.
Trabalhos anteriores apontam na mesma direção. O artigo de Shazeer de 2017 relatou especialistas que se tornaram altamente especializados por sintaxe e semântica. O artigo ST-MoE, de 2022, encontrou no codificador (encoder) especialistas em pontuação, verbos, nomes próprios e contagem, uma especialização bem mais fraca no decodificador (decoder) e nenhuma evidência de que os especialistas se especializassem por idioma em um modelo multilíngue.
Então não dá para direcionar um prompt "ao especialista jurídico": o roteador decide por token e por camada, e a divisão de trabalho que ele aprende é estatística.
Onde você encontra a mistura de especialistas?
- Cartões de modelo (model cards) e relatórios técnicos que informam dois tamanhos, parâmetros totais e ativos: o sinal mais claro de um modelo MoE.
- Modelos de pesos abertos que você baixa e roda, como o Mixtral e o DeepSeek-V3, em que o tamanho total decide se o modelo cabe no seu hardware.
- Modelos fechados por trás de uma API, cuja arquitetura muitas vezes não é publicada. Alguns fornecedores a publicam: o relatório do Gemini 1.5, do Google, descreve o Gemini 1.5 Pro como um transformer de mistura de especialistas esparsa. Quando um fornecedor não disse nada, as afirmações sobre o design dele são palpites.
A MoE muda os dados de que um modelo precisa? Não. Esparso ou denso, um modelo de linguagem é treinado com coleções de texto muito grandes, boa parte vinda de páginas web públicas. Equipes que fazem ajuste fino, grounding (ancoragem em fontes) ou avaliação de modelos também continuam coletando páginas, muitas vezes de vários países, porque preços, regras e detalhes de produto mudam de um mercado para outro. É nesse trabalho de coleta que os proxies entram: os Proxies residenciais permitem que um rastreador (crawler) carregue uma página pública como um visitante de determinado país a vê, em um ritmo de requisições que o site consegue suportar.
Erros comuns
- Dimensionar o hardware pelos parâmetros ativos. Um modelo com 13 bilhões de parâmetros ativos ainda precisa de memória para todos os 47 bilhões.
- Multiplicar o nome. "8x7B" não quer dizer 56 bilhões de parâmetros; as partes compartilhadas de cada camada são contadas uma vez.
- Comparar modelos por um único número. Use os parâmetros ativos para o processamento, os totais para a memória e seus próprios prompts de teste para a qualidade.
- Esperar especialistas por assunto. Um prompt não consegue escolher um especialista, e os especialistas raramente correspondem a assuntos.
- Fazer ajuste fino com um conjunto de dados minúsculo sem uma validação separada. O estudo ST-MoE constatou que modelos esparsos são mais propensos a sobreajuste (overfitting) em tarefas pequenas, então meça com exemplos que o modelo não viu; o básico está no nosso guia de ajuste fino.
- Repetir boatos sobre modelos fechados. Se o fornecedor não publicou a arquitetura, ela é desconhecida.
Guia de decisão
| Sua situação | O que a MoE significa para você |
|---|---|
| Você usa um modelo por uma API paga | Compare preço, latência e respostas; a arquitetura é assunto do provedor |
| Você roda um modelo aberto na sua própria GPU | Todos os parâmetros totais precisam caber na memória |
| Você quer mais qualidade com o mesmo processamento | Vale a pena testar um modelo MoE |
| A memória é o seu limite rígido | Um modelo denso menor é mais simples |
| Você atende muitos usuários em um cluster de GPUs | Planeje a distribuição dos especialistas e o tráfego entre chips |
| Você faz ajuste fino com um conjunto de dados pequeno | Acompanhe o sobreajuste nos resultados de validação |
| Você compara dois cartões de modelo | Leia separadamente os parâmetros totais e os ativos |
Perguntas frequentes
Um modelo MoE é mais rápido que um modelo denso?
Por token, sim, em comparação com um modelo denso do mesmo tamanho total, porque ele calcula só os especialistas escolhidos. Em comparação com um modelo denso do mesmo tamanho ativo, ele faz mais ou menos a mesma conta, mas movimenta mais dados, porque tokens diferentes em um lote chamam especialistas diferentes. A velocidade real depende do hardware, do tamanho do lote e de onde os especialistas estão alocados.
Por que os modelos MoE precisam de tanta memória?
Porque todo especialista precisa continuar carregado, embora cada token use só alguns. O roteador decide em tempo de execução, token a token, então qualquer especialista pode ser necessário em seguida. Os autores do Mixtral afirmam que a memória para servir o modelo acompanha os 47 bilhões de parâmetros totais, não os 13 bilhões ativos.
O que significa roteamento top-k?
Roteamento top-k significa que o roteador mantém os k especialistas com as maiores pontuações para um token e ignora o resto. O valor de k é uma escolha de projeto: o Switch Transformer usa 1, o Mixtral 2 e o DeepSeek-V3 8 dos seus 256 especialistas roteados. Um k maior gasta mais processamento por token; um menor sai mais barato.
Os especialistas de um modelo MoE se especializam por assunto?
Na maioria das vezes, não. Estudos de modelos treinados encontram especialistas ligados a tipos de token e à sintaxe, como pontuação, verbos ou indentação no código, e a equipe do Mixtral não encontrou nenhum padrão claro por assunto em textos de ciência, biologia, filosofia e código.
Qual é a diferença entre mistura de especialistas e um conjunto de modelos (ensemble)?
Um ensemble roda vários modelos completos, treinados separadamente, sobre a mesma entrada e combina as respostas, então paga por todos os modelos em cada entrada. Um modelo MoE é uma única rede treinada como um todo, em que um roteador dentro de cada camada MoE envia cada token a só alguns especialistas.
Todos os modelos de linguagem grandes usam mistura de especialistas?
Não. O Mixtral e o DeepSeek-V3 são modelos MoE, e o relatório do Gemini 1.5, do Google, descreve o Gemini 1.5 Pro como um deles, enquanto o maior modelo Llama 3, da Meta, é um transformer denso com 405 bilhões de parâmetros. Muitos fornecedores de modelos fechados nem publicam sua arquitetura.
Em resumo
A mistura de especialistas divide uma camada em muitas redes especialistas e deixa um roteador enviar cada token a só algumas delas, de modo que um modelo pode ter muito mais parâmetros do que usa no cálculo de qualquer token. Os parâmetros totais decidem a memória, os ativos decidem a maior parte do processamento, e os custos são memória, balanceamento de carga, estabilidade de treinamento e tráfego entre chips. Os especialistas são aprendidos, não atribuídos a assuntos. Para equipes que precisam coletar páginas web públicas em escala para construir ou testar modelos, a nossa Web Scraping API, um serviço de extração gerenciada de páginas oferecido pelo time de vendas, está descrita na página de extração de dados.


